



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.




De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
De kosten van generatieve AI lijken beheersbaar in de pilotfase. Een paar API-calls, een klein team, een beperkte use case. U start een paar pilotprojecten en alles lijkt prima te gaan. Dan schaalt het initiatief. Meer teams sluiten zich aan, tokenvolumes vermenigvuldigen zich en de infrastructuur verspreidt zich over uw cloud computing-accounts. De maandelijkse rekening lijkt in niets meer op de oorspronkelijke schatting.
Onderzoek van IBM toonde aan dat de computekosten tussen 2023 en 2025 naar verwachting met 89% zullen stijgen, waarbij 70% van de leidinggevenden generatieve AI noemt als de belangrijkste oorzaak. Elke ondervraagde leidinggevende had al minstens één GenAI-initiatief geannuleerd of uitgesteld vanwege kostenzorgen. Dit is geen mislukking van de budgettering; het is een zichtbaarheidsprobleem. De kosten zijn er en ze stapelen zich op; ze bevinden zich alleen niet waar de meeste organisaties ze verwachten te vinden.
Deze gids legt uit waar de kosten van generatieve AI zich opbouwen, wat de markt vraagt voor het beheersen ervan en hoe u kunt schalen zonder de financiële controle over uw AI-investeringen te verliezen.

De meeste teams voorspellen budgetten op basis van zichtbare tokenprijzen en missen de enorme structurele cloudkosten die onder het oppervlak schuilgaan. De totale kosten misleiden veel planners.
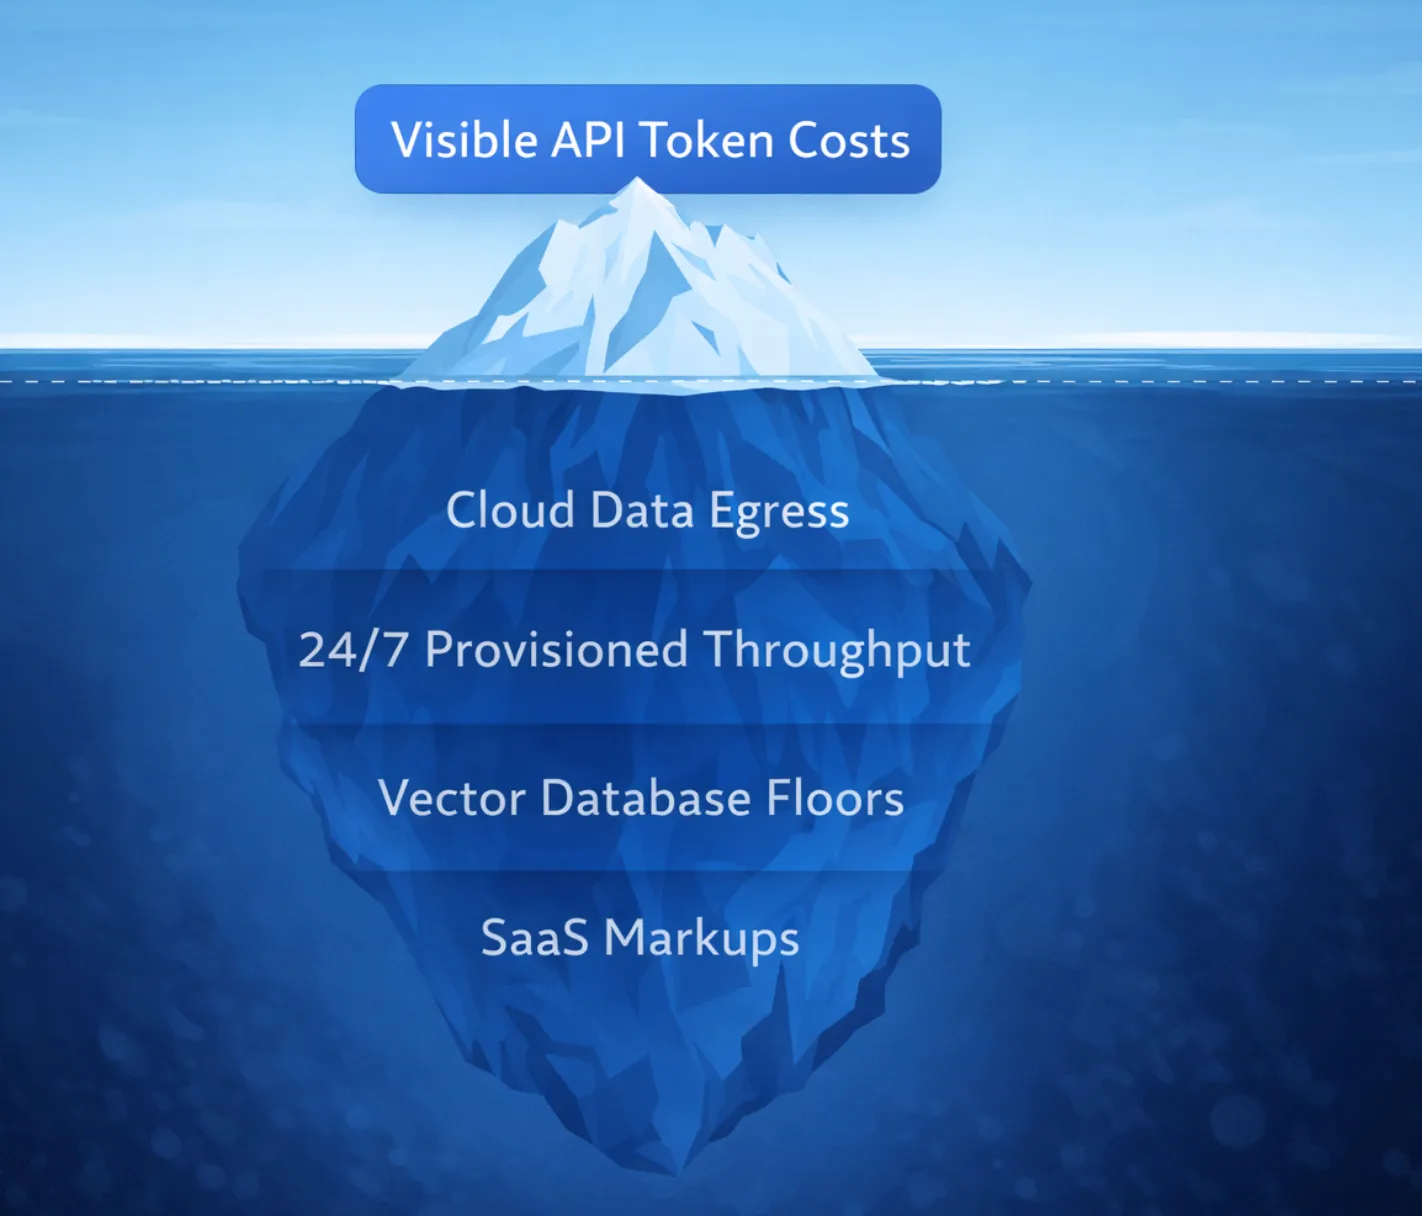
Naast de infrastructuur brengt de levenscyclus van het onderhouden van AI in productie verborgen kosten met zich mee.
De meeste prognoses voor de kosten van generatieve AI beginnen bij de AI-modellaag zelf, met weinig tot geen aandacht voor wat er moet gebeuren voordat er één enkele inference wordt uitgevoerd. Kosten voor datapreparatie, het opschonen en het structureren van de data voor generatieve AI-applicaties kunnen bijna net zo duur zijn als het model zelf. Enterprise-data bestaat van nature niet in een bruikbare staat. Het bevindt zich in vele systemen, wat initiële data-acquisitie vereist om verouderde formaten te exporteren die in de eerste plaats nooit bedoeld waren voor machinaal verbruik.
Het vergt een aanzienlijke investering in tijd, geld en data scientists om die data op een punt te krijgen waarop deze door het model zelf kan worden verwerkt. Deze fase kan erg duur zijn, vooral
voor complexe domeinen zoals de gezondheidszorg, juridische dienstverlening of financiële diensten, waar deze fase een veelvoud kan zijn van de kosten van de AI-workload zelf, wat de kosten van generatieve AI opdrijft.
Het probleem wordt in de loop van de tijd echter erger, omdat een slechte datakwaliteit kan leiden tot model training-kosten, verhoogde compute-kosten en verspilde middelen doordat een organisatie blijft proberen problemen op te lossen met hallucinaties die worden veroorzaakt door de slechte datakwaliteit zelf.
Wanneer de uiteindelijke resultaten van generatieve AI-modellen slecht zijn, is het logisch om aan te nemen dat het model zelf faalt. In werkelijkheid ligt het probleem vaak bij de training- of retrieval-data zelf. Het corrigeren van dit probleem vereist kostbare evaluatiefasen om ervoor te zorgen dat de datakwaliteit is verbeterd. Dit kan erg duur zijn, vooral wanneer dit probleem meerdere keren gedurende de levensduur van het model moet worden opgelost, waarbij kostbare GPU-resources onderweg worden verbruikt, zonder dat dit is meegenomen in het oorspronkelijke budget voor de kosten van generatieve AI.
Governance is geen eenmalig vinkje. Het zijn continue operationele kosten die de meeste organisaties schromelijk onderschatten wanneer ze Gen AI voor het eerst in productie nemen, wat een negatieve invloed heeft op de operationele efficiëntie.
Gereguleerde sectoren krijgen bijvoorbeeld te maken met extra kosten voor dataprivacy-beoordelingen en herstel wanneer de governance van kunstmatige intelligentie een achterafgedachte is. Een juridische of privacy-beoordeling die voor een traditionele softwarefunctie enkele uren duurt, kan weken duren wanneer er AI-gegenereerde output bij betrokken is, wat de kosten van generatieve AI opdrijft.
Bovendien eisen regelgevers van organisaties niet alleen dat ze laten zien wat een model heeft besloten, maar ook waarom het model die beslissing heeft genomen en welke training-data in dat generatieve kunstmatige intelligentie-systeem is gebruikt. Het zal exponentieel duurder zijn om deze traceerbaarheid achteraf in te bouwen in vergelijking met het vanaf het begin ontwerpen ervan.
GDPR, HIPAA en SOC 2 hebben documentatie-eisen waaraan AI-systemen standaard niet kunnen voldoen en die kostbare extra tooling vereisen, wat de totale businesscase beïnvloedt. Een traditionele LLM API-call logt niets wat vanuit een regelgevend perspectief interessant is. Het legt niet vast wie het verzoek heeft geïnitieerd, of de prompt die is gebruikt om de output te genereren gevoelig was, of hoe de output is gebruikt.
Het legt niet de audit trail vast die nodig is om te voldoen aan de eisen van grote regelgevende instanties. Het vereist extra logging, PII-detectie en lagen voor toegangsbeheer bovenop de basismodel-infrastructuur, wat de ontwikkeltijd verlengt. Organisaties die eerst implementeren en daarna proberen te beheren, moeten onder tijdsdruk betalen voor dit herstel, waardoor de kosten van generatieve AI veel hoger worden.

Als het centrale IT-proces traag verloopt, zoeken teams hun eigen manier om de problemen op te lossen met behulp van nieuwe technologie. Dit is hoe de kosten van generatieve AI in het wild terechtkomen, en het wordt zelden ontdekt totdat de rekening binnenkomt of een beveiligingsprobleem het aan het licht brengt. Wanneer teams in de organisatie hun eigen AI-tools implementeren zonder goed kostenbeheer, betaalt het bedrijf dubbel voor overlappende functionaliteit, terwijl er kostbare problemen met beveiligingsgovernance ontstaan.
Het ene team koopt een AI-schrijfassistent voor het maken van content. Een ander team koopt een documentanalysetool voor een specifieke taak. Een derde team bouwt een directe integratie met een LLM API. Elk van deze aankopen kan worden gedaan op basis van een zakelijke behoefte. Gezamenlijk vertegenwoordigen ze kostbare dubbele functionaliteit die de total cost of ownership opdrijft; geld dat had kunnen worden bespaard in één enkele oplossing tegen een fractie van de kosten.
Zorgwekkender is dat elk van deze integraties een nieuw aanvalsoppervlak creëert waardoor enterprise-data buiten de beoogde grenzen kan lekken, wat de veilige gebruikerservaring ondermijnt. Bijna 10% van de prompts die naar publieke GenAI-modellen worden gestuurd, bevat gevoelige bedrijfsinformatie. Dit vertegenwoordigt een kostbaar compliancerisico dat zelden in het financiële model voor generatieve AI-kosten wordt opgenomen.
Werknemers die AI-producten voor consumenten gebruiken, staan er niet bij stil om hun inputs te analyseren met de juiste prompt engineering. Prijsstrategieën, klantinformatie, juridische communicatie en financiële informatie met betrekking tot de bedrijfsvoering kunnen allemaal verschijnen in prompts die worden gestuurd naar tools die niet zijn gecontroleerd door security of legal. Dit type compliancerisico verschijnt niet in een financieel model, maar vertegenwoordigt een echt financieel risico in de vorm van boetes van toezichthouders, meldingen van datalekken en reputatieschade, waardoor de kosten van generatieve AI enorm toenemen.
Aan de ene kant kan AI-ondersteunde ontwikkeling en contentgeneratie de output-snelheid verhogen. Aan de andere kant kan AI-ondersteunde ontwikkeling de snelheid verhogen waarmee code wordt geproduceerd die niemand volledig begrijpt en waarvoor niemand ooit heeft gebudgetteerd om deze te onderhouden.
AI-code die snel via tekstgeneratie is geproduceerd en in een legacy-omgeving is geïmplementeerd, kan het tempo verhogen waarmee de totale technische schuld in de toekomst moet worden aangepakt. Hoewel de snelheid van AI-codegeneratie een aanzienlijk voordeel is, kan het een illusie van productiviteit creëren wanneer de AI-code in een legacy-omgeving wordt geïmplementeerd, wat de langetermijnkosten van generatieve AI verhoogt.
Code die is ontworpen om in een modern API-patroon te werken, kan incompatibiliteiten veroorzaken met oudere frameworks die pas zichtbaar worden wanneer de productie-omgeving zwaar wordt belast. Hoewel de snelheid van AI-codegeneratie de initiële uitrol er als een succes liet uitzien, kan diezelfde snelheid het uiteindelijke herstel tot een crisis maken.
AI-code kan complexe afhankelijkheden creëren die steeds moeilijker en duurder worden om te ontwarren in een legacy-omgeving. Large language models zijn ontworpen om aannemelijke output te creëren, niet om een solide architectuur te bouwen. Gegenereerde code kan leiden tot strakke koppelingen, ongebruikelijke coderingspraktijken en andere logische problemen die pas op een later moment zichtbaar worden. In een legacy-omgeving komen deze problemen niet geïsoleerd voor. Ze ontstaan samen met andere problemen die een cumulatief effect kunnen hebben dat duur wordt om op te lossen, zoals we bespreken in het volgende gedeelte over de kosten van generatieve AI.

De uitrol is echter niet het eindpunt. Voor enterprise AI is de uitrol slechts de eerste stap. Onderhoud voor AI-systemen in een enterprise-omgeving kan variëren van 17% tot 30% per jaar, en oplopen tot 50% in sterk gereguleerde sectoren. Dit zijn geen uitzonderingen; ze vormen de normale operationele omgeving voor AI-systemen om relevant, nauwkeurig en veilig te blijven en echte zakelijke waarde te leveren.
Er zijn updates bij cloud service providers. Er zijn veranderingen in de effectiviteit van prompts door wijzigingen in het gedrag van modellen. Er zijn evaluatie-pipelines die moeten worden bijgewerkt. Er zijn integraties die moeten worden aangepast vanwege veranderingen in API-calls. Er is behoefte aan verandermanagement waarbij een formeel complianceproces moet worden toegevoegd bovenop elke wijziging aan het AI-systeem in sterk gereguleerde sectoren, wat bijdraagt aan de kosten van generatieve AI.
Dit alles leidt tot een vermindering van het vermogen om snel te handelen. Een schokkende 75% van de middelen die oorspronkelijk zijn geïnvesteerd in het bouwen van het AI-systeem, moet mogelijk worden toegewezen aan doorlopende ondersteuning. Ja, u leest het goed. Voor financiële teams is dat getal een schok. Voor degenen op de AI-afdelingen is dat getal een harde realiteit. Voor het bestuur zou dat getal moeten dienen als een wake-up call, vooral gezien de milieueffecten en CO2-uitstoot van de voortdurende rekenkracht.
Voor velen in de enterprise-omgeving worden Gen AI-budgetten ontwikkeld vanuit de veronderstelling dat de duurste fase van AI-investeringen de bouwfase is. Dat is niet het geval. De onderhoudsfase vereist een aanzienlijk deel van de middelen die oorspronkelijk in de bouw van het AI-systeem zijn geïnvesteerd, wat de kosten van generatieve AI verhoogt.
Prompt engineers, machine learning engineers, data engineers en infrastructure engineers worden niet beschikbaar voor andere taken op het moment dat de uitrol is voltooid. Ze worden onderdeel van een permanente cyclus van monitoring, evaluatie en iteratie, wat een sleutelfactor is in de
kosten van generatieve AI. Voor degenen op de financiële afdelingen wordt het AI-investeringsmodel waarschijnlijk behandeld als een kapitaaluitgave. Dat is niet hoe het werkt.


De organisaties die de kosten van generatieve AI onder controle hebben gekregen, delen één kenmerk dat niets te maken heeft met welke modellen ze gebruiken of hoe ze onderhandelen over cloudcontracten. De organisaties die kostenoptimalisatie doelgericht uitvoeren, zijn de organisaties met één centraal overzicht van elke uitgegeven euro en waaraan deze is besteed. Zonder dat overzicht is kostenbeheer hooguit reactief. Teams ontdekken overschrijdingen pas nadat ze hebben plaatsgevonden.
Escaleert de financiële afdeling pas aan het einde van het kwartaal in plaats van wanneer een budgetdrempel wordt overschreden? Beslissingen over welke modellen te gebruiken, welke workloads waarheen te leiden en welke teams onevenredig veel resources verbruiken, worden dan genomen op basis van gevoel in plaats van data en best practices. De markt heeft dit niet makkelijk gemaakt. Platformopslagen, gefragmenteerde tooling en betaalmuren voor governance veranderen wat een beheersbare infrastructuurkost zou moeten zijn in een onvoorspelbare schuld die de kosten van generatieve AI opdrijft.
De functies die organisaties financiële controle zouden geven — zoals gedetailleerde tokentoewijzing, budgethandhaving op teamniveau, vergelijking van kosten tussen providers en real-time gebruikswaarschuwingen — zitten achter enterprise-contracten, worden verkocht als afzonderlijke producten of blijven onbeschikbaar op de platformen die organisaties al gebruiken. Het resultaat is dat de teams die het dichtst bij het probleem staan, de middelen missen om het te diagnosticeren (van proof of concept tot productie), en dat de financiële teams met budgetbevoegdheid de context missen om zinvol in te grijpen.
Dit is een oplosbaar probleem, en het vereist niet dat u de snelheid van uw modelontwikkeling opoffert. TrueFoundry geeft organisaties de compute-economie, de kostenzichtbaarheid en de budgethandhaving die ze nodig hebben om GenAI te schalen zonder financiële verrassingen. Door platformopslagen op ruwe compute te elimineren, observability over elk model en elke provider te centraliseren en harde budgetlimieten op teamniveau te handhaven vóórdat overschrijdingen plaatsvinden in plaats van achteraf, verandert TrueFoundry het beheer van de kosten van generatieve AI van een driemaandelijkse afrekening in een continue operationele controle. Het doel is niet om de AI-adoptie te vertragen. Het is om ervoor te zorgen dat de financiële infrastructuur rond die adoptie net zo gereed is voor productie als de modellen zelf.
Stop met het betalen van verborgen platformopslagen en het gissen naar uw infrastructuurkosten. TrueFoundry biedt de zichtbaarheid, slimme routing en budgethandhaving die u nodig hebt om uw AI-initiatieven met vertrouwen te schalen.
Boek een demo om aan de slag te gaan.
De kosten van generatieve AI variëren op basis van uw gekozen architectuur en implementatiestrategie. Het omvat API-tokenkosten, vector database-hosting en cloud compute-uitgaven. Het integreren van modellen vereist een dedicated infrastructuurbudget. Een enterprise-inrichting die uitstekende klantervaringen levert, brengt hogere totale uitgaven met zich mee dan eenvoudige pilotprojecten. Het voorspellen van exacte cijfers vereist een grondige analyse van uw verwachte gebruikspatronen.
Individuen hebben gratis toegang tot consumentenapplicaties onder strikte gebruikslimieten. Het implementeren van kunstmatige intelligentie in een echte enterprise-omgeving brengt echter altijd kosten met zich mee. U moet betalen voor API-calls of voor de cloudhardware die nodig is om open-source modellen veilig uit te voeren. Echt gratis gebruik bestaat niet voor hoog-volume contentgeneratie of enterprise-grade generatieve AI-applicaties die een betrouwbare uptime vereisen.
Ja, een enterprise-implementatie vereist een continue betaling. Zelfs bij het gebruik van open-source modellen is het verplicht om te betalen voor de cloudinfrastructuur die nodig is om de model training te hosten en inference uit te voeren binnen uw privé-omgeving. Uw financiële teams moeten budgetteren voor de infrastructuur die uw unieke use case aandrijft, inclusief de data opslag en rekenkracht die nodig zijn om ervoor te zorgen dat de AI-tool goed werkt voor uw bedrijfsdoelen.
Het bouwen van een applicatie varieert van enkele honderden dollars per maand voor een eenvoudige proof of concept tot tientallen duizenden dollars per maand voor robuuste enterprise-systemen. Productie-implementaties vereisen hoog-beschikbare endpoints, real-time vector databases en dedicated platformen voor kostenbeheer om de totale kosten te beheren. Het vooraf opstellen van een solide businesscase helpt bij het verkrijgen van de benodigde financiering voor infrastructuur.
De grootste verborgen kosten zijn onder meer SaaS-leveranciersopslagen op ruwe compute, cloud data egress-kosten en het verlies door onbenutte compute bij provisioned endpoints. Het onderhouden van gefragmenteerde beveiligings- en observability-tools vereist ook een aanzienlijke investering. Het beheren van deze gefragmenteerde factoren is een sleutelfactor om de totale kosten van generatieve AI te beheersen en ervoor te zorgen dat u uw doelstellingen voor kostenoptimalisatie op de lange termijn behaalt.
Organisaties verlagen de kosten van generatieve AI door een AI Gateway te gebruiken om eenvoudige prompts naar goedkopere modellen te leiden, waardoor geavanceerde modellen bewaard blijven voor complexe taken. Het hosten van open-source modellen op cloud Spot Instances met korting voor basisvragen van de klantenservice verbetert het kostenbeheer zonder dat dit ten koste gaat van de gebruikerservaring. Het implementeren van prompt caching vermindert ook dubbele API-calls, wat de totale operationele kosten verlaagt.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















