



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
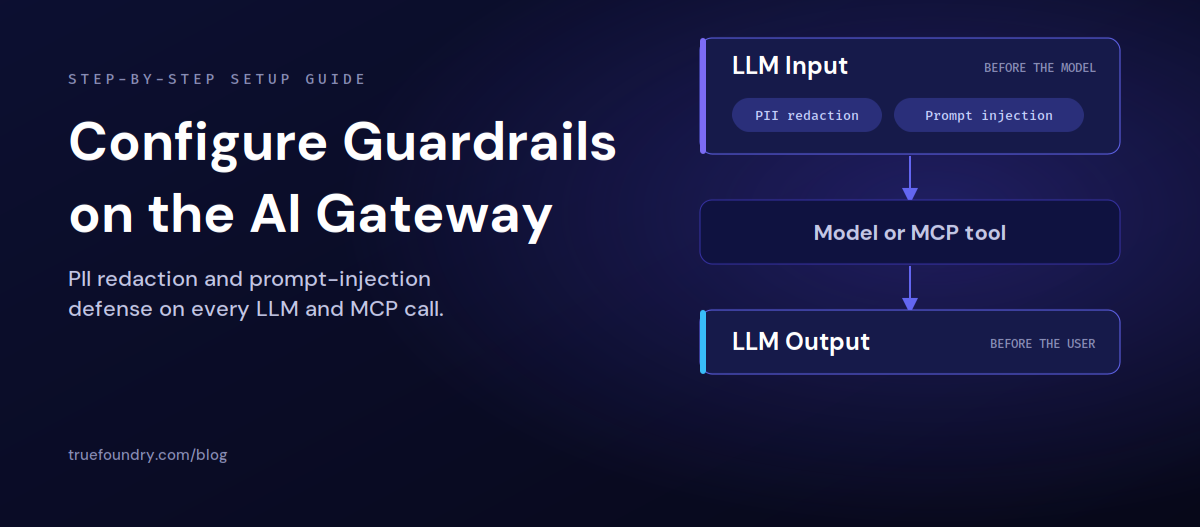
Een kaal model-endpoint zal zonder problemen persoonsgegevens retourneren, een prompt-injection-payload accepteren of een onveilig antwoord geven. Guardrails lossen dit op door verkeer te inspecteren en, waar nodig, te herschrijven voordat het het model bereikt en voordat het antwoord de gebruiker bereikt.
Door guardrails op de AI Gateway te plaatsen, krijgt elke applicatie automatisch dezelfde bescherming, zonder dat elk team de beveiliging opnieuw hoeft te implementeren. TrueFoundry levert ingebouwde guardrails voor PII-redactie en prompt-injection-detectie, beide volledig beheerd zonder dat u API-sleutels van derden hoeft te koppelen.
Zoals de guardrails-documentatie het omschrijft, is het toepassen van guardrails op de AI Gateway een proces van twee stappen.
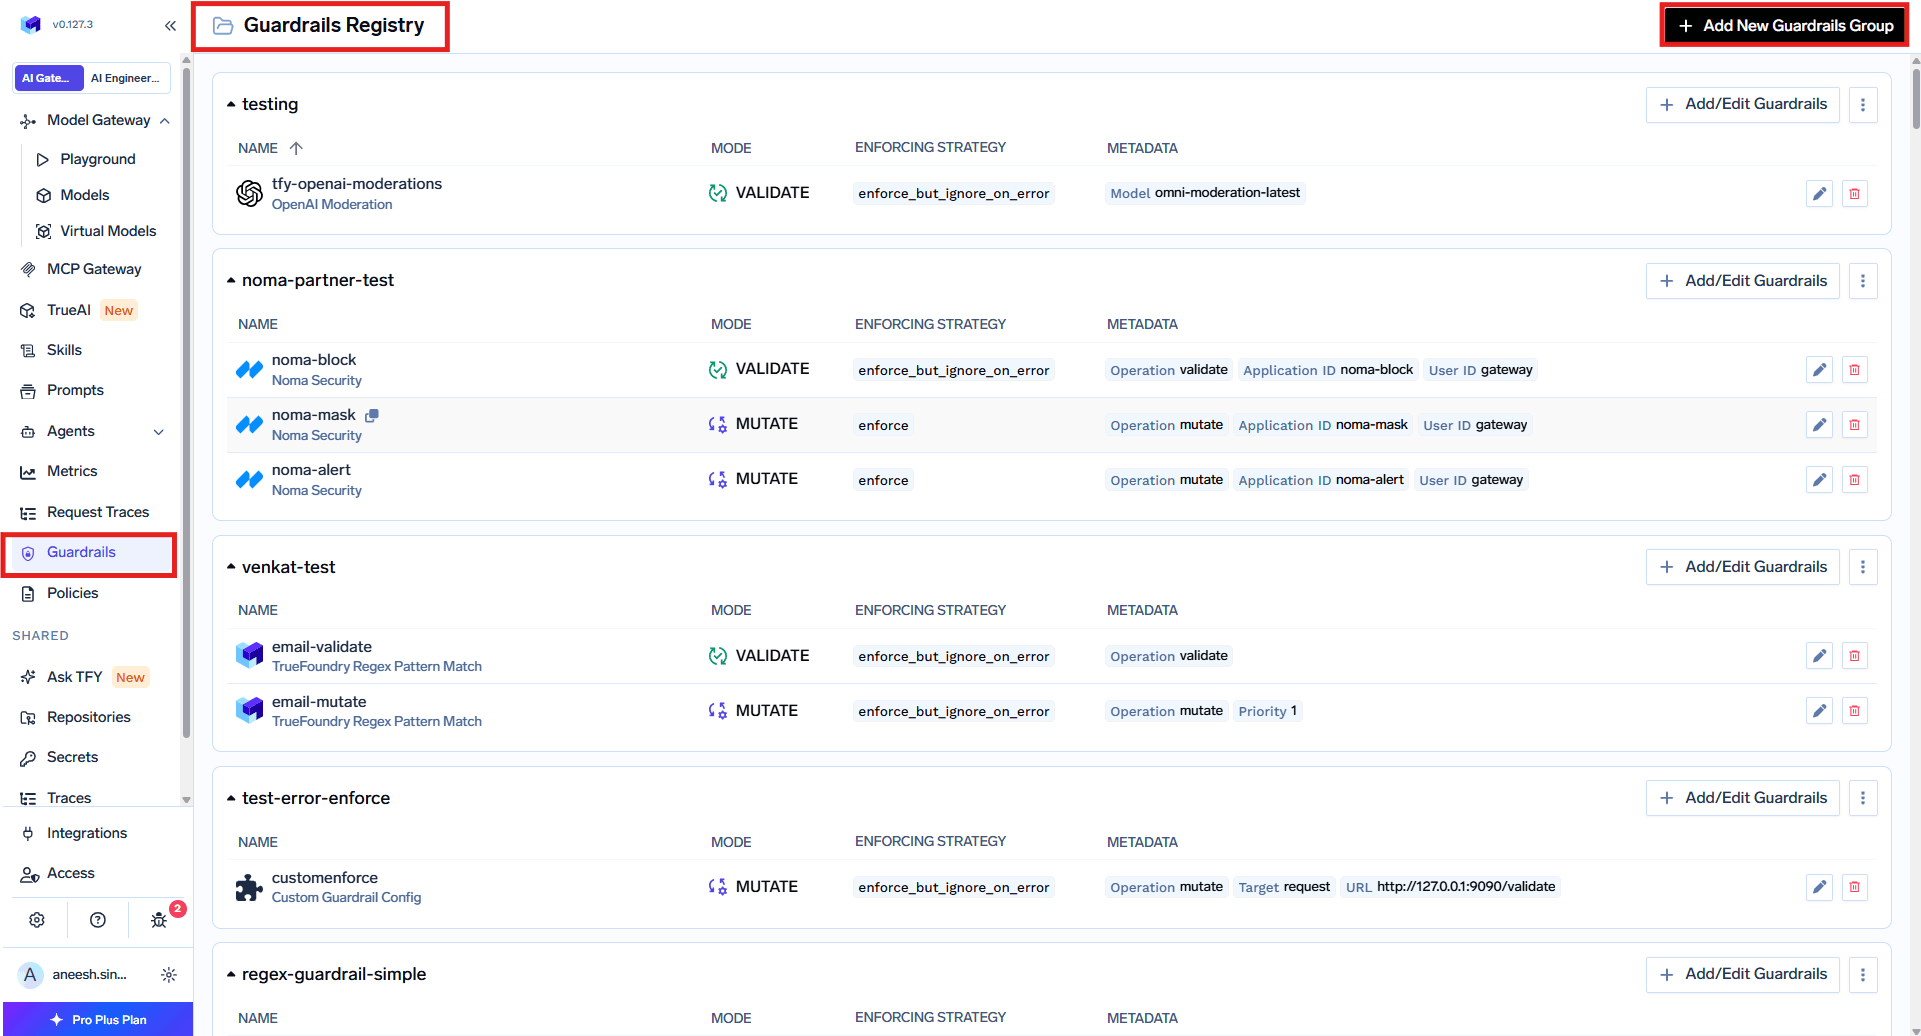
Klik in Policies en vervolgens Guardrails op Add Rule. Elke regel heeft een unieke Rule ID en een aantal secties die bepalen op wie de regel van toepassing is en waar deze wordt uitgevoerd.
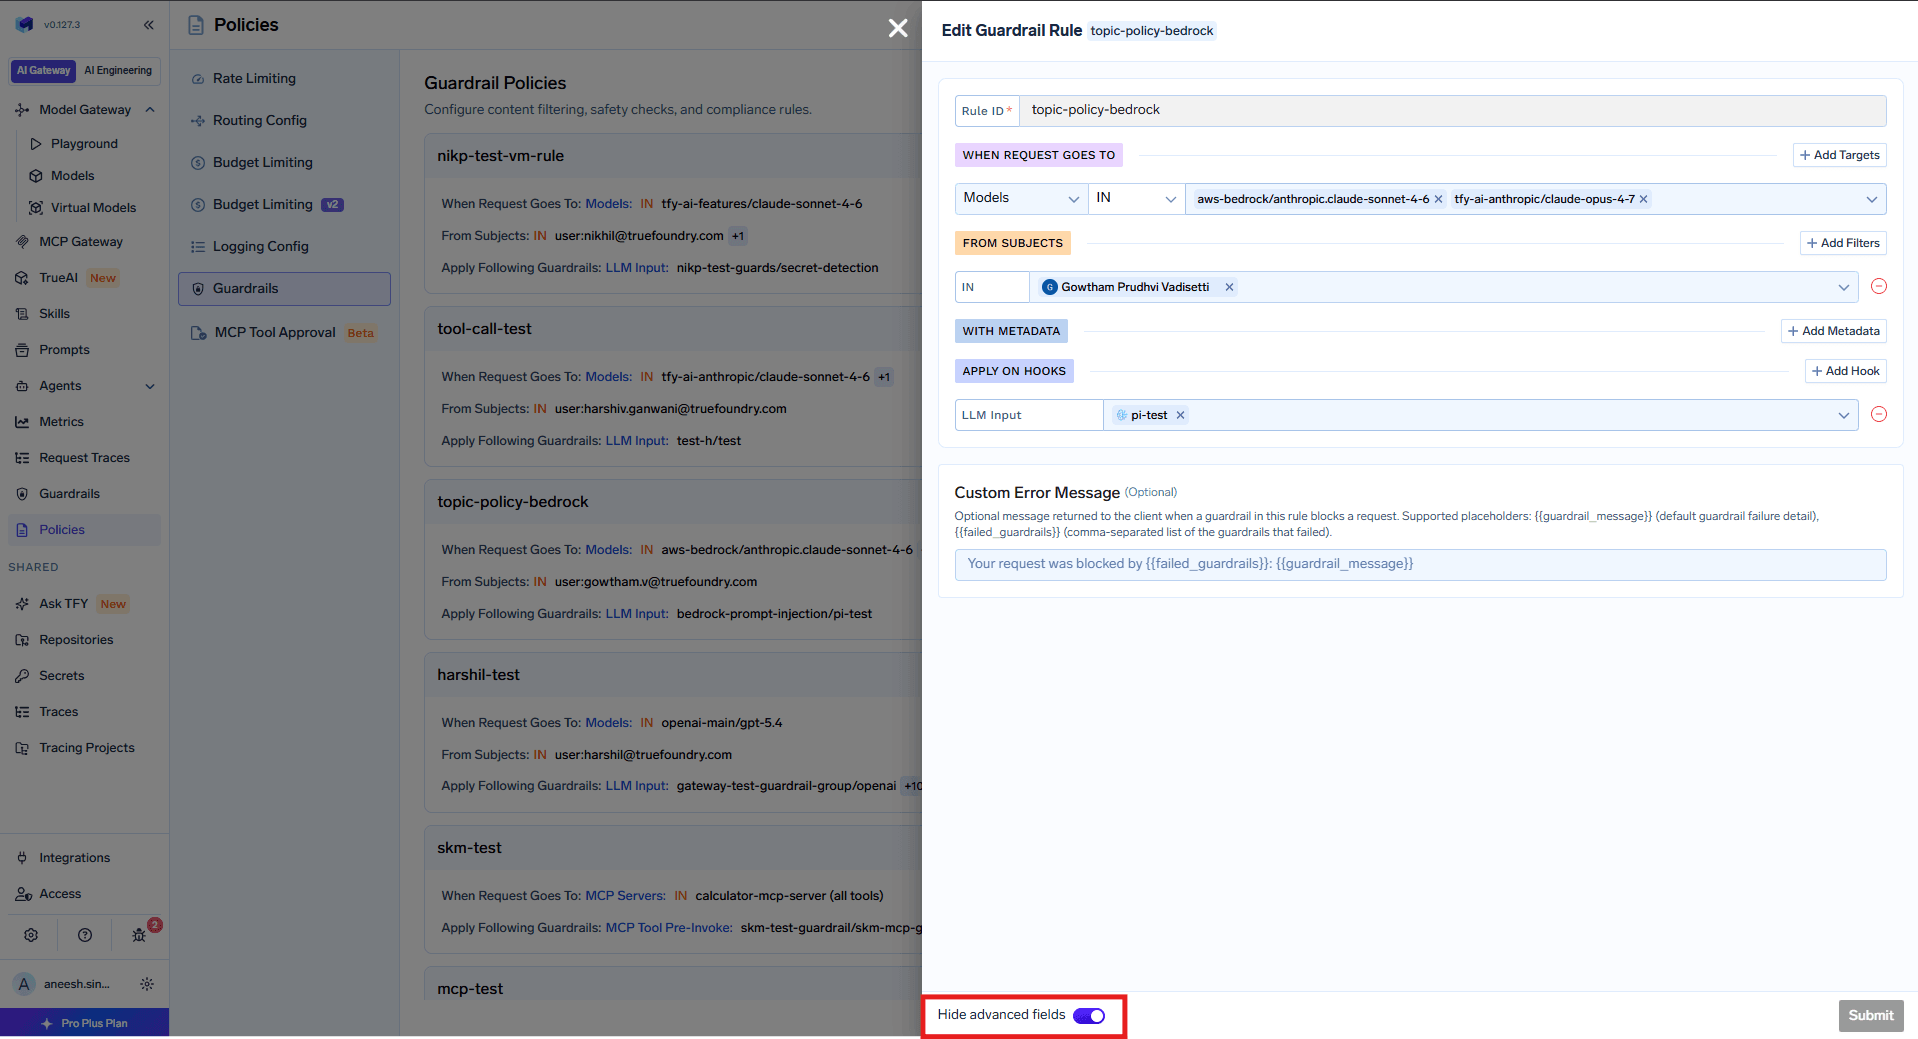
Alle regels worden voor elk verzoek geëvalueerd, en de guardrails van alle overeenkomende regels worden gecombineerd en samen toegepast. Als één regel PII-detectie toepast op LLM Input en een andere regel prompt-injection-detectie toepast op LLM Input, worden ze beide uitgevoerd.
De PII- en PHI-detectie-guardrail is een ingebouwde TrueFoundry-guardrail die persoonlijk identificeerbare informatie en beschermde gezondheidsinformatie identificeert en anonimiseert. Deze wordt onder de motorkap aangedreven door Azure AI Language PII Detection en is volledig beheerd, dus er zijn geen API-sleutels van derden nodig.
Deze ondersteunt alleen de mutate-modus, wat betekent dat gedetecteerde entiteiten altijd worden geanonimiseerd (geredigeerd). In het configuratieformulier stelt u een naam in, kiest u PII-categorieën of behoudt u de standaardinstelling van alle categorieën, en kiest u een handhavingsstrategie. Gedetecteerde waarden worden vervangen door astersken, zodat een telefoonnummer en e-mailadres in een bericht worden gemaskerd voordat het model ze te zien krijgt.
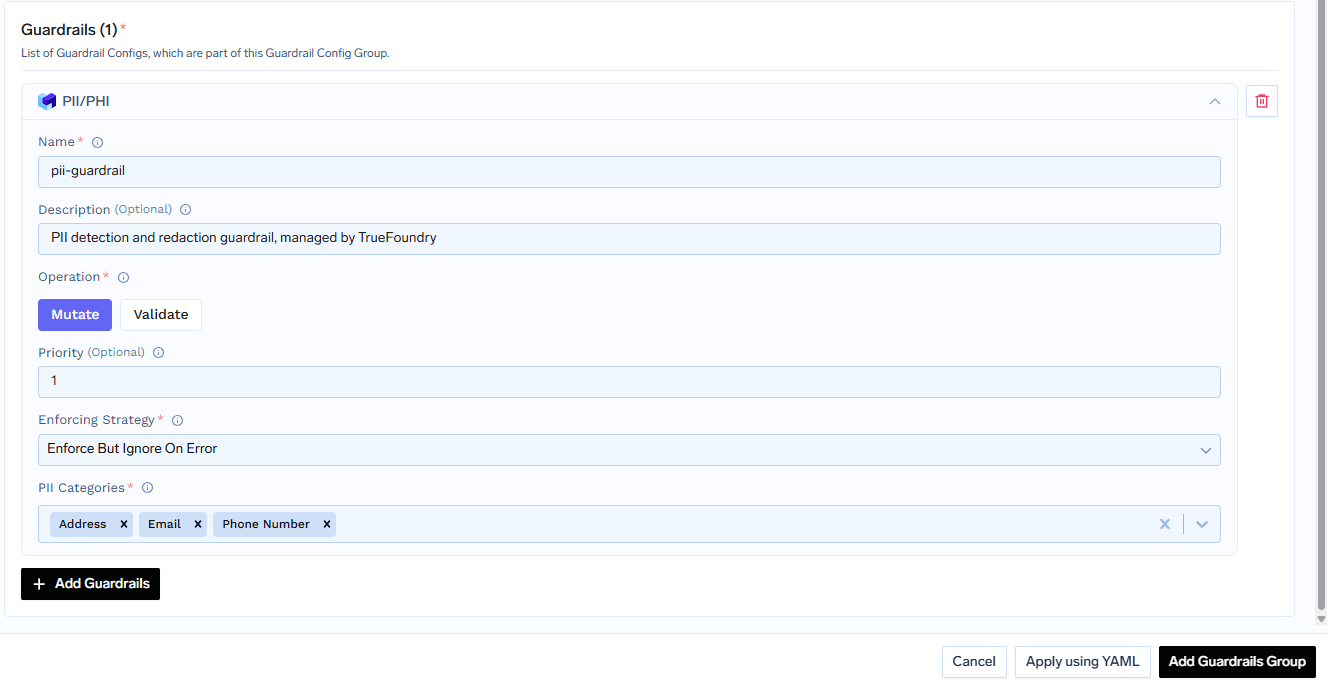
Een gebruikelijke configuratie past PII-redactie toe op LLM Input om gebruikersberichten op te schonen, op LLM Output om antwoorden op te schonen, en op de MCP-hooks om PII te verwijderen uit toolparameters en toolresultaten zoals databaserijen.
De prompt-injection-guardrail is een ingebouwde guardrail die wordt aangedreven door Azure Prompt Shield. Het detecteert directe prompt injection, jailbreak-aanvallen zoals het 'do anything now'-patroon, en indirecte injection die verborgen zit in document- of contextinhoud. Het analyseert de gebruikers-prompt en de documentinhoud afzonderlijk.
Het ondersteunt alleen de validate-modus, wat betekent dat het aanvallen detecteert en blokkeert, maar de inhoud niet wijzigt. De configuratie vraagt alleen om een naam en een handhavingsstrategie. De documentatie raadt aan om te beginnen met de audit-strategie om detecties in request traces te monitoren, en pas over te schakelen op enforce zodra u de configuratie vertrouwt.
Bij een LLM-verzoek worden input mutation-guardrails eerst uitgevoerd en deze blokkeren totdat ze klaar zijn, bijvoorbeeld bij het anonimiseren van PII in de prompt. Input validation, zoals prompt injection, wordt vervolgens op de achtergrond uitgevoerd terwijl het modelverzoek onderweg is. Als de input validation mislukt terwijl het model nog draait, annuleert de gateway het modelverzoek direct, zodat u er niet voor betaalt.
Nadat het model reageert, kan output mutation geheimen strippen, en controleert output validation het eindresultaat voordat het de client bereikt. Voor MCP-tools worden alle pre-tool guardrails uitgevoerd voordat de tool wordt aangeroepen; als er één mislukt, wordt de tool nooit uitgevoerd. Guardrails worden op elke tool-call afzonderlijk uitgevoerd.

TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



TrueFoundry ships built in PII and PHI detection, powered by Azure AI Language, and prompt injection detection, powered by Azure Prompt Shield. Both are fully managed, with no external credentials required. You can also add external providers or custom guardrails.
On four hooks: LLM Input, LLM Output, MCP Tool Pre-Invoke, and MCP Tool Post-Invoke. You attach guardrails to the hooks you want in a policy rule, and multiple guardrails can run on the same hook.
Als invoervalidatie faalt terwijl het modelverzoek onderweg is, annuleert de gateway dat modelverzoek, zodat u er niet voor betaalt. Uitvoervalidatie gebeurt nadat het model heeft geantwoord, dus in dat geval zijn de modelkosten al gemaakt.
Start with the audit enforcing strategy so detections are recorded in request traces without blocking traffic. Once you are confident in the results, switch the strategy to enforce.



Het laatste nieuws, artikelen en bronnen in je inbox



















