



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Het Sonic-3.5 text-to-speechmodel en het Ink-2 streaming speech-to-textmodel van Cartesia integreren met TrueFoundry AI Gateway via een native passthrough-laag. Verzoeken stromen naar Cartesia's /tts/bytes HTTP-endpoint, het /tts/sse server-sent events-stream, de /tts/websocket bidirectionele WebSocket en de Ink streaming WebSocket met behoud van hun originele protocolsemanticus. De gateway voegt de Cartesia API-sleutel toe vanuit zijn centrale credential store, voert toegangsbeheer uit en genereert OpenTelemetry-spans voordat de verbinding wordt doorgestuurd.
Dit artikel legt uit waarom aanbieders van spraak-inference niet hetzelfde OpenAI-compatibele vertaalpatroon kunnen gebruiken dat de gateway toepast op chat completion-aanbieders. Het behandelt hoe het gateway-vlak native passthrough afhandelt binnen de bestaande Hono-verzoekpijplijn. Het behandelt Cartesia's API-oppervlak over zowel TTS als STT. Het behandelt de configuratievorm en de end-to-end datastroom.
De meeste TrueFoundry AI Gateway-integraties werken op basis van een vertaalprincipe. Een verzoek komt in OpenAI-compatibel formaat binnen op /chat/completions, /embeddings of /responses. De gateway herleidt de model-ID naar een provider-endpoint en vertaalt het verzoek via een adapter naar de native vorm van die provider. Anthropic wordt vertaald naar de Messages API. Google Vertex wordt vertaald naar de Generative Language API. Cohere wordt vertaald naar zijn native chat-schema. Het antwoord komt terug en wordt omgekeerd vertaald, zodat de aanroeper een uniforme OpenAI-vorm ziet, ongeacht welke fysieke provider het verzoek heeft afgehandeld.
Dit patroon werkt omdat de semantiek van chat completions bij verschillende providers ongeveer gelijk is. Er is een lijst met berichten, een model-ID, sampling-parameters, een streaming-vlag en een antwoord met tool calls en finish reasons. De verschillen zijn er wel, maar ze zijn klein en kunnen binnen een adapter worden overbrugd.
Spraak-inference past niet in dat profiel. Cartesia's TTS API heeft parameters die geen equivalent hebben in de OpenAI Audio API. Het veld voice accepteert een Cartesia voice ID of een voice embedding. Het blok output_format specificeert container, codering en sample rate als een gestructureerd object. Het veld language kiest uit 42 ondersteunde talen. Het blok __experimental_controls bevat snelheids- en emotieparameters die verwijzen naar de expressieve bedieningselementen van Sonic-3.5. Het WebSocket-protocol introduceert gemultiplexte contexten, flush_id-grenzen en voortzettingssemantiek voor het streamen van tekstinvoer vanaf een upstream LLM. Niets hiervan bestaat in de vorm van OpenAI /v1/audio/speech.
Het Ink-2 STT-pad is vergelijkbaar. Het streaming WebSocket-protocol geeft audioframes in realtime door en zendt tussentijdse en definitieve transcripties uit naarmate het model semantisch zinvolle wisselgrenzen detecteert via native turn-detectie. Het OpenAI /v1/audio/transcriptions-endpoint is een bestandsupload op basis van verzoek-antwoord zonder streaming-tegenhanger in de officiële specificatie.
Het vertalen van dit oppervlak zou leiden tot het verlies van functionaliteit of tot verlieslatende toewijzingen. De gateway stelt Cartesia daarom beschikbaar via native passthrough. De aanroeper blijft de officiële Cartesia Python SDK of een andere Cartesia-client gebruiken met al zijn functies. De gateway bevindt zich in het pad als een grens voor credentials, beleid en observeerbaarheid, en niet als een protocolvertaler.
De TrueFoundry AI Gateway is gebouwd op het Hono-framework. Eén enkele gateway-pod op 1 vCPU en 1 GB RAM verwerkt meer dan 250 RPS met ongeveer 3 ms toegevoegde latentie. Pods zijn stateless, CPU-gebonden en schalen horizontaal naar duizenden RPS. Het gateway-vlak en het controle-vlak zijn gescheiden. Het controle-vlak beheert de configuratie in PostgreSQL en ClickHouse en verspreidt updates via NATS. Gateway-pods cachen die configuratie in het geheugen.
Wanneer een Cartesia-verzoek een gateway-pod bereikt, wordt dezelfde pijplijn voorafgaand aan het doorsturen uitgevoerd als bij chat completions. Het JWT dat bij het verzoek wordt opgegeven, wordt gecontroleerd aan de hand van gecachte openbare IdP-sleutels zonder externe auth-aanroep. Autorisatie wordt gecontroleerd aan de hand van de in-memory kaart van gebruikers naar modellen die NATS gesynchroniseerd houdt. De routinglaag herleidt de model-ID (zoals sonic-3.5 of ink-2) naar de provider-endpoint die voor dat model is geconfigureerd en naar de Cartesia-accountreferenties die in het controle-vlak zijn opgeslagen. De verzoekbody, het pad en de query-parameters worden niet herschreven. Alleen de headers Authorization en X-API-Key worden gestript van het inkomende verzoek en vervangen door de Cartesia API-sleutel uit de beveiligde credential store. De doorgestuurde URL wordt de Cartesia-origin (https://api.cartesia.ai/...) met behoud van het overeenkomstige pad en de methode. De body wordt ongewijzigd doorgestreamd.
Voor de WebSocket-endpoints (wss://api.cartesia.ai/tts/websocket en het Ink streaming-endpoint) voert de gateway een HTTP Upgrade-handshake uit. Nadat de upgrade is geslaagd, onderhoudt de gateway twee WebSocket-verbindingen (één met de client en één met Cartesia) en proxiet hij frames in beide richtingen. Het gemultiplexte contextmodel dat Cartesia biedt, blijft behouden omdat de gateway de frame-payloads niet interpreteert. Een client die één enkele WebSocket opent en tientallen gelijktijdige generaties uitvoert tegen verschillende context_id-waarden, ziet via de gateway hetzelfde gedrag als wanneer hij rechtstreeks met Cartesia zou communiceren.
Het asynchrone pad voor het publiceren van traces dat de gateway gebruikt voor chat completions, werkt ook voor Cartesia-verkeer. De gateway genereert spans voor de inkomende HTTP-handler, de herleiding van referenties en de uitgaande provider-aanroep (of WebSocket-sessie). Voor TTS-verzoeken bevatten deze spans de duur, de status, de herleide modelnaam en een hash van het transcript. Voor STT-sessies legt de span de levensduur van de verbinding en het aantal berichten vast. Spans worden asynchroon gepubliceerd naar NATS nadat het verzoek is voltooid. De OpenTelemetry-exporter leest uit het asynchrone pad en stuurt traces door naar de geconfigureerde backend (gRPC of HTTP). Export is aanvullend en verandert de eigen trace-opslag van de gateway niet. De gateway laat een Cartesia-verzoek nooit mislukken, zelfs niet als het externe OTEL-endpoint onbereikbaar is.
De pijplijn voor het bijhouden van kosten werkt ook in passthrough-modus. Cartesia rekent af op basis van credits, wat zich vertaalt naar gesynthetiseerde tekens voor TTS en getranscribeerde seconden voor STT. De gateway registreert de verzoekgrootte en de metadata over de responstijd en publiceert deze naar dezelfde NATS-eventbus die de kostengegevens van chat completions verzamelt. De aggregator-service berekent totalen per gebruiker, per team en per model die worden weergegeven in het uniforme analytics-overzicht, naast het chatverkeer.
Cartesia bouwt spraakmodellen op basis van een state space model-architectuur. De TTS-familie heet Sonic en het huidige productiemodel is Sonic-3.5. De STT-familie heet Ink en het huidige productiemodel is Ink-2.
Sonic-3.5 is een streaming TTS-model met een time-to-first-audio van minder dan 90 ms en native ondersteuning voor 42 talen. Het staat op #1 voor natuurlijkheid en spreekt alfanumerieke gegevens zoals telefoonnummers, ID's en e-mails correct uit zonder voorverwerking, terwijl Engelse heteroniemen zoals read en bass correct worden verwerkt op basis van de omringende context. Het biedt verfijnde bediening van volume, snelheid en emotie via API-parameters en SSML-tags. Het model is beschikbaar via drie endpoint-vormen die geschikt zijn voor verschillende toepassingen.
De eerste is POST /tts/bytes. Dit is een synchroon batch-endpoint dat het gehele audiobestand in de responsbody retourneert. Het accepteert MP3-, WAV- of ruwe PCM-uitvoerformaten en is geschikt voor het vooraf genereren van audio-assets waarbij de volledige wachttijd op het complete resultaat acceptabel is.
De tweede is POST /tts/sse. Dit is een server-sent events-stream. Het model zendt audiochunks stapsgewijs uit naarmate ze worden gegenereerd. Dit is geschikt voor toepassingen die audio stapsgewijs afspelen en het voordeel van een snelle time-to-first-byte nodig hebben, maar geen invoertekst in het model hoeven te streamen.
De derde is WSS /tts/websocket. Dit is het aanbevolen endpoint voor realtime spraak-agents. De verbinding is bidirectioneel en ondersteunt gemultiplexte generaties via het veld context_id. Één enkele open WebSocket kan tientallen gelijktijdige generaties verwerken. De context_id maakt voortzettingsgeneratie mogelijk waarbij extra tekstsegmenten in een bestaande context kunnen worden ingevoerd om de prosodie over de overgangen heen te behouden. Dit is van belang wanneer de upstream tekstbron een LLM is die token voor token streamt en de TTS het ritme van de tekstgeneratie moet volgen. Het WebSocket-protocol ondersteunt ook handmatig leegmaken via flush_id-markeringen, die discrete audiogrenzen creëren binnen één enkele context.
Ink-2 is een streaming STT-model dat vanaf de grond is opgebouwd voor productie-spraak-agents. Het biedt de laagste word error rate en de beste turn-detectie van alle streaming STT's en transcribeert gestructureerde gegevens zoals telefoonnummers, datums en e-mails nauwkeurig bij de eerste poging. De bepalende functie is native turn-detectie. Ink-2 weet wanneer een spreker begint en stopt zonder dat er een afzonderlijke VAD nodig is, en zendt een volledige levenscyclus van turn-events uit (turn.start, turn.update, turn.eager_end, turn.resume en turn.end) zodat de agent precies weet wanneer hij moet luisteren, denken en reageren. Semantische endpointing bepaalt het einde van een beurt op basis van betekenis in plaats van stilte, zodat een pauze halverwege een gedachte de agent niet voortijdig activeert, terwijl turn.eager_end de downstream LLM een voorsprong geeft voordat de beurt definitief als voltooid is bevestigd. Het endpoint is een streaming WebSocket die PCM-audioframes op 16 kHz accepteert en tussentijdse en definitieve transcripties uitzendt naarmate het model deze vastlegt. De standaard audiocodering is pcm_s16le op 16000 Hz.
Cartesia verbreekt WebSocket-verbindingen na 3 minuten inactiviteit. De timeout wordt gereset bij elk frame dat in een van beide richtingen wordt verzonden. Clients voeren doorgaans op stilte gebaseerde keepalives uit om de verbinding open te houden tijdens pauzes in de spraak.
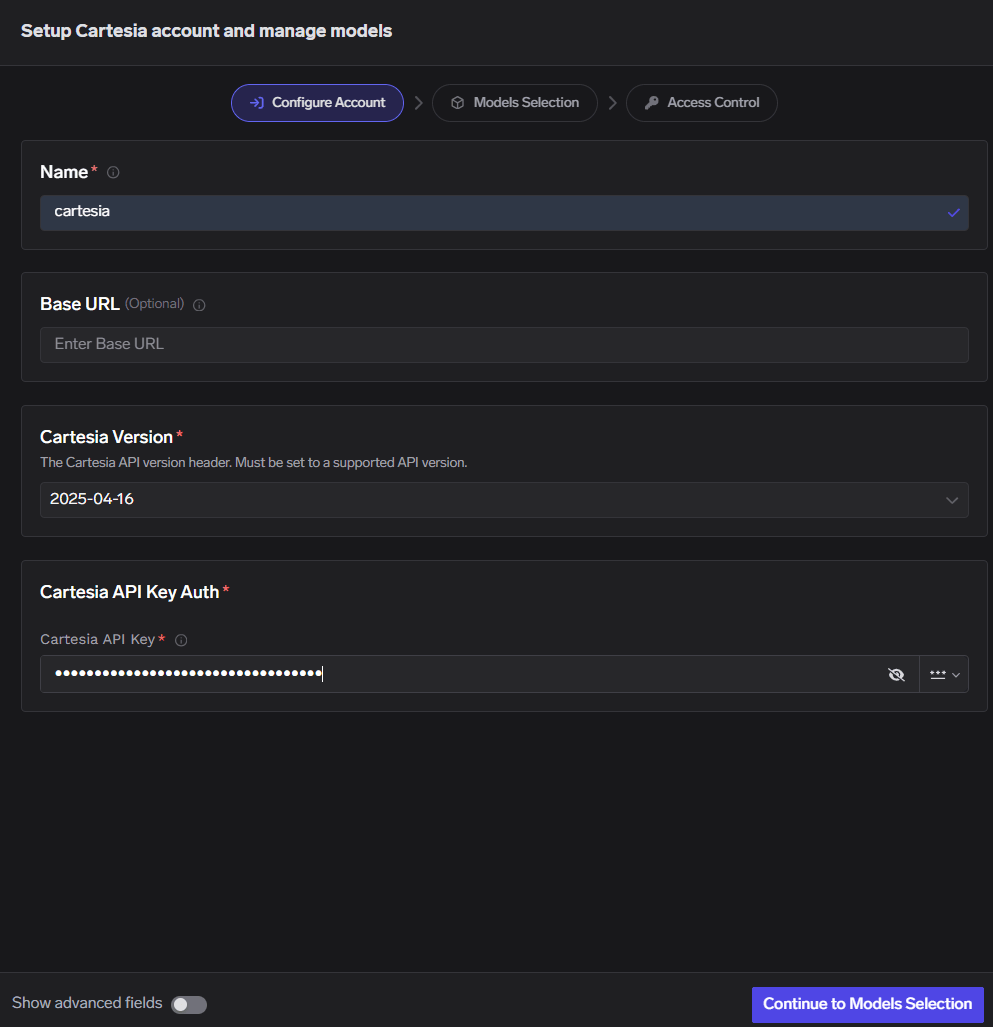
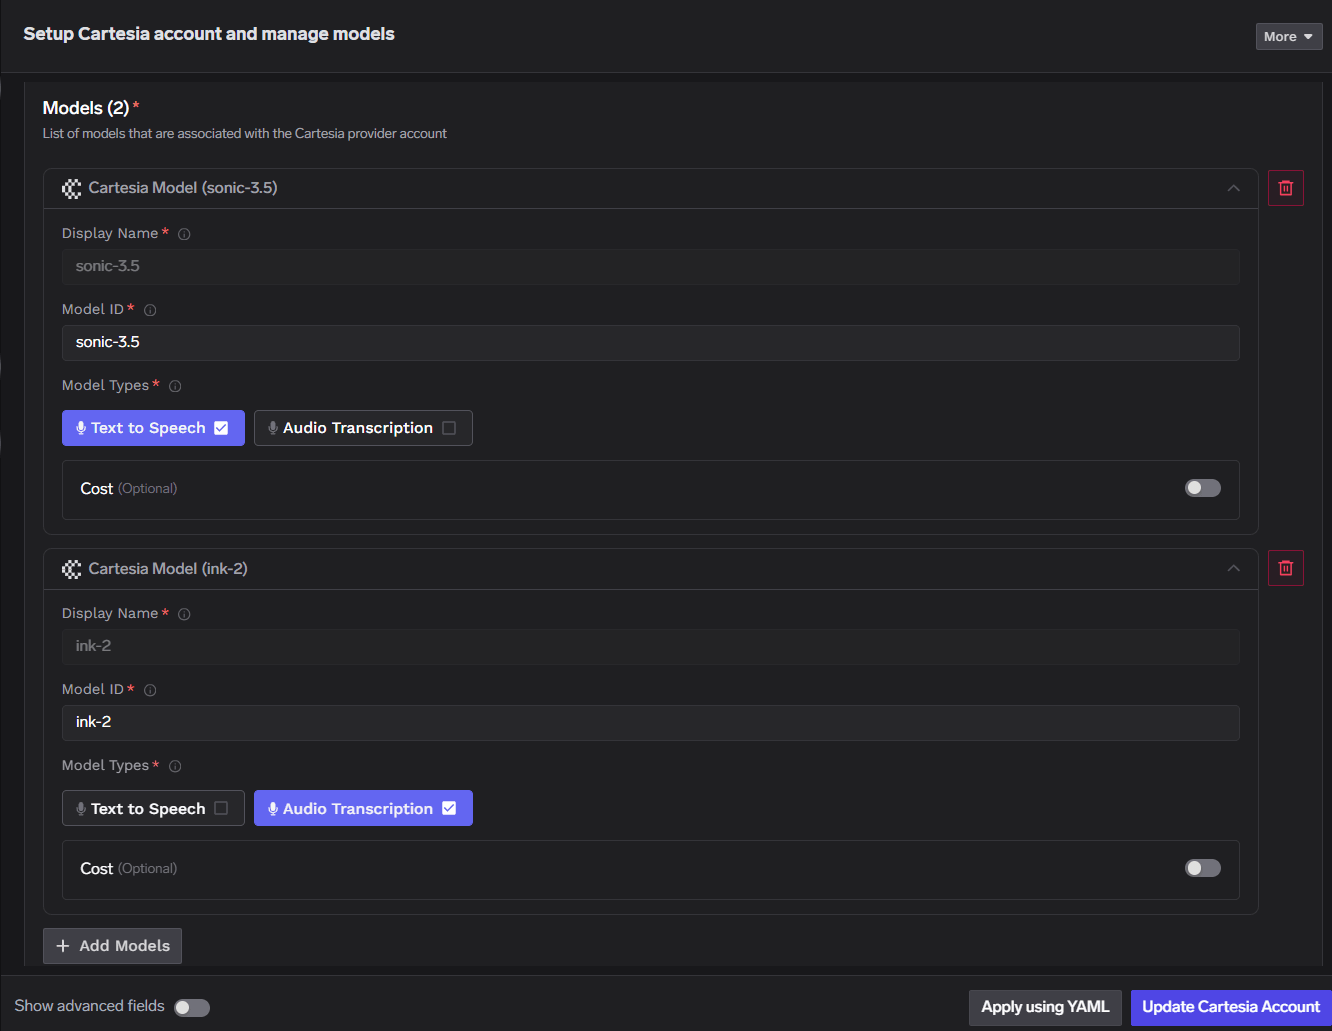
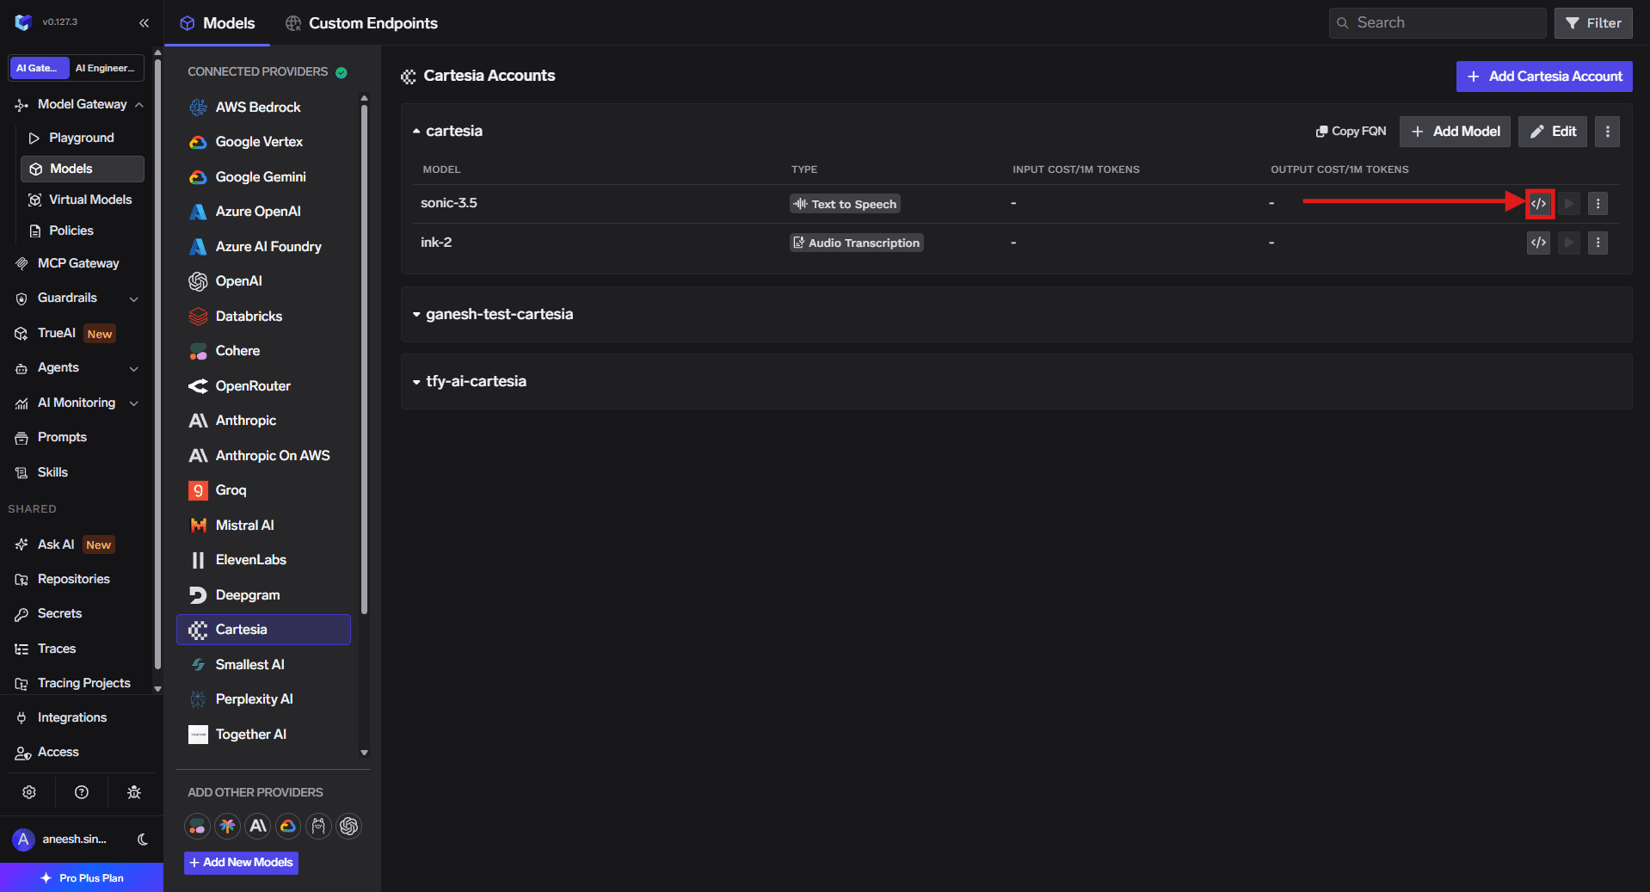
Het toevoegen van Cartesia aan TrueFoundry AI Gateway gebeurt in drie stappen in het dashboard. Navigeer naar AI Gateway en vervolgens naar Models en selecteer Cartesia. Voeg een Cartesia-account toe door een unieke accountnaam en de Cartesia API-sleutel in te voeren. De sleutel wordt versleuteld opgeslagen in het controle-vlak en wordt nooit rechtstreeks aan de gateway-pods getoond. Voeg optioneel medewerkers toe, waarmee wordt beheerd welke gebruikers en teams verkeer via dit account kunnen routeren. Registreer vervolgens een of meer modellen door te klikken op Add Model en een Display name, een Model ID en een Model type op te geven. Voor Cartesia moeten de Model ID en Display name identiek zijn en exact overeenkomen met de model-ID van Cartesia (sonic-3.5, ink-2 enzovoort).
Het configuratie-oppervlak voor een Cartesia-account is eenvoudig.
Inference maakt gebruik van de native Cartesia SDK waarbij de gateway-URL is ingevuld als de base-URL. Een Python-client ziet er als volgt uit:
Delfde SDK-aanroepen werken voor het WebSocket-endpoint en voor de Ink-2 STT WebSocket. Het door TrueFoundry uitgegeven JWT vervangt de Cartesia API-sleutel in de SDK-configuratie. De SDK 'denkt' dat hij rechtstreeks met Cartesia communiceert omdat de gateway de URL-paden en de antwoordvormen behoudt. Kosten, toegangsbeheer en tracing vinden allemaal onzichtbaar plaats in het verzoekpad.
De end-to-end datastroom is overzichtelijk. Een client opent een HTTP-verzoek of een WebSocket naar de gateway-URL met behulp van de Cartesia SDK. De gateway-pod authenticeert het JWT aan de hand van gecachte openbare IdP-sleutels en herleidt de model-ID naar het geconfigureerde Cartesia-account. Hij stript de inkomende auth-header en vervangt deze door de Cartesia API-sleutel uit de credential store. Hij stuur het verzoek door of upgradet de WebSocket naar https://api.cartesia.ai. Voor WebSocket-sessies overbrugt hij frames in beide richtingen totdat een van de zijden de verbinding sluit. Nadat het verzoek is voltooid, publiceert de gateway een span naar NATS, die de OTEL-exporter en de kosten-aggregator van gegevens voorziet.
Wat niet nodig is, is essentieel. Er is geen fork van de Cartesia SDK. Er is geen schaduwvertaallaag die TTS-parameters platslaat naar de OpenAI Audio-vorm en daarbij de voice ID en het streaming contextmodel verliest. Er is geen afzonderlijke trace-pijplijn voor spraakverkeer en een andere voor chatverkeer. Er is geen API-sleutel per dienst die over de applicatiecode is verspreid. Er is geen WebSocket-terminator aan de clientzijde die afzonderlijk moet worden ingezet om toegangsbeheer toe te passen op de streaming-endpoints.
Het architectonische principe dat dit mogelijk maakt, is de scheiding tussen protocolsemantiek en governance-semantiek. Het Cartesia-protocol bevat spraakdomein-betekenis die zich niet eenvoudig laat generaliseren naar andere providers. De governance-laag (authenticatie, autorisatie, het invoegen van referenties, observeerbaarheid en het bijhouden van kosten) is provider-onafhankelijk en kan worden uitgevoerd voor elke HTTP- of WebSocket-origin zonder de payload te inspecteren. Native passthrough behoudt het eerste terwijl het tweede wordt toegepast. Het resultaat is dat Cartesia's volledige functionaliteit (Sonic-3.5's contexten, voortzettingen en emotiebediening, en Ink-2's streaming transcriptiestroom) beschikbaar is voor clients, terwijl de operationele garanties die de rest van de AI Gateway biedt voor chatverkeer, ook gelden voor spraakverkeer op dezelfde gateway-pods met hetzelfde controle-vlak en dezelfde trace- en kosten-backends.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















