



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
We hebben allemaal wel dat moment meegemaakt met ChatGPT’s Code Interpreter (nu "Advanced Data Analysis"). Je uploadt een rommelig CSV-bestand, vraagt om "de datums te corrigeren en de trend te plotten", en kijkt vol bewondering hoe het in real-time Python-code schrijft en uitvoert.
Het is een superwapen voor productiviteit. Het is ook een enorm beveiligingsrisico als je met gevoelige data werkt.
Het moment dat je die CSV uploadt, verlaat deze je perimeter. Voor ons team was het doel om deze "OpenCode"-functionaliteit te dupliceren – onze LLM-agents de mogelijkheid geven om code te schrijven en uit te voeren – zonder de risico's van datalekkage. We wilden geen "black box"-API; we hadden een Private Code Interpreter nodig waar de compute plaatsvindt naast de data.
Zo hebben we veilige Tool Usage en code-uitvoering geïmplementeerd met behulp van de infrastructuurcomponenten van TrueFoundry.
"OpenCode" draait niet alleen om het hebben van een model dat Python kan schrijven. Het vereist drie afzonderlijke componenten die in harmonie samenwerken:
De meeste mensen lopen vast op "De handen." Je kunt een LLM niet zomaar os.system('rm -rf /') laten uitvoeren op je productiecluster. Je hebt een sandbox nodig.
TrueFoundry meent dit op door ons tijdelijke uitvoeringsomgevingen (Services of Jobs) te laten implementeren die fungeren als de sandbox. De LLM Gateway beheert de tool usage-definities, en de daadwerkelijke uitvoering vindt plaats in een afgeschermde container binnen onze VPC.
Hier is de workflow van hoe een gebruikersverzoek verandert in veilige code-uitvoering.
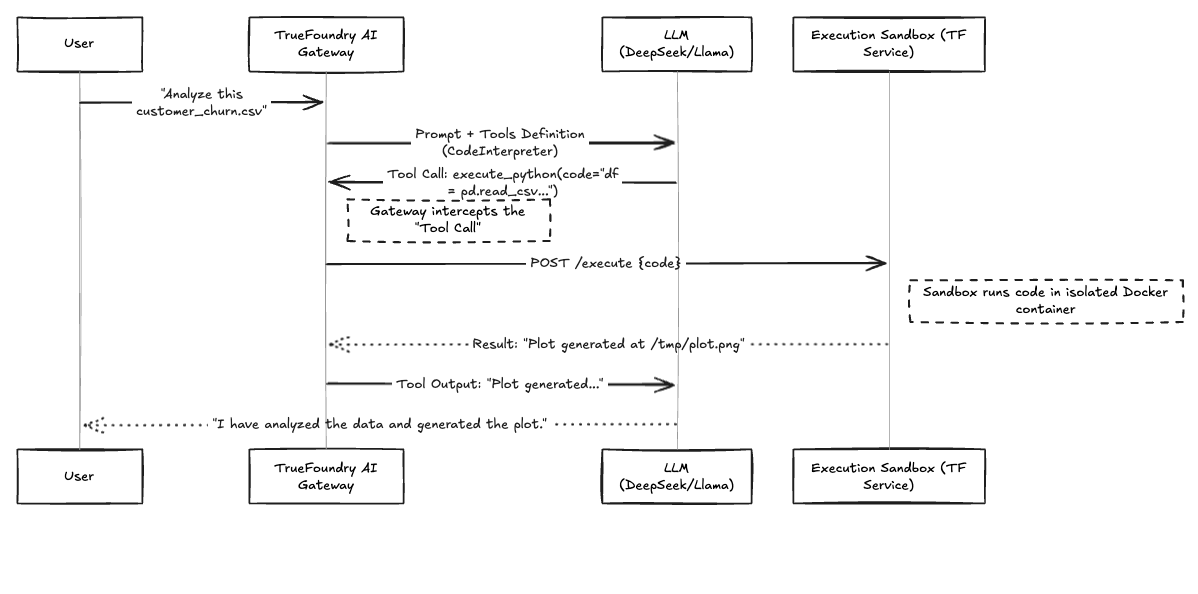
Fig 1: Workflow van de OpenCode-uitvoeringslus
Toen we dit voor het eerst probeerden te bouwen, onderschatten we de complexiteit van de uitvoeringsomgeving. Als je een standaard SaaS Code Interpreter API gebruikt, stuur je je data naar hen op. Als je het lokaal uitvoert, riskeer je de host te compromitteren.
We gebruiken TrueFoundry Services om een custom "Code Execution Agent" te hosten. Dit is in feite een Python FastAPI-service verpakt in een Docker-container die beschikt over:
Omdat TrueFoundry het onderliggende Kubernetes-manifest beheert, kunnen we deze beveiligingsbeperkingen (SecurityContext, NetworkPolicies) rechtstreeks vanuit de deployment-UI of Terraform injecteren, zodat de sandbox echt een sandbox is.
De afweging is altijd gemak vs. controle geweest. Door TrueFoundry in te zetten om het "OpenCode"-patroon te orchestreren, verschuiven we de balans. We krijgen het gemak van een beheerde deployment zonder het datarisico.
Tabel 1: Dit is het voorbeeld van de vergelijking tussen Gateway en Sandbox
De echte kracht komt vrij wanneer je Tool Usage combineert met je interne API's.
We hebben de TrueFoundry LLM Gateway zo geconfigureerd dat deze niet alleen de "Python Interpreter"-tool beschikbaar stelt, maar ook tools voor onze interne datalake (bijv. get_user_churn_metrics(user_id)).
Omdat de LLM via de Gateway routeert, en de Gateway is verbonden met onze privédiensten, kan het model nu:
Dit alles gebeurt zonder dat er één byte aan klantgegevens ons privé-subnet verlaat.
Het implementeren van "OpenCode" is niet langer zomaar een leuk hackathon-project; het is een vereiste voor moderne AI-agents. Maar je kunt het niet zomaar in elkaar flansen met LangChain en het beste ervan hopen.
Wij behandelen onze Code Interpreter als kritieke infrastructuur. We monitoren deze met TrueFoundry’s observability stack – waarbij we niet alleen de LLM-tokens bijhouden, maar ook de CPU-pieken in de sandbox en de uitvoeringslatentie. Als een gebruiker een script schrijft dat probeert 50 GB RAM toe te wijzen, beëindigt TrueFoundry de pod voordat deze het cluster beïnvloedt, en krijgt de gebruiker een vriendelijke foutmelding.
Dat is het verschil tussen een demo en een platform.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















