



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Bifrost verschijnt op bijna elke "AI gateway" shortlist in 2026, meestal naast de woorden snelste en open source. Geen van beide claims houdt stand bij een directe lezing van de eigen cijfers van de leverancier, dus hebben we het op de harde manier gecontroleerd: zelf gebenchmarkt op een afgeschermde 1 vCPU box.
Dit artikel behandelt in hoeverre de prestatieclaims van Bifrost standhouden onder echte metingen — op een vaste 1 vCPU / 2 GB opstelling, dezelfde standaard die we hanteren voor elke gateway in deze vergelijking.
Dit is het gedeelte waarop elke "snelste gateway"-claim zich moet verantwoorden.
Het getal van de leverancier: ~5.000 RPS bij ~11 microseconden gemiddelde overhead — op een t3.xlarge (4 vCPU), tegen een gemockte upstream. Voordat je dat met wat dan ook vergelijkt, lees wat het daadwerkelijk meet. Volgens de eigen bron van Bifrost is het cijfer in microseconden gemeten zonder HTTP request-afhandeling en JSON-marshalling — het is dus tijd doorgebracht binnen de interne pipeline van de gateway, niet de netto latency die wordt toegevoegd aan de request van een aanroeper. Dezelfde bron stelt het op 59 µs op een t3.medium, dus het verslechtert al ruimschoots 5x op een kleinere box. Het is ook een gemiddelde, geen percentiel, op 4x de rekenkracht die de meeste teams daadwerkelijk aan een gateway-container toewijzen.
Niets daarvan maakt het getal oneerlijk; het beantwoordt gewoon een andere vraag dan "hoe ziet mijn p99 eruit?" Alles hieronder is het andere getal: end-to-end toegevoegde latency voor echte, gedocumenteerde payload-groottes, inclusief marshalling en HTTP — de volledige heffing die een aanroeper betaalt omdat de gateway zich in het pad bevindt. Microseconden en milliseconden zijn hier beide waar, omdat ze verschillende dingen meten.
We hebben een vaste testopstelling gebouwd — 1 vCPU, 2 GB RAM, open-loop belasting, dezelfde standaard die we hanteren voor elke gateway in deze vergelijking — en Bifrost rechtstreeks gemeten, over drie payload-groottes: klein (200 input / 100 output tokens), middelgroot (2.000/500) en groot (20.000/1.000). De mock upstream achter Bifrost was ook vastgezet, dus elke vertraging is aan Bifrost te wijten, niet aan een onbetrouwbare test-double: 50 ms "denktijd" + 50 ms tot het eerste token voor niet-streaming calls, en een vaste streamingduur van 500 ms voor streaming calls — dat zijn de ondergrenzen van ~55 ms en ~530–627 ms die je in de onderstaande grafieken ziet, aanwezig bij elke payload-grootte.
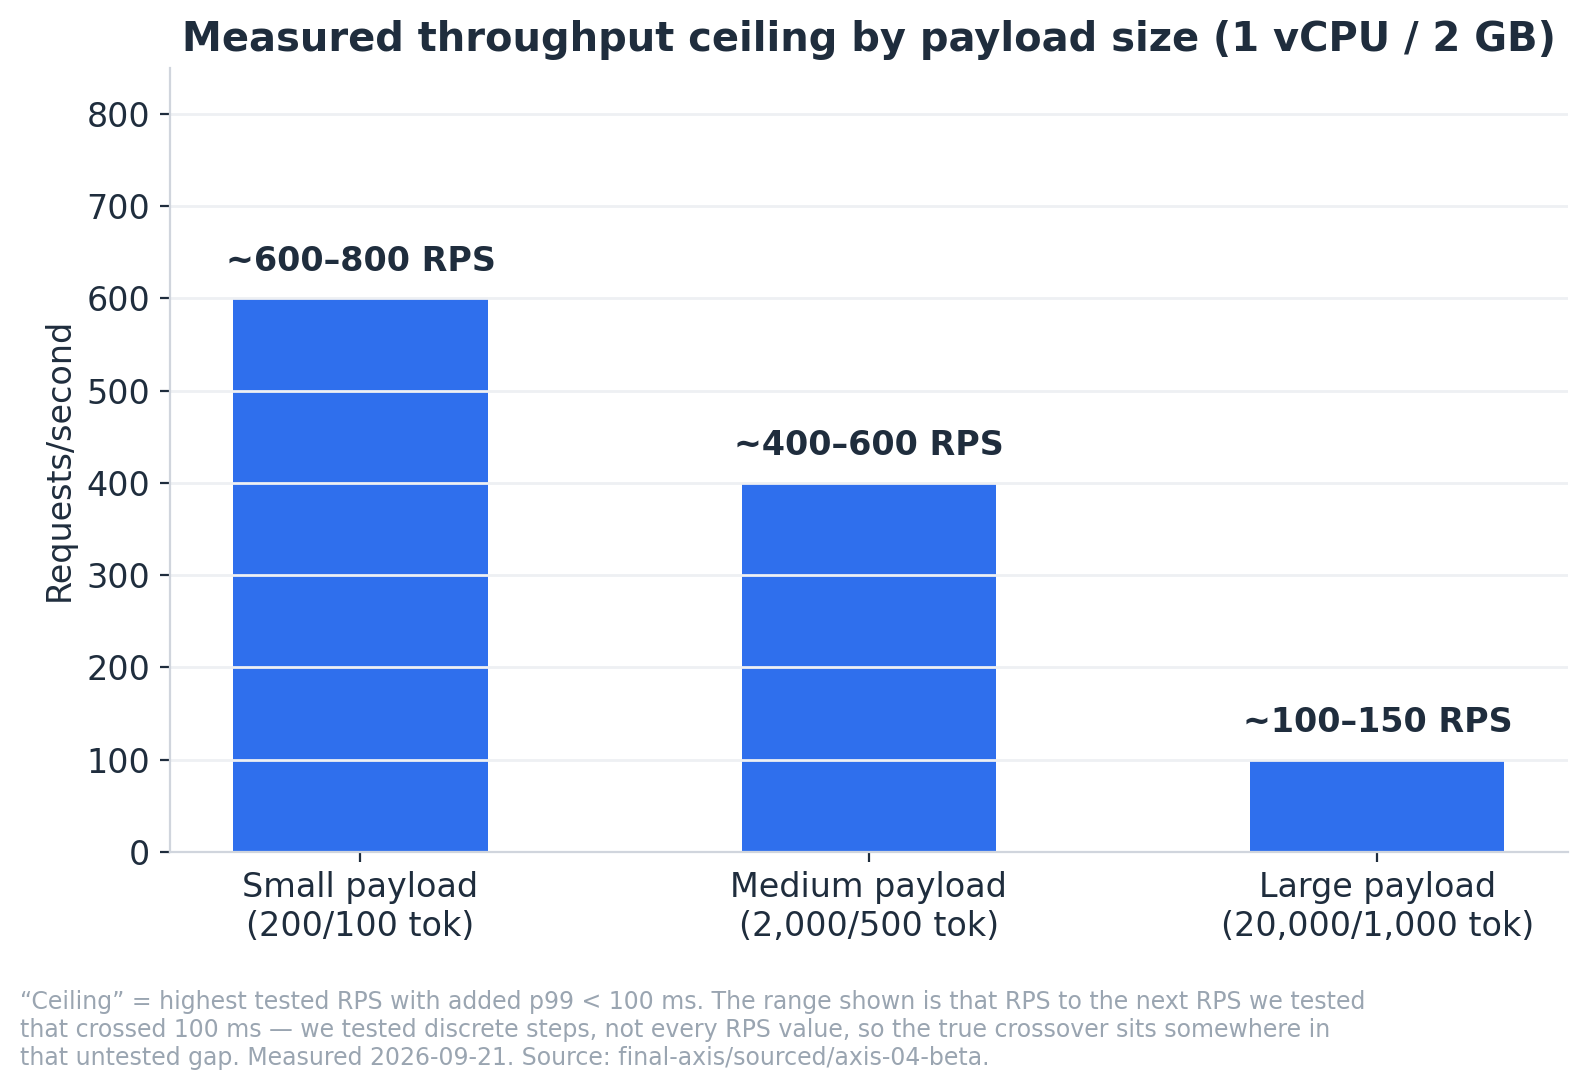
Echte throughput-plafonds, bij een budget van 100ms toegevoegde latency: ~600–800 RPS voor kleine payloads, ~400–600 voor middelgrote, ~100–150 voor grote. Dat zijn bewust bereiken en geen exacte getallen — we hebben discrete RPS-stappen getest, niet elke waarde, dus elk plafond is eigenlijk "de laatste RPS waarvan we hebben bevestigd dat deze goed was, tot de volgende waarvan we hebben bevestigd dat deze dat niet was." Onder het lage uiteinde van die bereiken betaalt de mediane request 2–6 ms voor de gateway. Die mediaan is het meest gunstige getal in deze sectie en het minst nuttige voor capaciteitsplanning: het beweegt nauwelijks met de belasting — 2,1 tot 3,1 ms voor klein over een 60x bereik van aangeboden verkeer — dus het blijft geruststellend tot het punt waarop de gateway omvalt. Het getal dat daadwerkelijk beweegt is de p99. Toegevoegde p99 stijgt van +5,6 ms (klein), +7,5 ms (middelgroot) en +15,2 ms (groot) bij 10 RPS naar +60 ms voor klein bij 600 RPS, +75 ms voor middelgroot bij 400, en +41 ms voor groot bij slechts 100 — en overschrijdt vervolgens het budget van 100 ms bij de allervolgende stap die we in alle drie de gevallen hebben getest. Boven het hoge uiteinde degradeert geen van de drie payload-groottes gecontroleerd, en elke grootte breekt op een andere manier. Hier is elke payload naast elkaar, de gateway vergeleken met zijn eigen echte direct-to-mock meting (geen enkele globale referentie die over groottes wordt gedeeld — klein, middelgroot en groot hebben elk een werkelijk verschillende directe ondergrens van ~55–62 ms, en de grafiek toont het werkelijke getal voor elk):
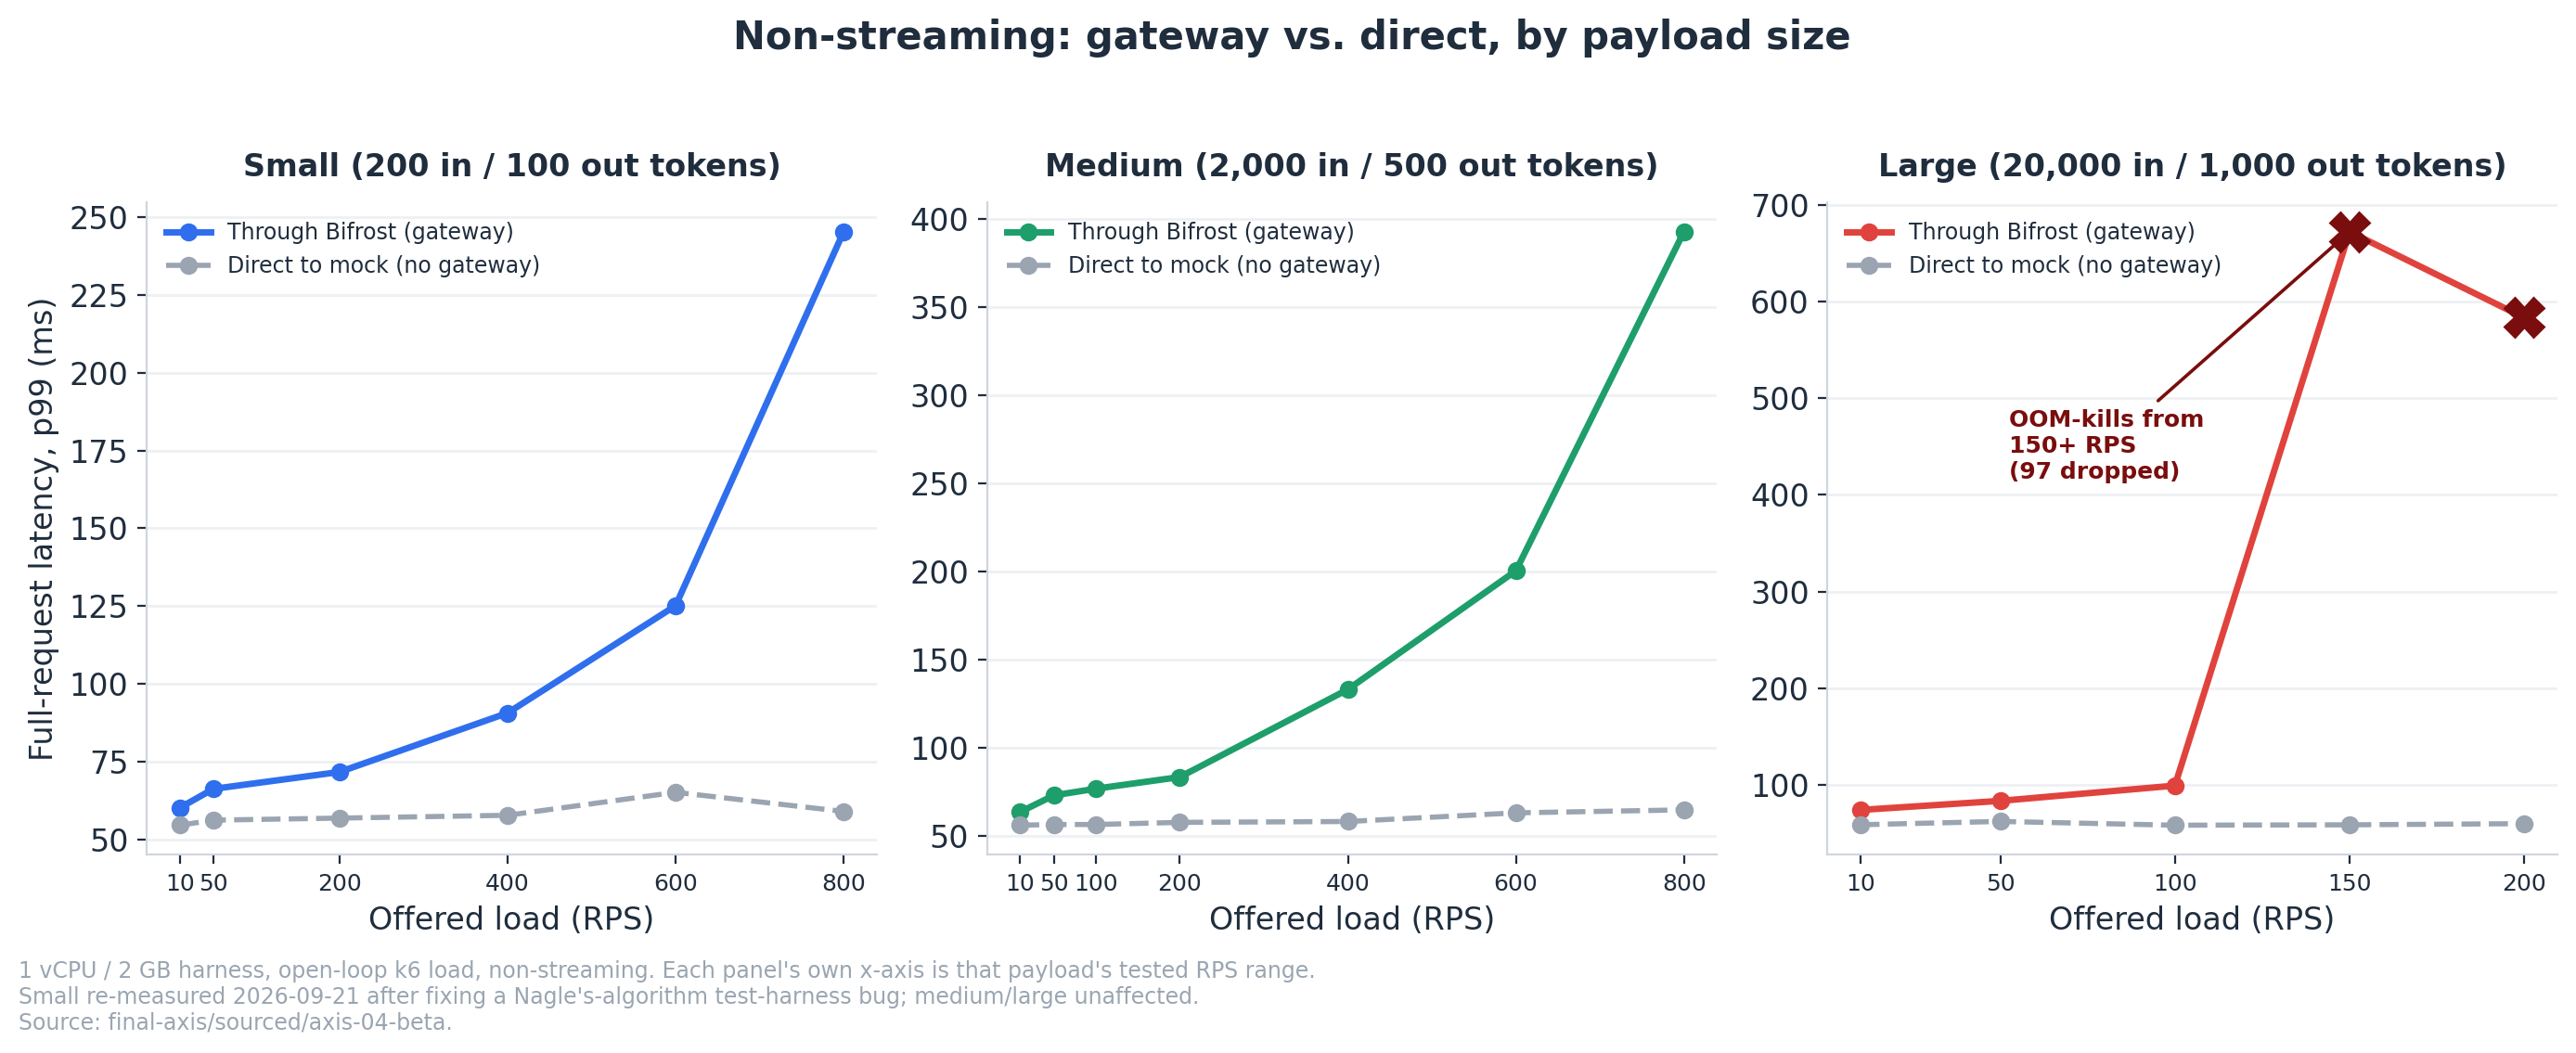
Klein en middelgroot volgen dezelfde vorm — vlak, en dan een stijgende p99-tail — alleen bij een verschillende RPS. De stijging van klein begint rond 400–600 RPS; die van middelgroot begint eerder per request, maar de hardere muur ligt verderop (400+ RPS) omdat de 2.000-token input de kosten per request gedurende het hele proces hoger houdt. Groot stijgt helemaal niet geleidelijk: het is vlak van 10 tot 100 RPS, en valt dan van een klif bij 150 RPS, waar de pod halverwege de run OOM-killed wordt (61 geweigerde requests bij 150 RPS, 97 meer bij 200). Dat is geen queuing-Knik zoals bij klein/middelgroot — het is een harde bronnenmuur, en het verschijnt als een vrijwel verticale sprong in plaats van een curve.
Streaming raakt dezelfde muur, alleen sneller, omdat elke open stream zijn buffers langer in het geheugen vasthoudt — dezelfde behandeling, gateway vs. direct, per payload:
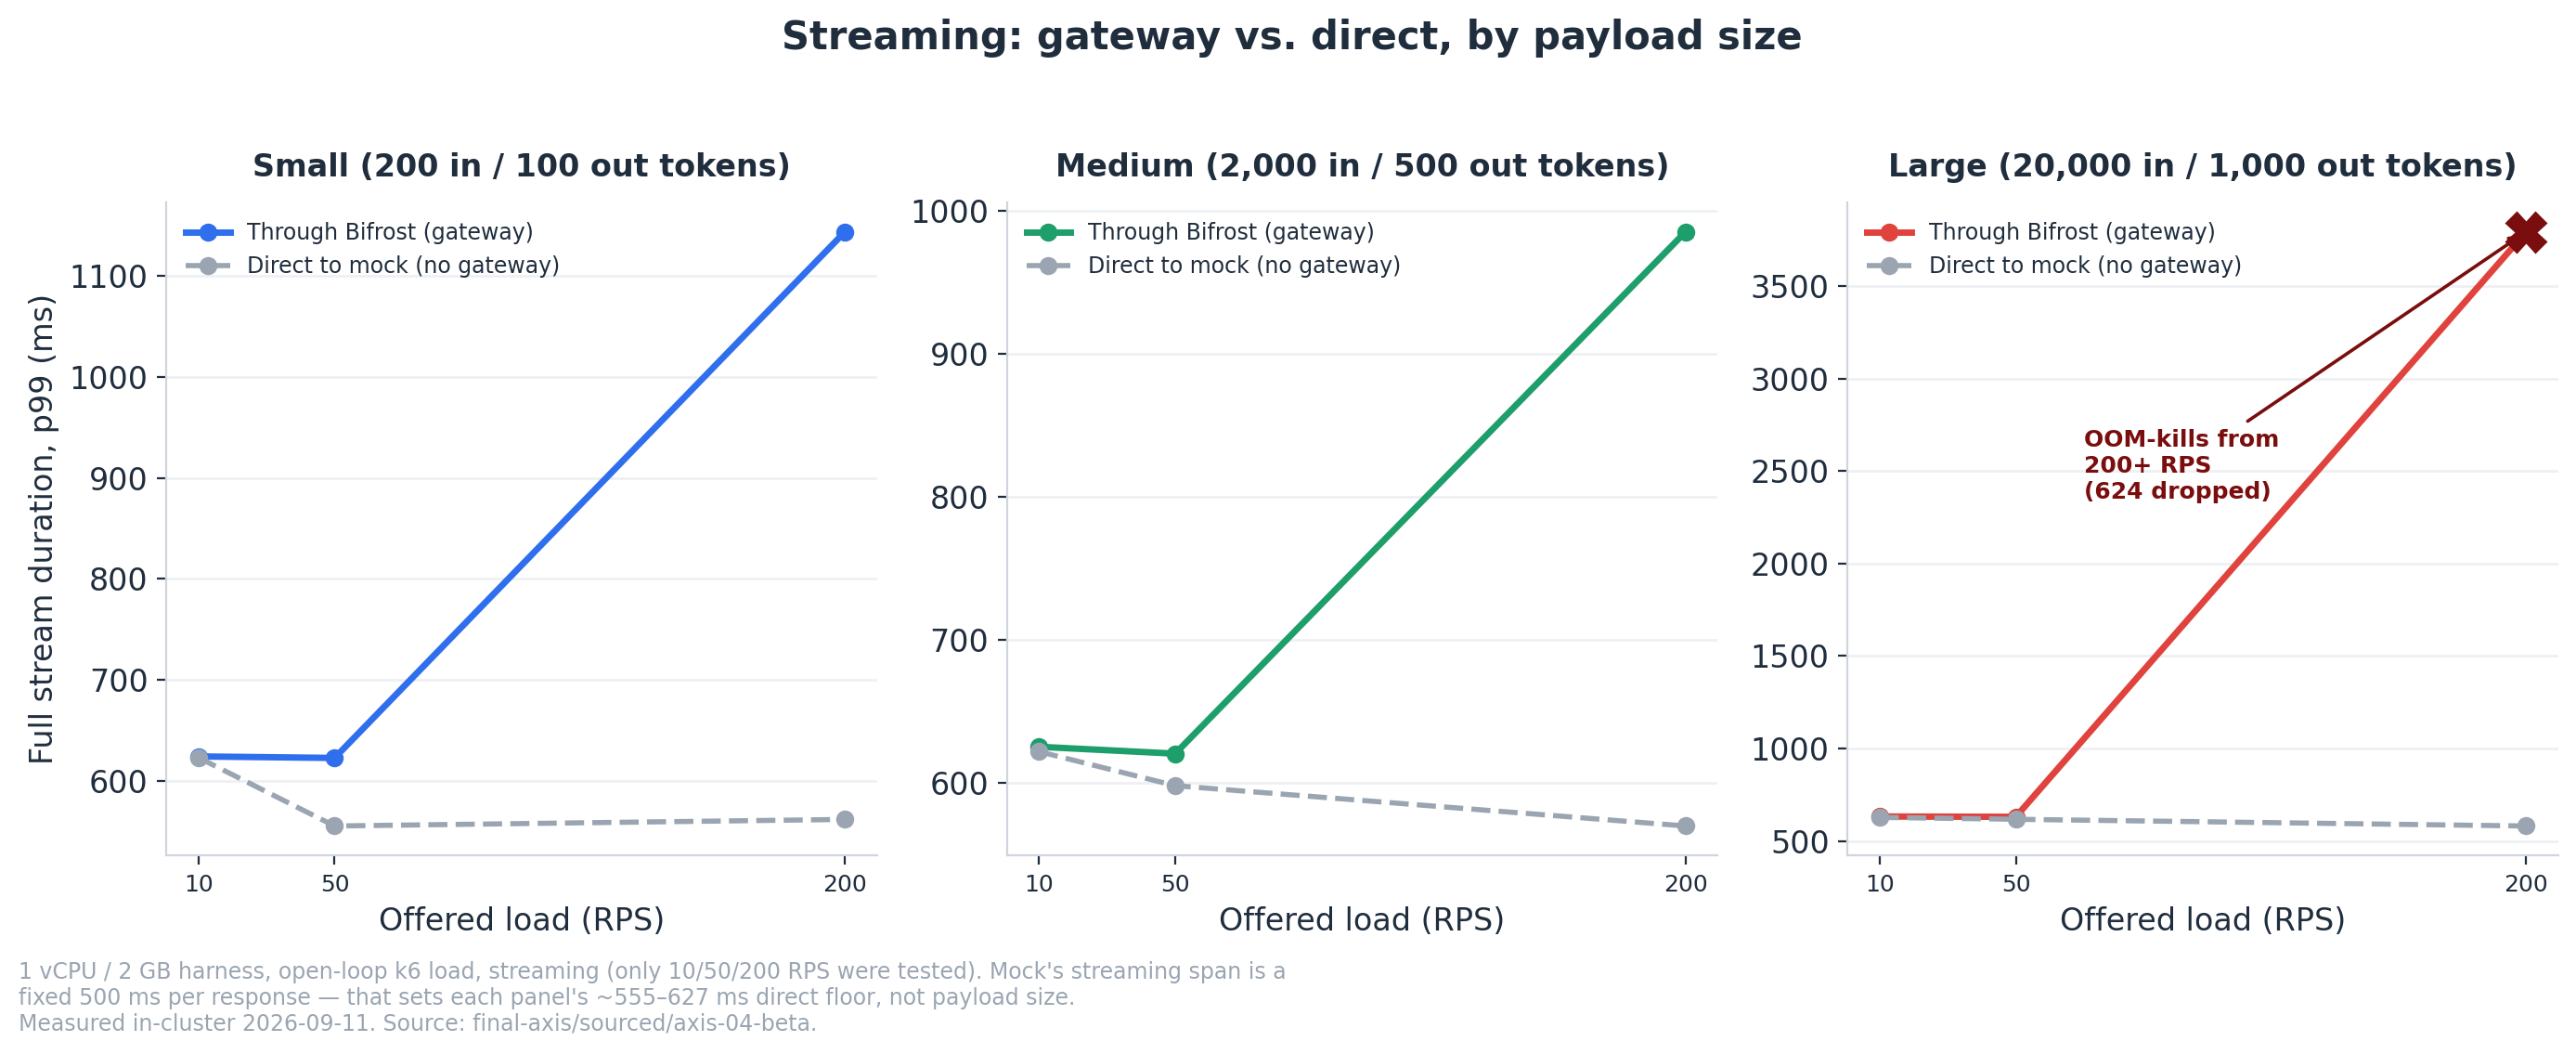
Kleine en middelgrote streaming volgen beide hun eigen directe ondergrens van ~555–627 ms op de voet tot 50 RPS, en beginnen te stijgen bij 200 RPS (kleine p99 bereikt ~1,14 s, middelgrote ~985 ms — beide queuing, geen OOM). Grote streaming krijgt die geleidelijke stijging ook niet: bij 200 RPS stort het halverwege de run in door OOM, waarbij 624 van de 12.001 streams uitvallen en de p99 oploopt tot ~3,8 seconden. Als jouw workload grote documenten streamt, is 200 RPS op één vCPU geen "langzamere" tier — het is een "omval"-tier.
De volledige streamduur is echter niet het getal dat er toe doet als jouw UI alleen het eerste token hoeft te tonen — dus hebben we dat afzonderlijk gemeten, met een gekoppelde async probe die het echte eerste-content-token meeneemt, niet de TTFB van k6 (die hier ongeldig is voor SSE, aangezien de mock headers flush voordat er een token bestaat):
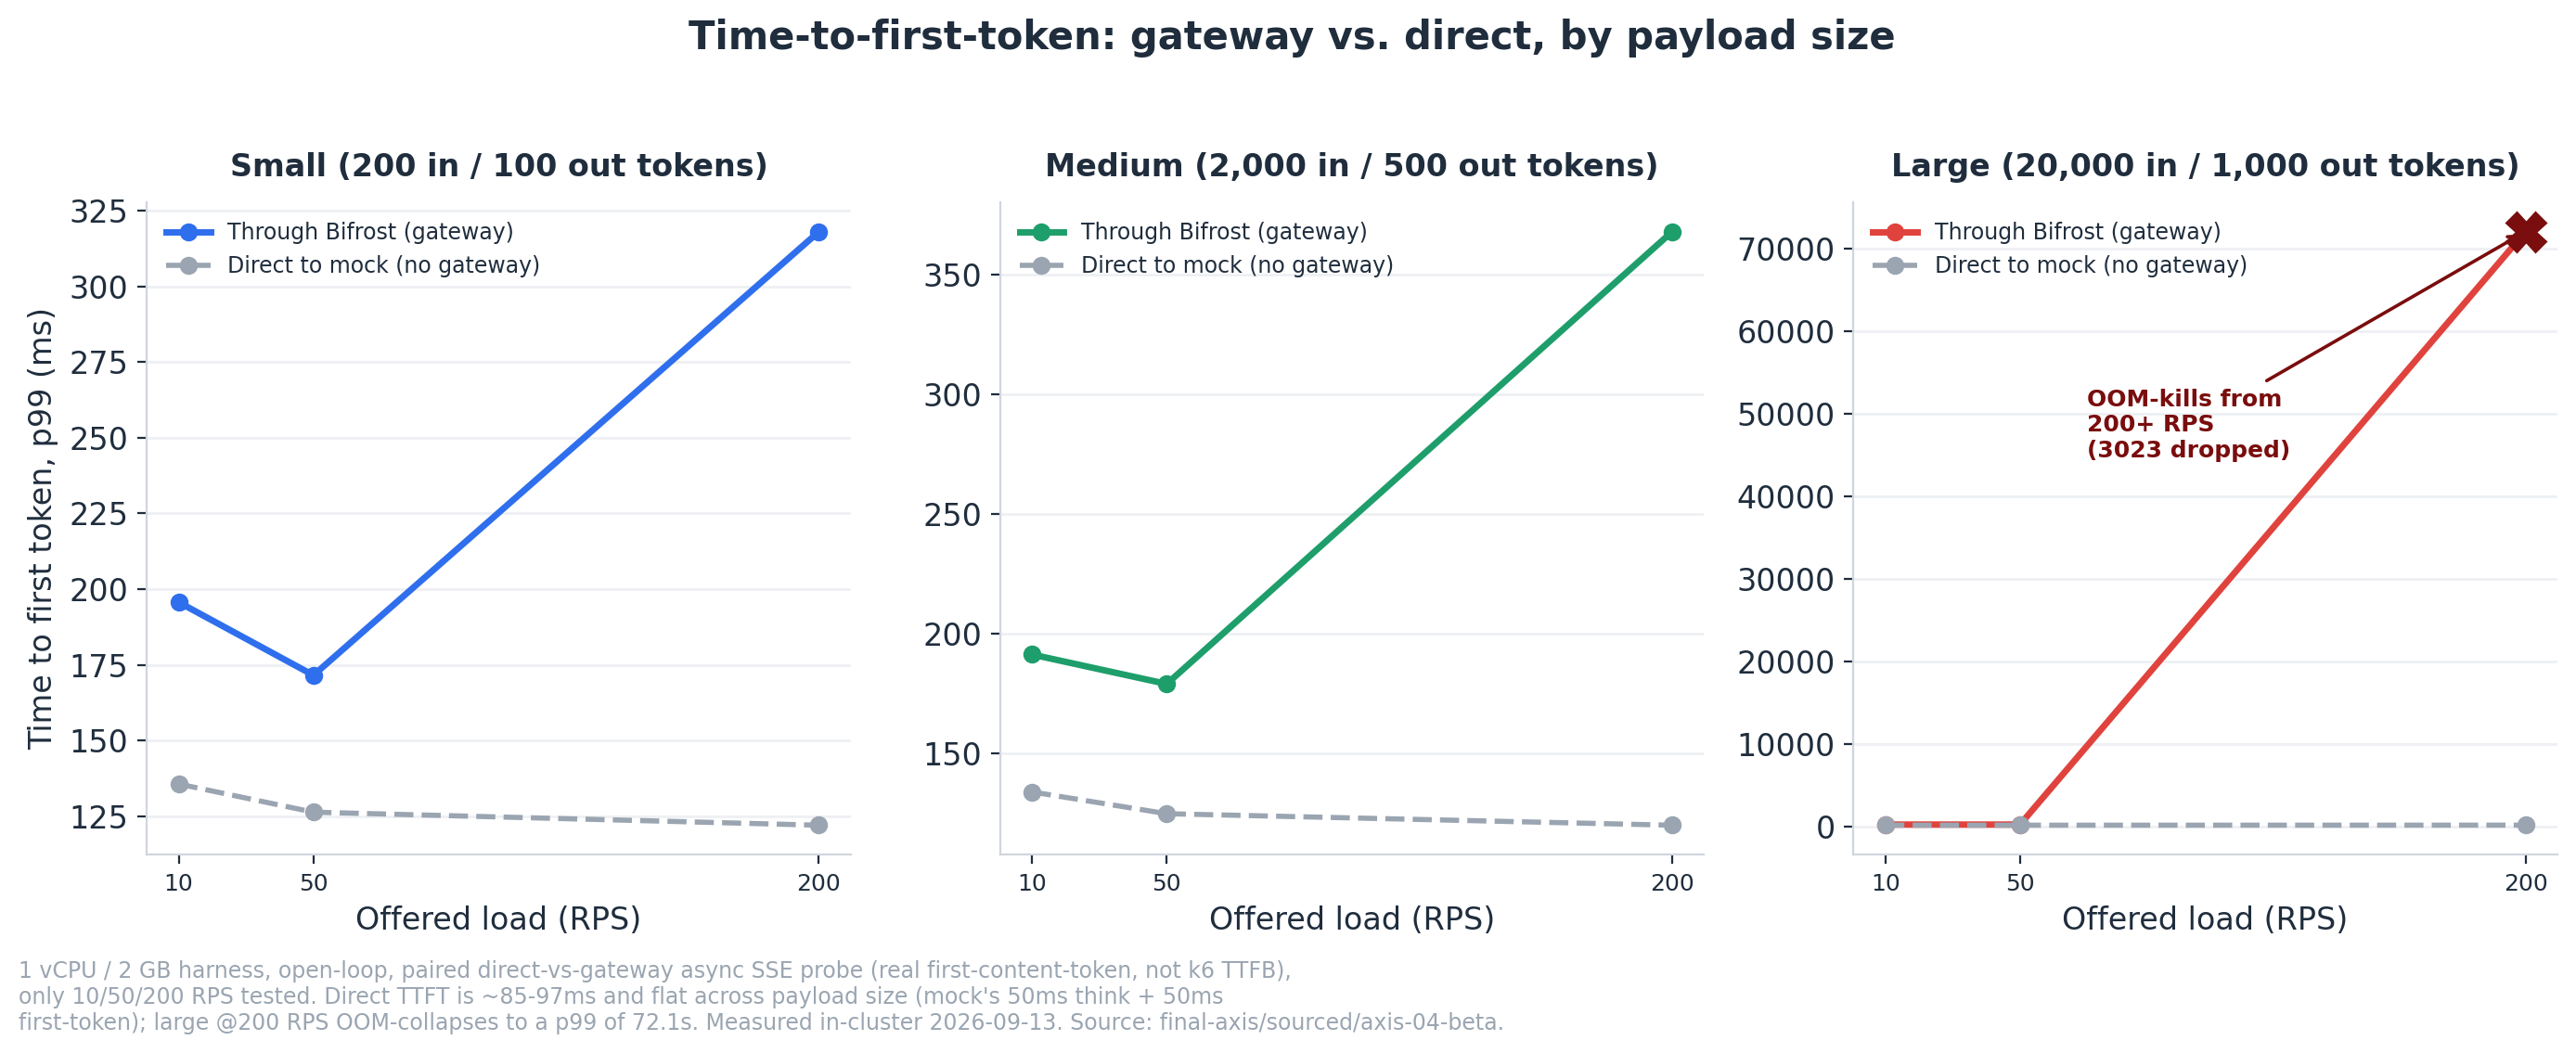
Directe TTFT is ~85–97 ms en vlak over alle drie de payload-groottes — het bewijs dat inputlengte de tijd tot het eerste token niet verandert, dus alles boven die ondergrens betreft de eigen streaming-setupkosten per request van Bifrost. Die extra kosten zijn ~27–46 ms en onafhankelijk van de grootte bij 10–50 RPS (groot @10 RPS voegt +46 ms toe, klein @10 RPS voegt +43 ms toe — dezelfde orde van grootte, andere payload). Bij 200 RPS houden de medianen van klein en middelgroot het nog steeds (+57 tot +71 ms), maar de tail ontploft — toegevoegde p99 bereikt +196 tot +248 ms — en 10–13% van de gateway-streams faalt volledig, dezelfde queuing-Knik die zichtbaar is in de grafiek voor volledige streams hierboven. Groot @200 RPS heeft geen tail-probleem, het heeft een totale crash: slechts 128,8 van de 200 aangeboden RPS wordt verwerkt, TTFT p99 loopt op tot 72,1 seconden, en 3.023 van de 12.001 streams falen — de OOM-muur, dit keer gezien vanaf de kant van het eerste token in plaats van de kant van de volledige respons.
En onder een bewuste overbelastingspiek bleven de twee modi van Bifrost beide geheugelveilig: "blocking" bedient iedereen uiteindelijk (langzaamste request wachtte ~5 seconden), "drop" faalt snel met een schone 503.
Het plafond voor grote payloads heeft een heel andere oorzaak dan die voor kleine/middelgrote. Het is geen CPU — en de duidelijkste manier om dat te zien is door geheugen en CPU afzonderlijk te bekijken, uitgesplitst naar payload-grootte en aangeboden belasting, niet alleen als een enkel piekgetal per payload:
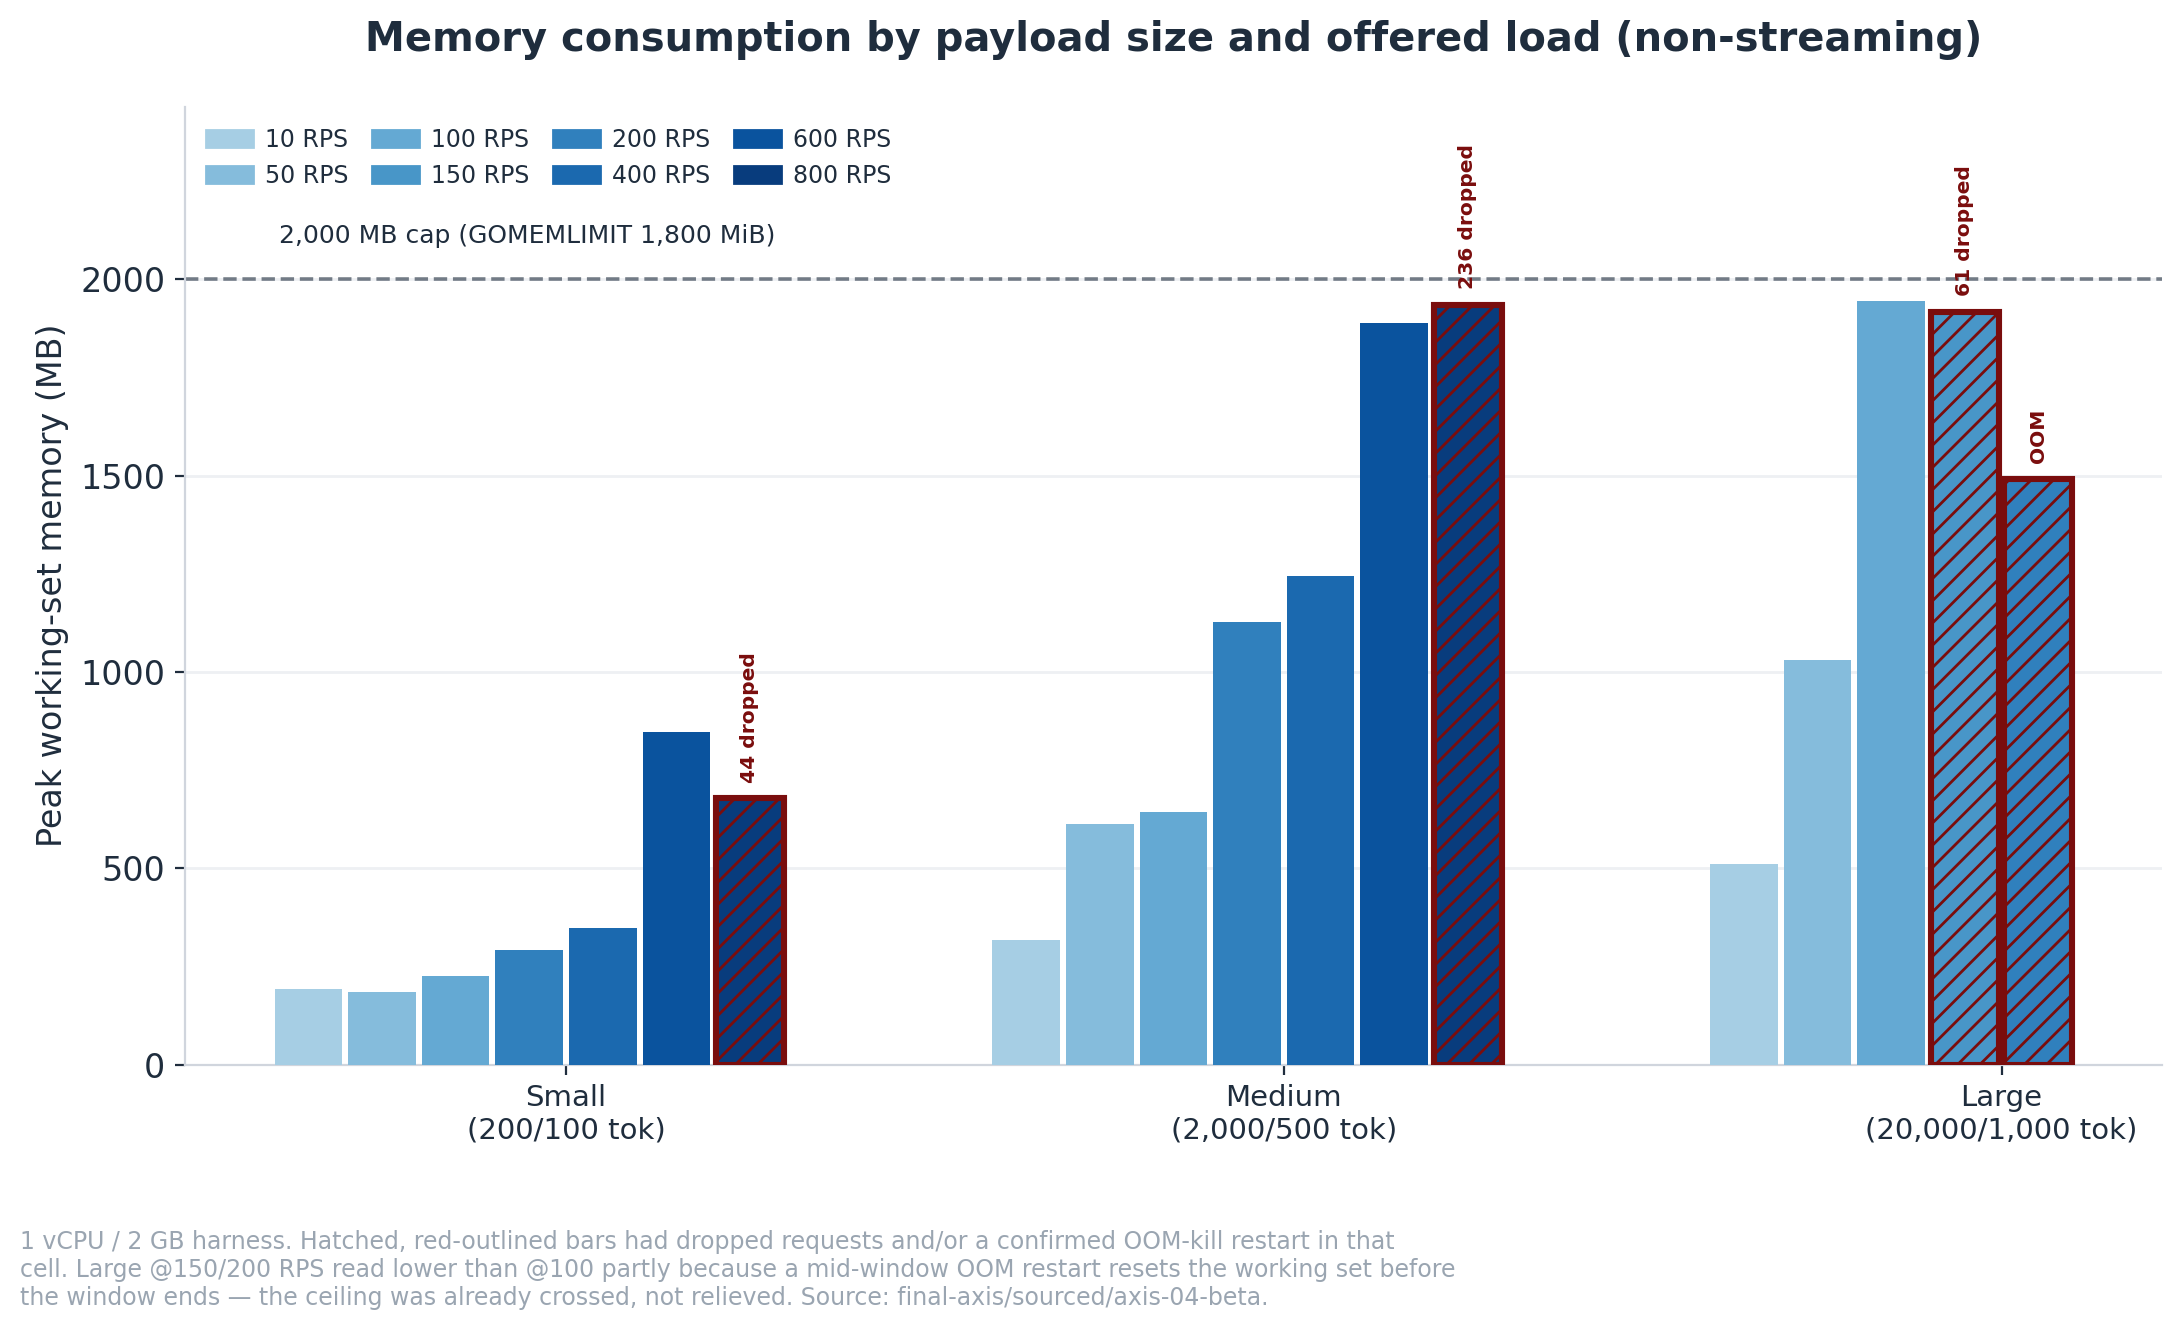
Klein en middelgroot stijgen geleidelijk en komen nooit in de buurt van de limiet van 2.000 MB, zelfs niet bij hun hoogst geteste RPS (respectievelijk 848 MB en 1.935 MB). Groot is een ander verhaal: het zit al op 1.944 MB — 97% van de limiet — bij 100 RPS, een volle 50–700 RPS vóór het gemeten "plafond". De staven met een rode omtrek en arcering (groot @150, @200) geven daadwerkelijk lagere waarden aan dan de staaf van 100 RPS, wat lijkt op herstel maar dat niet is — een OOM-kill halverwege het venster herstart de pod en reset de working-set teller voordat het meetvenster eindigt, waardoor die staven de echte piek te laag aangeven, niet te hoog.
CPU laat het tegenovergestelde beeld zien, en dat is precies het punt:
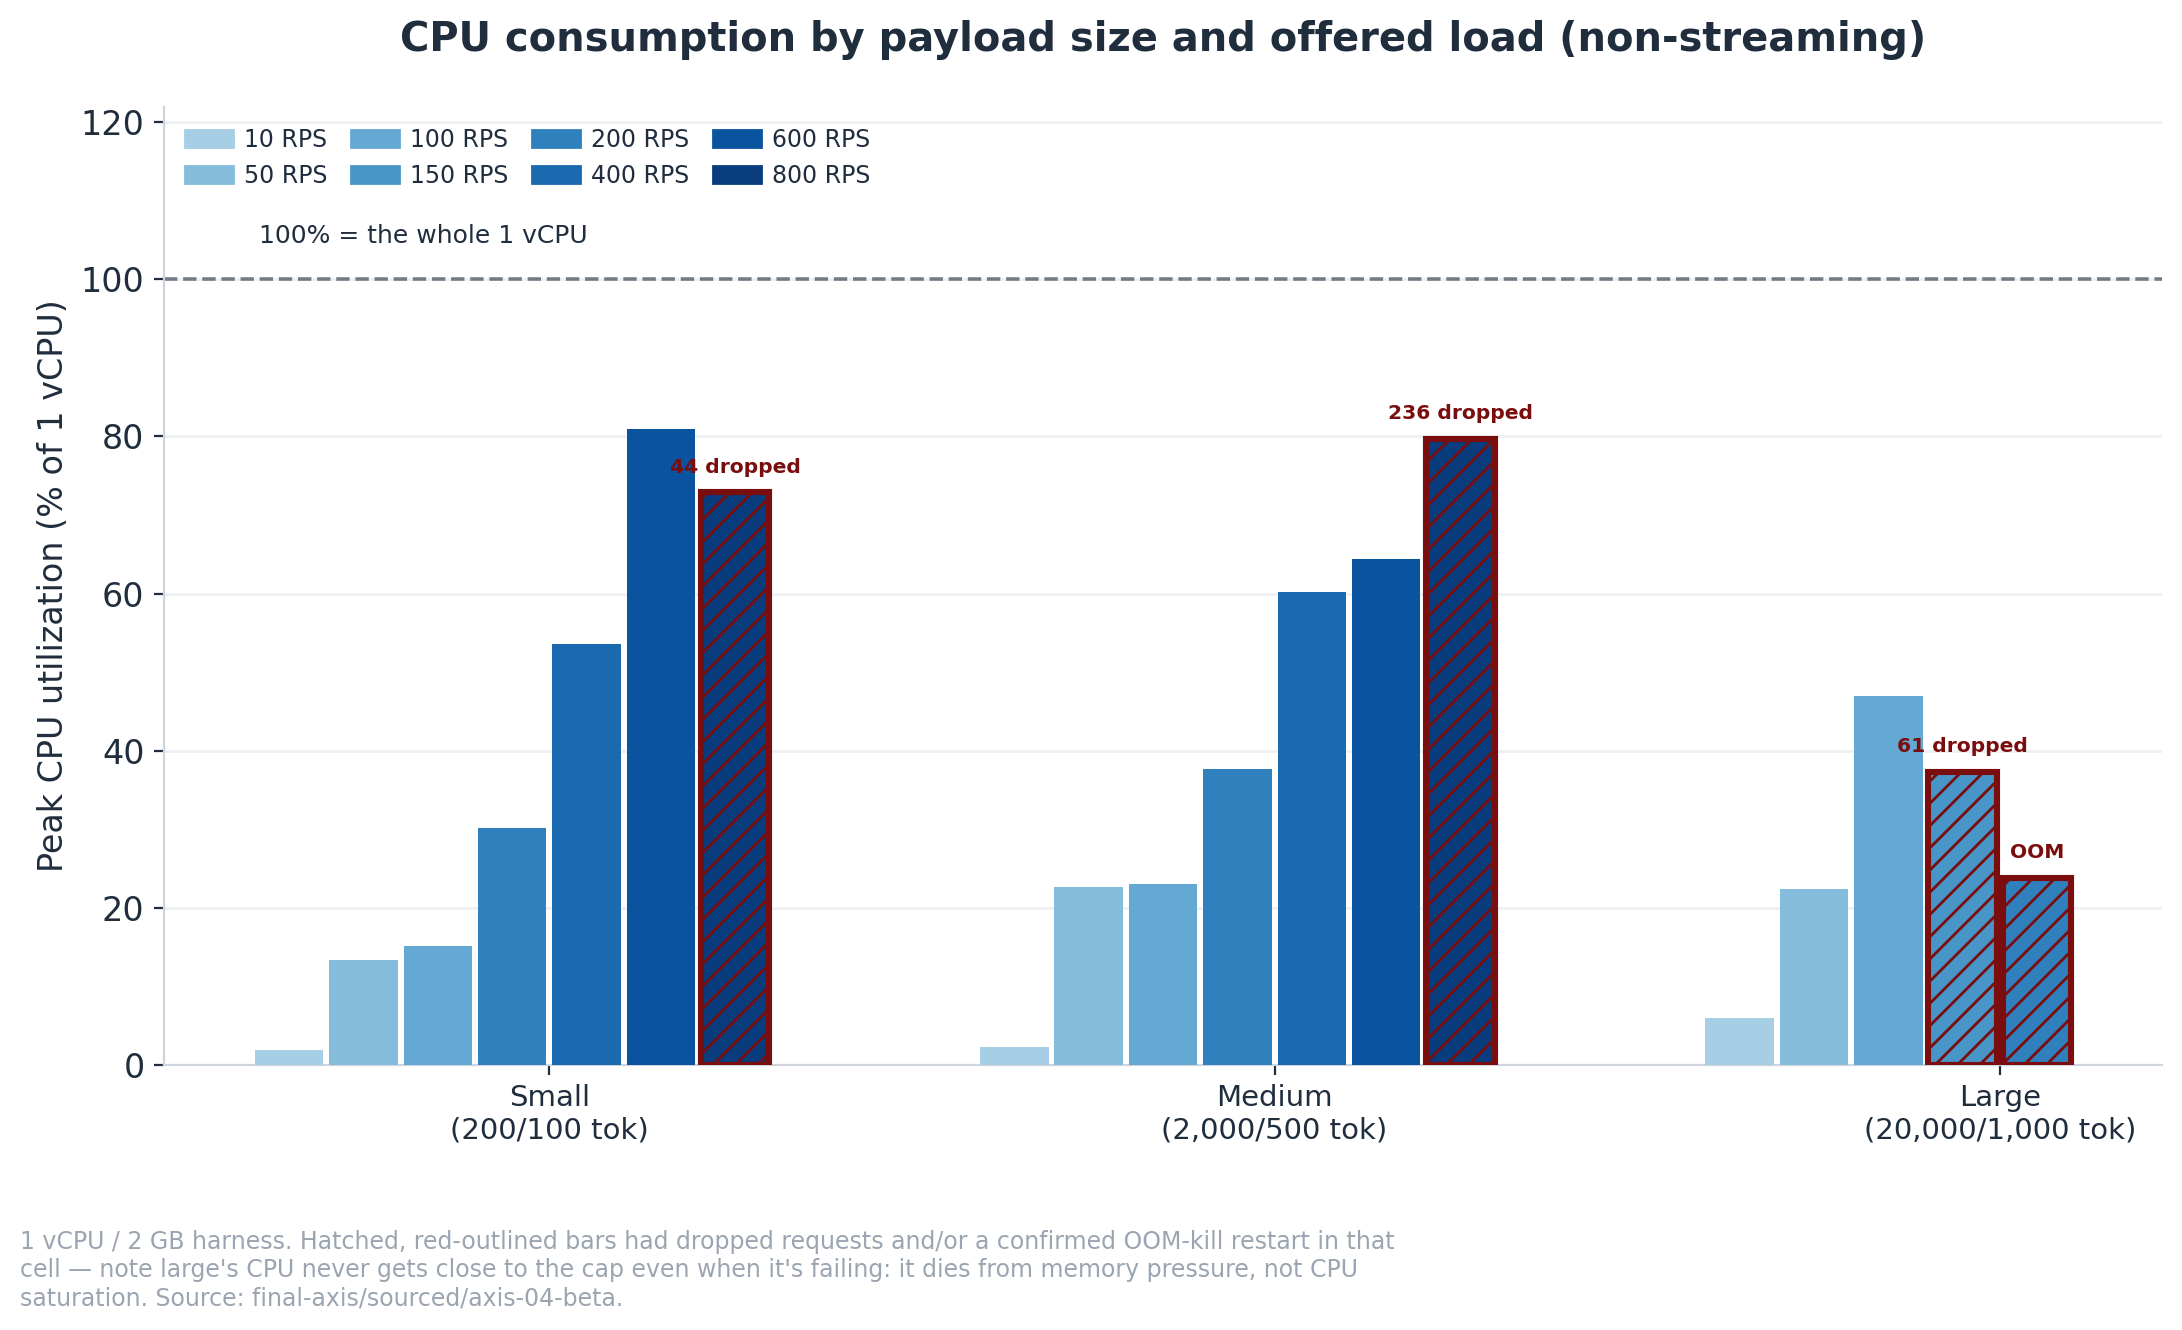
Klein en middelgroot stijgen beide naar het bereik van 73–80% bij hun hoogste RPS — echt CPU-gebonden, waarbij de enkele vCPU zwaar wordt belast. Groot doet dat nooit: zelfs in de cellen waar het actief requests weigert en OOM-killed wordt (rood omkaderd en gearceerd), komt de maximale CPU niet hoger uit dan 37% en 24%. Groot faalt niet omdat de CPU geen ruimte meer had — het faalt omdat het geheugen op was, terwijl de CPU nog capaciteit overhad. Als jouw workload uit lange documenten bestaat, is dat het getal om rekening mee te houden, niet het aantal vCPU's.
Een exact-match hit verandert een call van ~59 ms in ~4 ms. Semantische caching — het opvangen van een anders geformuleerde herhaling van dezelfde vraag — kost een echte embedding-heffing, maar is nog steeds de helft sneller dan een nieuwe call:
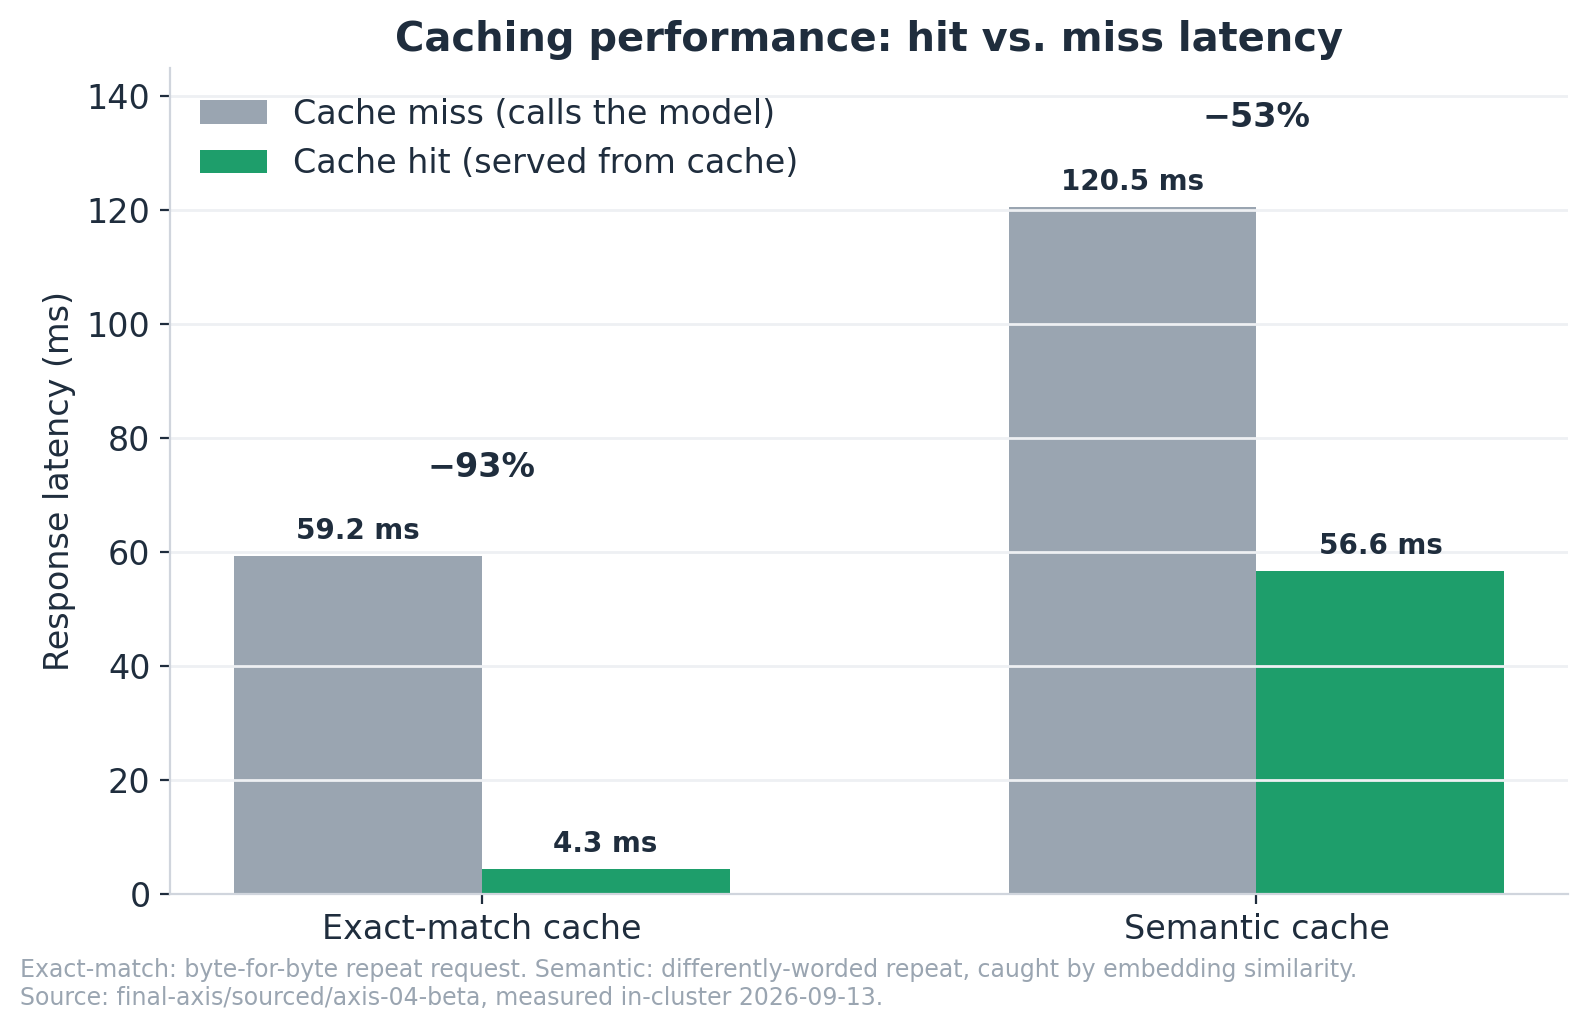
Geen van beide resultaten is op zichzelf verrassend — caching hoort sneller te zijn dan het aanroepen van het model, en dat is het ook. De cijfers hier zijn simpelweg de praktische meting van hoeveel sneller het precies is: 93% voor een exact-match hit, 53% voor een semantische hit zodra de embedding-kosten zijn betaald.
Nog twee cijfers voordat we verdergaan: een cold start duurt mediaan 8,7 seconden, en 8,2 van die seconden gaan op aan een verplichte opnieuw gedownloade catalogus bij elke herstart in een typische container-setup — op te lossen met permanente opslag, hier niet afzonderlijk opnieuw getest.
Een opmerking over transparantie met betrekking tot de bovenstaande cijfers: specifiek bij de cel met de kleine payload hebben we een bug ontdekt en opgelost in onze eigen testopstelling (een netwerk-interactie met het Nagle-algoritme die onze baseline ruisig maakte) — na het oplossen ervan ging het plafond voor kleine payloads van Bifrost daadwerkelijk omhoog, van ~400 naar ~600–800 RPS. We vermelden dit omdat dit het soort dingen is dat snel misgaat bij het benchmarken van elke gateway, inclusief Bifrost, en we laten liever ons werk zien dan dat we de correctie verbergen.
Op een enkele box is de overhead van Bifrost bij de mediaan echt laag: 2–6 ms bovenop een upstream call van ~55 ms, vlak over verschillende payload-groottes en vrijwel vlak over verschillende belastingen. Dat is de verdedigbare versie van de claim "snelste gateway", en het is iets waard — als aandeel van een echte LLM-call valt het weg in de ruis. De tail is een ander verhaal. Toegevoegde p99 is belastingsgevoelig en bereikt +41 tot +75 ms bij de plafonds die we hebben gemeten, en grote payloads worden niet zozeer geleidelijk trager, maar stoppen er gewoon mee: OOM-killed bij 150 RPS, met geweigerde requests tot gevolg. Caching werkt wel zoals geadverteerd (93% en 53% latency-reductie, gemeten). Het cijfer van 5.000 RPS van de leverancier beschrijft een grotere machine en een andere workload dan de meeste teams draaien. Dus voor een enkele node: de mediane snelheid is het probleem niet — tail latency onder belasting en geheugenruimte bij document-zwaar verkeer zijn dat wel.
De moeilijkere vraag is wat er gebeurt als je meer dan één node draait. Een productie-gateway moet kunnen opschalen, terugschalen en het overleven als een pod wegvalt zonder dat iemand het merkt. Op de open-source versie wordt het daar lastig. Configuratiewijzigingen worden niet live verspreid over replicas; het gedocumenteerde patroon is een gedeeld configuratiebestand plus een herstart. Elke routingwijziging, key-rotatie of budget-update verandert dus in een gecoördineerde rollout over je gateway-pods, in plaats van een instelling die je omzet. Voeg daar een admin-dashboard aan toe dat openstaat voor iedereen die het kan bereiken totdat het eerste admin-account is aangemaakt, en de open-source versie is het meest geschikt voor een enkele node die je nauwlettend in de gaten houdt, niet voor een heel cluster.
Bifrost Enterprise dicht een groot deel van dat gat: de gRPC mesh zendt configuratiewijzigingen binnen enkele seconden uit naar elke replica, zonder herstart. Maar zelfs Enterprise is nog steeds infrastructuur die je zelf moet deployen, schalen, patchen en monitoren. Het kopen van de licentie draagt de operationele druk niet over aan iemand anders.
De echte beslissing is dus minder "is Bifrost snel?" en meer "wie gaat het beheren?" Een team met toegewijde platform/DevOps-capaciteit, of met strikte vereisten om alles in de eigen omgeving te houden, kan Bifrost goed draaien, idealiter op Enterprise als er meer dan één replica nodig is. Een klein team dat gewoon een betrouwbare gateway nodig heeft voor zijn LLM-calls, haalt meestal meer uit een beheerde oplossing dan uit het zelf beheren van de gateway-operaties.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



Bifrost is an open-source AI gateway — a single Go process that sits between your applications and your LLM providers, exposing one OpenAI-compatible API across 28 built-in provider adapters. It is Apache-2.0 licensed and self-hosted: you run it yourself, bring your own provider keys and pay the providers directly, so the gateway takes no per-token cut. A paid Enterprise edition adds clustering, identity, guardrails and audit. It’s built by Maxim AI — legal entity H3 Labs Inc., founded in 2023 by Vaibhavi Gangwar and Akshay Deo, operating in the United States and India — with the open-source core at github.com/maximhq/bifrost and Enterprise sold through sales with no published price.
Bifrost’s own benchmark claims ~5,000 RPS at microsecond overhead on a 2–4 vCPU instance, but that figure is narrower than it looks: per the vendor’s own source it excludes HTTP request handling and JSON marshalling, making it internal-pipeline time rather than net latency added to your request. On a standardized 1 vCPU / 2 GB box, measuring the full end-to-end tax for documented payload sizes, you get two very different answers depending on which percentile you ask about. The median request pays 2–6 ms, and it stays there across almost the whole tested range. The p99 is the number to plan with: it grows with load, reaching +60 ms for small payloads at 600 RPS, +75 ms for medium at 400, and +41 ms for large at just 100 — those being the last steps where added p99 stayed inside a 100 ms budget. Push one step further and it crosses hard in all three cases (+186 ms small at 800 RPS, +137 ms medium at 600, +614 ms large at 150, the last two shedding requests as well). So: single-digit milliseconds typically, tens of milliseconds at the tail under real load, and a cliff rather than a slope just past it. Both the vendor’s microseconds and our milliseconds are accurate — they measure different things, and the milliseconds are the ones your users feel.
On a standardized 1 vCPU / 2 GB box, the last load steps where added p99 latency stayed under 100 ms were ~600 RPS for small payloads (200 in / 100 out tokens), ~400 for medium (2,000/500) and ~100 for large (20,000/1,000). The next step up failed in all three cases. Bifrost’s own benchmark claims ~5,000 RPS, but on a t3.xlarge — four times the compute — against a mocked upstream. Throughput scales with cores for small and medium traffic; for large payloads memory becomes the binding constraint long before CPU does, so adding vCPUs alone won’t move that ceiling.
It’s accurate, but it measures something narrower than most readers assume. Per Bifrost’s own source, the figure excludes HTTP request handling and JSON marshalling — so it’s time spent inside the gateway’s internal pipeline, not the net latency added to a caller’s request. It’s also an average rather than a percentile, taken on a t3.xlarge; the same source reports 59 µs on a t3.medium, roughly 5x worse on a smaller box. Measuring the full end-to-end cost on 1 vCPU, we got 2–6 ms at the median. Both numbers are true; they answer different questions.
More than you would guess, and memory — not CPU — is the constraint that actually bites. On a 2 GB box, small and medium payloads never came close to the cap (848 MB and 1,935 MB at their highest tested load). Large payloads hit 1,944 MB, or 97% of the cap, at just 100 RPS, then got OOM-killed at 150. In those failing cells CPU was only at 24–37% — there was processor headroom to spare while memory ran out. Size your deployment on concurrent requests multiplied by context length, not on vCPU count.
Het vertraagt niet geleidelijk - het stopt. De latentie bij grote payloads is vlak van 10 tot 100 RPS, en valt dan van een klif bij 150 RPS, waar de toegevoegde p99 naar +614 ms springt en 61 verzoeken worden gedropt doordat de pod midden in de run OOM-killed wordt. Streaming is nog erger: bij 200 RPS met grote payloads bereikte de time-to-first-token p99 72,1 seconden en mislukten 3.023 van de 12.001 streams volledig. Behandel bij documentzware workloads het niveau boven het plafond als "stort in", niet als "trager".
Cold start is a median 8.7 seconds, and about 8.2 of those seconds is Bifrost re-downloading the model pricing catalogue from the vendor — which it does on every restart in a typical containerized setup, because the container starts with no cached copy. Mounting persistent storage for the catalogue, or pointing it at a local copy, removes almost all of the startup time. Worth knowing if you autoscale, since every new pod pays the full cost before serving traffic.
Niet in stabiele toestand. Configuratie wordt bij het opstarten in het geheugen geladen en het inferentiepad leest de database niet, wat een werkelijk goede architecturale keuze is. We hebben dit getest in plaats van het op vertrouwen aan te nemen: we haalden PostgreSQL weg onder een draaiende single-node OSS-instantie, en de inferentie ging door met nul fouten en geen meetbare latentieverandering, terwijl /health tijdens de storing correct 503 teruggaf en binnen ~350 ms na het herstel van de store weer herstelde. De keerzijde van hetzelfde ontwerp is dat OSS-replica's, omdat configuratie in het geheugen leeft, elkaars configuratiewijzigingen niet overnemen zonder herstart.
An exact-match cache hit turns a ~59 ms call into ~4 ms, a 93% reduction. Semantic caching — catching a differently-worded repeat of the same question — pays a real embedding cost but still comes in about 53% faster than a fresh call. This is the one area where Bifrost’s marketing undersells the product rather than overselling it.
The core gateway’s performance envelope is well-understood and predictable up to its measured ceilings. Large payloads specifically hit a hard memory wall (not a CPU wall) above ~150 RPS on a 1 vCPU / 2 GB box, so plan capacity around memory, not vCPU count, if your workload is long documents.
Yes, but the replicas don’t share live configuration. On Bifrost OSS the documented pattern is a shared config file plus a restart, so a change made on one replica doesn’t reach the others until they restart. That makes scaling up and down, and rolling out config changes, a coordinated operation across all your gateway pods.
For multi-node deployments, the biggest operational difference is config propagation. Enterprise uses a gRPC mesh that broadcasts config changes to every replica within seconds, with no restart; OSS relies on a shared file and a restart. Either way, you still deploy, scale and operate the gateway infrastructure yourself.
It depends on who will operate it. Teams with dedicated platform/DevOps capacity, or strict data-residency requirements, can self-host Bifrost well. Smaller teams without that capacity usually get more value from a managed gateway, because the hard part of running Bifrost in production is operating a synchronized fleet of gateway pods, not raw speed.



Het laatste nieuws, artikelen en bronnen in je inbox



















