



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
We zijn de fase van "bekijk deze coole demo" in Voice AI voorbij. Bedrijven bouwen niet langer alleen maar leuke Alexa-skills. Ze implementeren complexe, multimodale systemen die zijn ontworpen om miljoenen gevoelige klantinteracties af te handelen—van bancaire overboekingen tot medische triage.
Maar dit is de ongemakkelijke waarheid over het overbrengen van Voice AI van prototype naar productie: het is ongelooflijk kwetsbaar.
In tegenstelling tot op tekst gebaseerde chatbots, waar een fout slechts een slechte tekstreactie is, is een fout in Voice AI voelbaar. Het is een doffe stilte. Het is een robotstem die stottert. Het is een klant die herhaaldelijk "medewerker!" roept omdat de latency van de RAG-lookup 400 ms te lang duurde en de ASR hen afkapte.
Wanneer u een omvangrijke stack orchestreert met Automatic Speech Recognition (ASR), complexe intentieclassificatie, agentic Retrieval-Augmented Generation (RAG) en realistische Text-to-Speech (TTS), schieten standaard application monitoring tools (APM's) schrikbarend tekort. Ze vertellen u dat er iets kapot is gegaan, maar zelden waarom.
In dit artikel behandelen we een realistische, grootschalige enterprise-use-case om aan te tonen waarom gespecialiseerde observability essentieel is, en hoe platforms zoals TrueFoundry opkomen als het control plane voor deze complexe systemen.
Om de uitdaging op het gebied van observability te begrijpen, moeten we eerst kijken naar het "beest" dat we proberen te temmen. Een moderne, conversatieve voice agent is geen enkel model; het is een estafateloop van zeer gespecialiseerde componenten, vaak verdeeld over verschillende infrastructuren.
Als een enkele overdracht in deze estafateloop mislukt, stort de gehele gebruikerservaring in.
Laten we ons Apex Financial voorstellen, een grote bank die een spraakassistent inzet om middelgrote transacties af te handelen, zoals het controleren van saldi over verschillende activaklassen en het starten van internationale overboekingen.
De schaal: 50.000 gelijktijdige gesprekken tijdens piekuren.
De belangen: Hoog. Het verkeerd interpreteren van "vijftig" als "zestig" tijdens een overboeking is catastrofaal.
De stack:
Een klant, "Sarah", belt in. Ze heeft wat achtergrondgeluid en zegt: "Ik moet 5k overmaken naar mijn broer in Londen vanaf mijn spaarrekening."
Zo ziet die workflow eruit, en dit is waar het meestal misgaat.
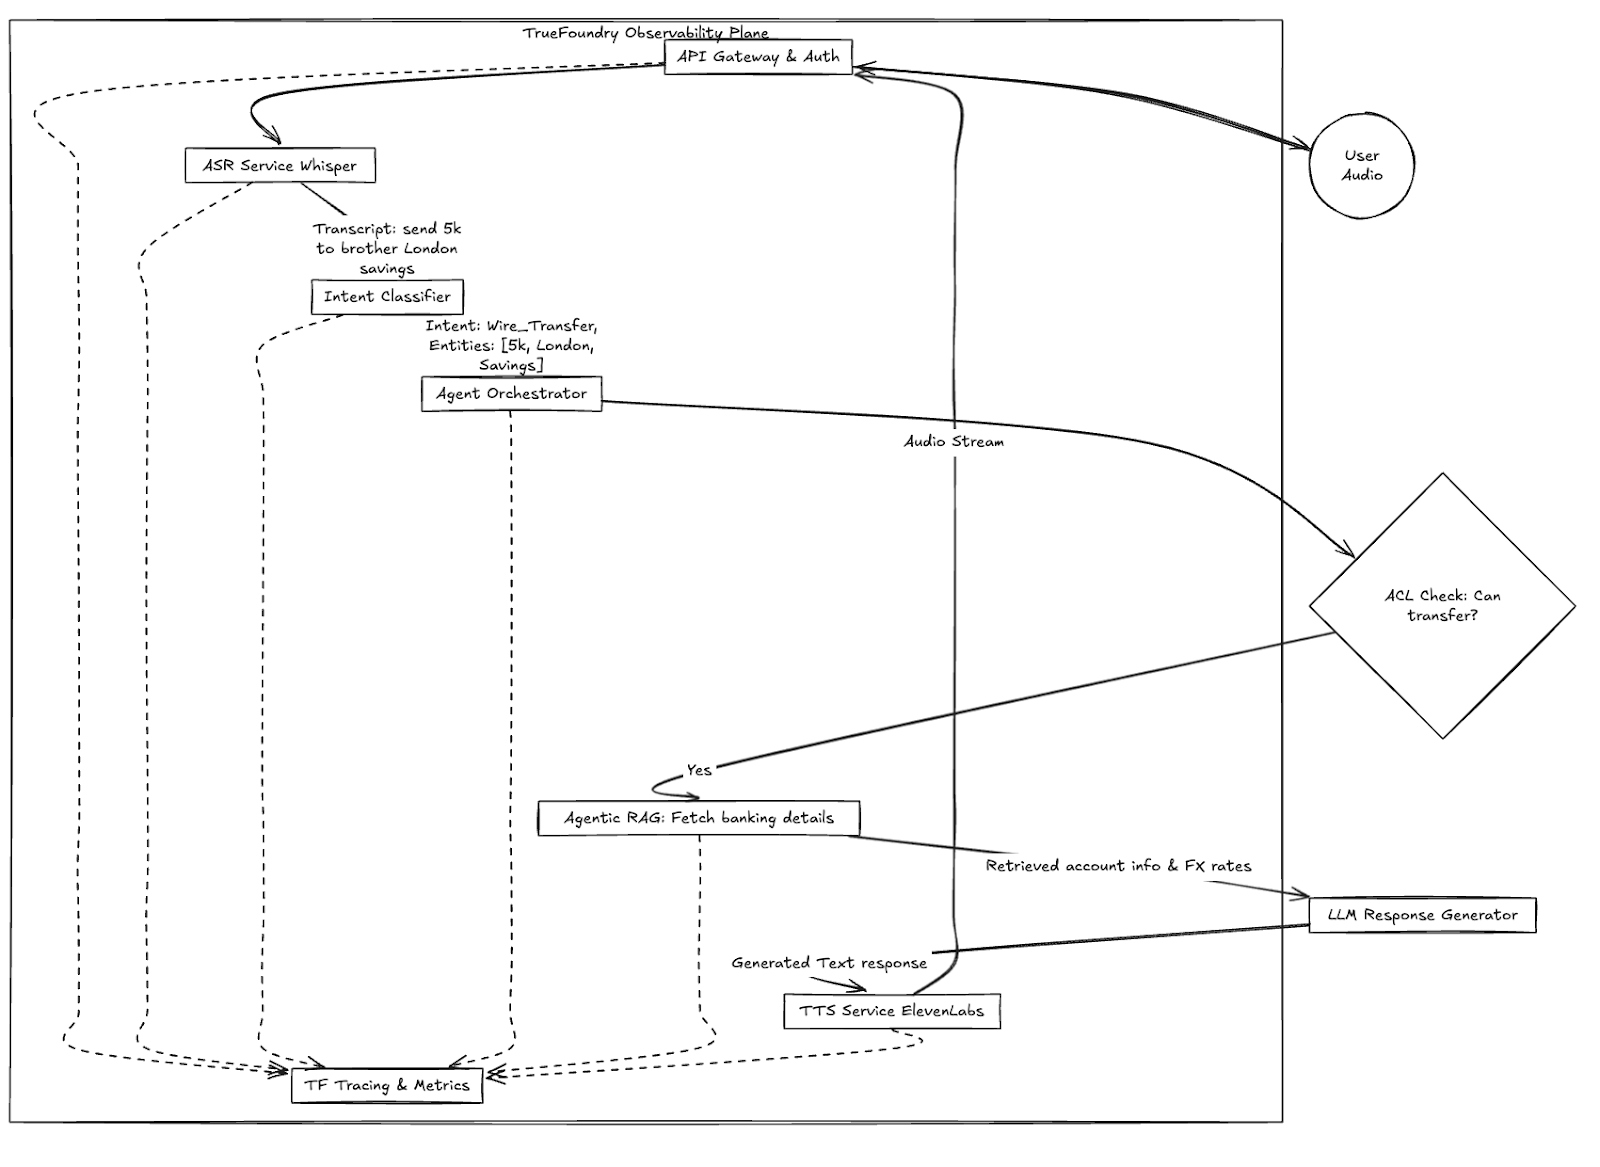
Fig 1: High-level workflow van de spraaktransactie van Apex Financial, waarin de cruciale rol van het Observability Plane wordt getoond.
In een standaardopstelling krijgt het engineeringteam bij een mislukt gesprek van Sarah een ticket met de melding "Voice bot heeft opgehangen."
Ze controleren Datadog of Prometheus. De CPU is in orde. Het geheugen is in orde. De Kubernetes pods draaien. Wat is er gebeurd?
Zonder gespecialiseerde Voice AI observability is het opsporen van de oorzaak als het oplossen van een mysterie zonder forensische middelen.
In een gedistribueerd Voice AI-systeem stapelt latency zich op. Een vertraging van 200 ms in ASR plus een vertraging van 400 ms in RAG leidt tot een mislukte klantervaring. U heeft tracing nodig die audioframes begrijpt, niet alleen HTTP-requests.
Dit is waar platforms zoals TrueFoundry essentieel worden. TrueFoundry is niet zomaar een monitoringdashboard; het is een AI/ML-infrastructuur- en observabilityplatform dat specifiek is gebouwd voor de complexiteit van GenAI-stacks, inclusief spraak.
TrueFoundry behandelt de gehele keten—van het eerste audiopakket tot de uiteindelijke TTS-stream—als een observeerbare flow.
Dit is hoe het voldoet aan de kritieke enterprise-behoeften die generieke tools missen:
Standaard tracing toont u de responstijden tussen services onderling. Met de gespecialiseerde tracing van TrueFoundry kunt u het latency-budget van een gesprek in realtime visualiseren.
U kunt zien dat voor het gesprek van Sarah de ASR 350 ms duurde (acceptabel), maar de Agentic RAG-stap 2,1 seconden in beslag nam (onacceptabel). U kunt direct inzoomen op de RAG-stap: Was het het ophalen uit de vector-DB? Was het het rerankingmodel?
U stopt met gissen en begint met het verhelpen van de bottleneck.
Wanneer uw Voice AI een agent gebruikt om beslissingen te nemen (zoals controleren of Sarah voldoende saldo heeft voordat er om de bestemming wordt gevraagd), moet u het "denkproces" van de agent kunnen auditeren.
TrueFoundry biedt inzicht in de tussenstappen van de agent. U ziet niet alleen de invoer en uitvoer; u ziet de tools die de agent heeft geselecteerd, de query's die zijn uitgevoerd op de vector-database en de ruwe context die is opgehaald. Als de bot een verkeerd antwoord geeft, kunt u precies zien welk verouderd gegeven uit het RAG-systeem de hallucinate heeft veroorzaakt.
In de banksector is "wie wat mag doen" van het hoogste belang. U kunt niet hebben dat uw marketing-voicebot per ongeluk toegang krijgt tot de transactie-agent.
TrueFoundry biedt robuuste Access Control Lists (ACL) die bepalen welke modellen en agents met elkaar kunnen interageren. Naarmate multi-agent systemen groeien, adopteert TrueFoundry bovendien standaarden zoals het Model Context Protocol (MCP) om geauthenticeerde, veilige communicatie tussen verschillende AI-agents binnen uw ecosysteem te garanderen.
Observability gaat hier niet alleen over prestaties; het is security-auditing. U heeft een logboek nodig dat bewijst waarom Agent A de toegang tot Databron B werd geweigerd tijdens een live gesprek.
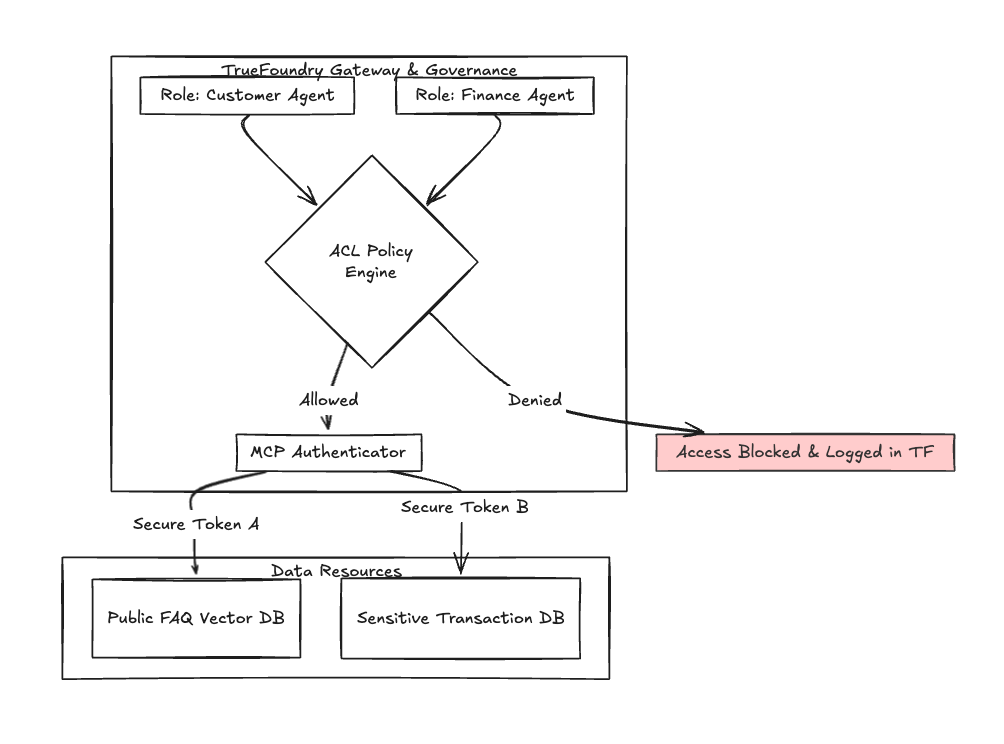
Fig 2: Vereenvoudigde weergave van de ACL- en MCP-authenticatiestroom beheerd binnen het TrueFoundry-ecosysteem, wat de isolatie van gevoelige spraak-agents garandeert.
Om het verschil samen te vatten tussen standaard monitoring en wat vereist is voor enterprise Voice AI:
Tabel 1: Vergelijking van Standaard APM vs. TrueFoundry Voice AI Observability-diepte.
Voor Apex Financial betekende de implementatie van TrueFoundry het verschil tussen het terugdraaien van hun spraakassistentprogramma of het schalen ervan. Ze gingen van een Mean Time To Detection (MTTD) van uren naar minuten. Ze konden proactief identificeren dat een specifiek RAG-embeddingmodel latency-pieken veroorzaakte tijdens periodes met hoog volume, voordat klanten begonnen op te hangen.
Bij het bouwen van enterprise Voice AI zijn de modellen die u kiest—Whisper, ElevenLabs, GPT-4o—slechts de motor. Observability is het avionicasysteem. U zou niet proberen een straaljager te vliegen met alleen een snelheidsmeter; probeer geen enterprise voice stack te draaien zonder diepgaande, gespecialiseerde observability.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















