



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Als u Slack draait via een agent op Opus, is hier het opvallende getal. Sonnet 4.6 bij high effort, met een skill-bestand van 55 regels, slaagde voor 56 van de 63 taken. Dat is 88,9%. Opus 4.8 bij high effort zonder skill slaagde eveneens voor 56 van de 63. De run van Sonnet kostte $ 4,28. Die van Opus kostte $ 6,81. De meederheid van de taken was op Sonnet bovendien 12% sneller.
De logische stap lijkt dus om Opus hetzelfde bestand te geven en te zien hoe het de leiding neemt. Dat hebben we gedaan. Opus met de skill slaagde voor 55 van de 63. Fable 5, dat boven de 90% begon, eindigde op 85,7%. Bij één prompt ging Opus van 3 uit 3 zonder de skill naar 0 uit 3 mét skill, en de fout is niet subtiel: het haalde een lijst met kanaalleden op, kreeg user id's terug en stopte, omdat het bestand zei: “doe één call en stop.” Sonnet las dezelfde regel en zocht de namen alsnog op.
Dat is de essentie van het gehele resultaat. Een skill is precies zoveel waard als het gat dat het dicht. Bij een kleiner model is dat gat groot en overbrugt een korte index het grootste deel, voor minder geld dan het grotere model zonder instructies kost. Bij een model dat de limiet al nadert is het gat smal, en een regel die geschreven is voor het onduidelijke geval wordt het meest strikt opgevolgd door het model dat hem het minst nodig had.
Zodra een team ziet dat een skill de nauwkeurigheid op één MCP-server verhoogt, ontstaan er vaak twee overtuigingen. Ten eerste dat sturing geen nadelen kent, dus schrijf de regels breed en laat elk model ze lezen. Ten tweede dat het sterkste model het meest profiteert, omdat het instructies het beste opvolgt. Slack bewijst dat beide niet kloppen.
De eerste overtuiging faalt omdat een skill alleen helpt waar het model een onderscheid miste. De meeste tools van Slack zijn eenvoudig van elkaar te onderscheiden. Send, draft en schedule zijn duidelijk in de toolnamen, en een sterk model koos die vrijwel elke keer goed zonder hulp. Waar de toollijst het werk al doet, kan een skill geen nauwkeurigheid toevoegen. Het kan alleen een regel toevoegen die het model niet nodig had, en een regel kan té goed worden opgevolgd.
De tweede overtuiging faalt om dezelfde reden, maar dan andersom bekeken. Het model dat instructies het beste opvolgt, is ook het model dat het meest geneigd is om “doe één call en stop” te gehoorzamen op het exacte moment dat het op het punt stond iets nuttigs te doen. Opus had uit zichzelf al ledennamen opgezocht. Fable was uit zichzelf al voorbij het DM-filter gekomen. De skill leerde geen van beiden iets nieuws. Het gaf ze een korte algemene regel, en ze volgden die letterlijker op dan ze uit zichzelf zouden hebben gedaan.
Het financiële aspect hangt daarmee samen. De vraag is niet of een skill zijn tokens waard is. De skilled agent gebruikte iets minder input-tokens en maakte ongeveer een derde minder calls, dus het bestand verdiende zichzelf puur op kosten al terug. De vraag is welk model u in de eerste plaats nodig heeft. Als een index van 55 regels Sonnet Opus laat evenaren, bespaarde de skill niet alleen tokens op de run. Het veranderde welk model de workload vereist.
Het voorbeeld. “Wie is er lid van mcp-gateway?” De ledenlijst geeft user id's terug. Een nuttig antwoord zoekt die id's op en geeft namen. Opus 4.8 bij high effort, geen skill: slaagde voor 3 van de 3, door leden te vermelden en vervolgens profielen te lezen om met namen te antwoorden. Hetzelfde model, dezelfde prompt, mét de skill: slaagde voor 0 van de 3. Eén poging zocht naar het kanaal, vermeldde de leden twee keer en stopte. Het antwoord bestond uit user id's zonder namen. Sonnet 4.6 met dezelfde skill slaagde voor 3 van de 3 en rondde het opzoeken van de namen af.
De cijfers. 21 Slack-taken, zes Claude-instellingen, drie runs elk. Over alle modellen heen steeg de nauwkeurigheid van 83,3% naar 86,5%. Bij high effort ging Sonnet met de skill van 66,7% naar 88,9%, dezelfde score als Opus zonder skill, voor $ 4,28 tegenover $ 6,81. Opus met de skill scoorde 87,3%. Bij medium effort steeg Sonnet van 74,6% naar 84,1% en bleef Opus op 87,3%. Fable ging bij beide instellingen van boven de 90% naar 85,7%, een daling van 3 of 4 runs uit 63, dus de omvang is onzeker, maar de specifieke fouten zijn reëel. Tool calls per taak daalden van 2,52 naar 1,71. De totale benchmarkkosten daalden van $ 46,10 naar $ 44,01.
De inzichten. Stem de skill af op het model en snoei deze vervolgens. Een skill helpt waar het model een onderscheid miste: een functionaliteit die de server mist, een zoekbereik, een schrijfopdracht die de gebruiker al gedetailleerd heeft omschreven. Waar de toolnamen de keuze al duidelijk maken, komt een sterk model er alleen wel uit, en een brede regel kan werk afsnijden dat het anders zou hebben voltooid. Schrijf elke regel specifiek gericht op een duidelijke verwarring, en test elke nieuwe regel op uw sterkste model voordat u er op vertrouwt.
Zelfde opzet als de Linear-test. Eén variabele aangepast.
De taken. 21 Slack-prompts geschreven rond zoekbereik, threads, drafts en schedules, canvases, lijsten, uploads, ontbrekende functionaliteiten en toestemming. “Wat hebben we besloten?” kan een zoekopdracht door de hele workspace zijn, de laatste paar berichten in één kanaal, of de reacties onder een enkel bericht. “Verstuur dit” kan nu betekenen, een concept dat iemand nog moet goedkeuren, of een bericht dat morgen de deur uit moet. “Werk dit uit” kan een canvas, een lijst of een bestand zijn. We hebben deze taken gekozen omdat ze verwarrend zijn, waardoor ze moeilijker zijn dan gewoon Slack-verkeer.
De data. Slack-antwoorden kwamen uit een vastgelegde opname. Beide kanten zagen identieke data en schrijfacties bereikten nooit een echte workspace.
De modellen. Sonnet 4.6, Opus 4.8 en Fable 5, elk bij medium en high effort. Zes instellingen, drie runs per taak, elke keer in een schone workspace. 378 runs met de skill en 378 zonder.
De twee testgroepen.
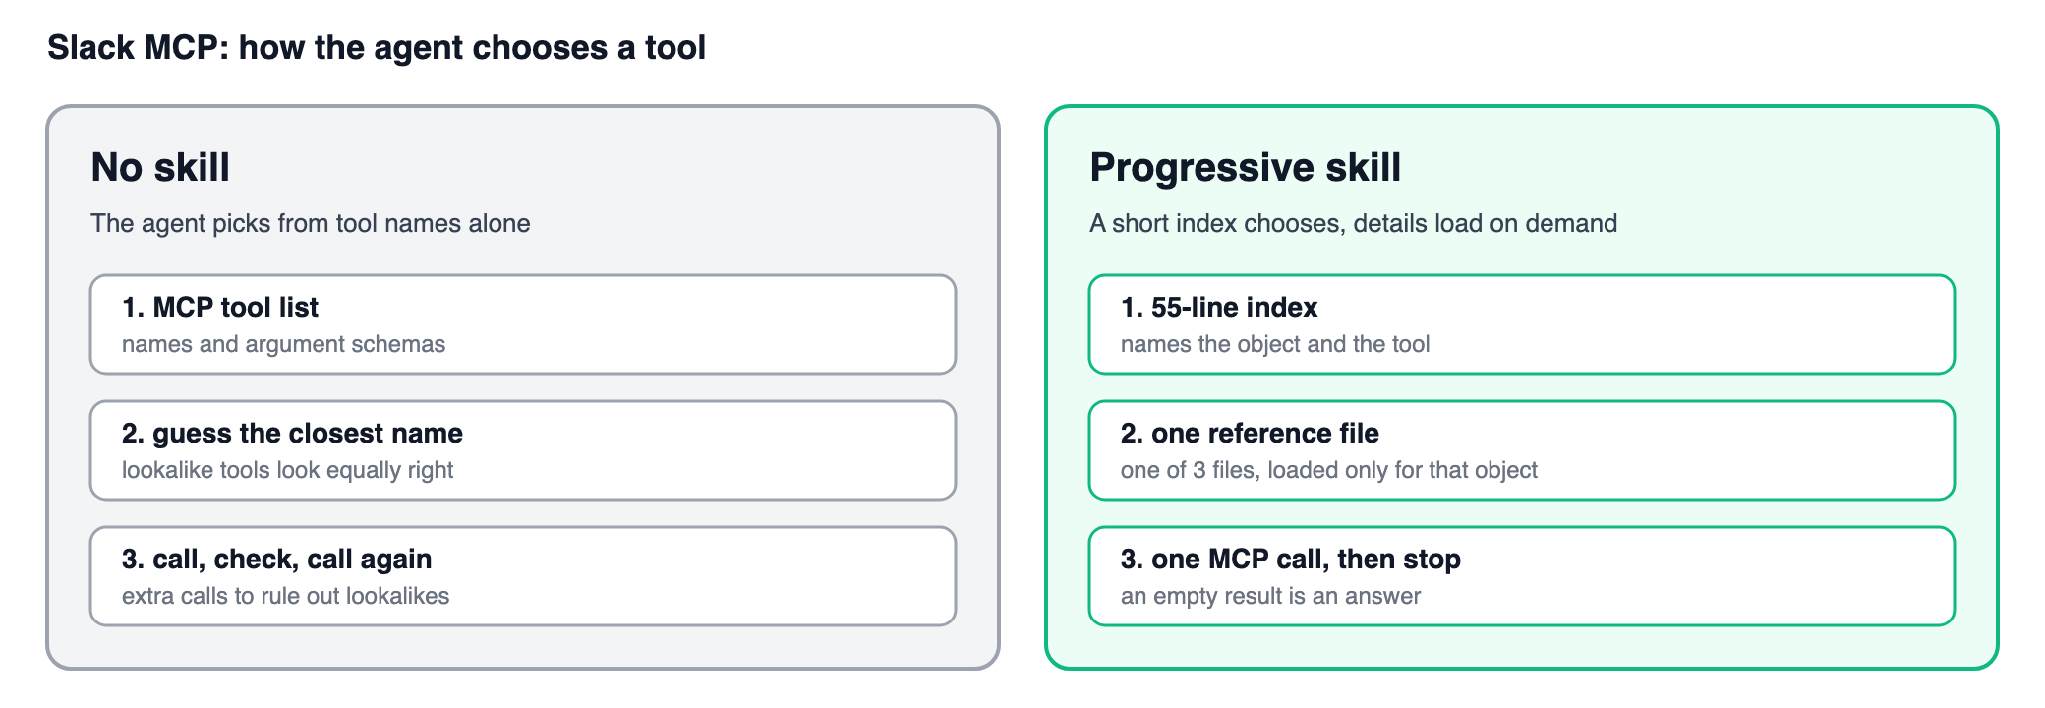
De skill. Een SKILL.md-index van 55 regels die de agent altijd leest. Het bevat de objecten, een snelle manier om daartussen te kiezen, een tabel met vergelijkbare opties en wat de server niet kan. Drie referentiebestanden (één voor zoeken, schrijven en artifacts) bevatten de details over de argumenten. Bij een typische taak bepaalt de agent waar de content zich bevindt (een onderwerp zonder vast honk is een zoekopdracht, recente berichten in één gesprek zijn kanaalhistorie, reacties onder één bericht zijn een thread), zet kanaalnamen om naar id's, opent indien nodig het referentiebestand van die categorie en voert één call uit om vervolgens te stoppen.
De beoordeling. Een taak slaagde alleen als de agent de juiste tools in de juiste volgorde koos, de veiligheidsregels respecteerde en een correct eindantwoord gaf. Een afzonderlijke Opus 4.8-beoordelaar beoordeelde het antwoord zonder te weten of er een skill aanwezig was. Drie runs per taak is een kleine steekproef, twee van de controlepunten worden door een model beoordeeld en replaying verwijdert de daadwerkelijke API-latency.
De taken, skills, beoordelingsregels en stappen voor reproductie staan in de openbare mcp-skillbench repository.
De algehele nauwkeurigheid veranderde licht, van 83,3% naar 86,5%. De interessante verschuiving zit per model.
Per model, per effort-niveau.
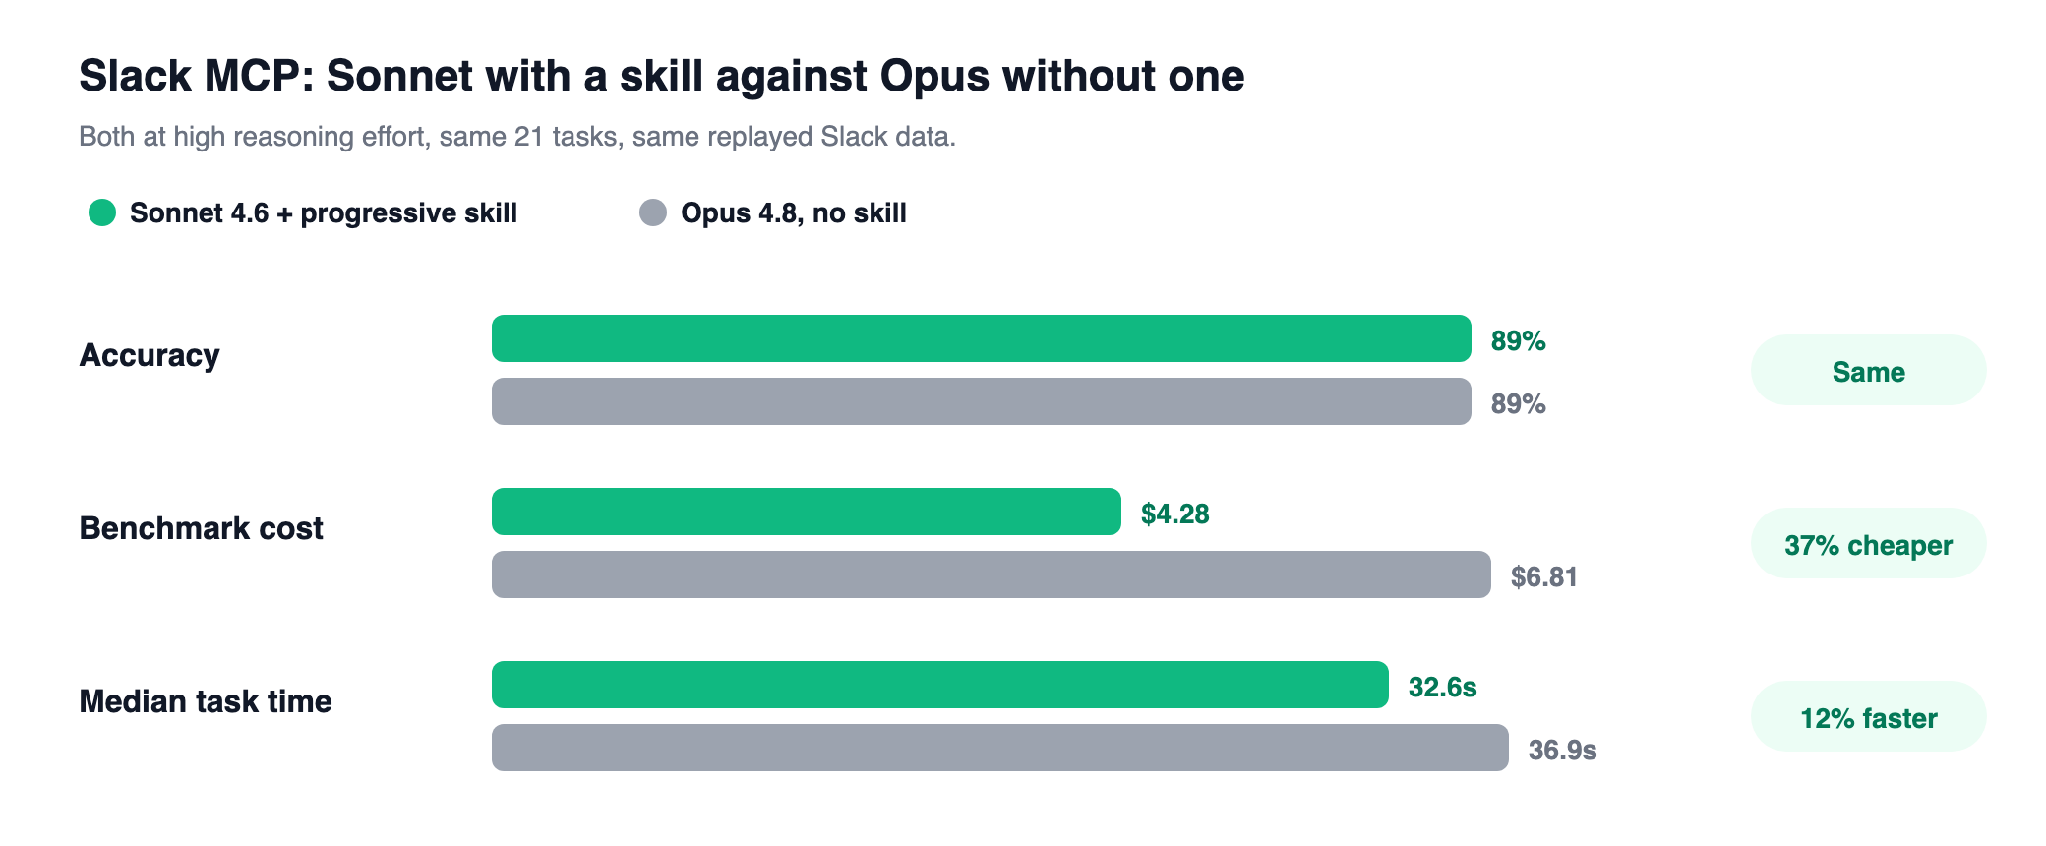
Het gemiddelde is het verkeerde getal om te onthouden. Sonnet bij high effort ging van 42 van de 63 naar 56 van de 63, de score die Opus behulde zonder skill, voor $ 4,28 tegenover $ 6,81 en een mediane taakduur van 32,6 seconden tegenover 36,9. Opus bleef wel de winnaar in de langzame piek. De daling van Fable betreft 3 of 4 runs uit 63 per instelling, wat dicht bij het bereiken van het maximum deels ruis kan zijn. De specifieke fouten hieronder zijn echter feitelijk. De exacte omvang van de daling is minder zeker.
Zonder skill was de agent al betrouwbaar bij de duidelijke combinaties. Versturen versus concept versus inplannen, een reactie toevoegen en uw eigen kanalen tonen gingen in beide gevallen bijna elke keer goed. Een paar taken waren anders, en dat is waar het kleinere model winst boekte.
De index-regels die hierachter zitten zijn kort:
Eén prompt, vier runs. “Wie is er lid van mcp-gateway?” De ledenlijst geeft user id's terug. Een nuttig antwoord zoekt die id's op en geeft namen. High effort in alle gevallen. Het enige verschil in elke rij is de skill.
Het kleinere model rondde het opzoeken van de namen alsnog af. Het grotere model volgde “doe één call en stop” en verbrak de taak voortijdig.
Twee andere prompts vertonen dezelfde overschrijving, beide bij Fable op high effort, beide van 3 uit 3 naar 1 uit 3. “Zoek met mijn toestemming in privékanalen en DM's naar __mcp_skill_eval_no_match__.” Een zoekopdracht inclusief privé was in beide gevallen de juiste tool. Zonder skill gebruikte de agent een filter voor privékanalen, groeps-DM's en DM's. De index geeft aan dat de zoekopdracht “privékanalen en DM's omvat”, en sommige skilled runs namen de zin letterlijk, lieten het filter weg en zeiden vervolgens dat DM's waren doorzocht. En “Lees de hele discussie onder [een link naar één bericht].” De eerste pagina bevat slechts een deel van de reacties, en agents presenteerden die pagina vaak als de volledige discussie. Dat was in beide gevallen lastig, en de skill maakte het erger.
In elk geval beschikte de agent over de juiste tool, of was het één lookup verwijderd van een afgerond antwoord. Vervolgens volgde het een korte algemene regel in de index letterlijker op dan het uit zichzelf zou hebben gedaan.
De index is klein en de referentiebestanden worden alleen geladen wanneer dat nodig is, waardoor de skilled agent iets minder input-tokens gebruikte dan de agent zonder skill. Het aantal tool calls daalde met ongeveer een derde, van 2,52 per taak naar 1,71, tegenover een kortste correcte pad van 1,24. Die besparing kwam grotendeels voort uit Sonnet, waarvan de runs zonder skill de neiging hadden om te zoeken, te lezen en opnieuw te zoeken. De mediaan werd iets sneller, van 37,6 seconden naar 35,1, en de langzaamste 5% daalde van ongeveer 75 seconden naar ongeveer 65. De volledige benchmark kostte $ 44,01 mét de skill en $ 46,10 zonder.
Sla een skill over voor routineuze leesacties op een sterk model. Als de agent draait op Opus of Fable en voornamelijk in openbare kanalen zoekt en geschiedenis leest, doet de toollijst het werk al. Een skill zal wat calls besparen. Het verhoogt de nauwkeurigheid mogelijk niet, en bij een model nabij de limiet kan het enkele pogingen kosten.
Voeg er een toe als een kleiner model gebruikt wordt, of als de taken te maken hebben met zoekbereik, een ontbrekende functionaliteit, of een schrijfopdracht die de gebruiker al gedetailleerd heeft omschreven. Sonnet bij high effort, dat van 66,7% naar 88,9% ging, is de reden dat we er een hebben geschreven. Op dat punt is de skill geen prompt-engineering detail meer. Het is het verschil tussen het wel of niet nodig hebben van Opus.
Snoei de skill vervolgens. Beperk de index tot het maken van de keuze, laad de details op aanvraag, en bekijk de taken die slechter scoorden. Als een regel werk afsnijdt dat het model al uit zichzelf deed, zoals het opzoeken van namen na het vermelden van leden, maak de regel dan specifieker of verwijder deze. Een kortere skill is makkelijker op te volgen. Dat geldt ook voor de momenten waarop het niet had moeten worden opgevolgd.
Test elke nieuwe regel op uw sterkste model voordat u er op vertrouwt. Bij het kleinere model ziet u de winst. Bij het sterkste model ziet u waar regels goed gedrag overschrijven.
Een skill verandert welke Slack-tool wordt aangeroepen. Het bepaalt niet wie privékanalen mag doorzoeken, welke token de call gebruikt, of wat er gelogd wordt.
De TrueFoundry Skills Registry houdt een skill zoals deze versiebeheerd en gedeeld. Een skill bevindt zich in een repository naast prompts en modellen. De repository bepaalt wie deze kan ontdekken, bewerken en koppelen, en houdt de versiegeschiedenis en het audit-logboek bij. Elke publicatie is een genummerde versie, dus wanneer u een regel aanscherpt die voor een achteruitgang zorgde, neemt elke agent dezelfde fix over. Ook kan een agent worden vastgezet op een oudere versie als een nieuwe publicatie ongewenst gedrag vertoont. Dezelfde versie kan worden gekoppeld aan een TrueFoundry-agent of worden opgehaald in Claude Code en Cursor. Deze Slack-skill is een index plus drie referentiebestanden, dus het wordt gepubliceerd als een bundel via de CLI of via GitOps met tfy apply.
De TrueFoundry MCP Gateway bevindt zich vóór de Slack MCP-server. Het beheert authenticatie, toegangscontrole op tool-niveau en een trace van elke call. De overhead is ongeveer 3 tot 4 ms en het verwerkt 350+ requests per seconde op één vCPU. Deze benchmark maakte gebruik van een lokale replay, dus het zegt niets over de gateway. De skill kiest de call. De gateway bepaalt of die call is toegestaan.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



On Sonnet, yes. At high effort, Sonnet with a skill reached 88.9% (56 of 63), the same as Opus with no skill, for about a third less money and a faster median task. Opus with the skill was 87.3% (55 of 63). At medium effort, Sonnet rose from 74.6% to 84.1%, and Opus stayed at 87.3%. Across all models, accuracy rose from 83.3% to 86.5%. Fable moved from above 90% to 85.7%, a few trials out of 63.
The model was already right, and a general rule in the skill overrode it. On “Who is a member of mcp-gateway?”, Opus at high effort passed 3 of 3 without a skill and 0 of 3 with one, because “make one call, then stop” ended the work before the name lookup. On the private-channel search, the index says the tool “includes private channels and DMs,” so some skilled agents dropped the DM filter and still reported that DMs were covered.
On this workload, for the smaller model at high effort, yes. Sonnet with the skill matched Opus without one at 37% lower cost. That will not hold for every workload, and the slow tail still favored Opus, but it is the first thing to test before paying for the larger model by default.
Ja. De agent met de skill deed ongeveer een derde minder tool-aanroepen en gebruikte iets minder inputtokens. De volledige run kostte $44,01 met de skill en $46,10 zonder.
Ja. Het omvat een MCP Gateway, een Agent Gateway, en een MCP en Agents Register met toegangscontrole op toolniveau, zodat agents van LangGraph, CrewAI, AutoGen, of een aangepast framework centraal kunnen worden gereguleerd.
About 3 to 4 ms, at 350+ requests per second on a single vCPU.



Het laatste nieuws, artikelen en bronnen in je inbox



















