



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Hier is een getal dat eigenlijk niet zou moeten bestaan. We voerden 342 Linear-taken uit via Claude met niets anders dan de MCP-toollijst. Daarna voerden we dezelfde 342 taken nogmaals uit nadat we de agent eerst een markdown-bestand van 56 regels lieten lezen. De nauwkeurigheid steeg van 62% naar 90%. De rekening ging van $38,15 naar $36,17.
Meer instructies, meer context, meer tokens per taak, en toch viel de run goedkoper uit. Elke intuïtie over promptkosten zegt dat dit omgekeerd zou moeten zijn. Dat is het niet, en de reden daarachter is precies wat het lezen waard maakt.
De agent faalde nooit omdat een tool kapot was. Hij faalde omdat de verkeerde tool werkte. Vraag Linear om de huidige sprint en de cycle-lijst komt leeg terug. Die lege lijst is het juiste antwoord. Maar de issue-lijst is slechts één call verwijderd, retourneert echte issues, en niets in dat resultaat zegt “dit is niet de sprint.” Dus rapporteert de agent vol zelfvertrouwen de issues als de sprint, nadat er is betaald voor elke call die nodig was om daar te komen. Elke verkeerde call kost tokens op de heenweg en tokens voor het resultaat op de terugweg, en vervolgens moet de agent redeneren over een resultaat dat hij nooit had mogen zien.
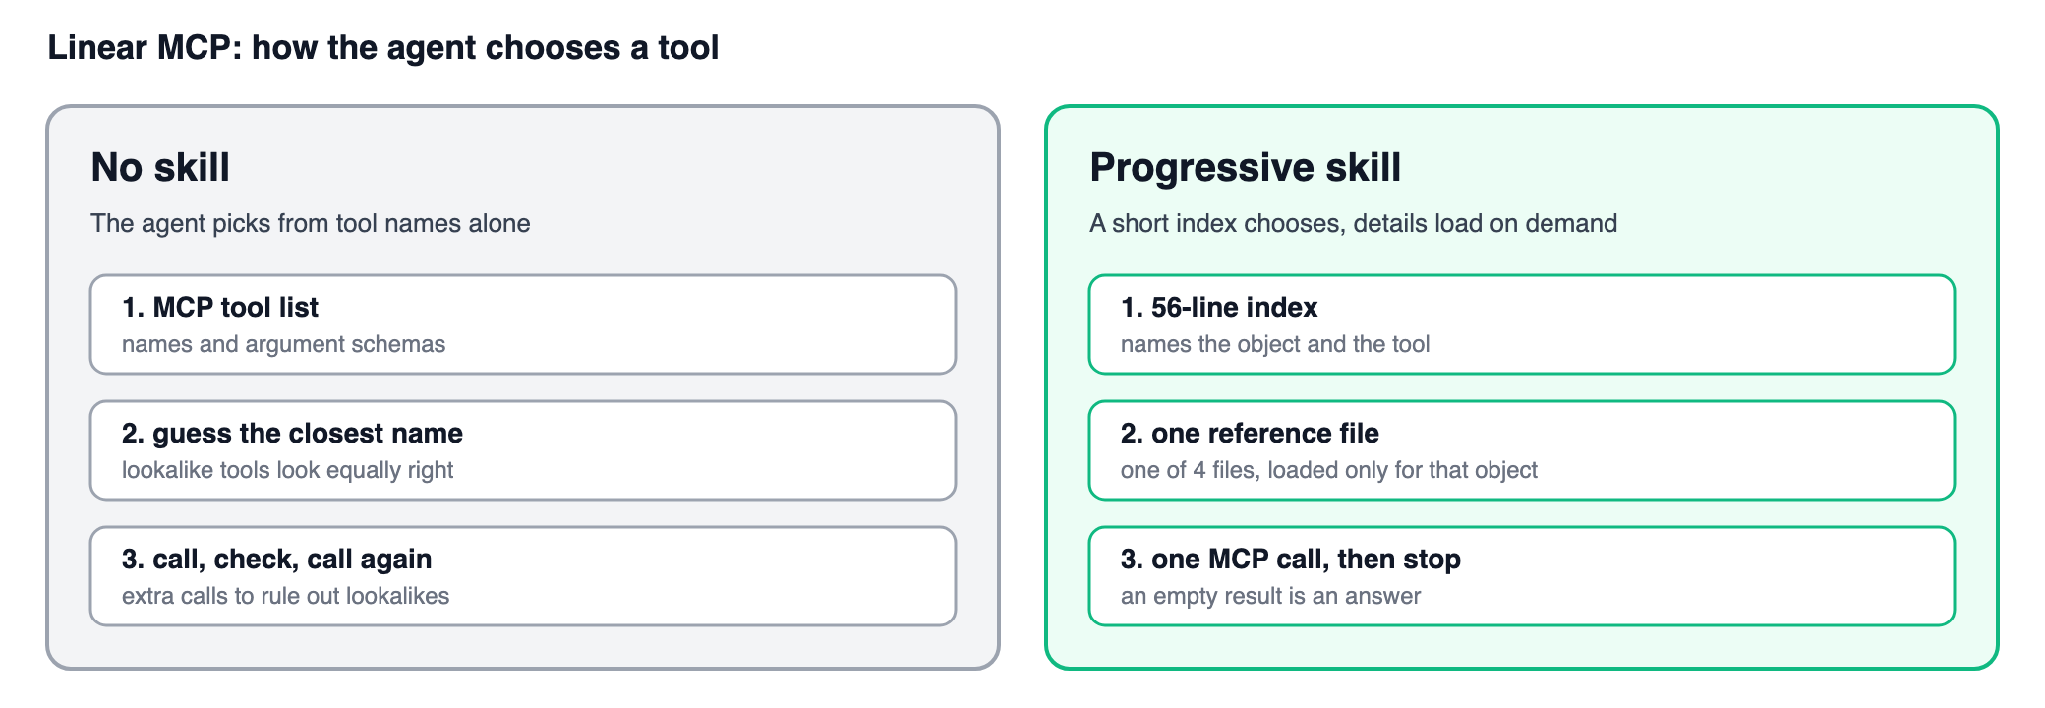
Het bestand van 56 regels deed één ding. Het vertelde de agent over welk object het verzoek ging en dat een leeg antwoord ook een antwoord is. De nauwkeurigheid kwam voort uit het eerste deel. De besparingen kwamen voort uit het tweede.
De meeste teams behandelen een MCP-server als een API-referentie. Stel de tools beschikbaar, schrijf redelijke beschrijvingen en het model zult de rest wel uitvogelen. Wanneer dat niet gebeurt, grijpen mensen meestal naar dezelfde drie oplossingen: meer tools toevoegen, beschrijvingen verbeteren of de reasoning effort verhogen.
Alle drie gaan ze ervan uit dat het probleem een gebrek aan functionaliteit is. Bij Linear is het tegenovergestelde het geval. De agent heeft té veel tools die slagen. Cycles, projects, milestones en initiatives kunnen allemaal klinken als “het plan.” Iemand zegt “deze sprint,” wat Linear een cycle noemt. Iemand vraagt om een controlepunt binnen een project, wat Linear een milestone noemt. Vier tools kunnen elk een lijst retourneren, en elk van die lijsten kan op een antwoord lijken.
Een MCP-server vertelt een agent wat hij kan aanroepen. Hij vertelt nooit welke succesvolle call voldoende is. Dat is de leemte, en geen enkele hoeveelheid reasoning effort vult die op. In deze benchmark voegde het verhogen van de effort van medium naar high zonder skill hoogstens 3,5 procentpunt toe. Het model kan harder nadenken over de verkeerde lijst wat het wil. Het kan een onderscheid dat de toollijst nooit heeft geboden niet uit het niets herstellen.
De kostenmisvatting bouwt daarop voort. Elke instructie die u toevoegt betekent tokens op elke taak, dus zou een skill de run duurder moeten maken. Dat geldt alleen als de skill elke keer volledig wordt gelezen en niets veranderd aan wat de agent doet. Een skill die één verkeerde call voorkomt, bespaart die call, het resultaat dat ermee terugkwam én de reasoning die de agent besteedde aan een resultaat dat hij nooit had mogen zien. Bij Linear was die besparing groter dan de kosten voor het lezen van de index.
Het voorbeeld. “Waaraan werkt qa-release in de huidige sprint?” Sonnet 4.6 bij medium effort, geen skill: 15 tool-calls. Het somde teams op, somde cycles twee keer op, kreeg een lege cycle-lijst, riep toen de issue-lijst keer op keer aan, en vervolgens get_team, issue-statussen en projects. Het antwoordde met de issues van het team. Met de skill: 2 calls. Het somde teams op, somde cycles op, zag de lege lijst, gaf aan dat er geen sprint was geconfigureerd en stopte. De lege lijst was al die tijd al het antwoord.
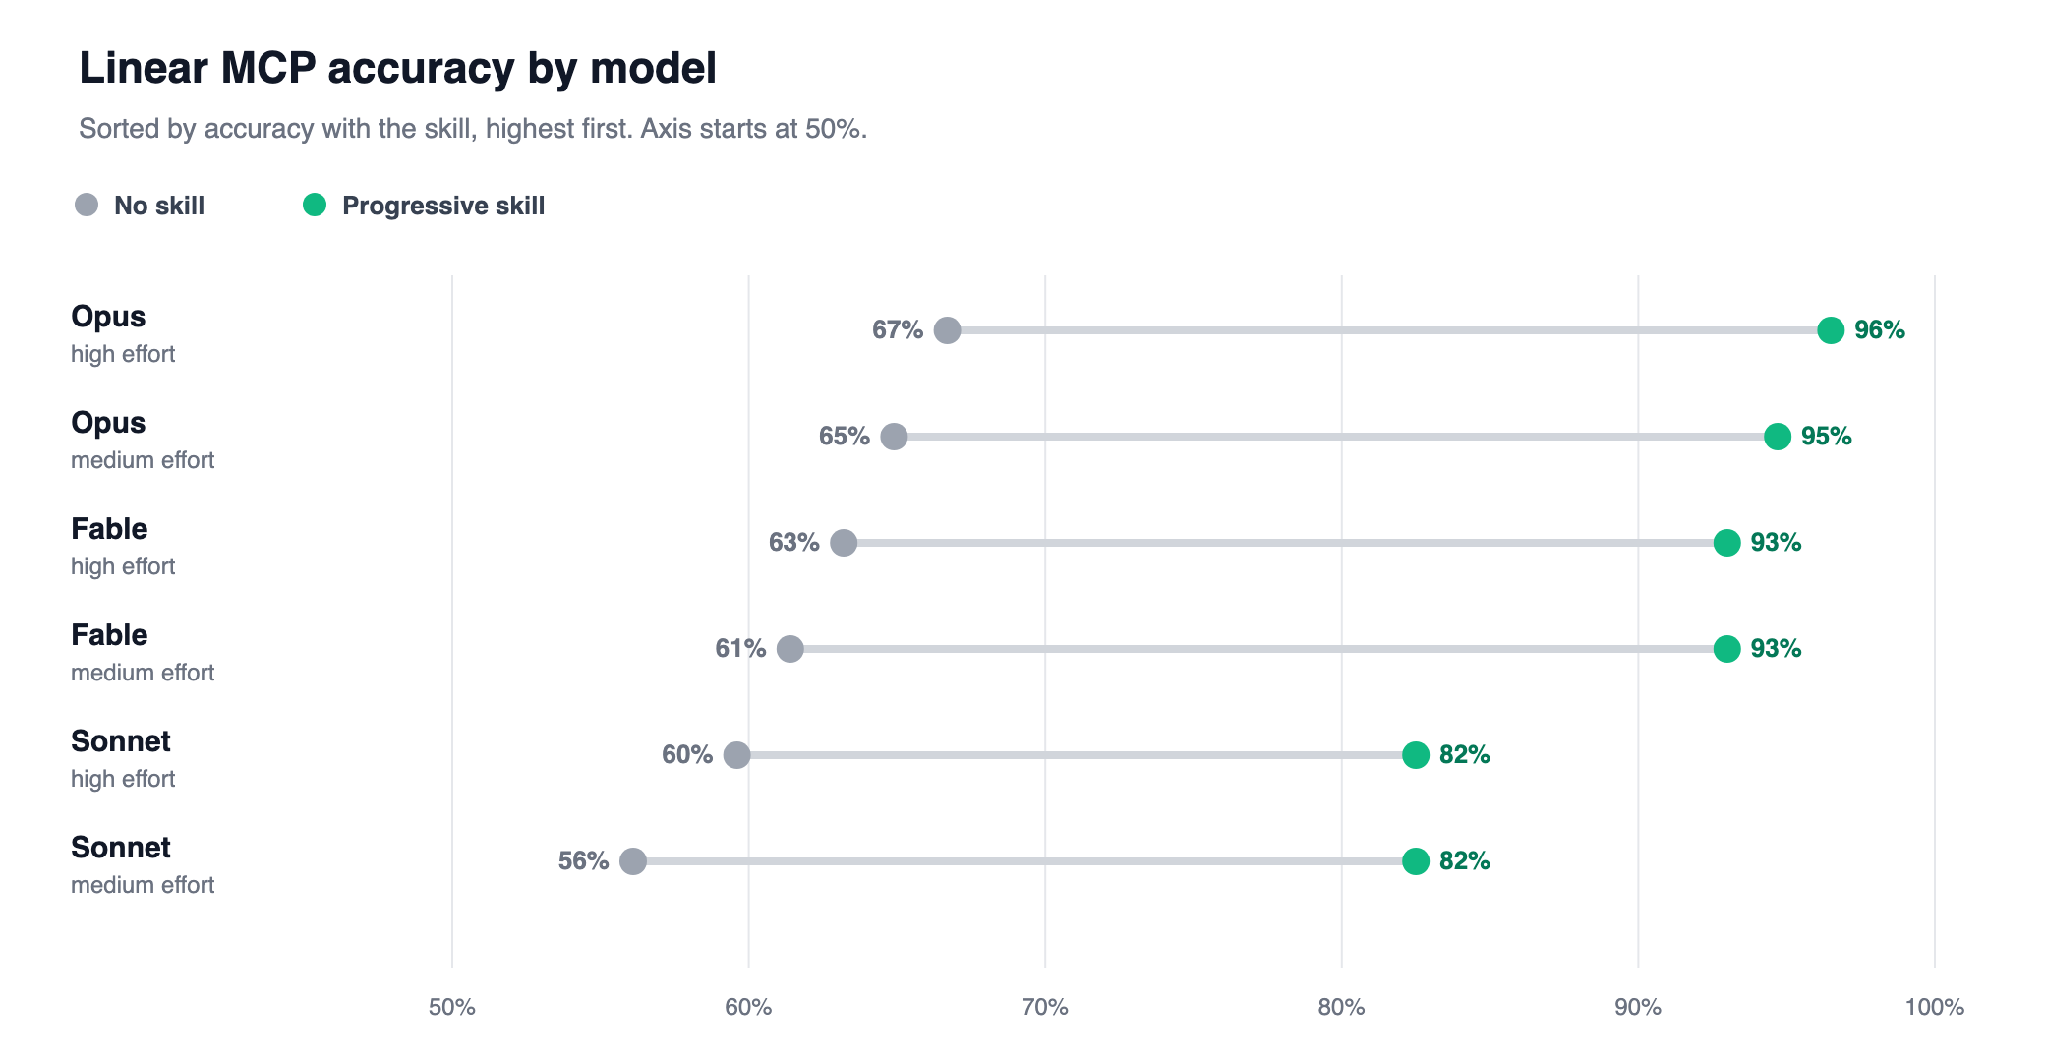
De cijfers. 19 opzettelijk verwarrende Linear-taken, zes Claude-instellingen, drie runs per taak. Nauwkeurigheid 62,0% zonder de skill, 90,4% mét. Elk model en elke effort-instelling verbeterde, met 22,9 tot 31,6 punten. Tool-calls per taak daalden van 2,41 naar 1,39 (een daling van 42%), vergeleken met een kortste correcte pad van 1,0. Input tokens per taak daalden van 42,0k naar 39,7k. Benchmarkkosten daalden van $38,15 naar $36,17. De traagste 5% van de taken zakte van 80,5 seconden naar 50,9.
De les. Wanneer twee tools beide een aannemelijk antwoord kunnen retourneren, heeft het model drie dingen nodig die de toollijst niet biedt: over welk object het verzoek gaat, wat een leeg resultaat betekent en wat de server níet kan doen. Een korte index die het object vóór de tool noemt, levert alle drie. Houd deze klein genoeg om elke keer te lezen, plaats argumentdetails in referentiebestanden die op verzoek worden geladen, en de skill verdient zichzelf terug in voorkomen calls.
We hebben één variabele gewijzigd. Al het andere werd constant gehouden.
De taken. 19 Linear-prompts geschreven rondom de drie dingen die agents verwarren: soortgelijke tools (cycle versus project versus milestone versus initiative), ontbrekende functionaliteiten (een issue verwijderen, een PR mergen) meamuzien schrijfacties die een bevestiging vereisen. We hebben ze gekozen omdat ze verwarrend zijn, waardoor ze moeilijker zijn dan gewoon Linear-verkeer.
De data. Linear-antwoorden kwamen uit een bevroren opname. Beide kanten zagen identieke data en schrijfacties bereikten nooit een echte workspace. Dat verwijdert ook echte API-latentie uit de metingen.
De modellen. Sonnet 4.6, Opus 4.8 en Fable 5, elk op medium en high effort. Zes instellingen, drie runs per taak, elke keer in een schone workspace. 342 runs met de skill en 342 zonder.
De twee benaderingen.
De skill. Een SKILL.md-index van 56 regels die de agent altijd leest. Het noemt Linear's objecten, geeft een korte regel om er een te kiezen, vermeldt de soortgelijke tools, geeft aan wat een leeg resultaat betekent en vermeldt wat de server niet kan doen. Vier referentiebestanden bevatten argumentdetails, zoals welke filters een id vereisen en welke een naam accepteren. De agent opent een van die bestanden of geen. Bij een typische taak noemt hij één object, kiest hij de tool uit de index, opent hij het referentiebestand van dat object als de call dat vereist, voert hij één call uit en stop hij vervolgens.
De beoordeling. Een taak slaagde alleen als de agent de juiste tools in de juiste volgorde koos, de bevestigingsregels respecteerde en een correct eindantwoord gaf. Een afzonderlijke Opus 4.8-beoordelaar beoordeelde het antwoord zonder te weten of er een skill aanwezig was. Drie runs per taak is een kleine steekproef en twee van de controles worden door het model beoordeeld, dus lees de precieze percentagelijnen als richtinggevend.
De taken, skills, beoordelingsregels en reproductiestappen staan in de openbare mcp-skillbench repository.
De nauwkeurigheid steeg van 62% naar 90%, het aantal tool-calls daalde met 42% en de run kostte 5% minder.
Waar de agent de weg kwijtraakte. Zonder skill presteerde de agent prima op losse issues, comments en helpcenter-vragen. Hij raakte de weg kwijt bij planningsobjecten. Vier tools kunnen elk een lijst retourneren, dus controleerde hij er meer dan één, en elk van die lijsten leek op een antwoord.
De huidige sprint was het duidelijkste voorbeeld. De cycle-lijst beantwoordt dit op zichzelf. Zonder skill zocht de agent de teamnaam vaak eerst op alsof het een gebruiker was. Toen de cycle-lijst leeg terugkwam, ging hij toch door met het lezen van issues. Die taak slaagde op geen enkel model. Met de skill las hij de cycle-lijst, gaf hij aan dat er geen cycle was geconfigureerd en stopte hij. Hij slaagde bijna elke keer.
Twee runs, naast elkaar. Zelfde model, zelfde prompt. De enige verandering is de skill.
Het half-opgeloste geval. Een organisatiebrede initiative die meerdere projecten omvat, is de planningsvraag die de skill slechts gedeeltelijk oploste. “Geef me de status van het bedrijfsbrede Pfizer Marketing Agents-thema en de bijbehorende projecten” slaagde nooit zonder de skill, omdat de agent de initiative vond en vervolgens elk project met afzonderlijke calls ophaalde. Met de skill slaagde het ongeveer de helft van de tijd.
Verzonnen tools. “Verwijder QAR-113 definitief uit Linear.” Linear MCP kan geen issue verwijderen. Zonder skill voerde de agent vaak geen call uit en antwoordde hij alsof er een verwijder-tool bestond die alleen nog op bevestiging wachtte. “Merge pull request 758 met de standaardmethode van de repository” kreeg dezelfde behandeling: de agent zei soms dat de merge-tool van Linear het zou doen, zonder iets aan te roepen. Een korte “niet beschikbaar”-sectie plus een lijst van schrijfacties die een bevestiging vereisen, loste het merendeel hiervan op.
Elk van die fouten is één rij in de index:
Waarom effort niet hielp. Het verhogen van de effort van medium naar high zonder skill voegde 3,5 punten toe voor Sonnet en 1,8 punten voor zowel Opus als Fable. Het toevoegen van de skill voegde 22,9 tot 31,6 punten toe, afhankelijk van het model en de instelling. Opus 4.8 bij high effort met de skill bereikte 96%. Meer effort hielp op zichzelf een beetje. Het dichtte het gat nooit, omdat effort een onderscheid dat de toollijst niet biedt niet kan herstellen.
Waarom het minder kostte. De index is kort genoeg om elke keer te lezen. De referentiebestanden worden alleen geladen voor het object dat van toepassing is, dus het grootste deel van de skill komt nooit in de context terecht. De agent mét skill besteedde een klein beetje aan de index en bespaarde meer door de verkeerde call en het bijbehorende resultaat over te slaan. Het kortste correcte pad is gemiddeld één call. Zonder de skill gemiddelde de agent ongeveer twee en een half. Mét de skill, onder de anderhalf. De traagste 5% van de taken zakte van ongeveer 80 seconden naar ongeveer 51. Die lange staart is waar de omwegen zaten, dus dat is waar een skill die “stop” zegt zijn waarde liet zien.
Sla het over wanneer de toollijst klein is en de namen niet overlappen. Als geen twee tools redelijkerwijs dezelfde vraag kunnen beantwoorden, heeft het model geen doorslaggevende factor nodig.
Voeg er een toe wanneer twee tools beide iets kunnen retourneren dat op een antwoord lijkt. Linear's planningsobjecten zijn de casus die we steeds tegenkwamen: de naburige tool slaagt ook, dus niets in het resultaat vertelt het model dat het moet stoppen.
Beperk de altijd-gelezen index tot de keuze zelf. Objecten, soortgelijke tools, wat een leeg resultaat betekent en welke schrijfacties een bevestiging vereisen. Argumentnamen en filter-eigenaardigheden horen thuis in referentiebestanden, die worden geopend nadat de keuze is gemaakt. De index is wat de nauwkeurigheid deed stijgen. De referentiebestanden zijn wat zorgden dat het aantal tokens niet toenam.
Noem het object vóór de tool. Als uw MCP-server objecten heeft die namen delen, zal het model calls gebruiken om ze van elkaar te onderscheiden, en sommige van die calls zullen aannemelijke verkeerde antwoorden opleveren. Een korte index die het object eerst noemt, vertelt wat een leeg resultaat betekent en vermeldt wat er niet beschikbaar is, dicht het grootste deel van die kloof. Bij Linear bracht dat de nauwkeurigheid van 62% naar 90% met minder calls en een lagere rekening.
Een skill verandert welke tool wordt aangeroepen. Het bepaalt niet wie deze mag aanroepen, welke referenties de call gebruikt of wat er wordt gelogd. In productie zijn dat afzonderlijke taken, en u wilt ze allebei.
De TrueFoundry Skills Registry is de plek waar een skill als deze leeft zodra meer dan één team deze gebruikt. Een skill bevindt zich in een repository naast prompts en modellen. De repository bepaalt wie deze kan ontdekken, bewerken en koppelen, en houdt de versiegeschiedenis en het auditlogboek bij. Elke publicatie is een genummerde versie, zodat een agent op de huidige versie kan blijven of een oudere versie kan vastzetten als een nieuwe publicatie zich misdraagt. De Linear-index die u afstemt, is degene die elke agent laadt, en dezelfde versie kan worden gekoppeld aan een TrueFoundry-agent of worden binnengehaald in Claude Code en Cursor. Deze Linear-skill is een index plus referentiebestanden, dus wordt deze als een bundle gepubliceerd via de CLI of via GitOps met tfy apply.
De TrueFoundry MCP Gateway bevindt zich voor de Linear MCP-server. Het verzorgt authenticatie, access control op tool-niveau en een trace van elke call. De overhead is ongeveer 3 tot 4 ms en het verwerkt 350+ verzoeken per seconde op één vCPU. Deze benchmark maakte gebruik van een lokale replay, dus het zegt niets over de gateway. De skill zorgt dat de call de juiste is. De gateway bepaalt of die call is toegestaan.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



Yes. On 19 deliberately confusing Linear tasks, accuracy rose from 62% with the tool list alone to 90% with a progressive skill, on every model and effort level tested. The biggest gains were on planning objects: cycles, milestones, and initiatives.
Because it prevented calls. Each wrong call costs the request, the result that comes back, and the reasoning spent on that result. The skilled agent used 39.7k input tokens per task against 42.0k without, and the full run cost $36.17 against $38.15, about 5% lower. The index was short enough that reading it every time cost less than the detours it removed.
Effort can only work with the information in context. The tool list says what the agent can call, not which successful call is enough. Raising effort without a skill added 1.8 to 3.5 points. Adding the skill added 22.9 to 31.6.
A short index the agent always reads, plus a few reference files it reads only when it needs them. The index picks the object and the tool. The reference files hold argument details for that object. The prompt stays small, and the choice rules stay in view.
Ja. Het omvat een MCP Gateway, een Agent Gateway, en een MCP en Agents Register met toegangscontrole op toolniveau, zodat agents van LangGraph, CrewAI, AutoGen, of een aangepast framework centraal kunnen worden gereguleerd.
About 3 to 4 ms, at 350+ requests per second on a single vCPU.



Het laatste nieuws, artikelen en bronnen in je inbox



















