November 2, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.



Blazingly fast way to build, track and deploy your models!
TypeSafe AI هي مختبر للذكاء الاصطناعي أسسه ديوغو ألميدا — الذي عمل سابقاً في OpenAI وشارك في أبحاث اتباع التعليمات التي أدت إلى تطوير ChatGPT — إلى جانب إريك غافني وساشا شينغ. بعد حوالي عامين من العمل في الخفاء، نشرت الشركة بيان إطلاقها في 15 سبتمبر 2026، بالتزامن مع جولة تمويل أولية بقيمة 40 مليون دولار بقيادة DCVC. وقد غطت منصة DataCamp والعديد من المجلات التجارية هذا الخبر في الأيام التالية.
تتمحور صياغة بيان الإطلاق حول تساؤل بدلاً من كونه معياراً للأداء: لقد كانت النماذج تتفوق على البشر في المحادثة لسنوات، فأين كل هذا الأتمتة؟ إجابة TypeSafe هي أن عنق الزجاجة لم يكن يوماً في الذكاء الخام، بل في أن النموذج الذي يرد بالنثر يعد مكوناً غير ملائم لبناء البرمجيات فوقه. وتوضح الشركة ذلك بشكل أكثر صراحة في بيانها: لقد تم تدريب الذكاء الاصطناعي الحالي على افتراض وجود إنسان في الطرف الآخر منه.
Jev هو أول نموذج تم بناؤه على هذا الأساس. يأتي الاسم من ويليام ستانلي جيفونز، الذي تنص مفارقته على أن انخفاض التكلفة يؤدي إلى زيادة الاستهلاك؛ أما "النظام الأول" (System One) فهو إشارة إلى مفهوم دانيال كانيمان عن التفكير السريع والبديهي، تمييزاً له عن التفكير البطيء والمتأني في "النظام الثاني".
من بين أنواع نماذج الذكاء الاصطناعي التي قد تستخدمها في بيئة الإنتاج، يتميز هذا النموذج بما يتخلى عنه. فنموذج المحادثة يعيد سلسلة نصية، وهذه السلسلة يمكن أن تكون أي شيء — إجابة، أو رفضاً، أو فقرة من التفكير، أو حتى نصاً مشوهاً يعجز محلل البيانات لديك عن معالجته. أما Jev فلا يعيد سلاسل نصية على الإطلاق.
بدلاً من ذلك، تقوم أنت بتحديد شكل الإجابة مسبقاً: الحقول التي تريدها، والقيم المسموح لكل حقل باتخاذها. يعيد النموذج تلك الحقول مملوءة، مع إرفاق احتمالية لكل منها. تصف TypeSafe النتيجة بأنها استدعاء دالة ذكاء متطور — حالة غير مهيكلة تدخل، وقرارات احتمالية محددة النوع تخرج. من الناحية العملية، يعمل النموذج كـ محرك قرارات ذكاء اصطناعي يمكنك استدعاؤه من سطر برمجي.
ينتج عن هذا التصميم ثلاث خصائص:
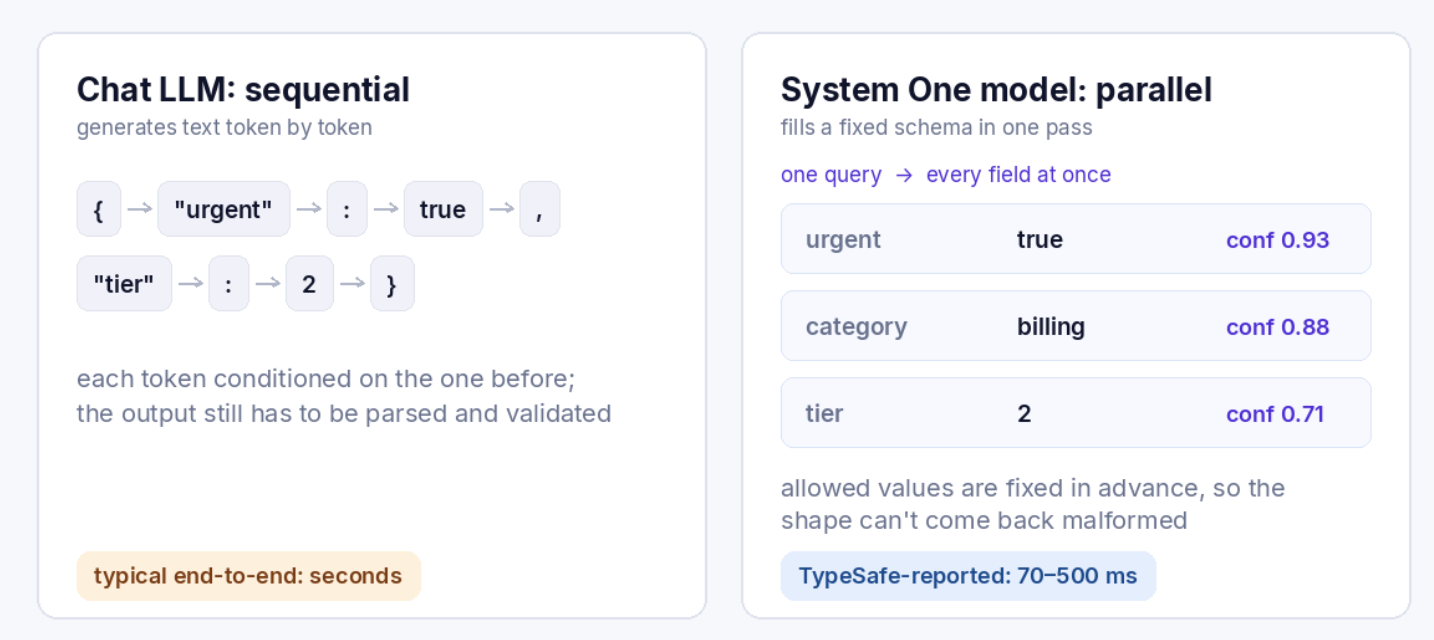
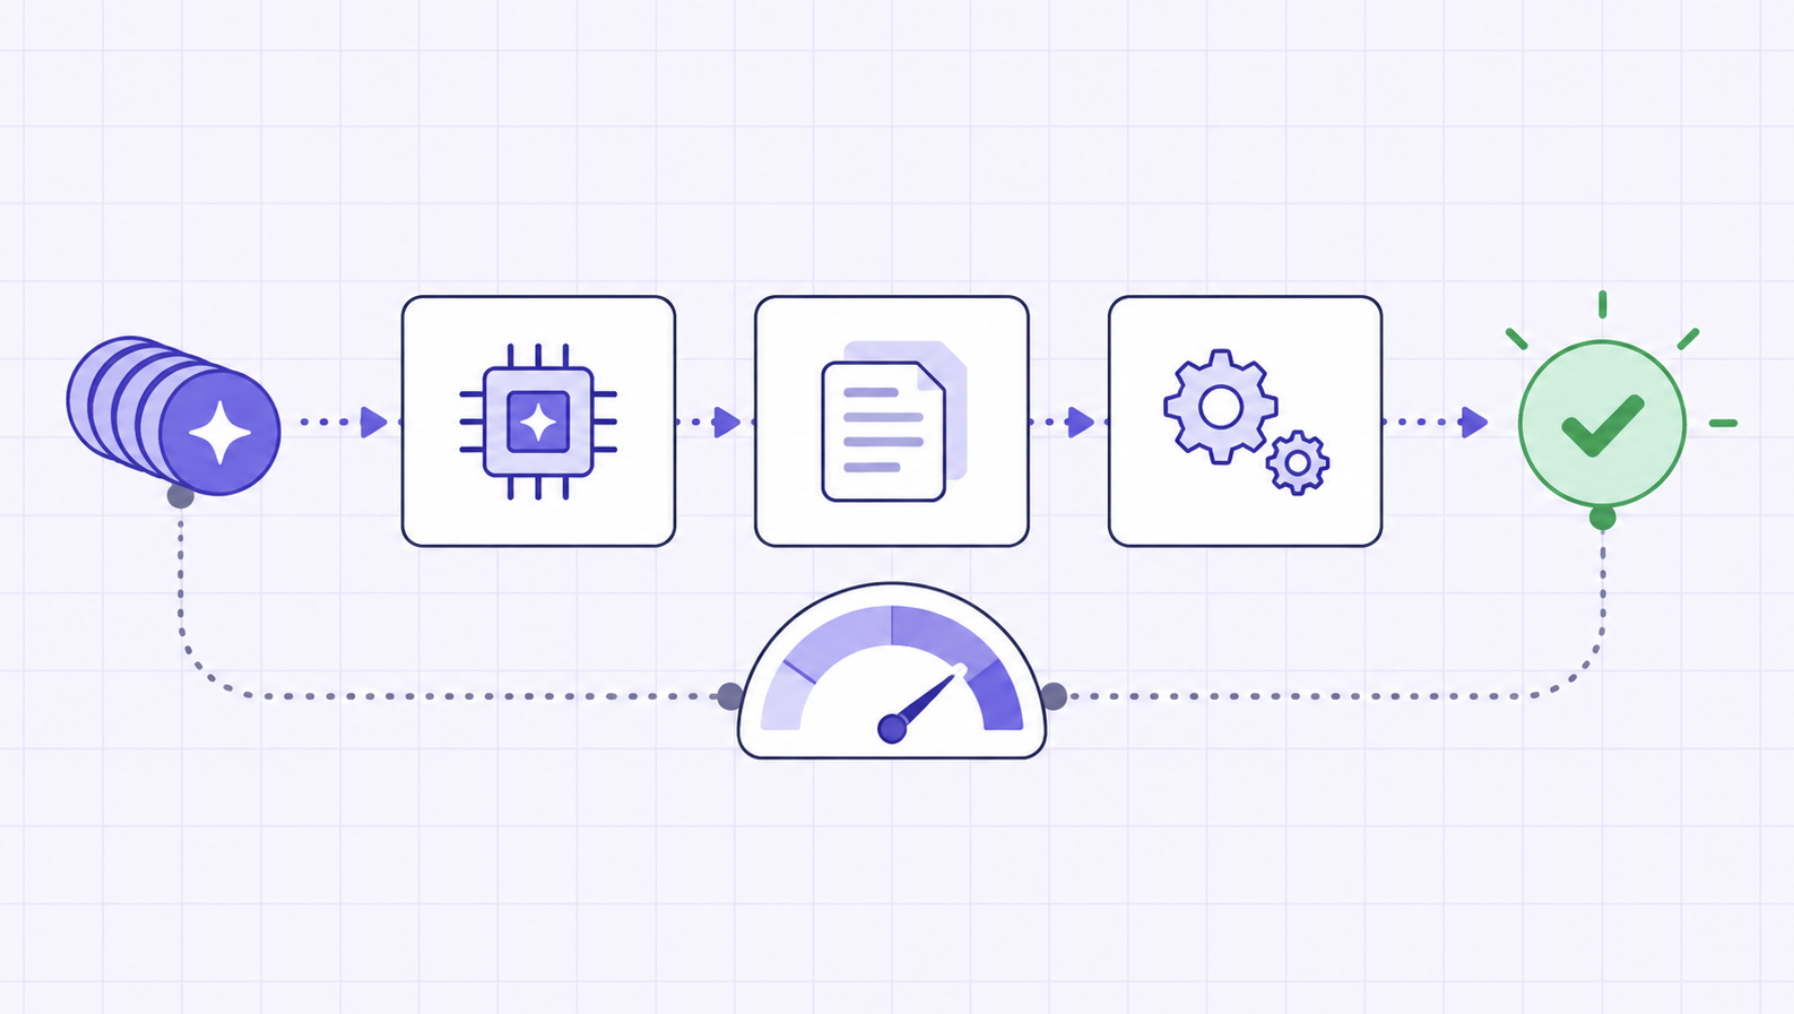
يبني نموذج اللغة الكبير (LLM) المخصص للدردشة إجابته رمزاً برمز، بينما يقوم نموذج "النظام الأول" بملء كل حقل من مخطط ثابت في تمريرة واحدة، مع إرفاق درجة ثقة لكل حقل.
تعد هذه الخاصية الثالثة هي الأكثر عرضة للتقليل من شأنها. فالنموذج الذي يصيب في 95% من الحالات لكنه لا يستطيع تحديد الحالات التي تقع ضمن الـ 5% المتبقية لا يمكن أتمتة العمل حوله. أما النموذج الذي يبلغ عن عدم اليقين بصدق فيمكن ذلك؛ إذ يمكنك اتخاذ قرارات متفرعة بناءً على درجة الثقة وتوجيه الحالات ذات الثقة المنخفضة إلى عنصر بشري أو نموذج أكبر.
هناك حد عملي يستحق المعرفة: يدعم Jev عدداً يصل إلى 255 خياراً لكل اختيار. وما يتجاوز ذلك، تستخدم TypeSafe نهجاً من مرحلتين — تقييم المرشحين بشكل مستقل، ثم اتخاذ خيار صريح — وهو نهج تقر الشركة بأنه أبطأ.
هذا الجزء يستحق التمهل، لأن أرقام الإطلاق كبيرة بشكل غير معتاد والأدلة التي تدعمها مكتفية ذاتياً بشكل غير مألوف. ويُحسب لشركة TypeSafe أنها أدرجت في منشورها ملاحظات "توضيحية" خاصة بها تحت كل نتيجة، وهو المصدر الذي استُمد منه معظم ما يلي.
يمكن التحقق منه بشكل مستقل اليوم:
تم الإبلاغ عنها ذاتياً ولم يتم التحقق منها بشكل مستقل بعد:
لا يزال غير معروف: الأداء في الاختبارات المعيارية العامة، والسلوك في المهام التي لا تتسم بطبيعة اتخاذ القرار الواضحة، والدقة في العمل المتخصص في مجالات معينة عند استخدامه من قبل أطراف أخرى، وأي معلومات حول الموثوقية في بيئات الإنتاج واسعة النطاق. لم يبدأ الوصول المبكر إلا هذا الأسبوع.
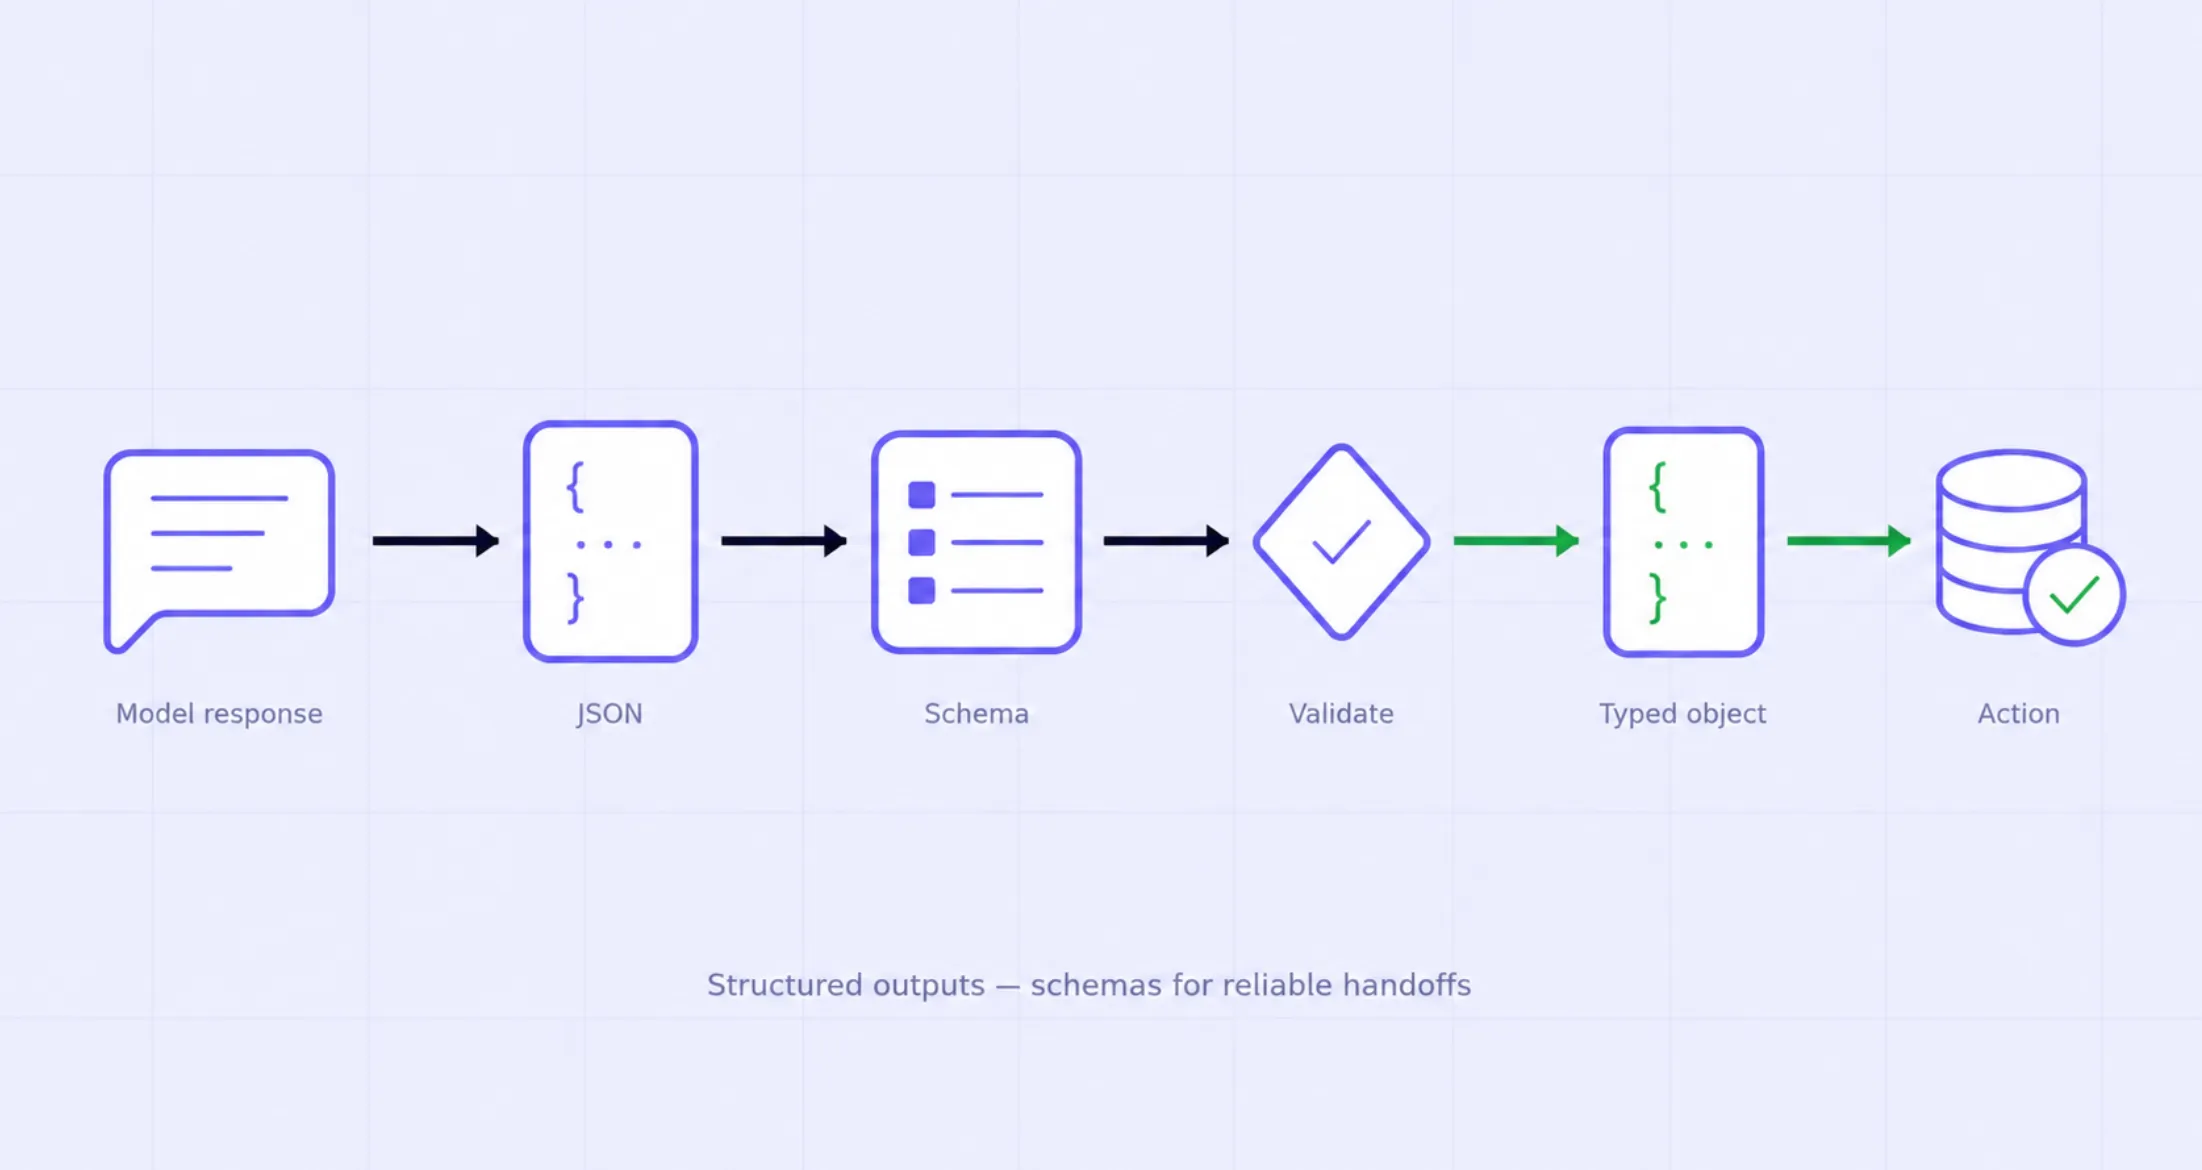
هناك أيضاً مسألة صياغة تستحق الدقة، لأنها ستُبسط بشكل مخل في الملخصات. تقول TypeSafe إن Jev لا يمكنه الهلوسة، وهذا صحيح بالمعنى الضيق: فالنموذج الذي لا ينتج نصاً حراً لا يمكنه اختلاق مرجع أو اسم أداة. لكن هلوسة النماذج اللغوية الكبيرة وصحة المعلومات ليسا نفس المشكلة. فالنموذج المقيد بثلاث فئات مسموح بها لا يزال بإمكانه اختيار الفئة الخاطئة بثقة؛ فما تم القضاء عليه هو الإجابة غير المنسقة، وليس الحكم الخاطئ. المعايرة هي رد TypeSafe على ذلك، والمعايرة هي بالضبط الادعاء الذي يحتاج إلى اختبار مستقل. الفرق التي تستخدم بالفعل المخرجات المهيكلة باستخدام مخطط JSON ستدرك هذا الفرق: فتقييد شكل الإجابة لم يضمن يوماً صحة مضمونها.
دعنا نضع الإطلاق المحدد جانباً للحظة، لأن هيكليته أكثر إثارة للاهتمام من أرقامه. ما تطرحه TypeSafe — وما يتوصل إليه عدد متزايد من الفرق بشكل مستقل — هو أن الاعتماد على نموذج عام واحد للإجابة على كل الطلبات هو نمط خاص بالنماذج الأولية، وليس بنظام الإنتاج.
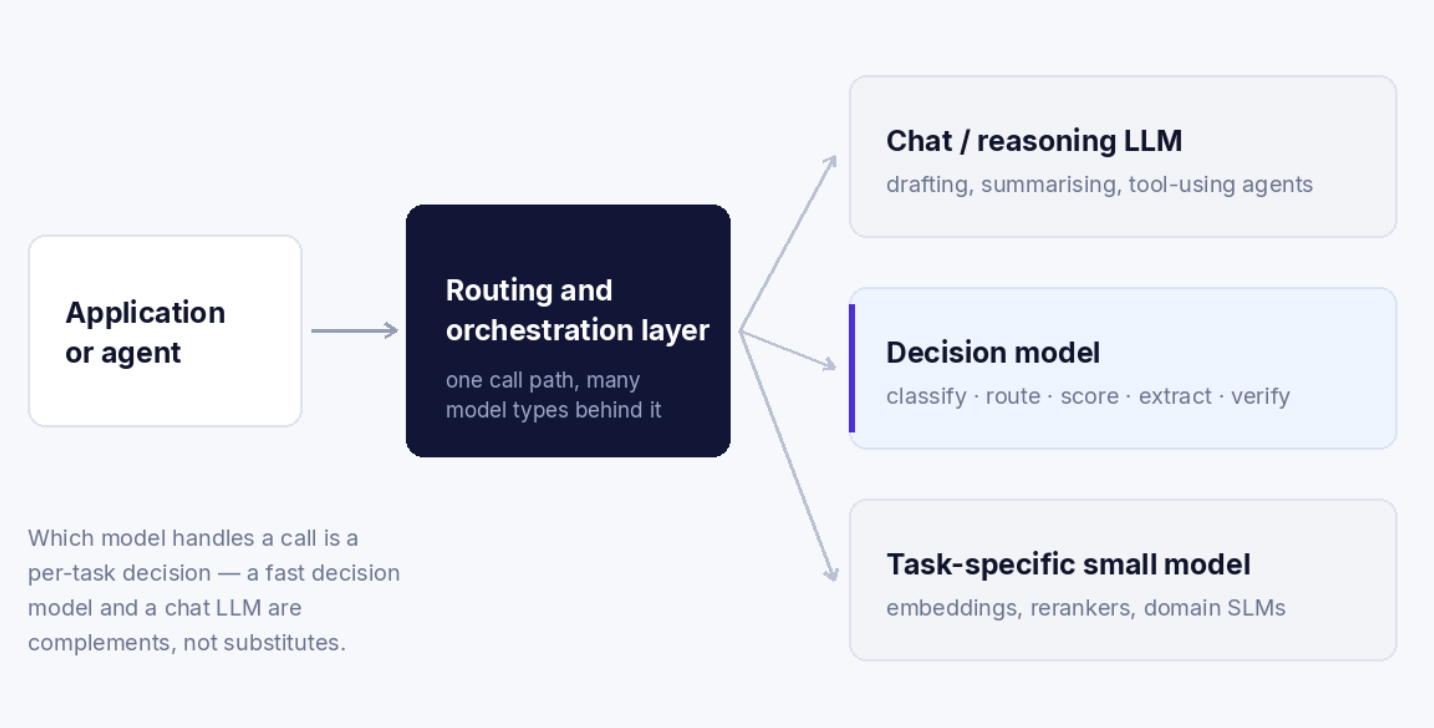
ينتهي المطاف ببيئة الإنتاج باحتواء عدة أنواع من النماذج في وقت واحد، مع وجود طبقة توجيه تقرر أي نموذج يخدم طلباً معيناً.
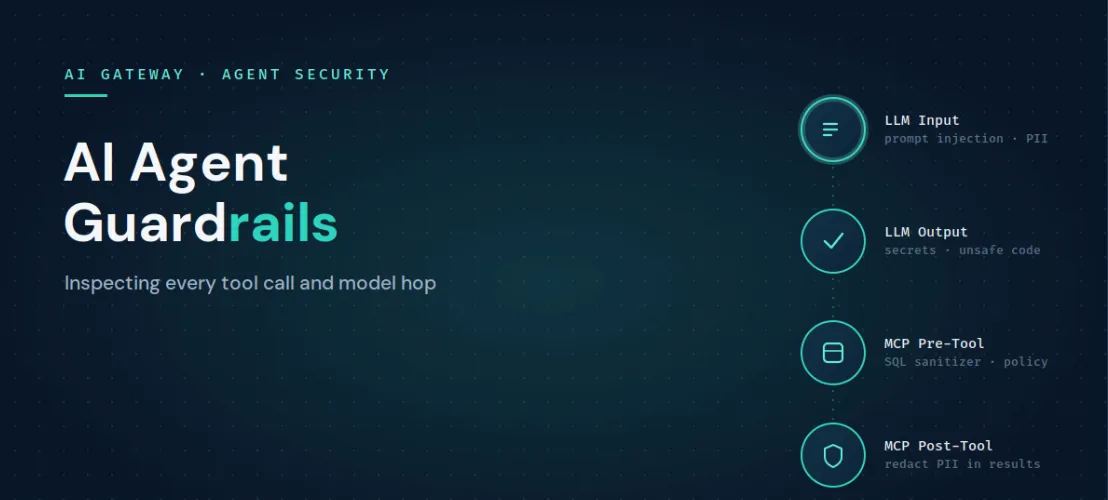
القرارات داخل النظام قيد التشغيل غالباً ما تكون صغيرة ومتكررة: هل هذه التذكرة عاجلة؟ إلى أي قائمة تنتمي؟ هل تخالف هذه الاستجابة السياسة المتبعة؟ أي من هذه الحقول يمثل رقم الفاتورة؟ إرسال كل هذه الطلبات إلى نموذج محادثة متطور أمر ممكن، والفرق تقوم بذلك بالفعل، لكنه يعني دفع تكاليف توليد عالية وتحمل زمن انتقال مرتفع لعملية لا تتعدى كونها مجرد استعلام. هذا هو نفس المنطق الكامن وراء اختيار متى يتم تخصيص نموذج صغير بدلاً من توجيه نموذج ضخم، وهو السبب في أن المهام المتعلقة بالتحقق — مثل التقييم، والحكم، واكتشاف محاولات كسر الحماية، وضوابط حماية الوكلاء — هي حالة الاستخدام التي تركز عليها TypeSafe. يجب أن تعمل ضوابط الحماية مع كل طلب، مما يجعل التكلفة وزمن الانتقال هما القيد الأساسي بدلاً من القدرة الخام للنموذج.
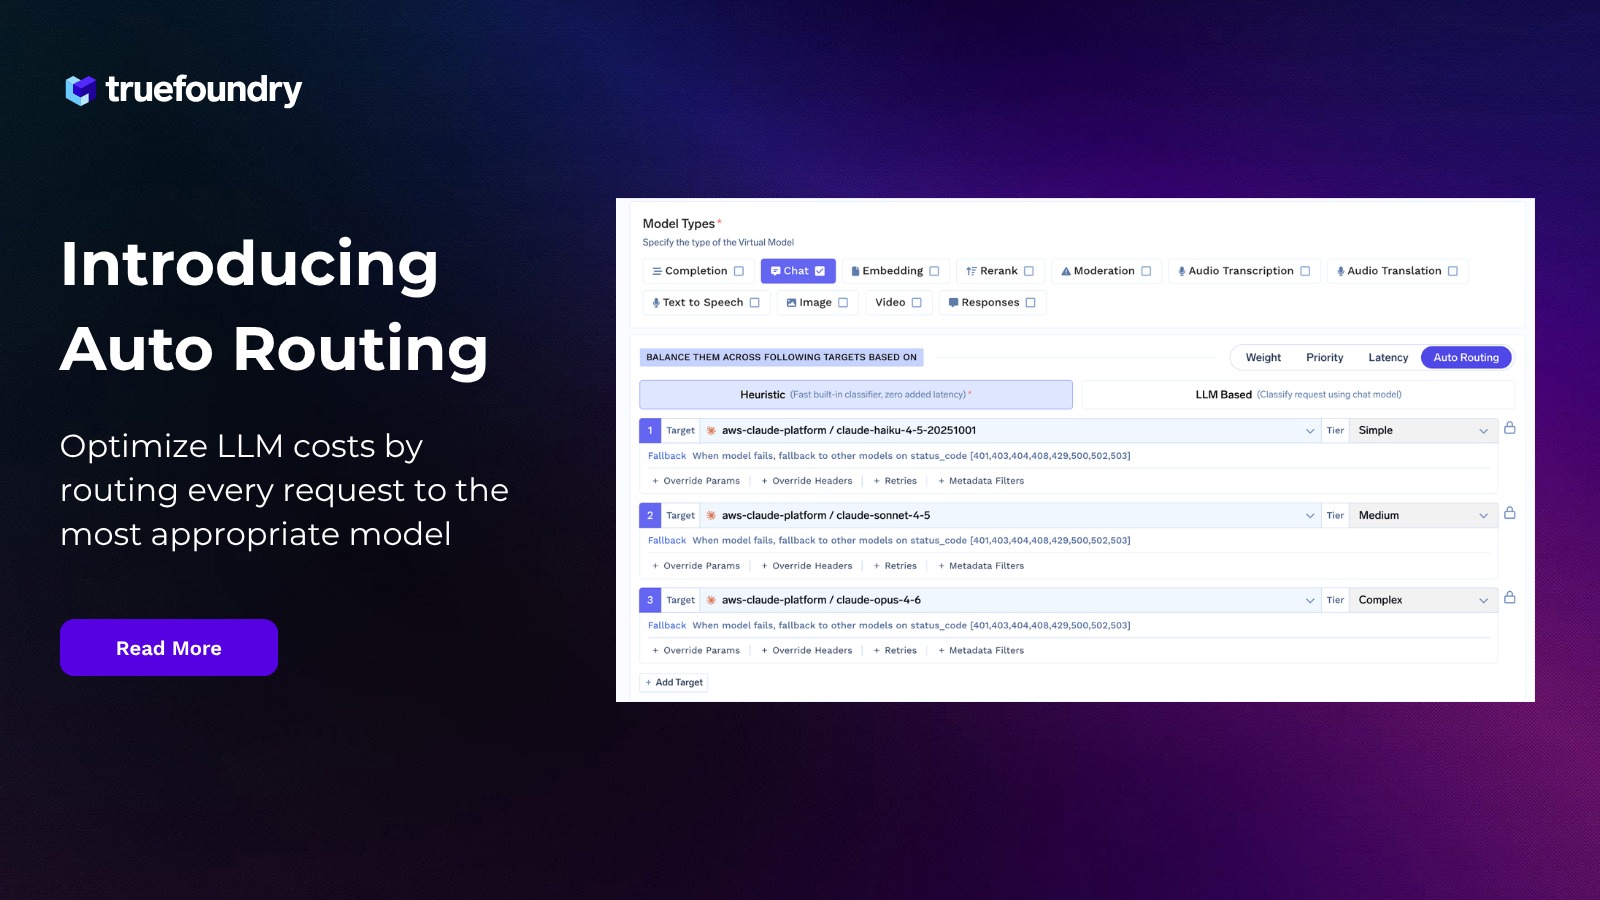
النتيجة لأي شخص يشغل الذكاء الاصطناعي في بيئة الإنتاج هي مشكلة تنسيق الذكاء الاصطناعي وليست مشكلة اختيار النموذج. إذا كانت الإجابة الصحيحة هي استخدام نموذج لغوي للمحادثة لبعض الطلبات، ونموذج قرار سريع لطلبات أخرى، ونموذج صغير مُعدّل لمجموعة ثالثة، فإن الشيء الذي يجب أن يظل ثابتاً هو الطبقة التي تسبق هذه النماذج — مسار طلب واحد، ومصادقة وتسجيل متسقان، وحرية تغيير النموذج الذي يخدم مهمة معينة دون الحاجة لإعادة كتابة التطبيق. هذه هي الفرضية الكامنة وراء التوجيه التلقائي في بوابة TrueFoundry للذكاء الاصطناعي، وهو السبب في أن إطلاقاً كهذا يعتبر مؤشراً معمارياً أكثر أهمية من كونه مجرد معيار قياس.
في الوقت الحالي، Jev عبارة عن واجهة برمجة تطبيقات مستضافة ومغلقة في مرحلة الوصول المبكر، لذا لا يوجد شيء لنشره أو تكامل لتقييمه. قد يتغير ذلك، لكن النمط الذي يمثله لن يتغير بالتأكيد.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد