October 24, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.


Blazingly fast way to build, track and deploy your models!
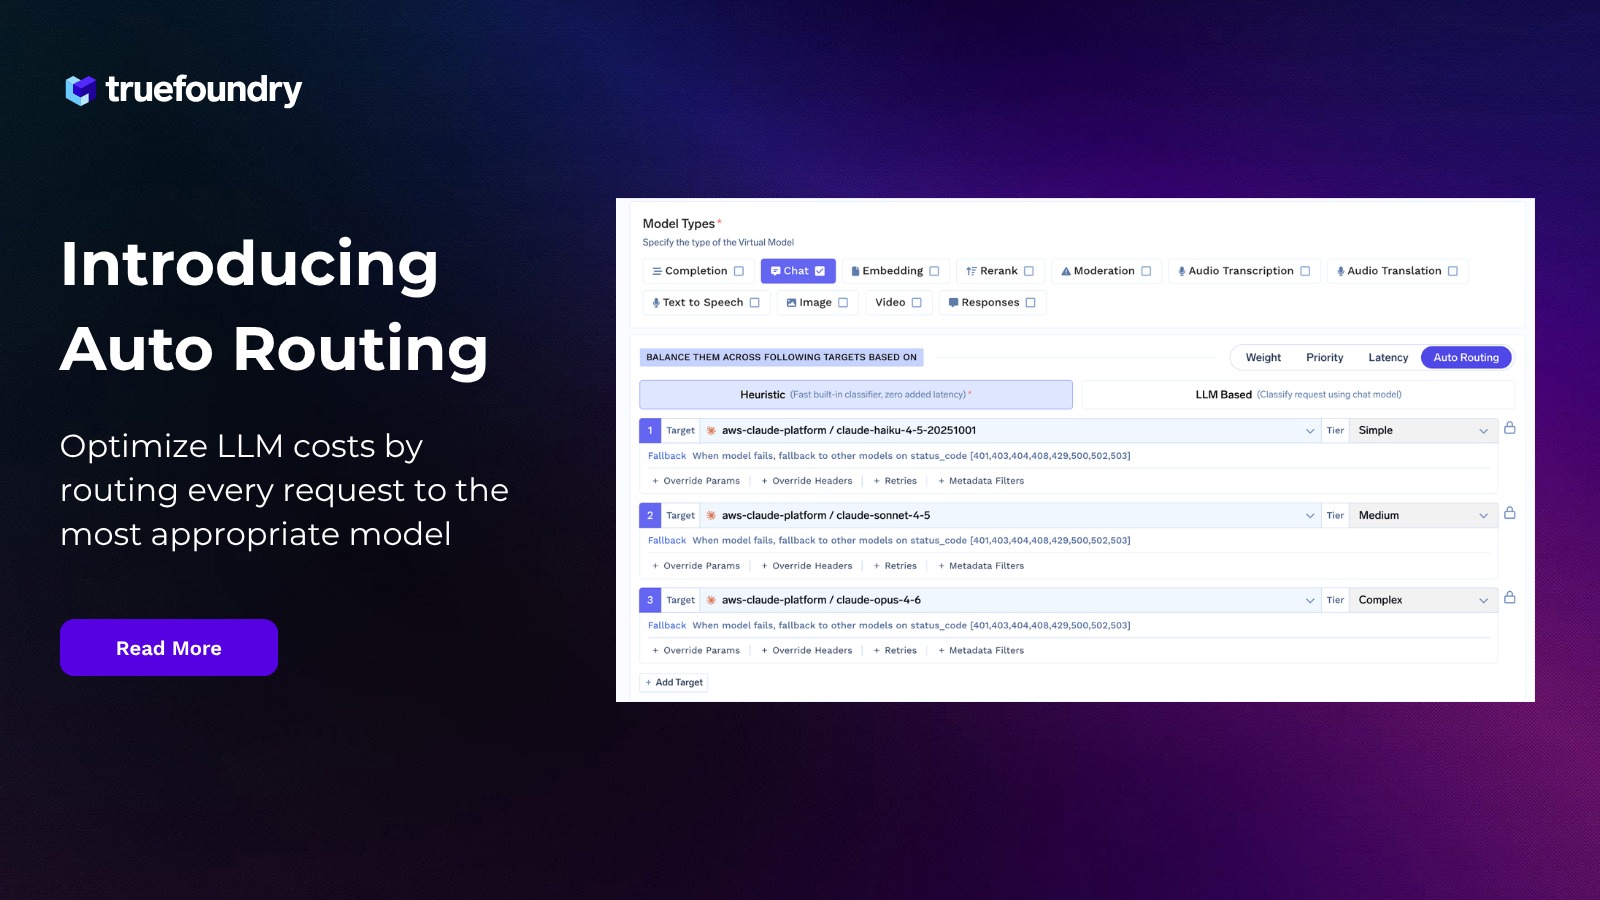
لقد أضفنا للتو إمكانية جديدة إلى بوابة TrueFoundry للذكاء الاصطناعي. تعمل ميزة التوجيه التلقائي الجديدة على قراءة كل طلب وارد، وتصنيفه ضمن واحدة من ثلاث فئات تعقيد، ثم توجيهه إلى النموذج الأنسب المخصص لتلك الفئة.
لقد طورنا هذه الميزة لحل نمط متكرر نلاحظه في حركة مرور بيانات العملاء. عادةً ما تكون معظم الاستعلامات مباشرة ويمكن معالجتها بواسطة نماذج بسيطة، بينما لا يتطلب الأمر سوى عدد قليل من الاستعلامات المعقدة التي تحتاج إلى توجيهها إلى نموذج أكثر تطوراً. ولكن ما يحدث في الواقع هو تعيين نموذج واحد بشكل موحد للإجابة على كل استعلام، بغض النظر عن مدى تعقيده. ونتيجة لذلك، تواجه الشركات فواتير ضخمة وغير ضرورية في نهاية كل دورة. كما أن كتابة قواعد التوجيه برمجياً (Hard-coding) ليست حلاً قابلاً للتوسع، حيث ينتهي الأمر بكل فريق بتطبيق منطق التوجيه الخاص به دون أي توحيد للمعايير.
أصبحت هذه المهمة الآن من مسؤولية البوابة.
على مدار العامين الماضيين، قاست معظم الفرق تبني الذكاء الاصطناعي بناءً على حجم الاستهلاك. وأصبح عدد الرموز (Tokens) المستهلكة معياراً للعمل المنجز. حتى أن بعض الشركات وضعت لوحات صدارة داخلية للاحتفاء بمن يستهلك أكبر قدر منها. ربما كان هذا منطقياً في المرحلة الأولى من تبني الذكاء الاصطناعي، عندما كان الهدف هو فهم مقدار العمل الذي يمكن إسناده فعلياً إلى النماذج.
ثم جاءت الفواتير. في استطلاع أجرته مؤسسة IDC لصناع القرار في مجالات السحابة والذكاء الاصطناعي، تجاوزت 61% من المؤسسات ميزانيتها المخصصة للذكاء الاصطناعي السحابي لعام 2025. وكشف المدير التقني لشركة أوبر أن فريقه استنفد ميزانية الذكاء الاصطناعي السنوية بالكامل بحلول منتصف أبريل. أصبحت حلقات الاستنتاج أطول، ونوافذ السياق أكثر امتلاءً، وبدأت الوكلاء (Agents) في استدعاء النماذج نيابة عن أنفسهم آلاف المرات يومياً دون رقابة.
لذا تغيرت الأولويات. تم استبدال "تعظيم استهلاك الرموز" بـ "اقتصاديات الرموز"، وهي استراتيجية تحاول فيها الشركات وضع سقف لإنفاق الذكاء الاصطناعي دون إبطاء وتيرة التبني أو التجريب. وهذا يعني تركيزاً أكبر على مراقبة التكاليف في الوقت الفعلي، ونماذج استرداد التكاليف، وتخصيص النفقات لكل فريق، ووضع حدود للاستخدام. كل هذه ميزات مهمة، لكنها تساعد فقط في مراقبة الإنفاق أو تقييده، لا في تحسينه.
القرار الذي يحدد فاتورتك فعلياً يتم اتخاذه في وقت أبكر وبسرعة أكبر: أي نموذج سيتولى هذا الطلب. وهذا هو المستوى الذي تعمل فيه ميزة التوجيه التلقائي.
يتم تكوين التوجيه التلقائي على نموذج افتراضي، وهو عبارة عن مدخل مسمى يستدعيه تطبيقك. هناك ثلاث فئات تعقيد يمكنك تعيين نماذج محددة لها.
بما أن تعيينات الفئات تعتمد على النموذج الافتراضي، يمكنك استبدال النموذج الموجود خلف أي فئة كلما توفر خيار أفضل أو أرخص، دون الحاجة إلى إجراء أي تغييرات في كود التطبيق. تصبح سياسة التوجيه كائناً إعدادياً له مالك، وسجل تغييرات، ومكان واحد لتعديله.
هناك طريقتان يتم من خلالهما تصنيف كل استعلام ضمن واحدة من الفئات الثلاث:
يقرأ المصنف الاستدلالي المطالبة، ويقيمها مقابل مجموعة ثابتة من الإشارات، ثم يختار المستوى المناسب. يعمل هذا المصنف ضمن عملية البوابة، لذا فهو لا يضيف أي زمن انتقال أو تكلفة، كما أنه حتمي بالكامل.
يحدد مدى تعقيد الاستعلام بناءً على معايير معينة:
هنا، يمكنك اختيار نموذج التصنيف، والذي يجب أن يكون نموذج دردشة من الكتالوج وليس نموذجاً افتراضياً آخر، كما يمكنك تعيين مهلة زمنية بالملي ثانية. يجب عليك أيضاً تكوين ما سيحدث في حال فشل هذا الاستدعاء. يتوفر خياران احتياطيان: الاستدلالي، الذي يعيد القرار إلى الإشارات المدمجة، أو الثابت، الذي يرسل كل شيء إلى مستوى تحدده أنت. فشل المصنف لا يؤدي أبداً إلى فشل الطلب.
يأتي هذا مع مقايضتين. يعمل المصنف كاستدعاء للنموذج قبل الطلب، مما يضيف زمن انتقال. كما أنه يعد طلباً مدفوعاً عبر البوابة، ويُنسب إلى نفس المستأجر والموضوع الخاص بالطلب الذي أدى إلى تشغيله.
يتجاوز التوجيه التلقائي قواعد التوجيه البسيطة، حيث يمنحك قدرات إضافية لضمان تحسين نفقات النماذج مع الحفاظ على الدقة:
لقد قمنا بتشغيل التوجيه التلقائي مقابل خط أساس يرسل كل طلب إلى Claude Opus 5، عبر 16 مجموعة بيانات عامة وحوالي 4,700 استدعاء، باستخدام مصنف استدلالي مجاني وتدرج هرمي يضم Haiku وSonnet وOpus. التقييم حتمي: يتم تشغيل الكود المولد مقابل اختبارات الوحدة لكل معيار في بيئة معزولة، بينما تتم مطابقة إجابات الرياضيات والاختيارات المتعددة مع مفاتيح الإجابة.
في كل حالة، كانت هناك وفورات كبيرة في التكاليف، دون أي مساس بالجودة.
للاطلاع على المنهجية الكاملة، وتفاصيل كل مجموعة بيانات، وتحليل حركة المرور في بيئة الإنتاج، اقرأ التحليل الهندسي المتعمق: كيف خفضنا تكاليف النماذج اللغوية الكبيرة بمقدار الثلثين دون فقدان الجودة.
يعمل التوجيه التلقائي على نموذج افتراضي. انتقل إلى بوابة الذكاء الاصطناعي (AI Gateway) → النماذج (Models) → النموذج الافتراضي (Virtual Model)، واختر التعقيد (Complexity) ضمن نوع التوجيه، وحدد استراتيجية التصنيف، وعيّن هدفاً لكل مستوى ترغب في خدمته. بعد ذلك، وجه تطبيقك إلى اسم النموذج الافتراضي وجربه باستخدام مطالبات ذات مستويات تعقيد متفاوتة في بيئة الاختبار (playground).
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد