November 14, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.



Blazingly fast way to build, track and deploy your models!
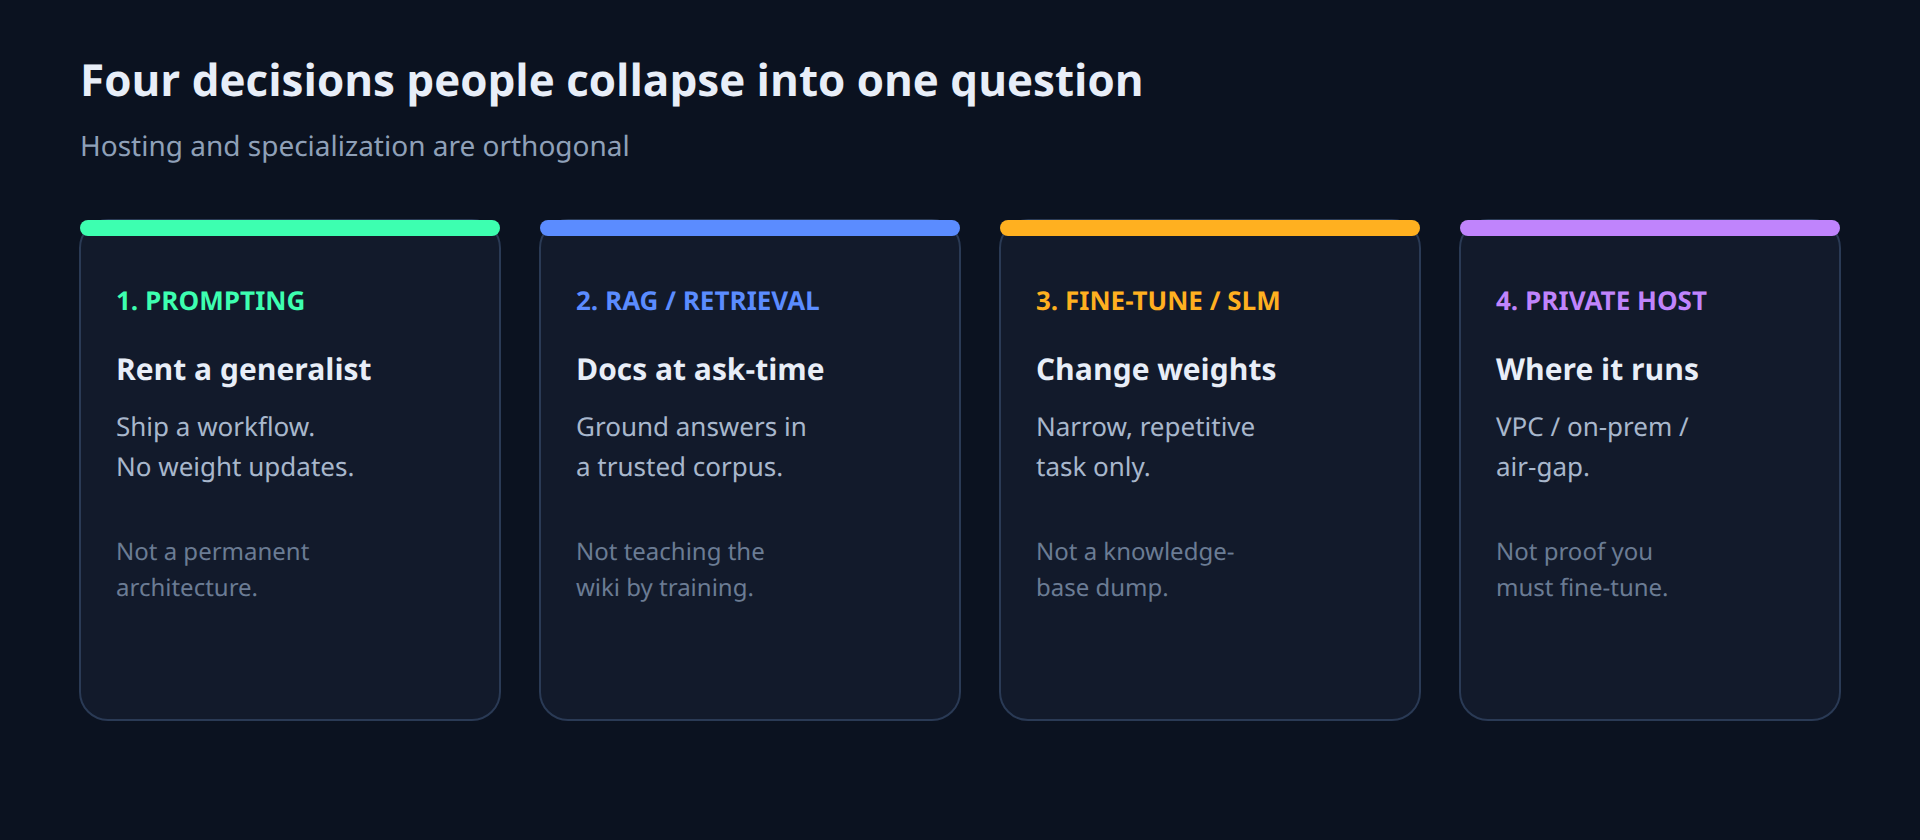
غالباً ما تسأل الفرق "هل نستخدم SLM أم LLM؟" وكأن ذلك يجيب على طبيعة المنتج. وهو لا يفعل ذلك. حيث يتم دمج أربعة قرارات مختلفة معاً:
يمكنك حث LLM خاص. كما يمكنك إجراء ضبط دقيق ومع ذلك الاستمرار في استدعاء API عام للأجزاء المفتوحة. إن الاستضافة والتخصيص أمران منفصلان تماماً. والخلط بينهما هو السبب في تعطل الفرق الخاضعة للتنظيم لربع سنوي كامل في انتظار وحدات GPU بينما كان العائق الحقيقي هو غياب الفهرس المرجعي للوثائق.
لمعرفة كيفية كبح الفرق لاختيار النماذج والإنفاق بمجرد بدء التدفق الفعلي، راجع ما يعنيه LLM gateway. يأتي سؤال البوابة بعد أن تعرف المسار الذي تسلكه.
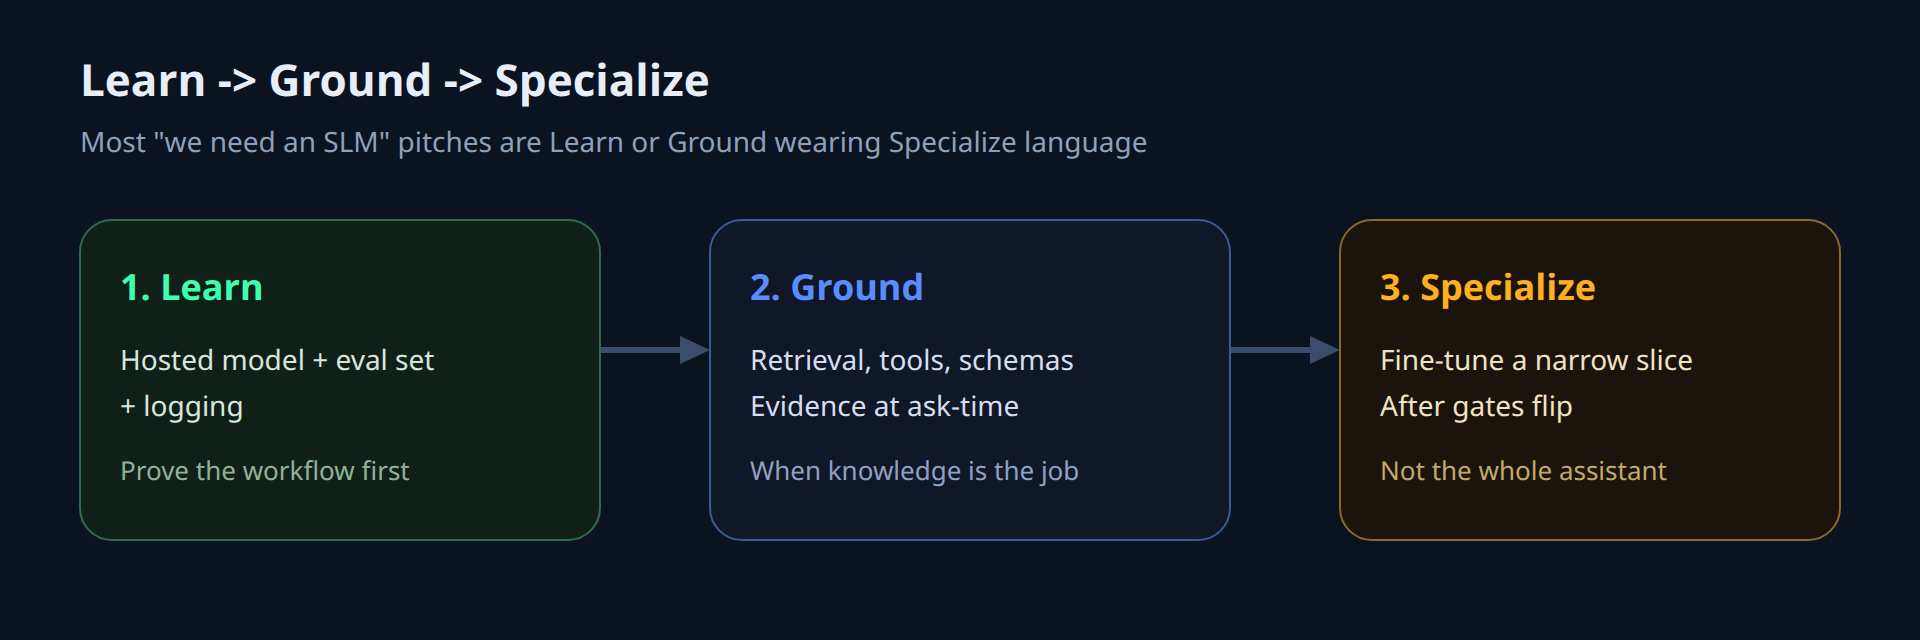
بمجرد الفصل بين هذه القرارات الأربعة، تتكثف خارطة الطريق في ثلاثة مسارات:
معظم الطروحات التي تدعي "نحن بحاجة إلى SLM" هي في الحقيقة مشاكل تعلم أو ترسيخ تتخفى في صيغة مصطلحات التخصيص.
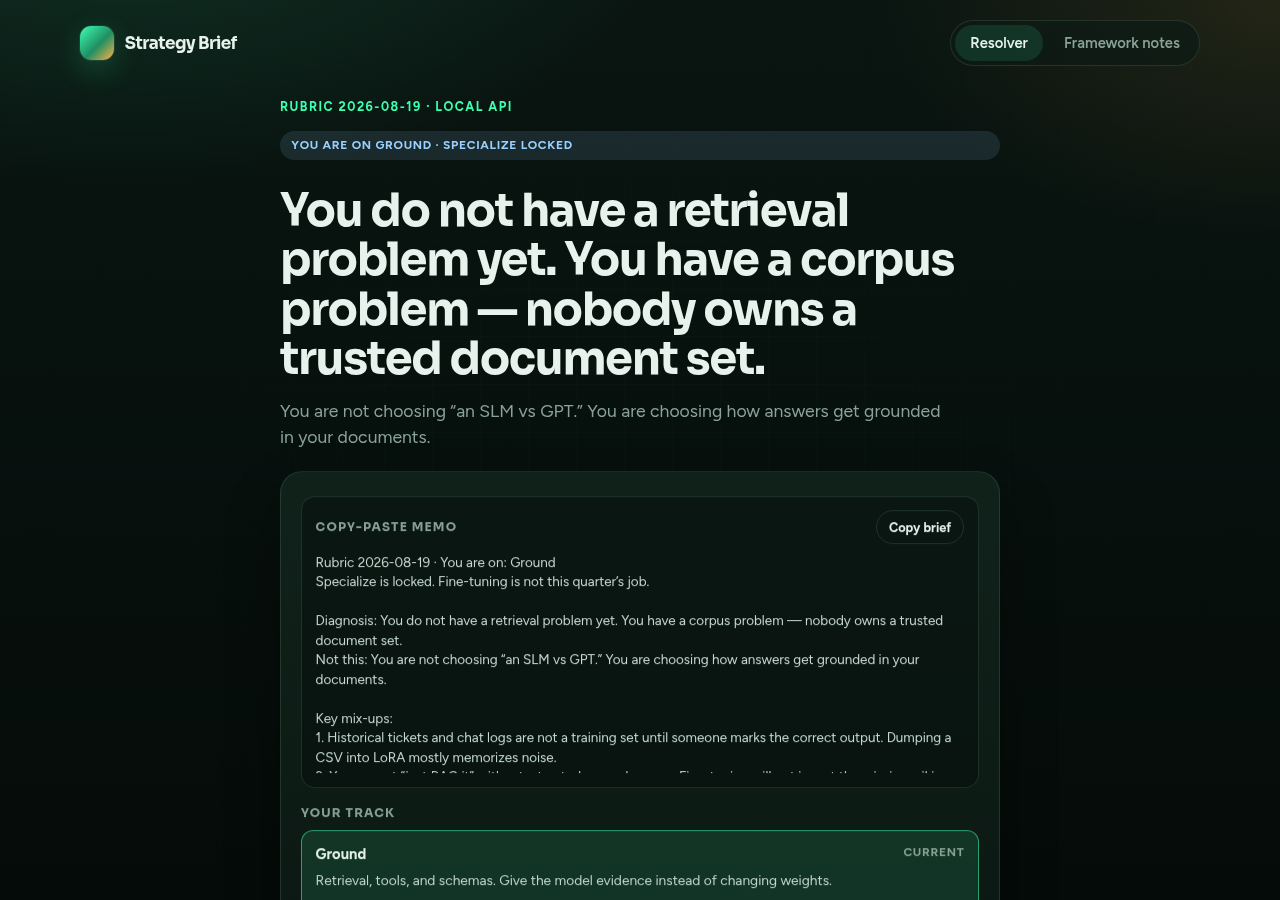
لقد قمنا ببناء fine-tuning vs prompting resolver حول هذا الإطار. أجب على عدد قليل من الأسئلة الخاصة بالمنتج وسيقدم لك تشخيصاً، والمسارات المغلقة مقابل الحالية، ومذكرة جاهزة للنسخ واللصق. نفس المعايير في كل مرة، بحيث يتناقش مدير المنتج، والفريق الهندسي، والأمني بناءً على مرجعية واحدة.
حماس المطورين أمر مهم. والعروض التوضيحية للبائعين أقل أهمية. ولا شيء منهما يغني عن استيفاء الشروط البنيوية.
هل المهمة هي فرز التذاكر، أو استخراج الحقول، أو الأسئلة والأجوبة على الوثائق، أو الدردشة المفتوحة، أو وكيل متعدد الخطوات؟
الأعمال المغلقة أو المرتبطة بمخطط محدد (Schema) يمكن تخصيصها لاحقاً. بينما المساعدون المفتوحون ووكلاء البرمجة ينبغي تقريباً عدم إخضاعهم للضبط الدقيق أولاً. إذا كان بإمكانك فصل مهمة فرعية ضيقة (التصنيف، ثم المسودة)، فقم بتخصيص هذا الجزء فقط.
يمكن للبيانات الداخلية / المنخفضة المخاطر أن تبدأ عبر API عام مع مراجعة اعتيادية للبائع. بينما تتطلب بيانات العملاء التعريفية (PII) مراجعة الخصوصية. البيانات الخاضعة للتنظيم (البيانات الصحية PHI، إقامة البيانات المالية، البيئات المعزولة) تفرض استخدام VPC أو الاستضافة المحلية (On-prem).
هذا القرار يتعلق بالاستضافة. وهو لا يفتح مجال الضبط الدقيق بمفرده. وللتحكم في الإنفاق وزمن الاستجابة بمجرد زيادة حجم الاستخدام، فإن LLM cost optimization هو النقاش الموازي، وليس بديلاً عن البيانات المصنفة.
التذاكر التاريخية وسجلات الدردشة لا تعتبر مجموعة تدريب حتى يقوم شخص ما بتحديد المخرجات الصحيحة. وتفريغ ملف CSV في LoRA يؤدي غالباً إلى حفظ الضوضاء فقط.
إذا قال أحدهم "لدينا بعض الأمثلة"، فاسأل عما إذا كانت هذه الأمثلة موثوقة (Gold) أم خام. الأمثلة الخام تُعامل كأنها معدومة.
الضبط الدقيق بدون مسؤول مسؤول هو بمثابة تعليمات حث تجمّدت ولا يمكن تحديثها بأمان عند تغير البيانات أو النموذج الأساسي. التقييمات، والانحراف، وإعادة النشر تتطلب وجود شخص مسؤول بشكل مباشر. كلمة "ربما لاحقاً" تعني أنك في مرحلة التعلم، وليس التخصيص.
المشاريع التجريبية نادراً ما تغطي تكاليف units الـ GPU بالإضافة إلى MLOps. مئات الطلبات يومياً قد تظل في صالح استخدام APIs. الحجم الكثيف والمستقر هو ما يبدأ في تبرير التكلفة والزمن لإنشاء نموذج متخصص، وبعد اجتياز الشروط الأخرى فقط.
اطلب من الفريق الهندسي مجموعة التقييم، وخطة التسجيل، وما إذا كان هناك خط أساس يعتمد على الحث موجوداً بالفعل. واسأل الفريق الأمني عن القوائم المعتمدة للبائعين، وتسجيل المطالبات، وما يحدث إذا بدأت ميزة مستقبلية في إرسال بيانات PII. تخطي هذه الخطوة يحول الضبط الدقيق إلى مفاجأة امتثال بعد عرض العرض التوضيحي الأول.
يريد شخص ما أن "يعرف النموذج ويكيبيديا الخاصة بنا". هذا استرجاع (Retrieval). الضبط الدقيق لن يخترع الصفحات المفقودة أو يبقيها محدثة عند تغيير الوثائق. إذا لم يكن هناك من يملك مجموعة الوثائق، فليس لديك مشكلة RAG بعد. لديك مشكلة في قاعدة البيانات الوثائقية. قم بالترسيخ أولاً.
هذا أحد المواقع القليلة التي يستحق فيها التخصيص مكاناً. احتفظ بخط أساس يعتمد على الحث في نفس التقييم. أجرِ تجربة LoRA ضيقة واحدة. بعد ذلك فقط ناقش نقطة النهاية الخاصة المدارة مقابل الاستضافة الذاتية. التصنيف والاستخراج هما المكاسب الشائعة، وليس "استبدال المساعد بأكمله".
تحاول الفرق دمج الشخصية عبر الضبط الدقيق في نموذج صغير وتتساءل عن سبب انهيار الجودة في الحالات الحافة. احتفظ بالوكيل المفتوح على نموذج عام. إذا كانت هناك خطوة مغلقة قبل الصياغة (القصد، التوجيه، الاستخراج)، فافصل تلك الخطوة وقم بتخصيصها فقط.
جدول البيانات يحتوي على آلاف الصفوف. ولكن لم يحدد أحد الإجابات الصحيحة. اعتبرها بلا تصنيفات حتى تتوفر المراجعة. يظل التخصيص مغلقاً لسبب وجيه.
الخصوصية قد تفرض استضافة VPC أو استضافة محلية. لكنها لا تفرض تحديث الأوزان. العديد من الفرق في القطاعات التنظيمية يجب أن تحث LLM خاصاً (التعلم) أو تسترجع عبر فهرس خاص (الترسيخ) قبل وقت طويل من البدء في التدريب.
ضغط التكاليف أمر واقعي. لكن التدريب بدون لوحة نتائج مستقلة هو الطريقة التي تشحن بها نموذجاً متخصصاً يخسر أمام خط الأساس المعتمد على الحث الذي لم تقسه أبداً. أصلح إطار التقييم أولاً. لتوجيه الأعمال الروتينية إلى نماذج أرخص أثناء التعلم، فإن LLM router غالباً ما يكون الوسيلة الأرخص مقارنة بالضبط الدقيق.
عندما يبدأ النقاش، افترض ثلاث جمل محددة:
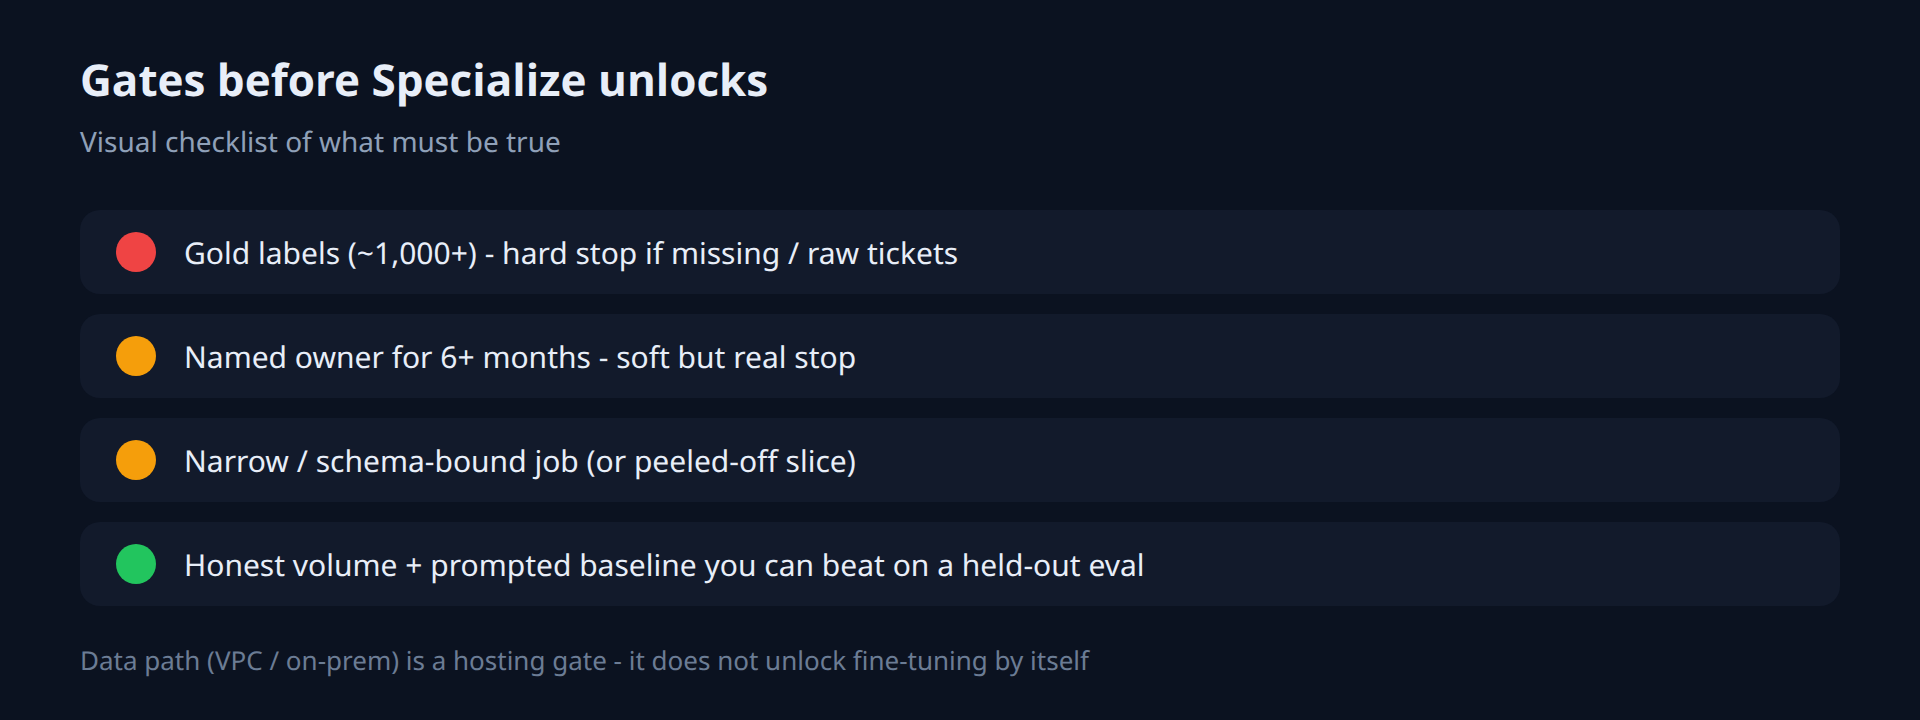
ثم اذكر البوابات الصارمة مع درجة أهميتها. عدم وجود تصنيفات هو توقف حاسم. عدم وجود مسؤول هو توقف مرن ولكنه حقيقي. "بعض التصنيفات" هي مشكلة تسلسل: كافية للقياس، وغير كافية للتدريب. مسار البيانات هو بوابة استضافة، وليس شرطاً لفتح التخصيص.
نحن نستخدم هذا الهيكل في strategy resolver. المخرج هو مذكرة قصيرة يمكن لمديري المنتجات لصقها في وثيقة متطلبات المنتج (PRD) أو محادثات Slack، مع وجود إصدار المعيار في الأعلى لتبقى النقاشات مرتبطة بنفس القواعد.
اختيار المسار هو نصف المهمة. بمجرد بدء التدفق الفعلي، تظهر نفس المشكلات لأي حمولة عمل تابعة لـ LLM.
يبقى اختيار النموذج تفضيلاً في الإعدادات. تُشحن النماذج المضبوطة دقيقاً بدون خط أساس. ويبقى الإنفاق والجودة غير مرئيين حتى يشتكي شخص ما.
الفرق التي تبقى في الصدارة تضع عادة طبقة تحكم أمام تدفق النماذج. حيث تعمل بوابة الذكاء الاصطناعي (AI gateway) بين التطبيقات والمزودين. فهي تحدد الإعدادات الافتراضية، وتتحكم فيمن يمكنه استدعاء النماذج المتقدمة، وتنسب التكاليف حسب الفريق، وتحافظ على الاستدلال داخل حدود الشبكة الصحيحة. لمعرفة التفاصيل التقنية، راجع LLM gateway و multi-model routing.
تُعد AI Gateway من TrueFoundry أحد الخيارات المصممة لهذه المهمة: API واحد متوافق مع OpenAI عبر أكثر من 1,000 نموذج، مع حصص الاستخدام (Quotas)، والتحكم في الوصول (RBAC)، وتتبع التكاليف، وسياسات التوجيه. يمكنك تشغيلها في VPC الخاص بك، أو محلياً، أو في بيئة معزولة، أو هجينة، بحيث يظل قرار مسار البيانات السابق قابلاً للتطبيق. وعندما يفتح مسار التخصيص أخيراً، فإن مسار التدريب و fine-tuning في TrueFoundry يغطي أعمال LoRA الضيقة دون الحاجة إلى تركيب حزمة MLOps منفصلة أولاً.
إذا كانت حوكمة النماذج، أو الاستضافة الخاصة، أو المسار النظيف من خط الأساس المعتمد على الحث إلى النموذج المتخصص لا تزال معلقة بعد اختيار المسار، فمن الجدير إلقاء نظرة عليها.
المفاضلة بين الضبط الدقيق والحث هي قرار يتعلق بالميزانية التسلسل، وليس تفضيلاً للعلامة التجارية. معظم الفرق يجب أن تسلك مسار التعلم أو الترسيخ في هذا الربع. التخصيص يُكتسب استحقاقاً: مهمة ضيقة، تصنيفات موثوقة، مسؤول محدد، حجم استخدام موثوق، وخط أساس يعتمد على الحث يمكنك التفوق عليه.
حدد معالم المهمة قبل تسمية النموذج. افصل الاستضافة عن الضبط الدقيق. احسب الأمثلة المراجعة، وليس التذاكر الخام. قدّم للإدارة المالية والأمن مساراً وقائمة بوابات، وليس تصويتاً يعتمد على الانطباعات.
لقد تعلمنا معظم هذا بعد مشاهدة مشاريع "لنقم بالضبط الدقيق" تستهلك ربعاً سنويًا كاملاً وتفشل في التقييم الذي اجتازه النموذج المعتمد على الحث بالفعل. كتالوج النماذج سيستمر في النمو. والشروط لن تصبح أسهل. إن ضبط جانب الاستراتيجية بشكل صحيح منذ البداية يوفر الكثير من عمليات إعادة ضبط خارطة الطريق المحرجة لاحقاً.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



عندما تكون المهمة ضيقة ومتكررة، ولديك نحو 1,000 مثال موسوم ونظيف أو أكثر، ويوجد مسؤول محدد عن التقييمات وإعادة النشر، والحجم كافٍ ليصبح تكلفة الوحدة أو زمن الاستجابة مشكلة، وتوجد نتيجة مرجعية بالتعليمات يمكنك تجاوزها على مجموعة بيانات محجوزة. وإذا غاب أي من هذه العناصر، فاستمر في استخدام التعليمات (وأضف RAG إذا كانت المهمة معرفية).
الضبط الدقيق يغيّر أوزان النموذج للحصول على سلوك متخصص. وRAG يسترجع مستندات موثوقة وقت السؤال حتى تبقى الإجابات مستندة إلى مصادر ومحدَّثة. والاستضافة الخاصة تتعلق بالمكان الذي يُشغَّل فيه الاستدلال. ويمكنك الجمع بينها بأي ترتيب، واختيار الاستضافة في VPC لا يعني أنك ملزم بالضبط الدقيق.
غالباً لأحد هذه الأسباب: غياب تقييم على بيانات محجوزة، أو أن التسميات كانت تذاكر خاماً، أو أن المهمة مفتوحة وما كان ينبغي تخصيصها، أو عدم وجود مسؤول يمنع انحراف النموذج المتخصص. وتطبيق Specialize دون لوحة نتائج مجرد تخمين.
وجّه حركة البيانات عبر بوابة ذكاء اصطناعي. حدّد نماذج افتراضية. قيّد الوصول إلى النماذج المميزة. اعرض الإنفاق لكل فريق. تمنح بوابة AI Gateway من TrueFoundry قادة الهندسة رؤية للاستخدام والتكلفة عبر أكثر من 1,000 نموذج LLM خلف واجهة API واحدة متوافقة مع OpenAI، حتى لا تتراكم اختيارات النماذج في مفاجآت بالفواتير وأنت ما زلت تثبت جدوى المنتج.
نعم. تعمل TrueFoundry في VPC الخاصة بك أو محلياً أو في بيئة معزولة عن الشبكة أو هجينة، فلا تغادر التعليمات والردود نطاقك أبداً حتى وأنت توجّه الطلبات عبر مزوّدين كثيرين.



أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد