



November 16, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.



Blazingly fast way to build, track and deploy your models!
توفر نماذج اللغات الكبيرة (LLMs) إمكانيات قوية، ولكنها تقدم أيضًا تكاليف بنية تحتية مرتفعة، وأنماط استخدام غير متوقعة، وإمكانية لسوء الاستخدام. مع دمج المؤسسات لـ LLMs في الأدوات الموجهة للعملاء، والمساعدين الداخليين، ومنصات API، تصبح الحاجة إلى وصول خاضع للرقابة وموثوق أمرًا حيويًا. وهنا يأتي الدور المحوري لتحديد معدل الطلبات (Rate Limiting).
في سياق استدلال LLM، لا يكفي تحديد معدل الطلبات التقليدي القائم على عدد الطلبات في الثانية (RPS). فنماذج LLMs كثيفة الاستهلاك للموارد، وقائمة على الرموز (Tokens)، ومتغيرة للغاية في الحمل الحسابي. يمكن للموجه (Prompt) الواحد إلى نموذج بحجم 70B بارامتر أن يستهلك آلاف الرموز ويؤثر بشكل كبير على زمن انتقال GPU. وبدون الضوابط المناسبة، يمكن للبنية التحتية المشتركة أن تصبح غير مستقرة بسرعة أو ذات تكلفة باهظة.
يشرح هذا المقال كيفية عمل تحديد معدل الطلبات في بوابة الذكاء الاصطناعي (AI Gateway)، ولماذا يُعد أساسيًا للبنية التحتية للذكاء الاصطناعي القابلة للتوسع، وكيف تمكنه TrueFoundry افتراضيًا لضمان الاستخدام العادل، وكفاءة التكلفة، والأداء الجاهز للإنتاج عبر عمليات النشر متعددة المستأجرين.
تحديد معدل الطلبات هو آلية تُستخدم للتحكم في عدد الطلبات التي يمكن للعميل إرسالها إلى نظام ما خلال نافذة زمنية محددة، وهو قدرة أساسية لـ بوابات الذكاء الاصطناعي الحديثة التي تدير حركة مرور LLM. فهو يضمن العدالة، ويمنع الحمل الزائد، ويحافظ على التوافر، خاصة في البيئات متعددة المستخدمين. غالبًا ما تطبق واجهات برمجة التطبيقات (APIs) التقليدية حدودًا بسيطة مثل 100 طلب في الدقيقة لكل مستخدم، وهو ما يعمل بشكل جيد لخدمات REST القياسية.
ومع ذلك، تعمل نماذج LLMs بشكل مختلف تمامًا. إذ يمكن لكل طلب أن يفرض حملاً مختلفًا بشكل جذري على البنية التحتية بناءً على حجم المدخلات، ونوع النموذج، والمخرجات المتوقعة. على سبيل المثال، قد يكتمل موجه مكون من 20 رمزًا لنموذج بحجم 7B بسرعة، بينما قد يعوق طلب مكون من 2000 رمز لنموذج بحجم 65B معالجات GPUs لعدة ثوانٍ. حتى الطلبان المتطابقان لنموذجين مختلفين يمكن أن يختلفا بمقدار 5 أضعاف أو أكثر في تكلفة الحوسبة.
هذا يجعل الحدود القائمة على الطلبات غير كافية. يجب على بوابات LLM الحديثة اعتماد تحديد معدل الطلبات الذكي للرموز لكل أداة LLM تخدمها، مع مراعاة العدد الفعلي للرموز التي تم معالجتها وعبء الحوسبة لكل استدعاء.
تشمل العوامل الرئيسية المأخوذة في الاعتبار عند تحديد معدل الطلبات الذكي للرموز ما يلي:
مقارنة بالحدود الثابتة للطلبات، فإن الحدود الذكية للرموز:
في سير عمل الذكاء الاصطناعي التوليدي، يصبح تحديد معدل الطلبات أكثر أهمية. إذ يمكن لمستخدم واحد إطلاق معالجة خلفية واسعة النطاق من خلال موجهات طويلة، أو استيعاب المستندات، أو وكلاء متعددة الخطوات. وبدون ضوابط، يمكن أن يؤدي ذلك إلى ازدحام GPU، أو زمن انتقال مرتفع، أو تكاليف غير متوقعة.
غالباً ما يكون الاستخدام في العالم الحقيقي غير متوقع، مدفوعًا بتطبيقات الواجهة الأمامية، أو دورات الاختبار، أو الأتمتة. ويضمن تحديد معدل الطلبات بقاء هذه التفاعلات مستقرة وفعالة، حتى عندما تكون البنية التحتية مشتركة بين المستخدمين أو المستأجرين.
لأي نشر جاهز للإنتاج، يجب أن توفر أفضل بوابة LLM تحديدًا ذكيًا لمعدل الطلبات كمتطلب أساسي للتوسع، والموثوقية، والتحكم في التكاليف.
مقاييس رئيسية لتقييم البوابة
| المعيار | ما الذي يجب عليك تقييمه؟ | الأولوية | TrueFoundry |
|---|---|---|---|
| زمن الانتقال (Latency) | هل يضيف حملًا إضافيًا <10ms p95 للوقت اللازم لأول رمز؟ | ضروري جداً | ✅ مدعوم |
| إقامة البيانات (Data Residency) | هل يحفظ السجلات داخل منطقتك (الاتحاد الأوروبي/الولايات المتحدة)؟ | يعتمد على حالة الاستخدام | ✅ مدعوم |
| التوجيه المستند إلى زمن الانتقال | هل يعيد التوجيه تلقائيًا بناءً على زمن الانتقال/الأخطاء في الوقت الفعلي؟ | ضروري جداً | ✅ مدعوم |
| تدوير المفاتيح وإلغاؤها | هل يمكن تدوير المفاتيح أو إلغاؤها دون وقت توقف؟ | ضروري جداً | ✅ مدعوم |
| تدوير المفاتيح وإلغاؤها | هل يمكن تدوير المفاتيح أو إلغاؤها دون وقت توقف؟ | ضروري جداً | ✅ مدعوم |
| تدوير المفاتيح وإلغاؤها | هل يمكن تدوير المفاتيح أو إلغاؤها دون وقت توقف؟ | ضروري جداً | ✅ مدعوم |
| تدوير المفاتيح وإلغاؤها | هل يمكن تدوير المفاتيح أو إلغاؤها دون وقت توقف؟ | ضروري جداً | ✅ مدعوم |
| تدوير المفاتيح وإلغاؤها | هل يمكن تدوير المفاتيح أو إلغاؤها دون وقت توقف؟ | ضروري جداً | ✅ مدعوم |

تحديد معدل الطلبات هو أكثر من مجرد وسيلة حماية للخلفية. بالنسبة للمنصات التي تخدم LLMs — خاصة تلك التي تقدم واجهات برمجة تطبيقات عامة أو متعددة المستأجرين — فإنه يعمل كطبقة استراتيجية للاستقرار والإدارة والتوافق مع أهداف الأعمال. سواء كان ذلك في OpenAI أو Anthropic أو المنصات المبنية باستخدام TrueFoundry، فإن حدود معدل الطلبات تخدم عدة أغراض حيوية.
حماية البنية التحتية من الإساءة
تستلزم عملية استدلال الذكاء الاصطناعي التوليدي استهلاكًا كثيفًا للموارد. يمكن لدفعة مفاجئة من الموجهات الطويلة أو الطلبات المتزامنة أن تغمر طوابير GPU، وتزيد من زمن الانتقال، أو حتى تتسبب في تعطل الخدمات. يضمن تحديد معدل الطلبات معالجة حركة المرور بطريقة خاضعة للرقابة وذات أولوية، مما يمنع استنزاف الموارد.
تطبيق العدالة عبر المستخدمين أو المستأجرين
في الأنظمة متعددة المستخدمين، لا ينبغي لاستخدام عميل واحد أن يؤدي إلى تراجع الأداء بالنسبة للآخرين. يساعد تحديد معدل الطلبات في فرض العزل بين المستخدمين، أو الفرق، أو مفاتيح API. هذا يضمن مستويات خدمة متسقة بغض النظر عن عدد المستخدمين النشطين في وقت واحد.
مواءمة الاستخدام مع خطط التسعير
تقوم العديد من منصات الذكاء الاصطناعي التوليدي بتحقيق الدخل بناءً على الرموز أو مستويات الاستخدام. يساعد تحديد معدل الطلبات في فرض تلك الحدود. على سبيل المثال:
منع مفاجآت التكلفة وتجاوز الميزانية
يمكن لاستخدام LLM أن يتوسع بهدوء وسرعة. وبدون حدود مناسبة، يمكن أن يتضخم استهلاك الرموز واستخدام GPU. يساعد تحديد معدل الطلبات المنصات على منع تكاليف البنية التحتية غير المتوقعة والحفاظ على التحكم في الميزانية.
تحسين الموثوقية وتجربة المستخدم
عندما يتم التحكم في الاستخدام، تظل طوابير النظام مستقرة. يؤدي هذا إلى تقليل زمن الانتقال، وارتفاع معدلات النجاح، وتوفير تجربة مستخدم أكثر اتساقًا، وهو أمر مهم بشكل خاص في بيئات الإنتاج ذات اتفاقيات مستوى الخدمة (SLAs).
في الأنظمة القائمة على LLM، لا تمتلك جميع الطلبات نفس التأثير. قد يستغرق الموجه القصير لنموذج صغير أدنى حد من الموارد، بينما يمكن للاستعلام الطويل لنموذج كبير أن يستهلك وقتًا كبيراً من GPU. نظرًا لتقلب هذا التأثير، تطبق المنصات الحديثة حدود معدل الطلبات عبر أبعاد متعددة بدلاً من الاعتماد فقط على عدد الطلبات.
فيما يلي الأبعاد الأكثر شيوعًا المستخدمة لتحديد معدل الطلبات بفاعلية:
منح هذه الأبعاد لفرق المنصات المرونة لمواءمة استخدام الموارد مع قيود البنية التحتية، واحتياجات المستخدمين، وتوقعات مستوى الخدمة.
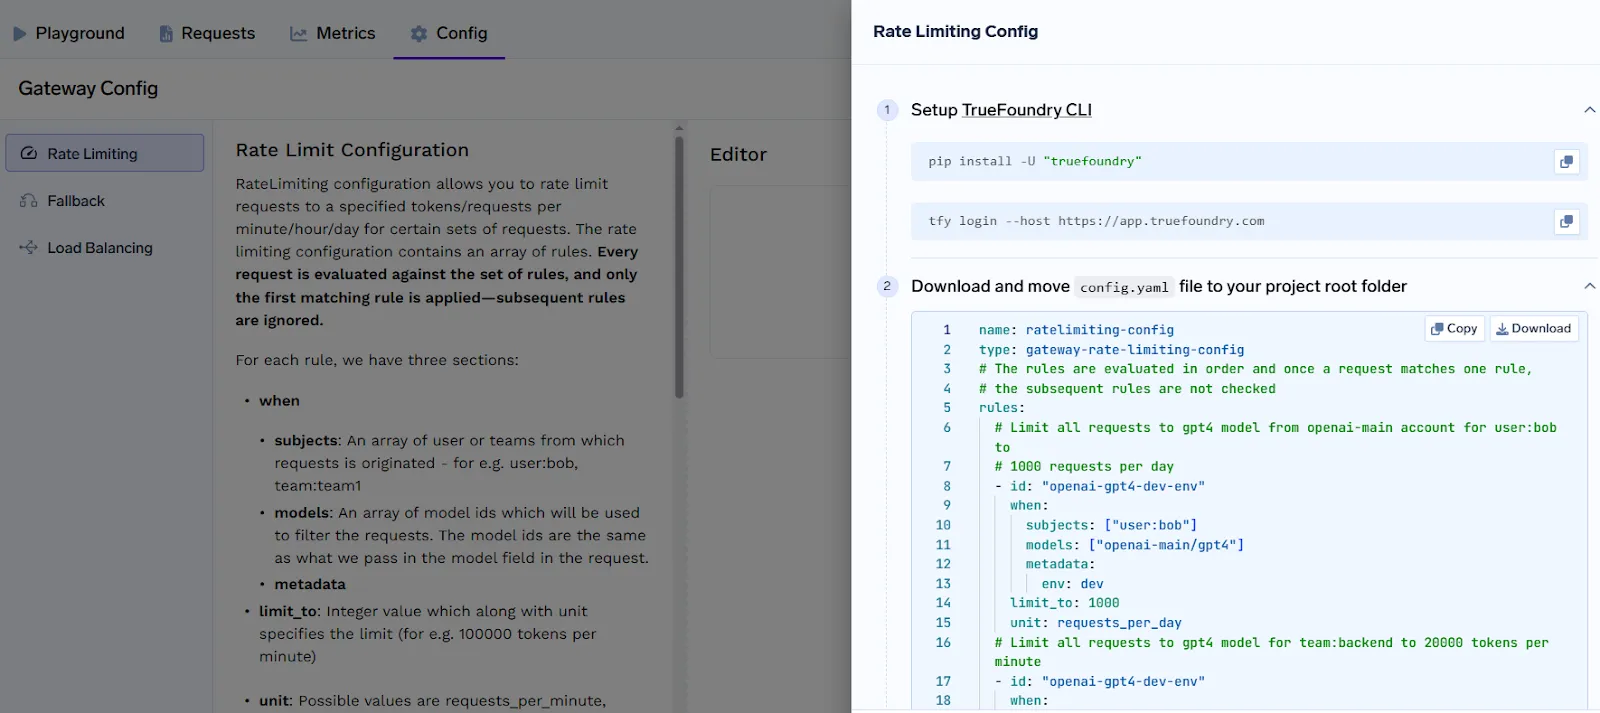
توفر TrueFoundry نظامًا قويًا ومَرنًا لتحديد معدل الطلبات يسمح لفرق المنصات بالتحكم في الوصول إلى نقاط نهاية LLM بناءً على الطلبات أو استخدام الرموز. يضمن ذلك التوزيع العادل للحوسبة، ويمنع الإساءة، ويوفق الاستخدام مع السياسات التنظيمية أو خطط الفوترة.
في قلب آلية تحديد معدل الطلبات في TrueFoundry يوجد نظام تكوين قائم على القواعد يسمح للفرق بتحديد سياسات دقيقة عبر المستخدمين والفرق والحسابات الافتراضية والنماذج والبيانات الوصفية للطلبات (Metadata).
التكوين القائم على القواعد
يتم تعريف تحديد معدل الطلبات في TrueFoundry من خلال قائمة من القواعد، التي تحدد كل منها:
تم التقييم حسب ترتيب القواعد، لذلك يجب وضع القواعد الأكثر تحديدًا فوق القواعد الأكثر عمومية لضمان التطابق الصحيح.
أنواع الحدود المدعومة
تدعم TrueFoundry كلاً من الحدود القائمة على الطلبات والحدود القائمة على الرموز عبر فترات زمنية مختلفة:
يتيح هذا تطبيق السياسات التي تعكس الاستخدام الفعلي للحوسبة، وهو أمر مهم بشكل خاص عند خدمة موجهات متغيرة الطول لنماذج ذات أحجام مختلفة.
حالات الاستخدام الشائعة
تدعم مرونة نظام التكوين مجموعة واسعة من حالات الاستخدام:
نموذج التكوين
name: ratelimiting-config
type: gateway-rate-limiting-config
rules:
  - id: "specific-rule"
    when:
      subjects: ["user:bob@email.com"]
      models: ["openai-main/gpt4"]
    limit_to: 1000
    unit: requests_per_day
يحدد هذا المثال استخدام مستخدم معين لـ GPT-4 بـ 1,000 طلب في اليوم. تم تصميم نظام تحديد معدل الطلبات في TrueFoundry ليكون قويًا وسهل الإدارة في نفس الوقت. بفضل الضوابط الذكية للرموز، والاستهداف الدقيق، والسياسات الواضحة القائمة على YAML، يمكن للفرق توسيع استخدام LLM بثقة مع الحفاظ على التحكم في البنية التحتية والتكلفة.
كيفية تطبيق التكوين
1. قم بتثبيت TrueFoundry CLI:
pip install -U "truefoundry"
tfy login --host https://app.truefoundry.com
2. ضع ملف config.yaml في دليل مشروعك.
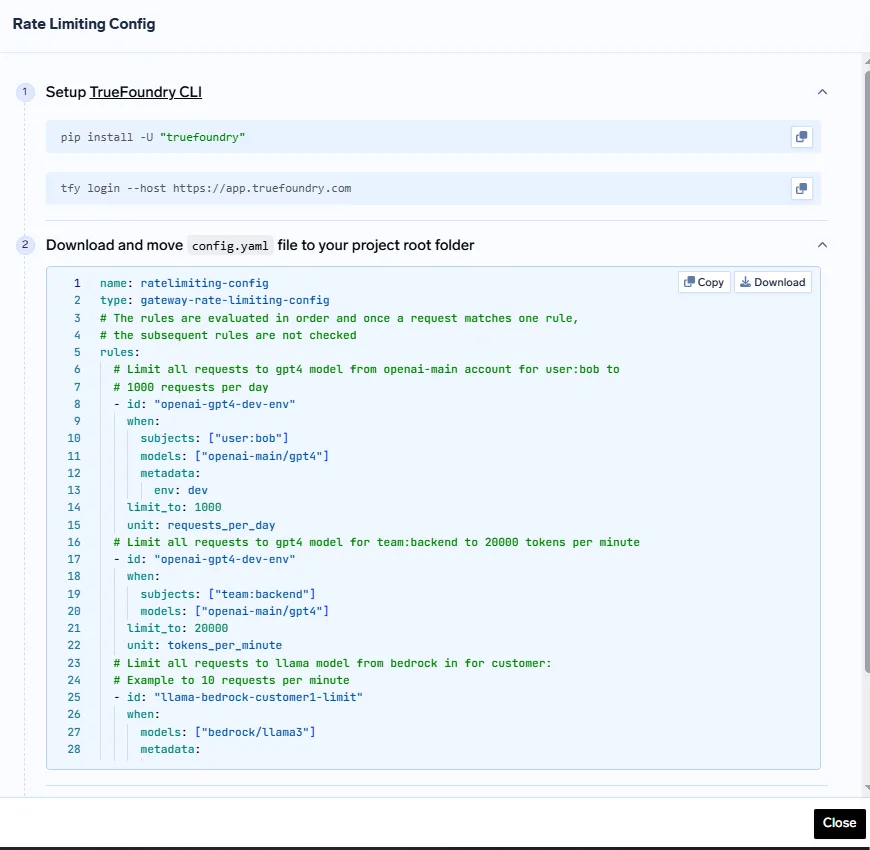
3. طبق التكوين باستخدام:
tfy apply -f config.yaml
يضمن هذا النهج الإعلاني (Declarative) أن تكون حدود معدل الطلبات خاضعة لرقابة الإصدارات، وقابلة للتكرار، ومتوافقة مع أفضل ممارسات GitOps.
ملاحظات واستجابات في الوقت الفعلي حول حدود معدل الطلبات
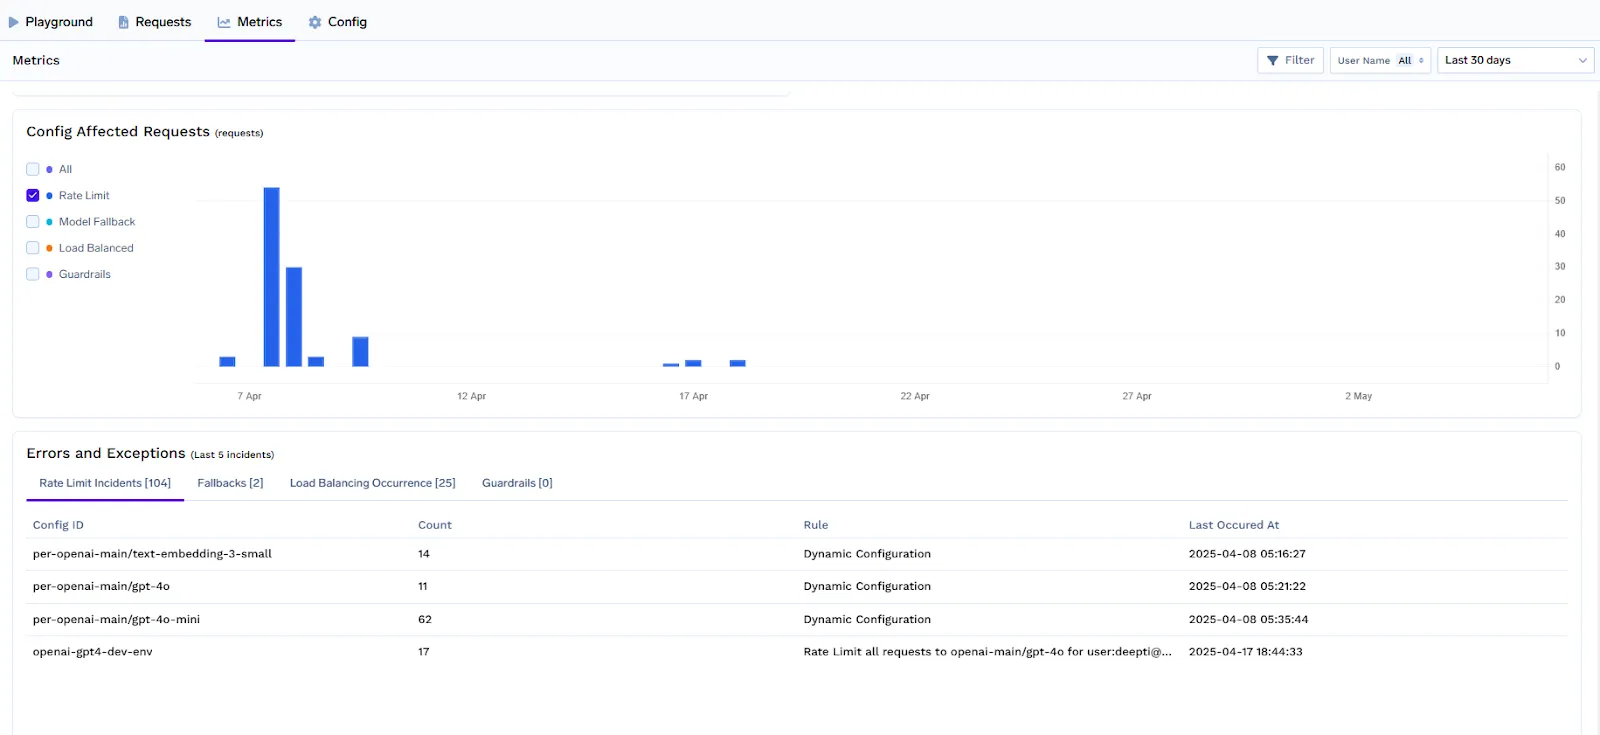
تم تصميم نظام تحديد معدل الطلبات في TrueFoundry لتقديم استجابة فورية وشفافة للعملاء عند خرق الحدود أو الاقتراب من استنفادها. يساعد هذا المطورين على فهم حدود الاستخدام ومعالجة تقليل السرعة (Throttling) بسلاسة في تطبيقاتهم.
عندما يتجاوز الطلب حد المعدل المحدد:
تدعم آلية الاستجابة هذه سلوكًا أفضل للعملاء، وتمكّن من منطق إعادة المحاولة التلقائي، وتضمن بقاء الاستخدام ضمن حدود الحصة دون تخمين.
لوحات التحكم والتنبيهات
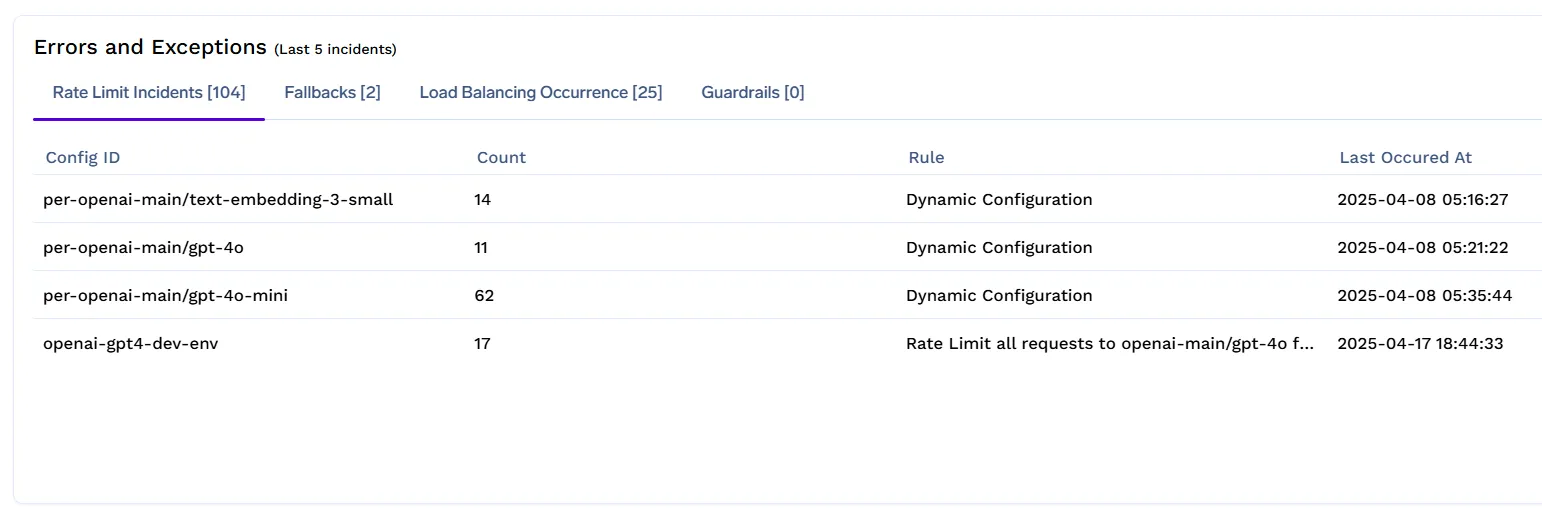
توفر TrueFoundry إمكانية المراقبة المدمجة لمساعدة فرق المنصات على مراقبة وسياسات حد المعدل وتحسينها في الوقت الفعلي.
باستخدام لوحة تحكم LLM Gateway، يمكنك تتبع:
تساعد هذه الرؤى في اكتشاف سوء الاستخدام، وتعديل الحدود استباقيًا، وضمان حصول المستخدمين ذوي التكلفة العالية على خدمة متسقة.
عند فشل واجهات برمجة تطبيقات LLM، سواء كان ذلك بسبب حدود معدل الطلبات، أو الأخطاء الداخلية، أو الانقطاعات المؤقتة، فإن آليات الخيار الاحتياطي تحافظ على تشغيل تطبيقاتك بسلاسة. بدلاً من إعادة الأخطاء إلى المستخدم النهائي، يمكن لـ TrueFoundry توجيه الطلب تلقائيًا إلى نموذج أو مزود بديل، مما يحافظ على التوافر بأقل قدر من الاضطراب.
يتم تشغيل قواعد الخيار الاحتياطي بناءً على شروط محددة مثل معرف النموذج، والمستخدم أو الفريق المطلوب، ورموز الاستجابة مثل 429 أو 500. عندما يستوفي الطلب هذه الشروط، يتم توجيهه إلى نموذج بديل واحد أو أكثر محدد في تكوين الخيار الاحتياطي. يمكن لأهداف الخيار الاحتياطي هذه اختياريًا تضمين عمليات تجاوز للمعلمات مثل Temperature أو max tokens، مما يسمح بضبط السلوك بدقة اعتمادًا على مزود النموذج. يتم تطبيق القاعدة الأولى المطابقة فقط أثناء التقييم، مما يضمن معالجة متوقعة ومحددة للأخطاء.
تتضمن قاعدة الخيار الاحتياطي النموذجية في TrueFoundry المكونات التالية:
تكوين الخيار الاحتياطي النموذجي:
name: model-fallback-config
type: gateway-fallback-config
# The rules are evaluated in order. Once a request matches one rule, the subsequent rules are not checked.
rules:
  # Fallback to gpt-4 on Azure or AWS if openai-main/gpt-4 fails with 500 or 503.
  # The openai-main target also overrides some request parameters like temperature and max_tokens.
  - id: "openai-gpt4-fallback"
    when:
      models: ["openai-main/gpt4"]
      response_status_codes: [500, 503]
    fallback_models:
      - target: openai-main/gpt-4
        override_params:
          temperature: 0.9
          max_tokens: 800
  # Fallback to LLaMA3 on Azure or AWS if bedrock/llama3 fails with 500 or 429 for customer1.
  - id: "llama-bedrock-customer1-fallback"
    when:
      models: ["bedrock/llama3"]
      metadata:
        customer-id: customer1
      response_status_codes: [500, 429]
    fallback_models:
      - target: aws/llama3
      - target: azure/llama3
تدعم بوابة LLM في TrueFoundry بطبيعتها إعداد الخيار الاحتياطي الإعلاني كجزء من نظام التكوين الخاص بها. يتيح ذلك للفرق تحديد سياسات توجيه مسبقة الأخطاء والحفاظ على وقت التشغيل دون تدخل يدوي، خاصة عند العمل مع مزودين متعددين. يعمل تحديد معدل الطلبات الذكي مع الخيار الاحتياطي الآلي على إرساء الأساس لخدمات ذكاء اصطناعي توليدي عالية التوافر.
في أي منصة ذكاء اصطناعي متعددة المستأجرين، يُعد تحديد معدل الطلبات أمرًا حاسمًا لضمان الاستقرار، والعدالة، وحوكمة التكاليف. يتيح للفرق تحديد حدود الوصول ليس فقط للمستخدمين الفرديين ولكن أيضًا عبر الفرق، والحسابات الافتراضية، ونماذج محددة دون الحاجة إلى منطق مخصص.
تدعم بوابة TrueFoundry تحديد معدل الطلبات الإعلاني عبر تكوين YAML، حيث يتم تقييم القواعد حسب الترتيب. يتم تطبيق القاعدة الأولى المطابقة، مما يعني أنه يجب وضع القواعد الأكثر تحديدًا في الأعلى، بينما يجب وضع القواعد العامة في الأسفل في التكوين. يضمن هذا الهيكل تحكمًا متدرجًا مع الحفاظ على تكوينات نظيفة وقابلة للقراءة.
يمكن أن تتضمن كل قاعدة المكونات التالية:
أمثلة على تحديد معدل الطلبات متعدد المستأجرين
حدود طلبات مستخدم معين: لنفترض أنك تريد تحديد جميع الطلبات لنموذج gpt4 من حساب openai-main للمستخدمين bob@email.com و jack@email.com بـ 1000 طلب في اليوم:
- id: "user-gpt4-limit"
  when:
    subjects: ["user:bob@email.com", "user:jack@email.com"]
    models: ["openai-main/gpt4"]
  limit_to: 1000
  unit: requests_per_day
تطبيق الحدود على مستوى الفريق: إذا كنت تريد تقييد إجمالي عدد الطلبات لفريق 'frontend' بـ 5000 طلب في اليوم
- id: "team-frontend-limit"
  when:
    subjects: ["team:frontend"]
  limit_to: 5000
  unit: requests_per_day
تقييد الحسابات الافتراضية: إذا كنت تريد تحديد عدد الطلبات للحساب الافتراضي 'va-james' بـ 1500 طلب في اليوم
- id: "va-james-limit"
  when:
    subjects: ["virtualaccount:va-james"]
  limit_to: 1500
  unit: requests_per_day
تعيين حدود عالمية شاملة عبر جميع المستخدمين والنماذج:
- id: "{user}-{model}-daily-limit"
  when: {}
  limit_to: 1000000
  unit: tokens_per_day
يتيح هذا الإعداد لفرق المنصات تقسيم الاستخدام عبر وحدات الأعمال، وتطبيق حصص لكل بيئة، وحماية نقاط نهاية النماذج المكلفة مع دعم أعباء عمل ذكاء اصطناعي موثوقة وقابلة للتوسع.
تحديد معدل الطلبات هو أكثر من مجرد عنصر تحكم خلفي. إنه مُمكّن حاسم للاستخدام الموثوق، والفعال من حيث التكلفة، والعادل للبنية التحتية لـ LLM على نطاق واسع. سواء كنت تدير منصة متعددة المستأجرين، أو تقدم وصولاً متدرجًا للعملاء، أو تشغل أعباء عمل ذكاء اصطناعي داخلية عبر الفرق، فإن تطبيق حدود ذكية للرموز يضمن بقاء نظامك متوقعًا تحت الضغط.
إلى جانب تحديد معدل الطلبات، توفر ميزات مثل التوجيه الاحتياطي، والملاحظات الاستجابية في الوقت الفعلي، والتكوين الدقيق لفرق الهندسة الأدوات اللازمة للموازنة بين الأداء والتحكم. تجمع بوابة LLM من TrueFoundry هذه الإمكانيات معًا مع واجهة إعلانية، مما يتيح لفرق المنصات تحديد سياسات شفافة، وقابلة للمراجعة، ومتوافقة مع الأهداف التنظيمية.
مع تسارع اعتماد الذكاء الاصطناعي التوليدي، فإن الأنظمة التي تطبق تحكمًا ذكيًا في الوصول دون التضحية بتجربة المستخدم أو وقت التشغيل ستحدد الجيل القادم من مرونة البنية التحتية. إذا كنت تبني أو توسع بوابة ذكاء اصطناعي، فإن تحديد معدل الطلبات ليس مجرد شيء تفكر فيه، بل هو أمر يجب عليك القيام به بشكل صحيح من اليوم الأول.
يشير تحديد معدل الطلبات في بوابة LLM إلى الآلية المستخدمة للتحكم في تردد الطلبات الواردة أو حجم الرموز التي يمكن للمستخدم أو الفريق أو التطبيق معالجتها خلال نافذة زمنية محددة. بخلاف تقليل سرعة API التقليدي، فإنه يدرك الرموز ويأخذ في الاعتبار عبء الحوسبة الفعلي لبنى النماذج المختلفة، مما يضمن أن الاستعلامات ذات الاستهلاك العالي للموارد لا تؤدي إلى تعطل النظام.
يساعد تطبيق تحديد معدل الطلبات في بيئات بوابة LLM على التحكم في التكاليف عن طريق منع الارتفاعات المفاجئة وغير المتوقعة في استهلاك الرموز والبرامج النصية الخارجة عن السيطرة. من خلال تعيين حصص يومية أو ساعية دقيقة، يمكن للمؤسسات وضع حد أقصى للإنفاق لمستخدمين معينين أو لبيئات غير متعلقة بالإنتاج، مما يضمن بقاء تجارب الذكاء الاصطناعي ضمن ميزانية متوقعة مع الحماية من مفاجآت الفواتير المكلفة.
يُعد تحديد معدل الطلبات في إعدادات بوابة LLM أمرًا حيويًا لحماية البنية التحتية من الإساءة وضمان التوافر العالي لجميع المستخدمين. فهو يمنع "المستأجر الصاخب" الفردي من استنزاف حصص المزود أو سعة GPU، مما قد يؤدي بخلاف ذلك إلى زيادة زمن الانتقال وتكرار أخطاء 429 "Too Many Requests". تُعد طبقة الإدارة هذه حاسمة للحفاظ على اتفاقيات مستوى الخدمة (SLAs) المستقرة في الإنتاج.
تتضمن الاستراتيجيات الشائعة لتحديد معدل الطلبات في بوابة LLM حدود الطلبات في الدقيقة (RPM) والرموز في الدقيقة (TPM)، والتي توفر قياسًا دقيقًا لاستخدام الموارد. كما تدعم البوابات المتقدمة حدودًا متدرجة بناءً على أدوار المستخدمين أو أنواع النماذج، مما يسمح للمهام الحيوية بالحصول على أولوية أعلى بينما يتم تقليل سرعة أعباء عمل التطوير ذات الأولوية المنخفضة خلال فترات الازدحام.
على الرغم من أنه يُضيف خطوة معالجة ضئيلة للغاية، فإن rate limiting في LLM gateway يتسبب عادةً في تأخير لا يتجاوز 4 أجزاء من المليثانية، وهو أمر لا يُذكر مقارنةً بالثواني المطلوبة لعملية توليد النموذج. وفي الواقع، فإنه غالبًا ما يُحسّن من زمن الاستجابة الملحوظ عن طريق منع ازدحام صفوف الانتظار في البنية الخلفية (backend queues)، مما يضمن معالجة الطلبات بسلاسة دون التسبب في مهل انقضاء الوقت (timeouts) أو تعطّل الخدمة.
نعم، يوفر TrueFoundry تطبيقًا عالي الكفاءة ومصممًا لبيئات الإنتاج لميزة rate limiting في LLM gateway من خلال إعدادات تصريحية قائمة على القواعد (declarative, rule-based configuration). يتيح ذلك للفرق تطبيق قيود تراعي استهلاك الـ tokens عبر العديد من مزودي النماذج والجهتين المتعددة (tenants) باستخدام ملفات YAML بسيطة. يقدم هذا النظام ملاحظات وتقارير في الوقت الفعلي ولوحات تحكم تفصيلية، مما يُمكّن فرق المنصات من توسيع أعباء عمل AI مع الحفاظ على حوكمة صارمة للتكاليف والموارد.
يعمل AI rate limiting من خلال تتبع معدل إرسال المستخدم للطلبات إلى AI API. يقوم النظام بحساب عدد الطلبات أو الـ tokens خلال نافذة زمنية محددة. إذا تجاوز المستخدم الحد المسموح به، يقوم الـ API بحظر الطلبات الجديدة مؤقتًا أو إرجاع خطأ حتى يتم إعادة ضبط الحد. يحمي هذا الإجراء السيرفرات من التحميل الزائد.
بالتأكيد. من خلال تحديد سقف لاستهلاك الـ tokens ومعدلات الطلبات، تمنع الـ gateways الاستخدام المفرط غير المتوقع لـ GPU أو الإنفاق السحابي الزائد. يمكن للمؤسسات مواءمة الاستخدام مع الميزانيات، والتخطيط للوصول متعدد المستويات (tiered access)، وتقليل التكلفة الناتجة عن التزويد الزائد للموارد (over-provisioning) مع الحفاظ على خدمة مستمرة لأعباء العمل الحرجة.
نعم. تسمح AI gateways الحديثة مثل TrueFoundry للفرق بتحديث قواعد rate-limit في الوقت الفعلي أو عبر سكربتات مؤتمتة، مما يضمن قدرة البنية التحتية على التعامل مع الارتفاعات المفاجئة دون توقف الخدمة أو تراجع الأداء. تحافظ التعديلات الديناميكية على استجابة الخدمة مع ضمان الاستخدام العادل عبر جميع الـ tenants.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد




















