



November 6, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.



Blazingly fast way to build, track and deploy your models!
تُعد قائمة OWASP لأبرز 10 مخاطر في تطبيقات نماذج اللغات الكبيرة (LLM) قائمة متفقًا عليها لأكثر المخاطر الأمنية حرجًا في البرمجيات المدعومة بنماذج LLM، ويشرف عليها مشروع الأمن للذكاء الاصطناعي التوليدي في OWASP. النسخة الحالية هي قائمة عام 2025 المتاحة على genai.owasp.org/llm-top-10. لا تزال قائمة v1.1 لعام 2023/24 مؤرشفة هناك ومستشهدًا بها على نطاق واسع - لذا إذا ذكر أي منشور سرقة النماذج (Model Theft) أو الاعتماد المفرط (Overreliance)، فهو يصف النسخة المتقاعدة.
قائمة عام 2025 كما نشرتها OWASP:
توضح التغييرات اتجاه تركيز الاهتمام. حيث أُضيفت كل من System Prompt Leakage و Vector and Embedding Weaknesses كعناصر جديدة. وتوسعت Model Denial of Service لتصبح Unbounded Consumption. ودمجت Insecure Plugin Design ضمن سلسلة التوريد و excessive agency مع استقرار الأدوات حول بروتوكولات مثل MCP. بينما أُزيلت Model Theft تمامًا.
هذا هو الجزء الذي تتجاهله معظم المقالات. تصنف القائمة المخاطر، والخطر ليس ميزة في منتج. تتبع أربعة من هذه المخاطر مسار الاستدلال (inference path) حيث توجد البوابة (gateway). وتتبع ثلاثة منها كود التطبيق. وتتبع ثلاثة منها مسارات عملية لا تراها البوابة أبدًا.
أربعة مخاطر تقع مباشرة ضمن النطاق، وثلاثة بشكل جزئي، وثلاثة تتطلب مسؤولاً في مكان آخر. إذا كان إطار عمل أمن الذكاء الاصطناعي لديك يحتوي على صف بوابة لـ LLM04 و LLM08، فإن هذا الصف شكلي فقط.
تغطي البوابة LLM01 و LLM02 و LLM06 و LLM10 بشكل جيد لأن جميعها مشكلات متعلقة بـ مسار الطلب (request-path): حيث تحدث لحظة إرسال المحث أو تشغيل الأداة، وهي اللحظة الوحيدة التي تراها البوابة. أما باقي المخاطر فقد حُسمت قبل أسابيع في دورة تدريبية أو عملية فهرسة.
التعامل مع القائمة كقائمة مرجعية للامتثال. تنشر OWASP تصنيفًا للمخاطر مع إرشادات للتخفيف منها، وليس شهادة اعتمادات. لا يوجد تدقيق رسمي لقائمة OWASP LLM Top 10 ولا توجد جهة تمنح شهادة نجاح. مصفوفة يدّعي منتج واحد فيها "تغطية" جميع المخاطر العشرة كُتبت لتجاوز اجتماع عمل، وليس لتصدي لهجوم حقيقي.
وضع التحقق من صحة المخرجات في المكان الخطأ. يتعلق LLM05 بما يفعله تطبيقك بمخرجات النموذج. يمكن للبوابة التنبيه إلى أن الاستجابة تحتوي على os.system أو وسام سكريبت غير معالج. لكنها لا تستطيع منع خدمتك من إرسال هذا النص إلى غلاف النظام (shell). ينبغي أن يكون عنصر التحكم في المكان الذي تُستهلك فيه المخرجات؛ أما فحص البوابة فهو خط دفاع إضافي (defence in depth).
افتراض أن اكتشاف الحقن يعني المنع. الاكتشاف هو نموذج تصنيف (classifier)، والمصنفات تحتوي على نتائج إيجابية خاطئة (false negatives)، والمهاجمون يطورون أساليبهم باستمرار ضدها. الحل المستدام لـ LLM01 هو التنسيق على فرضية أن الحقن قد ينجح أحيانًا وجعل النظام قادرًا على تحمل ذلك - وهي في الحقيقة مشكلة تتبع LLM06. قمم بتضييق نطاق الأدوات المتاحة، وسينتهي الحقن الناجح بنموذج لا يملك أي أدوات خطيرة للاستدعاء.
تجاهل LLM10 باعتباره مجرد شأن متعلق بالفواتير. الوكيل المحتجز في حلقة تكرارية هو هجوم حجب خدمة على ميزانيتك، والاستعلام عالي الحجم هو طريقة استخراج النماذج. إنه أسهل منفذ يمكن إغلاقه، ولكنه الأكثر تركًا دون حماية.
يطبق AI Gateway من TrueFoundry عناصر التحكم هذه في شكل حواجز حماية (guardrails) على خطافات (hooks) في مسار الطلب. هناك أربعة خطافات، وتعتمد المخاطر التي يمكنك معالجتها على الخطاف الذي تستخدمه.
لطلبات LLM: input، قبل وصول المحث إلى النموذج، و output، بعد استجابته.

لاستدعاءات أدوات MCP: mcp_pre_tool، قبل تنفيذ الأداة، و mcp_post_tool، بعد عودتها بالنتائج.
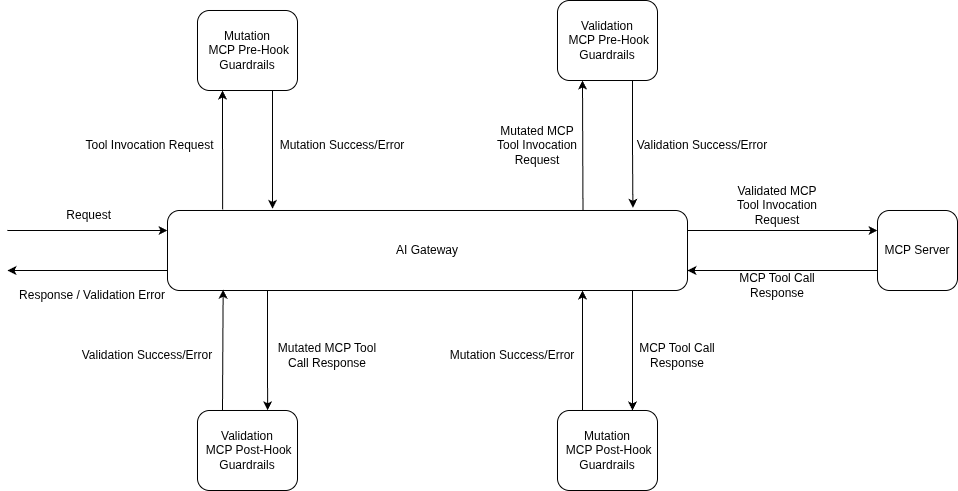
تجعل خطافات MCP هذه التساؤل حول owasp mcp قابلًا للحل. تعمل حواجز الحماية على كل استدعاء أداة بشكل منفصل - يعني استخدام خمس أدوات متتالية تشغيل خمس مجموعات من الفحوصات. أي فشل في مرحلة pre-tool يعني عدم تشغيل الأداة مطلقًا؛ وأي فشل في مرحلة post-tool يمنع إظهار النتيجة.
يمتلك كل حاجز حماية نمط تشغيل (operation mode) - نمط validate يفحص ويمكنه الحظر، ونمط mutate يقوم أيضًا بإعادة الكتابة - بالإضافة إلى استراتيجية تنفيذ (enforcement strategy) تغطي الانتهاكات وأخطاء حاجز الحماية نفسه:
يعمل حاجز الحماية المدمج Prompt Injection بواسطة Azure Prompt Shield وتديره TrueFoundry، دون الحاجة لمفاتيح طرف ثالث. يقوم بتحليل محث المستخدم وأي مستند أو محتوى في السياق بشكل منفصل، وبالتالي فإن الحقن غير المباشر المختفي داخل مستند مسترجع يُكتشف جنباً إلى جنب مع تعليمات الحقن المباشرة مثل "إلغاء جميع التعليمات السابقة". يعمل بنمط Validate-only. يمكنك إضافته من قسم Guardrails:
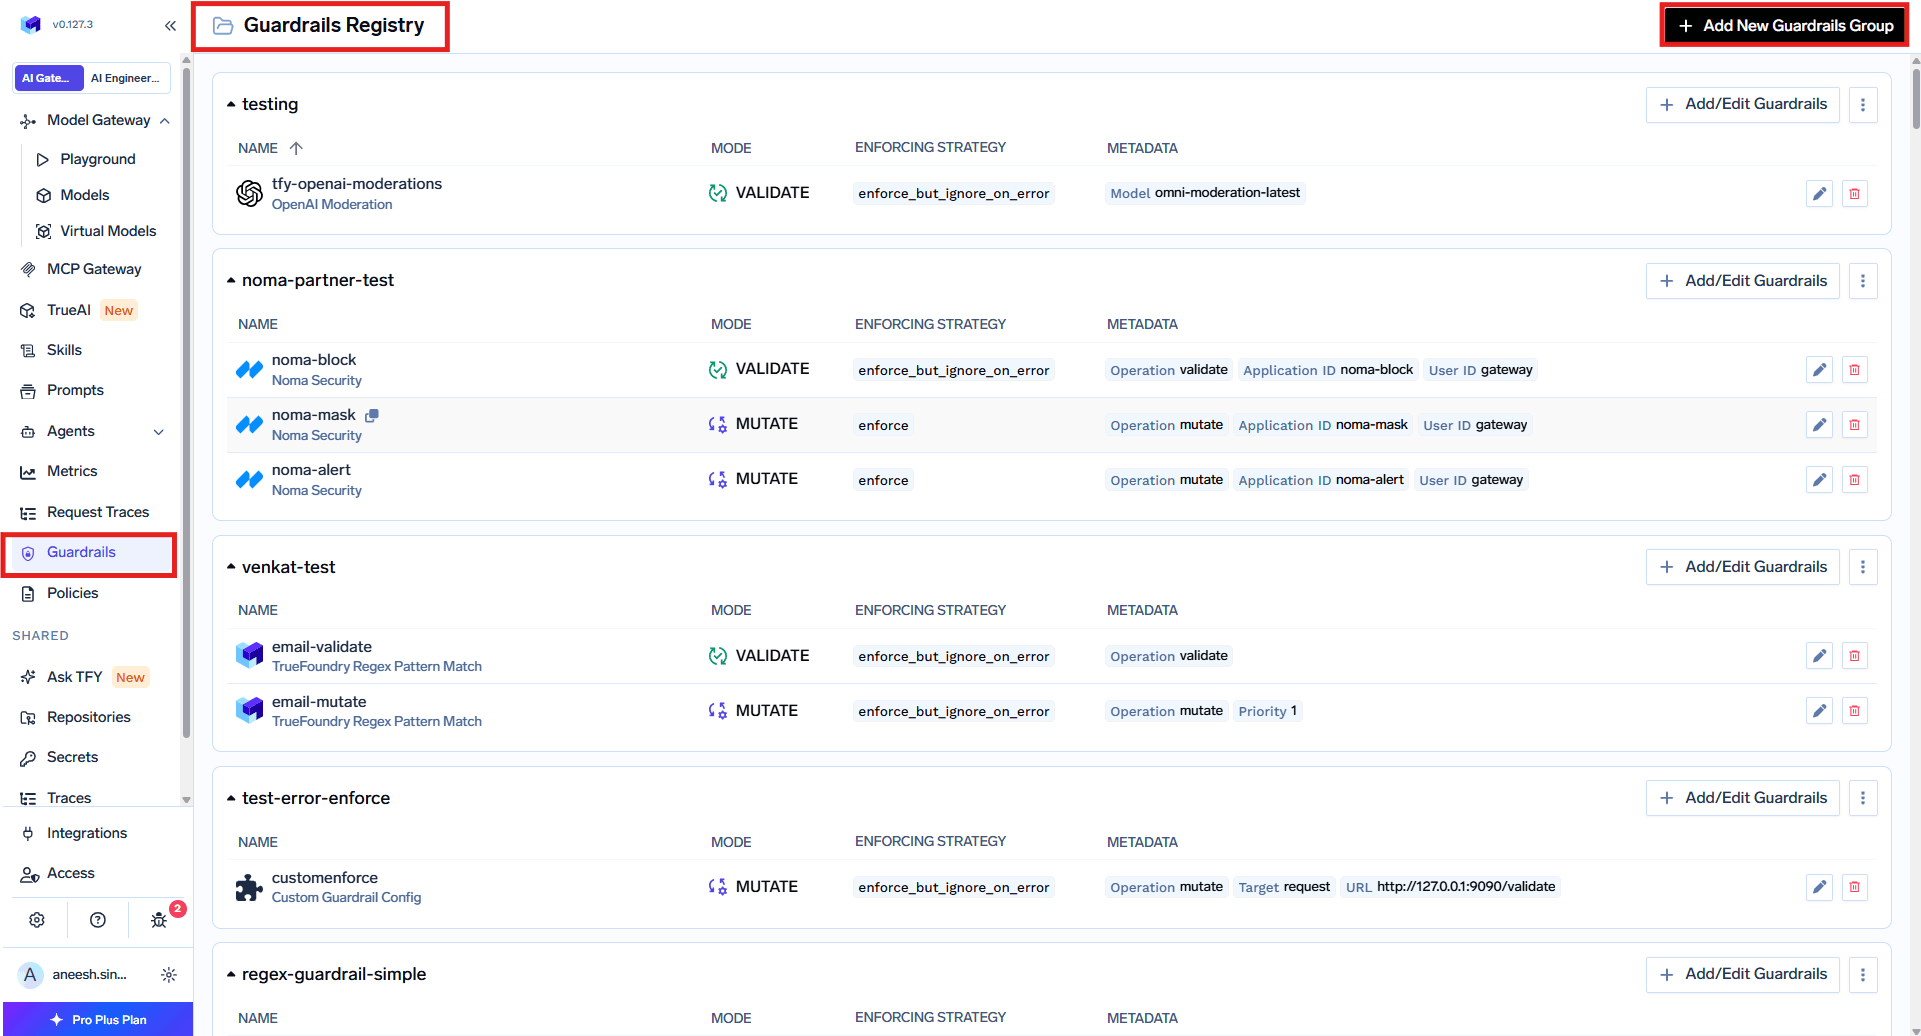
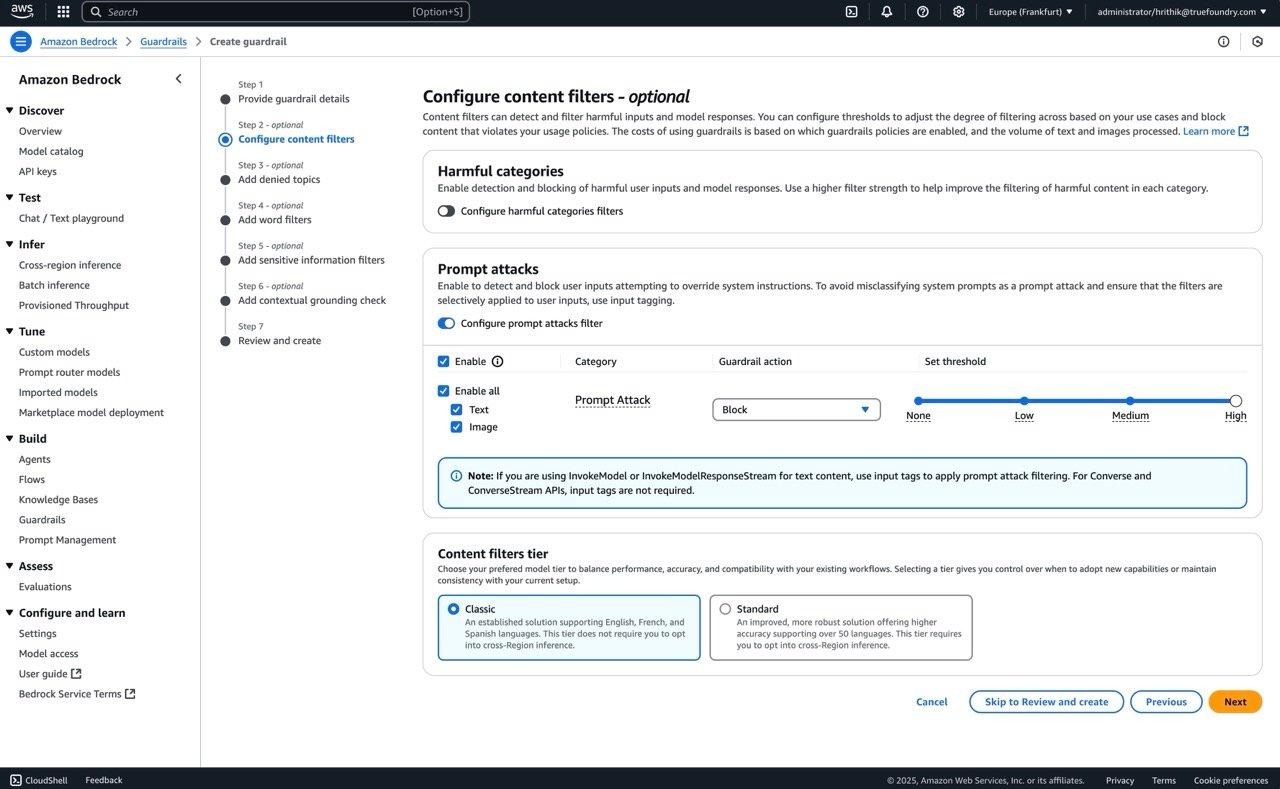
يعمل على LLM Input و MCP Pre Tool، حيث يبحث عن الحقن داخل وسيطات الأدوات. لاستخدام بيانات الاعتماد الخاصة بك، يؤدي AWS Bedrock Guardrails نفس المهمة - قم بتفعيل Prompt Attack، واضبط الإجراء على Block، ثم سجل الحاجز:
يغطي الميزتان المدمجتان معظم هذه الحالات. حيث يكتشف PII / PHI Detection الأسماء والعناوين وأرقام الضمان الاجتماعي وأرقام السجلات الطبية مع فئات كيانات قابلة للتكوين. بينما يلتقط Secrets Detection مفاتيح AWS، ومفاتيح API لـ OpenAI و Anthropic، ورموز GitHub و GitLab، ورموز JWT، والمفاتيح الخاصة، وسلاسل الاتصال بقواعد البيانات، والسلاسل ذات العشوائية العالية (high-entropy) القريبة من كلمات مفتاحية مثل api_key.
ميزة Secrets Detection هي ما ينبغي فهمه جيدًا: فهي الميزة المدمجة الوحيدة التي تعمل على جميع الخطافات الأربعة، وكل منها يلتقط نوعًا مختلفًا من الفشل.
يعمل الفحص داخل البوابة دون الحاجة لاستدعاءات API خارجية، وفي نمط mutate يستبدل النتائج بنص قابل للتعديل، وهو ***REDACTED*** بشكل افتراضي. بالنسبة لبيانات PII في بيئات الاستضافة الذاتية (self-hosted)، يمكنك استخدام Azure PII بمفتاحك الخاص، أو Presidio عبر حاجز حماية مخصص، أو تصفية Bedrock.
هنا تظهر الأهمية الحقيقية لـ خطافات MCP. حيث يلتقط SQL Sanitizer عمليات DROP و TRUNCATE و DELETE أو UPDATE بدون شرط WHERE، واستبدال النصوص. بينما ينبه Code Safety Linter إلى استدعاءات eval و exec و os.system و subprocess، وأوامر الغلاف (shell) الخطيرة. وتطبق سياسات Cedar و OPA سياسة الرفض الافتراضي الدقيقة على استدعاءات أدوات MCP.
ويقع أسفل ذلك نموذج الوصول، وهو الجزء الأكبر من LLM06: حيث يمكن تعطيل الأدوات حتى لا تظهر أبداً في tools/list، ويمكن طلب موافقة MCP Server Approver للاستدعاءات الحساسة، ويعني بروتوكول OAuth لكل مستخدم أن النظام البعيد يقيّم الصلاحيات الحقيقية للمستخدم الحالي بدلاً من استخدام رمز مشترك. يغطي منشورنا حول التحكم في الوصول إلى MCP تلك الطبقة بالتفصيل.
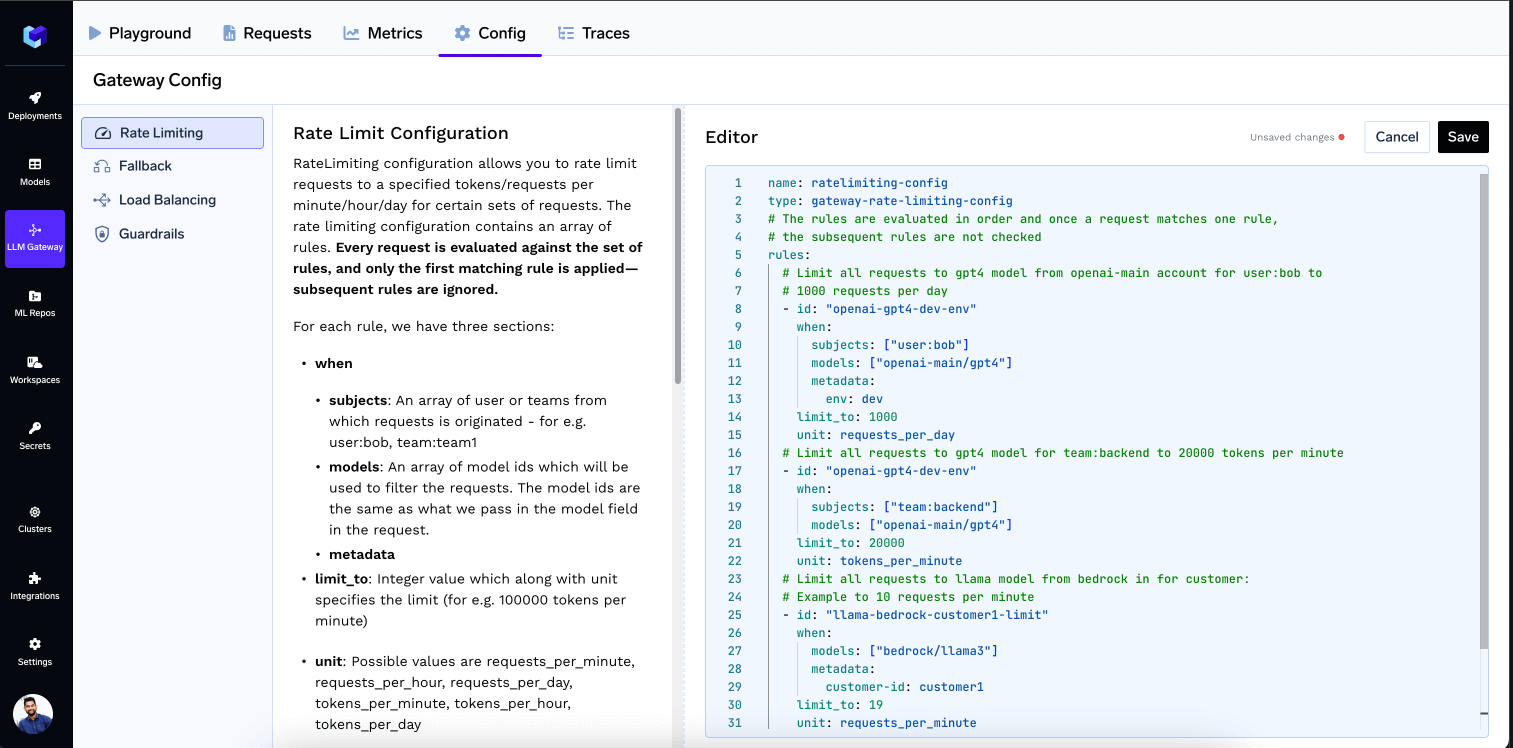
هذا ليس حاجز حماية على الإطلاق - بل هو تحديد معدل الاستخدام (rate limiting) وإعداد الميزانية، ويمثل التغطية الأكثر اكتمالاً في القائمة. تطابق القواعد بناءً على الكيان، أو النموذج، أو البيانات الوصفية وتحدد سقف الطلبات أو الرموز (tokens) لكل دقيقة، أو ساعة، أو يوم:
تقبل خاصية rate_limit_applies_per القيم user، أو virtualaccount، أو model، أو metadata.*، بحد أقصى شرطين لكل قاعدة، بحيث يحصل كل كيان على عداد خاص به بدلاً من التنافس على عداد مشترك. يستخدم التطبيق نافذة منزلقة (sliding window)؛ وعند تجاوز الحد الأقصى يتم إرجاع استجابة HTTP 429 مع ترويسة x-tfy-applied-rules توضح اسم القاعدة المطبقة:
يمكن معالجة LLM09 Misinformation جزئيًا عبر مزودين خارجيين - حيث يوفر Patronus AI و Fiddler أدوات تقييم للهلوَسَة ودقة الاستجابة على خطاف المخرجات. يجب التعامل مع هذه الأدوات كإشارات تنبيهية وليست كحل جذري.
يحصل LLM05 Improper Output Handling على فحص Code Safety Linter و Secrets Detection على خطاف المخرجات. ولا يحل أي منهما محل التحقق المطلوب داخل الكود الخاص بك.
تتوقف حدود تغطيتنا عند LLM03 و LLM04 و LLM08. فسلسلة التوريد هي مشكلة تتعلق بالمشتريات ومسار البناء؛ والمساهمة الوحيدة للبوابة هي التحكم في النماذج وخوادم MCP الموجودة في سجلك. ويحدث التسميم أثناء التدريب. بينما توجد نقاط ضعف المتجهات في مسار RAG الذي لا تقع البوابة فيه. إذا ادعى أي مزود خلاف ذلك، فاسأله عن الخطاف (hook) الذي يعمل عليه عنصر التحكم.
لنأخذ مثال وكيل دعم يقرأ تذاكر العملاء ويستعلم قاعدة بيانات الإنتاج عبر MCP. توجد أربعة مخاطر نشطة من أصل عشرة، وتتطلب أربعة عناصر تحكم مختلفة.
الخطوة الأولى - تسجيل حواجز الحماية. أنشئ مجموعة حواجز حماية وأضف Prompt Injection و PII Detection و Secrets Detection. إذا لم يكن الخيار المدمج مناسبًا، استخدم Custom Guardrail يشير إلى نقطة نهاية HTTPS الخاصة بك:
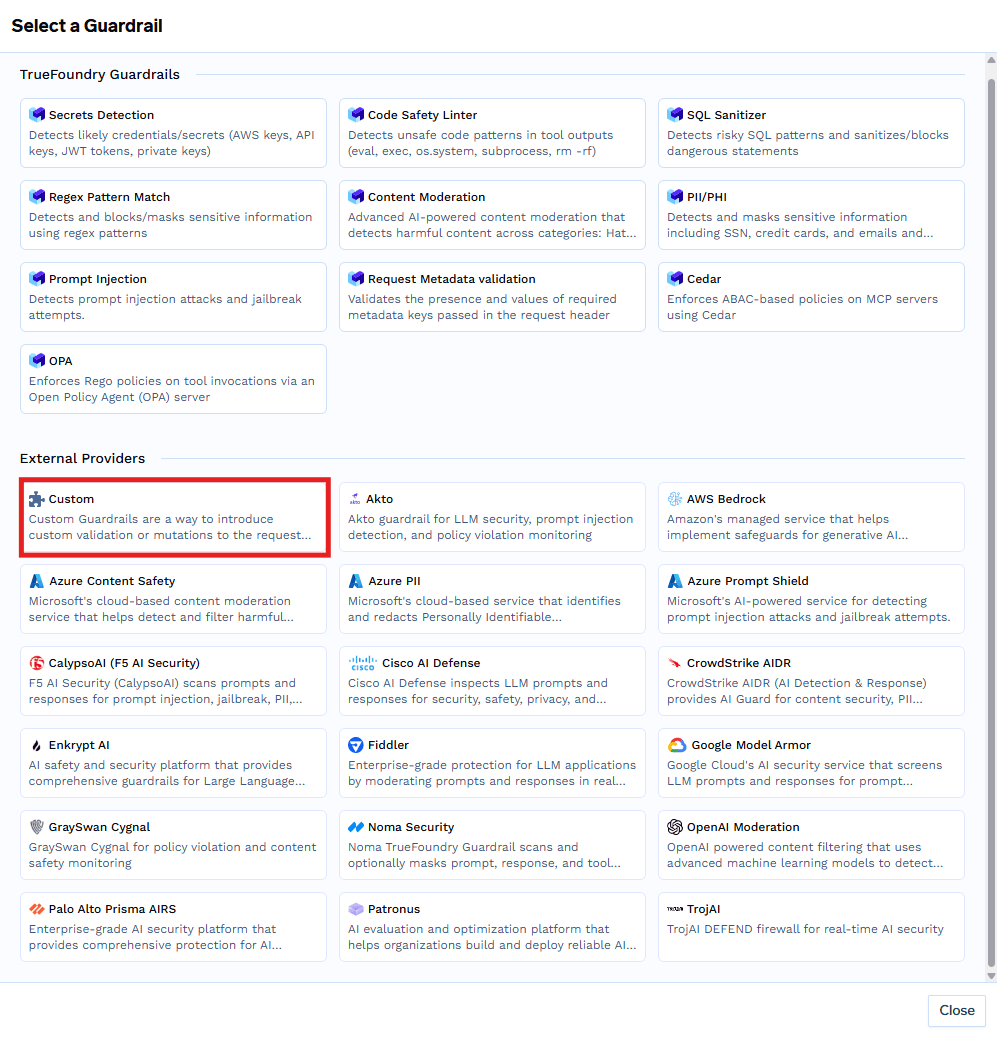
يتلقى حاجز الحماية المخصص requestBody بصيغة OpenAI، وكائن التكوين المحدد في النموذج، وسياقًا يحمل الكيان المستدعي. بالنسبة لحواجز حماية أدوات MCP، يحمل context.metadata أيضًا كائن claims يحتوي على مطالبات تم التحقق منها من رمز JWT الخاص بالمستدعي، مما يسمح بالترخيص حسب التطبيق أو النطاق:
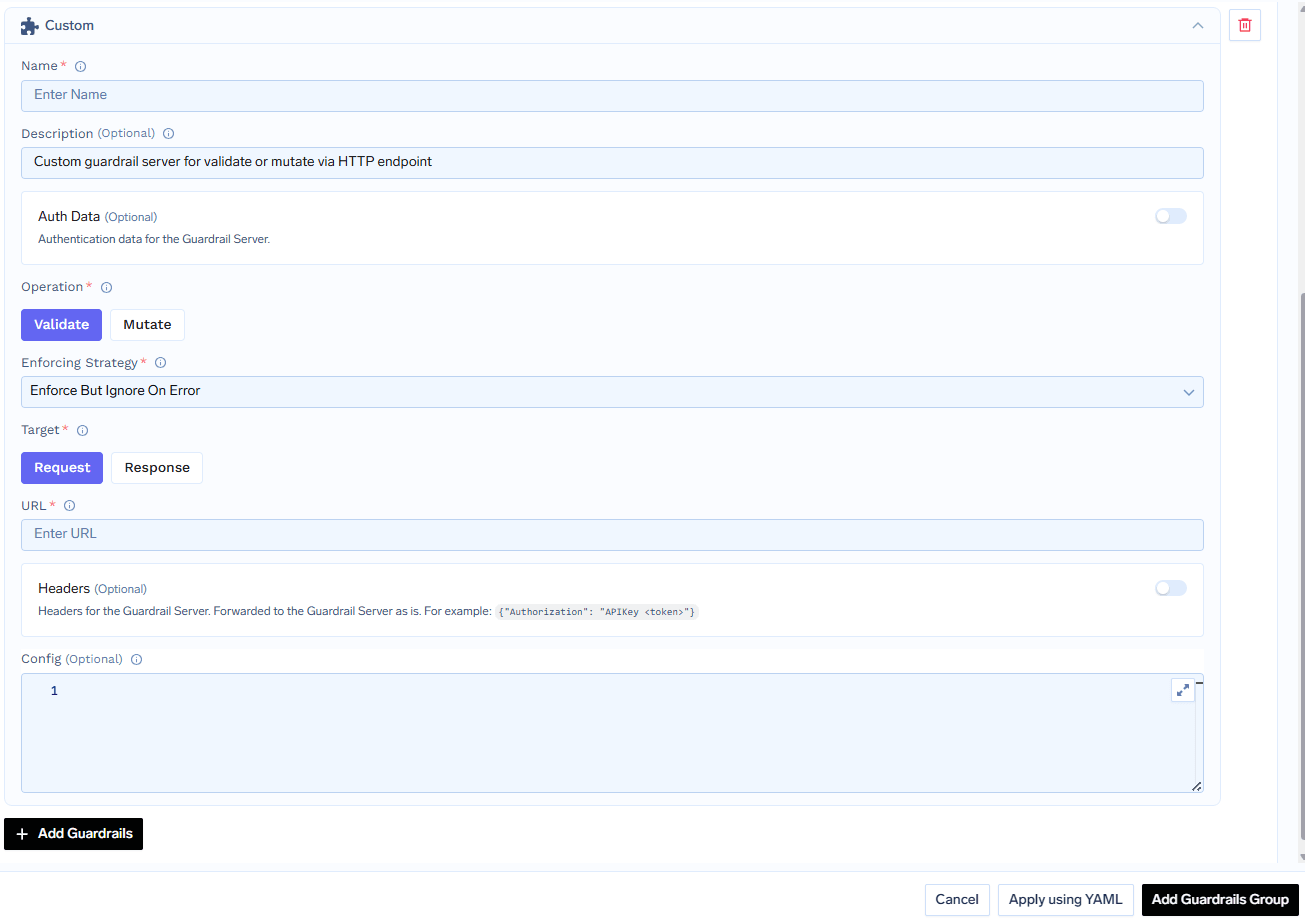
هناك تفصيل في عقود الاستخدام يغفل عنه الكثيرون: يجب إرجاع استجابة HTTP 2xx مع verdict: false للرفض. حيث تعتبر استجابة 400 خطأً في وقت التشغيل، وتحت خيار enforce_but_ignore_on_error يتم السماح بتمرير الطلب.
الخطوة الثانية - كتابة السياسة. تسجيل حاجز الحماية لا يعني تطبيقه على أي شيء تلقائيًا. في Policies ← Guardrails، أنشئ قاعدة تحدد حواجز الحماية التي تعمل على أي خطافات، ولأي نماذج، وخوادم MCP، وكيانات، وبيانات وصفتية.
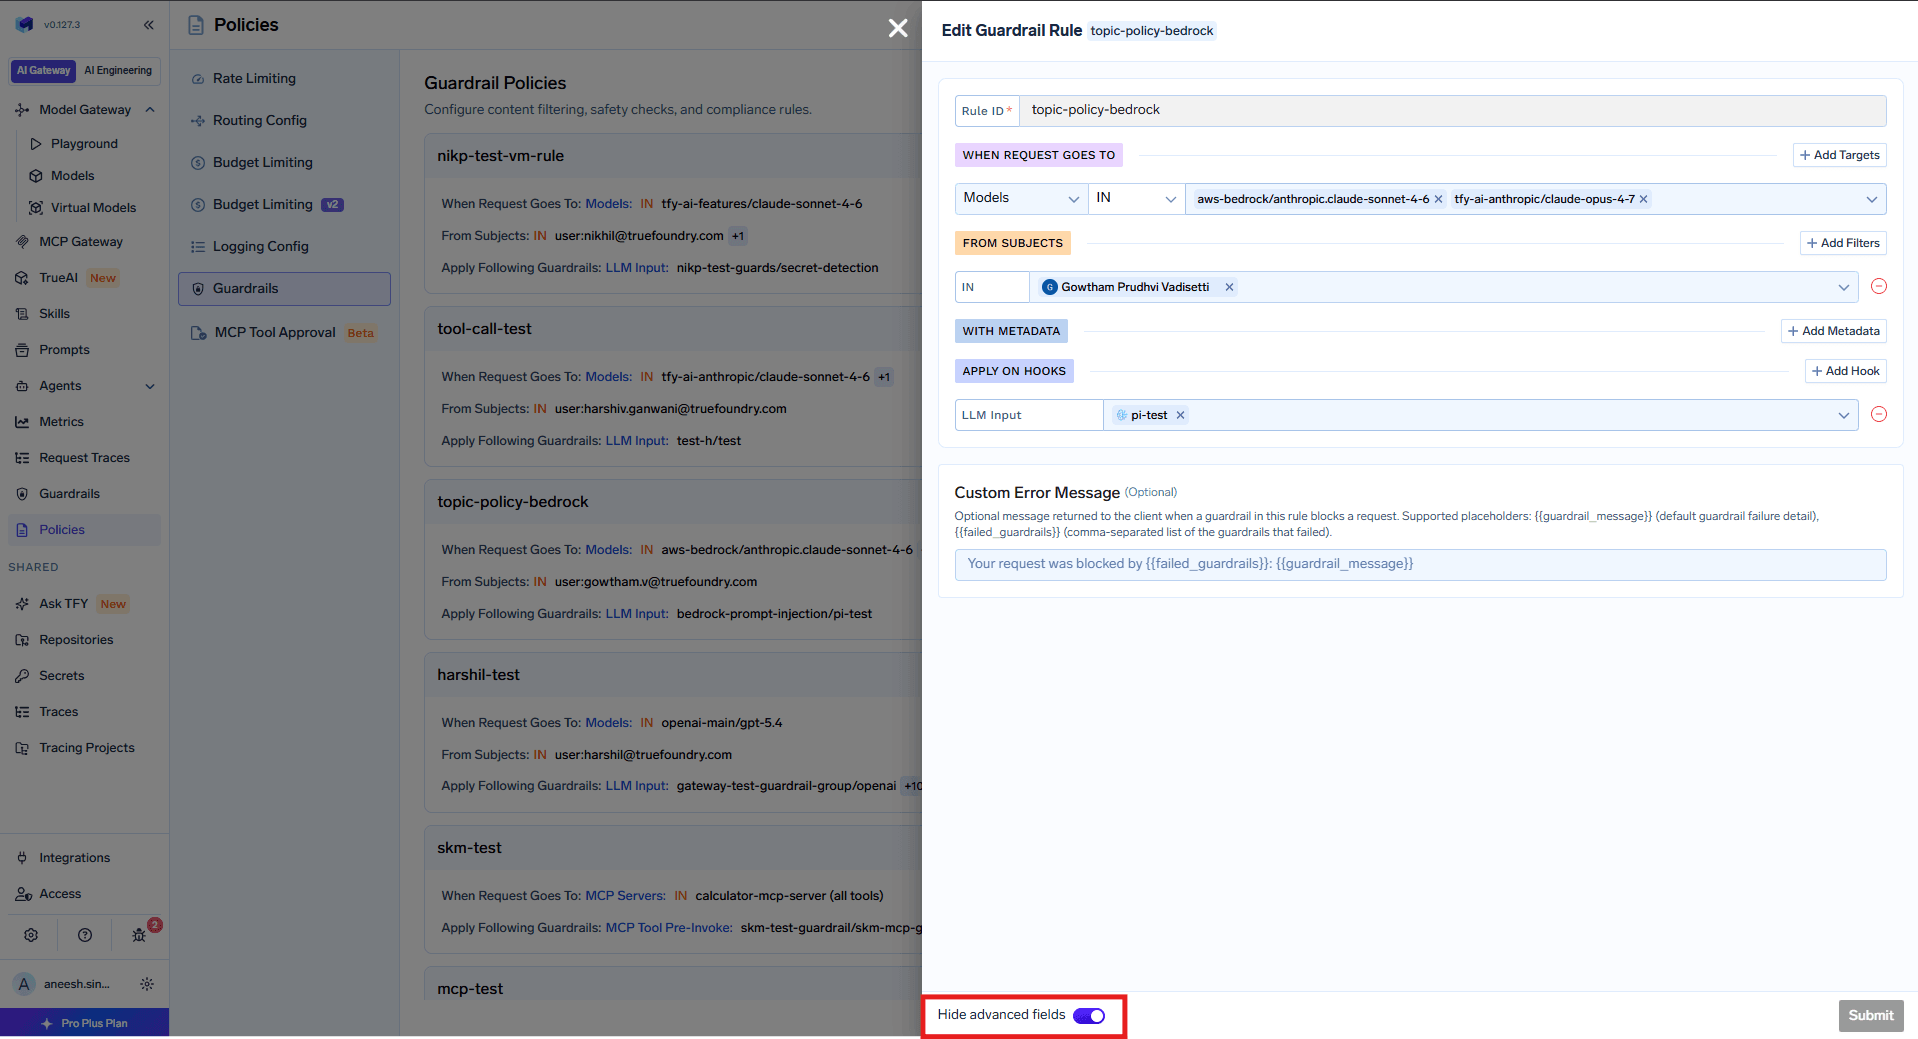
لهذا الوكيل: تطبيق Prompt Injection على LLM Input (LLM01)؛ و PII Detection على Input و Secrets Detection على Output (LLM02)؛ و SQL Sanitizer على MCP Pre-Invoke و Secrets Detection على Post-Invoke (LLM06). وقاعدة تحديد معدل الاستخدام مع rate_limit_applies_per: ['user'] لتغطية LLM10.
تُقيّم جميع القواعد مع كل طلب وتُدمج القواعد المتطابقة لكل خطاف، بحيث تُطبق القاعدة الأساسية وقاعدة الإنتاج الأكثر صرامة معا. استخدام Custom Error Message يعتمد على {{failed_guardrails}} أفضل من إرجاع مخرجات المزود الخام.
الخطوة الثالثة - المراقبة قبل الاعتماد الكامل. ابدأ تشغيل كل حاجز حماية في وضع Audit. يظهر كل منها كـ span منفصل في Monitor ← Request Traces، موضحًا زمن الانتقال، والنتيجة، والنطاق، والنتائج:
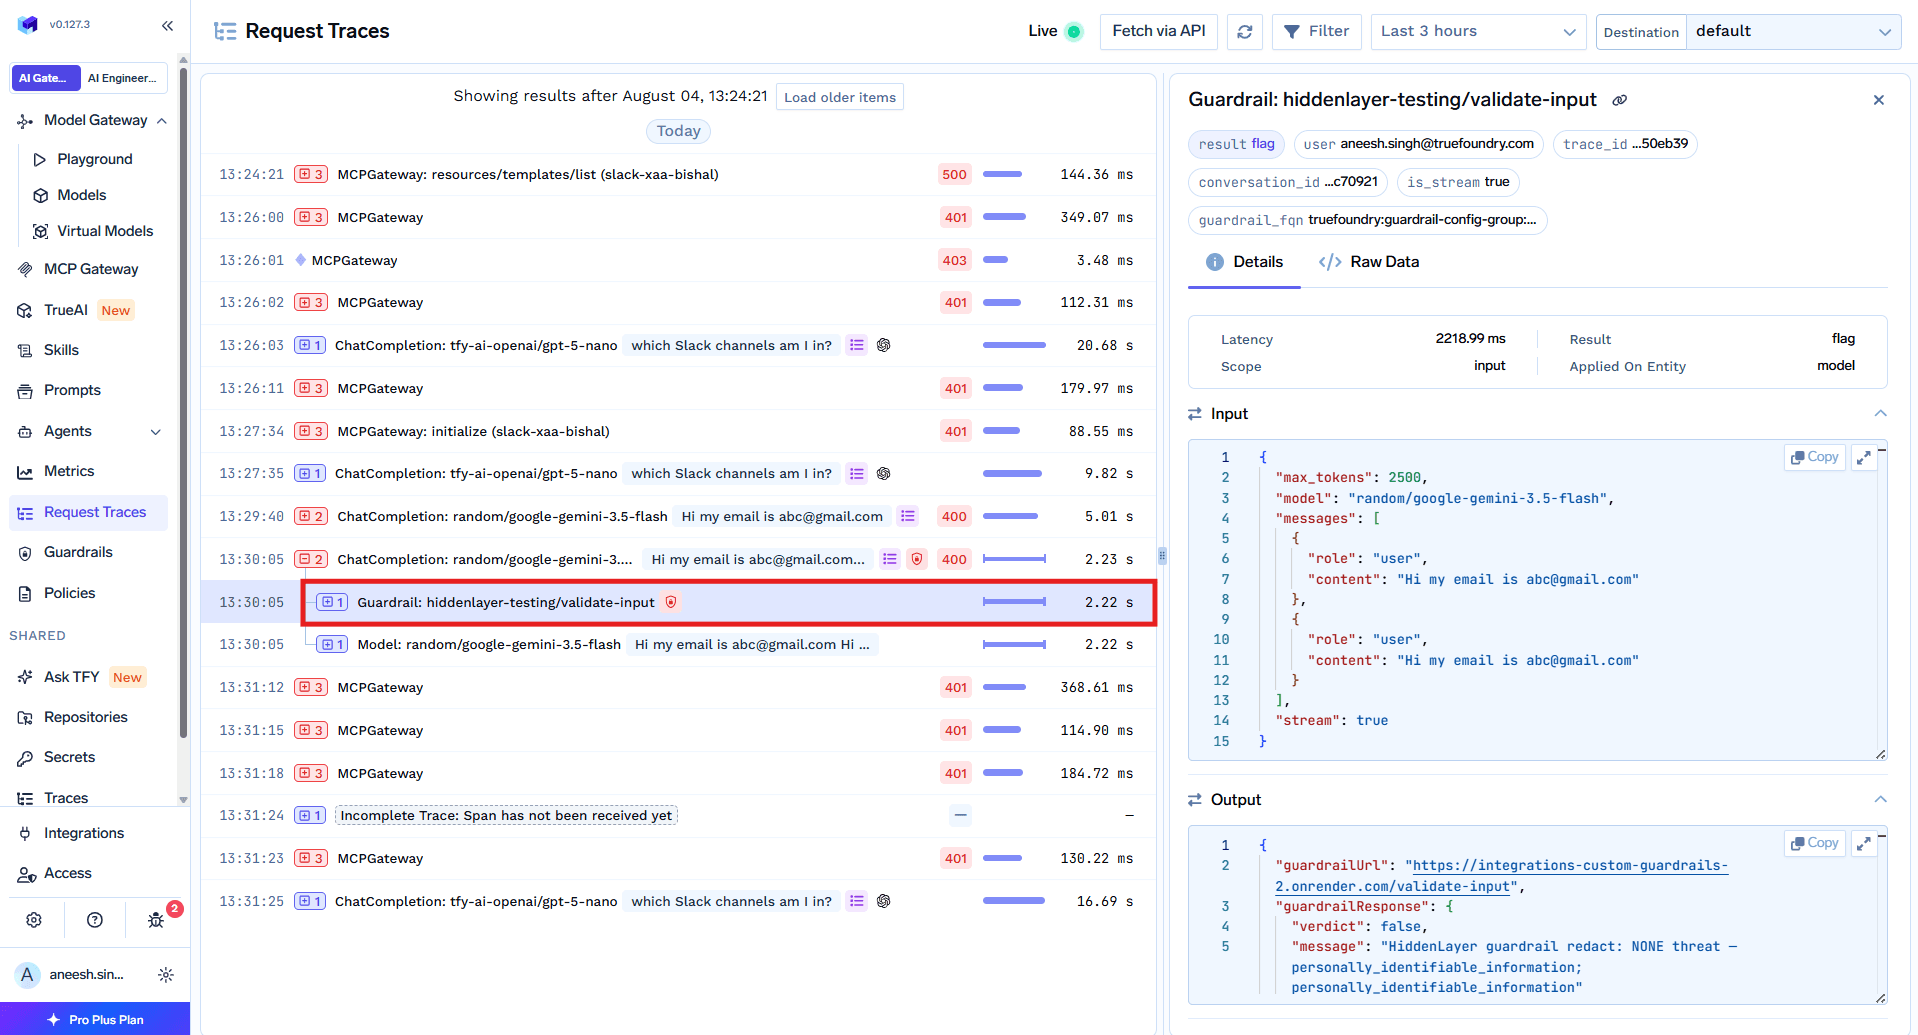
ثم انتقل إلى Enforce But Ignore On Error، والذي يحظر الانتهاكات دون أن يتسبب انقطاع الخدمة لدى المزود في تعطل تطبيقك. لا تستخدم وضع Enforce الكامل إلا عندما يتطلب الامتثال ذلك تمامًا.
حواجز حماية المخرجات لا تعمل على الاستجابات المنسابة (streamed responses). عندما يكون stream: true يتم تجاوزها تمامًا - حيث يتطلب تقييم الاستجابة وجود النص كاملاً، والبث يقوم بتسليم الرموز فور توليدها. هذا الأمر مهم لتغطية LLM02 و LLM05، لأن واجهات الدردشة التي يطلقها الجميع تعتمد البث افتراضيًا. يمكنك إما ضبط stream: false حيث تكون فحوصات المخرجات حاسمة، أو إجراء التحقق من جانب العميل (client-side)، أو قبول أن عناصر التحكم على خطاف المخرجات تكون غير نشطة هناك. لا تتأثر حواجز حماية المدخلات بهذا الأمر.
تُستثنى محثات النظام (System prompts) من حواجز الحماية بشكل افتراضي. تقوم البوابة بإزالتها قبل إرسال المحتوى إلى أي حاجز حماية، وبالتالي لا يتم فحصها أو حظرها أو حجبها أبدًا. يُعد CrowdStrike AIDR الاستثناء الوحيد - حيث يرى محث النظام ولكنه لا يقبل تعديله. من المهم معرفة هذا بالنسبة لـ LLM07: تراقب البوابة محاولات التسريب في طريق الدخول والأسرار في طريق الخروج، وليس المحث نفسه.
أين تتسبب أخطاء التحقق في تكاليف مالية. يعمل التحقق من المدخلات بالتوازي مع طلب النموذج؛ وإذا فشل، تقوم البوابة بإلغاء الاستدعاء الجاري لتجنب التكاليف. أما التحقق من المخرجات فيعمل بعد وصول الاستجابة - فالحظر يحمي مستخدمك، ولكن الرموز تكون قد استُهلكت بالفعل.
ثلاث ميزات مدمجة تقتصر على برمجيات SaaS فقط. ميزات Content Moderation، و PII / PHI Detection، و Prompt Injection غير متاحة في عمليات النشر ذاتية الاستضافة. توجد بدائل - مثل Azure Prompt Shield أو Palo Alto Prisma AIRS للحقن، و Azure PII أو CrowdStrike للبيانات الشخصية، و OpenAI Moderations أو Bedrock Guardrails للإشراف - ولكنها تتطلب استخدام بيانات الاعتماد الخاصة بك.
تُعد قائمة OWASP LLM Top 10 قائمة ممتازة ولكن يُساء استخدامها غالباً. كتصنيف، توضح لك ما يمكن أن يسير بشكل خاطئ وبأي ترتيب تقريبي ينبغي أن تهتم به. أما كقائمة مرجعية لإتمامها بعملية شراء واحدة، فإنها تنتج مصفوفة ضوابط تبدو مكتملة ولكنها لا تحمي شيئًا.
السؤال المفيد ليس "هل يغطي هذا المنتج قائمة Top 10" بل "أي من هذه المخاطر العشرة يحدث في مسار الطلب، وهل هناك ما يراقب ذلك المكان". أربعة منها تحدث هناك. والبوابة هي المكان الصحيح لهذه المخاطر الأربعة، والمكان الوحيد الذي يمكنك فيه تطبيقها مرة واحدة عبر كل نموذج وفريق ووكيل بدلاً من مطالبة عشرة فرق تطبيقات بتطبيقها بشكل صحيح كلٌ على حدة.
بالنسبة للمخاطر الستة الأخرى، ابحث عن المسؤول عنها. فسلسلة التوريد تتبع للمسؤول عن اعتماد النماذج. والتسميم يتبع للمسؤول عن إدارة التدريب. ونتائج ضعف المتجهات تتبع للمسؤول عن بناء الفهرس. اكتب أسماءهم بجوار المخاطر. هذه الوثيقة تساوي أكثر من ادعاء أي مزود بالتغطية الشاملة، بما في ذلك ادعاءاتنا.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



قائمة توافقية بأخطر عشرة مخاطر أمنية في تطبيقات LLM، صادرة عن OWASP GenAI Security Project. والنسخة الحالية هي قائمة 2025: حقن التعليمات، وإفشاء المعلومات الحساسة، وسلسلة التوريد، وتسميم البيانات والنماذج، والمعالجة غير السليمة للمخرجات، والصلاحيات المفرطة، وتسريب تعليمات النظام، ونقاط ضعف المتجهات والتضمينات، والمعلومات المضللة، والاستهلاك غير المحدود. وهي إرشادات لا شهادة اعتماد، فلا يوجد تدقيق يجب اجتيازه.
لا. البوابة تقع على مسار الطلب، ولذلك تعالج جيداً مخاطر هذا المسار: حقن التعليمات، وإفشاء المعلومات الحساسة، والصلاحيات المفرطة، والاستهلاك غير المحدود. وتساعد جزئياً في المعالجة غير السليمة للمخرجات والمعلومات المضللة وسلسلة التوريد. أما التسميم ونقاط ضعف المتجهات فتقع في مسارات التدريب والاسترجاع التي لا تمسها البوابة أبداً.
في الغالب عبر LLM06 Excessive Agency وLLM01 Prompt Injection. استدعاء أداة MCP هو النقطة التي تتحول فيها تعليمات مخترَقة إلى إجراء فعلي، ولذلك تقع الضوابط المهمة على مسار الأداة: خطاف mcp_pre_tool يتحقق من المعطيات قبل التنفيذ، وخطاف mcp_post_tool ينظّف النتائج قبل أن يراها النموذج، وقائمة سماح على مستوى الأدوات، وموافقة على الاستدعاءات التدميرية. وتشغّل TrueFoundry ضوابط الحماية على كل استدعاء أداة على حدة، لا مرة واحدة لكل محادثة.
نعم. تعمل TrueFoundry في VPC الخاصة بك أو محلياً أو في بيئة معزولة عن الشبكة أو هجينة، فلا تغادر التعليمات والردود نطاقك أبداً حتى وأنت توجّه الطلبات عبر مزوّدين كثيرين.
نعم. تتضمن MCP Gateway وAgent Gateway وMCP & Agents Registry مع تحكم في الوصول على مستوى الأدوات. ويمكن حوكمة الوكلاء المبنيين على LangGraph أو CrewAI أو AutoGen أو إطار عمل مخصص مركزياً.
نعم. البوابة متوافقة مع OpenTelemetry وتتكامل مع Grafana أو Datadog أو Prometheus أو حزمتك المفضلة. فهي تتتبع كل طلب من المطالبة إلى تنفيذ الأداة والنموذج، لتحصل على تسجيل موحد دون الحاجة إلى تغيير ما تستخدمه حاليًا.



أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد



















