



November 16, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.



Blazingly fast way to build, track and deploy your models!
تحدث النماذج اللغوية الكبيرة (LLMs) تحولاً جذرياً في كيفية أتمتة المؤسسات للمهام، وإنشائها للمحتوى، وتفاعلها مع البيانات. ومع ذلك، فإن معظم خدمات LLM اليوم تعتمد على السحابة، مما يثير المخاوف بشأن أمان البيانات والامتثال والتحكم.
بالنسبة للمؤسسات التي تتعامل مع معلومات حساسة أو تخضع للوائح تنظيمية، فإن الاعتماد على APIs خارجية أو نماذج السحابة العامة غالبًا ما يكون خيارًا غير عملي. وقد أدى ذلك إلى تحول متزايد نحو عمليات نشر LLM في المقر المحلي (on-premise)، حيث تقوم الشركات بتشغيل النماذج بأمان داخل البنية التحتية الخاصة بها.
في هذه المقالة، نستكشف ماهية نماذج LLMs في المقر المحلي، ولماذا تكتسب هذه الأهمية، وكيف تعمل، وكيف تمكّن منصات مثل TrueFoundry عمليات النشر القابلة للتوسع والآمنة في بيئات المؤسسات.
تشير نماذج LLMs في المقر المحلي إلى النماذج اللغوية الكبيرة التي يتم نشرها وتشغيلها داخل البنية التحتية الخاصة بالمؤسسة بدلاً من استخدام الخدمات السحابية الخارجية أو APIs التابعة لجهات خارجية. يمكن أن تكون هذه النماذج مفتوحة المصدر أو مملوكة لجهة معينة، وتعمل عادةً على خوادم GPU داخلية، أو مراكز بيانات خاصة، أو بيئات سحابية معزولة مهيأة لتلبية معايير الأمان والامتثال الداخلية.
بخلاف نماذج LLMs المستضافة سحابياً والتي تعتمد على نقاط نهاية عامة وبنية تحتية تديرها الجهة الموفرة، تخضع نماذج LLMs في المقر المحلي لسيطرة كاملة من قبل المؤسسة. وتتيح هذه السيطرة قدرًا أكبر من التخصيص، والضبط الدقيق (fine-tuning)، والتكامل مع الأنظمة وسلاسل العمل الداخلية. يمكن للمؤسسات اختيار النماذج المراد استخدامها، مثل LLaMA 2 أو Mistral أو Mixtral، وتحسينها بناءً على احتياجات عمل أو مجال محددة.
يمكّن النشر في المقر المحلي الفرق من تخصيص سلوك النموذج، وتطبيق سياسات إقامة البيانات (data residency)، وضمان عدم مغادرة المعلومات الحساسة لشبكتهم الموثوقة أبداً. كما يفتح الفرص لتحسين الأداء والتحكم في التكاليف بدقة أكبر، خاصة للتطبيقات ذات الحجم الكبير أو الحساسة لزمن الاستجابة (latency). بالنسبة للمؤسسات التي تعطي الأولوية للاستقلالية والأمان والامتثال التنظيمي، توفر نماذج LLMs في المقر المحلي بديلاً عملياً وقابلاً للتوسع لـ APIs الذكاء الاصطناعي التجارية.
يمنحك نشر LLM في المقر المحلي تحكماً كاملاً في البنية التحتية والبيانات وسلوك النموذج. ومع ذلك، فإنه يتطلب أيضاً تخطيطاً دقيقاً واستثماراً وإدارة مستمرة. فيما يلي الجوانب الرئيسية التي يجب عليك أخذها في الاعتبار:
تحتاج إلى أجهزة عالية الأداء لتشغيل النماذج اللغوية الكبيرة بكفاءة. يشمل ذلك معالجات رسومية (GPUs) قوية مثل NVIDIA A100 أو H100، وذاكرة وصول عشوائي (RAM) وفيرة، وشبكات عالية السرعة، وتخزين SSD سريع للتعامل مع أوزان النماذج الكبيرة ومجموعات البيانات.
تحتفظ بالملكية الكاملة لبياناتك، مما يتيح إعدادات معزولة تماماً عن الشبكة الخارجية (air-gapped)، وسياسات جدار حماية صارمة، والامتثال لوائح إقامة البيانات مثل GDPR وHIPAA. وهذا يجعل النشر في المقر المحلي مثالياً للقطاعات التي تتعامل مع معلومات حساسة أو خاضعة للوائح تنظيمية.
يجب عليك تطبيق خطوط أنابيب تعلم الآلة (ML pipelines) للتصدارات، والتضمين في الحاويات (containerization)، والنشر، والمراقبة. تساهم المتابعة المستمرة للأداء في ضمان دقة النموذج وموثوقيته واستقراره التشغيلي على مر الوقت.
على الرغم من تجنب رسوم API المتكررة القائمة على الرموز (tokens)، فإن نشر LLM في المقر المحلي يتطلب استثماراً رأسمالياً أولياً كبيراً في الأجهزة. تحتاج أيضاً إلى حساب التكاليف التشغيلية المستمرة مثل الطاقة، والتبريد، والصيانة، والكوادر المؤهلة.
تحصل على وصول كامل إلى أوزان النموذج، مما يتيح إجراء ضبط دقيق متقدم باستخدام بيانات مملوكة لك. ويمكّن هذا من تحقيق أداء مخصص للغاية يتوافق مع سلاسل العمل الخاصة بمؤسستك، بخلاف النماذج العامة المستضافة سحابياً.
تعتمد قابليتك للتوسع على سعة الأجهزة المتاحة. بخلاف التوسع التلقائي السحابي، يجب عليك التخطيط لأحمال العمل الذروية، وتطبيق توزيع الأحمال (load balancing)، وتحسين الأنظمة للحفاظ على زمن استجابة منخفض وإنتاجية عالية.
يكون فريق تكنولوجيا المعلومات أو DevOps الداخلي لديك مسؤولاً عن تثبيت التحديثات الأمنية، وصيانة البنية التحتية، وتحديث النماذج. تضمن الصيانة المنتظمة موثوقية النظام، وأمانه، وتوافقه مع متطلبات الذكاء الاصطناعي المتطورة.
سقّلت خدمات الذكاء الاصطناعي السحابية على الفرق تجربة نماذج تعلم الآلة وإنشاء نماذج أولية لها ونشرها بمقاييس كبيرة. ومع ذلك، عندما يتعلق الأمر بأحمال العمل الإنتاجية في بيئات المؤسسات، فإن الاعتماد حصرياً على LLMs المرتكزة على السحابة يطرح العديد من القيود التي لا يمكن التغاضي عنها.
تعد خصوصية البيانات والتحكم فيها أبرز المخاوف. عند استخدام APIs السحابة العامة، يجب نقل إدخالات البيانات الحساسة عبر الإنترنت ومعالجتها على بنية تحتية خارجية. يمثل هذا مخاطر تتعلق بتسريب البيانات، والوصول غير المصرح به، وانتهاكات الامتثال—خاصة في قطاعات مثل الرعاية الصحية، والمالية، والدفاع، والخدمات القانونية، حيث تطبق معايير تنظيمية صارمة.
يعد الارتباط المباشر بالمورد (Vendor lock-in) عيباً رئيسياً آخر. غالباً ما تجمع منصات الذكاء الاصطناعي السحابية بين APIs الاستدلال، والتخزين، والضبط الدقيق داخل أنظمة بيئية مملوكة لها. وبمجرد بناء سلسلة عمل حول موفر معين، ينطوي الانتقال إلى خدمة أخرى أو نقل أحمال العمل إلى الداخل على استهلاك كبير للوقت والتكلفة. يحد هذا الاعتماد من المرونة طويلة الأجل والتحكم في تحديثات النماذج أو شروط الاستخدام.
كما يشكل توسع التكاليف غير المتوقع تحدياً مع نمو الاستخدام. تتطلب نماذج LLMs كثافة حوسبية عالية، ويمكن أن تؤدي نماذج التسعير السحابية القائمة على عدد الرموز (tokens) أو حجم الطلبات إلى ارتفاع التكاليف التشغيلية بشكل حاد—خاصة للتطبيقات ذات الإنتاجية العالية أو التفاعل المستمر.
بالإضافة إلى ذلك، توفر البيئات السحابية خيارات محدودة لعمليات النشر ذات زمن الاستجابة المنخفض وعلى الحافة (edge). وقد تواجه التطبيقات التي تتطلب استجابات شبه فورية أو وظائف تعمل دون اتصال بالإنترنت صعوبة في تحقيق أهداف الأداء عند اعتمادها على APIs خارجية.
أخيراً، تخفي الجهات الموفرة للخدمات السحابية معظم تفاصيل البنية التحتية، مما يترك الفرق بأقل قدر من الرؤية حول اختناقات الأداء، وفرص التحسين، أو معلمات الضبط.
بالنسبة للمؤسسات التي تتطلب التحكم والشفافية الاستدامة طويلة الأجل، تجعل هذه القيود من اعتماد حلول LLM في المقر المحلي خياراً قوياً.
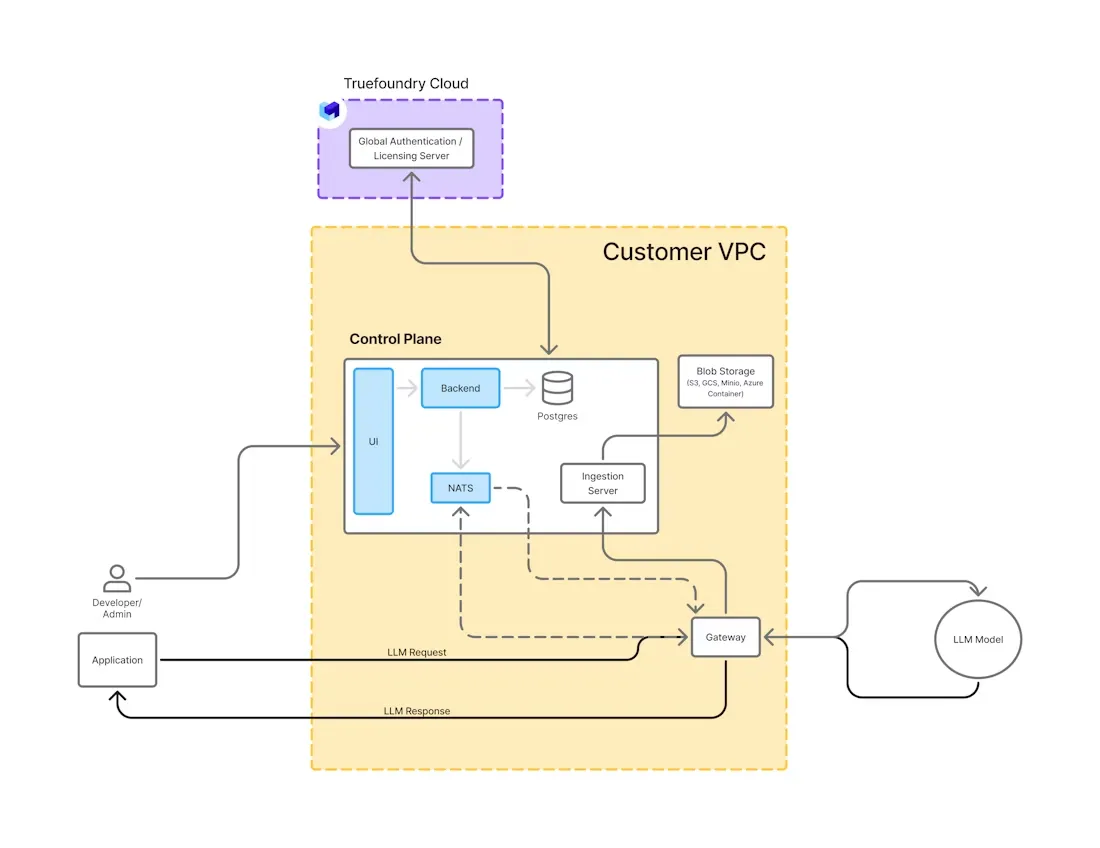
يتطلب نشر LLMs في المقر المحلي معمارية جيدة الهيكلة توازن بين الأداء والأمان وقابلية الصيانة. فيما يلي المكونات الرئيسية التي تتوفر عادةً في الإعدادات ذات المستوى الإنتاجي.
البنية التحتية للحوسبة: تشكل معالجات GPUs عالية الأداء الأساس لنماذج LLMs في المقر المحلي. غالباً ما تستخدم المؤسسات معالجات NVIDIA A100 أو H100 أو L40 GPUs، اعتماداً على حجم النموذج ومتطلبات الإنتاجية. وتُستضاف هذه المعالجات في مراكز بيانات محلية أو مجموعات سحابية خاصة مع توفير التبريد والشبكات والتخزين المناسب.
محرك الاستدلال: تتولى أطر عمل الاستدلال مثل vLLM أو TGI أو DeepSpeed-Inference التنفيذ الفعلي للنموذج. حيث تقوم بتحسين استخدام الذاكرة، ودعم تدفق الرموز (token streaming)، والسماح بتجميع الطلبات المتعددة (batching) لزيادة الإنتاجية إلى الحد الأقصى.
إدارة النماذج والتخزين: تُخزن النماذج محلياً في مستودعات عناصر آمنة (artifact repositories) أو نقاط تجميع أحجام التخزين (volume mounts). وتعتبر آليات تتبع الإصدارات والتراجع وضبط الوصول ضرورية لإدارة دورات حياة النماذج وتدقيق التغييرات.
التضمين في الحاويات والتنسيق: تُستخدم أدوات مثل Docker وKubernetes لنشر أحمال عمل LLM وتوسيعها وإدارتها. يتولى Kubernetes التوسع التلقائي، وجدولة GPU، وتوزيع الأحمال، والتعافي من الفشل، مما يضمن أداءً متسقاً عبر الخدمات.
طبقة API والتوجيه: تعرض طبقة API متوافقة مع REST أو OpenAI وظائف LLM للتطبيقات الداخلية. ويمكن أن تتضمن التوجيه متعدد النماذج، ومصادقة المستخدم، وتصفية الأوامر (prompts) من أجل السلامة والتحكم.
إمكانية الملاحظة والمراقبة: يتم تتبع المقاييس مثل زمن الاستجابة، واستخدام GPU، وإنتاجية الطلبات، وسرعة إنشاء الرموز باستخدام أدوات مثل Prometheus وGrafana وOpenTelemetry. يعد تسجيل البيانات والتنبيه أمراً حاسماً للحفاظ على وقت التشغيل واستكشاف الأخطاء وإصلاحها.
تتيح هذه المعمارية النمطية للمؤسسات بناء أنظمة LLM قابلة للتوسع وآمنة ومصممة خصيصاً لتلبية سياساتها الداخلية، وأهداف الأداء، ومتطلبات الامتثال لديهم.
تشهد نماذج LLMs في المقر المحلي اعتماداً متزايداً عبر القطاعات التي تتطلب سيادة البيانات، وأداءً بزمن استجابة منخفض، وتحكماً كاملاً في خطوط أنابيب الذكاء الاصطناعي. فيما يلي بعض حالات الاستخدام الشائعة والمؤثرة.
تستخدم المستشفيات ومختبرات الأبحاث نماذج LLMs لتلخيص ملاحظات المرضى، وإنشاء تقارير الخروج، والمساعدة في التوثيق السريري. تضمن عمليات النشر في المقر المحلي بقاء معلومات صحة المرضى داخل البنية التحتية الآمنة للمستشفى، مما يدعم الامتثال لـ HIPAA وسياسات البيانات المؤسسية.
تستخدم المؤسسات المالية نماذج LLMs لمهام مثل تلخيص مكالمات أرباح الشركات، وأتمتة تقارير الامتثال، وتحليل القوائم المالية. تمنع الإعدادات في المقر المحلي تعرض البيانات المالية الحساسة لـ APIs الخاصة بجهات خارجية مع الحفاظ على الامتثال لأطر المخاطر الداخلية وعمليات التدقيق التنظيمي.
تستخدم الهيئات الحكومية نماذج LLMs للإجابة على الأسئلة، وتلخيص التقارير المصنفة، واسترجاع المعرفة الداخلية. وبما أن بيانات الأمن القومي يجب أن تظل محمية بشكل صارم، فإن نماذج LLMs في المقر المحلي تمكّن تطبيقات الذكاء الاصطناعي التوليدي دون انتهاك بروتوكولات تصنيف البيانات.
تستخدم مكاتب المحاماة والأقسام القانونية نماذج LLMs لتحليل العقود، وإنشاء الملخصات، والمساعدة في الأبحاث القانونية. يضمن النشر في المقر المحلي عدم مغادرة المعلومات المحمية بامتياز السرية بين المحامي والموكل للسيرفرات الداخلية، مما يحافظ على السرية ويلبي متطلبات نقابات المحامين.
تستخدم الشركات في قطاع التصنيع نماذج LLMs لإنشاء أدلة استكشاف الأخطاء وإصلاحها، وتفسير سجلات المستشعرات، ومساعدة الفنيين الميدانيين. يساعد نشر LLMs على سيرفرات محلية في تجنب إرسال بيانات الآلات المملوكة للشركة إلى خدمات خارجية ويقلل من زمن الاستجابة للبيئات النائية أو غير المتصلة بالإنترنت.
تستخدم شركات الاتصالات نماذج LLMs لتشغيل روبوتات الدردشة، وفرز التذاكر، تقديم توصيات الخدمة المؤتمتة. يتيح النشر في المقر المحلي أداءً في الوقت الفعلي مع الاحتفاظ ببيانات العملاء داخل البنية التحتية الداخلية لضمان الامتثال لقوانين الخصوصية الإقليمية.
تسلط حالات الاستخدام هذه الضوء على كيفية تمكين نماذج LLMs في المقر المحلي للأتمتة القوية والذكاء دون المساومة على الأمان أو الامتثال أو التحكم.
يتضمن نشر LLMs في المقر المحلي سلسلة من الخطوات المنسقة، بدءاً من اختيار النموذج وصولاً إلى المراقبة الإنتاجية. تضمن سلسلة العمل المحددة بوضوح أن يكون النظام قابلاً للتوسع وآمناً ومحسّناً لتلبية احتياجات مؤسستك.
تبدأ العملية باختيار نموذج مناسب بناءً على حالة الاستخدام الخاصة بك. غالباً ما تُفضل النماذج المفتوحة المصدر الشائعة مثل LLaMA 2 أو Mistral أو Mixtral لعمليات النشر في المقر المحلي. بمجرد الاختيار، يتم تنزيل النموذج، وتكميمه (quantized) إذا لزم الأمر، والتحقق من توافقه مع البنية التحتية لديك.
بعد ذلك، يتم إعداد خوادم GPU أو موارد السحابة الخاصة. يتضمن ذلك إعداد بيئات تشغيل الحاويات (مثل Docker)، وأدوات التنسيق (مثل Kubernetes)، وطبقات التخزين لاستضافة أوزان النموذج والسجلات. يتم تكوين ضوابط الوصول وسياسات الأمان لتلبية متطلبات الامتثال.
يتم تحميل النموذج في محرك استدلال مثل vLLM أو TGI. توفر هذه المحركات بيئة التشغيل لإنشاء النصوص في الوقت الفعلي، والتجميع (batching)، والتدفق (streaming)، وتحسين الذاكرة. تحدد ملفات التكوين حجم الدفعة، والحد الأقصى للرموز، وحدود التزامن.
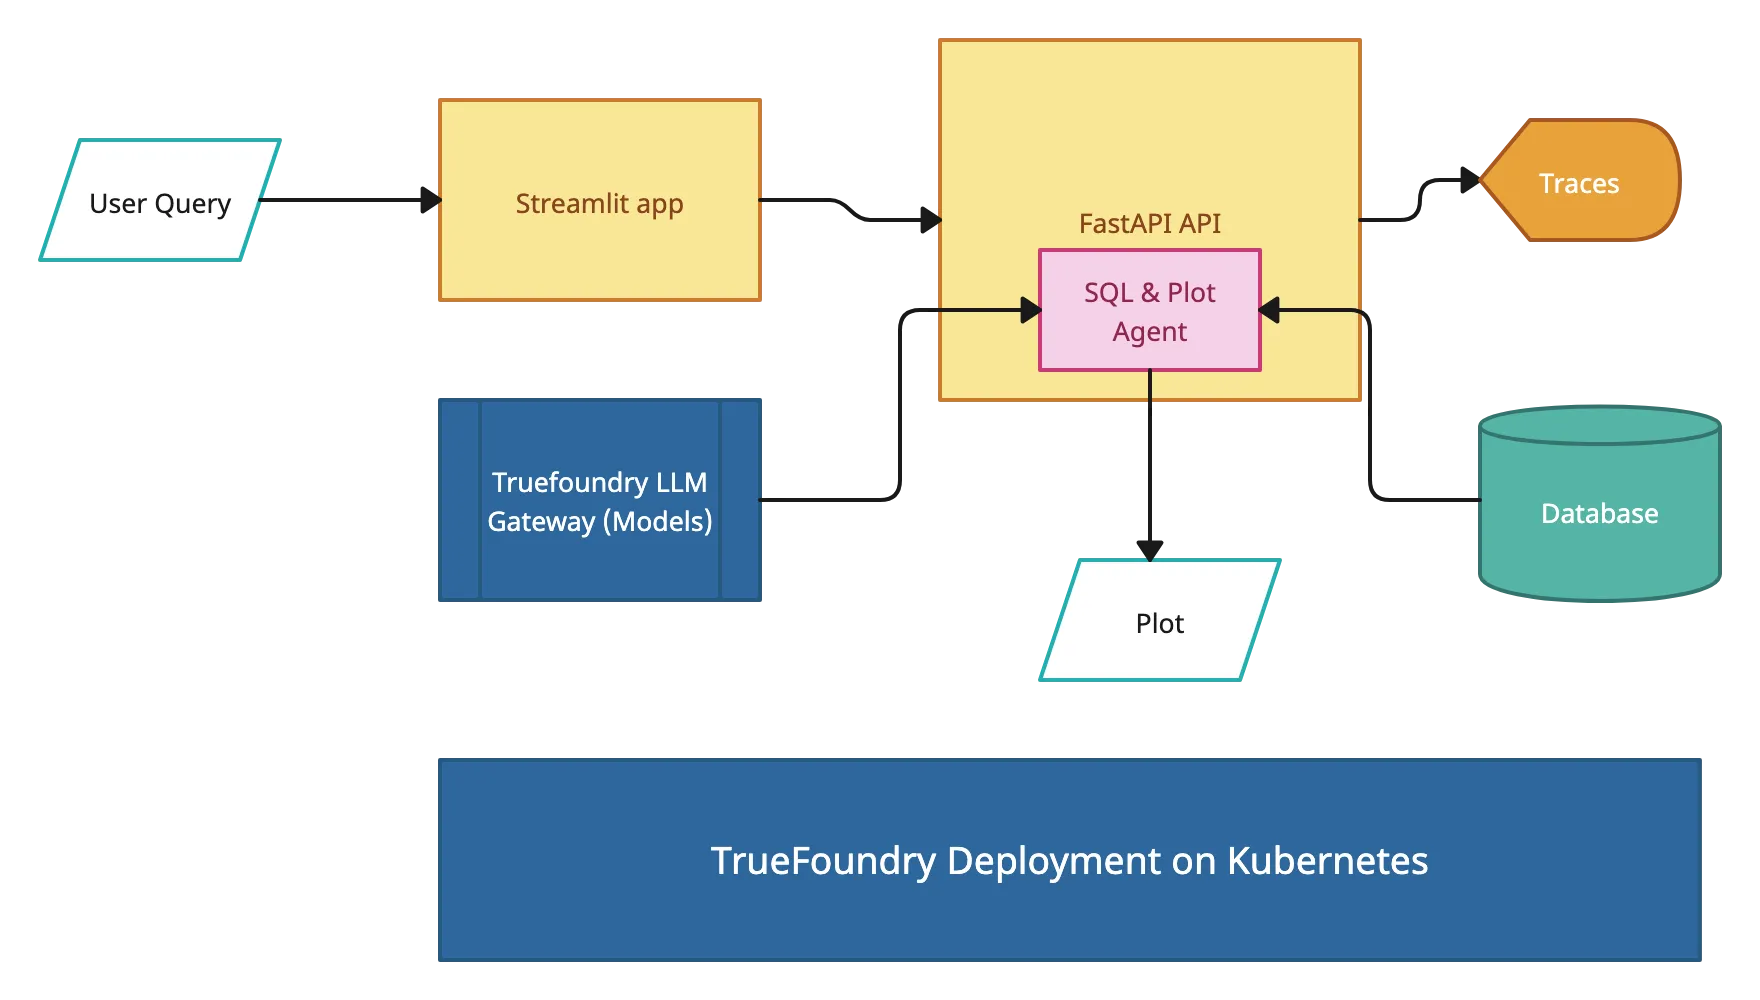
بمجرد أن يصبح المحرك قيد التشغيل، يتم إتاحته عبر API متوافق مع REST أو OpenAI. يتيح ذلك للتطبيقات الداخلية أو الأدوات أو واجهات المستخدم الاستعلام من النموذج. يمكن إضافة التوجيه متعدد النماذج، والمصادقة، وتحديد معدل الاستخدام (rate limiting) في هذه الطبقة لتحكم أفضل.
تُربط أدوات إمكانية الملاحظة لتتبع استخدام GPU، وزمن الاستجابة، وإنتاجية الرموز، وأخطاء الطلبات. وبناءً على أنماط الحركة، يتم تكوين سياسات التوسع التلقائي أو إجراءات التوسع اليدوي للتعامل مع الطلب دون انقطاع الخدمة.
يساعد اتباع سلسلة العمل هذه المؤسسات على إطلاق نماذج LLMs وإدارتها بكفاءة داخل بنيتها التحتية دون الاعتماد على منصات خارجية أو تعريض البيانات الحساسة للمخاطر.
تساعدك هذه الأدوات والتقنيات على نشر نماذج LLMs في المقر المحلي بأداء قوي، وأمان، وتحكم كامل في البيانات مع الحفاظ على موثوقية بمستوى المؤسسات.
يمنح نشر LLMs في المقر المحلي المؤسسات تحكماً كاملاً في البنية التحتية للذكاء الاصطناعي لديها ولكن يأتي أيضاً مع بعض المقايضات. يعد فهم كل من الفوائد والتحديات أمراً ضرورياً للتبني الناجح.
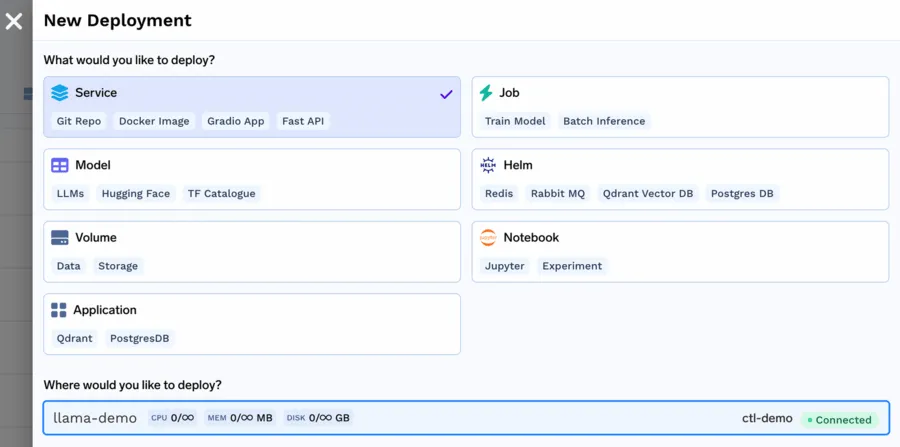
تبسط TrueFoundry نشر وإدارة النماذج اللغوية الكبيرة داخل البنية التحتية الخاصة، مما يجعل GenAI في المقر المحلي متاحاً للمؤسسات دون الحاجة إلى خبرة عميقة في DevOps أو MLOps. تم بناء TrueFoundry فوق Kubernetes، وهي تمكّن من تقديم خدمات LLM بسرعة وأمان وقابلية للتوسع من خلال دعم مدمج مسبقاً لمحركات الاستدلال عالية الأداء مثل vLLM وTGI.
تخفي المنصة تعقيد إدارة الحاويات ومعالجات GPUs وسياسات التوسع، مما يتيح للفرق التركيز على بناء التطبيقات بدلاً من صيانة البنية التحتية. ومع بوابة الذكاء الاصطناعي (AI Gateway) من TrueFoundry، يمكن للمؤسسات إتاحة نماذج LLMs باستخدام APIs متوافقة مع OpenAI مع تطبيق تحديد معدل الاستخدام، والفوترة القائمة على الرموز، والتوجيه متعدد النماذج، كل ذلك داخل بيئتها الآمنة.
تقدم TrueFoundry أيضاً إمكانية ملاحظة مدمجة، بما في ذلك المراقبة في الوقت الفعلي لاستخدام الرموز، وزمن الاستجابة، وأداء النموذج. يساعد هذا الفرق على تحسين الإنتاجية، واستكشاف المشكلات وإصلاحها، وتطبيق الحوكمة.
سواء كنت تقوم بنشر LLaMA 2 أو Mistral أو نماذج داخلية خضعت لضبط دقيق، تمنح TrueFoundry المؤسسات حلاً جاهزاً للإنتاج لـ GenAI في المقر المحلي، مخصصاً بالكامل، ومتوافقاً، ومبنياً ليتوسع.
مع تزايد تبني المؤسسات للنماذج اللغوية الكبيرة، يوفر النشر في المقر المحلي مساراً آمناً ومَرناً للاستفادة من GenAI دون المساومة على خصوصية البيانات، أو الامتثال، أو التحكم في البنية التحتية. في حين توفر الحلول السحابية الراحة، إلا أنها غالباً ما تقصر في البيئات الخاضعة للوائح التنظيمية أو البيئات الحساسة. تمنح نماذج LLMs في المقر المحلي المؤسسات ملكية كاملة للبنية التقنية، وتخصصاً أكبر، وتكاليف يمكن التنبؤ بها، مما يجعلها مثالية لاستراتيجيات الذكاء الاصطناعي طويلة الأجل. ومع منصات مثل TrueFoundry، أصبح نشر LLMs وتوسيعها داخلياً أسرع وأكثر كفاءة وأسهل في الإدارة. بالنسبة للمؤسسات التي تركز على التحكم والشفافية والابتكار، فإن GenAI في المقر المحلي ليس مجرد بديل، بل هو مزية استراتيجية.
تقوم بنشر نماذج LLMs في المقر المحلي عن طريق وضع النماذج في حاويات باستخدام Docker، وتنسيقها عبر Kubernetes، تقديمها من خلال محركات استدلال محسّنة مثل vLLM أو TGI. تقوم بتكوين معالجات GPUs، والشبكات، والتخزين، ودمج أدوات المراقبة، وتطبيق خطوط أنابيب MLOps لإدارة تتبع الإصدارات، والتوسع، والأمان، والأداء داخل بنيتك التحتية الخاصة.
يوفر النشر السحابي قابلية للتوسع عند الطلب، وبنية تحتية مُدارة، وتسعير الدفع حسب الاستخدام، بينما يوفر النشر في المقر المحلي تحكماً كاملاً في البيانات، وتخصصاً، وامتثالاً. أنت تقايض المرونة السحابية بأمان وسيادة أكبر في المقر المحلي، ولكن يجب عليك التعامل مع تكاليف الأجهزة، والصيانة، وقدور التوسع، والتعقيد التشغيلي داخلياً.
يمكنك استخدام خدمات LLM في السحابة العامة، أو البيئات السحابية الخاصة، أو عمليات النشر الهجينة، أو منصات الذكاء الاصطناعي المُدارة. تقلل النماذج القائمة على API مثل OpenAI أو نقاط نهاية Hugging Face المستضافة من عبء البنية التحتية. تتيح لك الإعدادات الهجينة الاحتفاظ بالبيانات الحساسة في المقر المحلي مع الاستفادة من القابلية للتوسع السحابية لأحمال العمل الذروية والتجريب.
تتطلب نماذج LLMs في المقر المحلي تكاليف أجهزة أولية عالية، وصيانة مستمرة، وكوادر مهارية، وتخطيطاً للسعة. تواجه قيوداً في التوسع، ومصاريف الطاقة والتبريد، وتحديثات أبطأ. وتضيف إدارة التحديثات الأمنية، وتحديثات النماذج، وموثوقية البنية التحتية تعقيداً تشغيلياً مقارنة بخدمات الذكاء الاصطناعي السحابية المُدارة بالكامل.
تسهل TrueFoundry عملية on-prem LLM deployment من خلال دمج Kubernetes orchestration، وGPU scheduling، وmodel serving، وmonitoring، وعناصر التحكم في الأمان. تحصل على إدارة مركزية، وRBAC، وobservability، وscaling سلس عبر مختلف البيئات. تتيح لك محركات inference المدمجة مسبقاً والميزات الجاهزة للالتزام بالمعايير (compliance) إمكانية نشر AI بمستوى إنتاجي (production-grade) بأمان وكفاءة.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد




















