



November 10, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.



Blazingly fast way to build, track and deploy your models!
يفترض تحديد معدل API التقليدي أن الطلبات قابلة للتبديل: فطلب GET /users/42 يكلف تقريباً ما يكلفه الطلب الذي يليه، لذا فإن عد الطلبات يعد حلاً مناسباً لتقدير الحمل. وكل محدد معدل قمت بتكوينه مصمم بناءً على تلك الفكرة.
لكن حركة مرور LLM تكسر هذه القاعدة. نفس نقطة النهاية، ونفس الدقيقة، ونفس المستخدم: طلب "لخص هذا في سطر واحد" قد يستهلك 50 توكن في رحلة الذهاب والإياب؛ بينما عقد من 150 صفحة مرسل إلى نموذج تفكير (reasoning model) يستهلك ما يقارب 200,000 توكن. كلاهما يمثل طلباً واحداً، وحدٌ أقصى قدره 1,000 طلب في الدقيقة يسمح بكليهما.
هذا التباين هو الشكل الطبيعي لحركة مرور الإنتاج بمجرد إشراك الوكلاء (agents)، لأن دورة الوكيل تنقل المحادثة بأكملها بالإضافة إلى نتائج الأدوات والسياق المسترجع إلى Prompt في كل خطوة. تظل أعداد الطلبات ثابتة بينما ترتفع أعداد التوكنات بدرجة كبيرة — الآلية الكامنة وراء الانفجار الهائل لتوكنات الوكلاء في CI/CD.
لذلك، قم بتغيير الوحدة. عدّ التوكنات، لأن التوكنات هي ما تشتريه بالفعل. لا تزال أعداد الطلبات مهمة — فهي تحمي البوابة (gateway) واتصال المزود — لذا قم بتشغيل كلينا.
معظم التخبط هنا يعود إلى المصطلحات. هناك أربع مشكلات، وأربع آليات، وغالباً ما تقوم الفرق بتثبيت أحدها وهي تعتقد أنها قامت بتثبيت آخر:
حدود المعدل هي ضابط توفر (availability control)؛ بينما الميزانيات هي ضابط مالي (financial control). وهما يفشلان بطرق مختلفة ولهما ملاك مختلفون — المنصة تملك الأول، والمالية تملك الثاني.
الخطأ الشائع هو تثبيت حد معدل التوكنات وتسميته التحكم في التكلفة. 20,000 توكن في الدقيقة على نموذج رخيص تكلف بضعة دولارات في اليوم؛ أما على نموذج تفكير متقدم فهي رقم مختلف تماماً، وتتغير كلما أعاد المزود تسعير خدماته. إن إنتاجية التوكنات ليست مالاً.
تستحق حدود المزود تحذيراً، لأن الفرق تعتمد عليها دون قصد. حد المنظمة الخاص بك في OpenAI أو Anthropic هو حصة مشتركة واحدة: عندما يستهلكها عمل دفعة (batch job)، فإن منتجك الموجه للعملاء يتم خنقه بواسطة نظام لا يمكنه التعبير عن أن "المساعد يتغلب دائماً". ومن هنا تأتي أهمية البوابة التي تتحكم بها.
تحدد الخوارزمية مقدار الاندفاع (burst) الذي يمر — وهي تفصيلة ليست بالصغيرة بالنسبة للوكلاء.
بالنسبة لحركة مرور دردشة البشر، تكون النافذة الثابتة ممتازة — فالناس لا ينسقون طلباتهم. أما الوكلاء فيفعلون ذلك دون قصد. فهم يعيدون المحاولة عند الفشل، ويتوسعون بالتوازي ويعملون وفق جداول زمنية، لذا يضرب العديد من المتصلين نفس اللحظة الزمنية، وتتوقف حالة المضاعفة عن كونها نظرية. تعالج النوافذ المنزلقة ذلك بعدم وجود لحظة إعادة ضبط. بينما تجيب خوارزمية Token bucket على سؤال مختلف — فهي تناسب حركة المرور التي تريد فيها اندفاعات قصيرة — مقابل ضبط رقم آخر.
تخفيض مستوى النموذج هو الأكثر استخداماً بشكل غير كافٍ: إذا تم الوصول إلى حد على مستوى النموذج، يمكن لسلسلة البدائل التقديم من مزود ثانٍ بدلاً من إرسال خطأ 429 للمستخدم — آلية الفشل في مقالنا حول موجّهات LLM، حيث 429 هو رمز حالة محفز. أما تجاوز الميزانية فهو مختلف: إذا انتهت الأموال فقد انتهت، والإنفاق بهدوء في مكان أرخص ليس ما طلبته المالية.
القاعدة العامة فوق القاعدة المحددة. تحت تطبيق خيار "الفوز لأول تطابق"، تبتلع القاعدة العريضة بالقرب من الأعلى حركة المرور التي كان ينبغي أن تطابق قاعدة أضيق أسفل منها. وبالتالي لا تعمل القاعدة الضيقة أبداً.
التعامل مع عداد مشترك واحد كحد لكل مستخدم. "20,000 توكن في الدقيقة" بدون تحديد نطاق هو عداد واحد للجميع. والمتصل الأول يستهلكه بالكامل.
افتراض أن الطلبات الفاشلة مجانية. بالنسبة للحدود القائمة على الطلبات، هي ليست كذلك — وبخصوص حدود التوكنات الإجابة مختلفة.
كائنان للسياسة، منفصلان تماماً عن قصد: تحديد المعدل يحكم الإنتاجية، والميزانيات تحكم الأموال.
تقبل قواعد حد المعدل ست وحدات — المجموعة الكاملة:
requests_per_minute · requests_per_hour · requests_per_day · tokens_per_minute · tokens_per_hour · tokens_per_day
لا توجد وحدة لكل ثانية؛ إذ يمكن لطلب LLM واحد أن يستغرق عشرات الثواني، لذا فإن الحدود لكل ثانية ستخضع لتقلبات وضوضاء لا معنى لها. يوجد التكوين في تبويب Config:
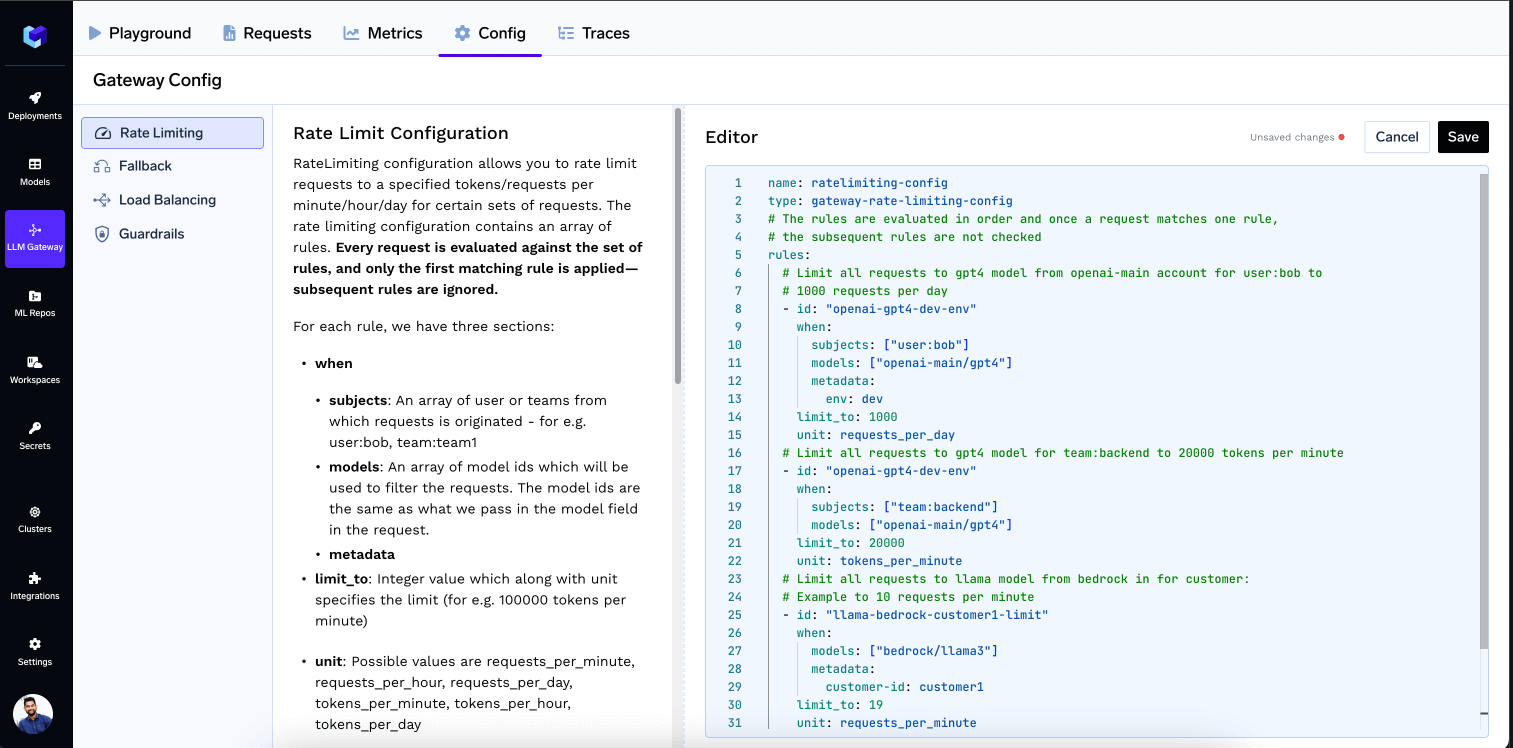
مجموعة القواعد هي من نوع: gateway-rate-limiting-config مع قائمة بالقواعد. كل قاعدة تحتوي على id ثابت، ومجموعات when التي تتجمع فيها موضوعات (subjects) ونماذج وشروط البيانات الوصفية (metadata) بـ AND، وحد عددي limit_to، ووحدة، وربما rate_limit_applies_per. الموضوعات مسبوقة بـ — user:، team:، virtualaccount: — وتقرأ البيانات الوصفية ترويسة X-TFY-METADATA.
لأن الحد الأدنى للوحدة هو في الدقيقة، تحتفظ البوابة بـ نافذة مدتها 60 ثانية، وتكتفي بـ مجموعات زمنية كل 10 ثوانٍ لكل مستخدم، نموذج، فريق أو شريحة مخصصة، وتجمع آخر 6 مجموعات لتقييم العداد. تسقط المجموعات الأقدم. الدقة البالغة عشر ثوانٍ هي الرقم الذي يجب استيعابه: يتم تنعيم الاندفاع عبر ست فترات فرعية بدلاً من السماح به مرتين عند حد إعادة ضبط واحد.
بدونه، تكون القاعدة عداداً مشتركاً واحداً لكل ما تطابقه. ومعه، ينقسم العداد لكل كيان. القيم المسموح بها هي user، virtualaccount، model، و metadata.* مع المفتاح الخاص بك. بحد أقصى قيمتان لكل قاعدة.
تمنح ['user'] كل مستخدم حصته الخاصة و ['model'] كل نموذج حصته الخاصة. القاعدة الأخيرة هي النمط الذي ينتهي الأمر بأغلب الفرق إلى الرغبة فيه: سقف لكل مشروع مرتبط بالبيانات الوصفية التي يرسلها التطبيق بالفعل، دون الحاجة لتعديل القاعدة عند ظهور مشروع جديد.
هذا يحل محل تنسيق معرف القاعدة الديناميكي. النقل آلية برمجية ميكانيكية — {user}-daily-limit يصبح id: 'user-daily-limit' بالإضافة إلى ['user']، و project-{metadata.project_id}-limit يصبح id: 'project-limit' بالإضافة إلى ['metadata.project_id']:
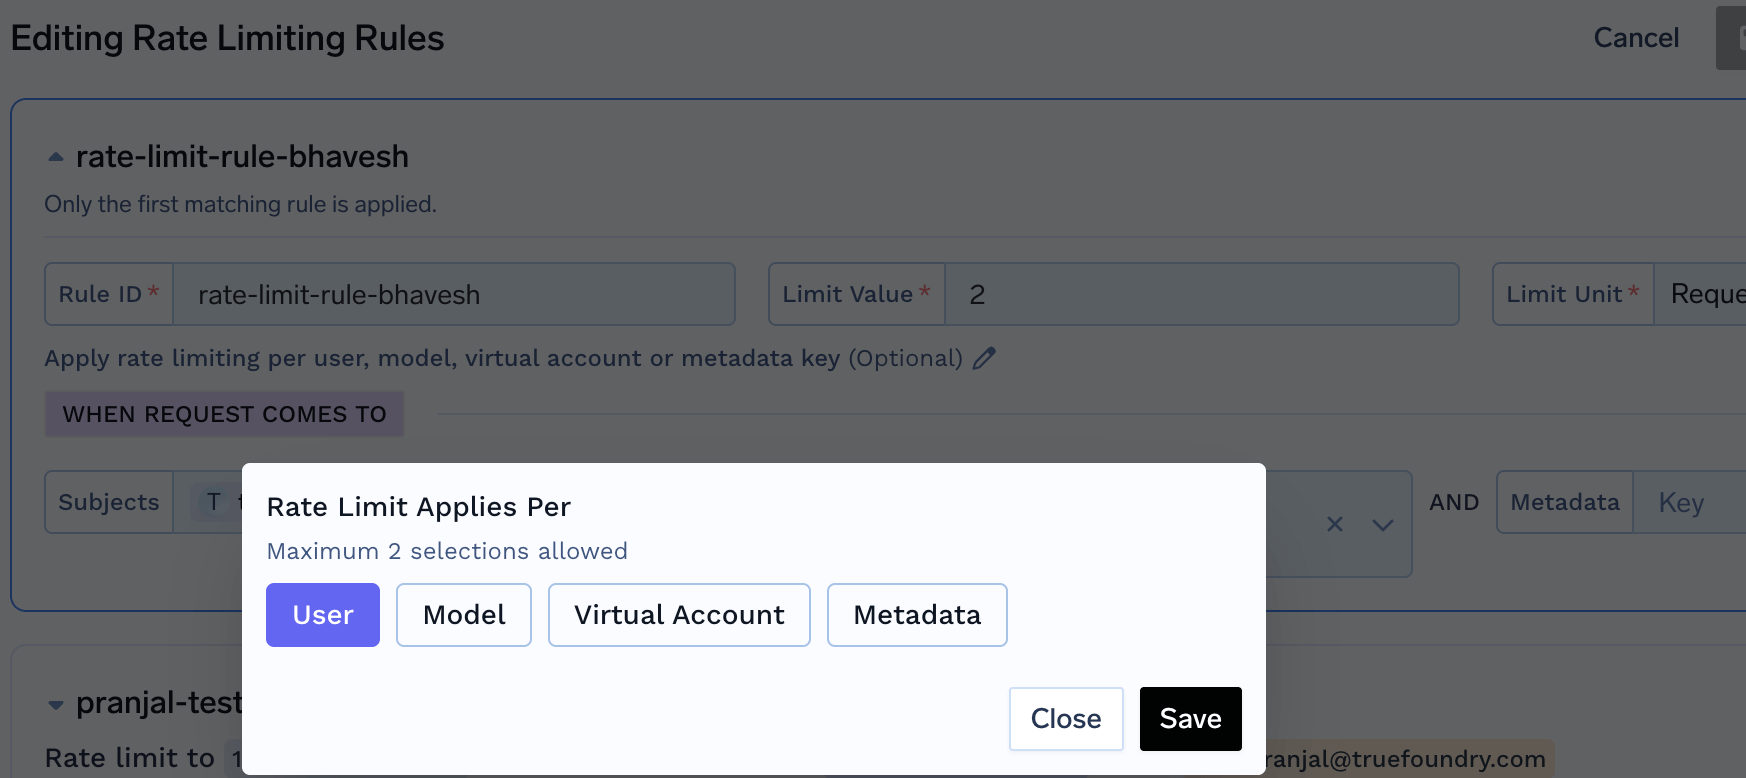
يتم تقييم كل طلب مقابل كل قاعدة، ولكن يتم تطبيق أول قاعدة متطابقة فقط. التطابقات اللاحقة لا تحظره أبداً. ومع ذلك، يتم احتساب الاستخدام مقابل كل قاعدة يطابقها الطلب.
لذا احتفظ بالقواعد المتخصصة في الأعلى. الفشل الموثق: ضع app-a-limit (10,000 rpm, virtualaccount:app-a) فوق tenant-wide-limit (5,000 rpm, when: {})، وحركة مرور التطبيق A — المحتسبة مقابل كليهما — تستهلك عداد المستأجر بمفردها. وكل من يكون أول تطابق له هو قاعدة المستأجر سيحصل حينها على خطأ 429 تحت 5,000 rpm بكثير. الحل ليس إعادة الترتيب بل تحديد النطاق: rate_limit_applies_per: ['user', 'virtualaccount'].
أي طلب ترفضه البوابة، أو يفشل المزود بـ 4XX/5XX، يحسب على أنه طلب واحد مقابل كل قاعدة requests_per_* طابقها. استثناء واحد: الطلب المرفوض بالفعل بـ 429 بواسطة حد المعدل نفسه، حتى لا تحفر عاصفة إعادة المحاولة حفرتها أعمق.
تتعامل حدود التوكنات بشكل مختلف. فالطلبات الفاشلة لا تستهلك حصة التوكنات، لأن الطلب الفاشل لا يبلغ عن أي توكنات. لا يوجد شيء لحسابه. لهذا السبب يمكن لحلقة إعادة المحاولة أن تستهلك ميزانية طلبك بينما تبدو لوحة تحكم التوكنات سليمة.
يعيد التجاوز HTTP 429 مع error.type: "RateLimitError" و error_origin_level: "rate_limit_budget"، بالإضافة إلى ترويسة x-tfy-applied-rules توضح القاعدة التي تم تفعيلها.
الميزانيات هي ضابط الأموال، وهي للتكلفة فقط، cost_per_* بالدولار الأمريكي. لا توجد ميزانية مقومة بالتوكنات — إذا كنت تريد سقفا للتوكنات، فهذا حد معدل.
تم إطلاق Budget V2 في الإصدار v0.158.0 ويعكس منطق التطبيق: يتم التحقق من كل قاعدة متطابقة ويجب أن تسمح كلها بالطلب، أي خوارزمية AND عبر الميزانيات. حد المعدل يعتمد الفوز لأول تطابق؛ بينما الميزانيات تتطلب موافقة الجميع. استخدم الإصدار V1 خيار الفوز لأول تطابق، لذا فإن عملية النقل هي تغيير دلالي، وليست تغييراً في بناء الجملة.
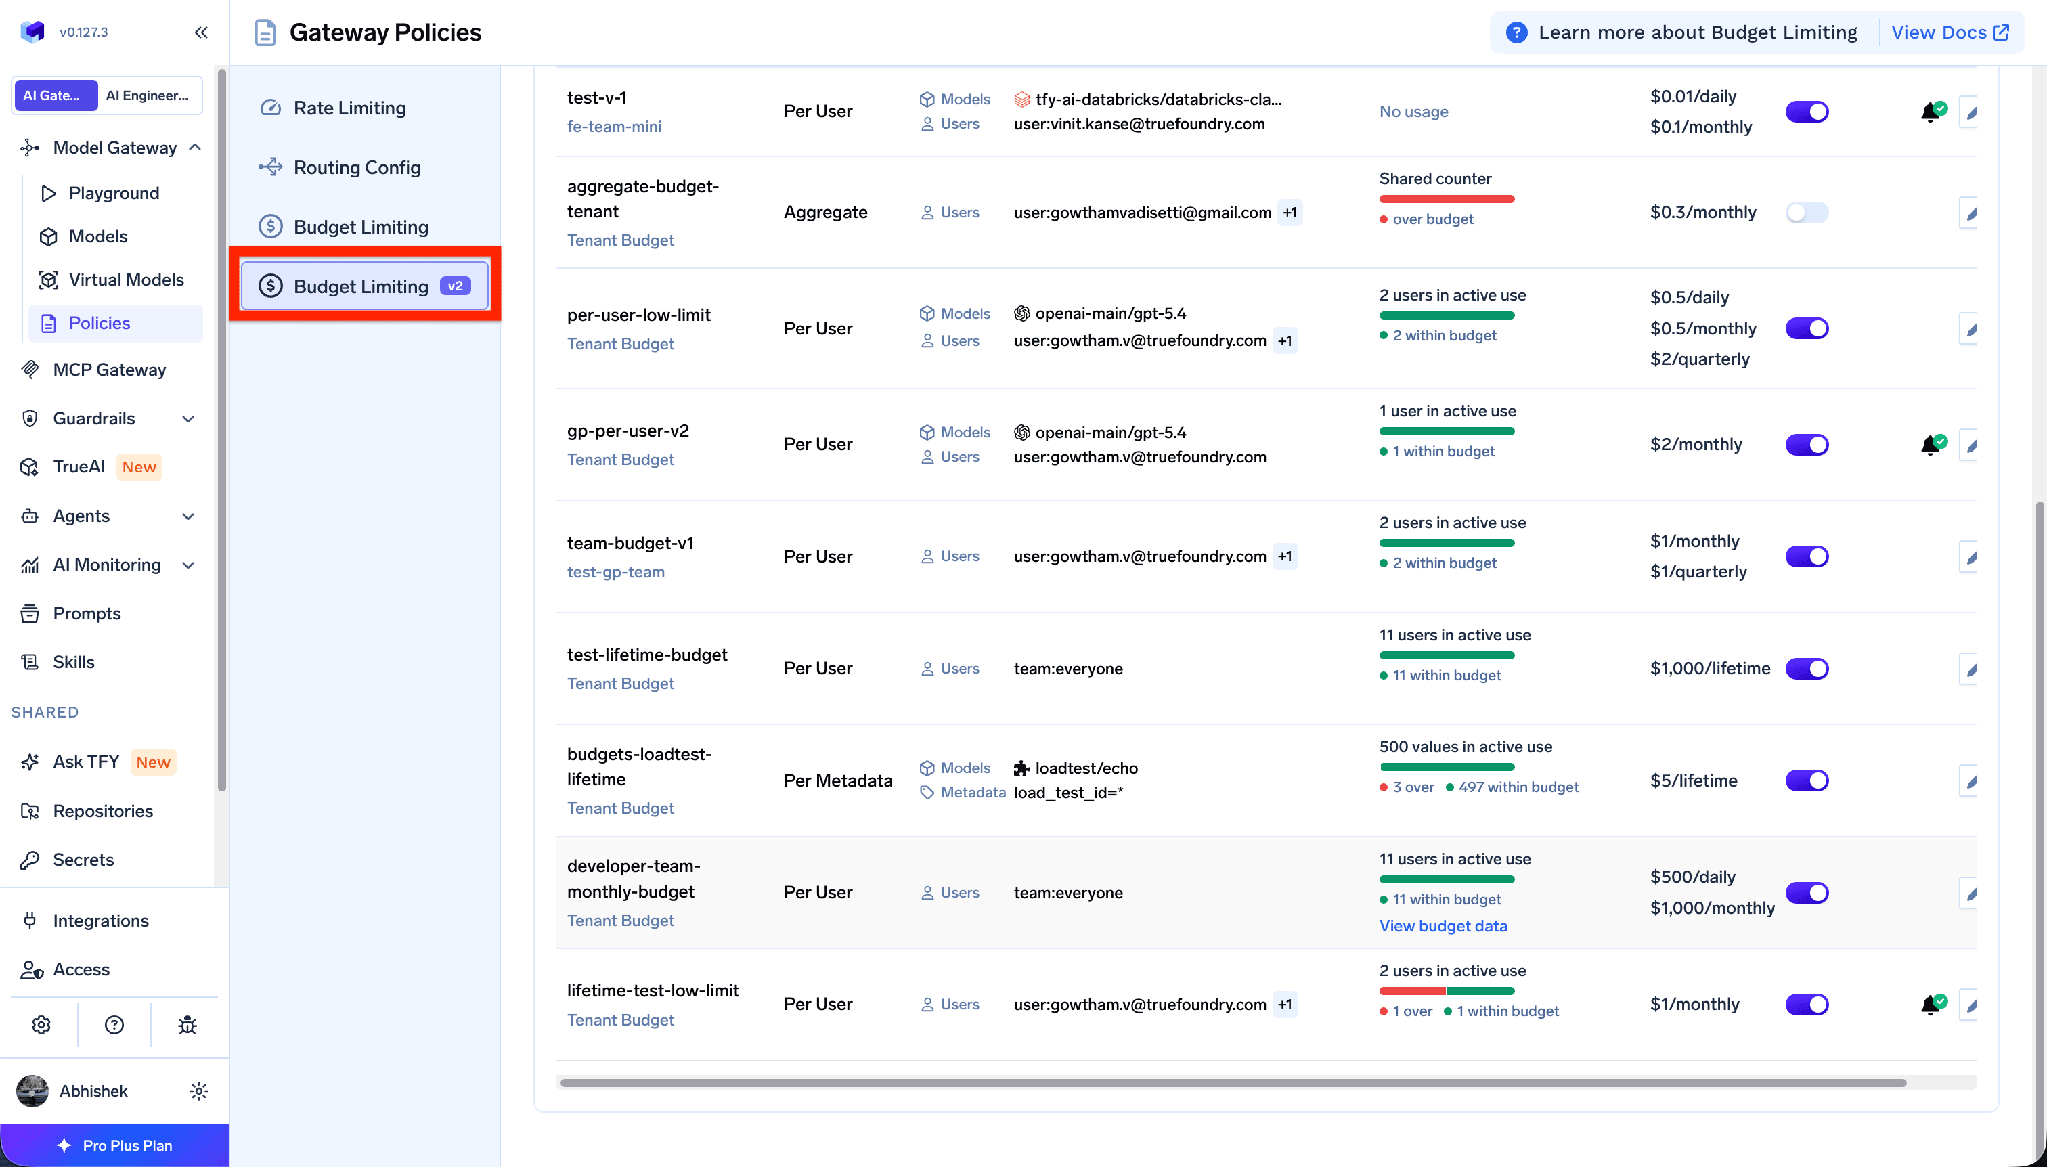
توجد القواعد تحت AI Gateway ← Policies ← Budget Limiting ← Add Rule، في نطاقين: المستأجر (tenant-budget-config) أو الفريق (team-budget-config، مع team_name مفروض بـ RBAC).
خمس فترات إعادة ضبط، كلها بالتوقيت العالمي UTC: يومياً (00:00)، أسبوعياً (الإثنين 00:00)، شهرياً (اليوم الأول)، ربع سنوياً (1 يناير، 1 أبريل، 1 يوليو، 1 أكتوبر)، و مدى الحياة (Lifetime)، والتي لا تتعدل دورياً أبداً — سقف الإنفاق من الجدول أعلاه:
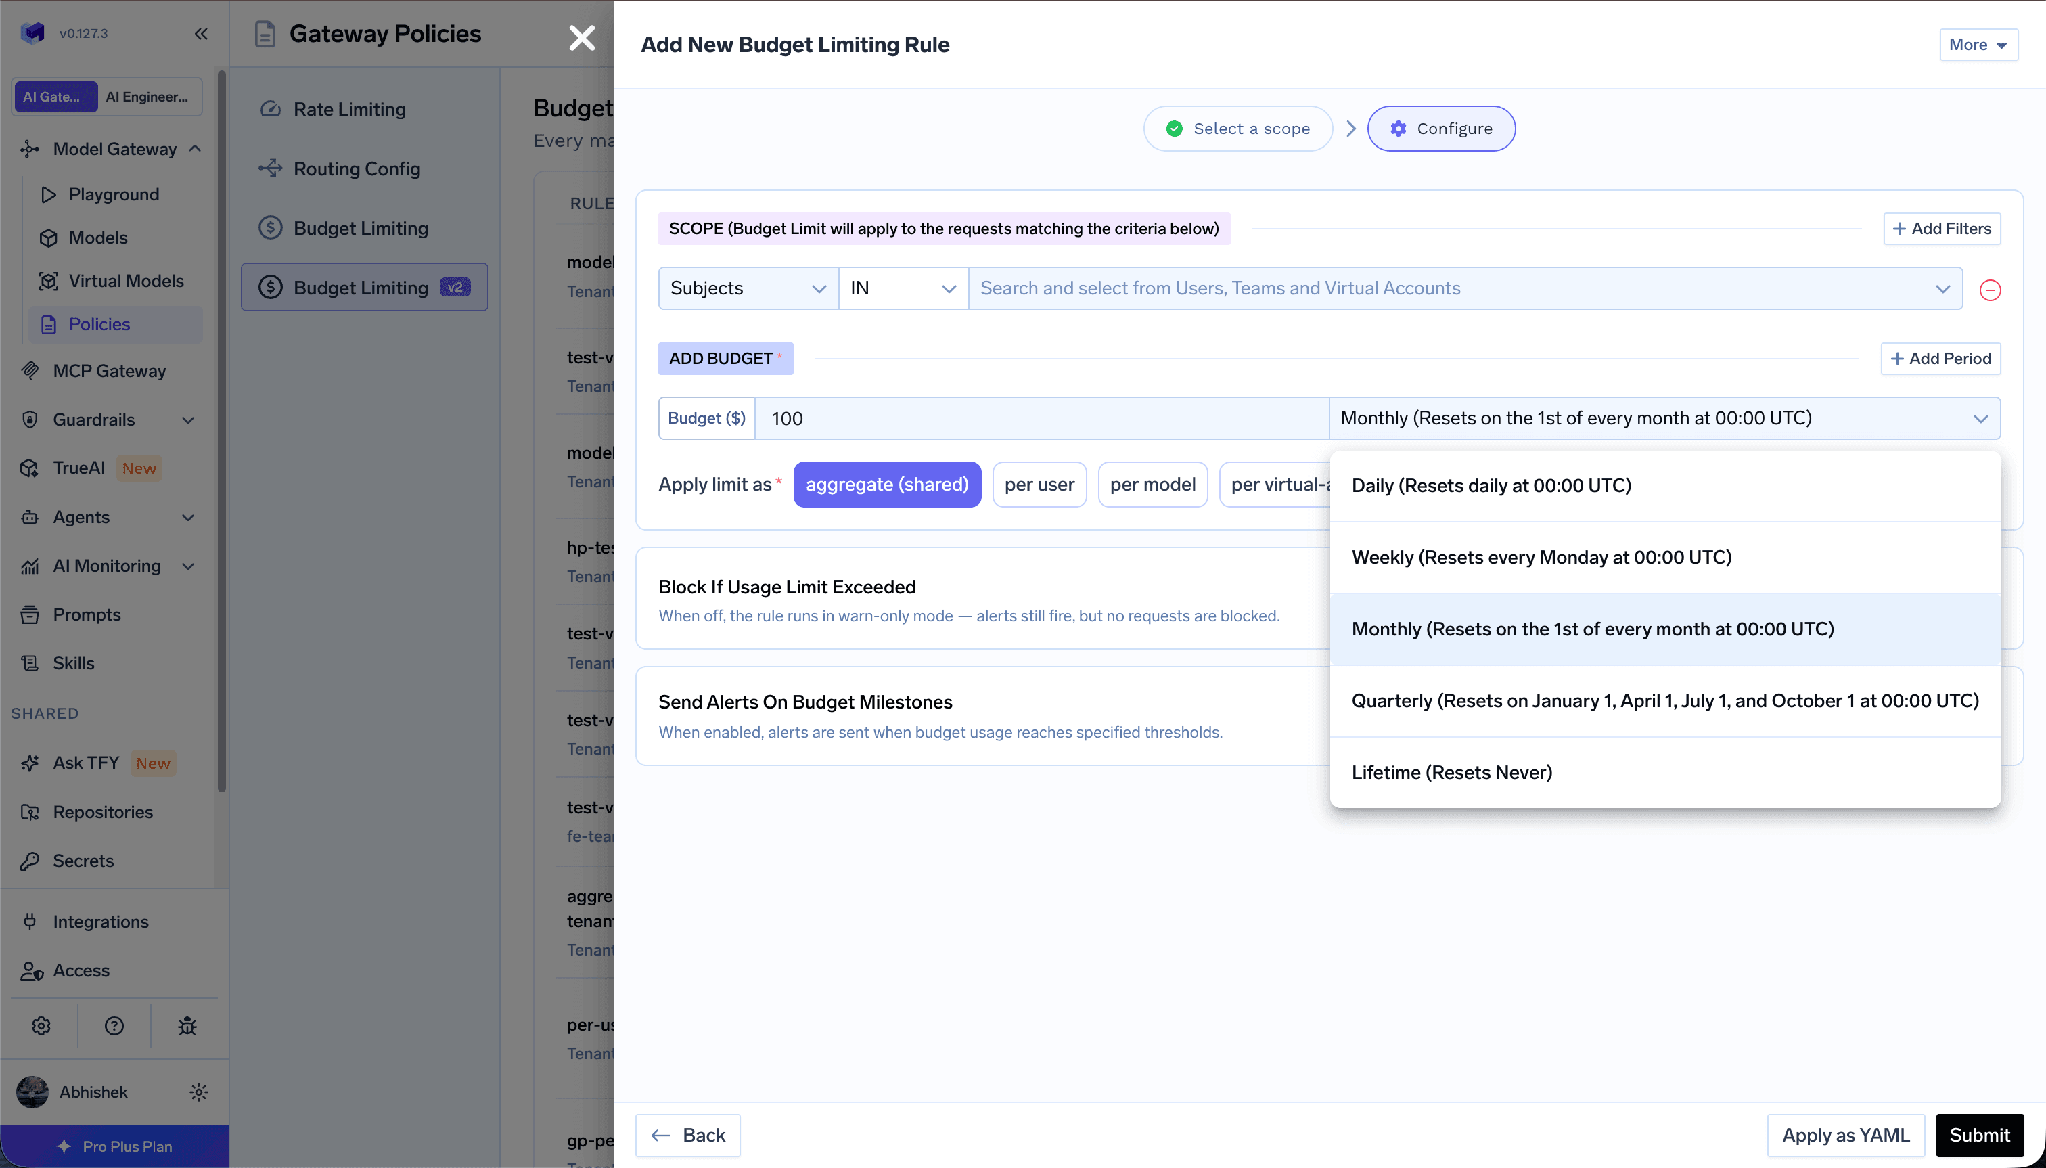
يمكن لـ قاعدة واحدة فرض عدة فترات في وقت واحد، والحظر إذا تم تجاوز أي منها — مثال سقف الفترات المتعددة في التوثيق يحدد cost_per_day: 0.5، cost_per_month: 0.5 و cost_per_quarter: 2 معاً. مرشحات النطاق — الموضوعات، النماذج، حسابات المزود، البيانات الوصفية — تأخذ IN/NOT IN وتتجمع بـ AND:
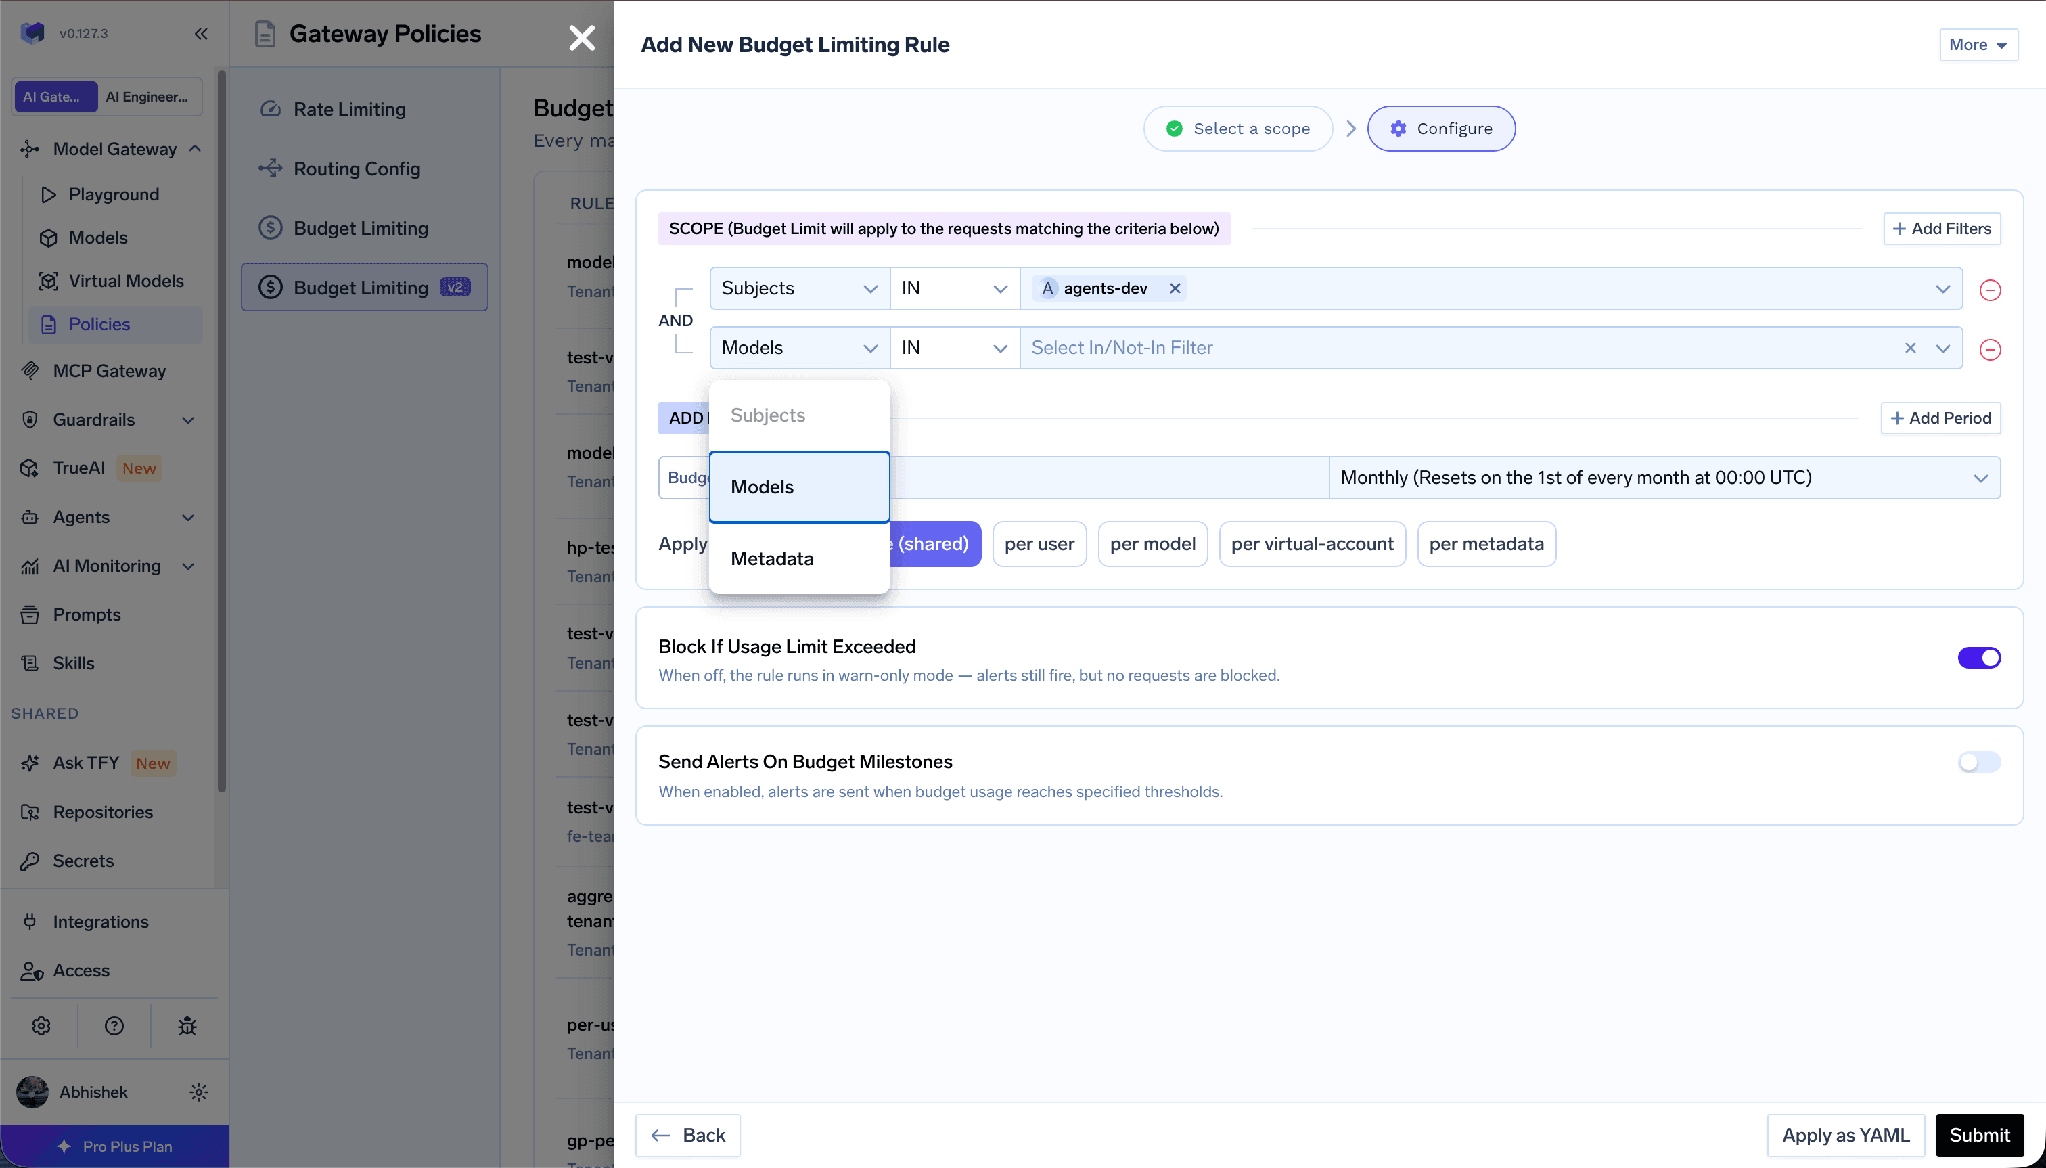
تطبيق الحد كـ (applies_to.type) يأخذ aggregate، per-user، per-model، per-virtual-account، أو metadata مع مفتاح، ولا يمكن تغييره بعد الإنشاء. تدعم القواعد لكل كيان التجاوزات (overrides) للمستخدمين، النماذج، الحسابات الافتراضية أو قيم البيانات الوصفية المحددة:
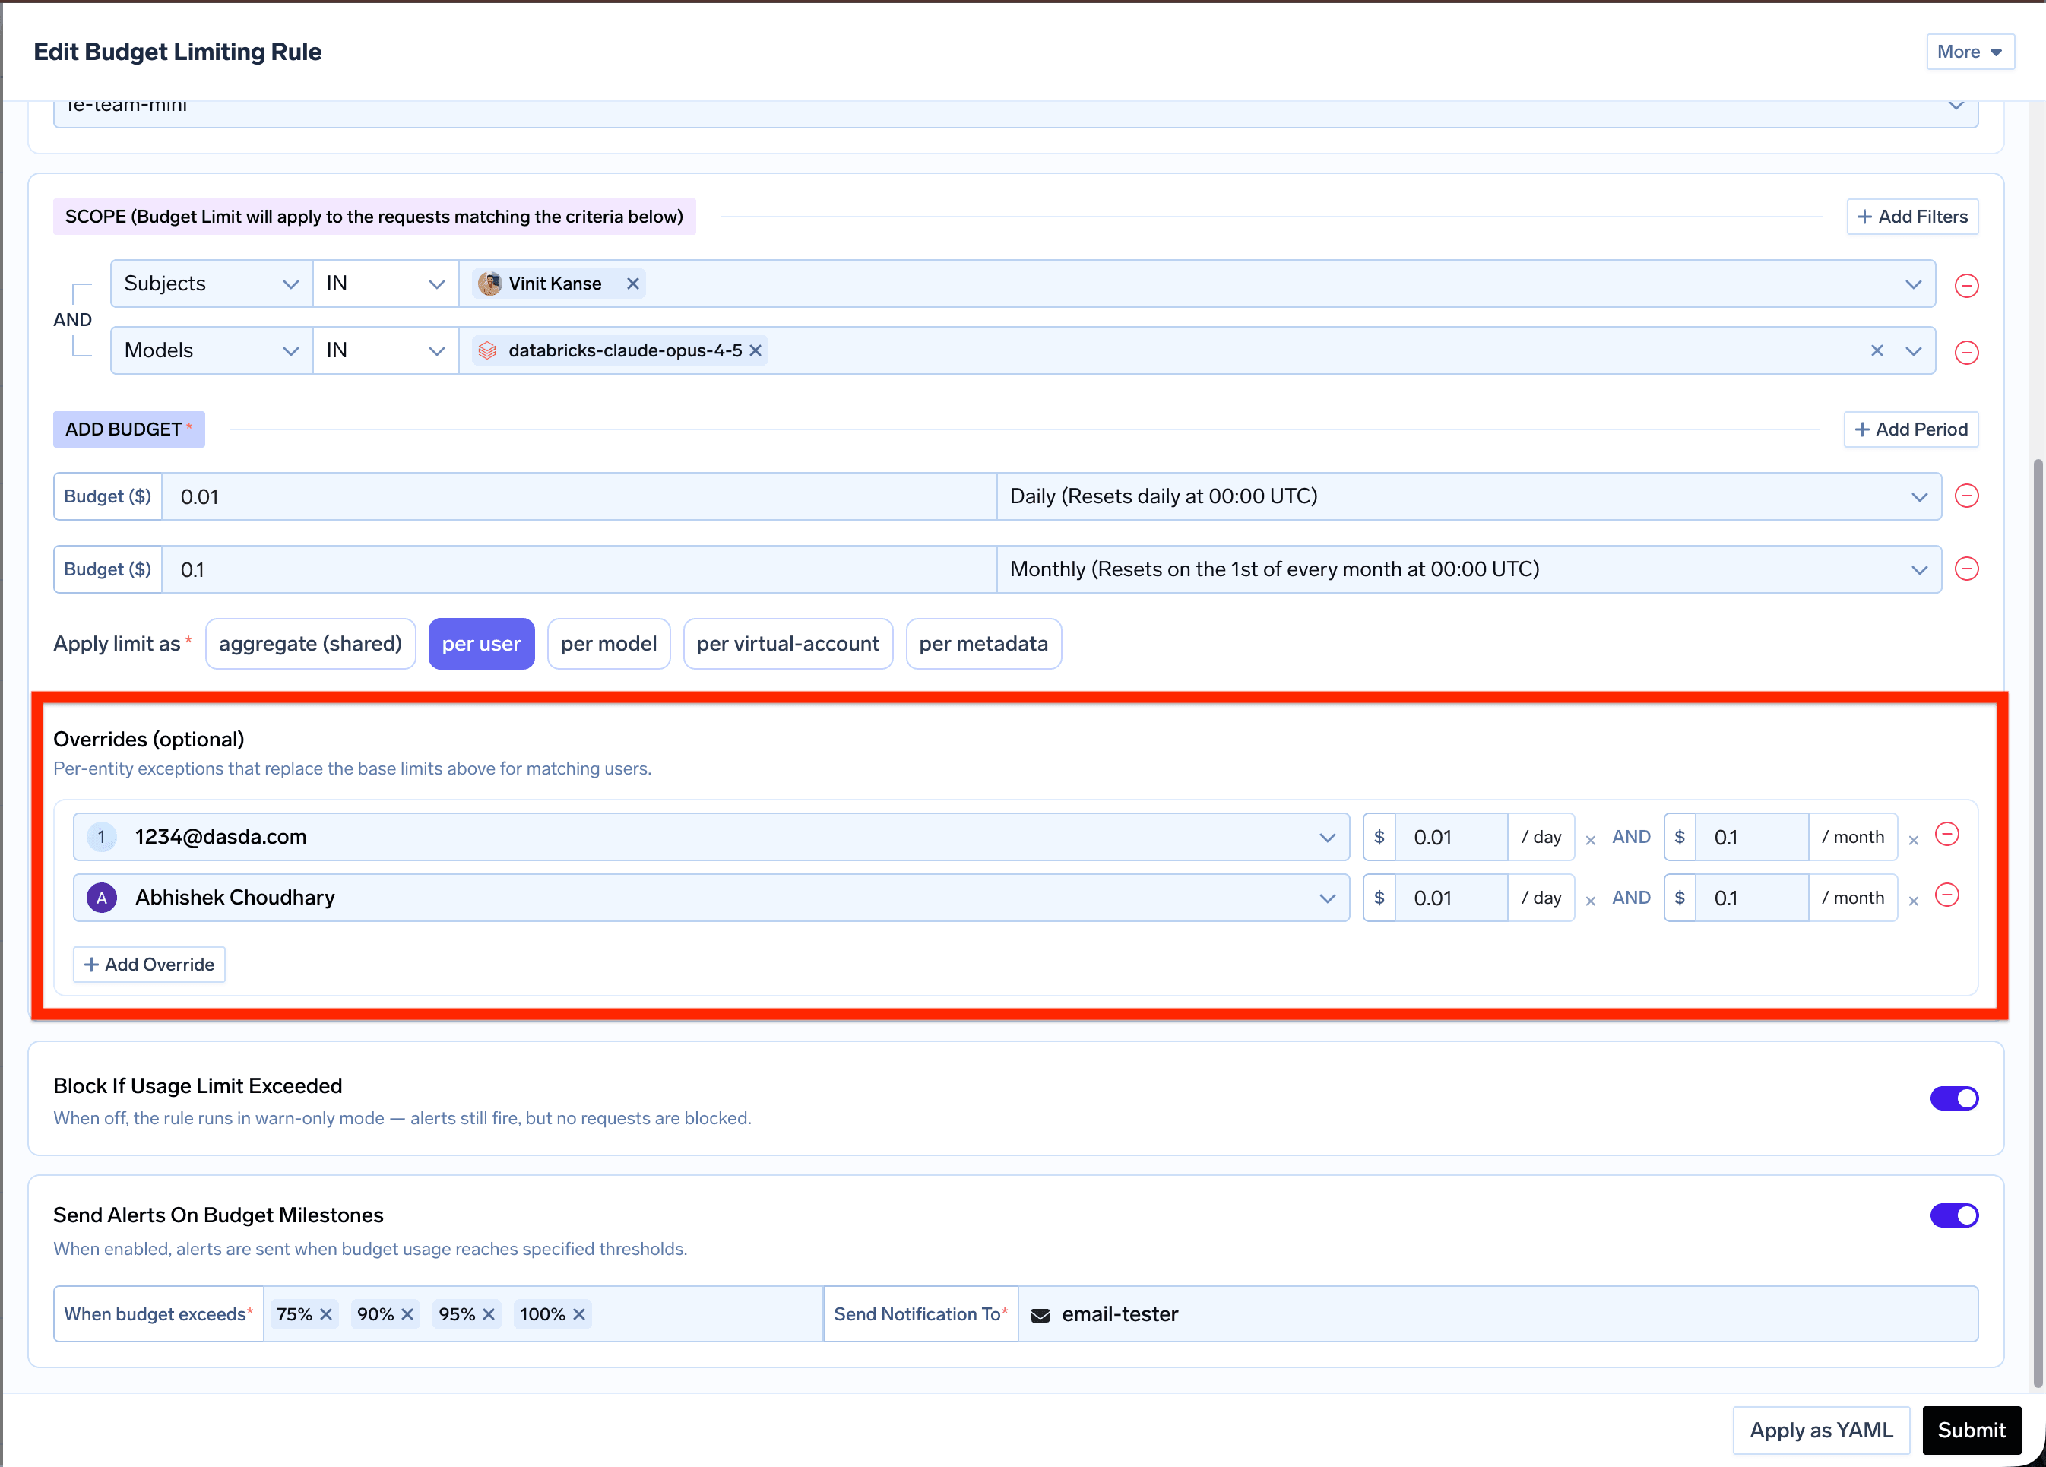
التجاوز يحل محل جميع الفترات لذلك الكيان. إذا حددت القاعدة الأساسية سقوفاً يومية وربع سنوية بينما حدد التجاوز حد يومي فقط، فلن يكون لدى هذا الكيان سقف ربع سنوي إطلاقاً. يرجى تضمين كل فترة تريد تطبيقها.
ثلاثة أوضاع: enforce (الافتراضي، الرفض)، audit (السماح بالمرور، الاستمرار في التتبع والتنبيه)، و soft_enforce — يتم الحظر فقط عندما لا توجد ميزانية متطابقة أخرى تسمح به؛ إذا كانت هناك ميزانية تتيح ذلك يمر الطلب ويسجل التجاوز مثل تجاوز التدقيق. التجاوز الصارم (hard enforce) في أي مكان يفوز.
تطلق التنبيهات عند 75، 90، 95 و 100 بالمائة، كل منها مرة واحدة لكل فترة ميزانية، بشكل منفصل لكل كيان في ميزانية لكل كيان؛ وتنبه ميزانيات Lifetime مرة واحدة لكل عتبة مدى الحياة. الأهداف: email، slack-webhook، slack-bot، pagerduty، ms-teams-webhook، مع {{user.email}} للتسليم لكل مستخدم.
تنبيه واحد: تبدأ عدادات الميزانية عند إنشاء القاعدة، وليس في بداية الفترة. لا يتم احتساب الإنفاق السابق بأثر رجعي، لذا فإن القاعدة المنشأة في منتصف الشهر لن تتوافق مع فاتورتك لتلك الفترة.
الميزانيات ممتازة بقدر دقة التسعير الكامن خلفها، ولهذا السبب فإن التسعير مفتوح. الكتالوج في github.com/truefoundry/models هو قاعدة بيانات التسعير المستخدمة لتتبع التكلفة العامة، ويمكن تصفحها على truefoundry.com/models. اقرأ المعدل الذي يتم تحصيله منك؛ وقدم PR إذا كان خاطئاً.
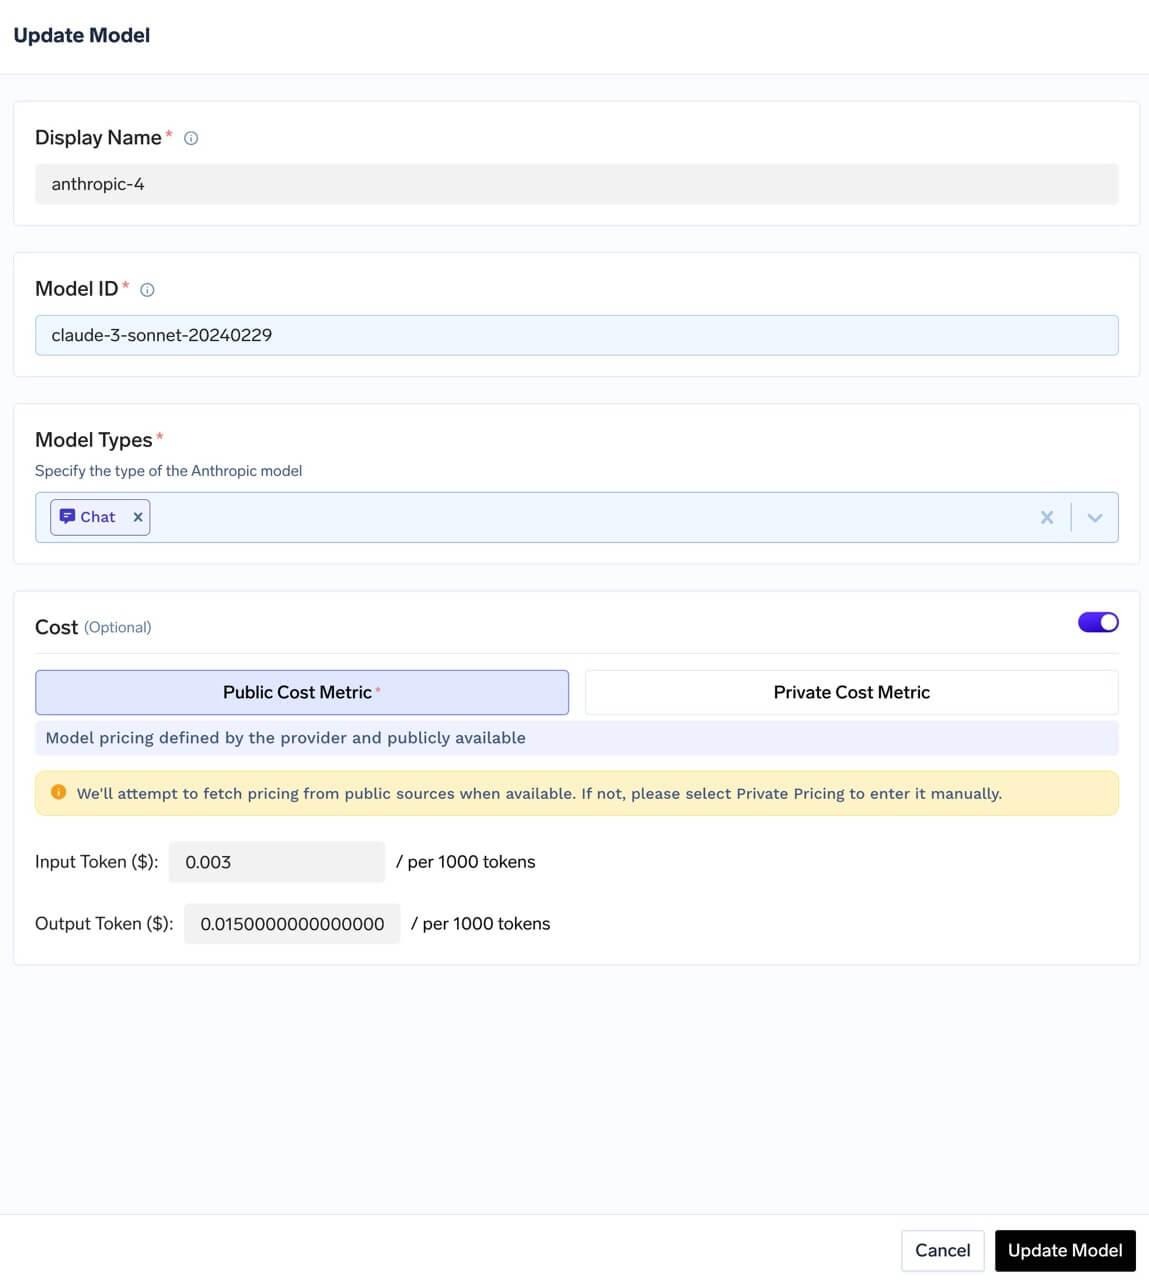
هناك تفصيلان مهمان. التسعير حسب المنطقة: يتضمن providers/aws-bedrock/us.amazon.nova-lite-v1:0.yaml معدلات إدخال وإخراج مختلفة لمناطق us-west-2، us-west-1، eu-central-1 و eu-west-1، لذا فإن حركة المرور متعددة المناطق لا تسعر بمعدل ثابت خاطئ. التسعير المتراتب (Tiered pricing): يحتوي providers/google-gemini/gemini-2.5-pro.yaml على معدلات أساسية بالإضافة إلى معدلات أعلى من 200 ألف توكن، وتتراتب معدلات gemini-1.5-flash.yaml من 128 ألف توكن. السياق الطويل لا يسعر بشكل خطي. النماذج التي ليس لها تسعير عام تستخدم إدخال Private Cost.
تعمل الميزانية لكل مستخدم فقط إذا تم إسناد الطلبات بشكل موثوق. جعلت ثلاث آليات هذا الأمر أوتوماتيكياً بدلاً من كونه مسألة التزام من المطورين:
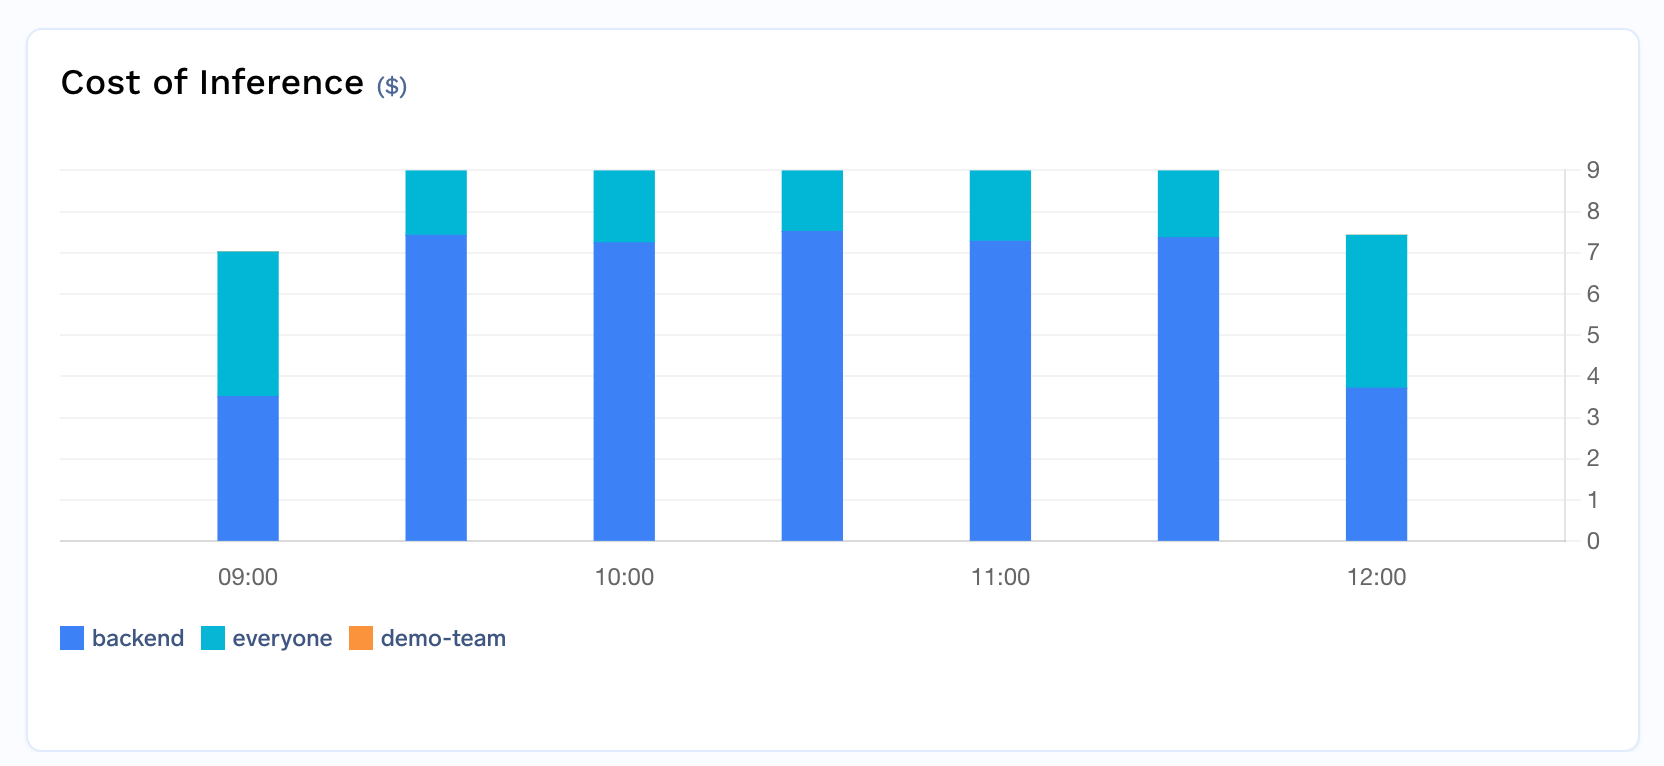
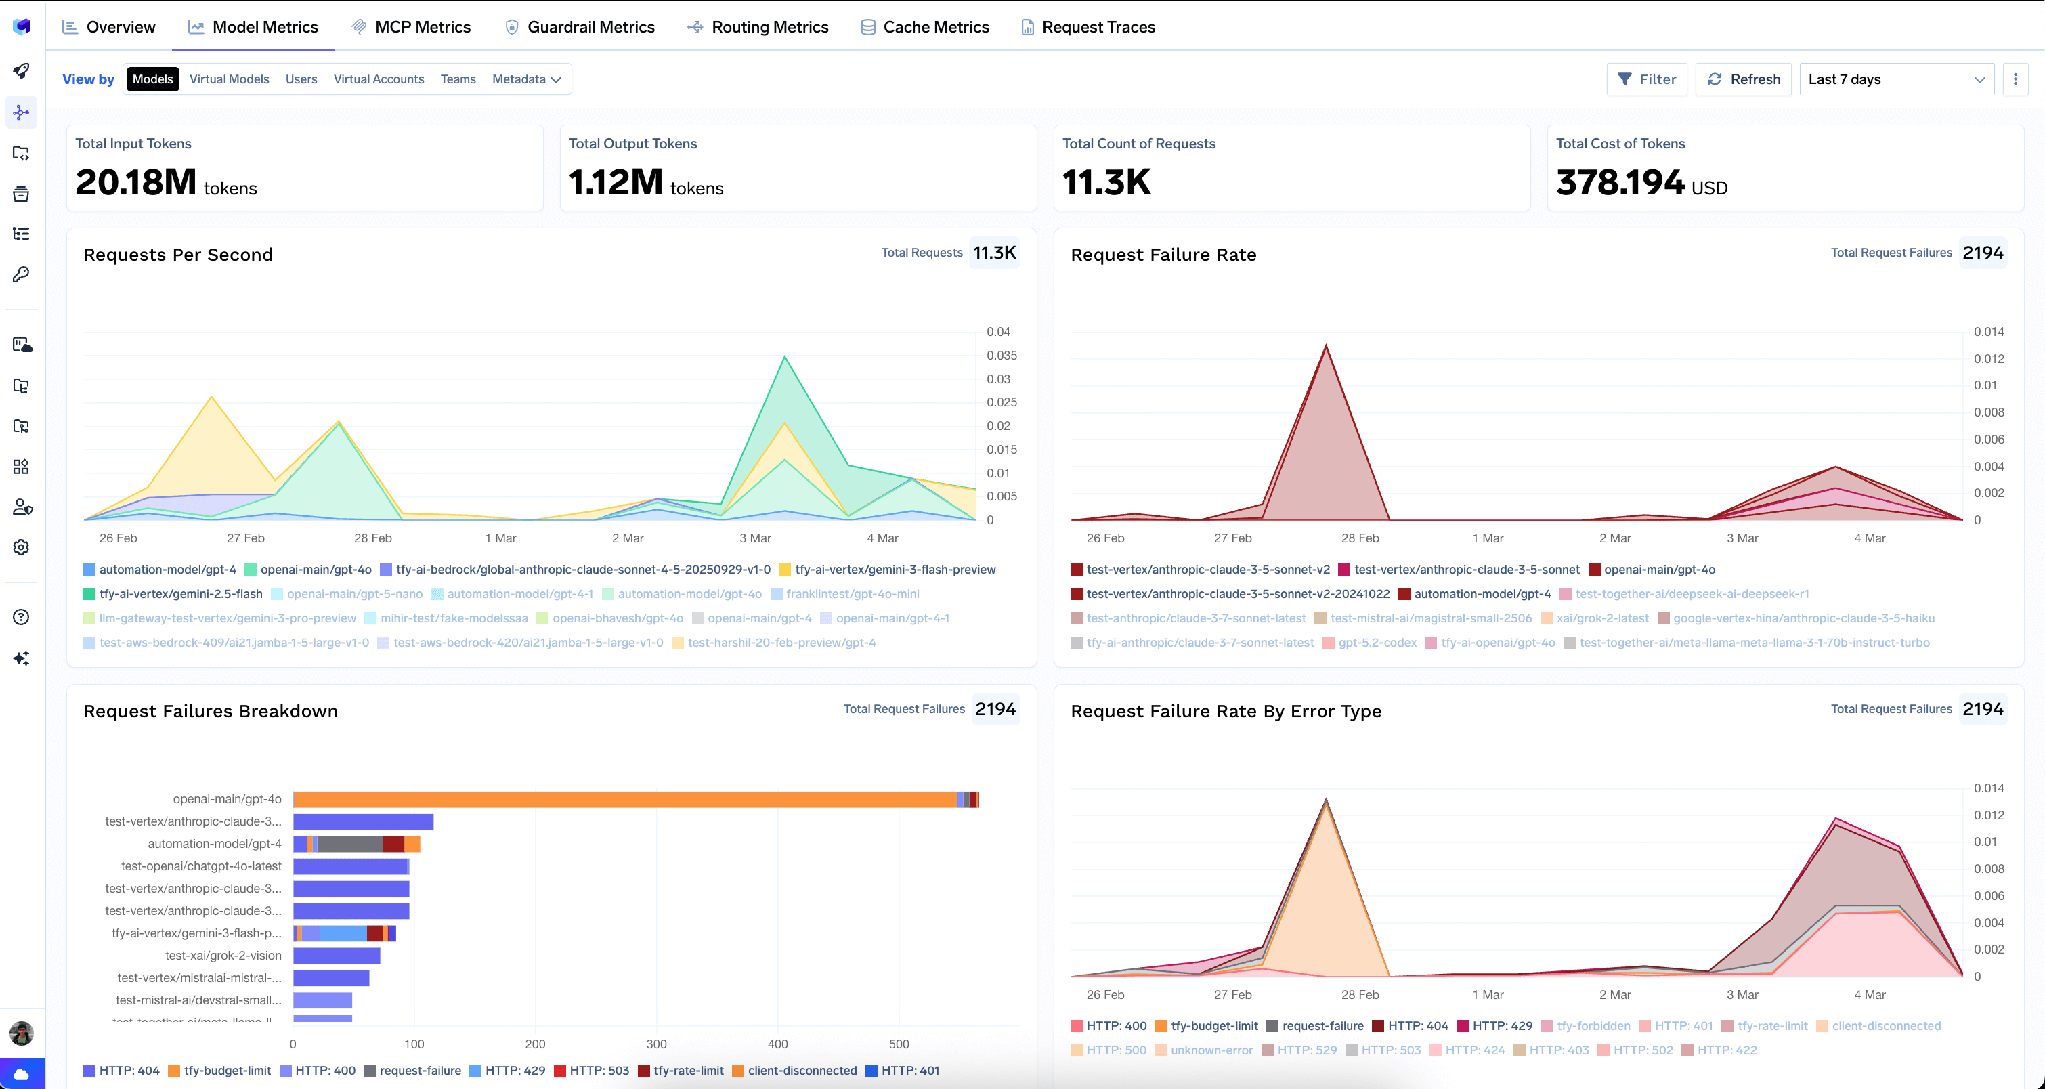
يتتبع Model Metrics إجمالي توكنات الإدخال، إجمالي توكنات الإخراج و إجمالي تكلفة التوكنات بالدولار الأمريكي، والتي يمكن تصديرها عبر Metrics ← النقاط الثلاث ← Download Raw Data مجمعة حسب اسم المستخدم، اسم النموذج أو الفرق:
بوابة واحدة، وثلاث مجموعات: مساعد موجه للعملاء، وكيل برمجة داخلي، وفريق بيانات يقوم باستخراج البيانات بكميات كبيرة، وكلهم على حساب مزود واحد. مر وكيل البرمجة بظرف سيئ بعد ظهر الشهر الماضي وحصل باقي المستخدمين على أخطاء 429.
أوقف الحرمان المتبادل. كانت المشكلة عداداً مشتركاً، وليست حدا مفقوداً. ضع قاعدة coding-agent-tpm (200,000 tokens_per_minute, subjects: ["virtualaccount:coding-agent"]) فوق قاعدة عامة على مستوى المستأجر (500,000 tokens_per_minute, when: {})، وامنح القاعدة العامة rate_limit_applies_per: ['virtualaccount'] حتى لا يتمكن الوكيل من استنزاف حصة الجميع بمطابقة كلا القاعدتين. أضف قاعدة requests_per_minute على نفس الموضوعات أيضاً: الطلبات الفاشلة تحسب ضد تلك القاعدة ولكن ليس ضد قاعدة التوكنات.
أضف السقف المالي. ميزانية شهرية لكل مستخدم على وكيل البرمجة مع تجاوز مهندس واحد، بالإضافة إلى سقف مدى الحياة (Lifetime) على مشروع الاستخراج:
يتم التحقق من كلاهما في كل طلب متطابق ويجب أن ينجح كلاهما. يوسع التجاوز سقف مهندس واحد دون تخفيف حدود أي شخص آخر، ولأنه يحل محل جميع الفترات، فإنه يكرر الفترة الخاصة بالقاعدة الأساسية.
ابدأ بوضع التدقيق (audit)، ثم الإسناد. قم بالتشغيل في وضع audit لمدة أسبوع: يتم تتبع الاستخدام وتطرق التنبيهات دون حظر أي شيء. اقرأ تنبيهات 75%، واضبط بناءً على حركة المرور الحقيقية، ثم طبق بتطوير الوضع لـ enforce. وسم كل حساب افتراضي وافرض اختيار الفريق في PATs، وسيكتب تقرير استرداد التكاليف نفسه — وهو الهدف من إسناد التكلفة حسب الفريق.
النظامان يطبقان في اتجاهين معاكسين. تحديد المعدل يطبق قاعدة الفوز لأول تطابق؛ وتمنع قاعدة واحدة فقط. بينما Budget V2 يتطلب موافقة الجميع؛ حيث يمكن لكل قاعدة متطابقة الحظر. إذا جليت نموذجاً ذهنياً من أحدهما إلى الآخر، فستفاجئك سياساتك.
لا يمكن ضبط الميزانيات بالتوكنات، ولا يمكن ضبط حدود المعدل بالدولار. أنت بحاجة إلى كلاهما. ورابط التوثيق هو /ai-gateway/ratelimiting، كلمة واحدة — إذا أضفت وصلة (-) فستحصل على صفحة 404.
تتبع تكلفة الصوت أضيق من تتبع تكلفة التوكنات. فهو يغطي تحويل النص إلى كلام ومن الكلام إلى نص في ElevenLabs و Google Vertex؛ أما مزودو الصوت الآخرون فيسجلون الاستخدام دون تسعير لكل حرف أو لكل ثانية، وتسعير الصوت الخاص مقتصر على Google Vertex فقط. تخدم خدمة تحويل الكلام إلى نص بدون مدة مبلّغ عنها من المزود بتكلفة صفرية — وستسمح الميزانية بحركة مرور غير محدودة تعتقد أنها مجانية.
الانتفال من الطلبات إلى التوكنات يسير التكوين وعظيم الأثر. فعداد الطلبات يخبرك بمدى انشغالك؛ وعداد التوكنات يخبرك بما تشتريه؛ بينما تطلعك الميزانية على الوقت المناسب للتوقف.
احرص على بناء الطبقات بشكل صحيح وسيترتب الباقي تلقائياً: حدود التوكنات تنعم استهلاك الدقيقة، وحدود الطلبات تحمي المسار، والميزانيات تحكم الشهر، وسقف مدى الحياة (Lifetime) يلتقط ما تبقى. السلوك الموصوف هنا مأخوذ من وثائق TrueFoundry اعتباراً من سبتمبر 2026.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



الفكرة نفسها، أي وضع سقف لما يمكن للجهة المستدعية استهلاكه ضمن نافذة زمنية، لكن الوحدة تتغير. تحديد معدل API التقليدي يعدّ الطلبات، وهذا ينجح عندما تتقارب تكلفة الطلبات. أما طلبات LLM فتتفاوت في عدد الرموز بمراتب عديدة، ولذلك يعكس حد الرموز الاستهلاك الفعلي بدقة أكبر بكثير. استخدم الاثنين معاً: الرموز تضبط معدل الإنفاق، والطلبات تحمي الاتصال من عواصف إعادة المحاولة.
كليهما. حد الرموز ضابط لمعدل المعالجة ضمن نافذة زمنية متحركة، يمنع جهة مستدعية واحدة من احتكار السعة في اللحظة الراهنة. والميزانية ضابط مالي ضمن فترة تقويمية، يمنع فريقاً من الإفراط في الإنفاق هذا الشهر. ولا يستطيع حد الرموز التعبير عن الدولارات، لأن عدد الرموز نفسه يكلّف مبالغ مختلفة باختلاف النماذج، والميزانية لا تقول شيئاً عن الدقيقة الحالية.
الطلب الفاشل، سواء رفضته البوابة أو فشل لدى المزوّد برمز 4XX أو 5XX، يُحتسب طلباً واحداً في كل قاعدة requests_per_* انطبقت عليه. والاستثناء الوحيد هو الطلب الذي رفضه تحديد المعدل نفسه برمز 429. أما حدود الرموز فلا تتأثر، لأن الطلب الفاشل لا يسجّل أي رموز.
نعم. تعمل TrueFoundry في VPC الخاصة بك أو محلياً أو في بيئة معزولة عن الشبكة أو هجينة، فلا تغادر التعليمات والردود نطاقك أبداً حتى وأنت توجّه الطلبات عبر مزوّدين كثيرين.
نحو 3 إلى 4 مللي ثانية من العبء الإضافي، مع معالجة أكثر من 350 طلباً في الثانية على وحدة vCPU واحدة، عبر أكثر من 1,000 نموذج LLM مدعوم. والاستثناء هو مصنِّف LLM الاختياري الذي يضيف استدعاءً فعلياً لنموذج قبل إعادة توجيه الطلب.
نعم. البوابة متوافقة مع OpenTelemetry وترتبط بـ Grafana أو Datadog أو Prometheus. وكل استدعاء لمصنِّف LLM ينتج span خاصاً به، فيظهر زمن استجابة المصنِّف منفصلاً عن زمن النموذج المقدَّم.



أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد



















