


November 13, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.



Blazingly fast way to build, track and deploy your models!
القاضي هو نموذج يتم إعطاؤه ثلاثة أشياء: مخرجات لتقييمها، ودليل تقييم يحدد معنى الإجابة "الجيدة"، وتعليمات لإعادة حكم قابل للقراءة آلياً — قبول/رفض، أو درجة، أو تفضيل بين مرشحين اثنين.
وُجد هذا المفهوم لأن البديل غير قابل للتوسع. تعمل مقاييس المطابقة الدقيقة عندما تكون هناك إجابة صحيحة واحدة؛ لكنها غير مجدية لإجابة دعم فني حيث تكون خمس إجابات مختلفة كلها صحيحة. يقوم البشر بتقييم هذه الحالات بشكل جيد ولكن ببطء. يقع القاضي في الوسط: فهو أقل دقة من إنسان حذر، ولكن أفضل بكثير من مقارنة النصوص، وسريع بما يكفي لمعالجة آلاف العينات. تعامل معه على أنه وكيل رخيص، غير دقيق، ومتوافق مع التقييم البشري.
الخطأ الأكثر شيوعاً هنا هو التعامل مع التقييم غير المباشر (offline eval) والحظر المباشر (online gating) كشيء واحد بجهتين للنشر.
صف الفشل هو ما يجب استيعابه جيداً. في الوضع غير المباشر، النتيجة الخاطئة تكلفك قراراً تعيد النظر فيه في الدورة التالية؛ أما في الوضع المباشر، فهي تعني مستخدماً يحدق في خطأ. لذلك قم بضبط القاضي المباشر لتحقيق الدقة (precision) حتى لو كان ذلك على حساب الاستدعاء (recall). إن نسخ دليل تقييم بين الوضعين هو السبب في قيام الفرق بحظر نسبة من الحركة الجيدة للبيانات.
ينجح القضاة في المعايير التي يمكن وصفها ولكن لا يمكن حسابها برمجياً — مثل هل هذه الإجابة مستندة إلى السياق المسترجع، أو هل النبرة مناسبة لسياق طبي. يمكنك كتابة القاعدة في فقرة ولكن ليس كـ regex. وهم يفشلون بثلاث طرق.
تحيز الموقع (Position bias). عند إعطاء القاضي مرشحَين، فإنه يفضل خانة واحدة؛ واكتعاس الترتيب يؤدي إلى قلب نسبة كبيرة من الأحكام. الحل هو تقييم كل زوج مرتين مع عكس المواقع واحتساب الاتفاق فقط، مما يضاعف التكلفة.
تحيز الإطناب (Verbosity bias). الإجابات الطولى تحصل على درجات أعلى، بشكل مستقل تقريباً عما إذا كانت الكلمات الإضافية قد أضافت أي قيمة. هذا يدفع موجهات الإنتاج خفية نحو الحشو: أنت تحسّن مقابل القاضي، والقاضي يكافئ الطول، وفاتورة الرموز ترتفع، دون أن يربط أحد بين الأمرين.
التفضيل الذاتي (Self-preference). يمنح النموذج درجات أعلى للنصوص التي تشبه توليداته الخاصة. إذا قام GPT بتقييم مخرجات GPT، فإن النتيجة تكون مجاملة — وهذا أقوى دليل على استخدام قاضٍ من عائلة مختلفة عن النموذج الخاضع للاختبار.
كذلك، فإن القضاة غير معايرين بشكل جيد على المقاييس المستمرة: اطلب درجة من 10 وستتجمع جميع التقييمات عند 7 و 8. التقييم الثنائي (نجاح/فشل) بناءً على معيار محدد يكون أكثر موثوقية بكثير. و القاضي لا يمكنه التحقق من حقيقة لا يملكها — فبدون مرجع، تحصل على انحيازاته المسبقة وليس على تحقق من الحقائق.
اختر عائلة مختلفة عن النموذج الخاضع للاختبار، لأن التفضيل الذاتي حقيقي وتجنبه مجاني. اختر نموذجاً أصغر مما تظن، لأن التقييم هو تصنيف مقابل موجه طويل وليس استنتاجاً معقداً. اختر نموذجاً محدداً بـ (pinned version) وليس متغيراً (floating)، لأن الاسم المستعار للمزود الذي يتحدث تلقائياً قد يغير مستوى الجودة لديك دون تغيير في الكود. واختر نموذجاً بـ p99 أقل من الشيء الذي يحميه، وإلا سيصبح القاضي هو السبب في تأخير الاستجابة (tail latency).
ثم تأتي الحسبة المالية. القاضي المباشر هو استدلال ثانٍ؛ وإذا فحصت الموجه والاستجابة معاً فإنه يصبح استدلالين. هذه ليست تكلفة إضافية يمكنك إلغاؤها بالهندسة، لذا فالقضية هي أي جزء من حركة البيانات تنطبق عليه:
إذا كان بإمكانك التعبير عن القاعدة ككود بركمجي، فعبر عنها ككود.
ينشرون دليل التقييم غير المباشر في مسار الطلب. دليل التقييم المكون من عشرة أبعاد والذي يعمل في التقييمات الليلية يتحول في بيئة الإنتاج إلى عائق بطيء وعالي التباين. يجب أن تكون أدلة التقييم المباشرة معياراً واحداً، ثنائياً، ومصاغاً بدقة تكفي لنموذج صغير للإجابة عليه باتساق.
لا يقيسون أداء القاضي أبداً. إنه نموذج في بيئة الإنتاج بدون تقييم خاص به. قم بتصنيف بضع مئات من الأمثلة الحقيقية يدوياً واقرأ الدقة (precision) والاستدعاء (recall) بشكل منفصل. إذا كنت لا تستطيع تحديد معدل النتائج الإيجابية الخاطئة، فأنك لا تستطيع تحديد نسبة المستخدمين الذين يفشل حاجز الحماية معهم.
ينتقلون مباشرة إلى الحظر. القاضي الذي تبلغ دقته 90% يحظر إجابة واحدة جيدة من بين كل عشر إجابات في اليوم الذي تطبقه فيه. قم بإجراء تدقيق أولاً، واقرأ تتبعات أسبوع كامل، ثم انتقل للتطبيق.
ينسون الاستجابات المتدفقة (Streamed responses). عند تدفق الرموز إلى المتصفح، لا يجد قاضي المخرجات شيئاً لتقييمه حتى ينتهي التدفق. معظم البوابات، بما فيها TrueFoundry، تتخطى حواجز حماية المخرجات في طلبات التدفق.
لا تحتوي TrueFoundry على منتج تقييم (eval). لا توجد صفحة تقييم، ولا مجموعات بيانات، ولا تتبع للتجارب، ولا واجهة واجهة لتنقيط الدرجات. التقييم غير المباشر يخص المنصات المصممة له، ودور TrueFoundry هو تصدير التتبعات عبر OpenTelemetry — تتبعات وليس مقاييس OTEL من تلك الشاشة. للحصول على مجموعة بيانات معتمدة ولوحة متصدرين، استخدم Braintrust، أو Arize أو ما يعادلهما ووجه المصدر إليها.
ما تطبقه TrueFoundry هو الجزء المباشر: قاضٍ يعمل كحاجز حماية في مسار الطلب، ويظهر حكمه، وزمن التأخير، واستهلاك الرموز في نفس التتبع الخاص بالطلب الذي حماه.

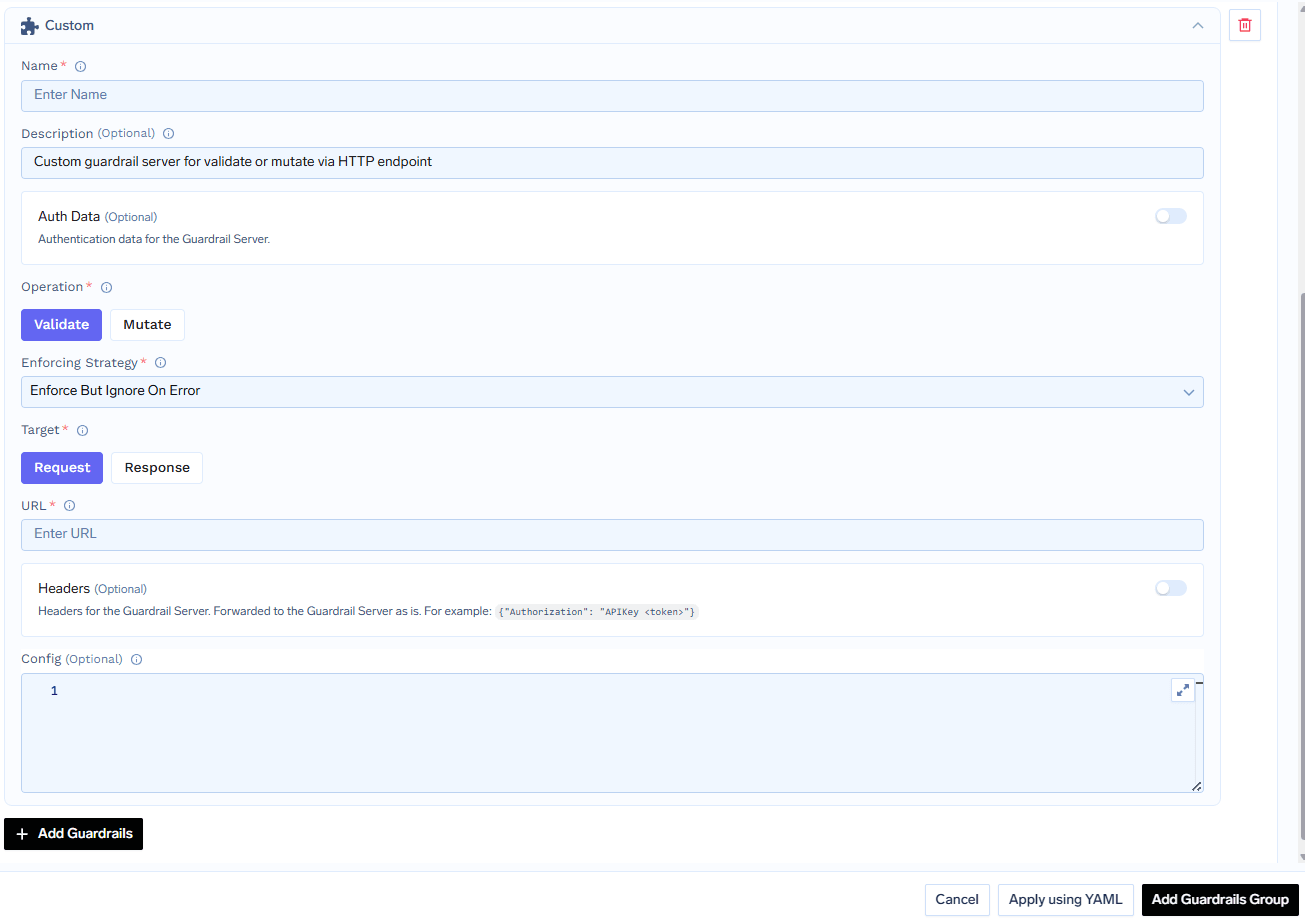
كل قاضٍ أدناه هو خدمة صغيرة تقوم بنشرها، وتستدعيها البوابة كحاجز من خلال عقد حواجز الحماية المخصصة. يحتوي هذا العقد على قاعدة واحدة تستحق الحفظ: رمز HTTP 2xx يعني أن حاجز الحماية عمل حتى الإنهاء، وقرار السياسة يوجد فقط داخل جسم JSON. تحذر وثائق الدعم من أن الحظر المشار إليه بـ HTTP 400 قد يُقرأ كخطأ أثناء التشغيل ويُسمح بالمرور. أرجع 2xx مع verdict: false.
يعمل NeMo كمغلف FastAPI موزع على TrueFoundry — بدون استدعاءات NeMo SDK أصلية من البوابة، وبدون تغييرات في SDK العميل في تطبيقك. في الداخل، يستخدم LLM قاضٍ صغيراً بالإضافة إلى Colang، وهي لغة مخصصة لمجال معين، لتقييم الموجهات والاستجابات من خلال حواجز self_check_input و self_check_output. يعيش دليل التقييم في حزمة Colang، حيث يحتوي config/prompts.yml على أمثلة لـ few-shot لالتقاط تمثيل الأدوار بأسلوب DAN، و"تجاهل التعليمات السابقة"، واستخراج موجهات النظام، وعلامات تجاوز السياسات في الإصدار v1.
التفصيل المهم تشغيلياً: يقوم LLM القاضي بالإعادة الاستدعاء عبر نفس بوابة TrueFoundry. يحمل ملف .env للمغلف TFY_BASE_URL و TFY_API_KEY و JUDGE_MODEL — المثال في الوثائق هو openai-main/gpt-4o-mini. ولأن استدلال القاضي هو حركة بيانات داخل البوابة، فإن رموزه، وتكلفته، وزمن التأخير تظهر في نفس لوحات التحكم ككل شيء آخر، مما يتيح لك رؤية تكلفة حواجز الحماية. تغيير القضاة يتم في سطر واحد: قم بتغيير JUDGE_MODEL (تظهر الوثائق openai-main/gpt-4o) وإعادة النشر.
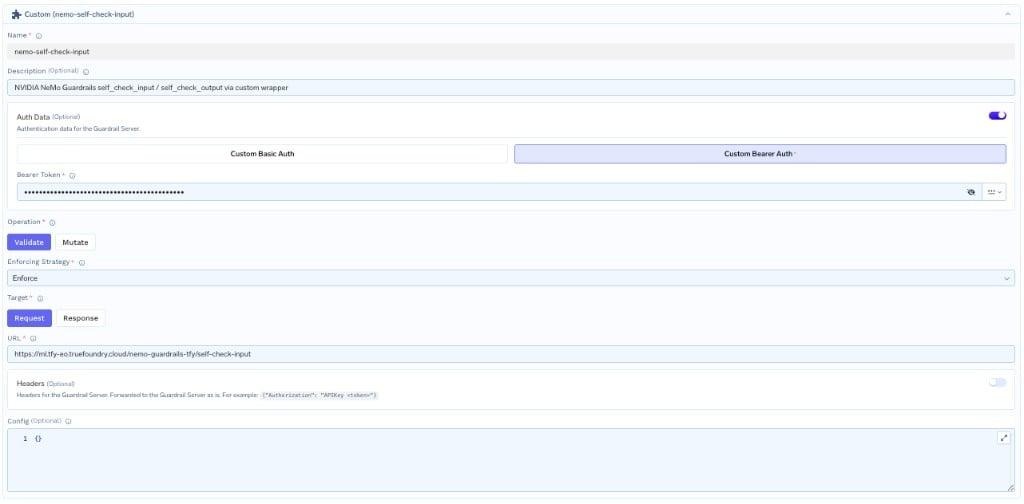
قم بتسجيل إعدادي حواجز حماية مخصصة (Custom Guardrail Configs)، كلاهما من نوع Validate — المحددات nemo-self-check/nemo-self-check-input و .../nemo-self-check-output — مع التوصية باختيار Enforce But Ignore On Error. عقد الحكم صغير جداً: HTTP 200 بالإضافة إلى {"verdict": bool, "message": Optional[str]}؛ بينما يصل الفشل الحقيقي كـ 5xx.
ترسل البوابة استدعاء حاجز المدخلات واستدعاء النموذج بالتوازي، وبالتالي لا يضيف القاضي وقتاً إلى الزمن حتى أول رمز (time-to-first-token)؛ وفي حالة الحظر يتم إلغاء استدعاء النموذج الذي قيد التشغيل. أما حاجز المخرجات فيعمل بشكل متسلسل، لأنه يتطلب ذلك.
الوثائق صريحة بشأن السعر. تحت القيود المعروفة، وبكلماتهم الخاصة: كل طلب محمي يضيف استدعاءً أو استدعاءين لـ LLM، استدعاء واحد لكل اتجاه. كما يلاحظون أنه لا توجد حواجز حماية تدعم التدفق (streaming-aware)، لأن العقد مؤقت (buffered)، وأن الحالة في الذاكرة تتم لكل نسخة مكررة (replica).
Patronus هو أقرب شيء إلى قاضٍ جاهز الاستخدام في الكتالوج، وهو للتأكيد فقط (Validate-only) — فالعملية هي "validate" حرفياً، وتذكر الوثائق أنه لا يمكنه التعديل.
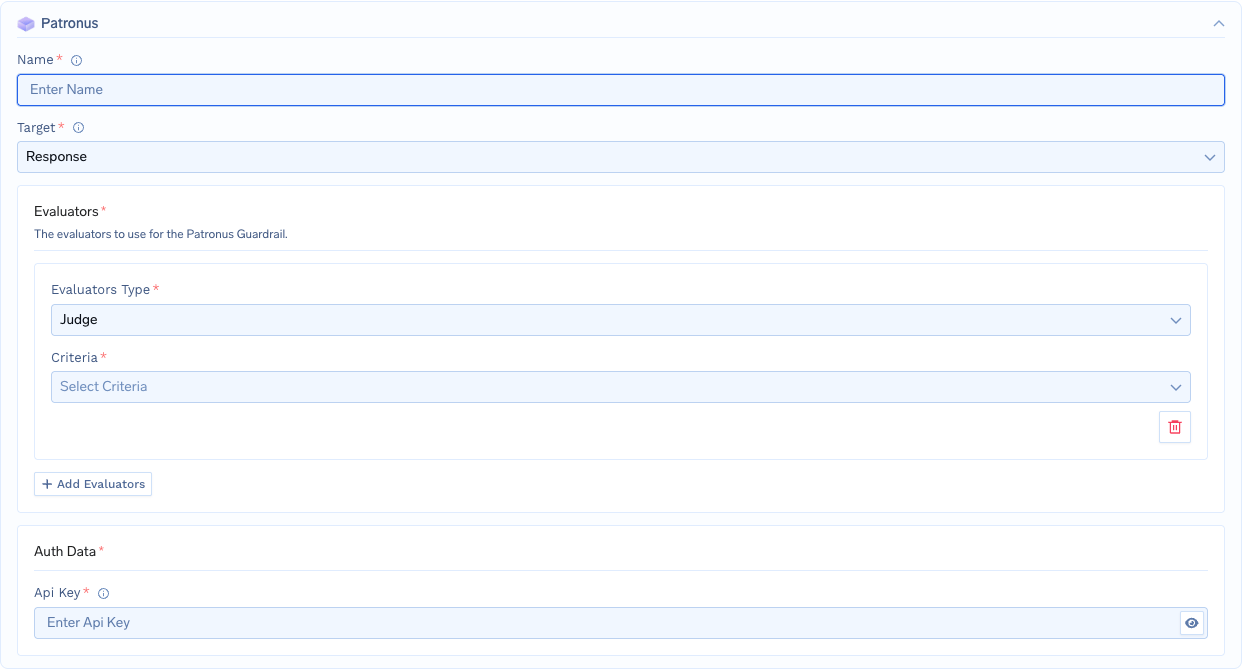
نوع الإعداد هو integration/guardrail-config/patronus. قم بضبط الهدف (target) على الطلب أو الاستجابة، ثم ادرج المقيمين؛ يوجد ستة أنواع — answer-relevance، glider، judge، pii، phi، toxicity. نوع القاضي (judge) هو الذي يعتمد على LLM-as-a-judge، وحقل المعايير (criteria) الخاص به إجباري. جميع القيم الـ 15 الموثقة:
تضيف عائلة glider الشقيقة خمسة معايير: patronus:is-compliant، patronus:is-factually-consistent، patronus:is-good-summary، patronus:is-harmful-advice، patronus:is-informal-tone.
مقارنة بجدول القرارات أعلاه، فإن التقسيم واضح: is-json و is-csv هي فحوصات تنسيق ينفذها المصادق (validator) بشكل أفضل وأرخص، في حين أن no-harmful-therapeutic-guidance و is-good-summary هي المعايير النصية التي يُستخدم القاضي لأجلها.
إذا كانت قيمة data.results[].evaluation_result.pass هي false، يتم حظر الطلب وإرجاع رمز 400. يظهر مثال الاستجابة في الوثائق evaluator_id: "judge-large-2024-08-08"، و evaluator_family: "Judge"، و profile_name: "patronus:prompt-injection"، و pass: false، و score_raw: 0، و evaluation_duration: "PT4.44S"، و usage_tokens: 687، و evaluation_metadata.highlighted_words. تدعي الصفحة أن أوقات الاستجابة تصل إلى 100 ملي ثانية؛ لكن مدة 4.44 ثانية في المثال تذكرنا بأن حد الأداء الأقصى للقاضي ليس هو المتوسط.
معظم Guardrails AI يتعمد ألا يكون قاضياً. حزمتها في الإصدار v1 — DetectPII، SecretsPresent، ToxicLanguage، ProfanityFree عبر سبعة أطراف نهاية — تعمل محلياً في حاوية المغلف (wrapper pod)، بدون جولة استدعاء لـ LLM لكل طلب، وزمن تأخير في الحالة المستقرة أقل من 100 ملي ثانية.
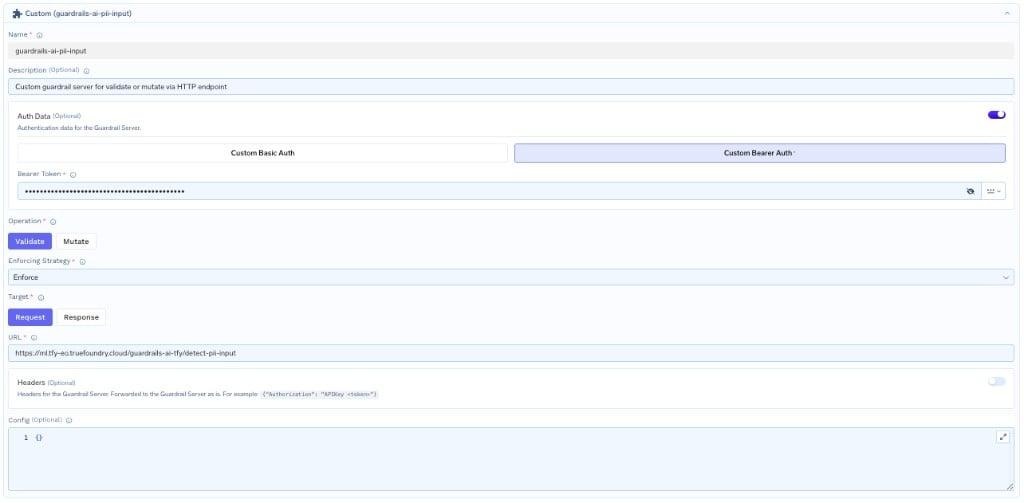
أدوات التحقق القائمة على القاضي هي مستوى اختياري من الـ Hub: hub://guardrails/restricttotopic (بتقييم LLM)، و hub://guardrails/provenance_llm — والتي تصفها الوثائق بأنها مكلفة — و hallucination_check. قم بتهيئتها عبر متغيرات البيئة LITELLM_* ووجهها عبر البوابة للحصول على إمكانية مراقبة موحدة، وهو نفس النمط الذي يستخدمه NeMo لـ JUDGE_MODEL. تتوفر بدائل رخيصة بجانبها: competitor_check يعتمد على القائمة المسموحة، و regex_match يعتبر رخيصاً كما في الوثائق.
توضح صفحة الهلوسة في TrueFoundry أربعة أنواع — حقيقية، وسياقية، ومنطقية، ولمصدر — وطريقتين محددتين للتنفيذ: AWS Bedrock Guardrails، حيث تقوم بتمكين Grounding و Relevance، وتحديد Guardrail Action إلى Block مع ضبط العتبة؛ أو حاجز حماية مخصص في مستودع القوالب.
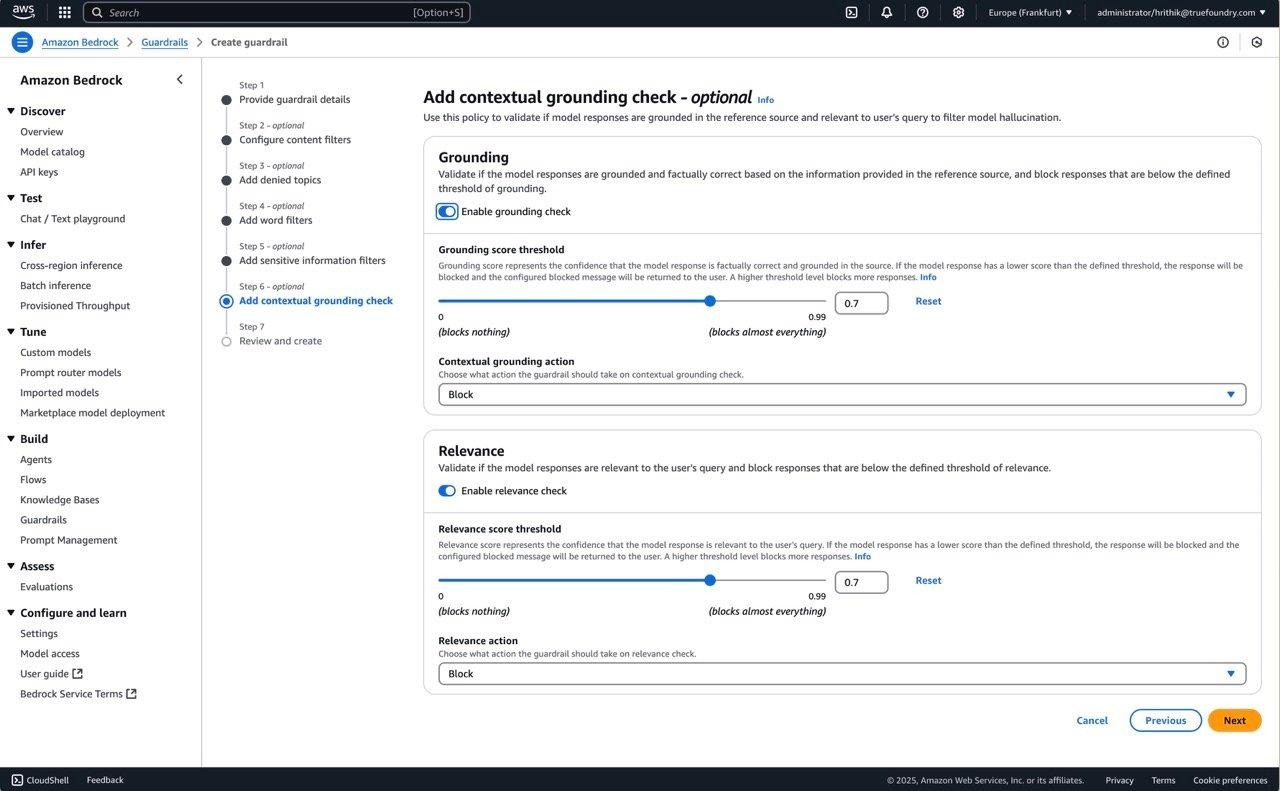
تذكر الوثائق بوضوح أن مستودع القوالب لا يتضمن حالياً حاجز حماية للهلوسة جاهزاً للاستخدام — فهو يقدم أمثلة مثل حجب PII وتصفية المحتوى غير اللائق (NSFW). المسار المخصص يتطلب عملاً حقيقياً وليس مجرد خيار يتم تفعيله.
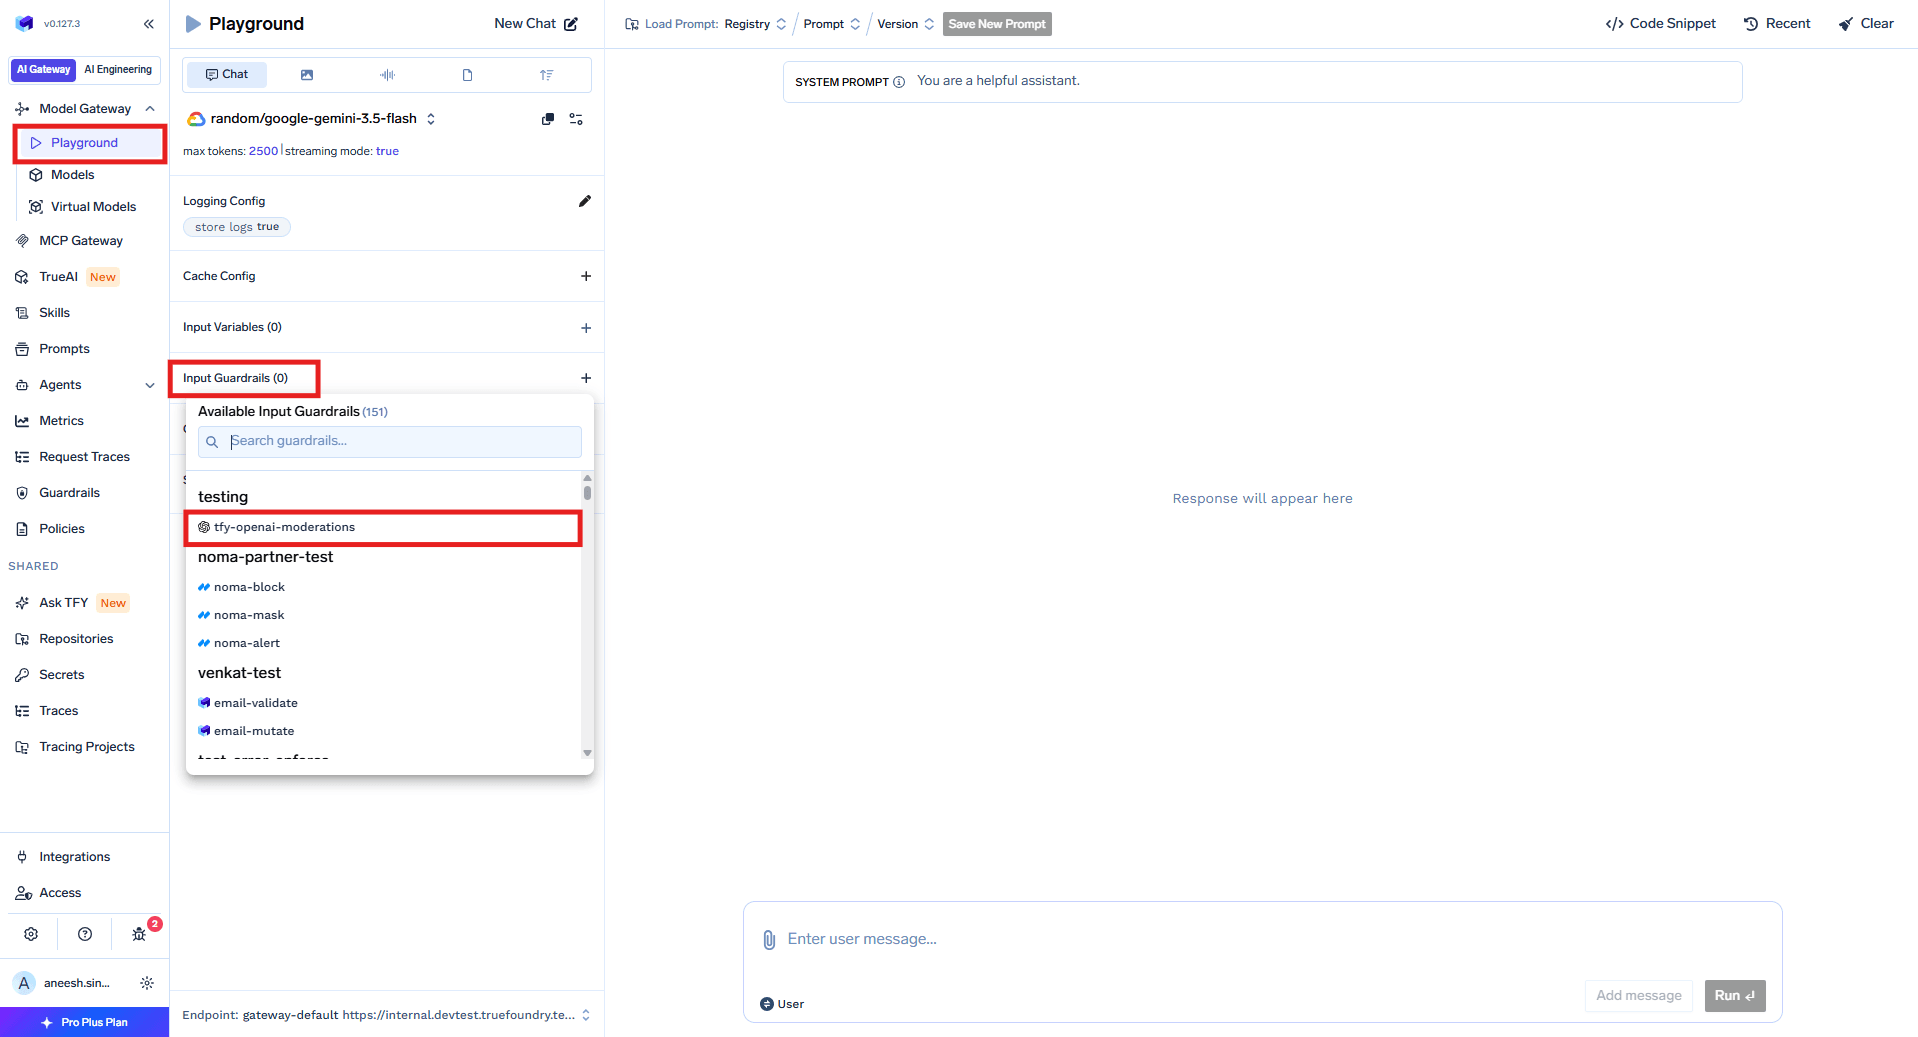
تشغل بيئة التجربة (Playground) جميع الخطافات الأربعة، بحيث يمكنك إرسال موجه هجومي إلى حاجز المدخلات قبل وجود أي سياسة.
بمجرد التشغيل المباشر، يصبح كل تقييم لحاجز الحماية عبارة عن فاصل زمني (span) مستقل في Monitor ← Request Traces يحتوي على وقت التنفيذ، والنتيجة، والنطاق، والمدخلات، والمخرجات — ويتم تسجيل ذلك حتى للطلبات المحظورة، بحيث يصبح الاستدعاء المرفوض دليلاً وليس فجوة في البيانات.

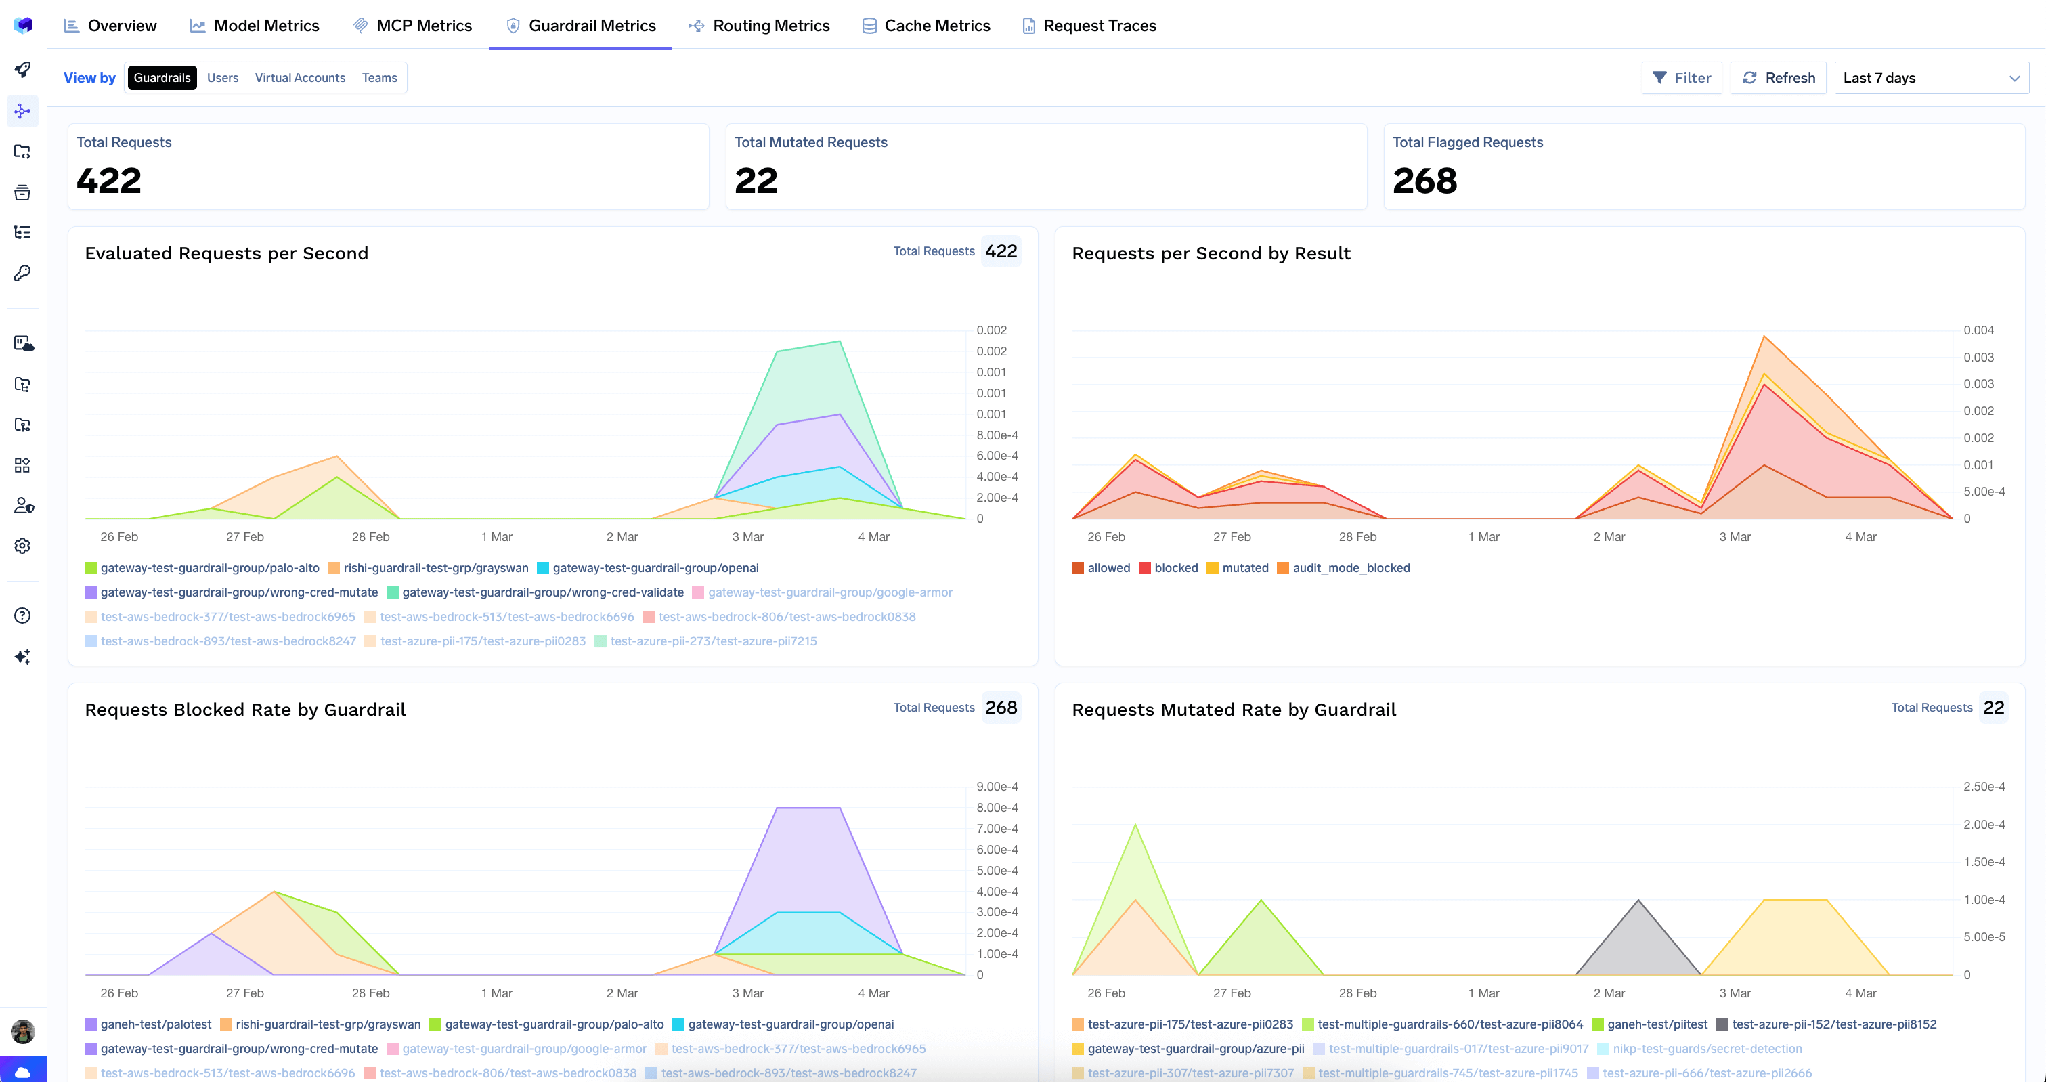
على المستوى الإجمالي، يقسم عرض حواجز الحماية في لوحة المقاييس (Metrics Dashboard) الطلبات في الثانية عبر المسموح بها، والمحظورة، والمعدلة، و audit_mode_blocked، مع معدلات الحظر والتعديل لكل حاجز وزمن تأخير الحاجز عند P50 و P75 و P90 و P99. الرسم البياني الأخير هو كيف تكتشف قاضياً أصبح الحد الأقصى لتأخيره هو سبب تأخير نظامك بكامله.
حكم القاضي هو ادعاء حول الجودة، والطريقة الوحيدة لاختباره هي مقارنته بحكم بشري على نفس الطلب. يحمل كل استجابة من AI Gateway ترويسة x-tfy-feedback-target-id. قم بإرسالها إلى POST https://{control_plane_url}/api/svc/v1/gateway-feedback مع {"target": {"feedbackTargetId": "<base64>"}, "rating": 4, "comment": "...", "metadata": {...}} — يتراوح التقييم من 1 (الأدنى) إلى 5 (الأعلى) — وتحصل على {"data": {"id": "..."}}. للتصحيح استخدم PUT .../gateway-feedback/{feedback_id}، وللإزالة DELETE. تظهر الملاحظات بجانب الفاصل الزمني، وتوجد القائمة الكاملة في Raw Data تحت tfyGatewayFeedbacks.
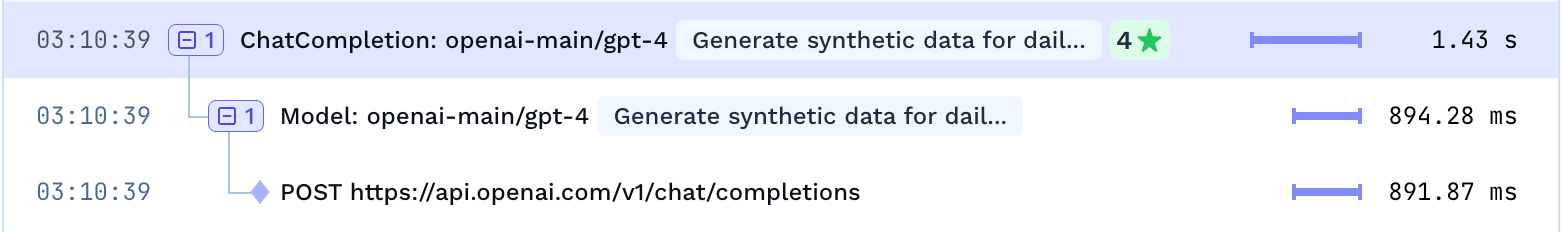
قيد واحد: معرف الهدف يوجه الفاصل الزمني الجذر (root span) فقط. الملاحظات تطبق على الطلب ككل، وليس على خطوة فرعية.
يجيب مساعد داخلي على أسئلة منسق الرعاية. تطلب إدارة الامتثال أمرين: عدم تقديم توجيهات علاجية ضارة أبداً، واستخدام نبرة مناسبة سريرياً. لا يمكن التعبير عن أي منهما كـ regex، لذا فهذا مجال استخدام القاضي.
1. اختر أضيق دليل تقييم ممكن. معيارا قاضٍ من Patronus فقط، وليس عشرة — patronus:no-harmful-therapeutic-guidance و patronus:clinically-inappropriate-tone، مع target: response. وبقية قائمة الامتثال تذهب إلى الكواشف الرخيصة.
2. ابدأ في وضع التدقيق (Audit). تم تحديد قاعدة سياسة تحت AI Gateway ← Policies ← Guardrails لنطاق نماذج المساعد وفريق منسقي الرعاية، مع استراتيجية تطبيق Audit: تسجيل الحكم بدون حظر أي شيء.
3. اقرأ تتبعات أسبوع كامل. يخبرك audit_mode_blocked بعدد الطلبات الحقيقية التي كان سيتم حظرها بواسطة هذه القاعدة؛ ويخبرك evaluation_metadata.highlighted_words بالسبب. عادةً ما يتم تفعيل معيار النبرة في الإجابات الجيدة التي تصادف أنها موجزة.
4. قارن مع التقييم البشري. تم ربط زر التقييم للمساعد بـ API الملاحظات عبر x-tfy-feedback-target-id. إذا كانت الطلبات المحددة بشرائح هي نفسها التي قيمها البشر بـ 1 أو 2، فالقاضي يؤدي عمله بنجاح. وإذا لم تكن كذلك، فقم بتعديل دليل التقييم، وليس العتبة.
5. ترقية الاستراتيجية، ثم مراقبة التكلفة. انتقل إلى Enforce But Ignore On Error بحيث يتحول انقطاع Patronus إلى وضع بدون حماية بدلاً من انقطاع في خدمتك الخاصة. يرسل Patronus تقريراً بـ usage_tokens لكل تقييم، ويتم توجيه استدلال القاضي عبر البوابة، وبالتالي تكون تكلفة التقييم مرئية وليست مستنتجة — وهذا الرقم هو ما يحدد معدل أخذ العينات لديك.
هل أنت مستعد لوضع قاضٍ أمام حركة البيانات لديك؟
سجل حاجز حماية مخصصاً واحداً، وابدأ في وضع التدقيق، واقرأ الأحكام.
ابدأ مجاناً

يتم تخطي حواجز حماية المخرجات في الاستجابات المتدفقة. مع "stream": true، لا تعمل حواجز المخرجات؛ بينما تعمل حواجز المدخلات دائماً. إذا كان منتجك يستخدم التدفق، فإن القاضي يحمي الموجه فقط ولا شيء غيره.
لا تطلع حواجز الحماية على موجهات النظام أبداً. تقوم البوابة بإزالتها قبل إرسال المحتوى إلى أي حاجز حماية، وتعتبر CrowdStrike AIDR الاستثناء الوحيد الموثق للقراءة فقط. لا يمكن للقاضي تقييم ما إذا تم اتباع تعليماتك أم لا.
التحقق من صحة المخرجات يكلفك استدعاء النموذج رغم ذلك. يفيد فشل حاجز المدخلات أثناء التشغيل في سماح البوابة بإلغاء الطلب. أما حاجز المخرجات فيعمل بعد وجود الاستجابة، وتلاحظ الوثائق أن تكاليف النموذج تكون قد حدثت بالفعل بحلول ذلك الوقت.
استخدام LLM كقاضٍ هو أسلوب جيد بشرط الاستخدام الصحيح والدقيق. إنه الطريقة الوحيدة لتقييم النصوص الموضوعية على نطاق واسع، ولكنه ينحاز نحو الإجابات الطويلة، ونحو مخرجات العائلة التي ينتمي إليها، ونحو المرشح الذي يتم تقديمه أولاً. الفريق الذي يصدق النصف الأول فقط سينشر حاجز حماية يحظر مستخدميه خفية.
التقسيم الذي يجعل الأمر قابلاً للتطبيق هو ما بدأنا به هذا المقال. التقييم غير المباشر (Offline scoring) هو مشكلة مجموعات بيانات تنتمي إلى منصة تقييم، حيث تقوم TrueFoundry بتصدير التتبعات إليها عبر OTEL. أما الحظر المباشر (Online gating) فهو مشكلة مسار طلب: معيار واحد محدد، وقاضٍ صغير محدد الإصدار من عائلة مختلفة، والبدء بوضع التدقيق أولاً، وإعطاء الأولوية للدقة على الاستدعاء، مع رؤية صريحة للتكلفة.
اكتب القاعدة ككود برجمي حيثما أمكنك ذلك. وعندما لا يمكنك كتابتها إلا كجملة نصوص، استخدم قاضياً — وقسه كأي نموذج آخر.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



هو استخدام نموذج لغوي لتقييم مخرجات نموذج آخر وفق معايير مكتوبة، مع إرجاع حكم قابل للقراءة آلياً: نجاح أو فشل، أو درجة، أو تفضيل بين مرشحين. وُجد هذا الأسلوب لأن النص المفتوح ليس له مقياس صحة قابل للحساب، والأفضل التعامل معه كبديل رخيص وغير دقيق تماماً عن المقيّم البشري.
مع المعايير الضيقة والثنائية والمصوغة بدقة، نعم في كثير من الأحيان، ومع معايير الجودة الواسعة، لا في الغالب. قِس أولاً الدقة والاستدعاء كلاً على حدة باستخدام أمثلة مصنّفة يدوياً، فالمُحكِّم الذي تبلغ دقته 90% يحظر نحو إجابة سليمة واحدة من كل عشر في اليوم الذي تبدأ فيه إنفاذه.
استدعاء إضافي واحد للنموذج على الأقل لكل طلب محمي، واستدعاءان إذا كنت تقيّم التعليمات والرد معاً، ووثائق NeMo لدى TrueFoundry تذكر هذا الحساب صراحةً. والرافعة الوحيدة هي نسبة التغطية: اعتمد العيّنات لأغراض القياس، واحتفظ بالتغطية الكاملة للفحوص التي يجب ألا تُخطئ أبداً.
نعم. تعمل TrueFoundry في VPC الخاصة بك أو محلياً أو في بيئة معزولة عن الشبكة أو هجينة، فلا تغادر التعليمات والردود نطاقك أبداً حتى وأنت توجّه الطلبات عبر مزوّدين كثيرين.
نحو 3 إلى 4 ميلي ثانية، مع الحفاظ على أكثر من 350 طلباً في الثانية على vCPU واحدة، عبر أكثر من 1,000 نموذج LLM. أما زمن ضوابط الحماية فيُقاس بشكل منفصل ويُعرض عند P50 وP75 وP90 وP99.
نعم. البوابة متوافقة مع OpenTelemetry وتصدّر بيانات التتبع إلى أنظمة خلفية خارجية، وبهذه الطريقة تصل بيانات البوابة إلى منصات مثل Braintrust أو Langfuse أو Arize. ولا تشغّل TrueFoundry نفسها مهام تقييم خارج وقت التشغيل.



أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد



















