احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.
٩.٩
اعتبارات التكلفة لاستخدام بوابة AI Gateway: تحسين إنفاق الذكاء الاصطناعي في المؤسسات
أصبحت إدارة تكلفة استخدام نماذج اللغات الكبيرة (LLM) مهمة حاسمة للمؤسسات التي تنشر الذكاء الاصطناعي على نطاق واسع. وعلى عكس البرامج التقليدية، غالبًا ما تستخدم الخدمات المستندة إلى LLM تسعيرًا قائمًا على الرموز (token-based pricing) – حيث يفرض المزودون رسومًا لكل رمز إدخال/إخراج – مما يجعل وضع الميزانية أمرًا يصعب التنبؤ به أو التحكم فيه. وتساهم عوامل متعددة في هذا التعقيد:
تسعير النماذج المختلفة: يمتلك كل مزود لـ LLM (مثل OpenAI وAnthropic وCohere وغيرهم) أو كل حجم نموذج سعره الخاص لكل رمز، حيث تكلف النماذج الأكبر (مثل فئة GPT-4) أكثر بكثير لكل رمز مقارنة بالنماذج الأصغر.
أنماط الاستخدام غير المتوقعة: يمكن أن يختلف استهلاك الرموز بشكل كبير حسب المستخدم أو الميزة أو سير العمل – حيث قد تستخدم إحدى الميزات بهدوء 10 أضعاف الرموز مقارنة بميزة أخرى، ويمكن أن يرتفع الاستخدام بشكل غير متوقع بناءً على سلوك المستخدم.
مسارات المطالبات الديناميكية: يمكن لحالات الاستخدام المتقدمة مثل التوليد المعزز بالاسترجاع (RAG)، أو الوكلاء الذين يستخدمون الأدوات، أو السلاسل متعددة الخطوات أن تؤدي عن غير قصد إلى توسيع حجم المطالبة وطول الاستجابة، مما يضاعف الرموز (والتكلفة) المطلوبة لكل استعلام.
والنتيجة هي أنه بدون الرؤية الضوابط المناسبة، غالبًا لا تدرك الفرق مدى سرعة تراكم التكاليف حتى تصل الفاتورة. وليس من غير المألوف أن تتضخم النفقات بشكل غير متوقع، مما يهدد ميزانيات المشاريع ويعيق جهود التوسع. كما يحذر تقرير حديث لشركة Gartner من أن نقص رؤية التكاليف والحوكمة يمكن أن يؤدي سريعًا إلى تجاوز الميزانية في مبادرات الذكاء الاصطناعي. باختصار، مع دمج المؤسسات لـ LLMs في منتجاتها، تصبح السيطرة على تكلفة الاستخدام حاسمة تمامًا مثل دقة النموذج أو وقت التشغيل. ويقدم التسعير القائم على الرموز حالة من عدم اليقين يمكن أن تعطل العائد على الاستثمار ما لم تتم إدارتها بفاعلية.
وهنا يأتي مفهوم AI Gateway. حيث تبرز AI Gateway كعنصر أساسي لاستعادة السيطرة على استخدام وصرف LLM. وقبل الغوص في محركات التكلفة والحلول، دعنا نحدد ما هي AI Gateway وكيف تؤثر على التكلفة.
ما هي AI Gateway؟ (وكيف تؤثر على التكلفة)
تُعد AI Gateway طبقة برمجيات وسيطة متخصصة تدير جميع التفاعلات بين تطبيقاتك ونماذج أو مزودي الذكاء الاصطناعي المتعددين. فكر فيها كبوابة API مبنية خصيصًا لأحمال عمل الذكاء الاصطناعي — تفهم التفاصيل الدقيقة الخاصة بالنماذج مثل الفوترة القائمة على الرموز، وزمن انتقال الاستدلال، التوجيه الديناميكي. وتوفر نقطة نهاية موحدة لجميع طلبات الذكاء الاصطناعي، وتوجه حركة المرور ذكيًا إلى backend النموذج المناسب بناءً على سياسات التكلفة أو الأداء أو التوفر.
بينما يضيف إضافة بوابة نفقات إضافية طفيفة مثل تكاليف الاستضافة وجهد التكوين — إلا أن هذه النفقات تفوقها بكثير السيطرة والرؤية التي توفرها. من خلال توجيه كل طلب عبر طبقة واحدة، يمكن للمؤسسات مراقبة الاستخدام، وفرض الميزانيات، واتخاذ قرارات في الوقت الفعلي بشأن النموذج الذي يقدم أفضل مقايضة بين التكلفة والأداء. وتصف Gartner بوابات الذكاء الاصطناعي بأنها "متحكمات حركة مرور ذكية" تساعد المؤسسات على تقييم وتحسين استخدام النماذج عبر التطبيقات.
تستعرض AI Gateway من TrueFoundry دور طبقة التحكم هذه التي توحد الوصول عبر النماذج والمزودين مع فرض سياسات المؤسسة مثل التحكم في الوصول، وحوكمة التكاليف، والتخزين المؤقت (caching)، والقابلية للملاحظة (observability). وهي تحول استهلاك الذكاء الاصطناعي من مصاريف غير متوقعة إلى نظام مدار، ومقاس، وقابل للتحسين.
محركات التكلفة الرئيسية في استخدام LLM
عند استخدام نماذج اللغات الكبيرة في الإنتاج، تحدد عدة عوامل رئيسية التكلفة الإجمالية للتشغيل. ويعد فهم هذه المحركات الخطوة الأولى في إدارة وتخفيض التكاليف المتعلقة بـ LLM:
اختيار النموذج وحجمه: يمتلك اختيار النموذج تأثيرًا هائلاً على التكلفة. وعادة ما تكون للنماذج الأكبر والأكثر تقدمًا (ذات عدد المعلمات الأعلى أو القدرات الأكبر) تكاليف أعلى بكثير لكل رمز. على سبيل المثال، يمكن أن تكلف نماذج GPT-4 أو غيرها من نماذج "التفكير المنطقي" أكثر بدرجة من حيث التكلفة لكل رمز مقارنة بالنماذج الأصغر. واستخدام نموذج من الدرجة الأولى لكل طلب فردي – بما في ذلك الاستعلامات التافهة – سيرفع التكاليف بلا داعٍ.
استخدام الرموز (طول المطالبة والاستجابة): يدفع عدد الرموز المرسلة في المطالبات بالإضافة إلى الرموز المنشأة في الاستجابات الفوترة بشكل مباشر. حيث تتسبب المحادثات أو المستندات الطويلة، أو نوافذ السياق الطويلة جدًا، أو المطالبات غير المحسنة التي تتضمن معلومات غير صلة في زيادة عدد الرموز. كما يمكن لميزات مثل طلب أن يكون النموذج مطولاً أو تقديم تفسيرات موسعة أن تزيد الاستخدام بشكل أسي. ويمكن لـ هندسة المطالبات (prompt engineering) الفعالة لإبقاء المطالبات موجزة والمخرجات مركزة أن تخفض التكاليف بشكل كبير. كل رمز يفرق عندما تدفع أجزاء من السنت لكل رمز ملايين المرات.
حجم حركة المرور وأنماطها: يؤثر معدل ونطاق استخدام ميزات الذكاء الاصطناعي بوضوح على التكلفة – ولكن الأمر لا يتعلق بالحجم الإجمالي فحسب، بل بالنمط أيضًا. حيث يمكن أن تتسبب حركة المرور المفاجئة غير المتوقعة في تكاليف أثناء ذروة الاستخدام تتجاوز الميزانية الشهرية. ويعني التباين بين المستخدمين أو الميزات أن عددًا قليلاً من المستخدمين النشطين أو أداة داخلية قد يستهلكون سراً غالبية الرموز. ويمكن أن تؤدي الارتفاعات المفاجئة في الاستخدام (مثل انتشاره ميزة جديدة بسرعة) إلى فواتير غير مخطط لها إذا لم يتم الحد منها. وتوسيع نطاق الاستخدام دون توسيع الرقابة على التكاليف هو وصفة لتجاوز الميزانية.
الاستخدام متعدد النماذج واختيار المزود: تستخدم العديد من الفرق مزيجًا من النماذج – على سبيل المثال، نموذج مفتوح المصدر لبعض المهام وAPI ملكي لمهام أخرى، أو مزودين مختلفين للغات مختلفة. وقد يكون لكل نموذج/مزود وحدات تسعير مختلفة (بعضها يفرض رسومًا لكل 1000 رمز، والبعض الآخر لكل طلب، وما إلى ذلك)، وربما رسوم إضافية. علاوة على ذلك، إذا اعتمد الفريق دائمًا على أغلى نموذج "للبقاء في الأمان"، فإنه يفوت فرص التوفير. ويعد اختيار النموذج المناسب لكل مهمة رافعة تكلفة رئيسية: الاستعلام البسيط لا يحتاج إلى نموذج مكلف بـ 175 مليار معلمة بينما يمكن لنموذج أصغر (وأرخص) القيام بذلك. وعلى العكس من ذلك، قد تبرر بعض المهام المعقدة تكلفة نموذج متفوق. وتعد الاستراتيجية (أو غيابها) في توجيه حركة المرور إلى النماذج محرك تكلفة كبيرًا.
البنية التحتية والنفقات الإضافية: هناك أيضًا تكاليف تتجاوز الرسوم المفروضة لكل رمز. إذا قمت باستضافة LLMs مفتوحة المصدر ذاتيًا لتجنب تكاليف API، فسوف تدفع في البنية التحتية – خوادم GPU، والذاكرة، والصيانة، وجهود MLOps. وكما صاغ أحد التحليلات باختصار، "إن LLMs مفتوحة المصدر ليست مجانية — فهي تنقل الفاتورة فقط من الترخيص إلى الهندسة، والبنية التحتية، والصيانة، والمخاطر الاستراتيجية." وحتى مع استخدام cloud APIs، قد تحتاج إلى بنية تحتية إضافية للتعامل مع الطلبات (مثل تشغيل خدمة داخلية أو بوابة، ودوابط بيانات متجهة لـ RAG، وما إلى ذلك)، مما يستلزم تكاليف الحوسبة السحابية. وتعد نفقات التكامل ووقت الهندسة تكاليف "خفية" يمكن أن تتسلل.
رسوم الترخيص أو الاشتراك: تتطلب بعض النماذج والخدمات رسومًا ثابتة بالإضافة إلى الاستخدام. على سبيل المثال، تتطلب بعض APIs للذكاء الاصطناعي للمؤسسات اشتراكًا شهريًا أو التزامًا. وحتى النماذج مفتوحة المصدر قد تحتوي على قيود ترخيص تدفع المؤسسات نحو الخيارات المدفوعة. وإذا اعتمدت منصة تقديم نماذج ملكية، فقد تكون هناك تكاليف ترخيص. ويجب مراعاة هذه الرسوم في التكلفة الإجمالية للملكية لاستخدام نموذج معين – ففي بعض الأحيان قد يتطلب النموذج "الأرخص لكل رمز" ترخيصًا مكلفًا، مما يلغي التوفير.
تكاليف التكامل وعدم الكفاءة: أخيرًا، يمكن لكيفية دمج الذكاء الاصطناعي في أنظمتك أن تخلق عدم كفاءة في التكلفة. حيث يمكن للمكالمات المكررة، أو غياب التخزين المؤقت، أو سوء إدارة الحمل أن تهدر الرموز. ووجد أوائل المتبنين في المؤسسات أن استخدام بوابة API قياسية أو تكامل مؤقت أدى إلى تجاوزات كبيرة في التكاليف – في بعض الحالات بنسبة 300% عن التوقعات الأولية – لأن الأدوات لم تأخذ في الاعتبار التحسينات الخاصة بالذكاء الاصطناعي مثل التخزين المؤقت للمطالبات المتشابهة أو موازنة الحمل عبر النماذج. وتوجد تكلفة لبناء وصيانة البنية التحتية الخاصة بك للوصول متعدد النماذج والمراقبة. وإذا طلب كل فريق APIs الذكاء الاصطناعي بشكل مستقل، فإنك تفقد وفورات الحجم والرقابة المركزية، مما يؤدي غالباً إلى إنفاق إجمالي أعلى من اللازم (على سبيل المثال، وصول فرق متعددة إلى نفس النموذج مع نفس الطلب والدفع مرتين).
يبرز فهم محركات التكلفة هذه سبب عدم كفاية مجرد منح الفرق إمكانية الوصول إلى LLM API – حيث إن الاستخدام غير المدار عبر العديد من التطبيقات والمستخدمين سيؤدي حتمًا إلى مفاجآت. وكلما كان استخدام الذكاء الاصطناعي أكثر أهمية وانتشارًا، زادت الحاجة إلى الحوكمة. وهنا تثبت AI Gateways قيمتها: فهي تستهدف مباشرة محركات التكلفة هذه، وتوفر آليات للسيطرة على التكاليف دون التضحية بالأداء أو الموثوقية.
إدارة وتخفيض تكاليف LLM باستخدام AI Gateway
تقدم AI Gateway مجموعة من الأدوات والاستراتيجيات الذكية لمعالجة محركات التكلفة المذكورة أعلاه. فهي تعمل كطبقة حوكمة تكاليف مركزية لجميع استخدامات الذكاء الاصطناعي. وفقًا لـ Gartner، يمكن لبوابات الذكاء الاصطناعي التخفيف من خطر "تصاعد تكاليف الذكاء الاصطناعي بسبب سوء الحوكمة" من خلال العمل كنقطة تحكم بين مستهلكي الذكاء الاصطناعي والمزودين. وتدمج AI Gateway من TrueFoundry، كمثال، العديد من الميزات لمراقبة التكلفة وتحسينها. دعنا نتعمق في كيفية مساعدة AI gateway في إدارة وتخفيض تكاليف LLM:
رؤية التكلفة الموحدة: تمر جميع الطلبات عبر البوابة، والتي تسجل مقاييس استخدام تفصيلية لكل مكالمة – النموذج المستخدم، الرموز المستهلكة، زمن الانتقال، إسناد المستخدم/الفريق، إلخ. ويقدم هذا رؤية دقيقة وفي الوقت الفعلي لأين تذهب أموال الرموز الخاصة بك. ويمكن للقادة أخيرًا الإجابة على "أي التطبيقات أو حالات الاستخدام تدفع معظم فاتورة OpenAI الخاصة بنا؟" بدقة. وهذه الرؤية عبر التطبيقات شبه مستحيلة عندما تطلب الفرق النماذج مباشرة. ومع وجود البوابة، تحصل على لوحة تحكم تمثل مصدرًا واحدًا للحقيقة لاستخدام الذكاء الاصطناعي والإنفاق. وتمكّن هذه الشفافية محاسبة رد التكاليف/إظهار التكاليف (تخصيص التكاليف للأقسام)، والتي بدورها تعزز المساءلة.
فرض الميزانية والضوابط: لا تكفي الرؤية بمفردها – حيث تفرض البوابة أيضًا سياسات لمنع الاستخدام الجامح. ويمكنك تحديد حدود المعدل والحصص (quotas) (على سبيل المثال، لا يزيد عن N من الرموز أو إنفاق X دولار في اليوم لمستخدم أو ميزة معينة) وسترفض البوابة أو تبطئ الطلبات التي تتجاوز ذلك. وهذا يضمن عدم قيام نص برمجي واحد يسيء التصرف أو ارتفاع مفاجئ غير متوقع في الاستخدام بتدمير الميزانية. ويمكنك أيضًا إعداد تنبيهات الميزانية أو قواعد الإيقاف التلقائي: إذا تجاوز الاستخدام الشهري للفريق الحد الأقصى، يمكن للبوابة إرسال إشعارات أو قطع المكالمات الإضافية مؤقتًا حتى تتم الموافقة عليها، مما يمنع الفواتير المفاجئة. بالإضافة إلى ذلك، تسمح البوابات بـ التحكم في الوصول وقيود النماذج – على سبيل المثال، قد تسمح فقط للنماذج المكلفة مثل GPT-4 بالاستخدام من قبل مسارات عمل حرجة معينة، بينما تقتصر الاستخدامات الأقل أهمية على النماذج الأرخص. وشكل آخر من أشكال الضوابط هو تصفية المطالبات: حظر المطالبات التي قد تؤدي إلى مخرجات طويلة للغاية أو طلبات غير فعالة من حيث التكلفة. ومن خلال تطبيق قواعد الحوكمة هذه مركزيًا، تنشئ المؤسسات حدودًا صارمة للتعرض للتكاليف.
المقاييس الرئيسية لتقييم البوابة
المعيار
ما الذي يجب تقييمه؟
الأولوية
TrueFoundry
زمن الانتقال (Latency)
هل يضيف نفقات إضافية <10ms p95 لوقت الرمز الأول؟
ضروري جدًا (Must Have)
✅ مدعوم
إقامة البيانات (Data Residency)
هل يحتفظ بالسجلات داخل منطقتك (الاتحاد الأوروبي/الولايات المتحدة)؟
يعتمد على حالة الاستخدام
✅ مدعوم
التوجيه القائم على زمن الانتقال
هل يعيد التوجيه تلقائيًا بناءً على زمن الانتقال/الإنهاء في الوقت الفعلي؟
ضروري جدًا (Must Have)
✅ مدعوم
تدوير وإلغاء المفاتيح
هل يدوّر أو يلغي المفاتيح دون توقف الخدمة؟
ضروري جدًا (Must Have)
✅ مدعوم
تدوير وإلغاء المفاتيح
هل يدوّر أو يلغي المفاتيح دون توقف الخدمة؟
ضروري جدًا (Must Have)
✅ مدعوم
تدوير وإلغاء المفاتيح
هل يدوّر أو يلغي المفاتيح دون توقف الخدمة؟
ضروري جدًا (Must Have)
✅ مدعوم
تدوير وإلغاء المفاتيح
هل يدوّر أو يلغي المفاتيح دون توقف الخدمة؟
ضروري جدًا (Must Have)
✅ مدعوم
تدوير وإلغاء المفاتيح
هل يدوّر أو يلغي المفاتيح دون توقف الخدمة؟
ضروري جدًا (Must Have)
✅ مدعوم
هل تقيم AI Gateway؟
دليل عملي يستخدمه فرق المنصات والبنية التحتية
التوجيه الذكي للنماذج: قد يكون الموفر الأكبر للتكلفة هو قدرة البوابة على توجيه كل طلب ديناميكيًا إلى النموذج أو المزود الأمثل بناءً على السياق. وبدلاً من حل واحد يناسب الجميع، يمكن للبوابة تقييم عوامل مثل تعقيد الاستعلام، والدقة المطلوبة، وزمن الانتقال، والتكلفة، ثم اختيار (أو حتى التبديل التلقائي) النموذج الذي يلبي الاحتياجات بأقل تكلفة. على سبيل المثال، يمكن إجابة سؤال حقيقي بسيط بواسطة نموذج أصغر وأرخص دون فرق ملحوظ في الجودة، بينما يرسل المهام المعقدة إلى نموذج أكثر قوة. هذا النوع من اختيار النموذج في الوقت الفعلي يقلل التكاليف عن طريق تجنب المبالغة. وتطبق AI Gateway من TrueFoundry ذلك عبر قواعد توجيه ذكية وموازنة الحمل: قد تقوم بتكوينها بحيث تذهب الاستعلامات افتراضيًا إلى نموذج مفتوح المصدر مثل Mistral للسرعة والتكلفة المنخفضة، ولكن إذا بدت المطالبة معقدة أو كان ثقة النموذج الأصغر منخفضة، توجه البوابة هذا الطلب إلى نموذج أكبر مثل GPT-4. وعلى مدار مئات الآلاف من الطلبات، يمكن لهذا التوجيه التكيفي أن يحقق توفيرًا هائلاً مع الحفاظ على الجودة الإجمالية. فهو يتغلب على المفاضلة الزائفة لاختيار إما نموذج عالي الأداء أو نموذج منخفض التكلفة – يمكنك الحصول على كلاهما باستخدام كل منهما حيث يكون ذلك منطقيًا.
التخزين المؤقت للاستجابات (Response Caching): وسيلة أخرى لتحسين التكلفة هي التخزين المؤقت للاستجابات المكررة أو الشائعة للذكاء الاصطناعي. إذا سأل مستخدمون متعددون نفس السؤال أو قام نظامك بإجراء استعلامات متطابقة بشكل مكرر، يمكن لـ AI gateway إرجاع إجابة مخزنة مؤقتًا بدلاً من طلب النموذج مرة أخرى، مما يوفر تلك الرموز بالكامل. وحتى التخزين المؤقت للنتائج الجزئية (مثل الخطوات المتوسطة المكلفة) يمكن أن يساعد. وهذا مفيد بشكل خاص لمهام الخلفية أو التطبيقات التي تستخدم فيها نفس المطالبة بشكل متكرر. ولا يقلل التخزين المؤقت التكلفة فحسب، بل يحسن أيضًا زمن الانتقال لتلك الاستعلامات. تدعم بوابة TrueFoundry كلاً من التخزين المؤقت البسيط والتخزين المؤقت الدلالي (semantic caching) الأحدث – حيث يمكن التعامل مع المطالبات المتشابهة دلاليًا على أنها إصابات تخزين مؤقت. (يجب استخدام التخزين المؤقت الدلالي بحذر، حيث قد تغير الاختلافات الدقيقة في المطالبات الإجابة، ولكن في السيناريوهات المناسبة يمكن أن يرفع معدلات التخزين المؤقت ويخفض التكلفة.) وأظهرت الدراسات أن آليات التخزين المؤقت الدلالي يمكن أن تخفض تكاليف LLM API بنسبة تصل إلى 70% في حالات استخدام المؤسسات. ومن الناحية العملية، حتى التخزين المؤقت الأبسط للطلبات المتطابقة يوفر وسادة تكلفة كبيرة للتطبيقات ذات الحجم الكبيرة.
القابلية للملاحظة واكتشاف الشذوذ: نظرًا لأن البوابة تراقب جميع الطلبات، فيمكنها أيضًا اكتشاف أنماط الاستخدام الشاذة التي قد تشير إلى خطأ برمجي أو إساءة استخدام. على سبيل المثال، إذا أظهرت هذه الساعة 5 أضعاف استخدام الرموز مقارنة بالساعة السابقة، أو بدأ أحد التطبيقات فجأة في إرسال مطالبات كبيرة بكثافة إلى النموذج، فستظهر البوابة (ولوحات التحكم المدمجة بها) هذا الشذوذ. ويكفل الاكتشاف المبكر إمكانية التدخل قبل أن يستنزف الميزانية. وتصب القابلية للملاحظة أيضًا في الموثوقية: فهي تتتبع معدلات الأخطاء وأزمنة الانتقال، مما يساعد في التمييز بين التباطؤ المرتبط بالتكلفة ومشاكل النموذج. وتتكامل بعض البوابات، مثل بوابة TrueFoundry، مع أدوات مثل OpenTelemetry بحيث يمكنك دمج مقاييس استخدام LLM مع مكدس المراقبة الإجمالي لديك. وتضمن هذه القابلية الشاملة للملاحظة الحفاظ على أهداف التكلفة والأداء. كما تنشط ردود التكاليف الداخلية – حيث إنه نظرًا لتسجيل الاستخدام مركزياً، يمكنك تحميل الفرق المسؤولية عن حصتها من فاتورة الذكاء الاصطناعي، مما يحفزها على أن تكون كفؤة.
كيف تدير وتخفض AI Gateway تكاليف LLMs، من خلال الجمع بين الرؤية الموحدة، وفرض الميزانية، والتوجيه الذكي للنماذج، والتخزين المؤقت، والقابلية للملاحظة في طبقة تحكم واحدة.
تتجمع كل هذه القدرات لفرض الانضباط في التكاليف دون رقابة دستورية مستمرة. باستخدام AI gateway، تصبح إدارة التكاليف استباقية ومؤتمتة: لديك حدود للتكلفة قائمة حتى لا تتجاوز الإنفاق، ولديك رؤى في الوقت الفعلي لتعديل أنماط الاستخدام، ولديك تحسينات مؤتمتة (التوجيه، التخزين المؤقت) للتخلص من عدم الكفاءة على الفور. وهي تحول ما يمكن أن يكون مركز تكلفة غامضًا وجامحًا إلى مرفق مدار.
تجسد AI Gateway من TrueFoundry عناصر التحكم في التكاليف هذه عمليًا. فهي توفر مدمجًا لوحات تحكم لتتبع التكاليف، وتكوين سياسات الميزانية، وقواعد توجيه متعدد النماذج، وآليات التخزين المؤقت، وكلها قابلة للتكوين من خلال واجهة سهلة الاستخدام للمؤسسات. والنتيجة هي أن الشركات يمكنها تبني المزيد من حالات استخدام الذكاء الاصطناعي دون الخوف من الفواتير غير المتوقعة. وبطبيعة الحال، يثير استخدام مثل هذه البوابة بعض الاعتبارات حول الأداء والبنية، والتي نناقشها بعد ذلك.
الموازنة بين التكلفة والدقة وزمن الانتقال والتعقيد
يجب موازنة أي استراتيجية للسيطرة الجريئة على التكاليف مع المتطلبات الفنية والتجارية الأخرى. إذ تعد المقايضات أمرًا حتميًا. وفي سياق نشر LLM، تكون الأبعاد الرئيسية للموازنة هي التكلفة، والدقة (أو جودة النتائج)، وزمن الانتقال (سرعة الاستجابة)، والتعقيد البنيوي. وتساعد AI gateway في إدارة هذه المقايضات، ولكن فهمها مهم لوضع السياسات الصحيحة:
التكلفة مقابل الدقة: تعني النماذج ذات الجودة الأعلى عادةً تكاليف أعلى، ولكن ليست كل مهمة تتطلب مستوى تفكير GPT-4. حيث يمكن لنموذج أصغر بقدرة 7B الإجابة على "ما هي عاصمة فرنسا؟" بنفس دقة النموذج الرائد، ولكن ليس سؤالاً قانونياً معقداً. والسر يكمن في استخدام ذكاء التوجيه في البوابة لتحديد ما إذا كانت الدقة المتميزة تستحق السعر. وجّه المهام اليومية إلى النماذج الأصغر، واحفظ النماذج عالية المستوى للتفكير المعقد. ومع مرور الوقت، تساعد التحليلات في صقل هذه العتبات لتحقيق التوازن بين الدقة المقبولة والتوفير الكبير في التكاليف.
التكلفة مقابل زمن الانتقال: غالبًا ما تقدم النماذج الأرخص استجابات أسرع أيضًا، خاصة عندما تستضيف محليًا. ومع ذلك، يمكن للتوجيه متعدد النماذج السطحي أن يدخل زمن انتقال إذا حاول النظام تجربة نموذج، ثم يتراجع إلى نموذج آخر. وتخفف بوابة TrueFoundry من ذلك عبر التوجيه القائم على زمن الانتقال والمراعي للحمل، مما يضمن تدفق الطلبات إلى أسرع نموذج قابل للتطبيق دون قفزات غير ضرورية. وتضيف بنيتها نفقات إضافية بضع ملي ثانية فقط (~ 3-4 ملي ثانية لكل طلب) — وهي ضئيلة مقارنة بأوقات استدلال النموذج، بحيث تكتسب الفرق الكفاءة دون المساس بتجربة المستخدم.
التكلفة مقابل التعقيد البنيوي: يضيف إضافة AI Gateway طبقة إضافية من البنية التحتية، ولكنه يوفر أيضًا الرؤية والضوابط والموثوقية التي تفتقر إليها إعدادات النموذج الفردي. بالنسبة للفرق الصغيرة أو النماذج الأولية، قد تكفي مكالمات النموذج المباشرة. ولكن مع توسع الاستخدام، يصبح التوجيه المركزي والتخزين المؤقت وحوكمة التكاليف أمورًا أساسية.
في النهاية، تعد الموازنة بين هذه العوامل ممارسة مستمرة. وتتمثل أفضل الممارسات في المراقبة المستمرة لتأثير تدابير توفير التكاليف على جودة مخرجات النموذج وتجربة المستخدم (والتي تساعد القابلية للملاحظة للبوابة فيها)، وتعديل المفاتيح (قواعد التوجيه، إعدادات التخزين المؤقت، إلخ) وفقًا لذلك. وجمال نهج AI gateway هو أنك تمتلك هذه المفاتيح لتعديلها – فأنت لست محصورًا في استخدام نموذج واحد يناسب الجميع. ويمكنك زيادة أو تقليل الإنفاق في مجالات معينة مع الحفاظ على ما يهم تطبيقك أكثر، سواء كان وقت الاستجابة أو دقة الإجابة.
أفضل الممارسات لتحسين تكلفة LLM باستخدام البوابة
للحصول على أقصى فائدة من AI gateway، يجب على المؤسسات دمج التكنولوجيا مع استراتيجيات الاستخدام السليمة. فيما يلي بعض أفضل الممارسات العملية لتحسين تكاليف LLM مع الحفاظ على الأداء:
1. تحسين المطالبات والمخرجات. قم بتقليم الرموز غير الضرورية وإبقاء المطالبات مركزة. وتستنزف التعليمات الطويلة أو المطولة الرموز بلا داعٍ. وتحافظ التنسيقات المهيكلة — مثل النقاط أو مخططات JSON — على الاستجابات موجزة ومؤكدة. وراجع واختصر المطالبات السياقية الشائعة التي تُلحق بكل مكالمة. هذا التحسين "صفر التكلفة" يخفض الإنفاق بشكل مباشر.
2. استخدام توجيه النماذج الهجين. اعتمد استراتيجية نموذج متعدد المستويات: وجّه الاستعلامات البسيطة أو منخفضة المخاطر إلى نماذج أصغر وأرخص، والمهام المعقدة إلى نماذج متميزة. وتتبع العديد من الفرق نمط 90/10 — 90% من حركة المرور إلى نماذج سريعة منخفضة التكلفة؛ و10% إلى نماذج عالية الجودة للمهام الحرجة. وتعمل بوابة TrueFoundry على أتمتة ذلك من خلال التوجيه القائم على القواعد أو التعلم الآلي، مما يضمن عدم دفع مبالغ إضافية مقابل قدرة لا تحتاج إليها.
3. تجميع المكالمات وموازاتها. عند الدفع لكل رمز أو لكل مكالمة، قلل النفقات الإضافية عن طريق تجميع مطالبات متعددة في طلب واحد. وتوفر بوابة batch inference API بتجميع المهام المرتبطة — وهو أمر مثالي للوظائف الدورية مثل تلخيص مجموعات المستندات الكبيرة. وفي بعض الحالات، يمكن إرسال طلبات متوازية إلى نماذج رخيصة ومكلفة في آن واحد، وإلغاء النموذج الأكثر تكلَفَة إذا أرجع النموذج الأول نتيجة مرضية.
4. تخزين الاستعلامات عالية التكرار في التخزين المؤقت (Cache). إعادة استخدام النتائج بدلاً من إعادة حسابها. يدعم الـ Gateway كلاً من التخزين المؤقت للمطابقة الدقيقة (exact-match) والتخزين المؤقت الدلالي (semantic caching)، حيث يمكن للموجهات (prompts) المتشابهة إعادة استخدام الاستجابات السابقة. حتى معدلات إصابة التخزين المؤقت (cache hit rates) المتواضعة يمكنها توفير إنفاق كبير على الـ tokens مع تحسين زمن الانتقال (latency) — وهو مكسب كبير لمجموعات العمل المتكررة أو الاستعلامات الشائعة.
5. ضبط النماذج أو تخصيصها (Fine-tune). للمهام المتكررة والخاصة بنطاق معين، يمكن لضبط نموذج أصغر أو دمج RAG (retrieval-augmented generation) تقصير الموجهات (prompts) وتقليل الـ tokens. تدعم منصة TrueFoundry الضبط الدقيق والشر النشر المخصص، مما يساعد الفرق على الموازنة بين الدقة والكفاءة على نطاق واسع.
6. الاستفادة من النماذج مفتوحة المصدر أو المستضافة ذاتياً. عند الأحجام الكبيرة، قد يكون استضافة النماذج مفتوحة الأوزان (open-weight) على وحدات GPU مخصصة أرخص من الدفع مقابل كل استدعاء API. يتيح الـ Gateway النشر الهجين السلس — توجيه بعض حركة المرور إلى النماذج المستضافة ذاتياً مع الحفاظ على تسجيل موحد وعناصر تحكم في السياسات. يمكن أن يحقق هذا الإعداد الهجين توفيراً كبيراً في التكاليف مع الحفاظ على المرونة.
بالإضافة إلى هذه الممارسات، احرص دائماً على
المراقبة والتكرار
. استخدم البيانات الواردة من الـ gateway لمعرفة الاستراتيجيات التي تحقق أكبر أثر (مثل معدلات إصابة التخزين المؤقت، والـ tokens الموفرة عبر التوجيه، وما إلى ذلك) واضبط الأداء بناءً على ذلك. إن تحسين التكلفة ليس إعداداً يتم لمرة واحدة ثم نسيانه، ولكن الـ gateway يمنحك الأدوات لجعلها جهداً مستمراً وقابلاً للمدارة بدلاً من مفاجأة تتطلب مكافحة الحرائق.
نهج TrueFoundry لمتابعة التكاليف والحوكمة
بينما يمثل تحسين التكلفة تحدياً عالمياً عبر عمليات نشر LLM، يحول TrueFoundry’s AI Gateway هذا التحدي إلى عملية مهيكلة وقابلة للمقياس ومستمرة. بدلاً من الاعتماد على الميزانيات اليدوية أو تقارير التكلفة المشتتة، تدمج TrueFoundry الحوكمة مباشرة في طبقة البنية التحتية — مما يضمن تسجيل كل تفاعل ذكاء اصطناعي وتسعيره وإسناده في الوقت الفعلي. تتيح هذه البنية التحتية الموحدة إمكانية هيكلة LLM cost tracking solution، مما يسمح للمؤسسات بمراقبة الإنفاق على مستوى النموذج والفريق ومجرى العمل بشفافية كاملة.
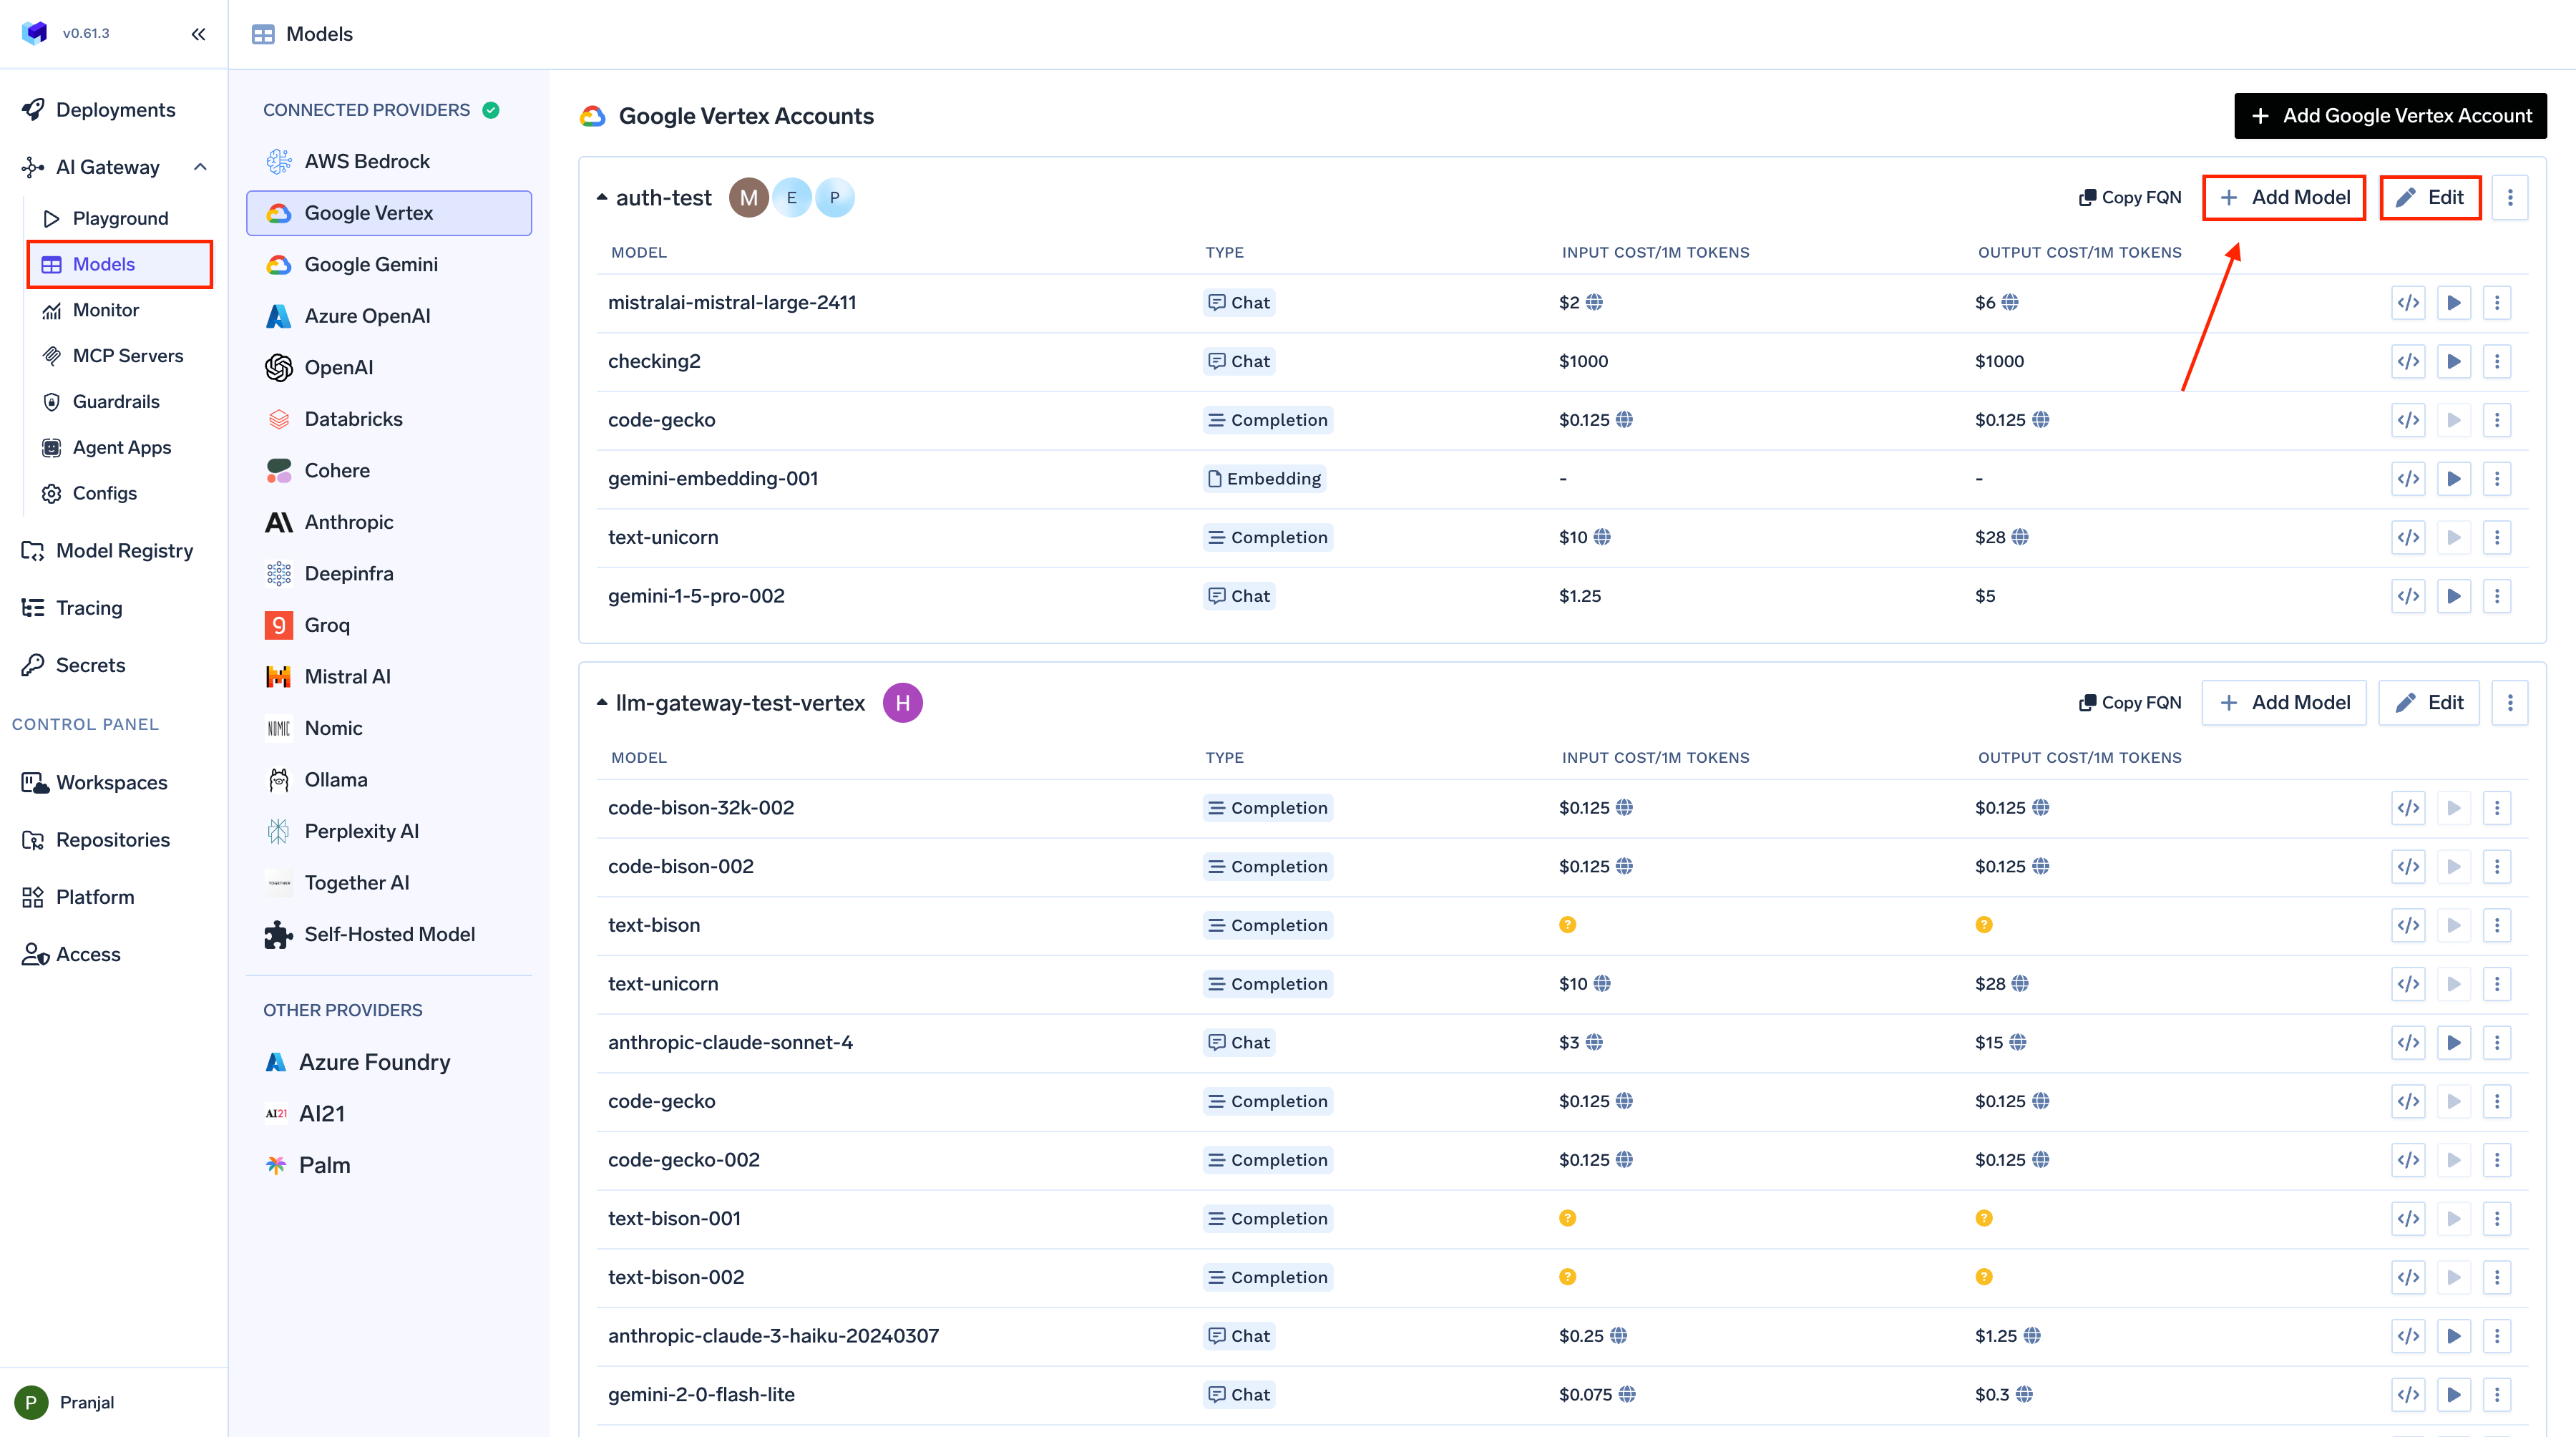
واجهة تكوين تكلفة النموذج من TrueFoundry
1. إسناد التكلفة في الوقت الفعلي
يتم وسم وتسعير كل طلب يمر عبر TrueFoundry Gateway تلقائياً. يجمع النظام بين عدد tokens الإدخال/الإخراج مع بيانات التسعير الخاصة بالنموذج، سواء من واجهات برمجة التطبيقات (APIs) العامة أو الأسعار المتفاوض عليها على مستوى المؤسسة — لحساب التكلفة الدقيقة لكل استدلال (inference). يمكن للفرق تصفية هذه المقاييس حسب النموذج، أو الفريق، أو البيئة، أو المستخدم، مما يمنح رؤية دقيقة حول من أو ما الذي يوجه الإنفاق. وهذا يسهل تخصيص التكاليف، أو تشغيل عمليات استرداد التكاليف (chargebacks) الداخلية، أو تبرير عائد الاستثمار (ROI) لميزات الذكاء الاصطناعي.
2. ميزانيات وتسعير نماذج قابلة للتكوين
تمكن TrueFoundry المؤسسات من تحديد تسعير مخصص لكل نموذج، مما يوفق بين التتبع الداخلي وعقود المزودين الفعلية أو تكاليف الحوسبة المستضافة ذاتياً. يمكن للمسؤولين أيضاً إنشاء حدود للميزانية أو حصص (quotas) لكل تطبيق أو بيئة. وعندما يتجاوز الإنفاق حداً محدداً، يمكن للـ Gateway إطلاق تنبيهات مؤتمتة أو حتى فرض تقييد مؤقت (throttling) مما يضمن احتواء التكلفة دون تدحل يدوي.
تصدر TrueFoundry بيانات التكلفة والاستخدام إلى Prometheus و OpenTelemetry، مما يندمج بسلاسة مع خطوط المراقبة الحالية. يتيح ذلك لمقاييس تكلفة الذكاء الاصطناعي، وزمن الانتقال (latency)، والموثوقية الظهور في نفس لوحات المعلومات (dashboards) المستخدمة لمراقبة البنية التحتية والتطبيقات. والنتيجة هي شاشة عرض واحدة (single pane of glass) حيث تشارك فرق الهندسة والمالية والمنتجات رؤية موحدة للأداء والإنفاق.
4. الحوكمة بالتصميم (Governance by Design)
نظراً لأن كل استدعاء يتضمن وسم البيانات الوصفية (metadata tagging) (الفريق، والمشروع، والبيئة)، يمكن للمؤسسات تنفيذ مساءلة مهيكلة عبر الأقسام. وبالاقتران مع التحكم في الوصول القائم على الأدوار (RBAC) والأذونات على مستوى النموذج، يضمن ذلك أن النماذج ذات التكلفة العالية أو المخاطر العالية لا تتاح إلا للفرق المعتمدة. تجعل هذه حواجز الحماية (guardrails) الامتثال، وانضباط الميزانية، والشفافية أمراً مؤتمتاً — وليس يدوياً.
متى قد لا يكون AI Gateway مبرراً
تقدم AI Gateways قيمة هائلة عند النطاقات الكبيرة، ولكن ليست كل مؤسسة بحاجة إلى واحد على الفور. بالنسبة للفرق الصغيرة أو المشاريع في مراحلها الأولى التي تستخدم نموذجاً واحداً وأحجام طلبات منخفضة، قد يكون نشر gateway كامل عبئاً غير ضروري. يمكن إدارة نموذج أولي يستدعي نموذج OpenAI واحد بعدد قليل من آلاف الـ tokens يومياً بسهولة باستخدام استدعاءات API المباشرة والمراقبة الأساسية.
تشير إرشادات الصناعة إلى أنه عندما يكون الاستخدام محدوداً (عشرات الآلاف من الـ tokens شهرياً) وتكون احتياجات الامتثال أو الموثوقية حد أدنى، فقد يكفي proxy خفيف الوزن أو تتبع يدوي. تظهر الميزة الحقيقية للـ gateway مع توسع أحجام العمل أو تنوعها عبر النماذج والمزودين. إذا كانت مؤسستك لا تزال تجري تجارب على LLMs أو لديها حد أدنى من البنية التحتية، فكرز على التكرار أولاً ولكن خطط مسبقاً. على سبيل المثال، يمكن لـ TrueFoundry Gateway التكيف نزولاً بكفاءة، مما يوفر رؤية وحوكمة مبكرة دون إعداد معقد. باختصار، قم بتقييم نضج الذكاء الاصطناعي ونطاقه لديك: بالنسبة لحالات الاستخدام ذات النموذج الواحد والحجم المنخفض، قد يكون الـ gateway قبل أوانه؛ ومع نمو الاعتماد، يصبح من الضروري بسرعة للتحكم في التكاليف والموثوقية والحوكمة طويلة الأمد.
الخاتمة
إن التحكم في تكاليف LLM في بيئات المؤسسات أمر معقد، ولكن AI Gateways تم بناؤها لحل ذلك بالضبط. بدلاً من ترك التكاليف للمصادفة، يقوم gateway مثل TrueFoundry’s بدمج حوكمة التكاليف مباشرة في بنية الذكاء الاصطناعي لديك. من خلال التتبع المركزي، وحواجز حماية الميزانية، والتوجيه الذكي، والتخزين المؤقت، فإنه يحول التحكم في التكلفة إلى إمكانية مدمجة بدلاً من أن يكون فكرة لاحقة.
تسجل المؤسسات التي تستخدم AI gateways تخفيضات بنسبة 40–60% في تكاليف الاستدلال (inference costs)، إلى جانب موثوقية وأمان أعلى. يقدم TrueFoundry Gateway، على وجه الخصوص، المساءلة بالتصميم — مما يمنح الفرق رؤية دقيقة، وإسناداً للتكلفة، واسترداداً للتكاليف (chargebacks) — و تقليل المخاطر عند النطاق عبر حدود مؤتمتة وآليات أمان للحماية من الفشل. كما يوفر شفافية كاملة في أنماط الاستخدام حتى لا تمر أي مشكلة تتعلق بالتكلفة أو زمن الانتقال دون ملاحظة.
من خلال توحيد السياسات عبر المناطق والفرق، يضمن الـ Gateway حوكمة وامتثالاً متسقين — وهو أمر حاسم للقطاعات التي تتعامل مع بيانات حساسة. والنتيجة: تنتقل مشاريع الذكاء الاصطناعي من التجريب إلى الإنتاج بإنفاق قابل للتنبؤ وثقة تشغيلية.
باختصار، تجعل AI Gateways اعتماد LLM أمراً مستداماً. قد يكون التسعير القائم على الـ tokens غير قابل للتنبؤ، ولكن مع لوحة التحكم المركزية من TrueFoundry، يمكن للمؤسسات تحسين الإنفاق، وفرض حواجز الحماية (guardrails)، والتوسع بمسؤولية. هذه هي الطريقة التي يتعايش بها الابتكار مع الانضباط المالي — تحويل الذكاء الاصطناعي إلى قدرة محكومة، وكفؤة، وجاهزة للمؤسسات.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.