


October 19, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.


Published: October 10, 2026
Blazingly fast way to build, track and deploy your models!
مع توسع تطبيقات الذكاء الاصطناعي، أصبح تحسين استنتاج النماذج اللغوية الكبيرة (LLM) لا يقل أهمية عن اختيار النموذج المناسب. تحتاج الفرق إلى تقليل زمن الاستجابة، وتحسين الموثوقية، وإدارة التكاليف، وتوجيه حركة البيانات بسلاسة عبر مزودين متعددين، كل ذلك مع الحفاظ على الرؤية والتحكم في كل طلب.
هنا يأتي دور بوابات الذكاء الاصطناعي. فهي تعمل كطبقة ذكية بين تطبيقاتك ومزودي النماذج اللغوية الكبيرة، حيث تعمل على تحسين الاستنتاج من خلال ميزات مثل التوجيه الذكي، وإعادة المحاولة، والتخزين المؤقت، وتحديد معدل الطلبات، والمراقبة، مما يساعد الفرق على بناء تطبيقات ذكاء اصطناعي أسرع وأكثر موثوقية.
في هذا الدليل، نقارن بين أفضل بوابات الذكاء الاصطناعي لتحسين استنتاج النماذج اللغوية الكبيرة في عام 2026، ونقيم أداءها، وقدراتها في التوجيه، وخيارات النشر، وميزات المؤسسات لمساعدتك في اختيار الحل المناسب.
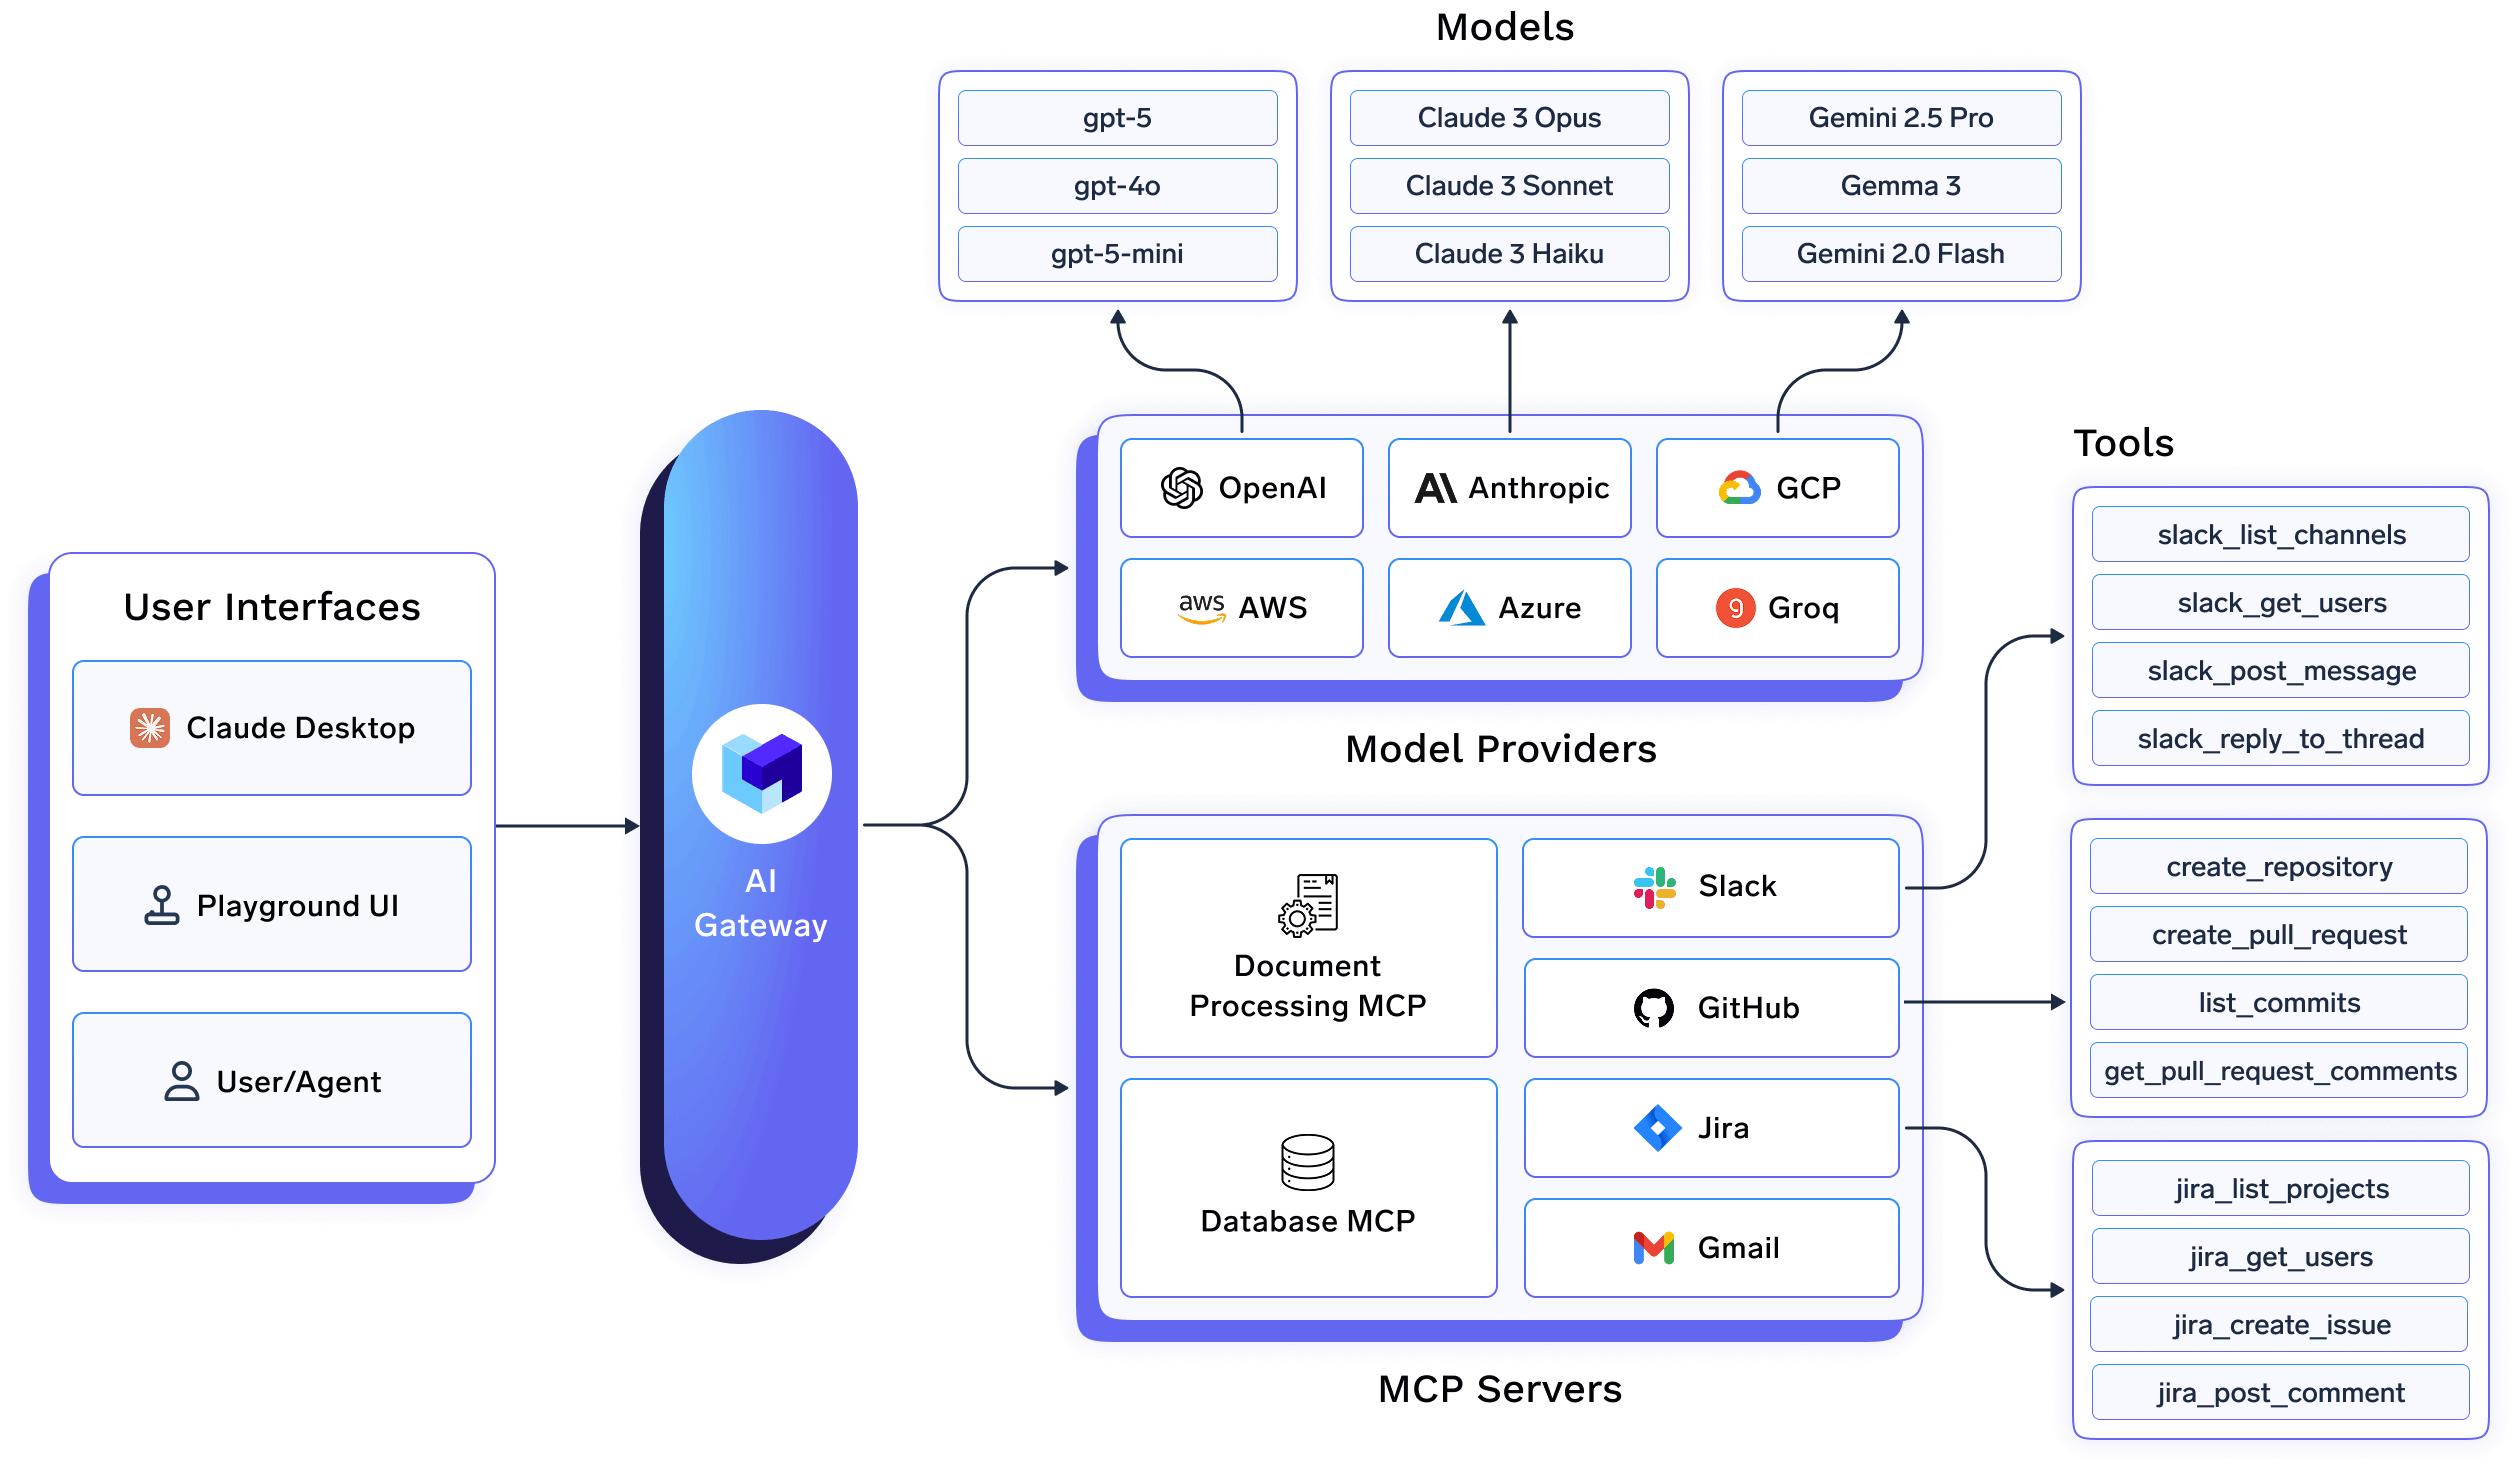
TrueFoundry بوابة الذكاء الاصطناعيطبقة الوكيل الخاصة بـ TrueFoundry التي تعمل بين تطبيقاتك ومزودي نماذج اللغة الكبيرة (وخوادم MCP)، مما يمنحك واجهة برمجة تطبيقات موحدة، بالإضافة إلى إمكانيات المراقبة والحوكمة اللازمة، بدلاً من ربط كل تطبيق بكل مزود على حدة. تدعم نسخة TrueFoundry من هذه الطبقة التخزين المؤقت على مستويين: التخزين المؤقت للمطالبات (prompt caching) (على مستوى المزود، حيث يتم تمريره إلى النموذج الأساسي) وعلى مستوى البوابة التخزين المؤقت الدلالي (semantic caching) الذي يطابق الطلبات باستخدام تشابه جيب التمام (cosine similarity) للتضمينات بدلاً من اشتراط تطابق تام، مما يسمح للمطالبات المتشابهة دلالياً بالاستفادة من التخزين المؤقت حتى عند اختلاف الصياغة. هذه الطبقة الدلالية هي ما يميز تحسين الاستدلال الحقيقي عن التخزين المؤقت البسيط للمفاتيح والقيم، وهي تلغي استدعاء النموذج تماماً بدلاً من مجرد تقليل الوقت اللازم للحصول على الرمز الأول.
فيما يتعلق بالموثوقية، موازنة الأحمال تتضمن تجاوز الفشل التلقائي: إذا فشل هدف ما لأسباب غير متعلقة ببروتوكول HTTP مثل بيانات الاعتماد غير الصحيحة أو أخطاء DNS أو TLS، تقوم البوابة بتجربة الهدف التالي بدلاً من إفشال الطلب بالكامل. تدعم قواعد التوجيه استراتيجيات تعتمد على الوزن، أو زمن الاستجابة، أو الأولوية، وهي قابلة للتهيئة من خلال ملف YAML أو واجهة المستخدم الموضحة أدناه.
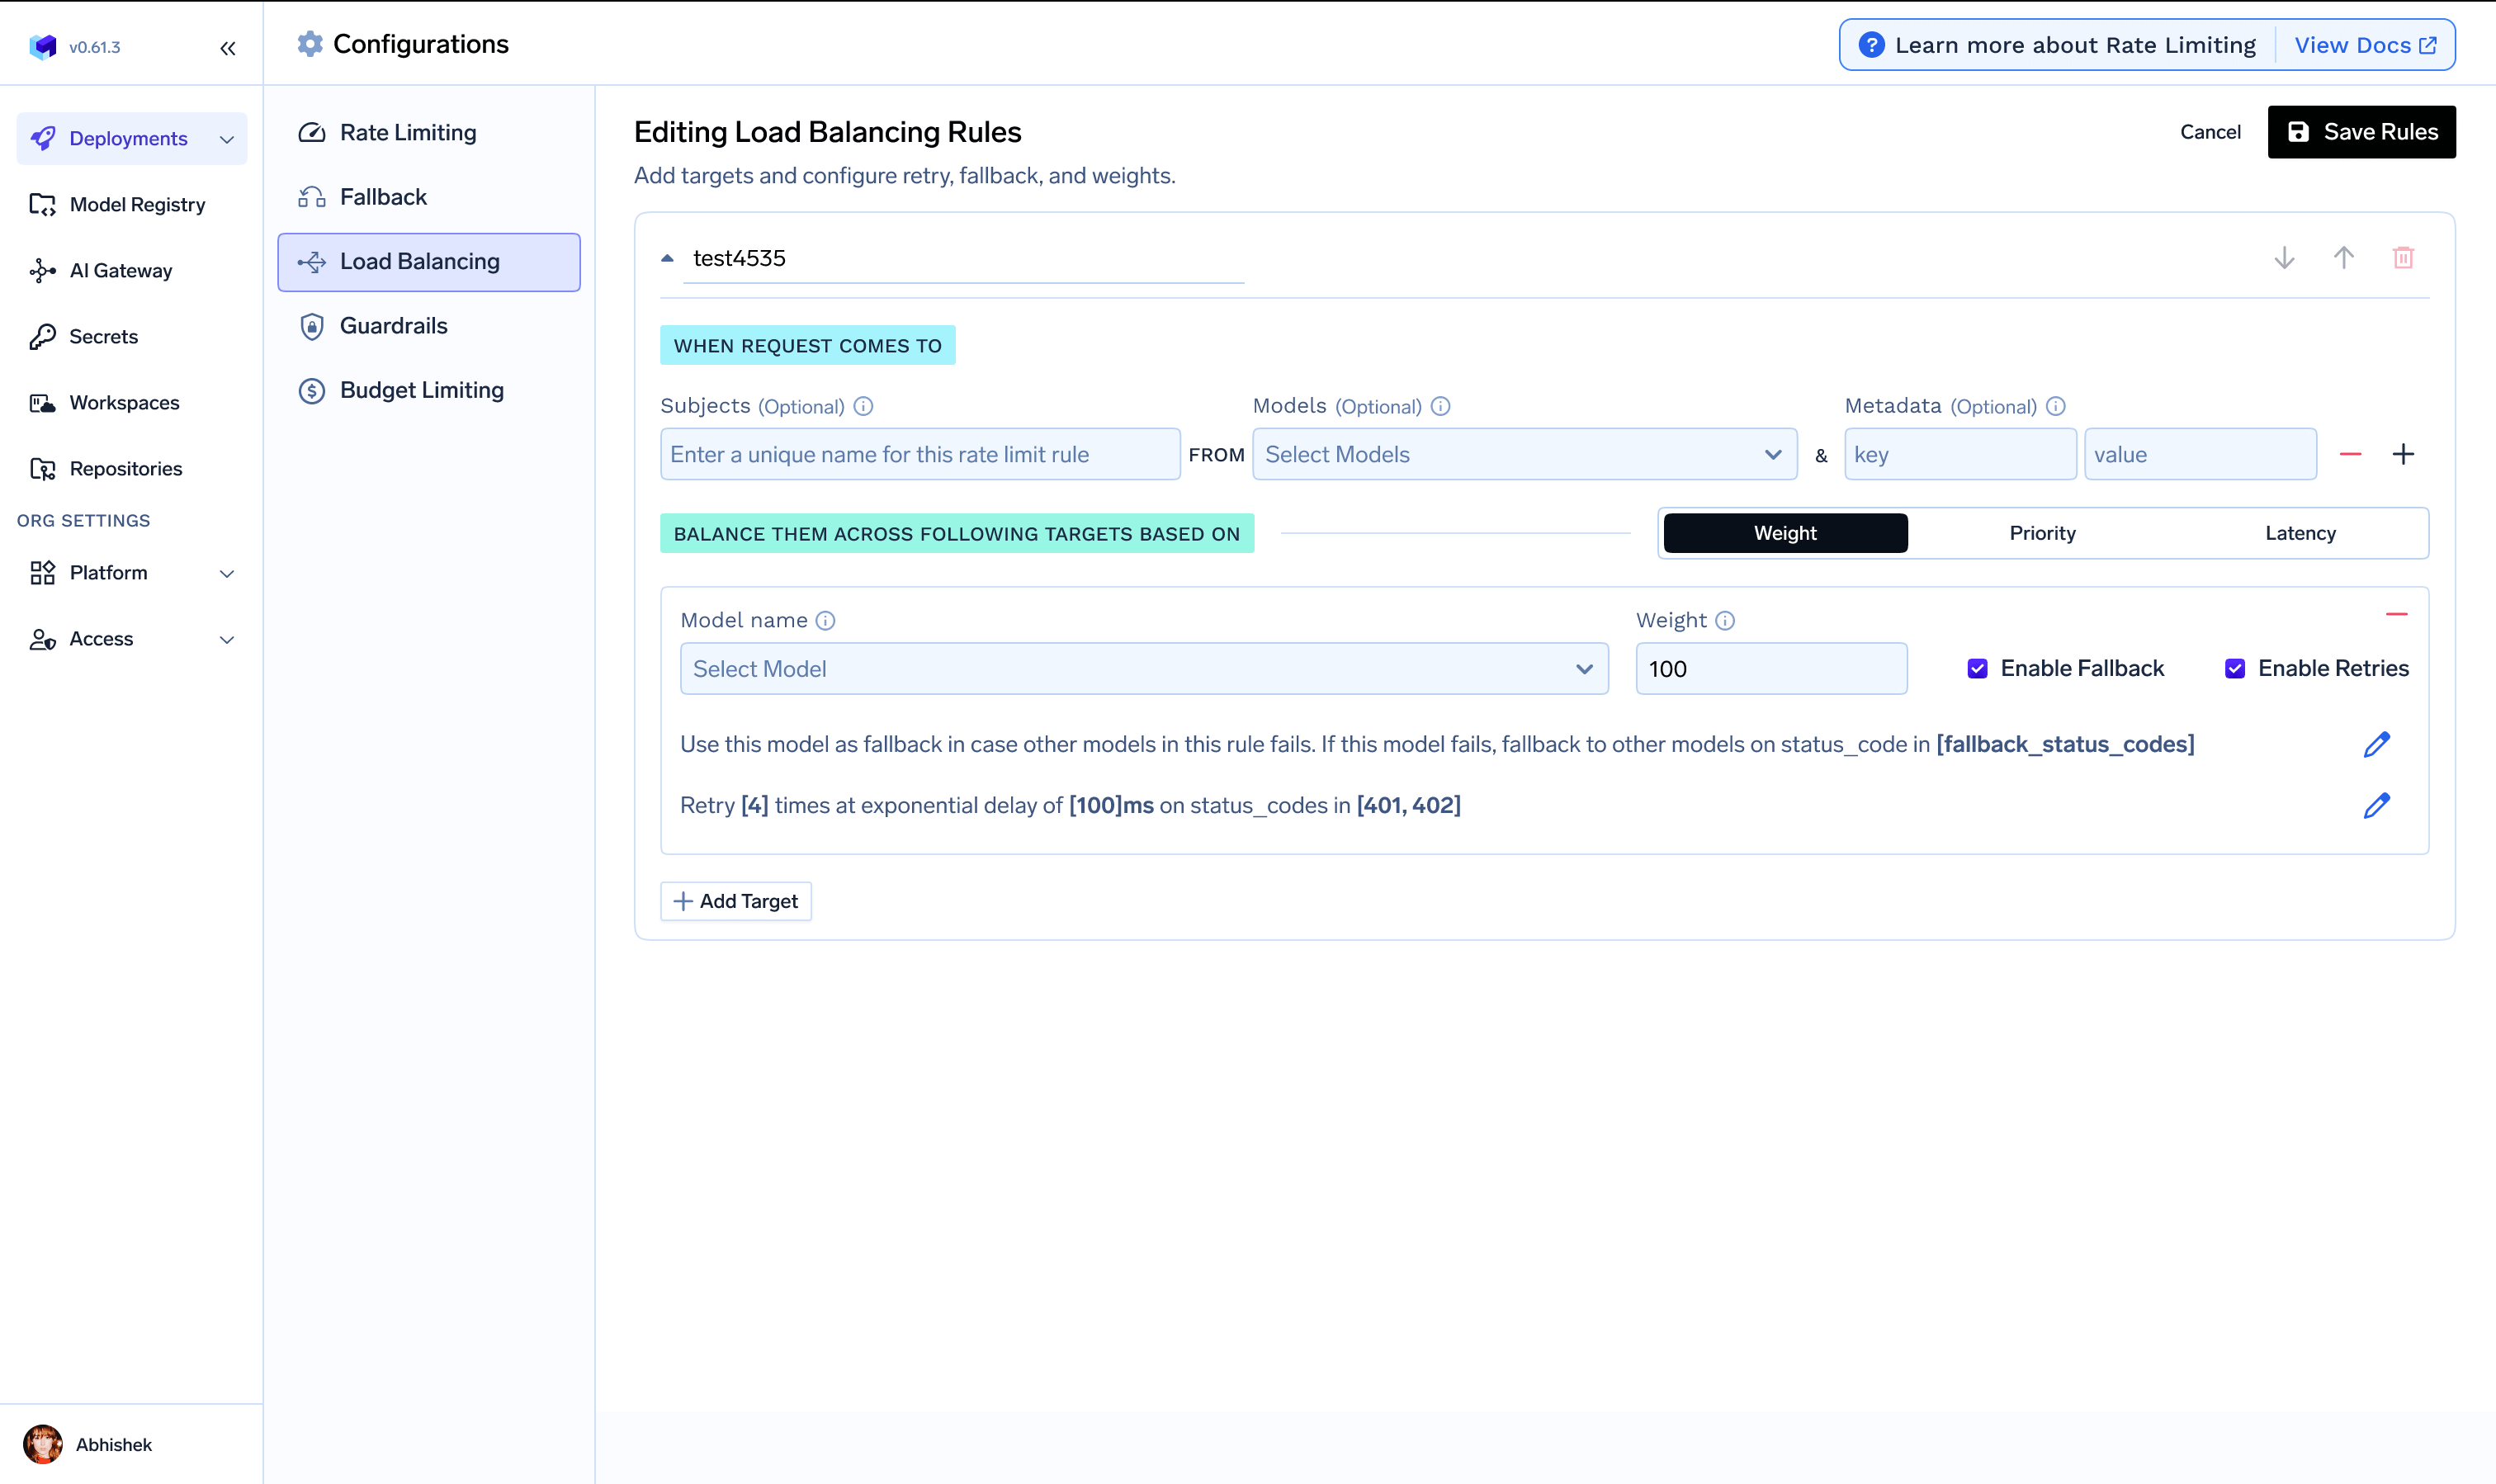
تتعامل البوابة مع أكثر من 350 طلباً في الثانية على وحدة معالجة مركزية افتراضية (vCPU) واحدة مع حمل إضافي يتراوح بين 3 إلى 4 مللي ثانية بشكل عام، كما تعالج واجهة برمجة تطبيقات الدفعات (Batch API) أحمال العمل غير المتزامنة الكبيرة بتكلفة أقل وإنتاجية أعلى من الاستدلال المتزامن. يعمل كل هذا مع أكثر من 1000 نموذج لغة كبير من خلال واجهة برمجة تطبيقات واحدة متوافقة مع OpenAI، لذا فإن التوجيه بعيداً عن مزود بطيء أو ضعيف الأداء لا يتطلب تعديل كود التطبيق.
الإيجابيات:
السلبيات: تتطلب أسعار المؤسسات الكاملة التواصل مع فريق المبيعات بدلاً من الشراء الذاتي، وهو ما يتناسب مع نموذج نشر المؤسسات ولكنه يمثل بداية أبطأ مقارنة بالتسجيل المباشر عبر بطاقة الائتمان في الخدمات المستضافة.
الأفضل لـ: الفرق التي ترغب في إدارة التخزين المؤقت، وموازنة الأحمال، ومعالجة الدفعات على مستوى البوابة مع أرقام أداء معلنة - وليس مجرد ادعاءات تسويقية - إلى جانب خدمة النماذج في نفس المنصة.
جرب بوابة الذكاء الاصطناعي من TrueFoundry →
يتولى موجه LiteLLM مهام موازنة الأحمال، وإعادة المحاولة، وفترات التهدئة، وخطط الطوارئ عبر عمليات نشر ومزودي نماذج لغوية ضخمة متعددة، حيث يتتبع أوقات الاستجابة لكل عملية نشر ويستخدم هذه البيانات لتوجيه قرارات التوجيه. وهو يدعم عمليات النشر الموزونة، مما يسمح بتوزيع حركة المرور بين المزودين مع الالتزام بحدود المعدل المكونة، بالإضافة إلى سياسات الطوارئ التي تعيد محاولة الطلب عبر مزود بديل في حال فشل المزود الأساسي. وفيما يتعلق بالتخزين المؤقت، تدعم LiteLLM التخزين المؤقت الدلالي عبر Redis أو Qdrant، حيث تقارن تضمينات المطالبات لاكتشاف الاستعلامات المتشابهة دلالياً بدلاً من الاكتفاء بالمطابقات الحرفية، مع إمكانية ضبط عتبات التشابه وفترات صلاحية البيانات (TTLs).
تتعلق المقايضات في الغالب بالجوانب التشغيلية. يتطلب التخزين المؤقت الدلالي إعداد Redis Stack بشكل خاص (مع وحدة RediSearch)، وهو ما لا توفره العديد من خدمات Redis السحابية المدارة افتراضياً، مما يضيف بنية تحتية لا تمتلكها معظم الفرق بالفعل. ونظراً لأن وكيل LiteLLM يعتمد على لغة بايثون، فقد يضيف تأخيراً ملحوظاً تحت الأحمال الثقيلة مقارنة بالبوابات المبنية بلغات ذات كفاءة أعلى؛ فعادة ما يظل التوجيه المستضاف ذاتياً في نطاق أرقام أحادية من المللي ثانية، ولكن من الجدير إجراء اختبارات تحميل قبل افتراض قدرته على الصمود عند ذروة حركة المرور لديك.
الإيجابيات: نواة مجانية ومفتوحة المصدر؛ تخزين مؤقت دلالي عبر Redis أو Qdrant؛ موجه مرن مع عمليات نشر موزونة وسياسات طوارئ؛ مجتمع كبير ونشط.
السلبيات: يتطلب التخزين المؤقت الدلالي نشر Redis Stack بشكل خاص وهو ما لا تملكه معظم الفرق؛ الوكيل المعتمد على بايثون قد يضيف تأخيراً تحت الأحمال الثقيلة؛ فريقك هو المسؤول عن تشغيل البنية التحتية بالكامل.
الأفضل لـ: الفرق التي ترغب في الحصول على تخزين مؤقت مفتوح المصدر ومرونة في التوجيه، وتتمتع بالقدرة على إعداد وتشغيل بنية Redis أو Qdrant التحتية التي يعتمد عليها التخزين المؤقت الدلالي.
تغطي البوابة الأساسية لـ Portkey أكثر من 250 نموذجاً عبر نقطة نهاية واحدة، مع تضمين التخزين المؤقت الدلالي والبسيط لتقليل التأخير والتكلفة في الاستعلامات المتكررة، إلى جانب خطط الطوارئ التلقائية، وموازنة الأحمال، وإعادة المحاولة، وقواطع الدائرة. إنه أحد الخيارات المستضافة الأكثر تكاملاً للفرق التي ترغب في ميزات التخزين المؤقت والموثوقية دون الحاجة إلى تجميعها من أدوات منفصلة.
تضيف فئة المؤسسات استضافة VPC، والتحكم في الوصول المستند إلى الأدوار (RBAC)، وتسجيل الدخول الموحد (SSO)، والامتثال لمعايير SOC2/HIPAA/GDPR، ولكن ميزات الحوكمة هذه تقع ضمن الفئة المدفوعة حصراً، وعادة ما تتراوح الأسعار في هذا المستوى من بضعة آلاف إلى أكثر من عشرة آلاف دولار شهرياً اعتماداً على حجم الاستخدام ونموذج النشر.
الإيجابيات: تخزين مؤقت دلالي وبسيط مدمج؛ تغطية واسعة للنماذج؛ خطط طوارئ تلقائية وقواطع دائرة لتعزيز الموثوقية.
السلبيات: تتطلب حوكمة المؤسسات ونشر VPC الفئة المدفوعة بدلاً من كونها جزءاً من المنتج الأساسي؛ لا يتم تضمين خدمة النماذج، لذا فهي تعمل جنباً إلى جنب مع طبقة خدمة منفصلة.
الأفضل لـ: الفرق التي ترغب في تخزين مؤقت دلالي مستضاف وميزات موثوقية عبر كتالوج واسع من النماذج، وتفضل تشغيل خدمة النماذج كمسؤولية منفصلة.
تخدم بوابة Cloudflare AI الطلبات المتطابقة مباشرة من ذاكرتها المؤقتة العالمية، وهو ما تشير التقارير إلى أنه يمكن أن يقلل التأخير بنسبة تصل إلى 90% عند العثور على البيانات في الذاكرة المؤقتة، مع خفض تكلفة الاستدعاءات المتكررة للمزود الأساسي. وتتميز خاصية تحديد المعدل بالمرونة، حيث تدعم النوافذ المنزلقة أو الثابتة المحددة حسب النموذج، أو المزود، أو البيانات الوصفية المخصصة مثل المستخدم أو الفريق، واعتباراً من مايو 2026، تتيح لك واجهة برمجة تطبيقات REST موحدة استدعاء أي نموذج عبر نقطة نهاية واحدة.
الميزات الأساسية، وتحليلات لوحة التحكم، والتخزين المؤقت، وتحديد المعدل، متاحة مجاناً بمجرد امتلاك حساب Cloudflare، وهو ما يمثل ميزة حقيقية للفرق الحساسة تجاه التكاليف. المقايضة هنا هي أن التخزين المؤقت يعتمد على المطابقة الحرفية عبر شبكة Cloudflare بدلاً من التخزين المؤقت الدلالي القائم على التضمينات الذي يكتشف المطالبات المتشابهة وليست المتطابقة تماماً، كما أن حجم السجلات في الفئة المجانية محدود بـ 100,000 سجل شهرياً قبل الحاجة إلى خطة Workers مدفوعة.
المميزات: تخزين مؤقت أساسي مجاني وتحديد لمعدل الطلبات؛ سرعة حقيقية في استجابات التخزين المؤقت على مستوى الحافة (edge)؛ إعداد بسيط بخطوة واحدة.
العيوب: التخزين المؤقت يعتمد على المطابقة الدقيقة وليس الدلالية؛ حجم السجلات محدود في الخطة المجانية؛ الارتباط بمنصة وشبكة Cloudflare.
الأفضل لـ: الفرق التي تستخدم منصة Cloudflare بالفعل وترغب في الحصول على تخزين مؤقت سريع يعتمد على المطابقة الدقيقة وتحديد لمعدل الطلبات مجانًا، دون الحاجة للتعامل مع مزود خدمة إضافي.
يعمل التخزين المؤقت للمطالبات (prompts) في Helicone بشكل مباشر عبر بوابتها المتوافقة مع OpenAI، حيث تقوم تلقائيًا بتخزين المطالبات التي تتجاوز 1,024 رمزًا (token)، مع توفير معامل prompt_cache_key للتحكم بشكل أدق. وبالنسبة لـ Anthropic تحديدًا، فهي تدعم نقاط توقف التحكم في التخزين المؤقت (حتى أربع نقاط لكل طلب) مع إمكانية التحكم في مدة البقاء (TTL)، ويتم تسجيل وتحليل كل طلب تلقائيًا دون الحاجة لإعدادات إضافية، نظرًا لأن ميزات المراقبة مدمجة افتراضيًا وليست إضافة خارجية.
تتدرج الأسعار من خطة الهواة المجانية (10,000 طلب شهريًا) وصولاً إلى خطة الفريق بسعر 799 دولارًا شهريًا التي تضيف شهادات SOC2 وHIPAA، مع توفير خطة للمؤسسات تتضمن ميزة SAML SSO والنشر المحلي (on-premises). بالنسبة للفرق التي ترغب في الحصول على التخزين المؤقت ومراقبة الطلبات في أداة واحدة دون الحاجة لإعداد مسار سجلات منفصل، فإن هذا الدمج هو الميزة الأساسية.
المميزات: تسعير بدون هوامش ربح إضافية؛ التخزين المؤقت والمراقبة مدمجان في المنتج نفسه افتراضيًا؛ عناصر تحكم متقدمة في التخزين المؤقت خاصة بمزودي الخدمة مثل Anthropic.
العيوب: شهادات الامتثال وخيارات النشر المحلي متاحة فقط في الخطط المدفوعة الأعلى؛ الخدمة غير مصممة كمنصة متكاملة لتقديم النماذج (model-serving).
الأفضل لـ: الفرق التي ترغب في الحصول على التخزين المؤقت للمطالبات ومراقبة الطلبات التلقائية معًا دون الحاجة لإعداد حزمة منفصلة للسجلات أو المراقبة.
يمكن أن يكون لاختيار بوابة الذكاء الاصطناعي المناسبة تأثير كبير على أداء وموثوقية وتكلفة تطبيقات الذكاء الاصطناعي الخاصة بك. وفي حين توفر كل الحلول طريقة للاتصال بمزودي نماذج لغوية كبيرة (LLM) متعددين، فإن أفضل البوابات تتجاوز مجرد إعادة توجيه الطلبات من خلال تحسين الاستدلال عبر التوجيه الذكي، والتخزين المؤقت، وتجاوز الفشل، والمراقبة، والحوكمة.
إذا كنت تعمل على بناء تطبيقات ذكاء اصطناعي للمؤسسات، فابحث عن بوابة لا تكتفي بتحسين زمن الاستجابة والموثوقية فحسب، بل توفر أيضاً عناصر الأمان والامتثال والتحكم التشغيلي اللازمة لتشغيل أحمال العمل الإنتاجية على نطاق واسع. تجمع بوابة TrueFoundry للذكاء الاصطناعي بين تحسين الاستدلال والحوكمة بمستوى المؤسسات، والتوجيه متعدد الموفرين، والتخزين المؤقت الدلالي، ودعم أكثر من 1000 نموذج لغوي كبير (LLM)، مما يجعلها خياراً قوياً للمؤسسات التي تتطلع إلى تحسين الأداء والكفاءة التشغيلية في آن واحد.
مع استمرار نمو أحمال عمل الذكاء الاصطناعي في عام 2026، سيساعدك الاستثمار في بوابة الذكاء الاصطناعي المناسبة على تقديم استجابات أسرع، وخفض تكاليف البنية التحتية، وبناء أنظمة ذكاء اصطناعي أكثر مرونة.
بوابة الذكاء الاصطناعي هي طبقة وسيطة تقع بين تطبيقك وموفري النماذج اللغوية الكبيرة مثل OpenAI وAnthropic وGoogle Gemini. تعمل البوابة على تحسين الاستدلال من خلال إدارة التوجيه الذكي، وإعادة المحاولة، وتجاوز الفشل، والتخزين المؤقت، وتحديد معدل الاستخدام، والمراقبة، مما يساعد في تحسين الأداء وتقليل التعقيد التشغيلي.
تعمل بوابات الذكاء الاصطناعي على تحسين الاستدلال من خلال توجيه الطلبات إلى النموذج أو الموفر الأفضل أداءً، وتخزين المطالبات المتكررة مؤقتاً، وموازنة حركة المرور عبر نقاط النهاية، وإعادة محاولة الطلبات الفاشلة تلقائياً، وتقليل وقت التوقف عن العمل من خلال تجاوز الفشل. تؤدي هذه الإمكانات إلى تقليل زمن الاستجابة وزيادة الموثوقية.
نعم. تعمل العديد من بوابات الذكاء الاصطناعي على تقليل التكاليف من خلال التخزين المؤقت الدلالي أو تخزين المطالبات، وتوجيه النماذج بناءً على السعر والأداء، وضوابط الميزانية، والتحليلات التي تحدد استخدام الرموز (Tokens) غير الضروري. يساعد هذا المؤسسات على تحسين إنفاقها على البنية التحتية وواجهات برمجة التطبيقات (APIs).
بالنسبة لعمليات النشر على مستوى المؤسسات، ابحث عن البوابات التي تجمع بين تحسين الاستدلال والحوكمة والأمان. على سبيل المثال، توفر TrueFoundry توجيهاً متعدد الموفرين، وتخزيناً مؤقتاً دلالياً، وإمكانية المراقبة، والمصادقة المؤسسية، والامتثال، ودعم أكثر من 1000 نموذج لغوي كبير، مما يجعلها مناسبة تماماً لأحمال عمل الذكاء الاصطناعي الإنتاجية.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد

















