November 6, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Blazingly fast way to build, track and deploy your models!
Quando a Moonshot AI disponibilizou o Kimi K2 em open-source, a comunidade de AI prestou atenção. Quando lançaram em seguida o Kimi K2 Thinking, um modelo capaz de raciocinar ao longo de centenas de chamadas de ferramentas com notável coerência, os profissionais começaram a levar a sério. Agora, com o Kimi K2.6, a Moonshot foi ainda mais longe: um modelo open-source no estado da arte que ocupa o topo dos benchmarks de código e de agentes de longo alcance (long-horizon), rivalizando com as melhores opções de código fechado do mundo.
Este artigo é uma análise aprofundada do que torna o K2.6 notável, o que os números de benchmark realmente significam para cargas de trabalho reais e como você pode colocá-lo em prática sem um projeto de implantação de seis semanas.
O Kimi K2.6 é o modelo multimodal de próxima geração da Moonshot AI, disponível no Hugging Face e por meio da API do Kimi. Assim como seus antecessores, ele foi construído sobre uma arquitetura Mixture-of-Experts (MoE) com uma janela de contexto de 262.144 tokens. Mas o K2.6 é mais do que uma melhoria incremental — ele representa uma mudança de design significativa em direção a três pilares que a geração anterior lidava de forma inconsistente: programação de longo alcance (long-horizon coding), design impulsionado por código e coordenação de enxames de agentes (agent swarms).
Aqui está uma rápida ilustração do que "longo alcance" significa na prática. Em uma demonstração de benchmark, o K2.6 implantou autonomamente um modelo Qwen3.5-0.8B localmente em um Mac, implementou a inferência em Zig (uma linguagem de programação de sistemas nichada) e, ao longo de mais de 4.000 chamadas de ferramentas e mais de 12 horas de execução contínua, melhorou o throughput de ~15 para ~193 tokens por segundo (cerca de 20% mais rápido que o LM Studio). Isso não é um chatbot respondendo a uma pergunta; isso é uma AI agindo como um engenheiro de performance sênior durante um projeto contínuo.
Em outra demonstração separada, o K2.6 reformulou um mecanismo de correspondência financeira open-source de 8 anos durante uma sessão de 13 horas, fazendo mais de 1.000 alterações de código direcionadas para alcançar um aumento de 185% no throughput médio e um ganho de 133% no throughput de pico — sem nenhuma orientação humana após a especificação inicial da tarefa.
Números importam, mas o contexto importa ainda mais. Veja como o K2.6 se desempenha nos benchmarks mais relevantes para sistemas de agentes em produção:
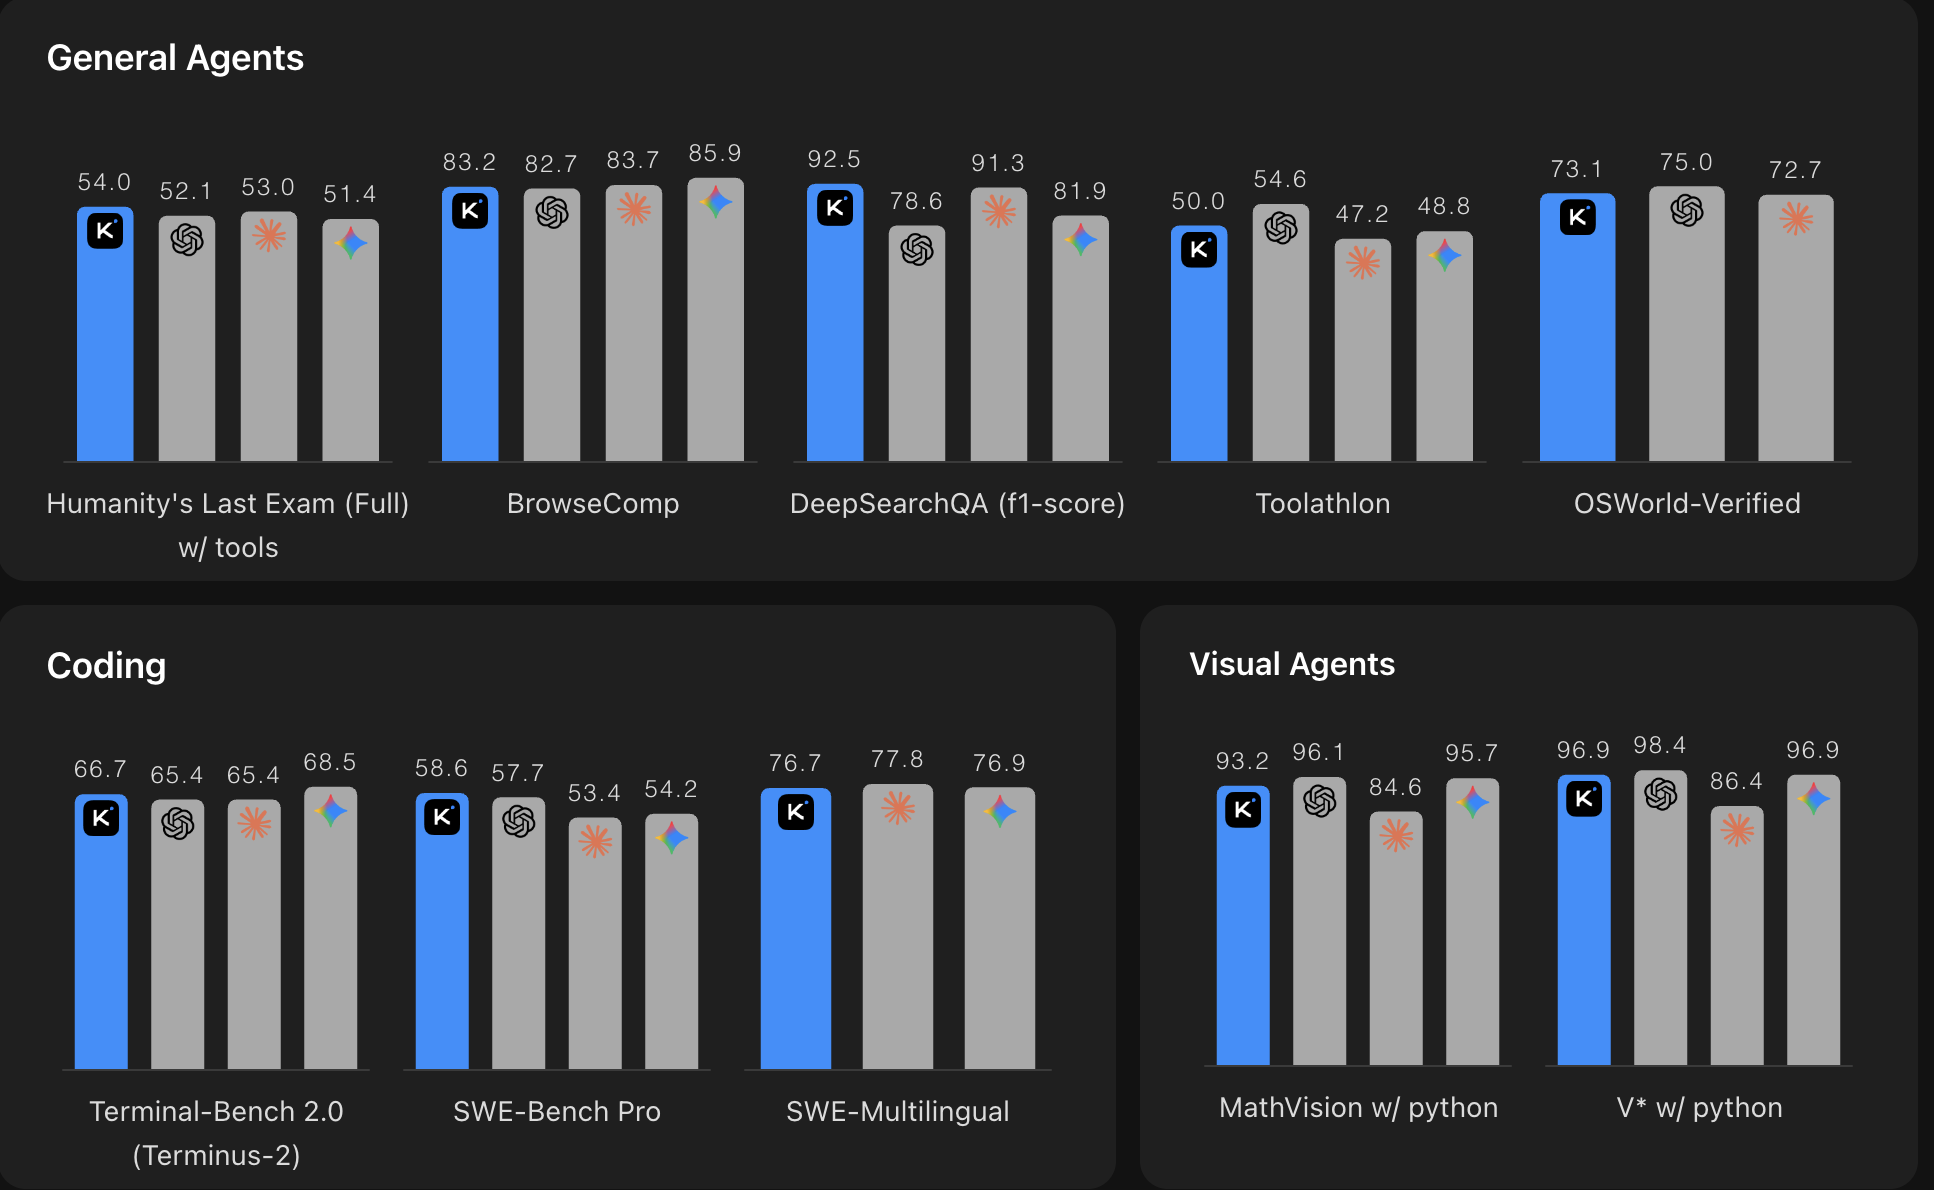
*Fonte: Comparação de benchmarks do Kimi K2.6 pela Moonshot AI. Quanto maior, melhor. O gráfico compara o Kimi K2.6 contra os principais modelos de código fechado em benchmarks de agentes gerais, programação e agentes visuais.*
O K2.6 é competitivo com os melhores modelos de código fechado, incluindo Claude Opus 4.6 e GPT-5.4, em praticamente todas as dimensões importantes para programação com agentes e tarefas de longo alcance. E ele faz isso sendo um modelo de pesos abertos a $0,74 / $3,50 por milhão de tokens de entrada/saída, o que é uma fração do custo de alternativas proprietárias comparáveis.
O salto em relação ao Kimi K2.5 também é significativo: uma melhoria de quase 80% no Toolathlon, ~8 pontos percentuais no BrowseComp e SWE-Bench Pro. Não são ganhos marginais.
Parceiros corporativos com acesso antecipado relatam resultados igualmente impressionantes: o CTO da Augmentcode destacou a "precisão cirúrgica em bases de código de grande porte" do K2.6; a Vercel observou uma melhoria de mais de 50% em seu benchmark do Next.js em comparação ao K2.5; e a CodeBuddy mediu uma melhoria de 12% na precisão de geração de código, com a taxa de sucesso de invocação de ferramentas atingindo 96,6%.
A maioria dos LLMs é adequada para geração de código pontual (one-shot). O K2.6 foi projetado para tarefas que levam horas: refatorações de múltiplos arquivos, otimizações entre diferentes linguagens, melhorias em pipelines de build e loops iterativos de depuração onde o modelo precisa ler a saída do compilador, ajustar sua hipótese e tentar novamente.
O modelo demonstra forte generalização em Python, Rust, Go e até linguagens raras como Zig, o que é notável pois sugere que o modelo internalizou conceitos de programação profundamente o suficiente para transferi-los, em vez de apenas memorizar padrões dos dados de treinamento.
O K2.6 pode transformar um único prompt em linguagem natural em um frontend completo e pronto para produção — não apenas um mockup estático, mas uma aplicação com elementos interativos, animações de scroll e autenticação integrada a banco de dados. No Kimi Design Bench interno da Moonshot, o K2.6 supera o Google AI Studio em tarefas de entrada visual, construção de landing pages, desenvolvimento de aplicações full-stack e programação criativa em geral.
Para equipes que constroem fluxos de trabalho de desenvolvimento auxiliados por AI, isso significa na prática um único modelo gerenciando toda a stack: arquitetura, lógica, interface e estrutura de implantação.
O K2.6 introduz uma grande expansão arquitetônica do sistema de enxame de agentes demonstrado inicialmente no K2.5. O enxame agora escala para 300 subagentes executando simultaneamente em 4.000 etapas coordinadas, em comparação com 100 agentes e 1.500 etapas no K2.5. Isso não é apenas uma melhoria de escala; é uma mudança qualitativa no tipo de tarefa que se torna viável.
Uma tarefa que antes exigia orquestração humana (por exemplo, "pesquisar 100 empresas de semicondutores, construir cinco estratégias quantitativas de investimento e produzir uma apresentação no estilo McKinsey") agora pode ser enviada como uma única instrução para o K2.6 e retornada como um entregável completo.
É aqui que a conversa costuma parar: uma equipe lê os números dos benchmarks, fica empolgada e passa as três semanas seguintes tentando descobrir como servir o modelo de forma confiável.
O K2.6 é um modelo MoE de grande porte. Sua janela de contexto de 262K significa que os requisitos de memória são significativos. Cargas de trabalho baseadas em agentes — por definição — geram padrões de tráfego altamente variáveis: silêncio por horas e, de repente, centenas de subagentes paralelos fazendo requisições simultaneamente. Estratégias ingênuas de implantação falham sob essa carga.
Este é o problema de infraestrutura que o TrueFoundry AI Gateway foi projetado para resolver.
Em vez de provisionar seu próprio cluster de GPUs, construir um balanceador de carga customizado e ajustar parâmetros de inferência manualmente, o TrueFoundry permite que você aponte sua aplicação para um único endpoint — e cuida do resto. O Gateway roteia requisições de forma inteligente entre provedores, gerencia a concorrência para picos de carga (como um enxame disparando 300 subagentes simultâneos) e oferece ferramentas de observabilidade — traces, histogramas de latência, uso de tokens por equipe — que, de outra forma, você teria que construir do zero.
Em nossos testes internos com o Kimi K2 Thinking, o Gateway do TrueFoundry sustentou mais de 350 RPS em um único vCPU com um overhead de apenas ~10ms. Para cargas de trabalho de agentes onde uma única tarefa iniciada pelo usuário pode se desdobrar em dezenas ou centenas de chamadas de API, essa margem faz toda a diferença.
Há também uma dimensão organizacional prática. Equipes corporativas executando o K2.6 normalmente possuem múltiplos times — ciência de dados, engenharia de produto, plataforma — todos querendo experimentar o mesmo modelo. O Gateway fornece um painel de controle único para limite de taxa (rate limiting), atribuição de custos e políticas de acesso, sem que cada equipe precise gerenciar suas próprias chaves de API.
O caminho mais rápido para executar o K2.6 em um ambiente gerenciado e pronto para produção:
1. Via TrueFoundry AI Gateway (API)
Se você já utiliza o SDK da OpenAI ou qualquer cliente compatível com a OpenAI, pode alternar para o K2.6 alterando apenas a string do modelo:
O Gateway gerencia a seleção de provedores, o roteamento de fallback e os limites de taxa de forma transparente.
2. Para cargas de trabalho com agentes
A interface de chamada de ferramentas (tool calling) do K2.6 segue o esquema padrão de function calling da OpenAI. Para tarefas de longo alcance, é recomendável:
- Configurar `max_tokens` de forma generosa (o modelo consegue fazer uso produtivo de um grande orçamento de geração)
- Habilitar streaming para receber respostas incrementais de longas cadeias de ferramentas
- Usar o painel de tracing do TrueFoundry para visualizar quais chamadas de ferramentas estão consumindo tempo e onde o contexto está sendo gasto
3. Para orquestração de enxames de agentes
Se você está construindo sistemas multiagente, o Gateway do TrueFoundry fornece metadados no nível da requisição — você pode etiquetar as requisições de cada subagente com o ID da tarefa pai e reconstruir o trace de execução completo posteriormente. Isso é fundamental para depurar o comportamento do enxame e entender onde o paralelismo está ajudando (ou prejudicando).
Equipes de engenharia criando ferramentas de programação com agentes: o K2.6 é o primeiro modelo open-source que compete seriamente com o GPT-5.4 e o Claude Opus no SWE-Bench Pro. Se você estava esperando por um modelo de pesos abertos capaz de lidar com tarefas de base de código em nível de produção, a hora é agora.
Equipes de plataforma de ML gerenciando acesso a modelos: empresas que estão avaliando o K2.6 ao lado de outros modelos de ponta se beneficiam ao rodar tudo por meio de um único gateway. A abordagem de catálogo de modelos da TrueFoundry permite realizar testes A/B do K2.6 contra o Claude ou GPT-5.4 em suas cargas de trabalho reais, acompanhando custos e latência lado a lado.
Equipes com requisitos de residência de dados: os pesos abertos do K2.6 significam que ele pode ser implantado em uma infraestrutura sob seu controle. A plataforma de implantação da TrueFoundry cuida da orquestração, oferecendo governança corporativa sobre o modelo sem que um fornecedor proprietário fique no caminho da sua inferência.
Qualquer pessoa cansada de pagar preços de modelos de código fechado: a $0,74 / $3,50 por milhão de tokens e um desempenho em benchmarks que iguala ou supera alternativas proprietárias na maioria das tarefas de agentes, o argumento de custo-benefício do K2.6 é difícil de ignorar.
O Kimi K2.6 é um modelo de fronteira autêntico. Não apenas "bom para um open-source" — mas genuinamente competitivo com os melhores modelos do mundo nos benchmarks que realmente importam para o trabalho diário de engenharia. Sua confiabilidade em tarefas de longo alcance, arquitetura de enxame de agentes e preço competitivo o tornam o modelo de pesos abertos mais atraente disponível atualmente para sistemas de agentes em produção.
A questão prática não é se vale a pena usar o K2.6. Vale. A questão é a rapidez e a confiabilidade com que você consegue colocá-lo em produção. O TrueFoundry AI Gateway responde a essa pergunta — para que sua equipe dedique tempo construindo soluções com o modelo, e não construindo a infraestrutura ao redor dele.
Experimente agora: Acesse o Kimi K2.6 através do [TrueFoundry AI Gateway](https://www.truefoundry.com/ai-gateway) ou [agende uma demonstração](https://www.truefoundry.com/book-demo) para ver como ele se adapta ao fluxo de trabalho da sua equipe.
*Todas as estatísticas de benchmark foram citadas do blog técnico oficial do Kimi K2.6 e verificadas por avaliações de terceiros no OpenRouter. Os números de desempenho de infraestrutura são oriundos de testes internos da TrueFoundry.*
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada