



October 21, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.


Blazingly fast way to build, track and deploy your models!
A confiabilidade de um agente é uma propriedade tanto do modelo quanto do sistema ao seu redor. Um estudo de 2026 realizado por pesquisadores da Carnegie Mellon, Yale, Amazon e outras instituições propõe o ETCLOVG — Execução, Ferramentas, Contexto, Ciclo de Vida, Observabilidade, Verificação e Governança — como uma taxonomia para esse sistema de suporte, ou harness de agente.
Os autores mapeiam mais de 170 projetos de código aberto nas sete camadas e identificam tanto áreas maduras quanto lacunas operacionais. Este post resume a taxonomia e a mapeia para o Agent Harness da TrueFoundry, separando os recursos nativos de runtime de padrões e integrações adjacentes.
Priyanka, uma chefe de plataforma, tinha um problema de confiabilidade que ela não conseguia nomear. Suas equipes operavam cinco agentes em produção e, quando um deles apresentava comportamento inadequado, as análises pós-incidente nunca chegavam a um consenso sobre o que corrigir. Um culpava o modelo e defendia uma atualização. Outro reescrevia o prompt. Um adicionava uma nova tentativa. Outro queria um sandbox. Cada correção era plausível, cada uma abordava uma camada diferente, e nenhuma delas compartilhava um vocabulário para dizer qual camada havia realmente falhado — então as reuniões ficavam em círculos. O que Priyanka precisava não era de um modelo melhor ou de uma opinião mais forte; era de um mapa: uma maneira de apontar para um agente e dizer "esta falha reside no ciclo de vida, não no modelo" ou "não temos nenhuma camada de verificação". O ETCLOVG é esse mapa, e este post é o guia através dele — primeiro a taxonomia como seus autores a construíram, depois cada camada em relação a um runtime de produção, distinguindo capacidades nativas de fluxos de trabalho e integrações adjacentes, independentemente de serem chamados por esses nomes ou não.
A principal afirmação do estudo é deflacionária em relação aos modelos e inflacionária em relação à infraestrutura: a rápida implementação de agentes de LLM revelou que a confiabilidade da execução depende menos do modelo base do que do harness que o envolve. A evidência é parcialmente histórica. A era ReAct de 2022–23 envolvia um loop de modelo único em um loop while, um template de prompt e uma pequena tabela de despacho de ferramentas; o AutoGPT e o BabyAGI expuseram então os modos de falha desse wrapper fino — execução descontrolada, estouro de contexto, perda de estado, efeitos colaterais não monitorados — como problemas de infraestrutura em vez de problemas de prompt. Os anos seguintes foram dedicados ao campo construindo lentamente a infraestrutura ausente e, apenas recentemente, dando um nome a ela.
Essa nomeação é a estrutura de três fases do estudo, que localiza a engenharia de harness com precisão. Engenharia de prompt (2022–24): a alavanca é o texto de entrada, otimizado para uma única chamada. Engenharia de contexto (2025): a questão muda para "o que o modelo deve ver em cada etapa?" — recuperação, compactação, classificação de resultados de ferramentas, saturação de janela. Engenharia de harness (2026–): à medida que os modelos se tornam capazes o suficiente para tarefas de longa duração, o foco se expande para todo o wrapper de infraestrutura. Cada fase engloba a anterior — o harness inclui o contexto, que inclui o prompt — e elas se sobrepõem em vez de se substituírem. O ETCLOVG dá a essa terceira fase os limites arquiteturais que as duas primeiras nunca precisaram.
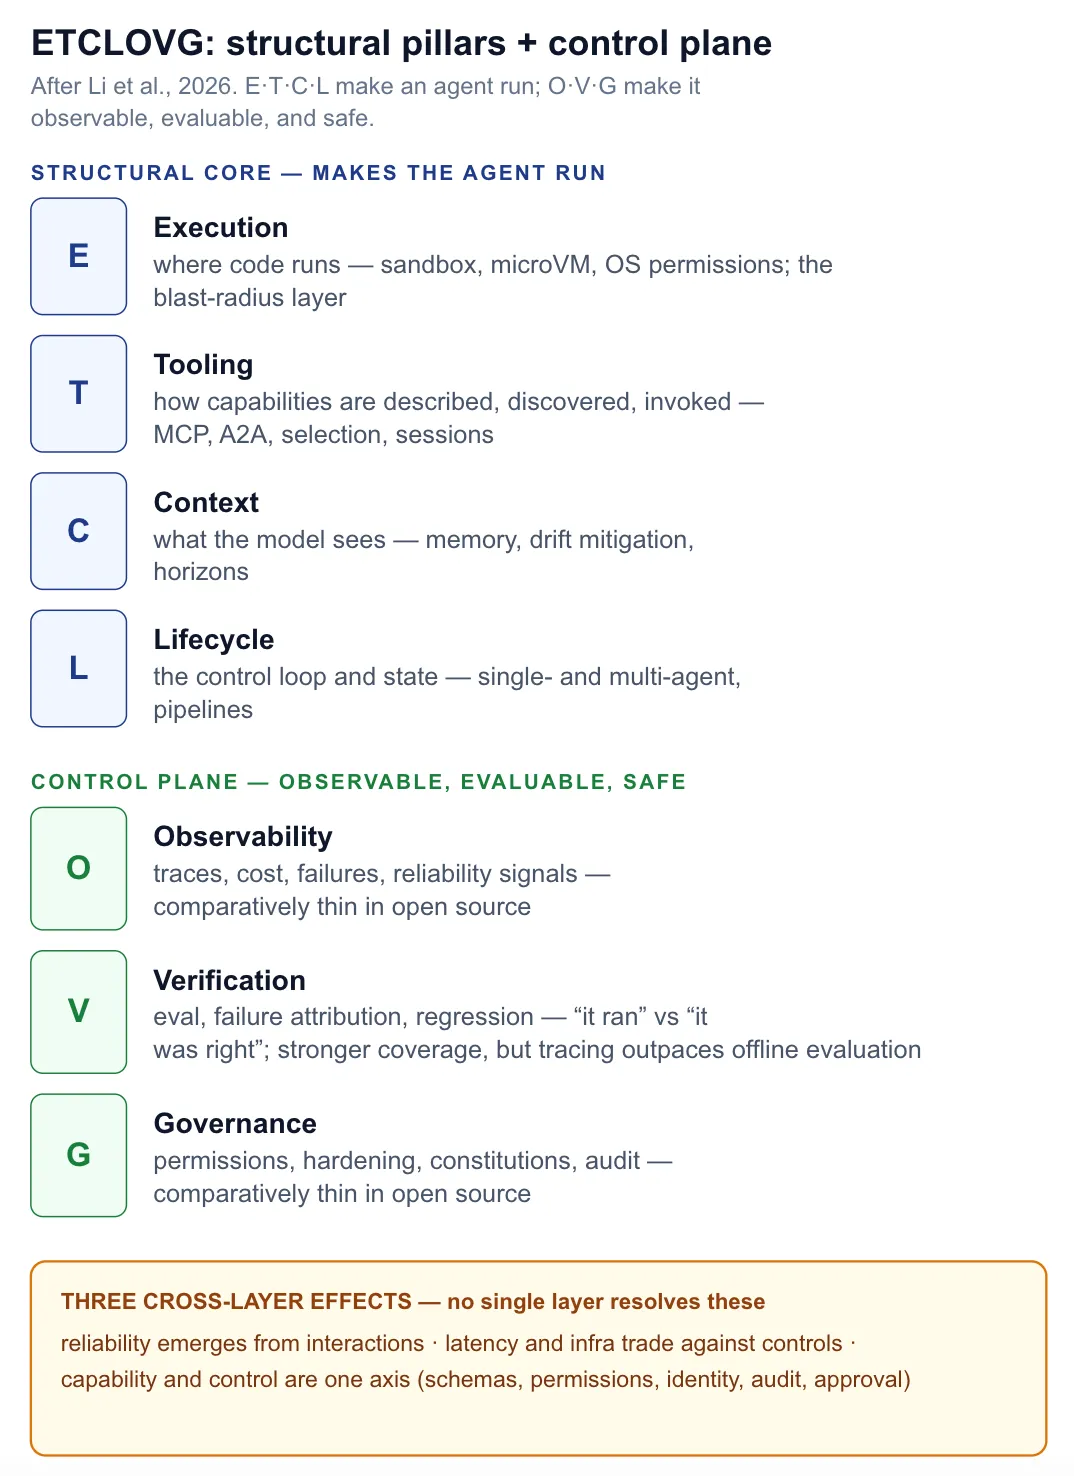
A taxonomia se divide em um núcleo estrutural e um plano de controle. E, T, C e L são os pilares estruturais — eles fazem um agente funcionar. O, V e G são o plano de controle — eles tornam um agente em execução observável, avaliável e seguro. O movimento notável do estudo é promover a Observabilidade e a Governança a camadas independentes, em vez de incorporá-las em hooks de ciclo de vida, sob o argumento de que, em produção, cada uma possui seu próprio ecossistema de ferramentas e é de responsabilidade de uma equipe diferente. Aqui estão as sete, parafraseadas a partir das definições do estudo.
E — Ambiente de execução. Onde o código e as ações do agente realmente são executados e o que os limita: sandboxes gerenciados, microVMs, runtimes especializados em código, ambientes de uso de computador e navegador, modelos de permissão em nível de sistema operacional. Esta é a camada de raio de explosão — o que um agente pode tocar quando executa um comando.
T — Interface e protocolo de ferramentas. Como as capacidades externas são descritas, descobertas e invocadas: padrões de protocolo (MCP, A2A), descrição e seleção de ferramentas, treinamento aumentado por ferramentas, gerenciamento de sessão. O modelo só conhece as ferramentas através desta camada.
C — Gerenciamento de contexto e memória. O que o modelo consegue visualizar em horizontes de curto prazo, de sessão e persistentes: técnicas de contexto de longo prazo e mitigações para o desvio de contexto. O tema da fase de engenharia anterior, agora um dos quatro pilares.
L — Ciclo de vida e orquestração. O fluxo de controle que lê e grava estados — desde o loop interno de agente único até padrões multiagente e pipelines completos de issue-to-pull-request. O loop em si reside aqui.
O — Observabilidade e operações. Rastreamentos, custos, falhas, sinais de confiabilidade — plataformas de rastreamento, ferramentas de operações específicas para agentes, controle de custos, observabilidade unificada. O mapeamento de código aberto da pesquisa revela que esta camada é comparativamente escassa em códigos públicos.
V — Verificação e avaliação. Transformar tarefas e rastreamentos em avaliação, atribuição de falhas e feedback de regressão: fundamentação de benchmarks, execução controlada, julgamento multinível, loops de avaliação em tempo de implantação. A diferença entre "executou" e "estava correto".
G — Governança e segurança. Restrições nas subcamadas de modelo, sistema e organização: modelos de permissão, hooks de ciclo de vida, endurecimento de componentes, constituições declarativas, infraestrutura de auditoria. Também escassa em código aberto, observa a pesquisa, e "mais frequentemente presente dentro de plataformas comerciais".
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada



















