



August 26, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.



Blazingly fast way to build, track and deploy your models!
يسعدنا أن نعلن أن TrueFoundry قد طورت حلاً قوياً وسهل الاستخدام لنشر ودوزنة Large Language Model (LLM) من خلال Model Catalouge. نهدف إلى مساعدة الشركات على استضافة LLMs المفتوحة المصدر الخاصة بها ذاتياً فوق Kubernetes، مما يجعل تكاليف الاستدلال لديك أرخص بـ 10 مرات بنقرة واحدة. في هذه المدونة، نوضح لك كيف يمكنك نشر نموذج Dolly-v2-3b ودوزنة نموذج Pythia-70M باستخدام TrueFoundry.تم تصميم منصة TrueFoundry لدعم نماذج Machine Learning و Deep Learning من جميع الأنواع، بدءاً من أَبسطها مثل Logistic Regression وحتى أحدث النماذج مثل Stable Diffusion. قد يتساءل المرء، لماذا نحتاج إلى بناء شيء جديد عندما يتعلق الأمر بـ Large Language Models؟
إن الحجم الهائل لهذه النماذج وتعقيدها يفرضان تحديات كبيرة عندما يتعلق الأمر بنشرها في تطبيقات العالم الحقيقي. على الرغم من أن منصة TrueFoundry كانت تدعم بالفعل نشر النماذج من جميع الأحجام على نطاق واسع، فقد أدركنا أن هناك المزيد من التحسينات (التكلفة + الوقت) وتحسينات تجربة المستخدم التي يمكننا القيام بها لهذه النماذج.
لقد أثارت Large language models (LLMs)، مثل ChatGPT، بلا شك ضجة كبيرة في مجال الذكاء الاصطناعي.
ولكن بعد التحدث إلى أكثر من 50 شركة بدأت بالفعل في إدخالها في الإنتاج، فإن القيمة التي تخلقها بالفعل هائلة. نحن نؤمن بأن استخدام LLMs سيتوسع فقط حيث يكتشف الناس حالات استخدام جديدة كل يوم.
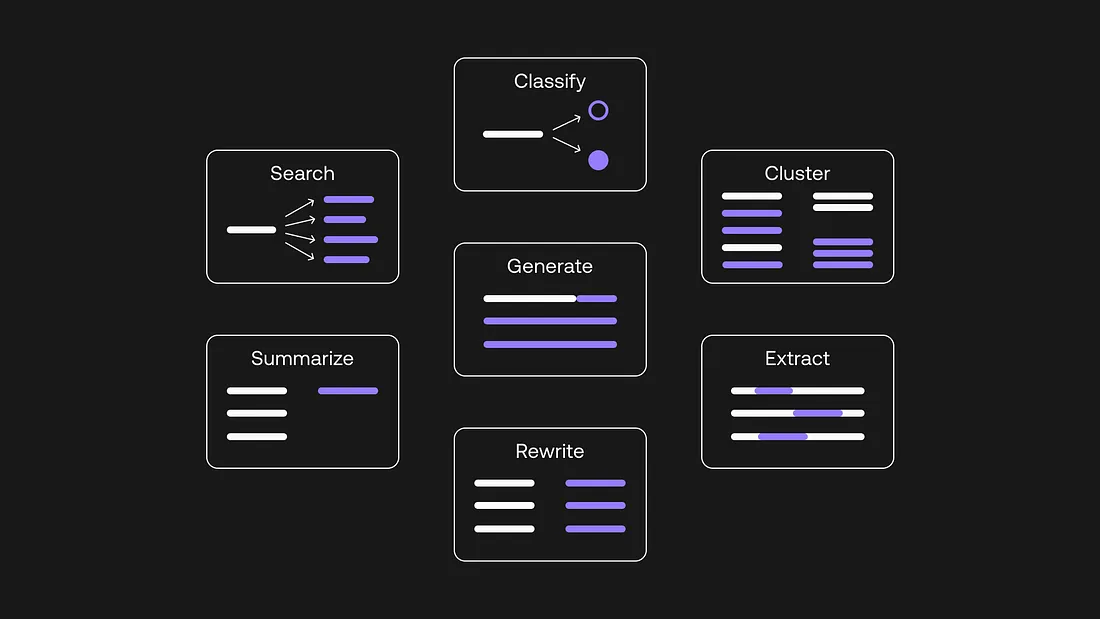
يعد إنشاء حالة استخدام لإثبات المفهوم باستخدام Large Language Models و OpenAI APIs أمراً سهلاً، ولكن عندما تبدأ في التفكير في الإنتاج 🚀، فإن العديد من الاعتبارات الأخرى تدخل في الحسبان.
بالنسبة لمعظم الشركات، فإن بناء القدرات الهندسيّة للتعامل مع البنية التحتية المعقدة لـ GPU لخدمة LLMs بشكل موثوق أمر صعب ويستغرق وقتاً طويلاً. علاوة على ذلك، ترغب معظم الشركات في الحصول على نماذج محددة تعمل بشكل أفضل في حالة الاستخدام الخاصة بها، والتي تحتاج من أجلها إلى دوزنة هذه النماذج. يمكن أن يكون هذا تحدياً تقنياً وأمراً مكلفاً في نفس الوقت.
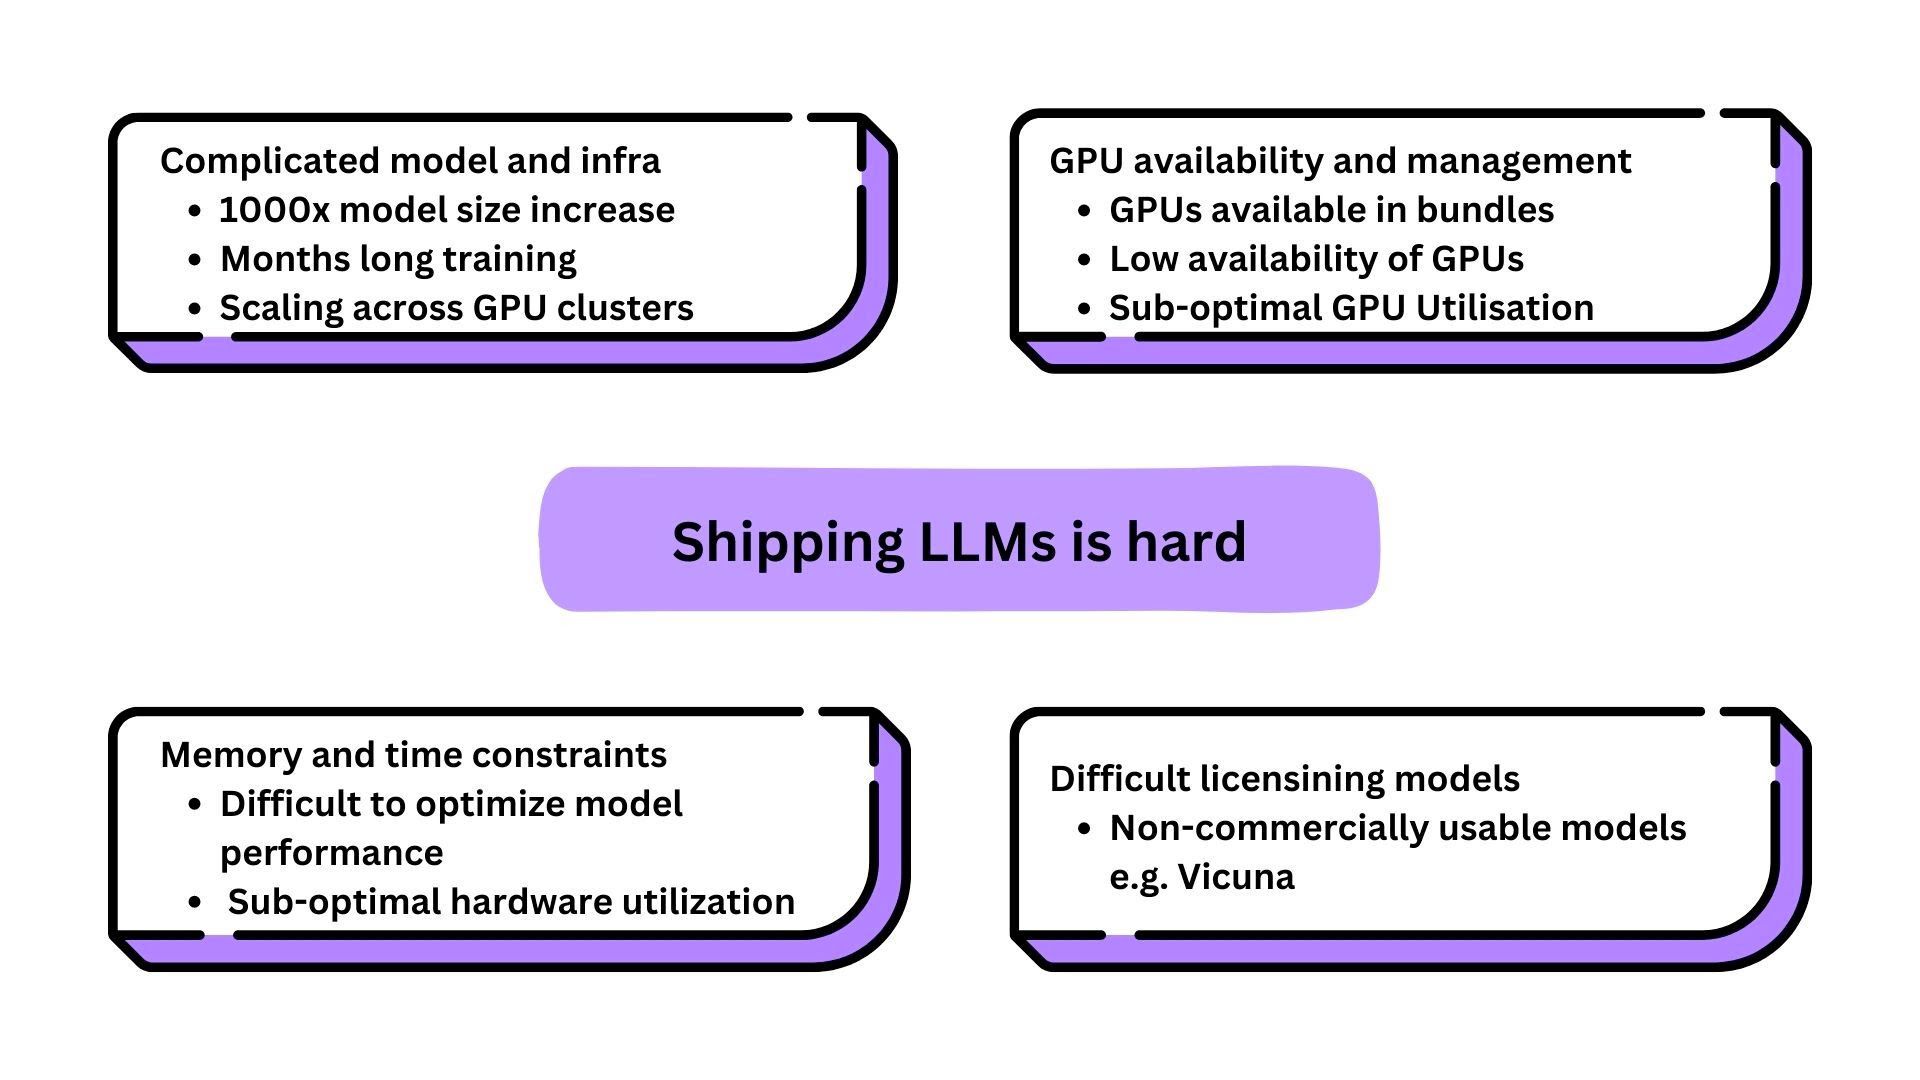
موقفنا بشأن مستقبل LLMs هو أن النماذج المفتوحة المصدر ستكون هي السبيل للمضي قدماً. اقرأ المزيد عن آرائنا حول هذا الموضوع هنا. لقد قررنا الاستفادة من مجتمع المبتكرين هذا الذي يتطور بسرعة ومساعدة الشركات على استغلال القيمة الكاملة لهذه النماذج من LLMs المفتوحة المصدر في مؤسساتهم.
تريد TrueFoundry أن يتمكن شركاؤنا من تحقيق النطاق الكامل للمزايا التي يمكن أن تحدثها LLMs المفتوحة المصدر، المدوزنة لحالة الاستخدام الخاصة بهم، في مؤسساتهم:
ومع ذلك، فإن إدارة ونشر النماذج المفتوحة المصدر على البنية التحتية الخاصة بك ليست مهمة سهلة. في حين أن نشر LLM محلياً (on-premise) يوفر تحكماً لا مثيل له في البيانات، وجاهزية للامتثال، وكفاءة تكلفة طويلة الأجل، إلا أنه يتطلب خبرة عميقة في تنسيق GPU، وإدارة Kubernetes، وتحسين النماذج.
ولكن تخيل لو كان الأمر بسهولة توصيل بياناتك وبضع نقرات فقط؟
نحن نفهم التحديات التي تواجهها الشركات عند الانتقال من إثبات مفهوم LLM إلى الإنتاج. نهدف إلى بناء الطبقة التي تجعل هذه العملية سهلة للغاية لشركائنا. إليك كيف نفعل ذلك:
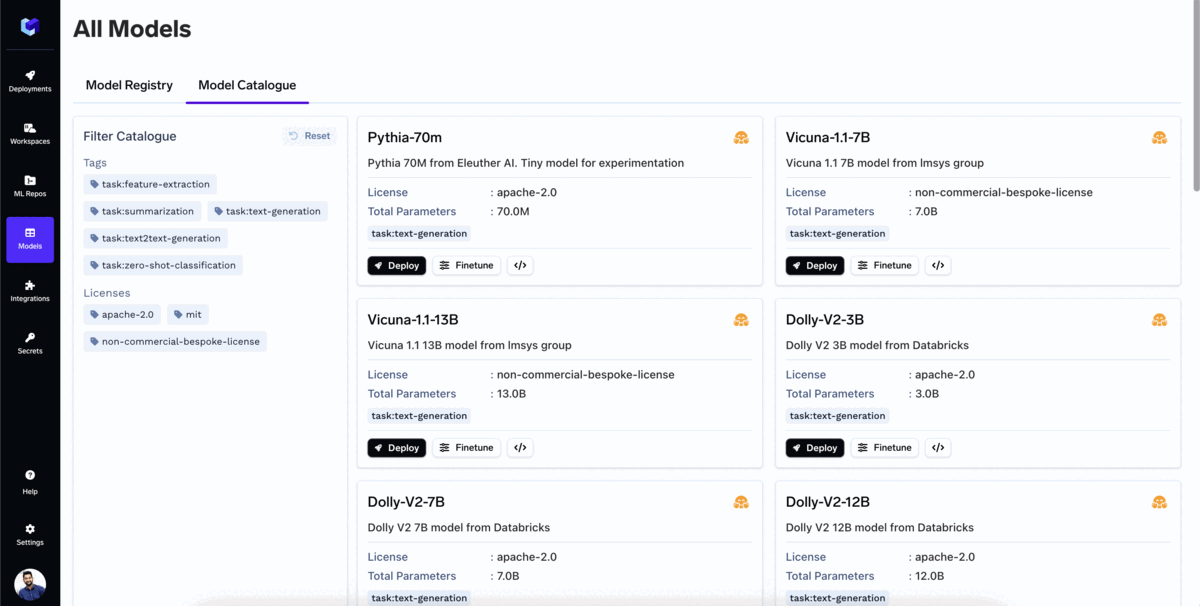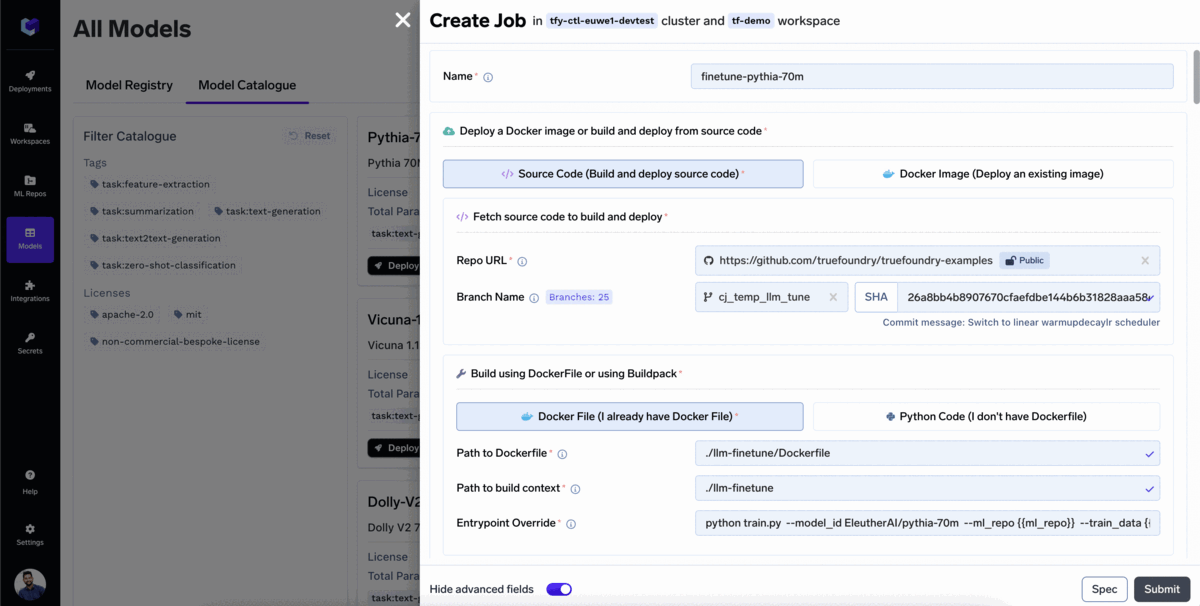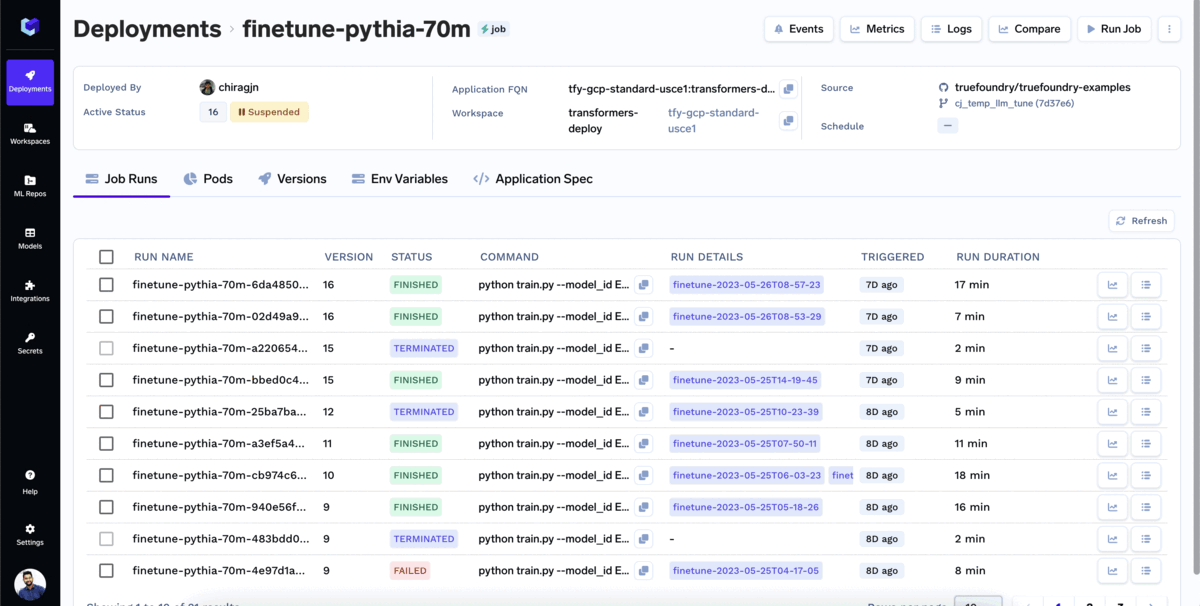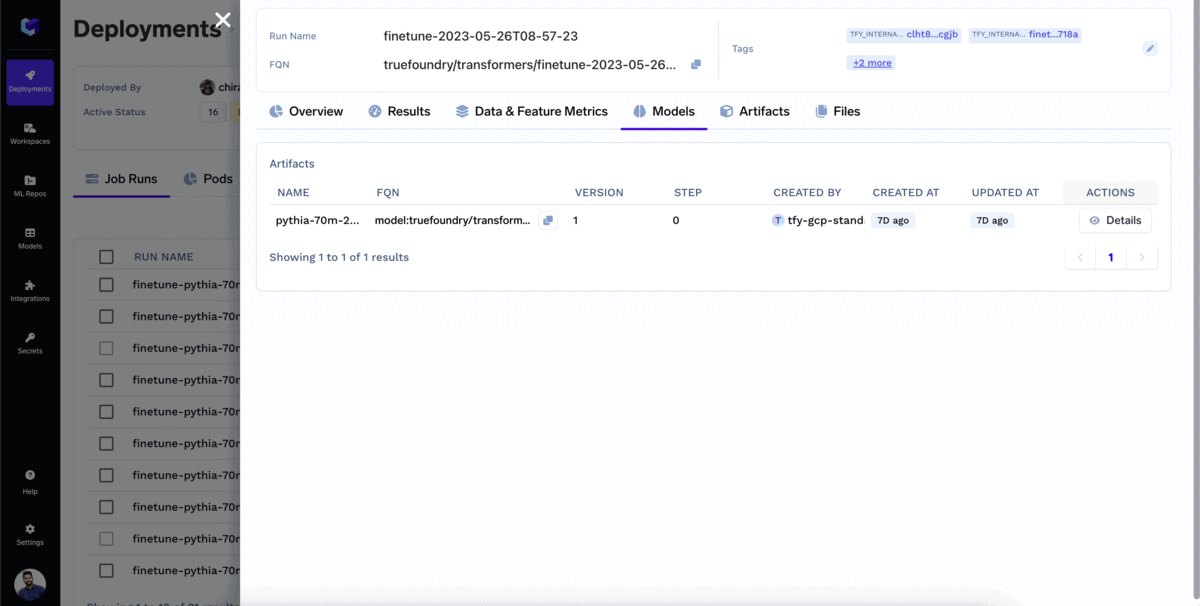
إن Model Catalogue الخاص بـ TrueFoundry هو مستودع لجميع Open Source Large Language Models (LLMs) الشائعة التي يمكن نشرها بنقرة واحدة. يمكن للمستخدم أيضاً دوزنة النموذج مباشرة من كتالوج النماذج.
يدعم الكتالوج معظم النماذج الشائعة بالفعل، ونحن نضيف الدعم للمزيد كل يوم. بعض النماذج الشائعة التي يمكنك نشرها بالفعل على السحابة الخاصة بك هي:
وغيرها الكثير.....
نحن مهووسون بتمكين الشركات من الشحن في اليوم الأول. لجعل هذا ممكناً، إليك المبادئ التي نبني عليها قدرات LLM لدينا:
ℹ️
للحصول على شرح تفصيلي لتدفقات التدريب والدوزنة على واجهة المستخدم، يرجى الرجوع إلى فيديو YouTube هذا
إن نشر LLMs الخاص بك بسهولة النقر ثلاث مرات!
🚀
تم نشر نموذجك الآن!
ابدأ الاستدلال باستخدام نقطة نهاية API الخاصة بالنموذج. توفر لك TrueFoundry واجهة OpenAPI لاختبار نموذجك والكود النموذجي واستدعاء النموذج داخل تطبيقاتك.
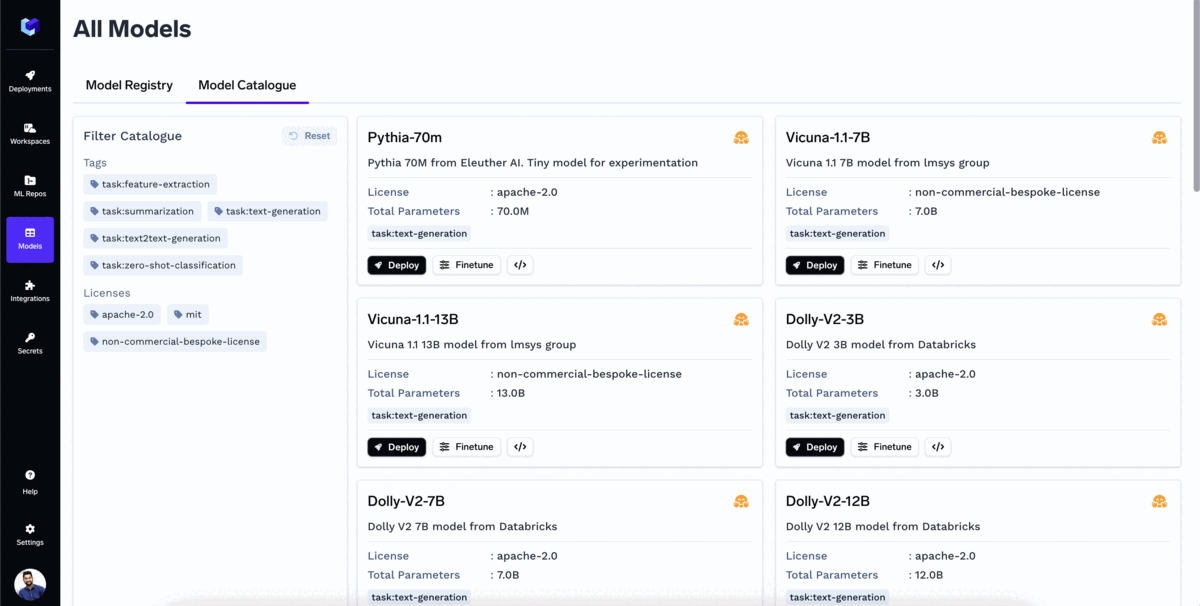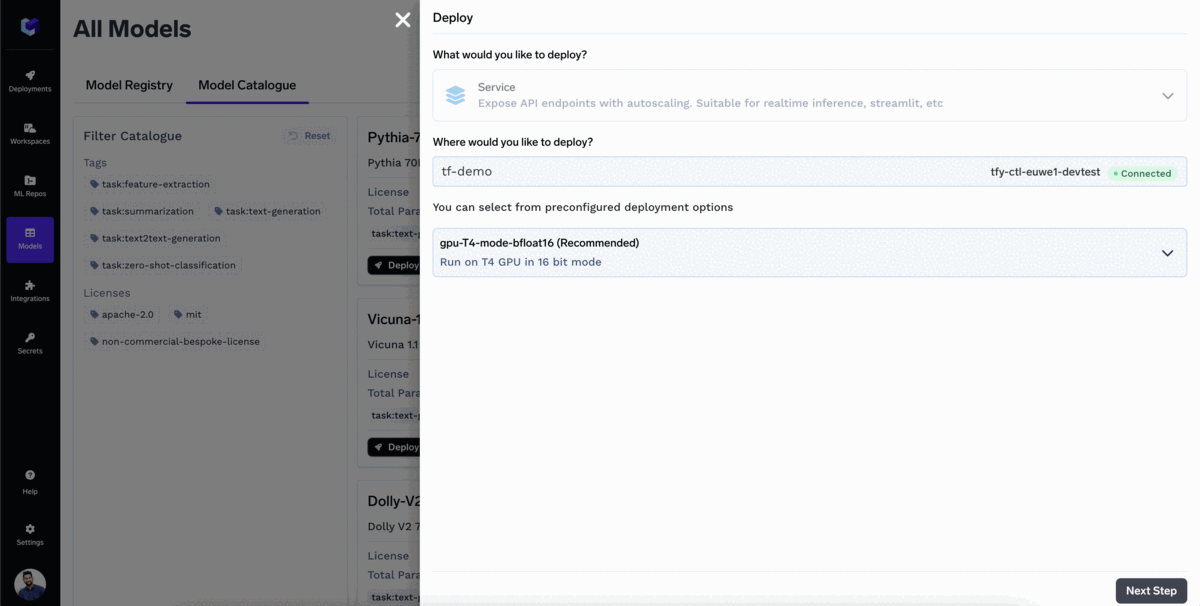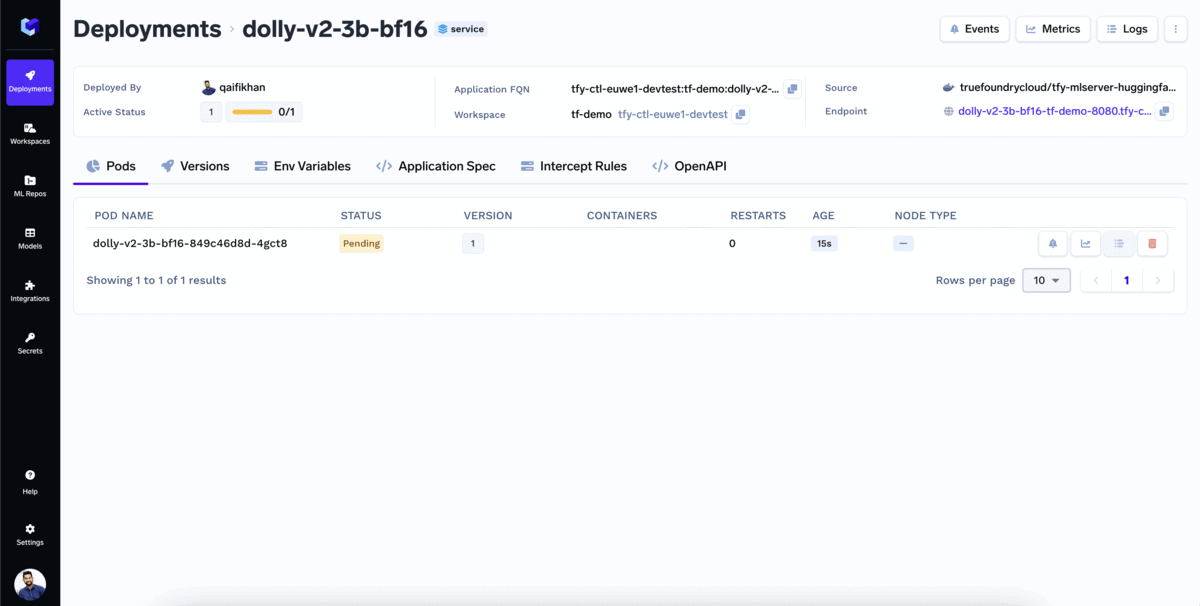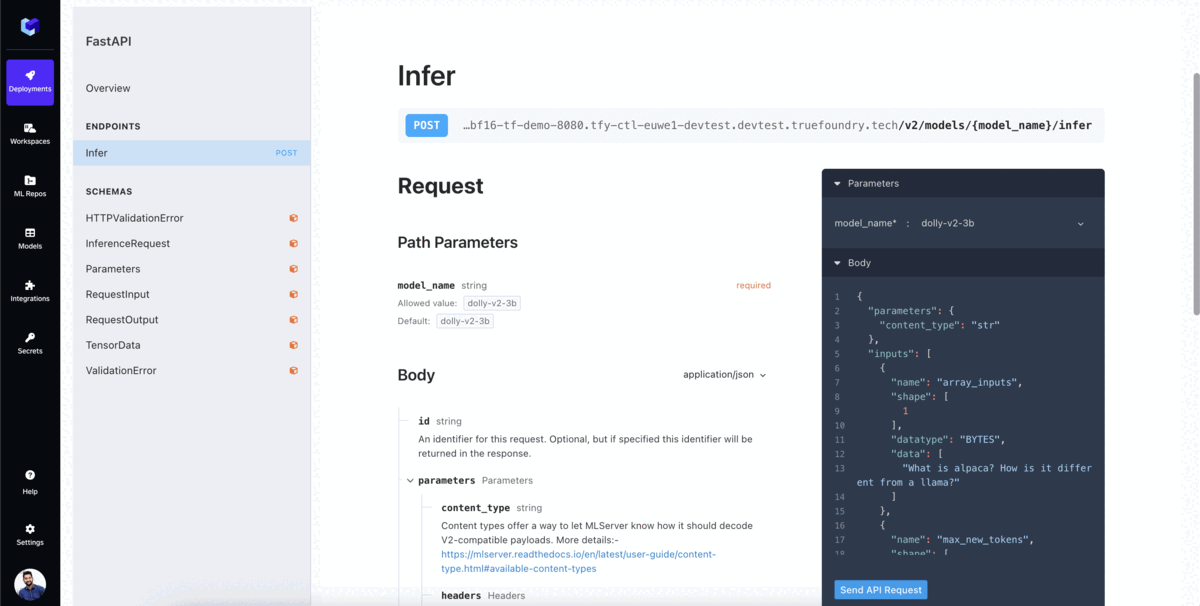
ترغب معظم الشركات في استخدام نماذج مدوزنة لحالة الاستخدام الخاصة بها. لدوزنة نموذج باستخدام TrueFoundry:
🚀
بدأ النموذج في الدوزنة!
يمكنك مراقبة الدوزنة أثناء تقدمها. في تبويب تشغيل الوظائف (job runs)، يمكنك عرض جميع المعلومات ذات الصلة المرتبطة بوظيفة التدريب، مثل مقاييس الخسارة، ومنحنيات التدريب، ونقاط التقييم. يتيح لك هذا تتبع عملية الدوزنة واتخاذ قرارات مستنيرة بناءً على أداء الوظيفة.
هذه مجرد بداية رحلتنا مع Large Language Models (LLMs) والذكاء الاصطناعي التوليدي. نحن نخطط لبناء المزيد في الأيام القادمة وسنبقيكم على اطلاع!
ما زلنا نتعلم عن هذا الموضوع، مثل أي شخص آخر. في حال كنت تحاول الاستفادة من Large Language Models في مؤسستك، فنحن نحب الدردشة وتبادل الملاحظات.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد
























