October 14, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.



Published: October 6, 2026
Blazingly fast way to build, track and deploy your models!
تلجأ الفرق الهندسية للمقارنة بين LiteLLM وVercel AI عندما تصبح عمليات التكامل المباشر مع مزودي الخدمة صعبة الإدارة. كلاهما يبسط الوصول إلى العديد من مزودي نماذج اللغة الكبيرة (LLM) ويقلل من حجم العمل المطلوب للتكامل مع كل نموذج على حدة. كما يوفران واجهة موحدة لتطبيقات الذكاء الاصطناعي تتيح تبديل النماذج دون الحاجة إلى تعديلات متكررة في الكود البرمجي.
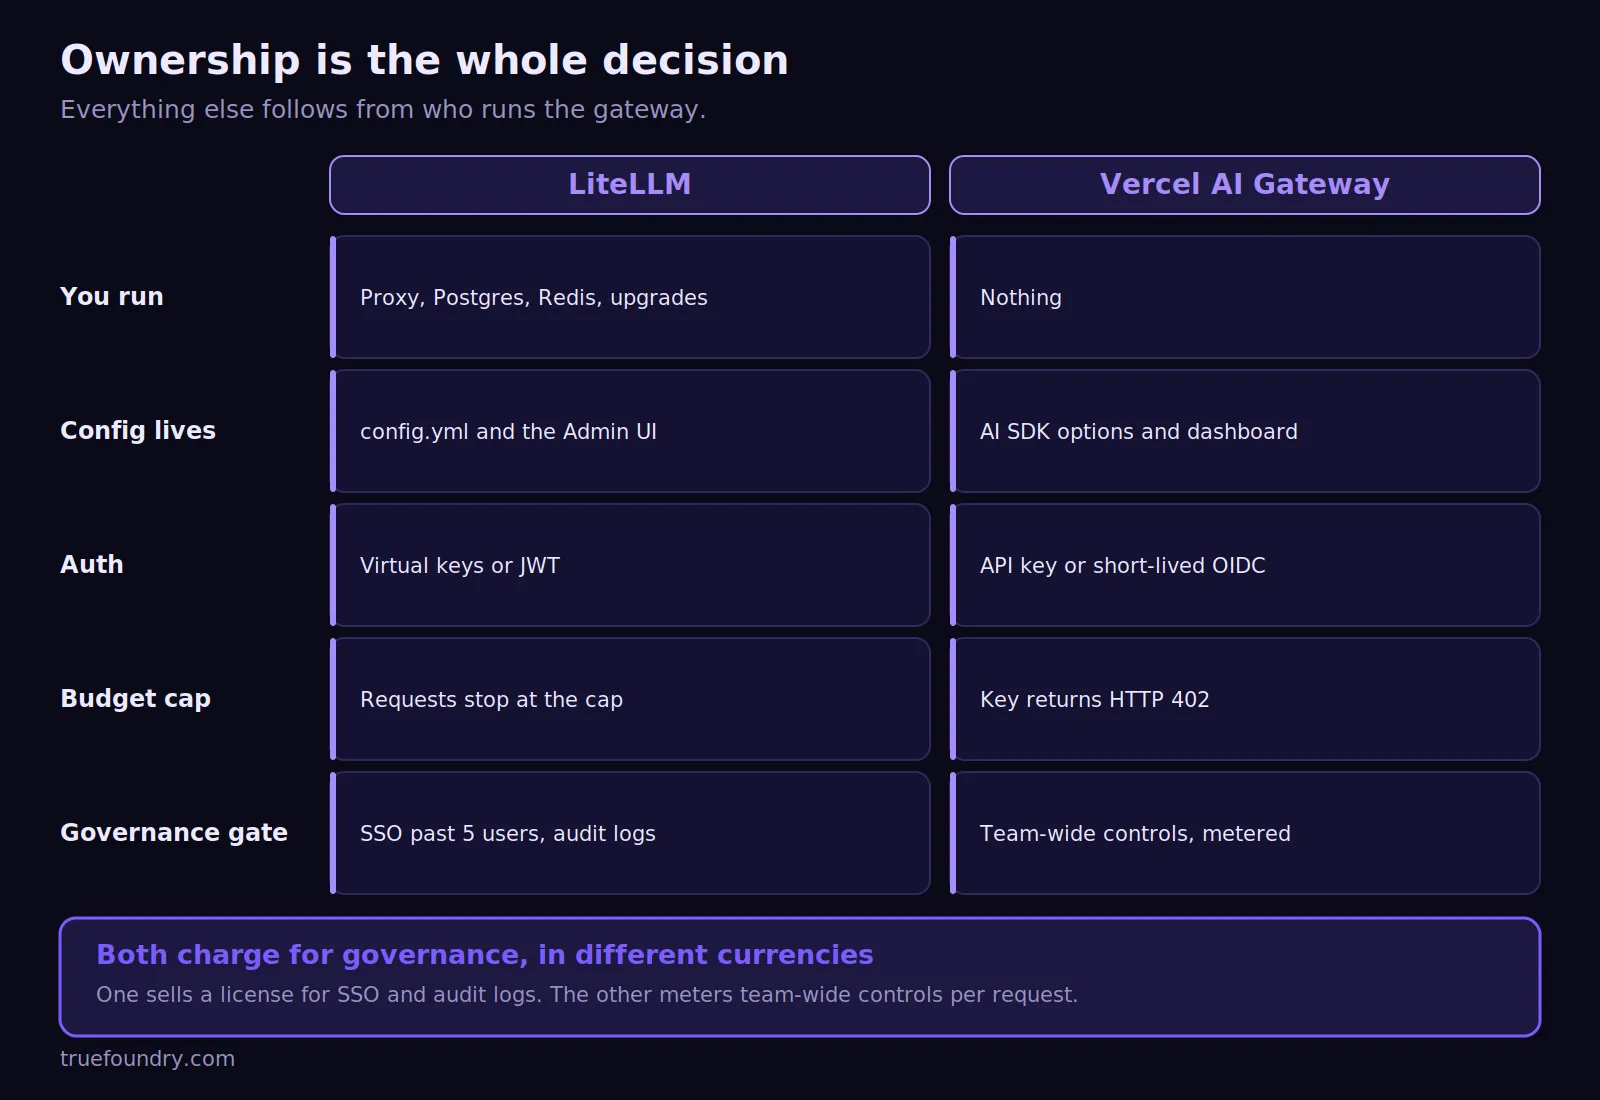
يكمن الاختلاف الجوهري في طبيعة الملكية التشغيلية لكلتا المنصتين. LiteLLM عبارة عن بوابة ذكاء اصطناعي وخادم وكيل (Proxy) مفتوح المصدر ومستضاف ذاتياً. أما Vercel AI Gateway فهي خدمة مدارة ومستضافة تركز على تجربة المطورين. باختصار، يتم تشغيل LiteLLM ضمن بنيتك التحتية الخاصة، بينما تتولى Vercel إدارة البوابة بالكامل.
تكتسب TrueFoundry أهميتها عندما تحتاج المؤسسات إلى حوكمة أوسع تشمل النماذج، والأدوات، والوكلاء، والميزانيات.
تعد الملكية هي المعيار الأكثر فائدة للمقارنة بين LiteLLM وVercel AI. تمنح LiteLLM الفرق خادم وكيل خاص بهم يقومون بتشغيله وتخصيصه، حيث تتحكم فرق المنصة في التوجيه، وحدود الاستخدام، والميزانيات، وبيانات اعتماد المزود، وعمليات النشر. كما يدعم خادم وكيل LiteLLM حزمة تطوير برمجية (SDK) بلغة Python، ويمكن لطلبات API تمرير البيانات الوصفية عبر رؤوس HTTP.
تعتمد Vercel AI Gateway نهج الخدمة المستضافة؛ حيث يحصل فريق المنتج على مفتاح API واحد، مع دعم ميزات مثل BYOK، ورموز OIDC، والتوجيه، والمراقبة. يمكن ترحيل عمليات التكامل المتوافقة مع OpenAI ببساطة عن طريق استبدال عنوان URL الأساسي، كما يتصل SDK الخاص بـ Vercel AI دون الحاجة إلى صيانة البوابة.
تؤدي الملكية إلى تباين في التكاليف التشغيلية. تستخدم LiteLLM قاعدة بيانات Postgres لإدارة الفرق، والمفاتيح الافتراضية، والميزانيات، والتحكم في الوصول. في المقابل، تتولى Vercel تشغيل الخدمة بينما يقوم الفريق بتهيئة التوجيه والمزودين.
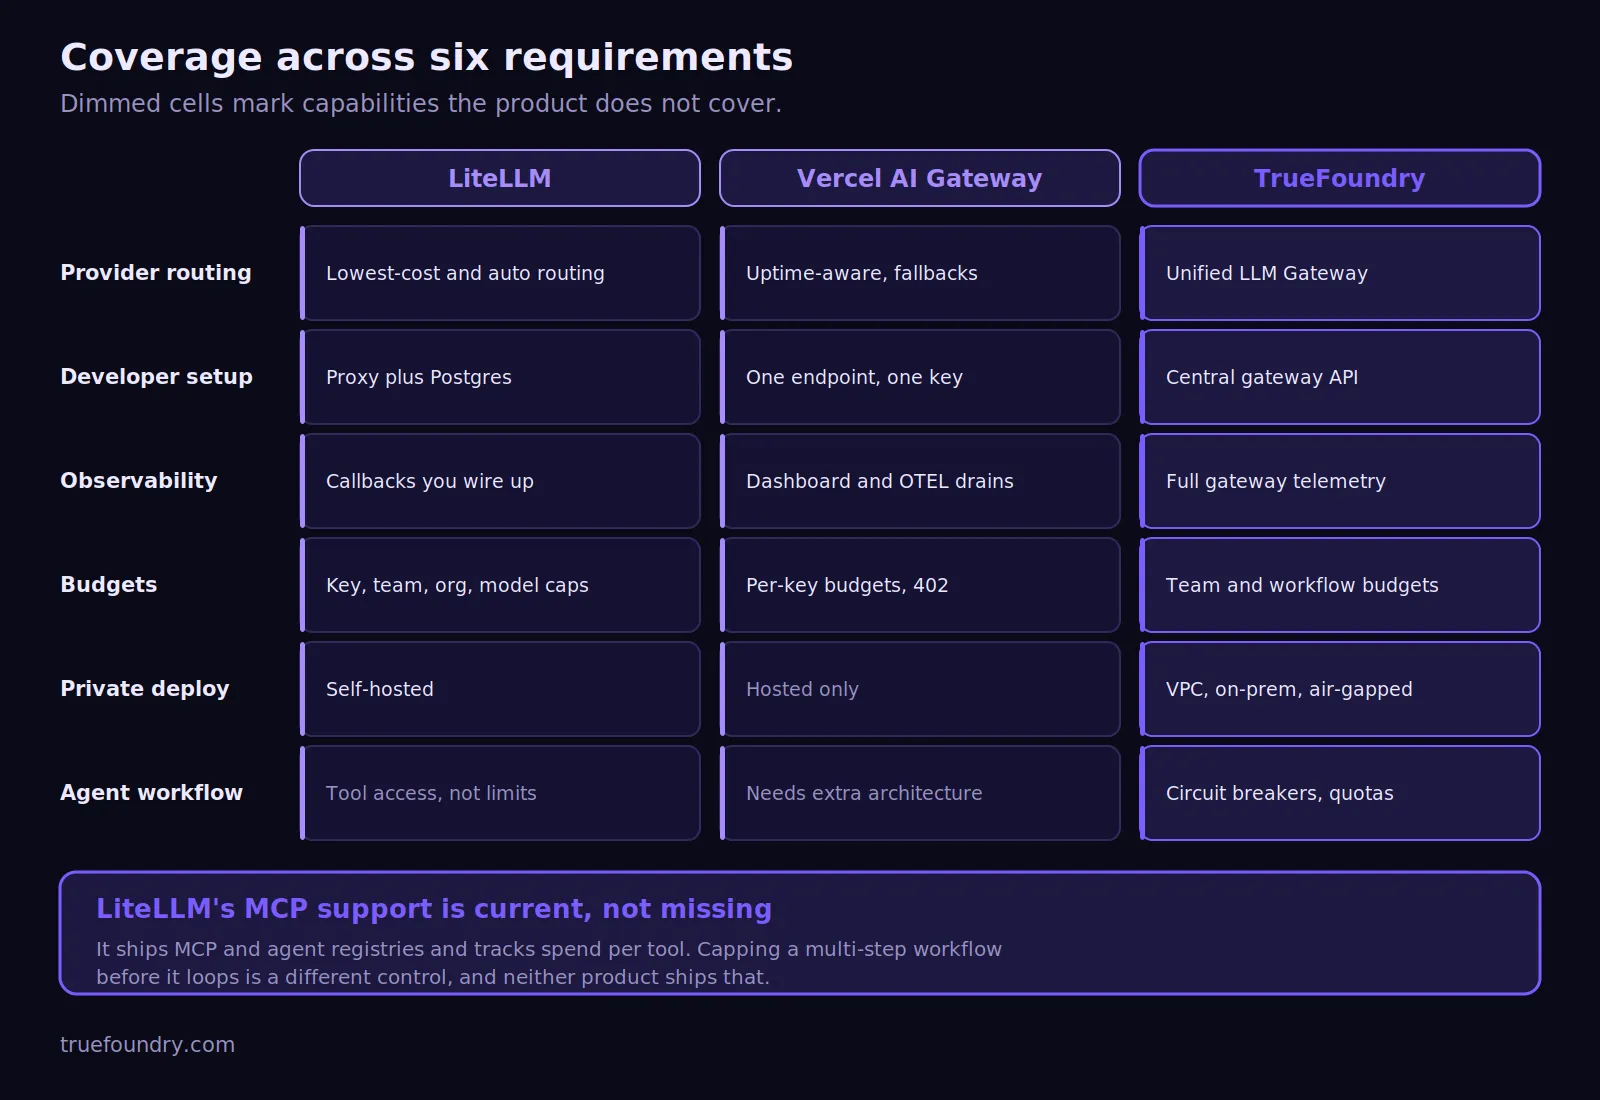
تعد LiteLLM مناسبة للفرق التي ترغب في توجيه مستضاف ذاتياً وتحكم كامل في التكاليف. يدعم جوهرها المرخص برخصة MIT أكثر من 140 مزوداً من خلال واجهة موحدة. ويمكن للفرق ربط النماذج الداخلية، وGoogle Vertex، وAmazon Bedrock، وAWS Bedrock، وغيرهم من المزودين.
تتضمن النسخة المجانية مفاتيح افتراضية، وميزانيات، وتحديد معدل الاستخدام، وآليات التبديل التلقائي، ومقاييس Prometheus. تدعم LiteLLM موازنة الأحمال عبر المزودين والمناطق والمفاتيح. كما يمكن لميزات "التكلفة الأقل" و"التوجيه التلقائي" اختيار مزودي النماذج بناءً على التكلفة أو التعقيد. دليل TrueFoundry حول موازنة أحمال نماذج اللغة الكبيرة (LLM) يشرح مسارات حركة المرور هذه عبر بيئات العمل الإنتاجية.
تجاوزت LiteLLM الآن كونها مجرد خادم وكيل أساسي لتشمل قدرات نماذج اللغة الكبيرة (LLM)، وMCP، والوكلاء. يتم تتبع الاستخدام بناءً على المفتاح، والمستخدم، والفريق، والأداة، والوكيل، وخادم MCP عبر حالات استخدام أوسع.
تظل المقايضة متمثلة في الملكية التشغيلية المطلوبة من الفرق الهندسية؛ حيث يتعين على الفرق إدارة النشر، والتحديثات، والتخزين، والأمان، والموثوقية. توفر نسخة المؤسسات ميزات مثل SSO، وSCIM، وسجلات التدقيق، وإدارة الأسرار، وعناصر التحكم متعددة المناطق، والدعم الفني. تعتمد التسعير على عرض مخصص يتوقف على سعة البوابة السنوية ومتطلبات النشر.
اختر LiteLLM عندما:
يُعد Vercel AI Gateway الخيار الأقوى للفرق الصغيرة التي تبني تطبيقاتها بالفعل على منصة Vercel. توفر نقطة نهاية واحدة الوصول إلى نماذج متعددة باستخدام بيانات اعتماد موحدة وبدون أي رسوم إضافية على الرموز. يمكن للفرق استخدام بيانات اعتماد النظام أو مفاتيحهم الخاصة، كما يمكن لعمليات تكامل OpenAI الحالية الانتقال بسهولة عن طريق تغيير عنوان URL الأساسي.
تكمن الميزة العملية في سرعة الإعداد وتقليل الأعباء التشغيلية. يمكن للمطورين تبديل مزودي الخدمة، ومراجعة تحليلات الاستخدام، وتحديد الميزانيات دون الحاجة إلى إدارة بوابة (Gateway) خاصة بهم. تغطي وثائق Vercel AI Gateway كلاً من AI SDK، وOpenAI Chat Completions، وResponses، وAnthropic Messages من خلال واجهة موحدة.
توفر Vercel خاصية التبديل التلقائي عند الفشل (Failover) بين المزودين الذين يقدمون نفس نموذج الذكاء الاصطناعي. يمكن للفرق إجراء اختبارات A/B للمطالبات (Prompts) من خلال التوجيه المتحكم فيه، كما يمكنهم ترتيب كل مزود مدعوم بناءً على التكلفة، أو الوقت المستغرق للحصول على الرمز الأول، أو معدل الإنتاجية. تتيح ميزة "إحضار مفتاحك الخاص" (BYOK) استخدام مهلات المزود، بينما تقوم منطق التبديل التلقائي بتوجيه حركة المرور المتعثرة إلى مسارات أخرى.
تعمل سياسة عدم الاحتفاظ بالبيانات على مستوى الفريق على قصر الطلبات على المزودين المشمولين باتفاقيات Vercel. كما تساهم قوائم السماح الخاصة بالمزودين في تقييد حركة مرور الفريق. ومع ذلك، لا يزال يتعين مراجعة سياسات الاحتفاظ بالبيانات على مستوى المزود بالنسبة لأحمال العمل الخاضعة للتنظيم.
اختر Vercel AI Gateway عندما:
تتضح المقارنة بين Vercel AI وLiteLLM عند النظر في جوانب التوجيه والمراقبة. يتحكم LiteLLM في تحديد معدل الطلبات، والتبديل عند الفشل، وتوجيه المزودين، وتسجيل البيانات، حيث يوفر الوكيل (Proxy) واجهة برمجة تطبيقات موحدة عبر عمليات النشر المختلفة.
توفر Vercel مراقبة مدمجة من خلال لوحة تحكم Vercel. يمكن للفرق مراجعة الطلبات، والتكلفة، وزمن الاستجابة (Latency)، واستخدام الرموز، وسلوك المزود. يمكن للتوجيه أن يعطي الأولوية للتكلفة، أو الإنتاجية، أو زمن الاستجابة المنخفض دون الحاجة إلى تشغيل مستوى البيانات. يظل زمن الاستجابة المتأخر (Tail latency) معتمداً على المزودين الأساسيين والنماذج المختارة.
بالنسبة للمؤسسات، قابلية ملاحظة بوابة الذكاء الاصطناعي يجب أن تربط بين التوجيه وحالات الفشل والتكلفة ونشاط السياسات. إن وجود بوابة لنماذج اللغات الكبيرة (LLM Gateway) يمكنه مركزية الوصول إلى الموفرين عبر حركة مرور الإنتاج.
تغطي LiteLLM الآن بروتوكول MCP والوكلاء بشكل أعمق مما تشير إليه المقارنات القديمة. لا يزال يتعين على المشترين الفصل بين الوصول إلى الأدوات وحدود سير العمل. فإدارة استدعاء أداة تختلف عن التحكم في سلسلة كاملة من استدعاءات الوكلاء.
يجب أن يعكس التسعير إجمالي تكلفة الملكية المطلوبة لكل نموذج تشغيلي. لا تفرض بوابة LiteLLM مفتوحة المصدر أي رسوم ترخيص، بينما يتم تخصيص تسعير المؤسسات. يتم تحديد حجم المؤسسة بناءً على سعة الطلبات السنوية، وبنية النشر، واحتياجات الدعم. ولا تزال الفرق تتحمل تكاليف البنية التحتية الداعمة والعمليات الجارية بنفسها.
تضيف نسخة المؤسسات ميزات تسجيل الدخول الموحد (SSO)، وSCIM، وسجلات التدقيق، وإدارة الأسرار، وإمكانيات المناطق المتعددة، والدعم. وهذا يحل محل افتراض السعر العام القديم في المسودة. إن تحليل تسعير LiteLLM للمؤسسات يوفر معلومات مفصلة حول محركات التكلفة التشغيلية.
تستخدم Vercel أرصدة مدفوعة مسبقاً وتفرض السعر المعلن للموفر دون إضافة هامش ربح على الرموز (tokens). تتضمن خطتها المجانية 5 دولارات كل 30 يوماً حتى يبدأ الدفع. قد تخضع عمليات الشراء بالبطاقة لرسوم معالجة الدفع، بينما تتوفر الفواتير بدون هذه الرسوم.
تتضمن بعض عناصر التحكم في الحوكمة أيضاً عدادات منفصلة قائمة على الاستخدام للفرق. تبلغ تكلفة ميزة ZDR على مستوى الفريق 0.10 دولار لكل 1,000 طلب. وتفرض ميزة التقارير المخصصة 0.075 دولار لكل 1,000 قيمة مكتوبة و5 دولارات لكل 1,000 استعلام. هذه التكاليف الإضافية مهمة مع توسع حركة مرور الإنتاج عبر الفرق.
ينبغي للمؤسسات المقارنة بين البرمجيات، والبنية التحتية، والعمليات، والتحكم في التكاليف معاً بمجرد أن يصبح النشر الخاص والحوكمة الأوسع من المتطلبات الأساسية.
لم تعد المقارنة بين LiteLLM و Vercel AI مجرد مقارنة بسيطة بين وكيل (proxy) وخدمة مستضافة. تغطي LiteLLM النماذج، وبروتوكول MCP، والوكلاء، والحوكمة. بينما تتمتع Vercel بميزانيات أقوى وعناصر تحكم أفضل في الموفرين. وتتعلق الفجوات المتبقية بسير عمل الوكلاء المتكامل.
يمكن أن يبدأ الذكاء الاصطناعي في الإنتاج كاستدعاء لنموذج لغوي كبير (LLM)، ثم يستمر عبر أدوات بروتوكول سياق النموذج (MCP)، ويؤدي إلى مزيد من الإجراءات. قد تحتاج المؤسسات إلى الهوية، والميزانيات، وأدلة التدقيق عبر تلك السلسلة. إن بوابة MCP تدير الوصول إلى الأدوات، بينما بوابة الوكلاء تدير تنفيذ الوكلاء.
تشمل المجالات الشائعة للتقييم ما يلي:
يجب أن يعكس القرار بين Vercel AI أو LiteLLM متطلبات الحوكمة الحالية. وينبغي على الفرق التي تقارن خياراً مداراً آخر، مثل Kong AI Gateway، تطبيق نفس اختبار الملكية.
تعد TrueFoundry خياراً مناسباً عندما ترغب المؤسسات في الحصول على طبقة حوكمة موحدة عبر النماذج والأدوات والوكلاء. حيث تقوم بوابة الذكاء الاصطناعي (AI Gateway) بمركزية التوجيه، والميزانيات، وضوابط الحماية، والمراقبة، والوصول إلى المزودين عبر خدمات البرمجيات (SaaS) والنشر الخاص.
تمنح LiteLLM الفرق بوابة يقومون بتشغيلها بأنفسهم، بينما توفر Vercel بوابة نماذج مستضافة. أما TrueFoundry فهي تجمع بين حوكمة النماذج، وMCP، والوكلاء مع خيارات للنشر الخاص.
يتم فرض القواعد بشكل تصريحي وتُحفظ في نظام التحكم في الإصدار. يتم تقييم القواعد بالترتيب، وتُطبق القاعدة الأولى التي تتحقق شروطها:
name: ratelimiting-config
type: gateway-rate-limiting-config
rules:
  # Cap one contractor account on a specific model
  - id: "contractor-gpt4-daily"
    when:
      subjects: ["user:contractor@example.com"]
      models: ["openai-main/gpt4"]
    limit_to: 1000
    unit: requests_per_day

  # Give every user an independent daily token budget
  - id: "user-daily-limit"
    when: {}
    limit_to: 1000000
    unit: tokens_per_day
    rate_limit_applies_per: ['user']
ينشئ الحقل `rate_limit_applies_per` عداداً منفصلاً لكل كيان، بحيث تغطي قاعدة واحدة جميع المستخدمين دون الحاجة لإنشاء قاعدة لكل هوية. عند تجاوز الطلب للحد المسموح به، يتم إرجاع رمز الخطأ HTTP 429، مع ذكر القاعدة التي تم تفعيلها، إلى جانب ترويسة `x-tfy-applied-rules`:
{
  "status": "failure",
  "message": "Rate limit exceeded for model: openai-main/gpt4 with rule: contractor-gpt4-daily",
  "error": {
    "type": "RateLimitError",
    "code": "429"
  },
  "error_origin_level": "rate_limit_budget"
}
تكون TrueFoundry ذات أهمية قصوى عندما:
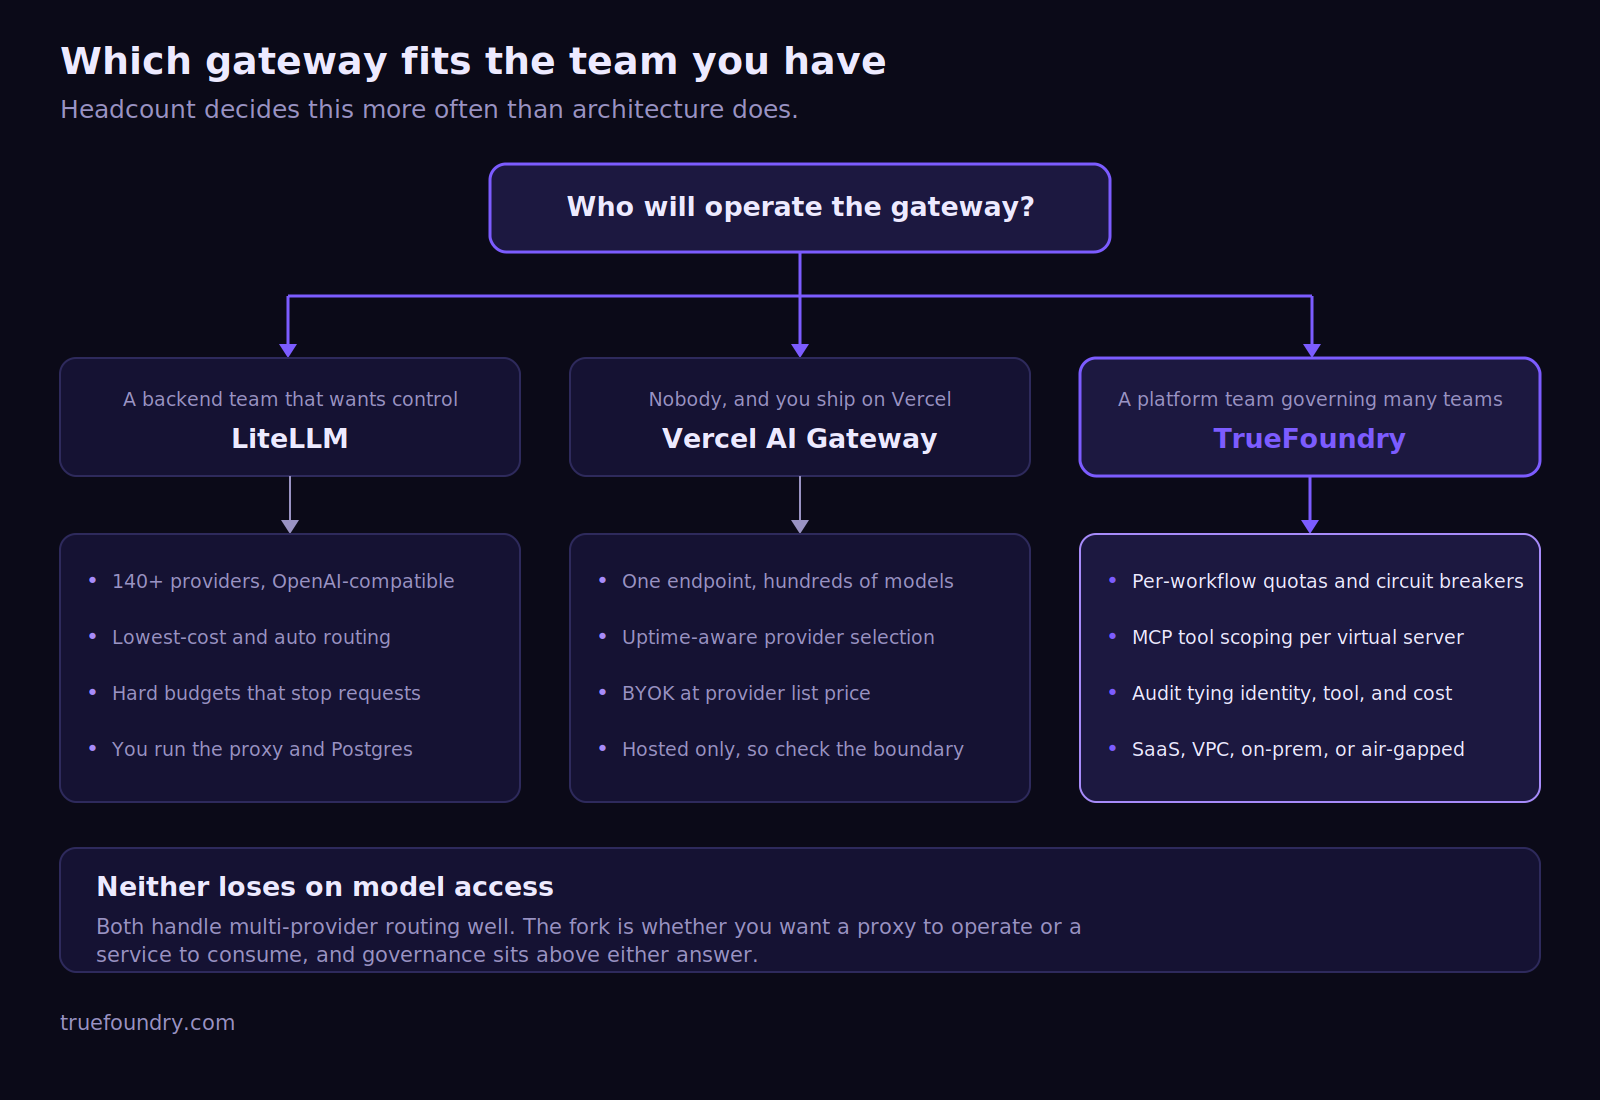
اختر LiteLLM عندما يحتاج فريقك إلى تحكم ذاتي الاستضافة، ومرونة المصادر المفتوحة، والمفاتيح الافتراضية، وإدارة الميزانيات، والعمليات المخصصة. تغطي منصتها الآن النماذج، وMCP، والوكلاء، مما يجعلها الخيار الأمثل عندما ترغب فرق المنصات في امتلاك زمام العمليات بالكامل.
اختر Vercel AI Gateway عندما يستخدم فريقك منصة Vercel ويرغب في الوصول السريع للنماذج، واستخدام مفاتيحك الخاصة (BYOK)، والموثوقية التي توفرها الخدمات المستضافة. تكون هذه المنصة هي الأقوى عندما تكون سرعة التسليم أولوية تفوق الحاجة إلى امتلاك بوابة خاصة.
اختر TrueFoundry عندما يتطلب الأمر تنفيذًا خاضعًا للحوكمة يغطي النماذج، وأدوات MCP، والوكلاء، والميزانيات. كما أنها مناسبة لبيئات الإنتاج الخاصة أو المُدارة التي تتطلب سجلات تدقيق موثقة.
يعتمد القرار بين LiteLLM وVercel AI في المقام الأول على مستوى الملكية المطلوب. توفر LiteLLM تحكمًا في البنية التحتية، بينما توفر Vercel خدمة مستضافة. أما TrueFoundry فهي الخيار الأنسب عندما تصبح حوكمة الذكاء الاصطناعي بمفهومها الأوسع هي التركيز الأساسي.
احجز عرضًا توضيحيًا مع TrueFoundry لتقييم متطلباتك المتعلقة بالبوابة، وMCP، والوكلاء، والنشر، والحوكمة.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد