



October 21, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.


Blazingly fast way to build, track and deploy your models!
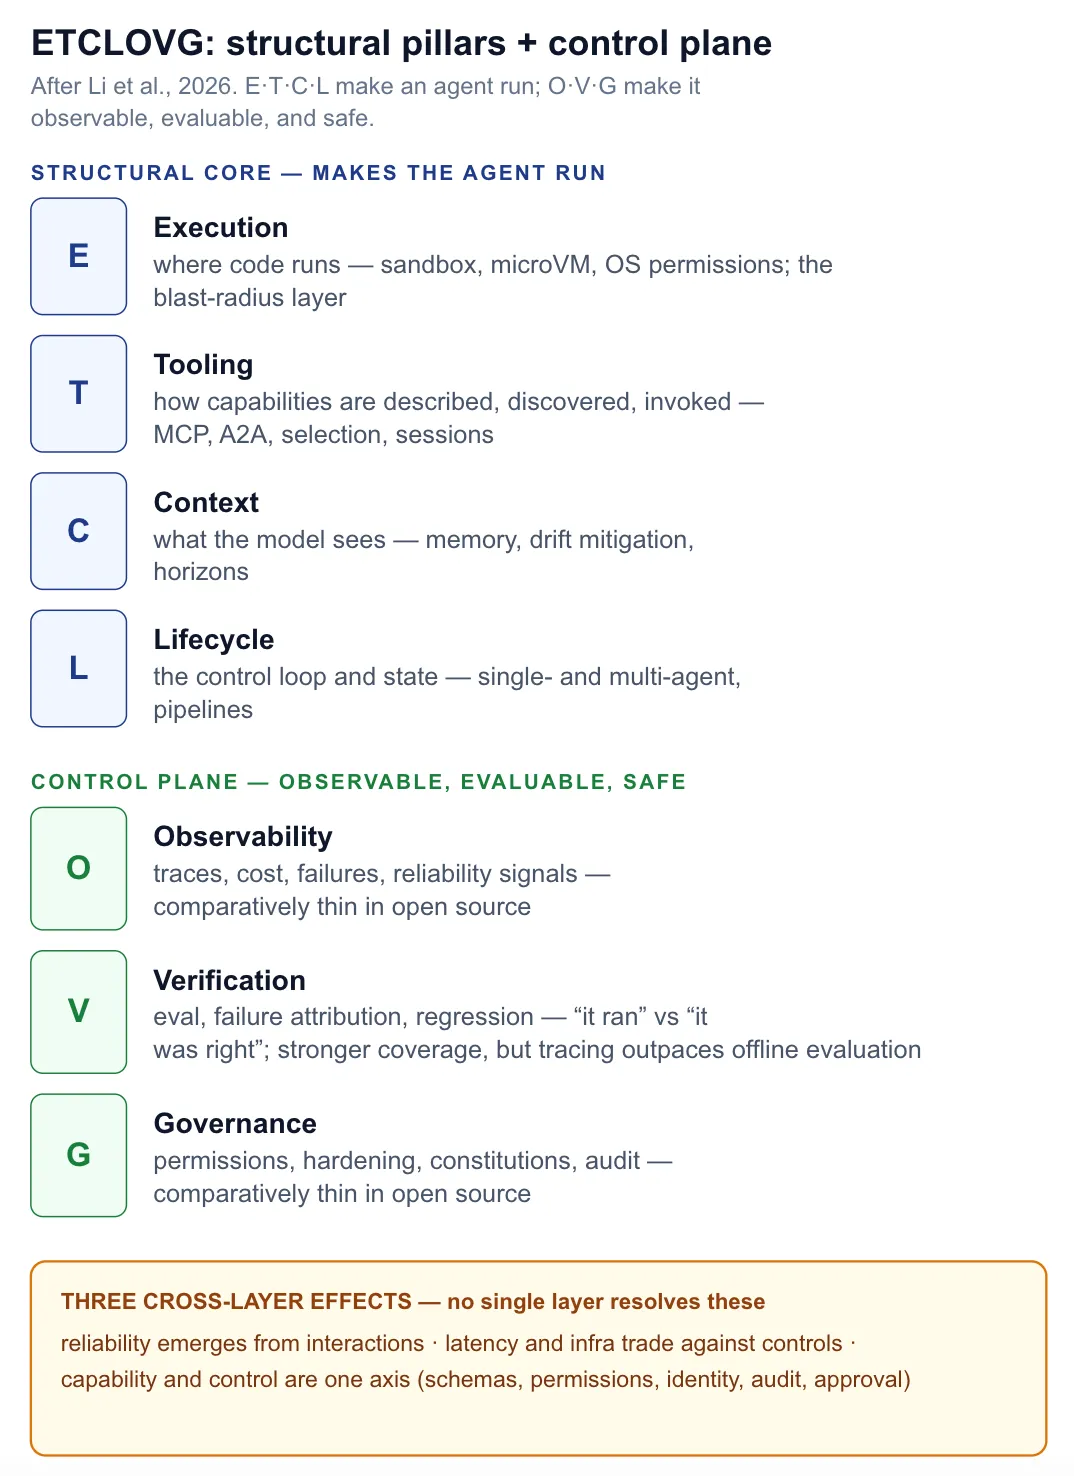
تعتمد موثوقية الوكيل على كل من النموذج والنظام المحيط به. يقترح استطلاع أجري عام 2026 من قبل باحثين من جامعة كارنيجي ميلون، وييل، وأمازون، ومؤسسات أخرى، تصنيف ETCLOVG — التنفيذ، والأدوات، والسياق، ودورة الحياة، والقابلية للمراقبة، والتحقق، والحوكمة — كتصنيف لذلك النظام المحيط، أو منظومة الوكيل.
يربط المؤلفون أكثر من 170 مشروعاً مفتوح المصدر بالطبقات السبع ويحددون كلاً من المجالات الناضجة والفجوات التشغيلية. يلخص هذا المنشور التصنيف، ثم يربطه بمنظومة الوكلاء في TrueFoundry — مع الفصل بين قدرات بيئة التشغيل الأصلية والأنماط والتكاملات المجاورة.
بريانكا، رئيسة المنصة، كانت تواجه مشكلة في الموثوقية لم تستطع تسميتها. كانت فرقها تدير خمسة وكلاء في بيئة الإنتاج، وعندما يسيء أحدهم التصرف، لم تكن تقارير ما بعد الوفاة تتفق أبداً على ما يجب إصلاحه. ألقى أحدهم باللوم على النموذج وطالب بترقيته. وأعاد آخر كتابة المطالبة (Prompt). وأضاف ثالث محاولة إعادة تنفيذ. وأراد رابع بيئة معزولة (Sandbox). كان كل إصلاح يبدو منطقياً، وكل منها يعالج طبقة مختلفة، ولم يشارك أي منهم مفردات مشتركة لتحديد الطبقة التي فشلت بالفعل — لذا ظلت الاجتماعات تدور في حلقة مفرغة. ما كانت تحتاجه بريانكا ليس نموذجاً أفضل أو رأياً أعلى صوتاً؛ بل كان خريطة: طريقة للإشارة إلى وكيل والقول "هذا الفشل يكمن في دورة الحياة، وليس في النموذج" أو "ليس لدينا طبقة تحقق على الإطلاق". ETCLOVG هي تلك الخريطة، وهذا المنشور هو جولة فيها — نبدأ بالتصنيف كما بناه مؤلفوه، ثم نطبق كل طبقة على بيئة تشغيل الإنتاج، مع التمييز بين القدرات الأصلية وسير العمل والتكاملات المجاورة، سواء كانت تطلق عليها هذه الأسماء أم لا.
الادعاء الرئيسي للاستطلاع هو تقليل أهمية النماذج وزيادة أهمية البنية التحتية: كشف النشر السريع لوكلاء النماذج اللغوية الكبيرة (LLM) أن موثوقية التنفيذ تعتمد على البنية التحتية التي تغلف النموذج أكثر من اعتمادها على النموذج الأساسي نفسه. الأدلة جزئياً تاريخية. حقبة ReAct في 2022–23 غلفت حلقة نموذج واحدة في حلقة تكرار (while-loop)، وقالب مطالبة، وجدول صغير لإرسال الأدوات؛ ثم كشفت AutoGPT وBabyAGI عن أنماط الفشل في ذلك الغلاف الرقيق — هروب التنفيذ، وتضخم السياق، وفقدان الحالة، والآثار الجانبية غير المراقبة — باعتبارها مشاكل بنية تحتية وليست مشاكل في المطالبة. السنوات التي تلت ذلك كانت عبارة عن بناء بطيء للبنية التحتية المفقودة، ولم يتم تسميتها إلا مؤخراً.
تلك التسمية هي الإطار المكون من ثلاث مراحل في الاستطلاع، والذي يحدد هندسة المنظومة بدقة. هندسة المطالبات (2022–24): الرافعة هي نص الإدخال، المحسّن لاستدعاء واحد. هندسة السياق (2025): يتحول السؤال إلى "ما الذي يجب أن يراه النموذج في كل خطوة؟" — الاسترجاع، والضغط، وترتيب نتائج الأدوات، وتشبع نافذة السياق. هندسة المنظومة (2026–): مع نمو قدرة النماذج على تنفيذ مهام طويلة الأمد، يتوسع التركيز ليشمل غلاف البنية التحتية بالكامل. كل مرحلة تتضمن ما قبلها — المنظومة تشمل السياق الذي يشمل المطالبة — وهي تتداخل بدلاً من أن تحل محل بعضها. تمنح ETCLOVG تلك المرحلة الثالثة الحدود المعمارية التي لم تكن المرحلتان الأوليان بحاجة إليها.
ينقسم التصنيف إلى نواة هيكلية ومستوى تحكم. E وT وC وL هي الركائز الهيكلية — فهي تجعل الوكيل يعمل. أما O وV وG فهي مستوى التحكم — فهي تجعل الوكيل قيد التشغيل قابلاً للمراقبة والتقييم وآمناً. الخطوة البارزة في الاستطلاع هي ترقية القابلية للمراقبة والحوكمة إلى طبقات مستقلة بدلاً من دمجها في خطافات دورة الحياة، وذلك على أساس أن لكل منها في بيئة الإنتاج نظاماً بيئياً خاصاً بالأدوات وتديره فرق مختلفة. إليكم الطبقات السبع، مصاغة من تعريفات الاستطلاع.
E — بيئة التنفيذ. حيث يتم تشغيل كود الوكيل وإجراءاته فعلياً، وما يحدها: البيئات المعزولة المدارة، والأجهزة الافتراضية الدقيقة (microVMs)، وبيئات التشغيل المتخصصة في الكود، وبيئات استخدام الكمبيوتر والمتصفح، ونماذج الأذونات على مستوى نظام التشغيل. هذه هي طبقة "نطاق الانفجار" — ما يمكن للوكيل الوصول إليه عند تشغيل أمر ما.
T — واجهة وبروتوكول الأدوات. كيفية وصف القدرات الخارجية واكتشافها واستدعائها: معايير البروتوكول (MCP, A2A)، ووصف الأدوات واختيارها، والتدريب المعزز بالأدوات، وإدارة الجلسات. لا يعرف النموذج الأدوات إلا من خلال هذه الطبقة.
C — إدارة السياق والذاكرة. ما يمكن للنموذج رؤيته عبر آفاق زمنية قصيرة المدى، وجلسات العمل، والآفاق المستمرة: تقنيات السياق طويل المدى وتخفيف حدة انحراف السياق. كان هذا موضوع مرحلة الهندسة السابقة، وأصبح الآن ركيزة واحدة من أصل أربع ركائز.
L — دورة الحياة والتنسيق. تدفق التحكم الذي يقرأ ويكتب الحالة — بدءاً من الحلقة الداخلية للوكيل الفردي، مروراً بأنماط الوكلاء المتعددين، وصولاً إلى خطوط أنابيب العمل الكاملة من إصدار المشكلة وحتى طلب السحب. الحلقة نفسها تقع هنا.
O — القابلية للملاحظة والعمليات. التتبعات، والتكاليف، والإخفاقات، ومؤشرات الموثوقية — منصات التتبع، وأدوات العمليات الخاصة بالوكلاء، وتتبع التكلفة، والقابلية الموحدة للملاحظة. تشير نتائج المسح إلى أن هذه الطبقة لا تزال محدودة نسبياً في البرمجيات مفتوحة المصدر.
V — التحقق والتقييم. تحويل المهام والتتبعات إلى تقييم، وتحديد أسباب الفشل، وملاحظات الانحدار: تأصيل المعايير، والتنفيذ الخاضع للرقابة، والتقييم متعدد المستويات، وحلقات التقييم أثناء النشر. الفرق بين "لقد تم التشغيل" و"لقد كان صحيحاً".
G — الحوكمة والأمن. القيود عبر الطبقات الفرعية للنموذج والنظام والمؤسسة: نماذج الأذونات، وخطافات دورة الحياة، وتقوية المكونات، والدساتير التعريفية، وبنية التدقيق التحتية. يلاحظ المسح أن هذه الجوانب أيضاً محدودة في المصادر المفتوحة، وغالباً ما تكون "موجودة داخل المنصات التجارية".
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد



















