



November 6, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.



Blazingly fast way to build, track and deploy your models!
دخل نموذج DeepSeek-V4-Pro مرحلة المعاينة في 24 أبريل 2026 وأصبح متاحاً بشكل عام في 13 أغسطس 2026 — أي في أقل من أربعة أشهر بقليل. لم يتغير اسم النموذج في API أبداً: لا تزال تستدعي deepseek-v4-pro، وحل إصدار الإطلاق العام محلياً مكان إصدار المعاينة خلف هذا الاسم.
المواصفات، المأخوذة من صفحة النماذج والأسعار الخاصة بـ DeepSeek وبطاقة النموذج للإطلاق العام، اعتباراً من سبتمبر 2026:
هناك تفصيلان أكثر أهمية من عدد المعلمات.
أولاً، الأوزان مفتوحة بحق. نُشرت نقطة التحقق (Checkpoint) لإصدار GA على deepseek-ai/DeepSeek-V4-Pro-0813 تحت رخصة MIT — وليست رخصة مجتمعية مخصصة ذات سقف للإيرادات أو استثناءات لمجالات الاستخدام. وتعد رخصة MIT من أكثر الرخص تسامحاً المتاحة. وتلك هي الحقيقة الوحيدة التي تجعل بقية هذه المقالة تستحق الكتابة.
ثانياً، العمل على كفاءة النموذج هو القصة الأساسية لبنيته الهندسية. تصف بطاقة النموذج الخاصة بإصدار المعاينة معمارية انتباه هجينة تجمع بين Compressed Sparse Attention وHeavily Compressed Attention، وتذكر أنه عند سياق يصل إلى 1M رمز، يحتاج V4-Pro إلى حوالي 27% فقط من عمليات FLOPs الخاصة باستدلال الرمز الواحد و10% من ذاكرة التخزين المؤقت KV مقارنة بنموذج DeepSeek-V3.2. أصبحت خدمة السياق الطويل هنا منخفضة التكلفة بطريقة لم تكن مجهزة بها أجيال V3، وهو ما يجعل حسابات الاستضافة الذاتية مثيرة للاهتمام للغاية.
[لقطة شاشة: محادثة DeepSeek — محدد الوضع المتقدم (Expert Mode) الذي يوجه إلى V4-Pro على التطبيق والويب]
تتميز DeepSeek بصراحتها غير المعتادة حول هذا الأمر. تذكر بطاقة النموذج لإصدار الإطلاق العام أن V4-Pro-0813 "مبني على بنية نموذج DeepSeek-V4-Pro (Preview)، مع إرفاق وحدة فك الترميز التخمينية DSpark" — النموذج الأساسي هو نفسه؛ لكن مرحلة ما بعد التدريب ومسار فك الترميز حسناً.
الفروق التي نشرتها، من المعاينة إلى الإطلاق العام (GA):
المصدر: بطاقة نموذج DeepSeek-V4-Pro-0813، سبتمبر 2026.
كلمة تحذير عند قراءة هذه الأرقام. تشير DeepSeek إلى أن درجات وكلاء البرمجة تم إنتاجها باستخدام DeepSeek Harness الخاص بها في الحد الأدنى من الوضعية وبأقصى جهد استدلال (max reasoning effort)، درجة الحرارة = 1.0، top_p = 0.95. إن القفزة المقاربة لخمسة أضعاف في DeepSWE هي نتيجة لمرحلة ما بعد التدريب تم قياسها تحت حزمة الاختبار الخاصة بالمزود، وليست إعادة إنتاج مستقلة. الاتجاه حقيقي بالتأكيد؛ ولكن الضخامة تستحق إجراء التقييم الخاص بك.
إلى جانب النموذج، جلب الإطلاق العام (GA) دمجاً أصلياً لدعم OpenAI Responses API مع إعداد Codex بنقرة واحدة، والتحكم في reasoning_effort ثلاثي المستويات الذي يحل محل زر التبديل الثنائي للتفكير.
تنشر بطاقة النموذج لإصدار GA جدول مقارنة مباشراً ضد المنافسين المفتوحين والمغلقين. إليك الجزء الذي ينقله الجميع، ثم الجزء الذي تتجاهله معظم المقالات.
المصدر: بطاقة نموذج DeepSeek-V4-Pro-0813، سبتمبر 2026.
المجالات التي يتفوق فيها V4-Pro. مهام الوكلاء القائمة على الواجهات الطرفية (Terminal) والبرمجة الموجهة للأمن السيبراني. حيث يتفوق على Opus-4.8 في Terminal Bench 2.1 وDeepSWE وCybergym وAutomationBench. بالنسبة لنموذج يمكنك تنزيله، فهذه نتيجة ممتازة حقاً.
المجالات التي لا تزال تتفوق فيها النماذج المغلقة. المعرفة الخام والعمل الأكثر تعقيداً على مستودعات البرمجة. يتفوق Opus-4.8 على NL2Repo بأكثر من ثماني نقاط، وعلى DSBench-Hard وToolathlon-Verified وHLE بدون أدوات. ويتفوق Fable-5 مع التراجع (fallback) في معظم هذه المجالات أيضاً. إذا كانت أحمال العمل لديك يغلب عليها التعديل المعقد على مستودعات الأكواد المكونة من عدة ملفات أو أسئلة اتساع المعرفة، تظل النماذج المغلقة الرائدة هي الخيار الأفضل، ولن يغير أي قدر من الحماس للرخص المفتوحة هذه الحقيقة.
أين تقف النماذج المفتوحة الأخرى. يتفوق Kimi K3 بفارق ضئيل على V4-Pro في Terminal Bench 2.1 وDeepSWE. لقب "أفضل نموذج مفتوح الأوزان" هو محل تنافس ولم يحسم بعد. الادعاء الأكثر أهمية وأكثر ثباتاً هو: أن النموذج القابل للتنزيل أصبح الآن قريباً بدرجة كافية من الفئة الرائدة بحيث أصبحت مسألة النشر مطروحة وعملية.
قدمت DeepSeek نظام الفوترة لأوقات الذروة وخارج الذروة بالتزامن مع الإطلاق العام، بدءاً من الساعة 16:00 بتوقيت UTC في 16 أغسطس 2026. الأسعار خارج أوقات الذروة تبلغ نصف أسعار الذروة تماماً. أوقات الذروة هي من 01:00 إلى 04:00 ومن 06:00 إلى 10:00 بتوقيت UTC، من الاثنين إلى الجمعة، باستثناء العطلات الرسمية الصينية؛ وكل ما عدا ذلك، بما في ذلك عطلات نهاية الأسبوع، يعتبر خارج أوقات الذروة.
المصدر: أسعار ونماذج DeepSeek، سبتمبر 2026.
ثلاثة أشياء يجب ملاحظتها. سعر ضربة الذاكرة المؤقتة (cache-hit) أقل بـ 30 مرة من فقدان الذاكرة المؤقتة، لذا فإن بنية الموجه (prompt) تهم بشكل كبير لأي عملية تحتوي على موجه نظام ثابت. التباين بين أوقات الذروة وخارجها هو أداة جدولة وليس مجرد خصم — نقل أحمال العمل المجمعة (batch work) إلى خارج أوقات الذروة يقلل فاتورتها إلى النصف. وقامت DeepSeek برفع الأسعار في الإطلاق العام مقارنة بنموذج المعاينة، على الرغم من أن الأسعار المنشورة للمعاينة هي [VERIFY] — حيث لم تعد موجودة في صفحة الأسعار ولن نعتمد على تغطية ثانوية لجلبها.
ملاحظة تشغيلية واحدة: حد التزامن في API لـ deepseek-v4-pro هو 500. كما أكدت DeepSeek في 10 سبتمبر 2026 أنها ستستمر في تقديم V4 Pro API بعد 14 سبتمبر 2026 بنفس الفوترة دون تغيير (سجل التغييرات).
[لقطة شاشة: منصة DeepSeek — لوحة تحكم الاستخدام التي توضح إنفاق الرموز في أوقات الذروة مقابل خارج أوقات الذروة]
تظهر أربعة أنماط للفشل بانتظام مع النماذج الرائدة ذات الأوزان المفتوحة، وتتضمن V4-Pro هذه الأنماط الأربعة جميعها.
فاتورة الاستضافة الذاتية تتعلق بالعقدة الكاملة (Node)، وليس فقط ببطاقات GPU. أمر الخدمة المرجعي من DeepSeek في بطاقة النموذج يستهدف تكوين GB300 مكوناً من 4 عقد عبر vLLM، مع تفعيل ذاكرة التخزين المؤقت FP8 KV والتوازي الخبير (expert parallelism) وفك الترميز التخميني DSpark. نموذج MoE بحجم 1.7T معلمة ليس شيئاً تشغله على بطاقة A100 إضافية. تمنحك الأوزان المفتوحة خيار الاستضافة الذاتية؛ وما إذا كانت الحسابات أفضل من 1.98 دولار لكل مليون رمز إخراج يعتمد كلياً على نسبة الاستخدام لديك. تحت مستوى معين من الحمل المستقر المرتفع، يتفوق الـ API من حيث التكلفة.
لا يوجد قالب محادثة (chat template). لا يتضمن إصدار الإطلاق العام قالب محادثة Jinja. وبدلاً من ذلك، توفر DeepSeek مجلد تشفير يحتوي على نصفيات Python البرمجية لتحويل الرسائل بتنسيق OpenAI إلى مدخلات للنموذج وتحليل المخرجات مرة أخرى. أي شيء في حزمتك البرمجية يفترض وجود tokenizer.apply_chat_template سيتطلب عملاً إضافياً.
لا يحتوي V4-Pro على قدرات رؤية (Vision). قدرات الرؤية توجد في خط Flash وليس Pro. استراتيجية النموذج الواحد التي افترضت وجود تعدد الوسائط (multimodality) ستتوقف هنا، مما يعني أنك ستقوم بالتوجيه عبر نموذجين على الأقل سواء خططت لذلك أم لا.
توطين البيانات (Residency) واستخدام الـ API أصبحا قرارين منفصلين الآن. إرسال الموجهات إلى api.deepseek.com يمثل مسألة تدفق بيانات مختلفة عن تشغيل نفس الأوزان داخل VPC الخاص بك. غالباً ما تخلط الفرق بين "يمكننا استخدام DeepSeek V4" و"يمكننا استدعاء DeepSeek API"، وتتلقى هاتان الحالتان إجابات مختلفة من نفس المراجعة الأمنية. المراجع القانوني الخاص بك هو من يقرر ما هو مقبول؛ والنقطة المهمة هي أن الأوزان المفتوحة تجعل كلا المسارين متاحين تقنياً.
النموذج الرائد مفتوح الأوزان يغير معادلتك الاقتصادية فقط إذا كنت قادراً بالفعل على نشره واستضافته. وهذا هو الجزء الذي تتكفل به TrueFoundry.
استضفه ذاتياً داخل VPC الخاص بك. يقوم AI Gateway بتسجيل النماذج مفتوحة الأوزان المستضافة ذاتياً إلى جانب المزودين المستضافين: تقوم بنشر V4-Pro على Kubernetes الخاص بك باستخدام vLLM أو SGLang، وتوجه البوابة إلى نقطة النهاية، ليظهر في كتالوج النماذج بنفس ميزات التوجيه، وتحديد معدل الطلبات (rate limiting)، وتتبع التكاليف، والشفافية التشغيلية مثل أي نموذج API آخر (وثائق النماذج المستضافة ذاتياً). ونظراً لأن كل من vLLM وSGLang يدعمان API متوافقاً مع OpenAI افتراضياً، فإن البوابة لا تحتاج إلى محول خاص بـ DeepSeek.
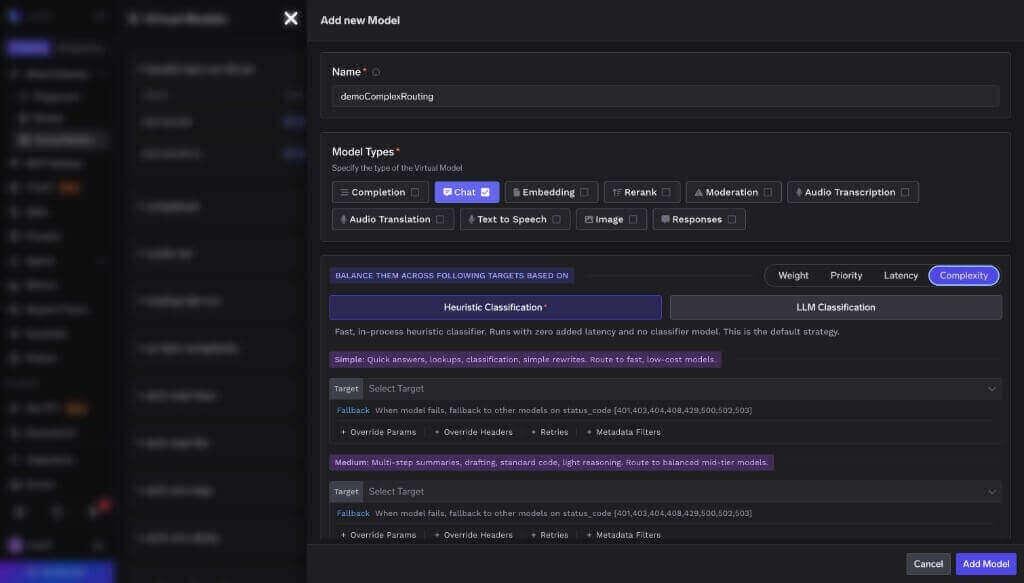
أو استدعِ الـ API وأبقِ الخيار مفتوحاً. إذا لم تكن مستعداً بعد للاستضافة الذاتية، قم بالتوجيه إلى DeepSeek API عبر البوابة واستخدم نفس مسار الاستدعاء الذي ستستخدمه لاحقاً للنشر المستضاف ذاتياً. الانقسام من نقطة النهاية المستضافة إلى العنقود الخاص بك يصبح مجرد تغيير في الإعدادات بدلاً من إعادة كتابة التطبيق.
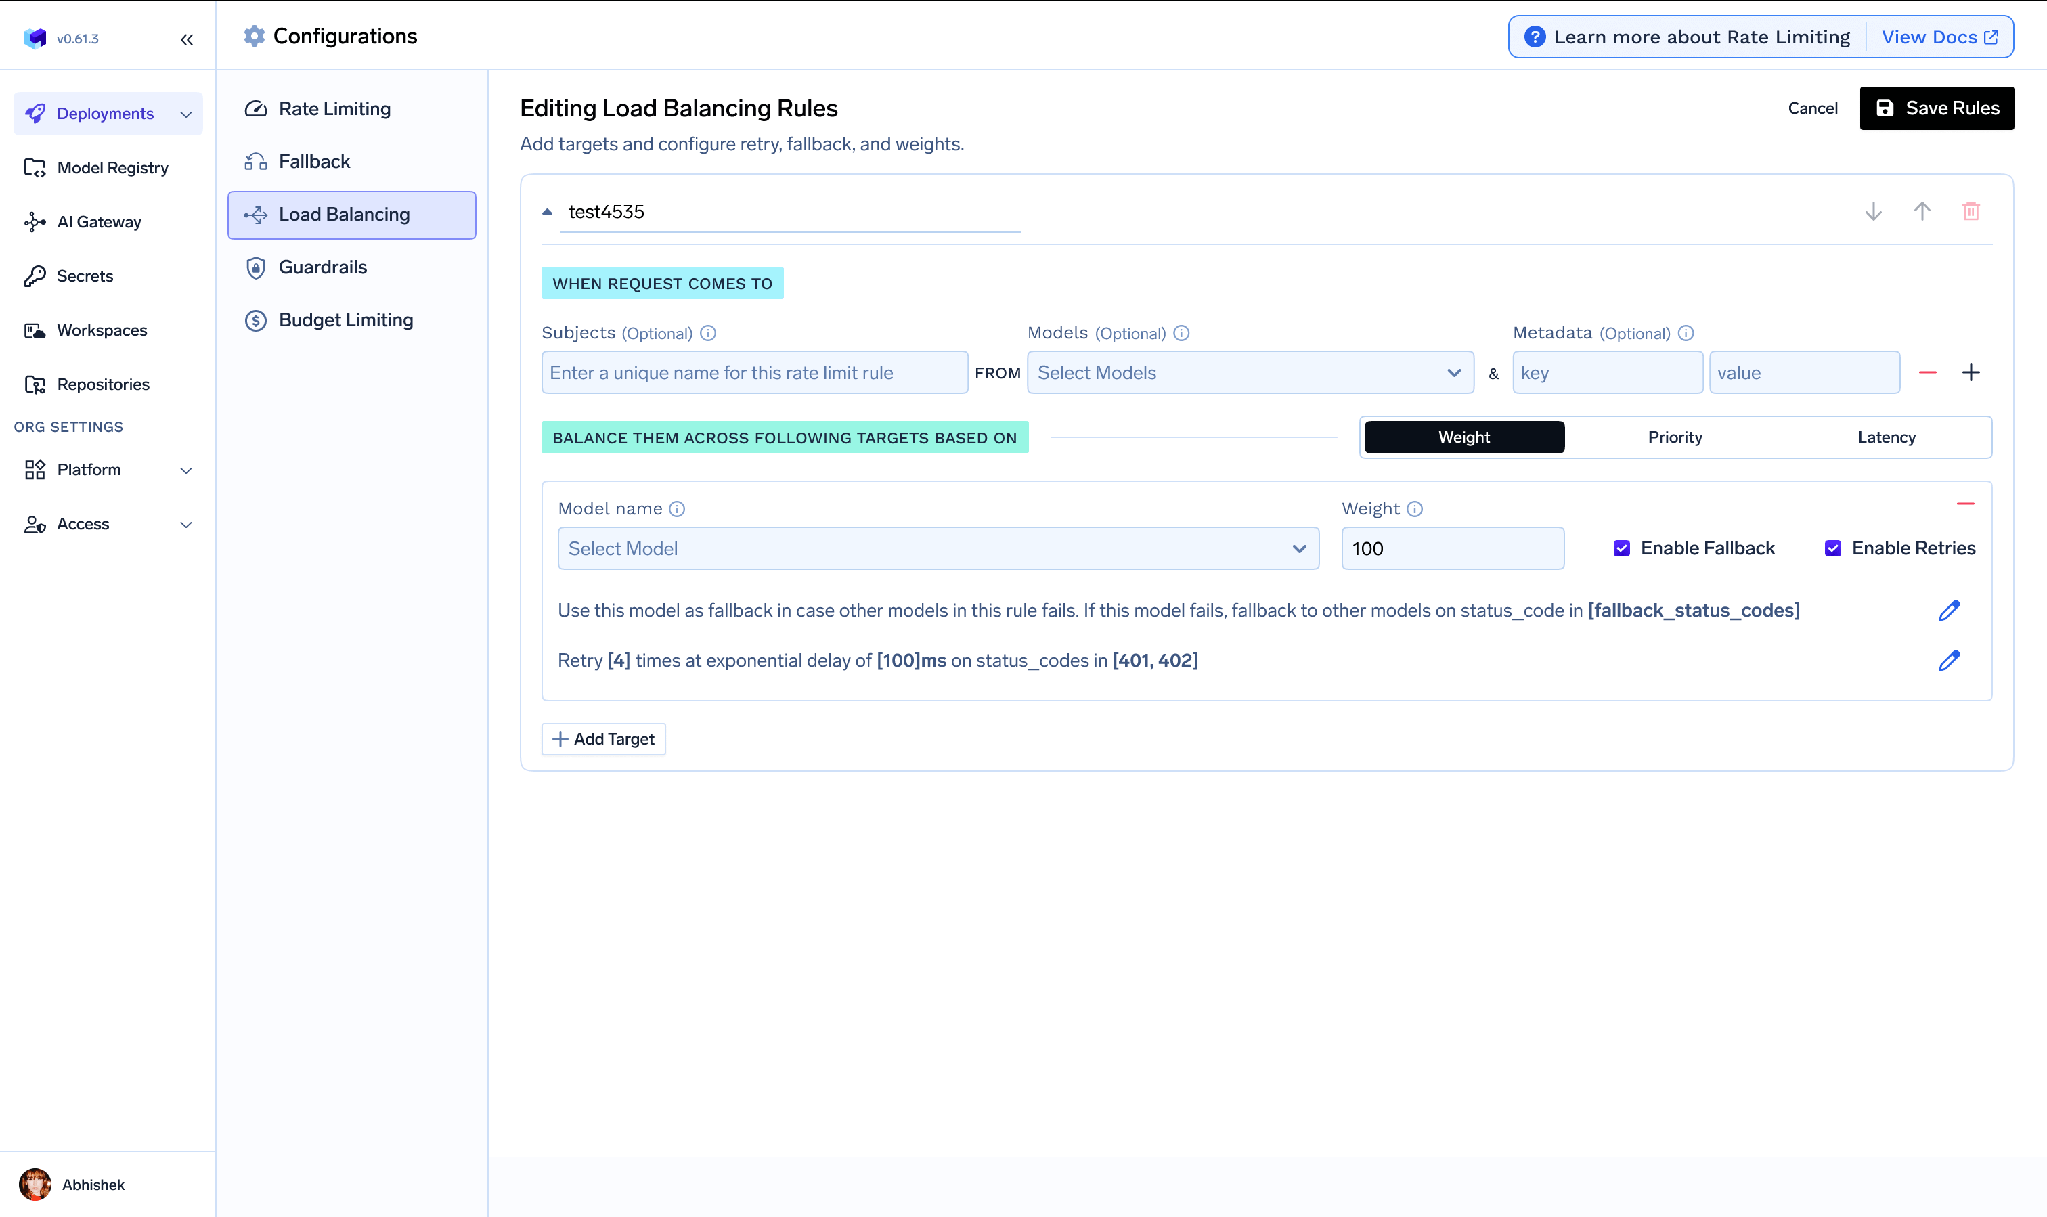
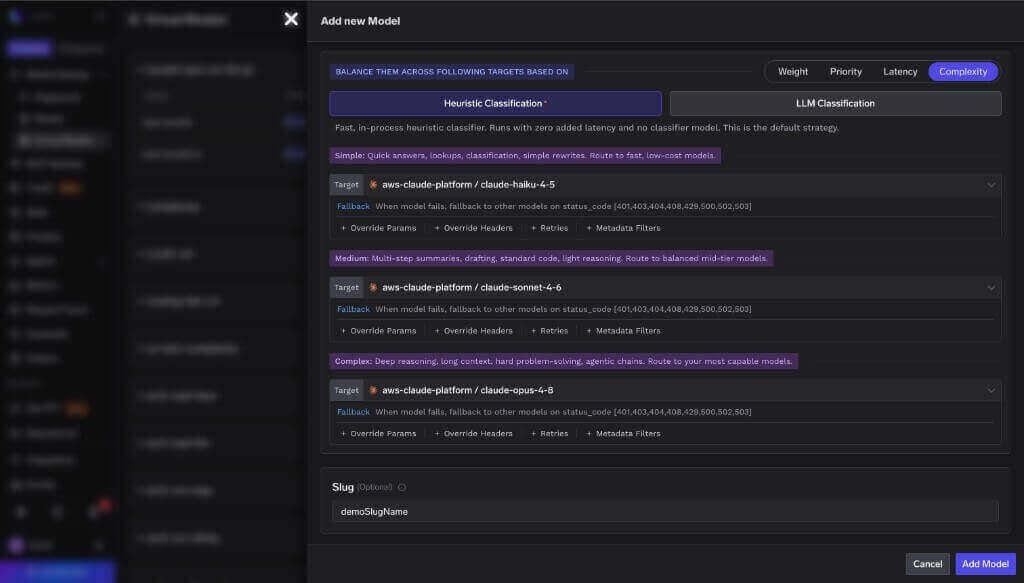
التوجيه حسب التعقيد، وليس حسب العادة. جدول الاختبارات المرجعية أعلاه هو حجة لاستخدام أسطول مختلط من النماذج وليس للهجرة الكاملة، والتوجيه المعتمد على التكلفة والجودة هو كيفية إدارة ذلك. الأعمال التعقيدية للمستودعات إلى Opus-4.8، ومهام الوكلاء الموجهة للواجهة الطرفية إلى V4-Pro، والتصنيف والاستخراج إلى نموذج أسرع وأرخص. في اختبار Auto Routing المرجعي الخاص بـ TrueFoundry عبر 550 موجه، أدى تقسيم الطلبات إلى مستويات إلى خفض التكلفة بنسبة 69% مع الحفاظ على 98% من الجودة الأساسية، مع انخفاض متوسط زمن الانتقال من 7.6 ثانية إلى 4.0 ثوانٍ؛ وعلى حركة المرور الفعلية المصممة للإنتاج وصل الخفض إلى 80%.
تطبيق نفس ضوابط الحماية (Guardrails) في كلا الحالتين. النموذج المستضاف ذاتياً لا يرث حزمة الأمان الخاصة بالمزود. تعمل ضوابط الحماية على مستوى البوابة على مسار الطلب والاستجابة بغض النظر عما إذا كان النموذج هو نقطة نهاية DeepSeek أو الـ Pod الخاص بك.

القياس قبل التعهد. معرفة تكلفة وزمن انتقال كل طلب لكل فريق هي الطريقة الوحيدة لمعرفة ما إذا كانت أسعار V4-Pro خارج أوقات الذروة أو العقدة المستضافة ذاتياً تتفوق فعلياً على ما تشغله اليوم.

النسخة المختصرة، اعتباراً من سبتمبر 2026:

إن إطلاق DeepSeek V4-Pro بشكل عام (GA) ليس مجرد قصة أرقام اختبارات مرجعية. بناءً على الأرقام التي تنشرها DeepSeek نفسها، فإنه يتفوق على Opus-4.8 في بعض مهام الوكلاء الذكيين وخسر أمامه في الأعمال الأكثر تعقيداً على مستودعات الأكواد وفي جانب المعرفة العامة، بينما ينافسه Kimi K3 على الصدارة بين النماذج المفتوحة. وعند النظر إليه كمنافس في لوحة الصدارة، فهو نموذج جيد مع نتائج غير متكافئة.
ولكن عند النظر إليه من حيث الرخصة، فإنه يمثل شيئاً آخر تماماً. نموذج بسياق 1M قريب بدرجة كافية من الفئة الرائدة ليكون خياراً حقيقياً، ومُنشور تحت رخصة MIT، مما يعني أن مسألة خيارات النشر لم تعد مجرد فرضية نظرية. يمكنك تشغيله في VPC الخاص بك، والاحتفاظ بالموجهات على البنية التحتية التي تتحكم فيها، والدفع مقابل الحوسبة بدلاً من الرموز — إذا كان معدل الاستخدام لديك يبرر عقدة عالية الأداء، وإذا كنت مستعداً لإدارة حزمة الخدمة بنفسك. بالنسبة لغالبية الفرق اليوم لن يكون ذلك مبرراً، والخطوة الصحيحة هي التوجيه إلى الـ API مع إبقاء مسار الاستضافة الذاتية مفتوحاً.
تلك هي الخلاصة المنصفة: الأمر يعود إلى ما تريد امتلاكه وإدارته. إذا كنت تريد أن يقوم شخص آخر بتشغيل النموذج، فإن النماذج المغلقة الرائدة لا تزال هي المسار الأكثر إيجازاً والأفضل في المهام الأكثر صعوبة. وإذا كنت تريد خيار نقل النموذج داخل محيطك الأمني دون إعادة كتابة التطبيق، فإن النموذج مفتوح الأوزان خلف البوابة هو كيف تشتري هذا الخيار بتكلفة منخفضة — ويجب عليك شراؤه قبل أن تحتاج إليه بالفعل.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



DeepSeek V4 هي عائلة نماذج mixture-of-experts من DeepSeek. وقد أُطلقت النسخة التمهيدية من V4، التي تشمل V4-Pro وV4-Flash، في 24 أبريل 2026. ووصل DeepSeek-V4-Pro إلى الإتاحة العامة باسم DeepSeek-V4-Pro-0813 في 13 أغسطس 2026.
الأوزان والمستودع منشوران بترخيص MIT على Hugging Face ضمن deepseek-ai/DeepSeek-V4-Pro-0813. ويشمل ذلك الأوزان والشيفرة لا بيانات التدريب، ولذلك فإن «مفتوح الأوزان» وصف أدق من «مفتوح المصدر».
حتى سبتمبر 2026: 0.66 دولار لكل مليون رمز إدخال خارج أوقات الذروة و1.32 دولار في أوقات الذروة عند عدم وجود إصابة في الذاكرة المؤقتة، و0.022 و0.044 دولار عند وجود إصابة، و1.98 و3.96 دولار لكل مليون رمز إخراج. وأوقات الذروة هي من 01:00 إلى 04:00 ومن 06:00 إلى 10:00 بالتوقيت العالمي المنسق في أيام العمل.
نعم، وتنشر DeepSeek إرشادات تشغيل لـ vLLM وSGLang. لكن كن واقعياً بشأن الحجم: فهو نموذج يضم 1.7 تريليون معامل، والإعداد المرجعي في بطاقة النموذج هو عقدة GB300 متعددة وحدات GPU.
تضيف بوابة AI Gateway من TrueFoundry نحو 3 إلى 4 مللي ثانية وتتحمل أكثر من 350 طلباً في الثانية على وحدة vCPU واحدة، وهو مقدار لا يُذكر مقارنةً بأزمنة توليد تبلغ عدة ثوانٍ.
لا، وتباين نتائج الاختبارات المعيارية أعلاه هو الحجة ضد ذلك. فالتوجيه بحسب نوع المهمة بين النماذج المفتوحة والمغلقة يكون عادةً أرخص وأفضل من الاعتماد على نموذج واحد.



أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد



















