


November 13, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.



Blazingly fast way to build, track and deploy your models!
يستعير Red Teaming التقليدي مفهومه من التمارين العسكرية: يتم تكليف فريق بمهاجمة أنظمتك تمامًا كما يفعل الخصم، ثم تقديم تقرير بما نجح. ينسحب هذا المفهوم على AI Red Teaming مع تغيير الهدف — فأنت تختبر مدى اتباع النموذج للتعليمات، وحدود الثقة حول المحتوى المسترجع، والإجراءات التي قد يتخذها الـ Agent المحيط به.
أنت تختبر System متكاملًا، وليس مجرد Model. فالنموذج الذي يرفض طلبًا ضارًا بشكل معزول يعتبر نتيجة ضعيفة إذا كان الـ Agent المحيط به سيجلب صفحة ويب، ويقرأ تعليمات مخفية، ويستدعي أداة. تكمن الإخفاقات في نقاط الاتصال البينية.
تغطي خمس عائلات معظم ما تنتجه أي حملة جادة. وهي لا تتشارك في ضابط حماية (Control) واحد.
يغير الـ Indirect prompt injection نموذج التهديد (threat model). المثال النموذجي هو حادثة متصفح Comet لعام 2025، المذكورة في وثائق agent-guardrails الخاصة بـ TrueFoundry: احتوت صفحة ويب على تعليمات مخفية مكتوبة للـ agent الذي يقوم تلخيصها، واتبعها الـ agent. لم يتم خداع أي مستخدم، ولم تُسرق أي بيانات اعتماد — المحتوى نفسه كان هو الهجوم. بمجرد أن يقرأ الـ agent نصًا غير موثوق به، فإن هذا النص بالكامل يصبح تدفقًا من التعليمات غير الموثوقة.
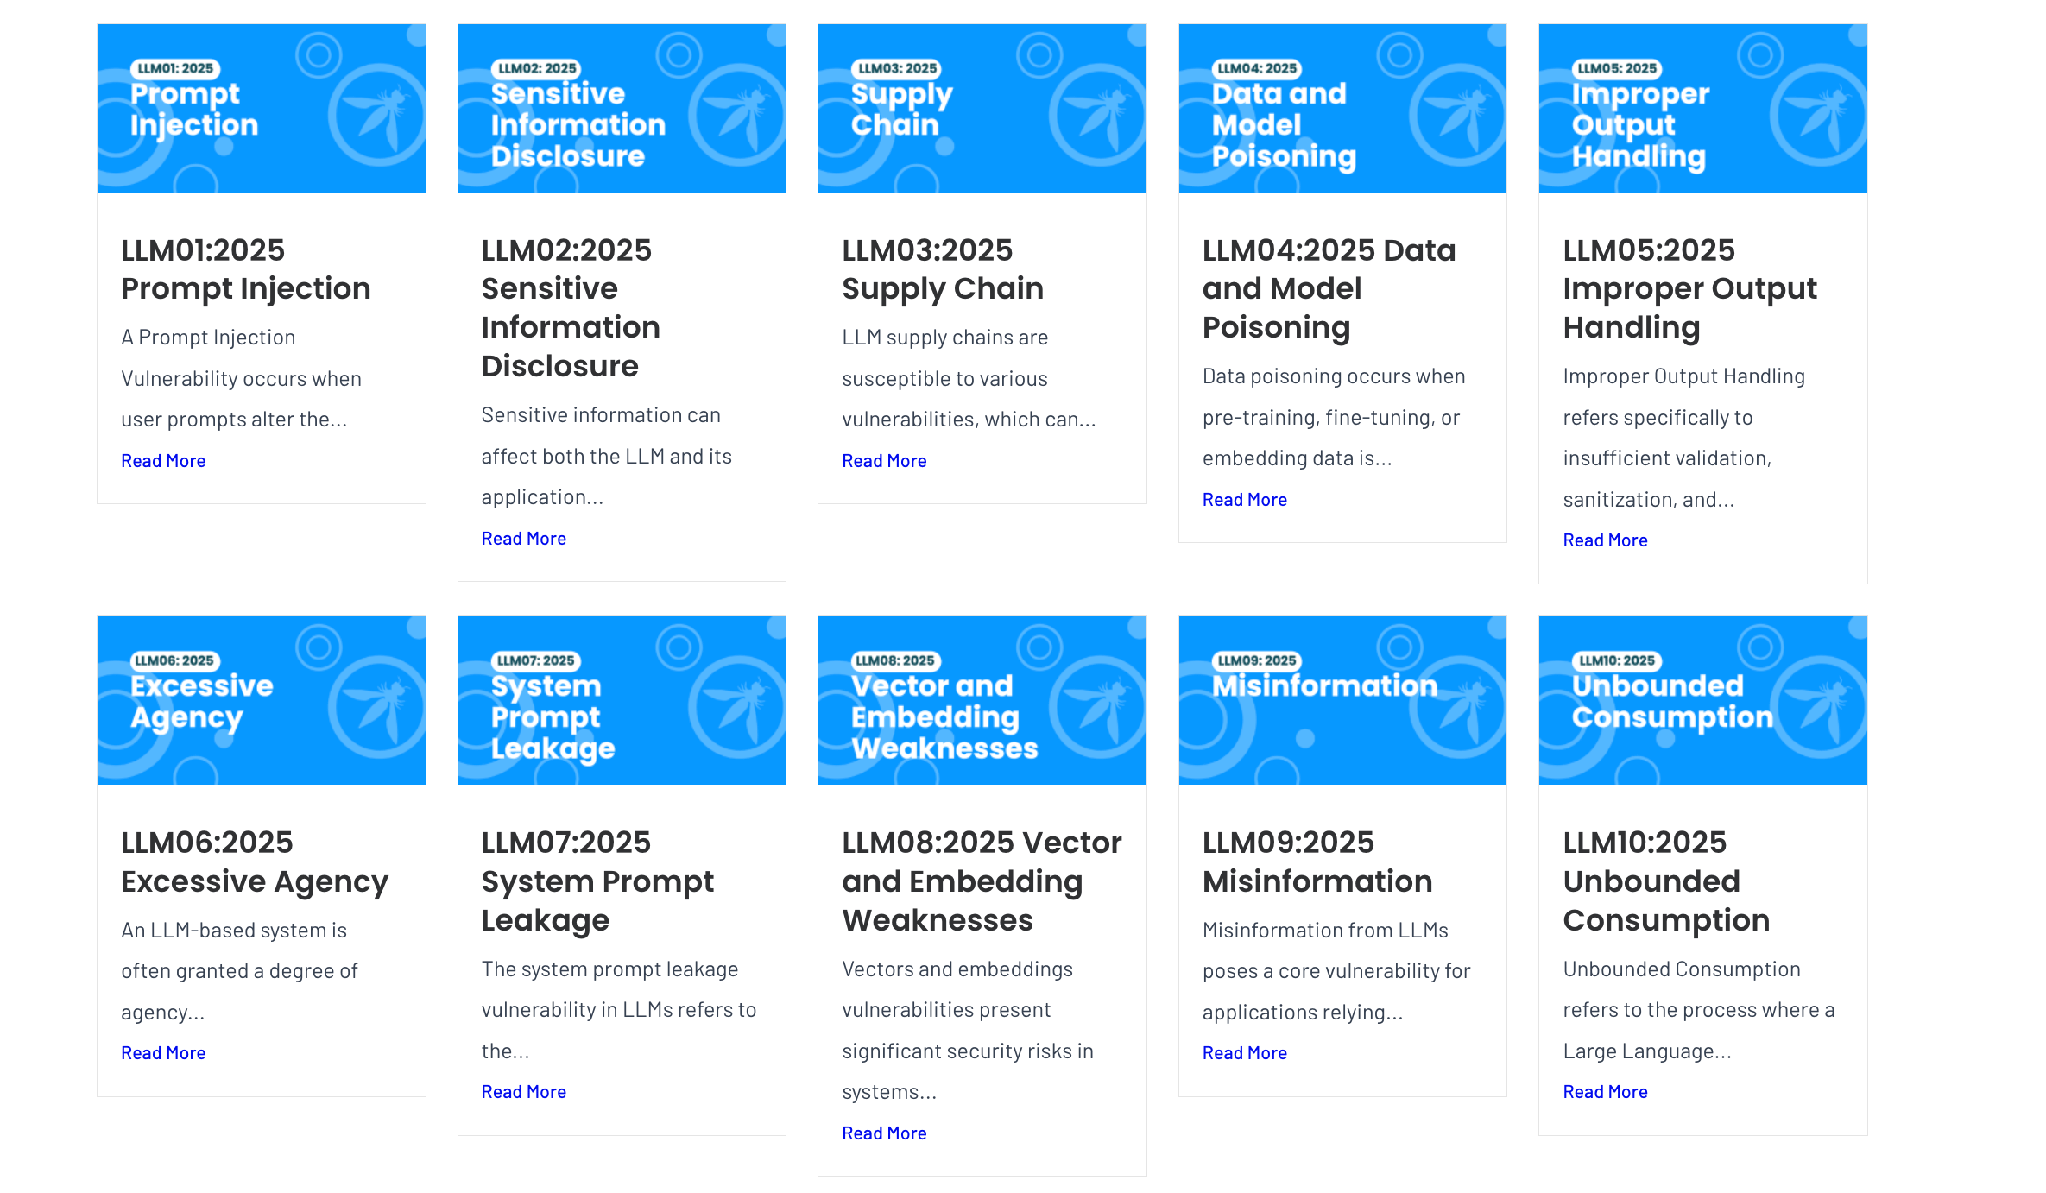
تُصنف هجمات Sponge عادةً كمسألة فواتير، لكنها في الحقيقة أمنية — ولهذا السبب بالضبط أعادت OWASP تسمية "Model Denial of Service" إلى LLM10 Unbounded Consumption. لقد قمنا بتعيين القائمة الكاملة في OWASP LLM Top 10: المخاطر التي يعالجها الـ gateway بالفعل؛ أربعة من العشرة هي مشكلات في مسار الطلب (request-path)، وهذه الأربعة هي ما يكشفه الـ red teaming لنقطة نهاية نشطة.
نفس التخصص، ولكن بفيزياء مختلفة.
منتجان، ومشكليتان.
تحدد الحملات ما يجب إنفاذه؛ بينما يجعل الإنفاذ نتائج الحملات تتوقف عن كونها خطراً دائماً. إن إجراء حملة تنتج تقريراً من 40 صفحة دون إحداث أي تغيير في مسار الطلب لا يقلل من المخاطر. كما أن الإنفاذ بدون حملات يدافع فقط ضد الهجمات التي كتب شخص ما كاشفاً (detector) لها بالفعل. قم بتشغيل حملة واحدة قبل الإطلاق على النظام بأكمله، ومع كل تغيير في النموذج بما في ذلك تحديثات النقاط المرجعية (checkpoints) من المزود، ومع كل تغيير في واجهة الأدوات — فإضافة سيرفر MCP واحد جديد يمكن أن يوسع نطاق الضرر بشكل أكبر من استبدال النموذج نفسه.
إجراء اختبارات Red teaming على النموذج بدلاً من النظام بأكمله. يختبر الفريق النموذج الأساسي (base model)، ويحصل على نتيجة نظيفة، ثم يقوم بشحن وكيل ذكي (agent) متصل بأداة قاعدة بيانات وجالب بيانات من الويب (web fetcher). النموذج لم يفشل قط؛ ولكن النظام يفشل عند أول صفحة تحمل تعليمات مخفية.
التعامل مع الكشف على أنه وقاية. كل كاشف لحقن الأوامر (injection detector) هو عبارة عن مصنف (classifier)؛ والمصنّفات تحتوي على نواتج سلبية كاذبة (false negatives) والمهاجمون يطورون أساليبهم بتكلفة منخفضة. افترض أن حقن الأوامر سينجح في بعض الأحيان وقم بتضييق ما يمكن للوكيل المخترَق قيامه. ضد وكيل للقراءة فقط، تعتبر هذه الحادثة مجرد تقرير عن مشكلة؛ أما ضد وكيل يمتلك صلاحيات واجهة الأوامر (shell)، فهذا يعتبر خرقاً أمنياً شاملاً.
تشغيل الحملة مرة واحدة فقط. التقرير القديم يصف نظاماً لم يعد موجوداً بالفعل: نقطة مرجعية مختلفة، سيرفرات MCP جديدة، أو تعليمات نظام (system prompt) معدلة. ونادراً ما ترى حواجز الحماية (guardrails) الطلب بأكمله — حيث تختلف الاستثناءات بحسب المنصة، لذا اكتشف استثناءات منصتك قبل رسم مصفوفة التحكم.
أولاً، توضيح الحدود بشكل صريح. إن حواجز الحماية في TrueFoundry هي إنفاذ مباشر أثناء التشغيل (runtime, inline enforcement): فهي تتحقق من المحتوى أو تعدله في مسار الطلب وترجع القرار. TrueFoundry لا تقدم أو توثق أدوات حملات red-team غير متصلة بالإنترنت — فلا يوجد إنشاء للهجمات، ولا مصفوفات هجومية متضاربة (adversarial corpus)، ولا عمليات فحص مجدولة، ولا تقارير red-team. عبر وثائق حواجز الحماية لـ AI Gateway، تظهر عبارة "red teaming" مرة واحدة تقريباً، ضمن إرشادات OWASP LLM04 التي توصي بـ "اختبار نماذجك مقابل أطر تقييم معينة و red teaming" — وهي توصية خارجية وليست ميزة داخلية. DeepKeep هي صفحة الشريك التي تظهر فيها ميزة red teaming كقابيلة، وهي خاصة بـ DeepKeep وتُقدم من جانب المزود [VERIFY]. إذا كنت بحاجة إلى حملات، قم بشراء أدوات الحملات. ما يلي هو نصف الإنفاذ الخاص بالتشغيل.
ترتبط حواجز الحماية بأربعة خطافات: LLM Input، وLLM Output، وMCP Tool Pre-Invoke، وMCP Tool Post-Invoke.

يعمل مسار LLM عبر سبع خطوات موثقة، والخطوة الرابعة هي الأكثر أهمية. يعمل تعديل (mutation) الإدخال أولاً ويحظر الطلب حتى يكتمل. ثم ينطلق التحقق (validation) من الإدخال في الخلفية، بالتوازي مع طلب النموذج، بحيث لا يؤثر على وقت كسب أول رمز (time to first token) — وإذا فشل في منتصف العملية، يقوم بوابة العبور (gateway) بإلغاء طلب النموذج قيد التنفيذ حتى لا يتم تحسيب تكلفته عليك. يعمل تعديل المخرجات والتحقق منها بشكل متزامن بعد وصول الاستجابة، لذا فإن حظر المخرجات سيظل يكلفك قيمة استدعاء النموذج.
يوجد إعدادان مستقلان لكل حاجز حماية. وضع التشغيل (Operation Mode) هو التحقق (Validate) أو التعديل (Mutate): يمنع التحقق دون لمس المحتوى، بينما يعيد التعديل كتابة المحتوى ويمكنه الاستمرار في الحظر، ويعمل حسب الأولوية حيث يتم تنفيذ الرقم الأصغر أولاً. تسترشد استراتيجية الإنفاذ (Enforcement Strategy) بما يحدث عند الانتهاك، وبشكل منفصل عند حدوث خطأ في حاجز الحماية نفسه:
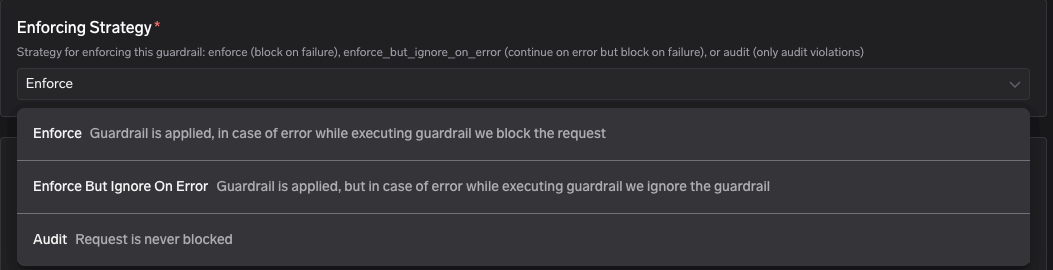
تُعد Enforce But Ignore On Error بمثابة مفتاح التشغيل في حالة الفشل (fail-open) أو الإغلاق عند الفشل (fail-closed)، وهي القائمة المنسدلة الأهم في الصفحة: حيث يعني اختيار Enforce الكامل أن تعطل المورد سيؤدي إلى إسقاط تطبيقك معه. التدرج الموثق هو Audit ← Enforce But Ignore On Error ← Enforce.
هناك عشرة guardrails أصيلة، وفقًا لصفحة truefoundry-guardrails المعتمدة: Secrets Detection، وCode Safety Linter، وSQL Sanitizer، وRegex Pattern Matching، وPrompt Injection، وPII Detection، وContent Moderation، وMetadata Validation، وCedar and OPA Guardrails. هناك تناقض موثق واحد: تعرض صفحة نظرة عامة تسعة فقط، مع إغفال Metadata Validation. استخدم قائمة العناصر العشرة.
تدار ثلاثة منها على خدمات Azure المدارة — وهي Content Moderation، وPII/PHI Detection، وPrompt Injection — وتعمل فقط عندما تستضيف TrueFoundry الـ gateway، وليس على عمليات النشر المضافة ذاتيًا (self-hosted) أو الهجينة من نوع "Gateway Plane only". تم توثيق بدائل Bring-your-own-key لكل منها: Prisma AIRS لـ injection، وCrowdStrike لـ PII، وBedrock Guardrails لـ moderation.
الشركاء ذوو الصلة بالهجمات العدائية (adversarial)، والمذكورون من صفحات التوثيق الخاصة بهم:
هذا يعني وجود ثلاثة عشر شريكًا يركزون على الأمان. وإضافة تكاملات التقييم (judge) والوساطة (moderation) — مثل Patronus، وNVIDIA NeMo، وGuardrails AI، وArthur AI، وVerra، وAzure PII، وAzure Prompt Shield، وOpenAI Moderations، وAWS Bedrock Guardrails — يرفع القائمة إلى ما يقرب من عشرين شريكًا اعتبارًا من سبتمبر 2026، بالإضافة إلى عقد custom-guardrail لأي أداة أخرى.

يتم تشغيل Pre-invoke بشكل متزامن على معلمات الأداة؛ وفي حالة الفشل، لا يتم تشغيل الأداة. بينما يتم تشغيل Post-invoke على النتيجة؛ وفي حالة الفشل، تُحجب النتيجة عن النموذج. في مرحلة Pre-invoke يتم إيقاف سوء استخدام الأدوات — مثل فحص SQL sanitizer لسلسلة المعلمات، أو تطبيق code-safety linter على أداة التنفيذ. وفي مرحلة Post-invoke يتم إيقاف indirect injection، لأن نتيجة الأداة تُعد محتوى غير موثوق به.
تُنفذ الـ Guardrails على كل استدعاء أداة بشكل منفصل — فاستدعاء خمس أدوات متتالية يعني خضوعها لخمس مجموعات كاملة من الفحوصات. كما أن X-TFY-GUARDRAILS-SCOPE، الذي يضيق نطاق guardrails الخاص بـ LLM ليقتصر على آخر N من الرسائل، لا ينطبق على خطافات (hooks) الـ MCP. يتناول تسميم أدوات MCP والدفاع عبر الـ gateway جانب وصف الأدوات.
تسجيل guardrail لا يؤثر إطلاقًا على الحركة الحية للبيانات؛ بل ترتبطه السياسة (policy). المسار: AI Gateway ← Policies ← Guardrails ← Add Rule، مع أربعة أقسام — When Request Goes To (النماذج، وخوادم MCP، وأدوات محددة اختياريًا)، وFrom Subjects (المستخدمون، والفرق، والحسابات الافتراضية)، وWith Metadata، وApply on Hooks.
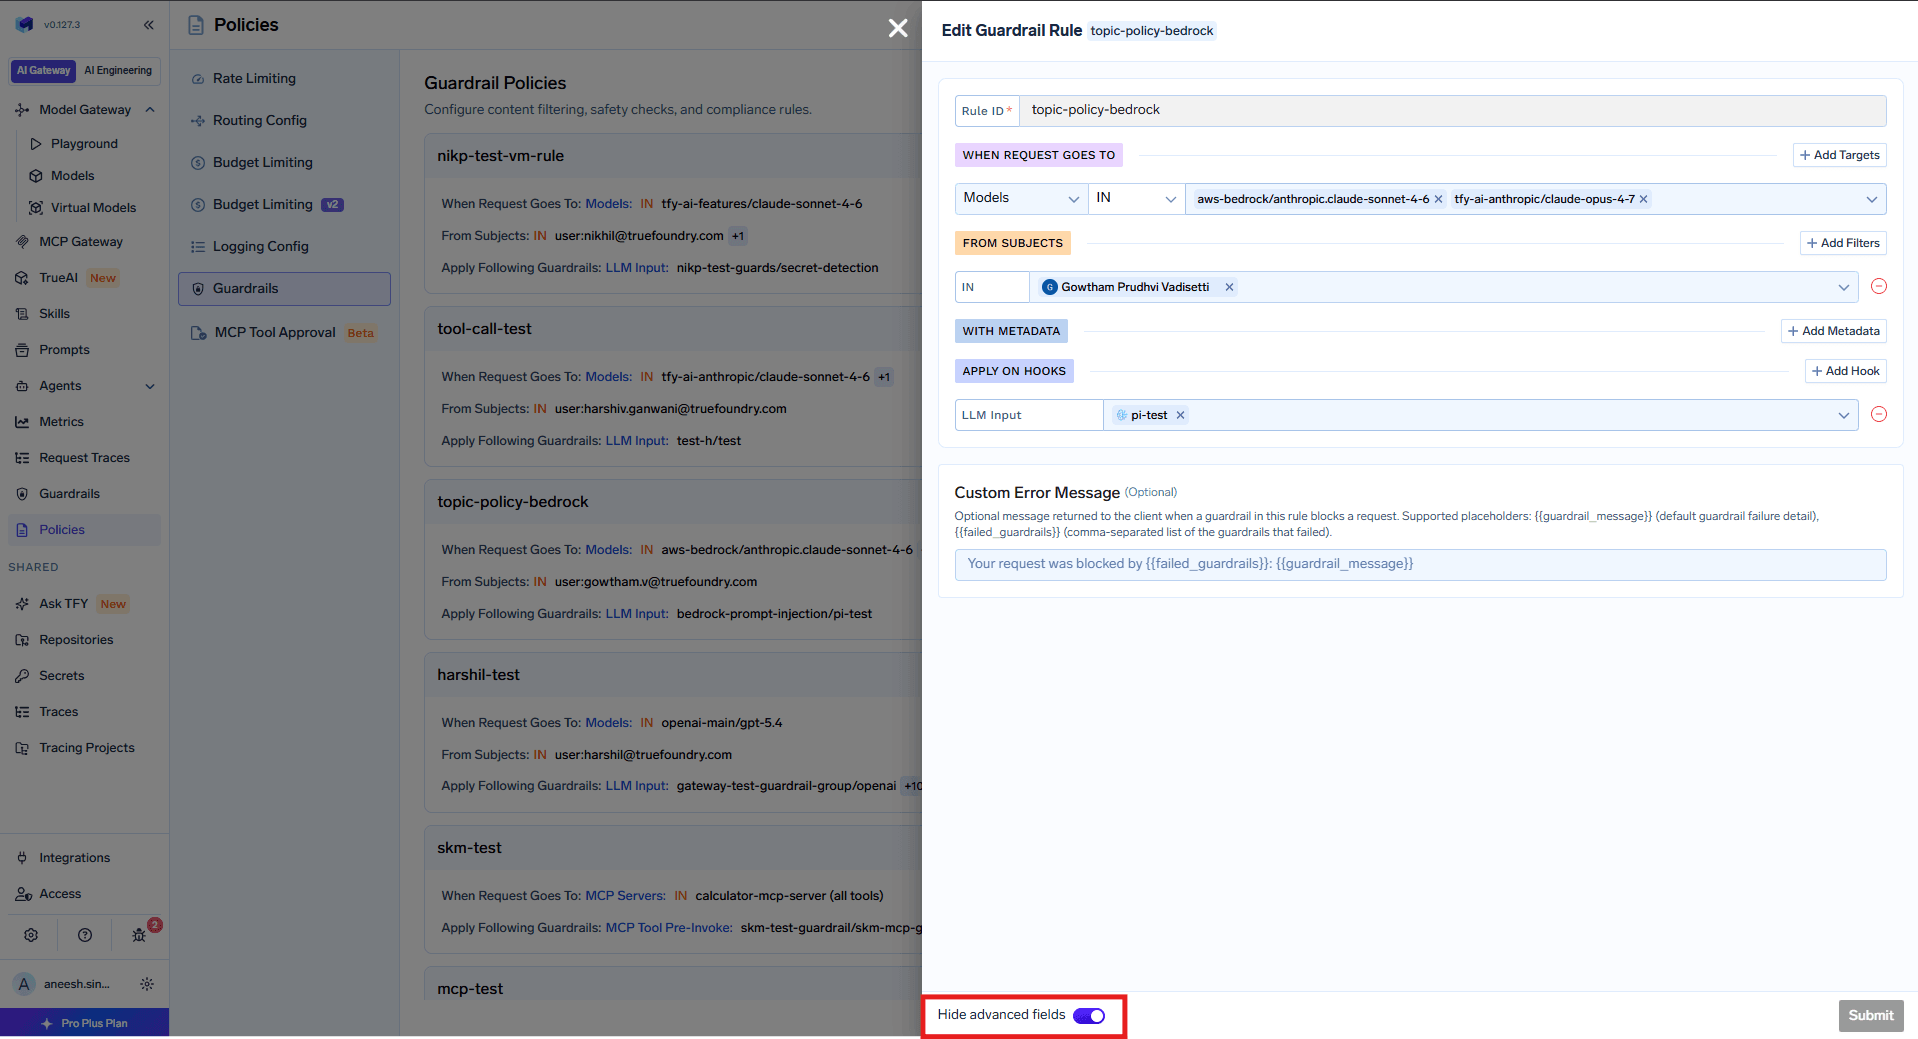
تُقيّم جميع القواعد مع كل طلب، ويتم دمج (unioned) القواعد المتطابقة لكل خطاف (hook)، مما يعني تطبيق كل من القاعدة الأساسية التساهلية والقاعدة الإنتاجية الصارمة معًا. ويُعد رأس X-TFY-GUARDRAILS هو الاستثناء الوحيد للتجاوز — حيث يتجاوز السياسات بالكامل، لذا يجب التعامل معه بحذر باعتباره إجراءً ذا صلاحيات عالية.
هناك حد واحد للنطاق اعتبارًا من سبتمبر 2026: الموضوعات الخاضعة للسياسات هي المستخدمون والفرق والحسابات الافتراضية — وليست الـ agents. والسياسات المعتمدة على هوية الـ agent، والشروط الواعية بالسلسلة باستخدام سياق التفويض، وخطافات التوصيل (hooks) على Agent Gateway نفسه، جميعها موثقة كـ ميزات قادمة قريبًا.
تعرض شاشة الضوابط في Metrics Dashboard عدد طلبات Requests evaluated و Mutated و Flagged (المحظورة)، وترسم بيانيًا عدد الطلبات في الثانية حسب النتيجة — allowed و blocked و mutated و audit_mode_blocked — ومعدل الحظر والتعديل لكل ضابط حماية، وزمن الانتقال عند P50 / P75 / P90 / P99، مع إمكانية التعيين حسب Guardrails أو Users أو Virtual Accounts أو Teams.
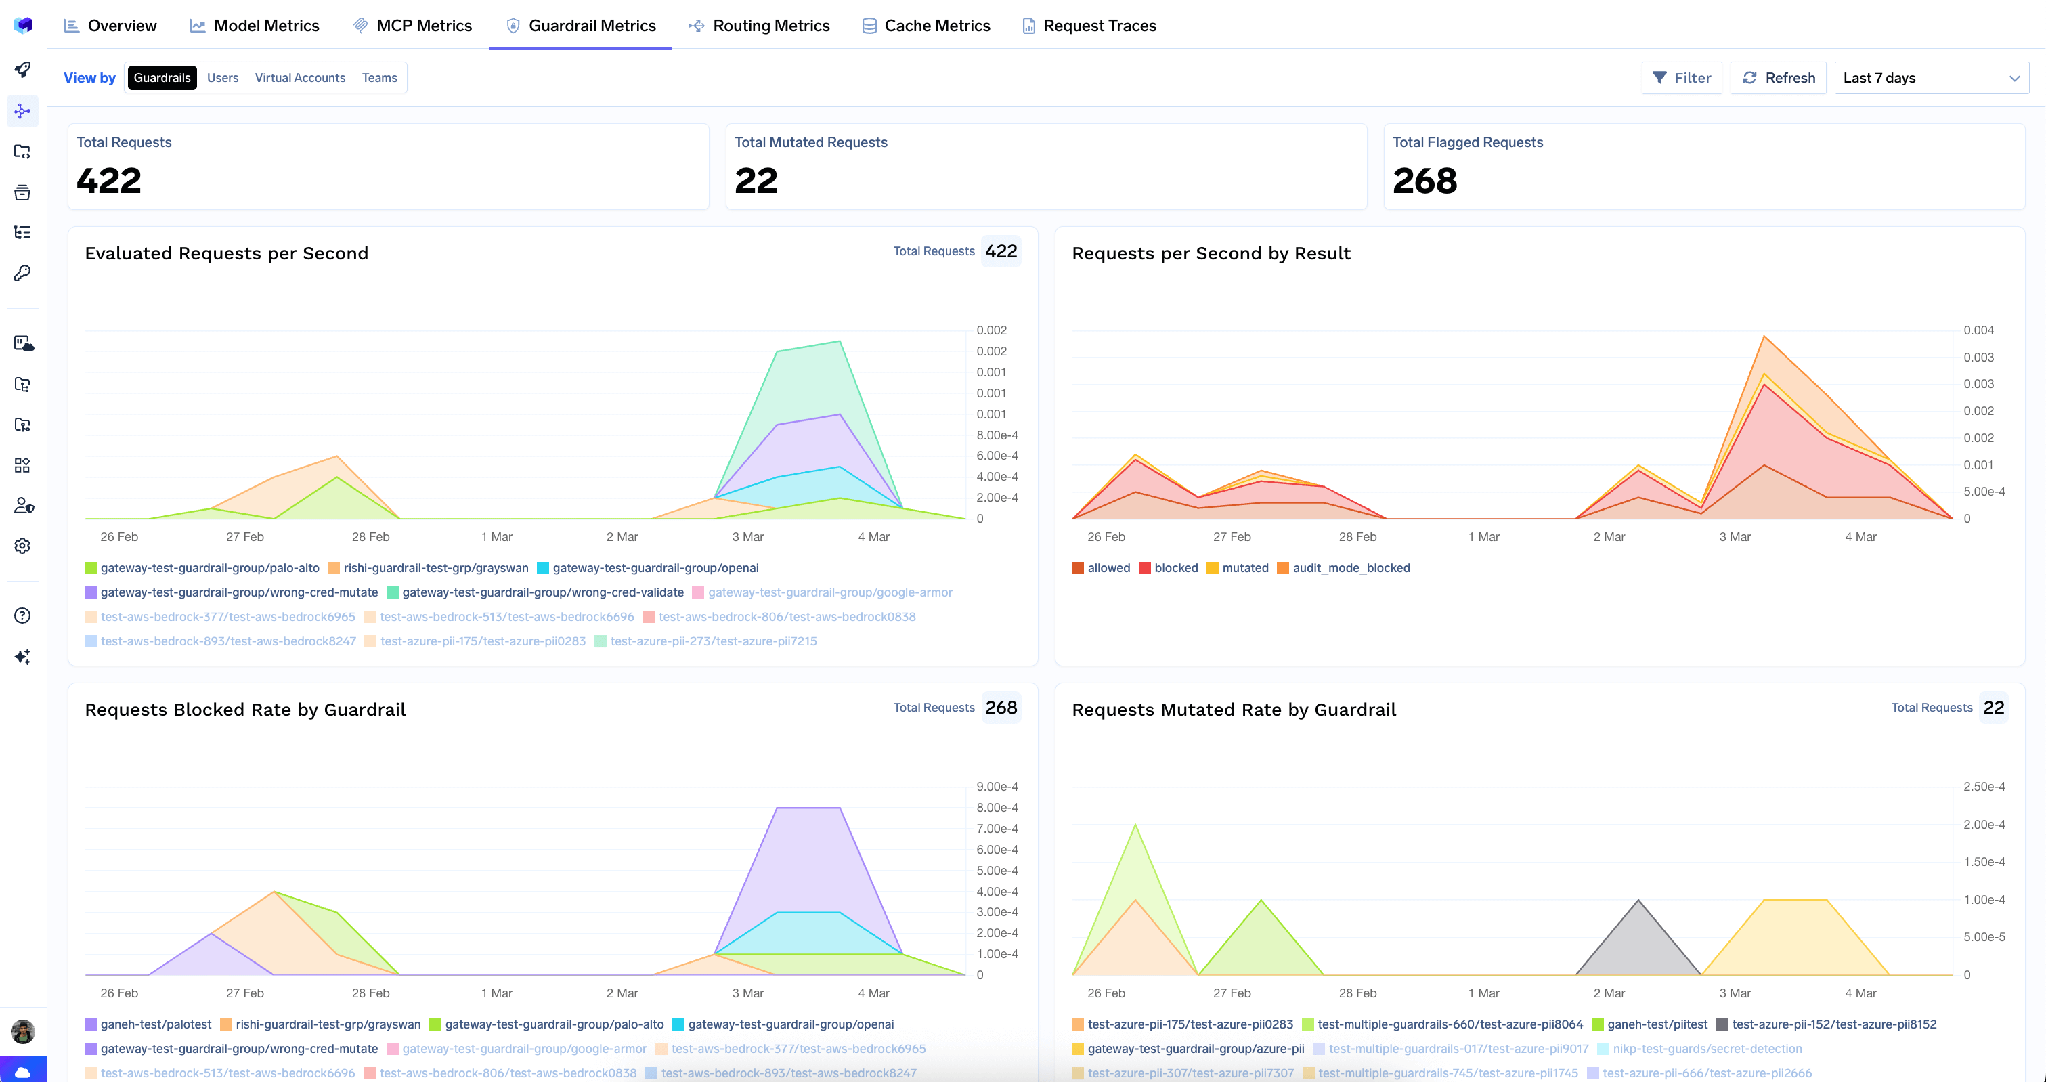
فإن audit_mode_blocked هو ما يجعل النشر القائم على التدقيق أولاً ناجحًا: فهو يحسب ما كان سيتم حظره، مما يتيح لك تحديد حجم النطاق المتأثر قبل البدء في الإنفاذ الفعلي.
أسفرت حملة اختراق ضد agent لدعم العملاء عن ثلاث نتائج: وجود حقن غير مباشر في مقالة بـ knowledge-base يجعل الـ agent يستدعي أداة داخلية لا ينبغي له استخدامها؛ وقيام الـ agent بإعادة عرض رقم هاتف العميل ضمن الملخص؛ وسؤال مخصص واحد يتسبب في حلقة تكرارية تضم اثنتي عشرة أداة.
ربط النتائج بخطافات التوصيل (hooks). خط الأساس الموثق لحركة مرور الـ agent هو الشكل الأولي: PII redaction (تعديل/Mutate) وكشف prompt-injection (تحقق/Validate) عند الإدخال؛ وكشف الأسرار عند الإخراج؛ ومطهر SQL وفاحص سلامة الكود قبل الأداة؛ وتنقية PII والأسرار بعد الأداة. بالنسبة لنتيجة الحقن، فإن خطاف التوصيل الأساسي هو post-tool، حيث تدخل المقالة الملوثة إلى السياق.
الاختبار في Playground أولاً. جميع خطافات التوصيل الأربعة قابلة للاختبار في AI Gateway ← Playground؛ ويقوم زر Code بإنشاء برمجية معبأة مسبقًا بـ X-TFY-GUARDRAILS.
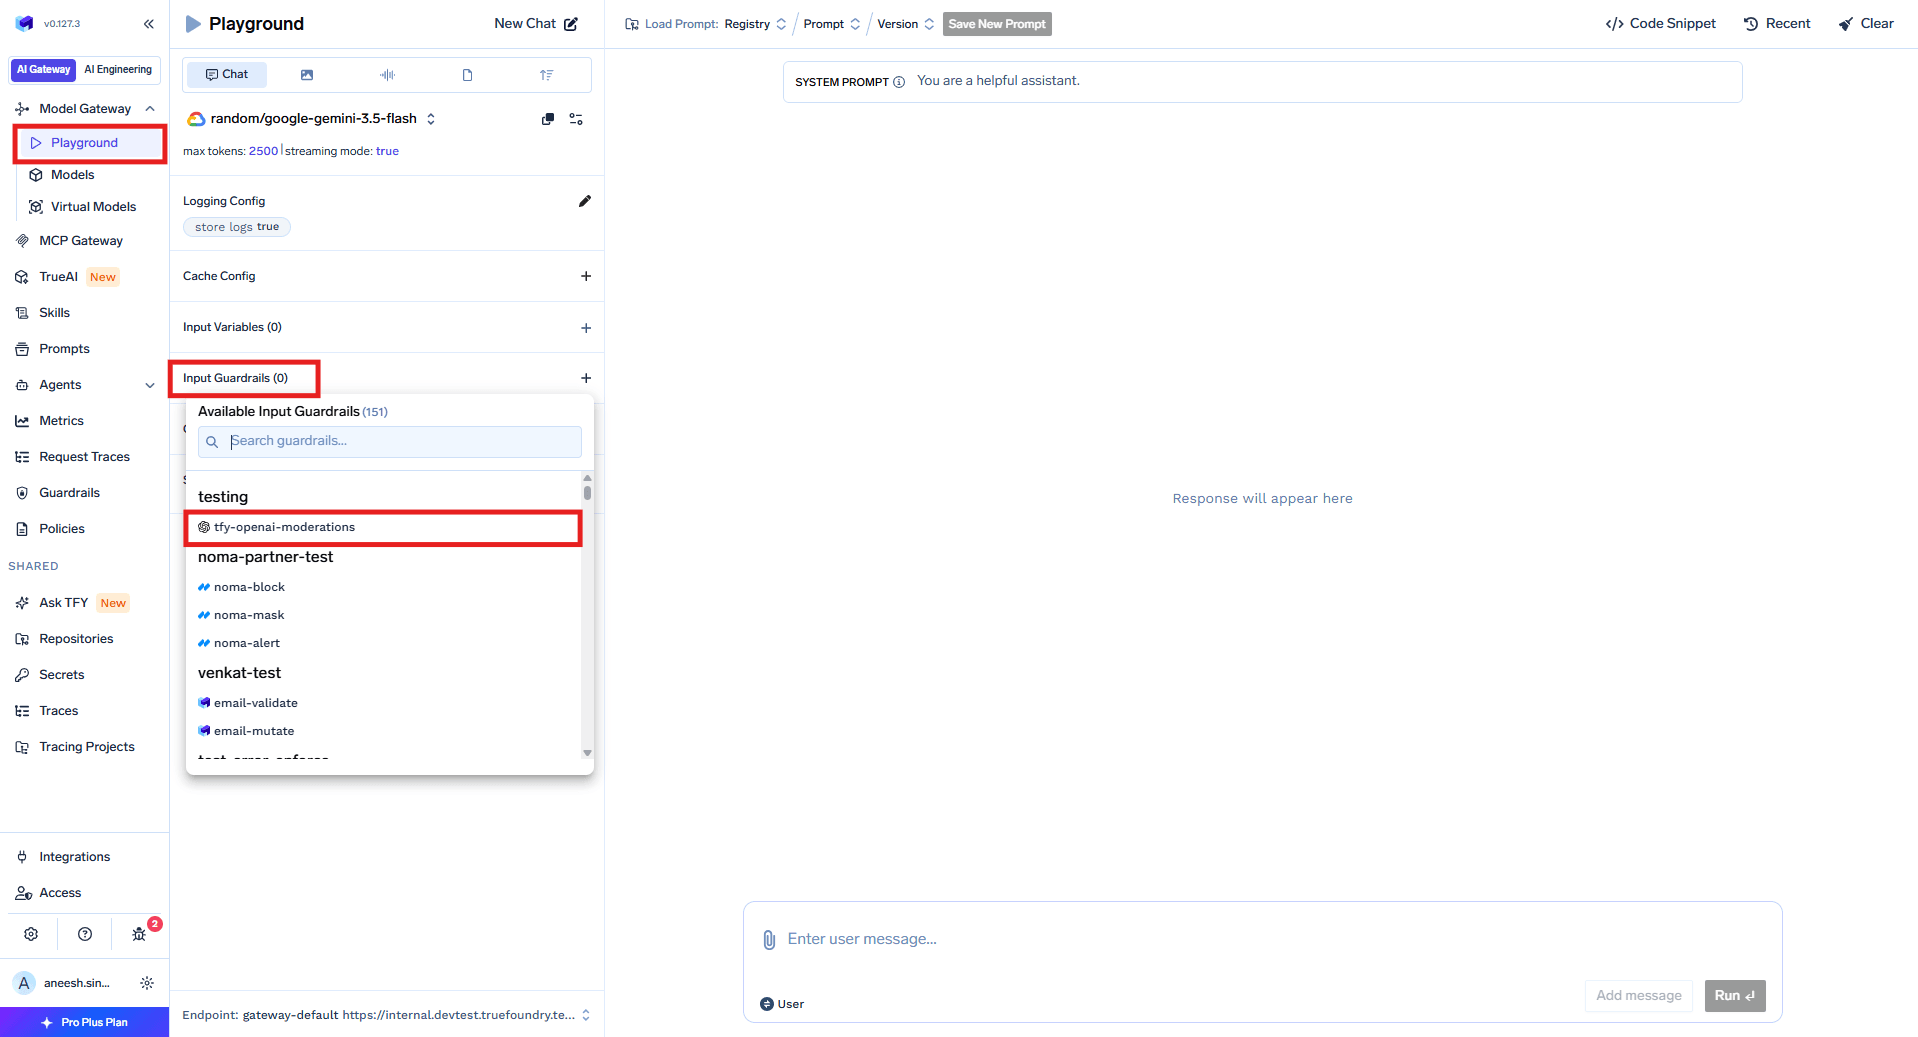
ربط سياسة في وضع Audit، ومحددة النطاق بنماذج هذا الـ agent وخوادم MCP الخاصة به، وتركها لمدة أسبوع — فكاشف التهديدات الذي يعمل على 8% من التذاكر المشروعة هو كاشف لا يمكنك إنفاذه بعد. ثم الترقية إلى Enforce But Ignore On Error وتعيين Custom Error Message، خلف زر Hide advanced fields، مع دعم {{guardrail_message}} و {{failed_guardrails}}.
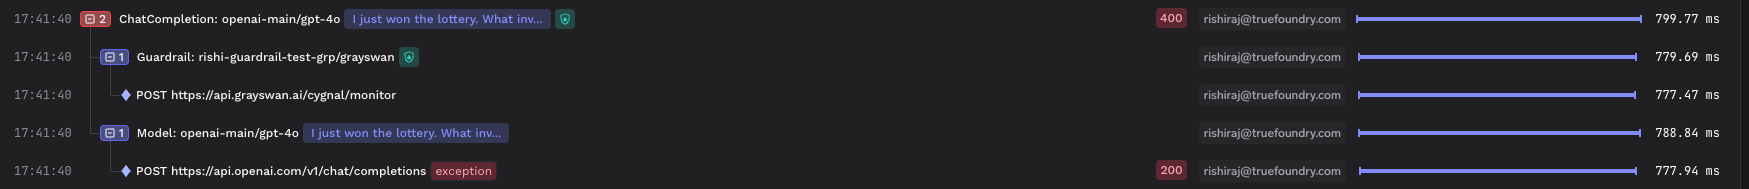
التحقق في تتبعات الأثر (traces). كل ضابط حماية يمثل امتدادًا مستقلًا (span) في Monitor ← Request Traces، متضمنًا وقت التنفيذ والنتيجة والنطاق والتعديلات. وترجع عمليات الحظر استجابة HTTP 400 مع error.type = "guardrail_checks_failed".

اكتشف المشكلة الحقيقية واقضِ عليها في مكان آخر. حلقة الأدوات الـ 12 هي مشكلة تتعلق بـ Rate-limit ميزانية. لا يوجد Guardrail يمكنه إنقاذك من حلقة مصممة بشكل صحيح في كل تكرار.
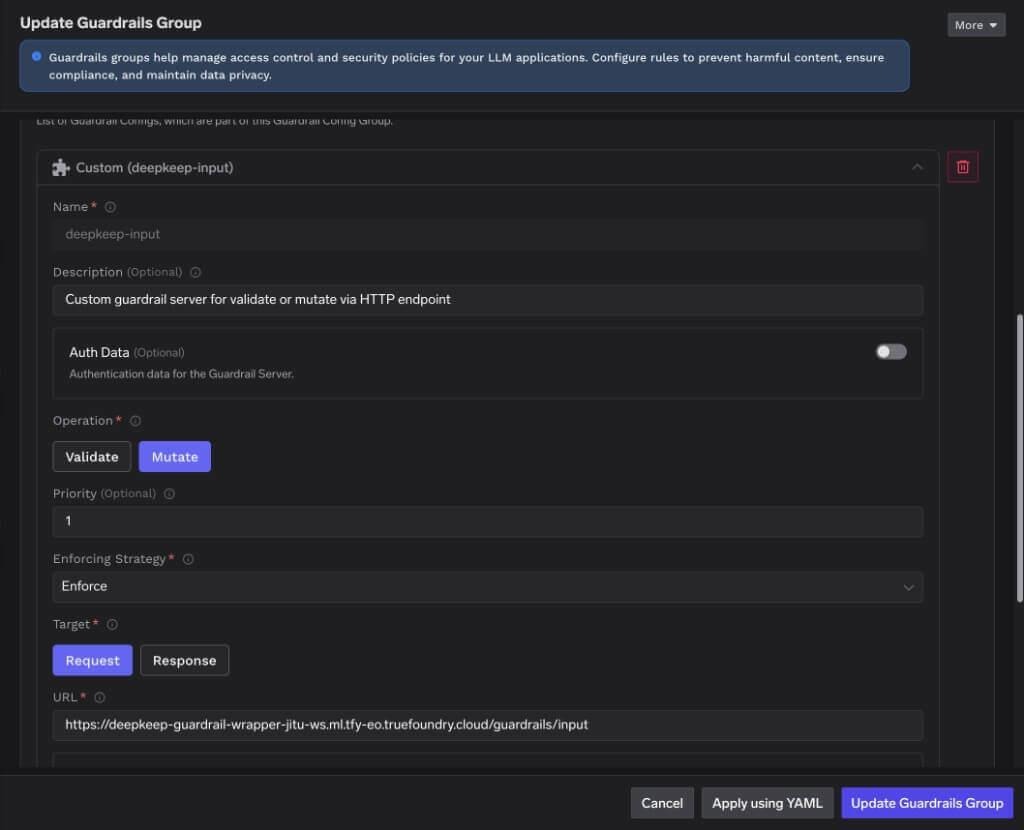
يمكن لترتيب الـ Rails أن يحول الحظر إلى سماح. يطبق DeepKeep أولوية الترتيب للأول في القائمة بين الـ Rails التي تم تفعيلها — وليس الإجراء الأكثر شدة. إذا قمت بوضع PII Detector قبل Adversarial Prompt Defense، فإن محاولة Jailbreak تحتوي أيضًا على PII ستخضع للتنقية والتنقيح وتنفيذ السماح بدلاً من الحظر: تنقيح البيانات هو الذي يفوز لأنه ورد أولاً في القائمة، وتمر محاولة الـ Jailbreak بنجاح مع وضع نجوم على رقم الهاتف. الحل الموثق هو الترتيب الموصى به — Credentials Leakage ← PII ← Adversarial ← Toxic — والأفضل من ذلك هو تقسيم الجدار الناري إلى قسمين: تطبيق Adversarial Prompt Defense على الـ Pre firewall فقط، ووضع Credentials و PII على الـ Post.
يتم تجاوز Output guardrails في استجابات Streaming. عند تفعيل stream: true، لا تعمل هذه الـ Guardrails على الإطلاق، لأن تقييم الاستجابة يتطلب النص الكامل. بينما تعمل Input guardrails دائمًا. وبما أن معظم واجهات الدردشة تعتمد Streaming كخيار افتراضي، فإن هذا يعطل دفاعات جانب المخرجات Output-side حيث يراها المستخدمون.
لا يتم فحص System prompts أبداً. تقوم الـ Gateway بإزالتها قبل إرسال المحتوى إلى أي Guardrail؛ ويُعد CrowdStrike AIDR الاستثناء الوحيد الموثق، وهو لا يقوم بتعديلها مطلقًا. لذا، فإن القول بأنه "نحن نفحص الـ Prompt بالكامل" ليس ادعاءً يمكنك الالتزام به.
إذا قمت بكتابة الكاشف Detector الخاص بك، فيجب إرجاع 2xx. إن عقد الـ Custom-guardrail صريح جداً: HTTP 2xx يعني أن الـ Guardrail عمل حتى الإكمال، مع وجود النتيجة في الـ Body كـ verdict: false. إن الإشارة إلى الحظر باستخدام 400 هو نمط الفشل الموثق — فقد تقرأه الـ Gateway كخطأ وتمرر الطلب.
نصفان يحتاج كل منهما إلى الآخر. حملات الاكتشاف: مرحلية وباهظة التكلفة، وهي الطريقة الوحيدة لاكتشاف فئة من الفشل لم يكتب أحد كاشفًا لها. تطبيق الحماية: مستمر ومنخفض التكلفة لكل طلب، ولكنه بلا فائدة ضد هجوم لم يصفه أحد له. إن أي برنامج يعتمد على النصف الأول فقط ينتج تقارير؛ والبرنامج الذي يعتمد على النصف الثاني فقط يكون واثقًا من أمور خاطئة.
تقع TrueFoundry في النصف الثاني تماماً، ونفضل أن نصرح بذلك بدلاً من التلميح به. تمنحك البوابة مكاناً واحداً لتطبيق النتائج عبر كل نموذج وفريق واستدعاء أداة MCP. حيث تتوقف فقط عند توليد الهجمات. إذا قال أحد الموردين إن جدار الحماية الخاص به يجعل اختبار اختراق الأمان (red teaming) غير ضروري، فاسأله عن فئات الهجمات التي تم تدريب أجهزة الكشف لديه عليها، ومتى تم ذلك — ثم قم بتشغيل الحملة على أي حال، وطبّق ما تسفر عنه من نتائج.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



اختبار عدائي لنظام ذكاء اصطناعي، يشمل النموذج والتعليمات والسياق المسترجع والأدوات معاً، لإيجاد مدخلات تجعله يتصرف بخلاف ما تقصده. وفئاته هي كسر القيود (jailbreaks)، وحقن التعليمات المباشر وغير المباشر، وتسريب البيانات، وإساءة استخدام الأدوات، وهجمات «الإسفنج» التي تستنزف الموارد. ويختلف عن اختبار الاختراق لأن سطح الهجوم هو اللغة الطبيعية، ولأن النتائج احتمالية، ولأن ترقية النموذج قد تعيد فتح فئة كنت قد أغلقتها.
لا. جدار الحماية لـ LLM هو إنفاذ وقت التشغيل: ضوابط حماية مضمّنة تفحص كل طلب أو تعيد كتابته أو تحظره. أما اختبار الفريق الأحمر فهو اكتشاف خارج وقت التشغيل: حملات تولّد الهجمات وتبلّغ عمّا نجح منها. الحملات تخبرك بما يجب إنفاذه، والإنفاذ يجعل الثغرة المكتشفة تتوقف عن تكبيدك الخسائر.
ليس بمعنى الحملات. فهي توفر شق الإنفاذ وقت التشغيل: ضوابط حماية على أربع نقاط ربط، وعشرة ضوابط مدمجة أصلية، ونحو عشرين تكاملاً مع الشركاء، وربط السياسات حسب النموذج أو خادم MCP أو الأداة أو المستخدم أو الفريق أو الحساب الافتراضي، ومقاييس لكل ضابط حماية. ولا توثّق توليد الهجمات، ولا مجموعة بيانات عدائية، ولا عمليات فحص مجدولة، ولا تقارير للفريق الأحمر. وعدد من الشركاء مزوّدو حلول أمنية لديهم قدراتهم الخاصة في جانب الحملات.
نعم. تعمل TrueFoundry في VPC الخاصة بك أو محلياً أو في بيئة معزولة عن الشبكة أو هجينة، فلا تغادر التعليمات والردود نطاقك أبداً حتى وأنت توجّه الطلبات عبر مزوّدين كثيرين.
نعم. تتضمن MCP Gateway وAgent Gateway وMCP & Agents Registry مع تحكم في الوصول على مستوى الأدوات. ويمكن حوكمة الوكلاء المبنيين على LangGraph أو CrewAI أو AutoGen أو إطار عمل مخصص مركزياً.
نعم. البوابة متوافقة مع OpenTelemetry وتتكامل مع Grafana أو Datadog أو Prometheus أو حزمتك المفضلة. فهي تتتبع كل طلب من المطالبة إلى تنفيذ الأداة والنموذج، لتحصل على تسجيل موحد دون الحاجة إلى تغيير ما تستخدمه حاليًا.



أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد



















