



November 16, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.


Blazingly fast way to build, track and deploy your models!
في عام 2026، لم يعد بإمكان المؤسسات تحمل تكلفة تعديل LLM Gateway ليصبح AI Gateway مؤقتاً. فالذكاء الاصطناعي سيزداد اندماجاً في مسارات العمل الموجهة للعملاء، مما يجعل طبقة البوابة المخصصة أمراً لا مفر منه لضمان موثوقية التطبيقات المدعومة بالذكاء الاصطناعي. وغالباً ما تكون البنية التحتية النموذجية للذكاء الاصطناعي في المؤسسات متعددة النماذج، ومتعددة الفرق، ومتعددة السحب، مما يؤدي إلى تعقيدات في الامتثال ومساءلة التكاليف.
تعرّف Gartner بوابة الذكاء الاصطناعي بأنها تقنية أو منصة تعمل كوسيط بين التطبيقات ومختلف خدمات أو نماذج الذكاء الاصطناعي (AI). والغرض منها هو تبسيط وإدارة الوصول إلى قدرات الذكاء الاصطناعي، مما يوفر نقطة مركزية لتمكين الأمان والحوكمة وقابلية الملاحظة لأحمال عمل الذكاء الاصطناعي. اقرأ دليل السوق من Gartner لبوابات الذكاء الاصطناعي 2025 الكامل لمعرفة المزيد.
على مدار العام الماضي، رأينا ظهور ثلاث فئات واسعة لمعالجة مشكلة الحوكمة والمرونة في GenAI:
تُحسّن كل فئة مرحلة مختلفة من مراحل تبني الذكاء الاصطناعي. وتنشأ المشكلات عندما تُمط الأدوات المحسّنة لمرحلة معينة للتعامل مع مرحلة أخرى.
في هذه المدونة، نجمع كل الأبحاث التنافسية في مشهد نهائي واحد، لنشرح أين تتناسب كل منصة، وأين تتوقف عن تلبية المتطلبات، وما الذي تحتاج المؤسسات إلى مراعاته عند اختيار المورد الذي يناسب متطلباتها بشكل أفضل.
1. Kong AI: بوابة API تقليدية مُكيّفة للذكاء الاصطناعي
Kong هي بوابة API يُشار إليها غالباً في البنيات الهيكلية للخدمات المصغرة القائمة على Kubernetes. وتعتمد Kong AI على هذا الأساس من خلال تقديم ملحقات وتكاملات مصممة لتوجيه حركة المرور إلى نماذج اللغات الكبيرة.
ما تجيده Kong AI
أين تتراجع Kong AI
مع نمو استخدام الذكاء الاصطناعي، تزداد هذه الفجوات وضوحاً. ويجب التعامل مع إسناد التكاليف، واستراتيجيات اختيار النماذج، والحوكمة الخاصة بالذكاء الاصطناعي خارج البوابة، وغالباً داخل كود التطبيق.
الخلاصة: تتميز Kong AI بفاعليتها كبوابة API، ولكن يظل الذكاء الاصطناعي فيها اهتماماً ثانوياً وليس تجريداً أصلياً.
2. Portkey: بوابة LLM على مستوى التطبيق
Portkey هي بوابة ذكاء اصطناعي مصممة خصيصاً لتطبيقات LLM. وبدلاً من التعامل مع طلبات الذكاء الاصطناعي كاستدعاءات HTTP عامة، تقدم Portkey توجيهاً وقابلية ملاحظة واعية بالأوامر والنماذج.
ما تجيده Portkey
أين تقصر Portkey
تصميم Portkey يركز عمداً على التطبيقات، مما يفرض قيوداً عند التوسع على مستوى المؤسسة
مع تحول الذكاء الاصطناعي إلى قدرة داخلية مشتركة بدلاً من ميزة تطبيق فردية، غالباً ما تتطلب هذه القيود طبقات بنية تحتية إضافية.
الأفضل لـ: تطبيقات LLM الخاصة بفريق واحد والتي تنتقل إلى مراحل الإنتاج المبكرة.
3. LiteLLM: بوابة مفتوحة المصدر تركز على المطورين
LiteLLM هي LLM gateway مفتوحة المصدر توفر API موحداً ومتوافقاً مع OpenAI للوصول إلى عشرات مزودي النماذج.
ما تجيده LiteLLM
أين تقصر LiteLLM
الأفضل لـ: تُعد LiteLLM نقطة بداية فعالة ولكنها تتطلب تعزيزاً كبيراً لبيئات العمل المنظمة أو متعددة الفرق.
اقرأ أيضاً: Portkey vs LiteLLM
4. AWS Bedrock: واجهات برمجة تطبيقات النماذج الخادشية (Serverless)
تقدم AWS Bedrock وصولاً مُداراً وبدون خوادم إلى النماذج التأسيسية من مزودين مثل Anthropic وAmazon. وتجرد البنية التحتية بالكامل وتعتمد الفوترة بناءً على استخدام الرموز المميزة (tokens) فقط.
ما تجيده AWS Bedrock
المقايضات الخفية لـ AWS Bedrock
غالباً ما تفاجئ هذه المقايضات الفرق مع انتقال أحمال العمل من التجريب إلى الاستخدام الإنتاجي المستمر.
الخلاصة: تُحسّن Bedrock السرعة والبساطة، وليس كفاءة التكلفة أو التحكم على المدى الطويل.
5. AWS SageMaker: بنية تحتية مُدارة للتعلم الآلي
توفر SageMaker حزمة شاملة لتدريب نماذج التعلم الآلي وضبطها ونشرها. وعلى عكس Bedrock، فإنها تعرض خيارات البنية التحتية للمستخدمين مباشرة.
ما تجيده AWS Sagemaker
عيوب AWS Sagemaker
الخلاصة: توفر SageMaker التحكم ولكن على حساب البساطة التشغيلية.
6. Databricks: منصة التعلم الآلي لـ Lakehouse
تتعامل Databricks مع الذكاء الاصطناعي من منظور يرتب البيانات أولاً، حيث تدمج قدرات ML وGenAI في بنيتها الهيكلية لـ Lakehouse.
ما تجيده Databricks
أين تقصر Databricks
الخلاصة: تتفوق Databricks في هندسة البيانات، وليس في تقديم خدمات الذكاء الاصطناعي.
الخيط المشترك: بوابات بدون حوكمة
عبر Kong vs LiteLLM وPortkey وحتى Bedrock، تظهر المشكلة نفسها: فهي تدير الطلبات وليس أنظمة الذكاء الاصطناعي.
عبر البوابات والخدمات المُدارة، تظهر مشكلة متكررة: معظم الأدوات تركز على الطلبات وليس على الأنظمة.
فهي تجيب على أسئلة مثل:
لكنها تواجه صعوبة في الإجابة على:
هذه المخاوف تقع على مستوى البنية التحتية.
تحتل TrueFoundry طبقة مختلفة في البنية التقنية. فبدلاً من التركيز فقط على توجيه API أو الخدمات المُدارة، فإنها تتعامل مع أحمال عمل الذكاء الاصطناعي — النماذج والوكلاء والخدمات والمهام — ككائنات بنية تحتية من الدرجة الأولى. وهذا ينقل المسؤولية من كود التطبيق إلى المنصة نفسها.
تم بناء بوابة الذكاء الاصطناعي من TrueFoundry وفقاً للمبادئ الأساسية التالية:
وهذا يعني أن بوابة الذكاء الاصطناعي هي مكون من نظام أكبر، مما يتيح للمؤسسات توسيع حالات استخدام الذكاء الاصطناعي لديها بسلاسة.
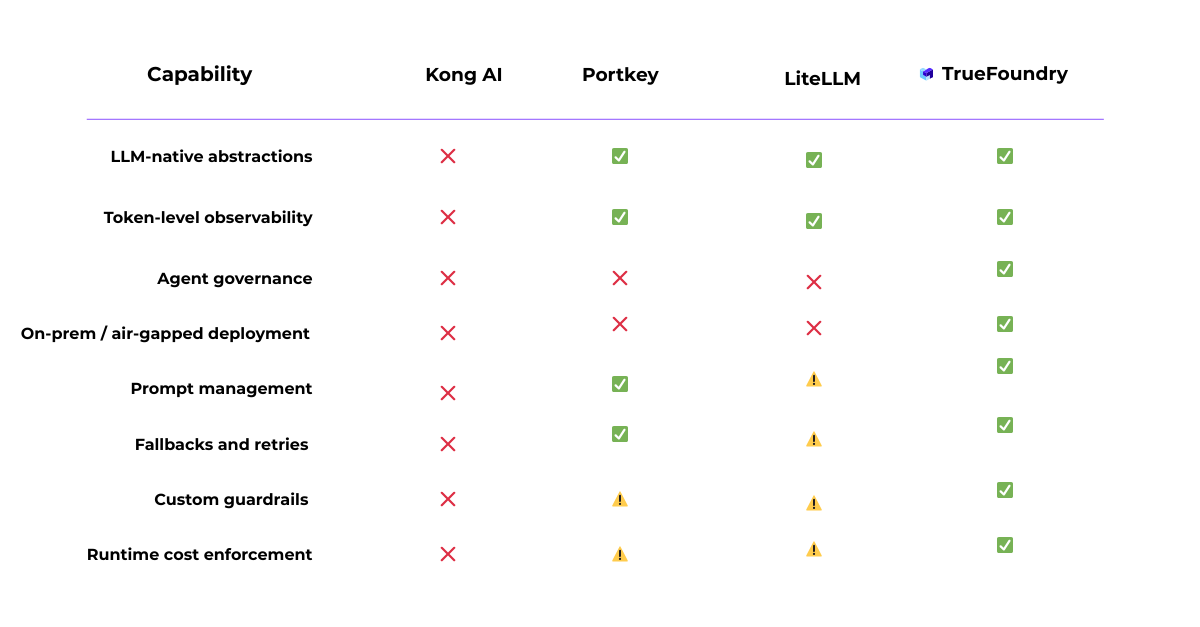
إليك إطار التقييم لنموذج المقترحات
| المعيار | ما الذي يجب عليك تقييمه؟ | الأولوية | TrueFoundry |
|---|---|---|---|
| API موحد وتوجيه | |||
| نقطة نهاية موحدة متوافقة مع OpenAI | هل API البوابة متوافق مع صيغ /v1/chat/completions و/v1/responses من OpenAI، مما يسمح بالوصول المتسق عبر النماذج المختلفة من خلال واجهة موحدة؟ | ضروري جداً | ✅ مدعوم: نقطة نهاية متوافقة مع OpenAI عبر جميع المزودين. |
| تغطية المزودين والنماذج | هل تدعم المزودين الرائدين مثل OpenAI و Azure OpenAI وAmazon Bedrock وAnthropic و Gemini وGroq، بالإضافة إلى النماذج المستضافة ذاتياً؟ | ضروري جداً | ✅ مدعوم: 1000+ نموذج LLM عبر المزودين المستضافين و المستضافين ذاتياً. |
| سرعة إدراج النماذج | ما هي السرعة التي يمكن بها إضافة نماذج جديدة (سواء المتوافقة مع OpenAI أو APIs غير القياسية) دون تغيير الكود؟ | ضروري جداً | ✅ مدعوم: إدراج مدعوم بالتكوين (config-driven) خلال دقائق. |
| الدعم متعدد الوسائط (Multimodal) | هل تدعم البوابة النصوص والرؤية والصوت وإنشاء الصور والضمائم (embeddings) من خلال واجهة واحدة؟ | يعتمد على حالة الاستخدام | ✅ مدعوم: المحادثة، والضمائم، والصور، والصوت، وإعادة الترتيب (rerank)، وAPIs في الوقت الفعلي. |
| التوجيه، وموازنة الأحمال، والاستبدال | هل يمكن توجيه الطلبات حسب النموذج، والمزود، وزمن الانتقال، والأولوية، والوزن، والمنطقة، وحالة الفشل مع إعادات محاولة تلقائية؟ | ضروري جداً | ✅ مدعوم: موازنة الأحمال، ومسارات الاستبدال، والتوجيه القائم على الوزن وزمن الانتقال. |
| التبديل بين النماذج دون تغيير الكود | هل التبديل بين النماذج مدعوم عبر الهيدرز (headers) أو التكوين دون تغيير كود العميل؟ | ضروري جداً | ✅ مدعوم: التبديل بين النماذج القائم على الهيدرز والتكوين. |

تصبح بوابة الذكاء الاصطناعي من TrueFoundry حاسمة عندما يتجاوز استخدام الذكاء الاصطناعي التطبيقات المعزولة ليصبح قدرة مشتركة وحرجة لبيئة الإنتاج. في تلك المرحلة، غالباً ما تكون التحديات أقل تعلقاً باستدعاءات النماذج الفردية وأكثر اتساماً بالاتساق التشغيلي عبر الفرق وبيئات العمل.
إليك كيف تختلف بوابة الذكاء الاصطناعي من TrueFoundry عن الحلول الأخرى:
تركز العديد من أدوات الذكاء الاصطناعي على المخاوف القائمة على مستوى الطلب مثل التوجيه، وإعادات المحاولة، وقابلية الملاحظة الأساسية. وهذا يكون كافياً عادةً في المرحلة المبكرة.
ومع ذلك، كلما اتسع نطاق الاستخدام، تبدأ النماذج والوكلاء في التصرف كخدمات طويلة الأمد. وتحتاج الفرق إلى ملكية أكثر وضوحاً، وإدارة لدورة الحياة، وهياكل تشغيلية محددة. تم تصميم TrueFoundry لإدارة أحمال عمل الذكاء الاصطناعي — النماذج والخدمات والمهام — كعناصر بنية تحتية ذات خصائص نشر وتشغيل محددة.
في العديد من البيئات التقنية، يتم تكوين عناصر التحكم بالوصول وسياسات الاستخدام على مستوى التطبيق أو SDK. ومع مرور الوقت، يمكن أن يؤدي ذلك إلى عدم الاتساق مع نمو عدد الخدمات.
تطبق TrueFoundry عناصر التحكم على مستوى بيئة العمل، حيث تفصل بين بيئات التطوير، والتجهيز، والإنتاج افتراضياً. وتُطبق السياسات المحددة في هذه الطبقة بانتظام على جميع أحمال العمل المنشورة داخل بيئة العمل، مما يقلل الاعتماد على التكوين الخاص بكل تطبيق.
غالباً ما ترتفع تكاليف الذكاء الاصطناعي بسبب التزامن، أو إعادات المحاولة، أو أحمال العمل في الخلفية بدلاً من الطلبات الفردية. تعالج TrueFoundry ذلك من خلال فرض حدود على التزامن، والإنتاجية، واستخدام الموارد أثناء التنفيذ.
يتيح هذا للمؤسسات إدارة البنية التحتية المشتركة بشكل أكثر قابلية للتنبؤ مع توسع الاستخدام.
في حين أن مقاييس الرموز المميزة مفيدة، إلا أنها لا تفسر سلوك النظام بالكامل في مرحلة الإنتاج. تربط TrueFoundry بين الإشارات على مستوى الطلب ومقاييس البنية التحتية مثل استهلاك CPU/GPU وسلوك التوسع التلقائي (autoscaling)، مما يساعد الفرق على فهم محركات الأداء والتكلفة في سياقها الصحيح.
تعمل بعض المؤسسات تحت قيود تتطلب شبكات خاصة، أو نشراً داخلياً (on-prem)، أو قواعد صارمة لإقامة البيانات. تم تصميم TrueFoundry للعمل في هذه البيئات، مما يسمح بحوكمة أحمال عمل الذكاء الاصطناعي باستخدام معايير البنية التحتية نفسها المطبقة في أجزاء أخرى من المؤسسة.
الخاتمة
يعكس المشهد الحالي لمنصات الذكاء الاصطناعي السرعة التي تطور بها الذكاء الاصطناعي التوليدي. تعالج العديد من الأدوات مشكلات حقيقية — مثل التوجيه، أو الوصول إلى النماذج، أو قابلية الملاحظة، أو التدريب — ولكنها تفعل ذلك من نقاط انطلاق مختلفة. ونتيجة لذلك، لا تغطي أي فئة بمفردها بشكل طبيعي المجموعة الكاملة من المتطلبات التشغيلية التي تظهر بمجرد أن يصبح الذكاء الاصطناعي حرجاً لبيئة الإنتاج.
تقدم TrueFoundry أقصى قيمة عندما يلزم تشغيل أحمال عمل الذكاء الاصطناعي بالانضباط نفسه المطبق على الأنظمة الإنتاجية الأخرى — عبر بيئات العمل، وتحت سياسات مشتركة، وبسلوك موثوق للموارد.
غالباً ما تبدأ المؤسسات التي تقارن بين المزودين بالبحث عن best LLM gateway، ولكن الفارق الحقيقي يكمن في مدى جودة حوكمة المنصة لأنظمة الذكاء الاصطناعي على نطاق واسع. إن فهم أين تتناسب كل منصة، وأين تبدأ افتراضات تصميمها في التراجع، يعد أمراً أساسياً عند تقييم best AI gateway لعمليات النشر على مستوى المؤسسات. فالخيار الصحيح يعتمد بدرجة أقل على الميزات الفردية وبدرجة أكبر على كيفية توقع المؤسسة لتطور استخدامها للذكاء الاصطناعي بمرور الوقت.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



يعتمد أفضل بوابة للذكاء الاصطناعي على المتطلبات المحددة للمؤسسة. تبرز بوابة الذكاء الاصطناعي من TrueFoundry للشركات التي تحتاج إلى توجيه متعدد المزودين، وحوكمة مركزية، وتتبع التكاليف، وتكامل MCP في منصة واحدة. تشمل الخيارات القوية الأخرى LiteLLM لمرونة المصدر المفتوح، وبوابة Kong AI للفرق التي تستخدم بالفعل نظام Kong البيئي لإدارة واجهات برمجة التطبيقات.
بوابة الذكاء الاصطناعي هي طبقة وسيطة تقع بين التطبيقات ومزودي نماذج اللغة الكبيرة (LLM) (مثل OpenAI أو Anthropic أو Google). يتضمن هيكلها عادةً محرك توجيه يوجه الطلبات إلى النموذج المناسب، وطبقة سياسات لفرض حدود المعدل وضوابط الوصول، ومكدس مراقبة لتسجيل البيانات وتتبع التكاليف، وطبقة تخزين مؤقت لتقليل استدعاءات API المتكررة. يتيح هذا الهيكل للمؤسسات إدارة عمليات نشر النماذج المتعددة من لوحة تحكم واحدة.
تتميز TrueFoundry بجمعها بين إمكانيات بوابة الذكاء الاصطناعي ومنصة بنية تحتية كاملة للتعلم الآلي، بما في ذلك خدمة النماذج، والضبط الدقيق، وإدارة خوادم MCP، في حل موحد. توفر بوابة الذكاء الاصطناعي الخاصة بها ميزات على مستوى المؤسسات مثل ضوابط الميزانية لكل فريق، وتسجيل التدقيق، وتوجيه النماذج الاحتياطية، ودعم MCP الأصلي، مما يجعلها مناسبة بشكل خاص للمؤسسات التي تسعى إلى إدارة وتوسيع نطاق نشر Claude Code ونشر الذكاء الاصطناعي الوكيل الآخر.



أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد




















