


October 19, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.


Published: October 7, 2026
Blazingly fast way to build, track and deploy your models!
A cada segundo, sua IA toma decisões. Agentes estão conversando diretamente com seus clientes, roteando solicitações, executando ferramentas e gastando dinheiro real. O sistema está rodando e, na maioria das vezes, você não faz ideia do que está acontecendo lá dentro.
Isso não é uma crítica à sua equipe. É apenas a realidade de operar IA em escala. Os dados estão lá, nos seus rastreamentos, nas suas configurações, nos seus logs, mas acessá-los significa saber exatamente onde procurar, o que filtrar e como conectar os pontos entre meia dúzia de telas diferentes. Quando tudo está funcionando, você nem pensa nisso. Quando algo quebra, de repente você se vê alternando entre o painel de monitoramento, a configuração de guardrails, as regras de roteamento e a documentação, tentando entender o que deu errado antes que alguém transforme isso em um problema maior.
É aqui que a maioria das equipes está hoje. E isso é exaustivo.
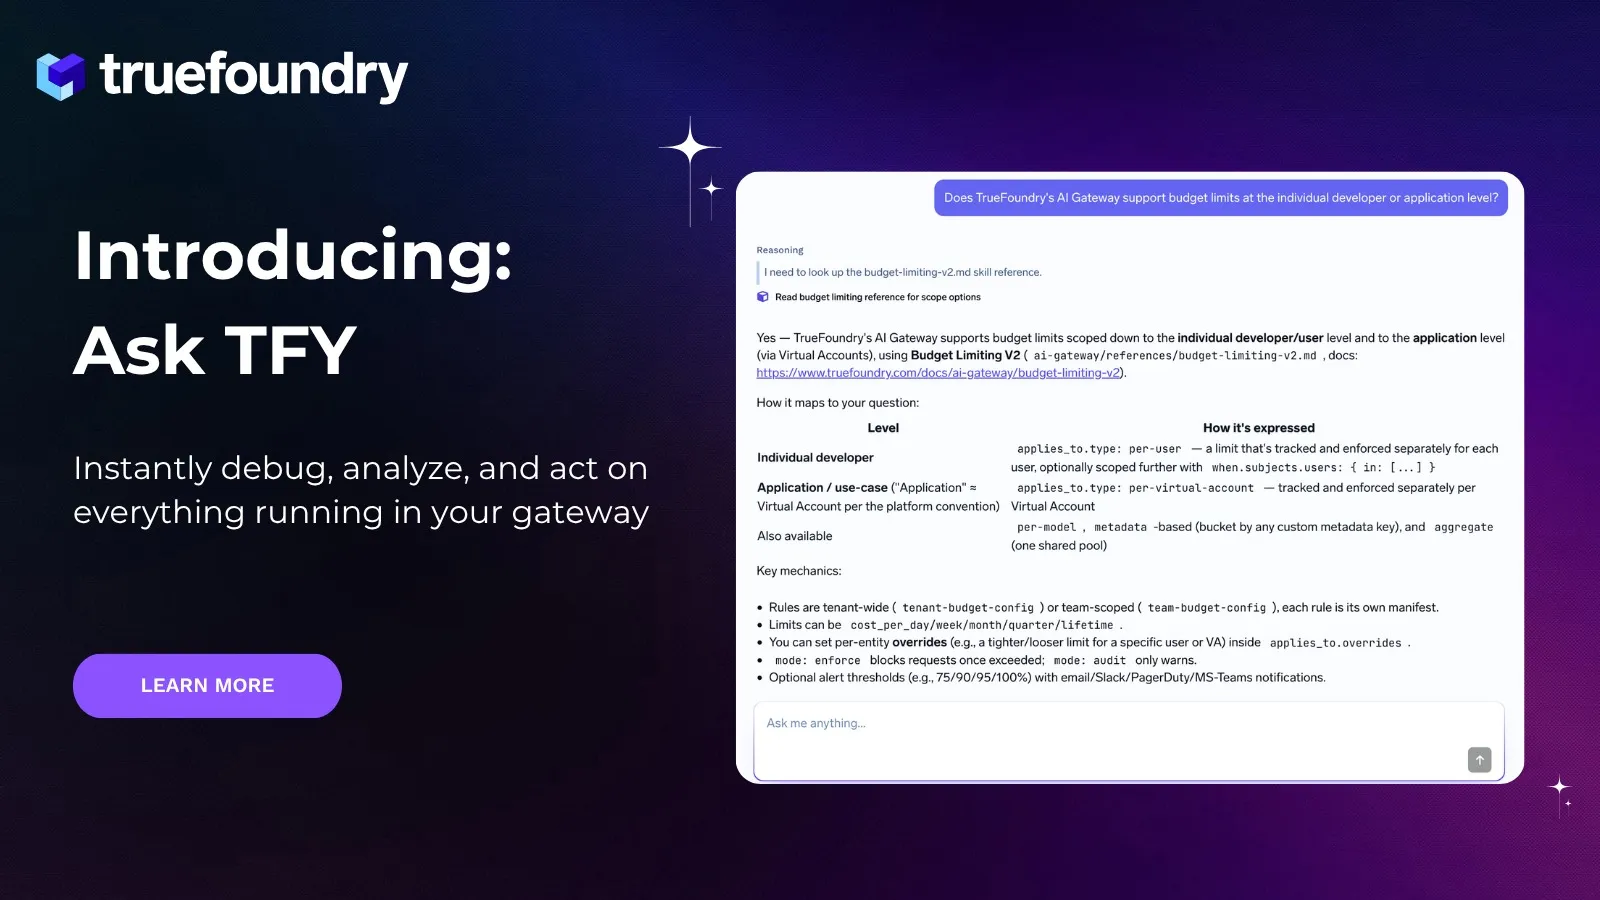
O Ask TFY é uma nova forma de interagir com seu gateway de IA no TrueFoundry. Não é uma barra de pesquisa, nem um chatbot que regurgita documentação para você. É um agente integrado ao TrueFoundry, com acesso em tempo real a tudo o que está sendo executado dentro do seu gateway: seus modelos, rastreamentos, servidores MCP, configurações de guardrails, regras de orçamento e políticas de acesso a dados. Quando você pergunta algo, ele retorna com uma resposta fundamentada no que está realmente acontecendo no seu sistema agora.
Aqui está um cenário que pode parecer muito familiar. Sua aplicação começa a apresentar erros. Você não sabe se é um problema de modelo, de roteamento, um limite de orçamento atingido ou algo totalmente diferente. Então você começa a investigar, filtrando rastreamentos manualmente, procurando padrões, verificando configurações uma por uma.
Com o Ask TFY, você descreve o problema.
"Minha aplicação tem falhado intermitentemente nos últimos 7 dias. O que deu errado?"
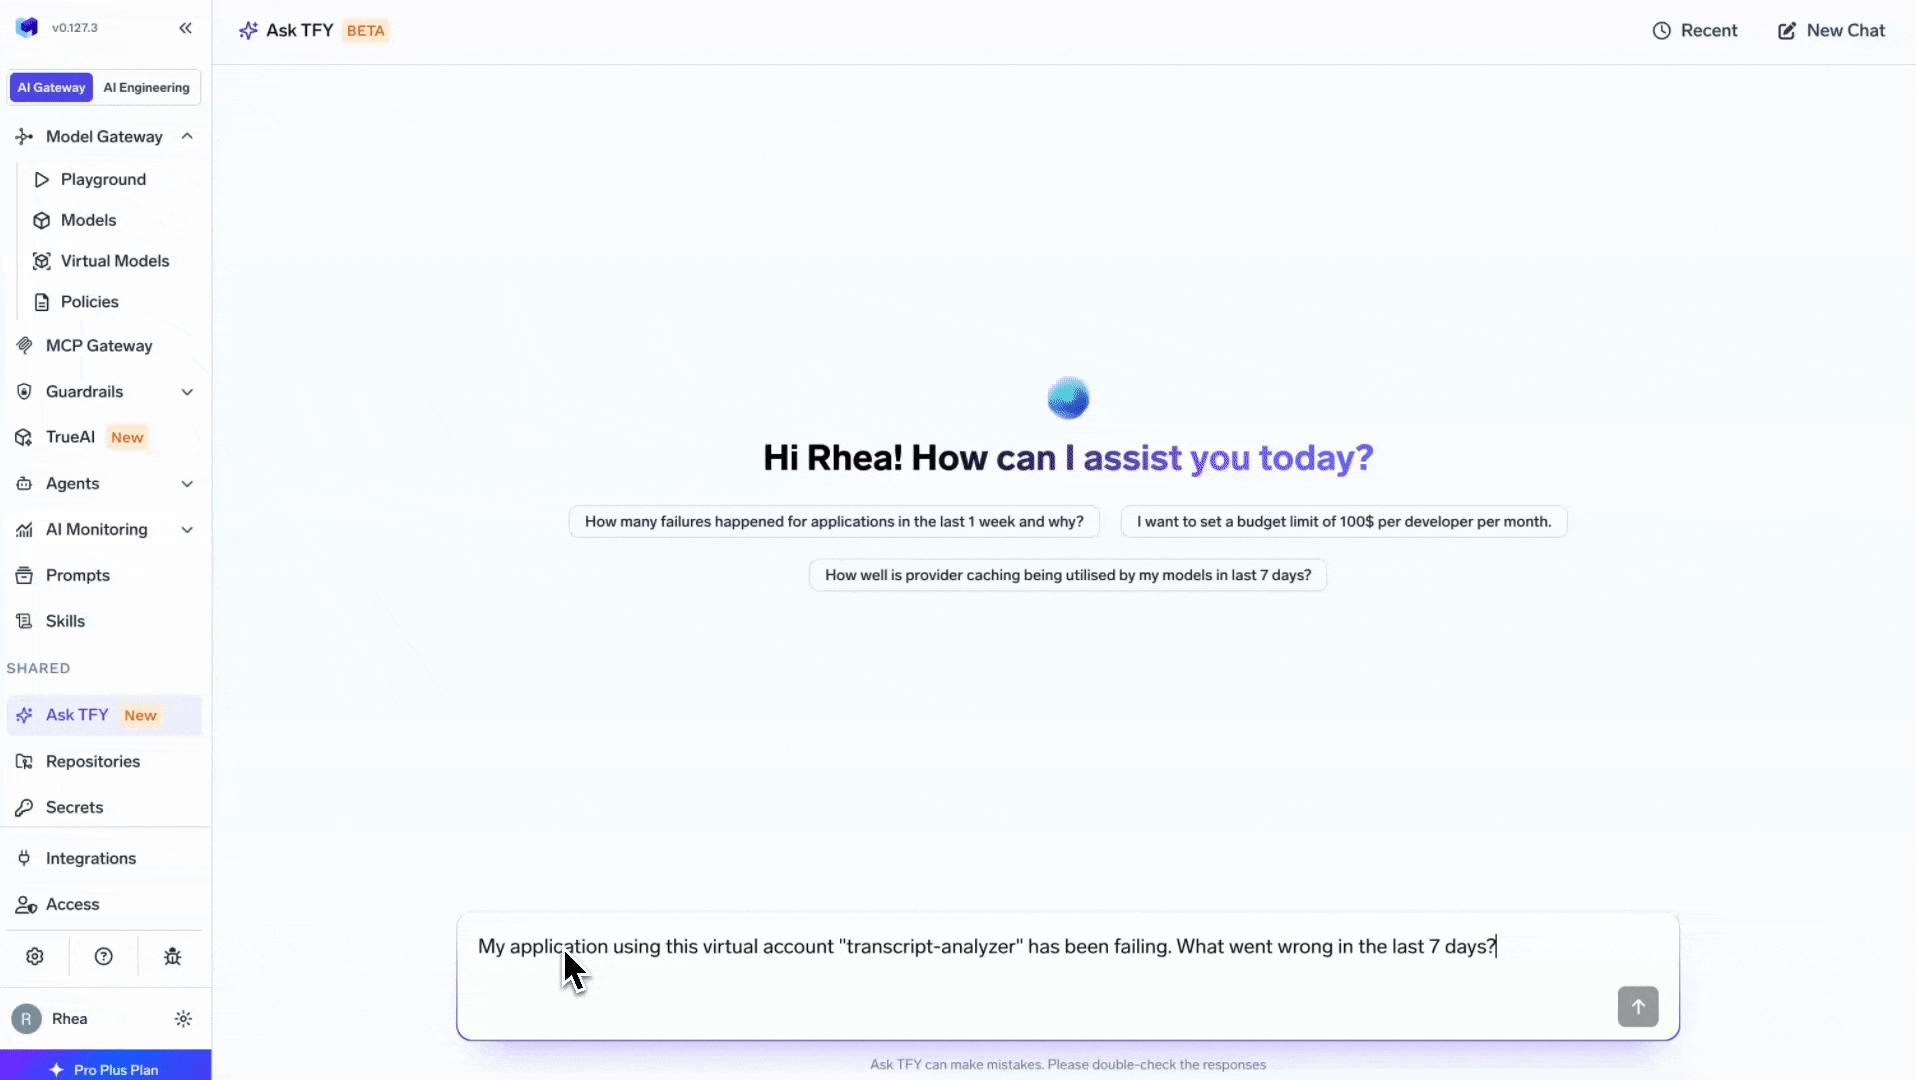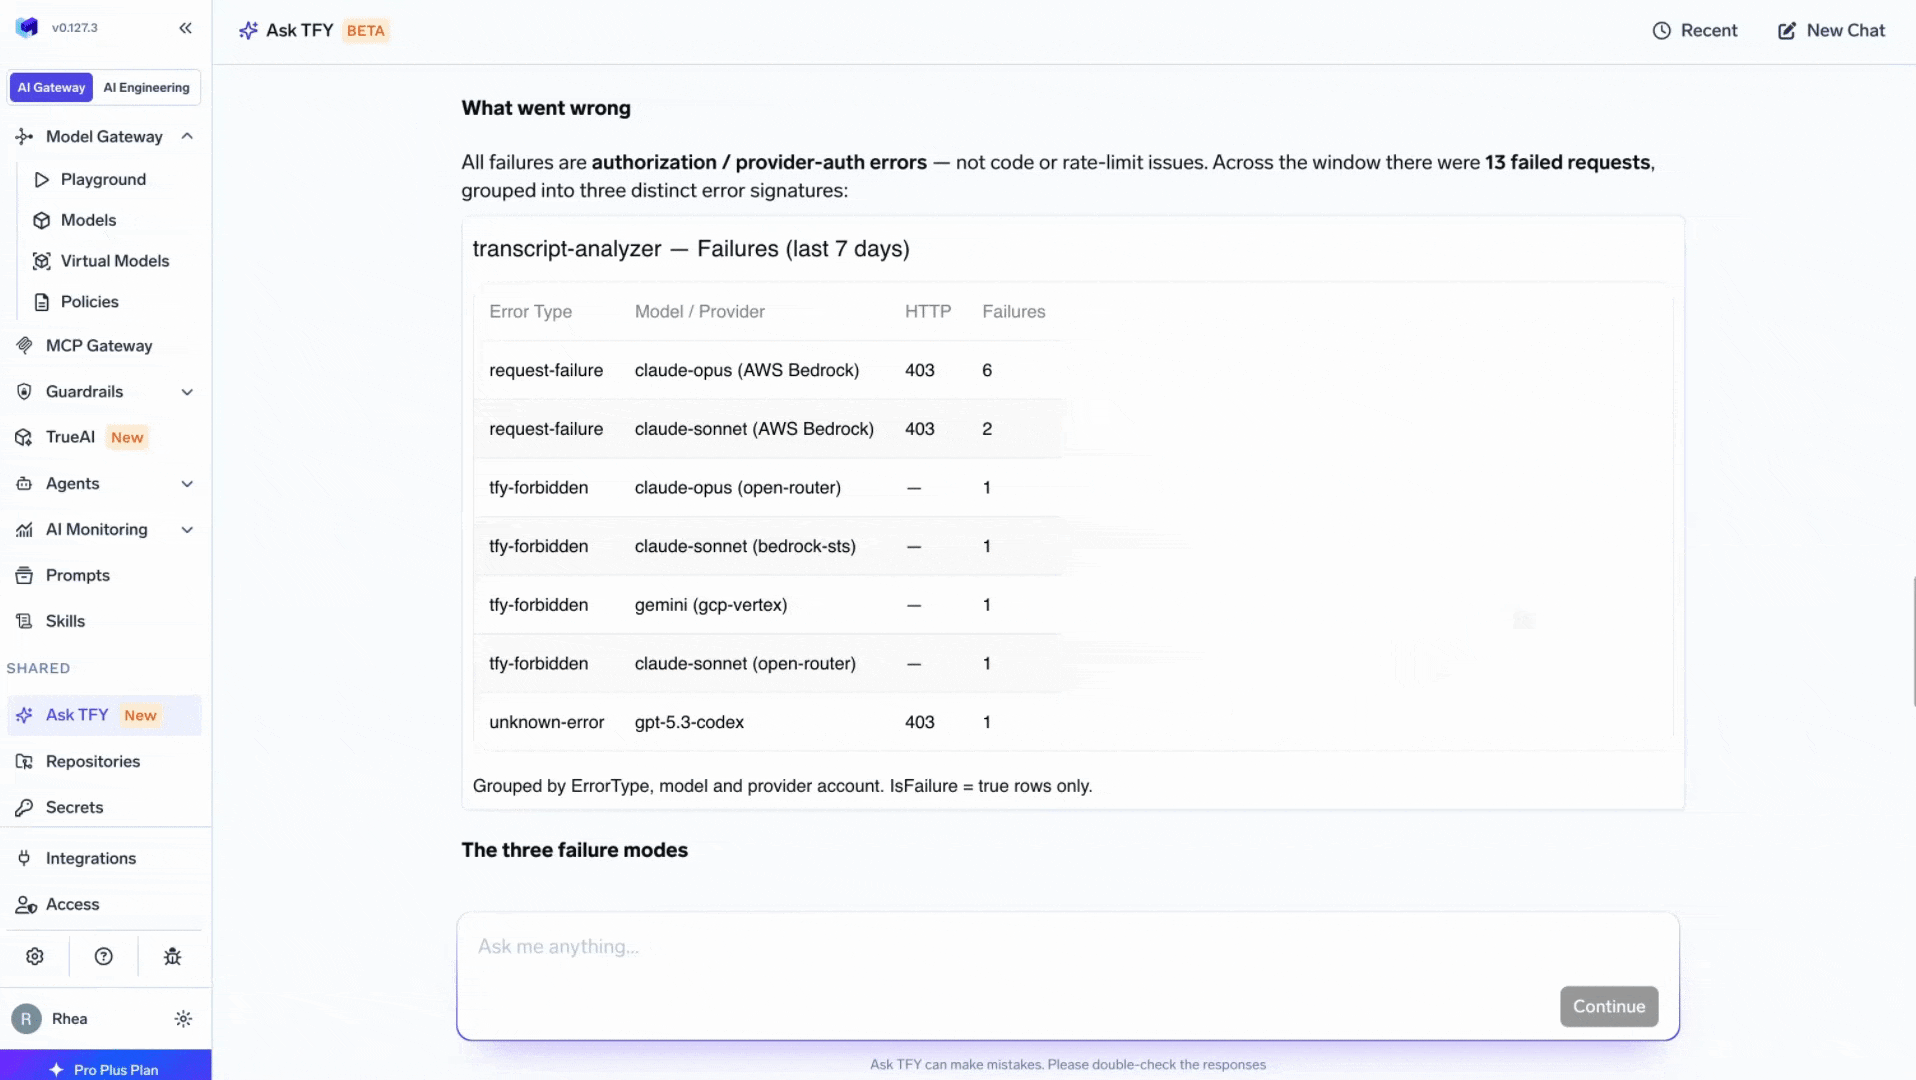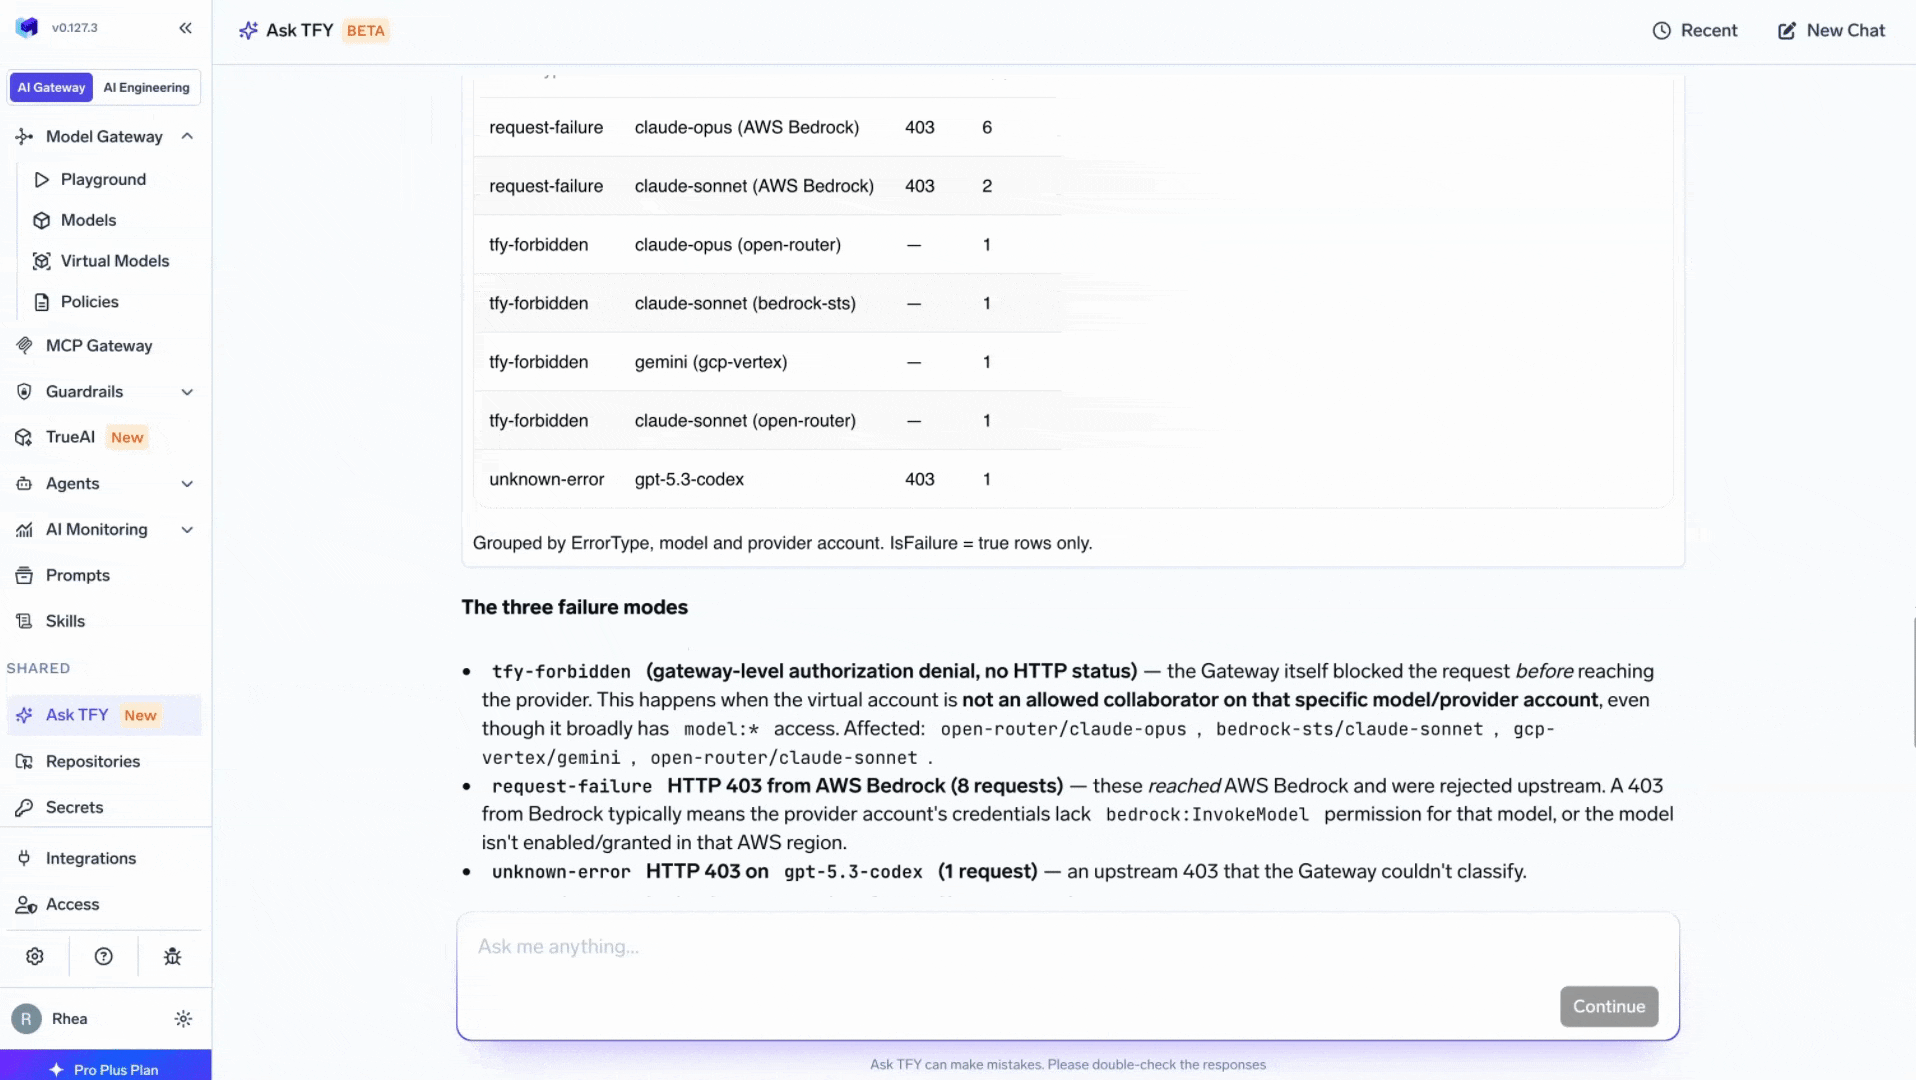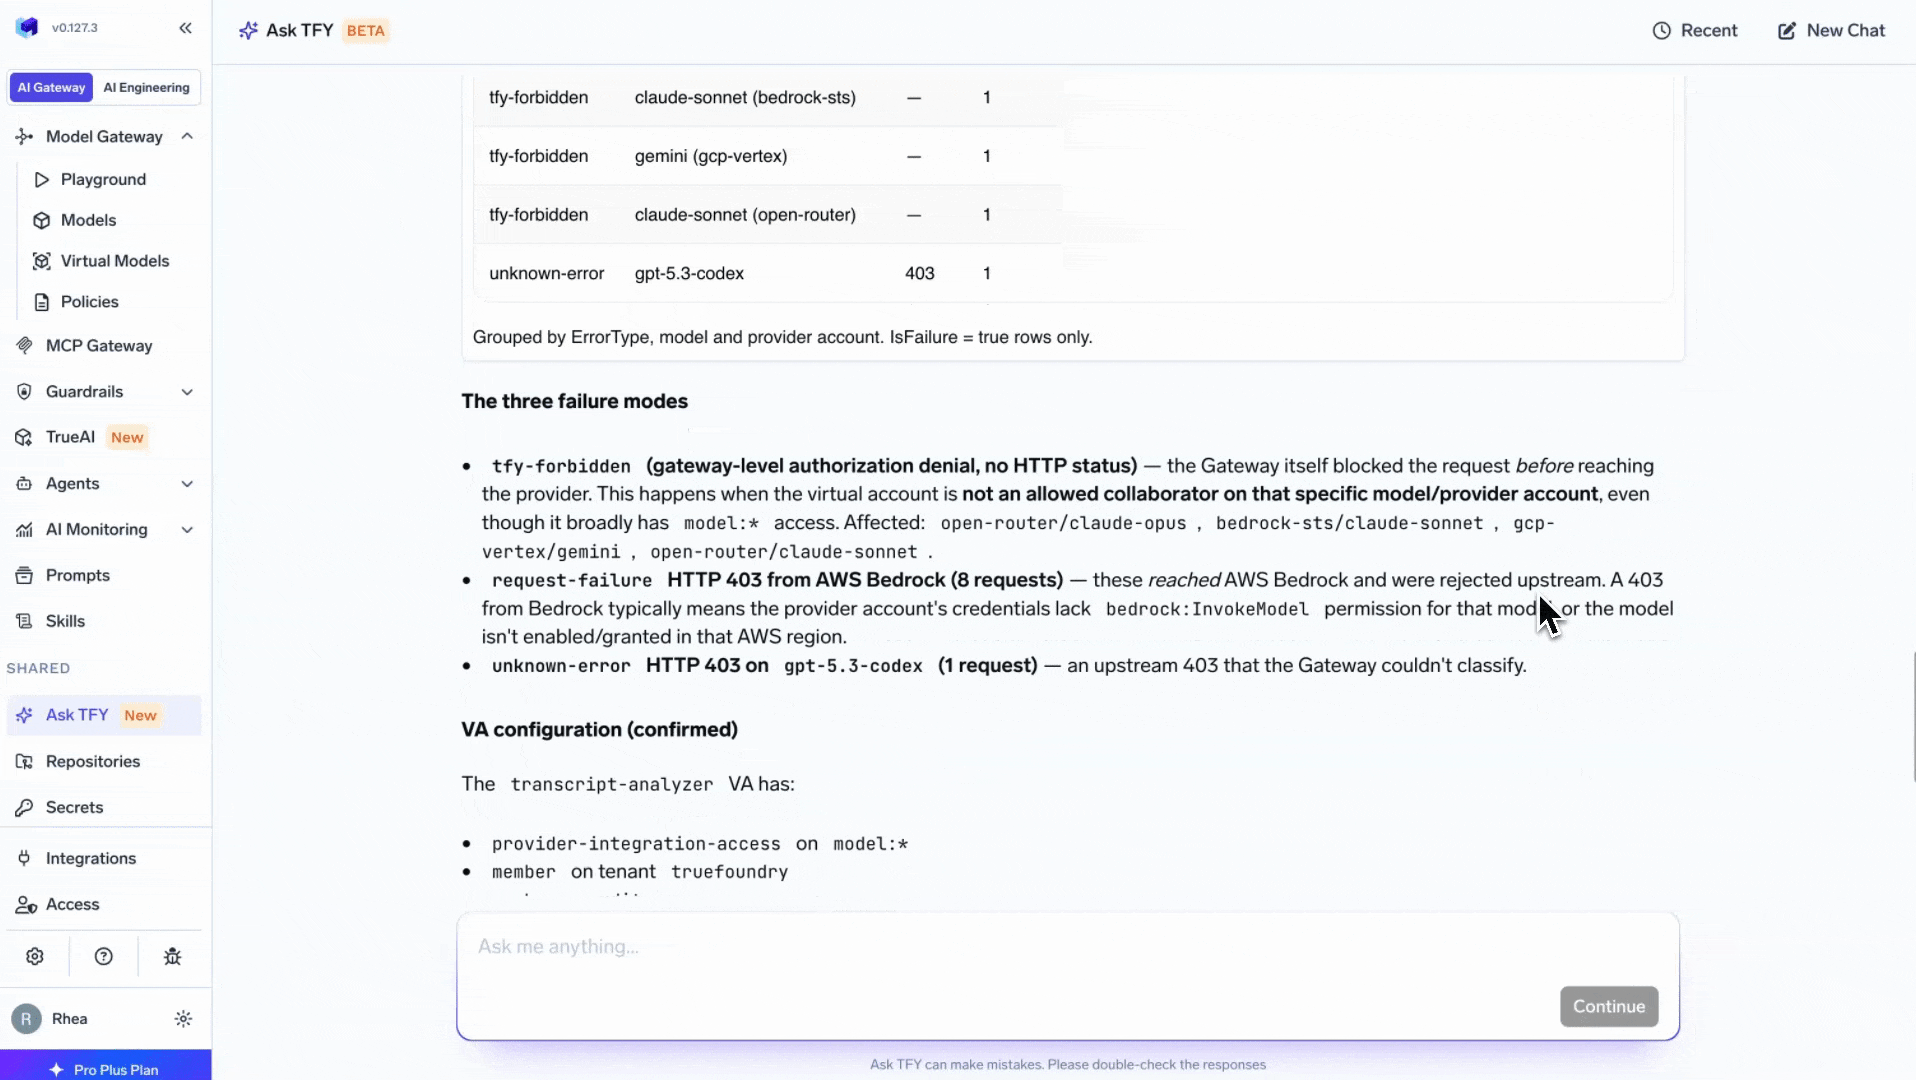
O Ask TFY analisa seu histórico de rastreamento, classifica os erros, identifica se as falhas foram do lado do cliente ou causadas por algo como a queda de um provedor de modelo upstream, e destaca o padrão. Ele diz o que quebrou e por que, especificamente, não de forma genérica. E então ele diz o que fazer a respeito.
"Como corrijo a configuração para tornar isso mais resiliente?"
Ele recomenda a solução certa para sua configuração. Talvez seja configurar um modelo virtual com fallback. Talvez seja ajustar suas regras de roteamento. Como ele conhece seu sistema, ele oferece uma resposta que realmente se aplica, e não um guia de solução de problemas genérico.
E então você pode pedir para ele agir diretamente nessa recomendação.
"Aplique o orçamento recomendado e a configuração de fallback para aquele agente."
É isso. Você permaneceu no mesmo lugar, fez três perguntas e o problema foi resolvido. Sem copiar YAML de uma tela e colar em outra. Sem alternar entre abas.
A depuração é um caso de uso, mas o Ask TFY é igualmente útil quando nada parece estar errado. Os problemas de produção mais caros são aqueles que drenam silenciosamente seus recursos ou criam vulnerabilidades de segurança antes que alguém perceba.
Por exemplo, você pode perguntar quão bem o cache de prompt no nível do provedor está sendo utilizado. Ele não fornecerá apenas um número. Ele dirá quais solicitações específicas estão perdendo o cache e exatamente onde você precisa adicionar o bloco de cache para corrigir isso. Esse é o tipo de insight que levaria uma hora para um engenheiro qualificado extrair manualmente, e a maioria das equipes nunca se preocupa com isso porque não parece urgente o suficiente até que a conta chegue.
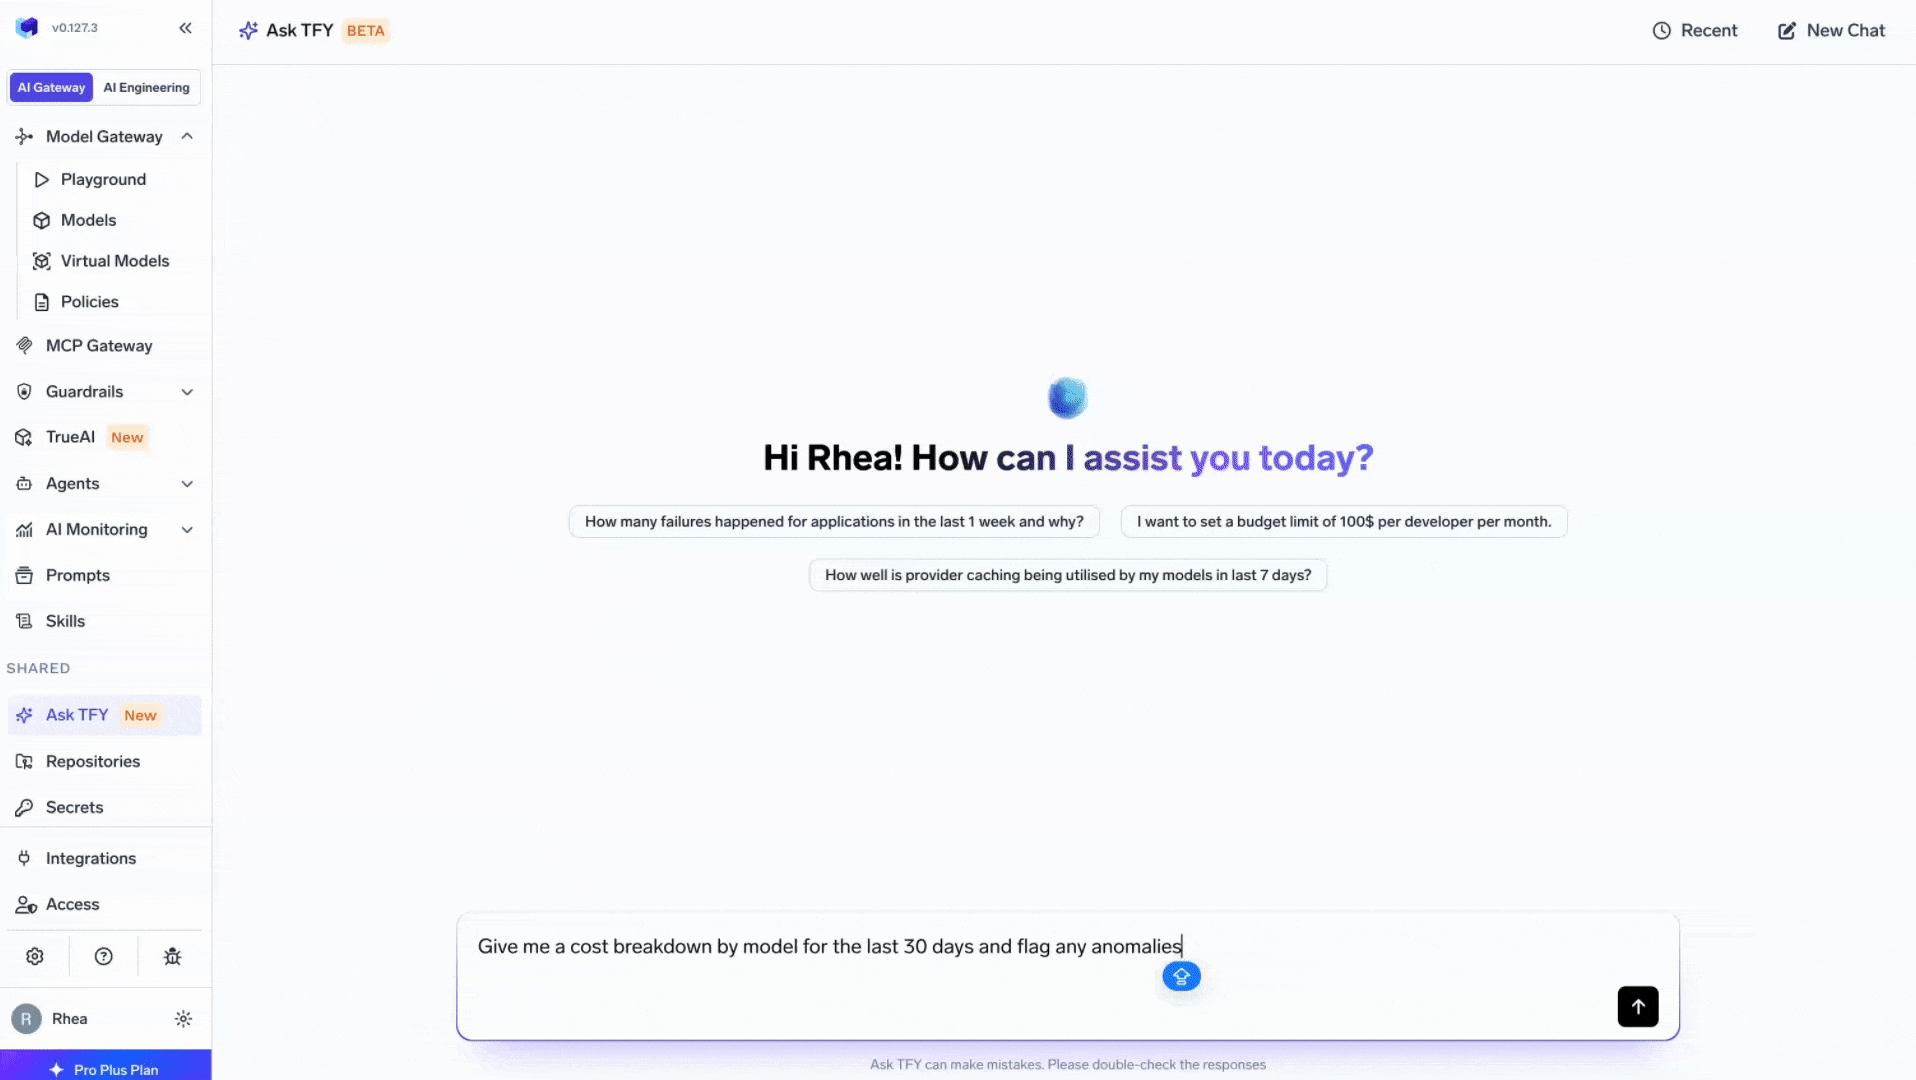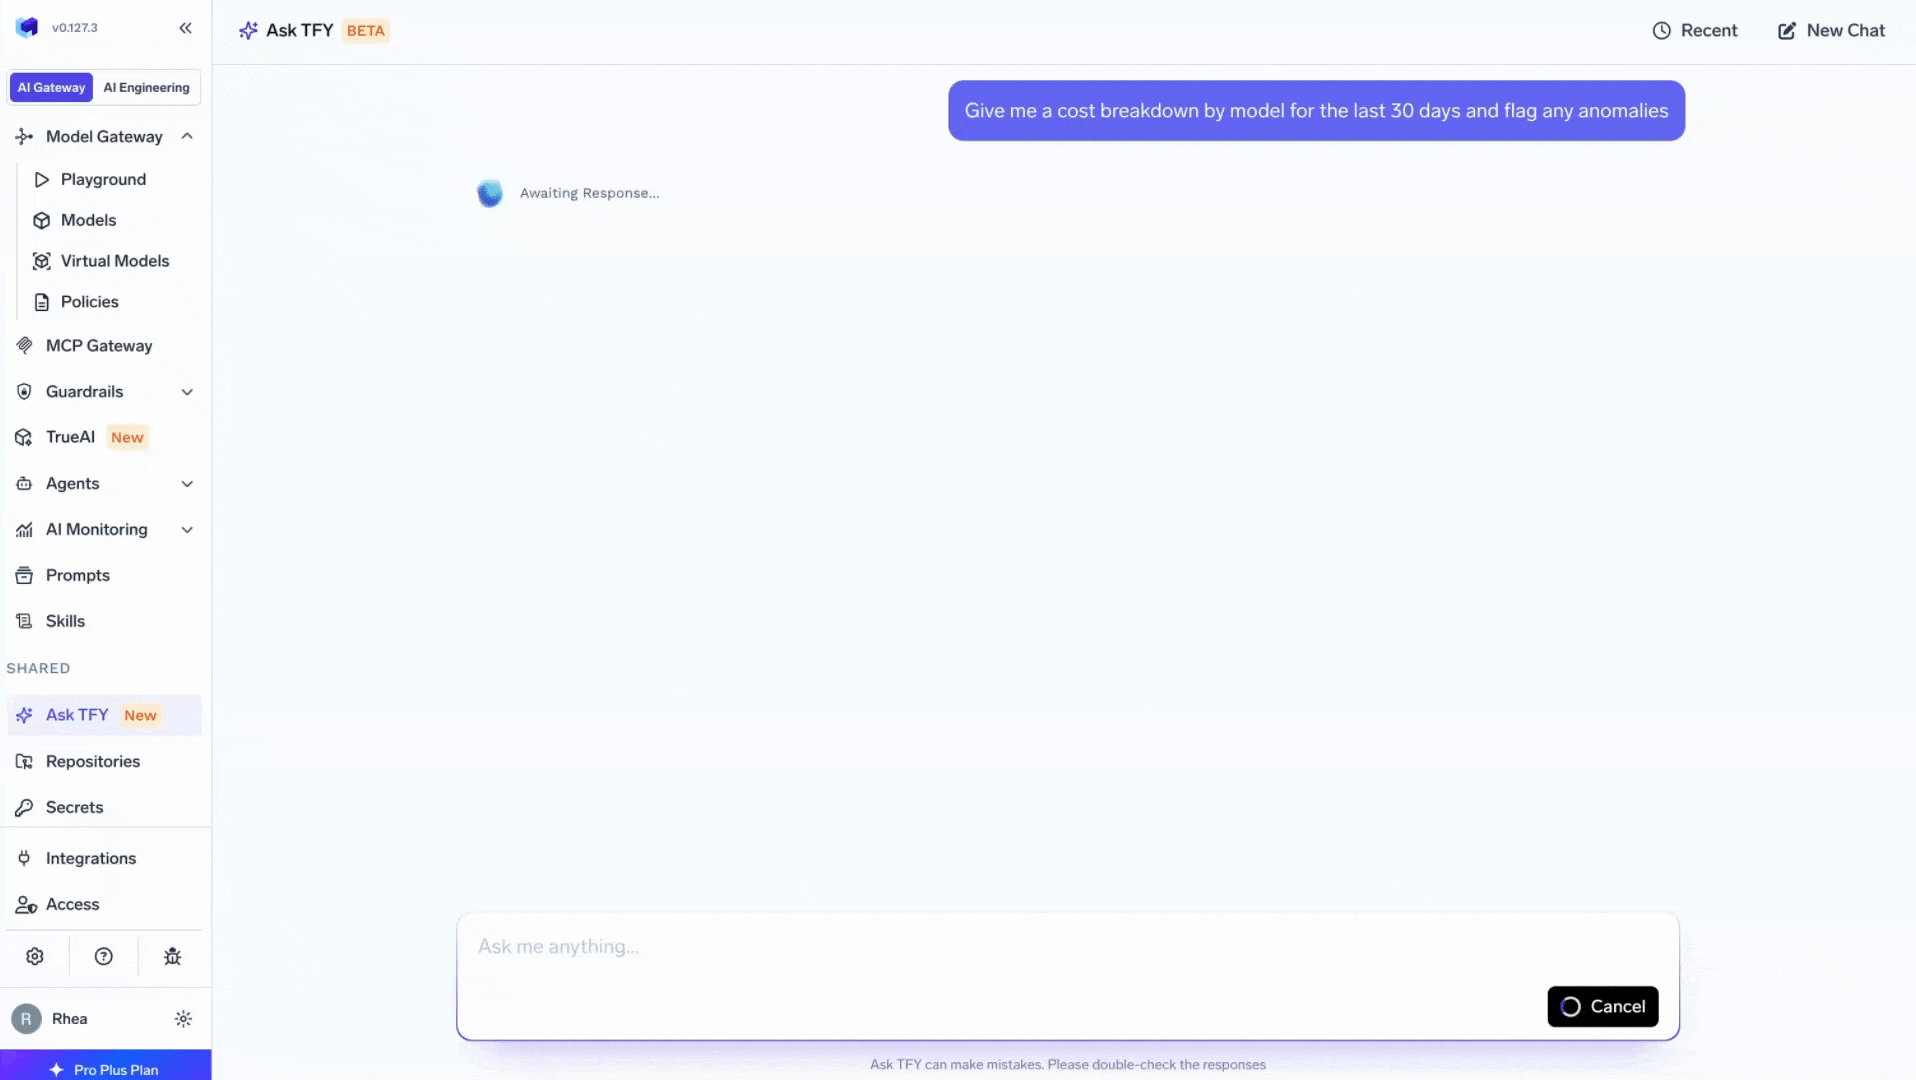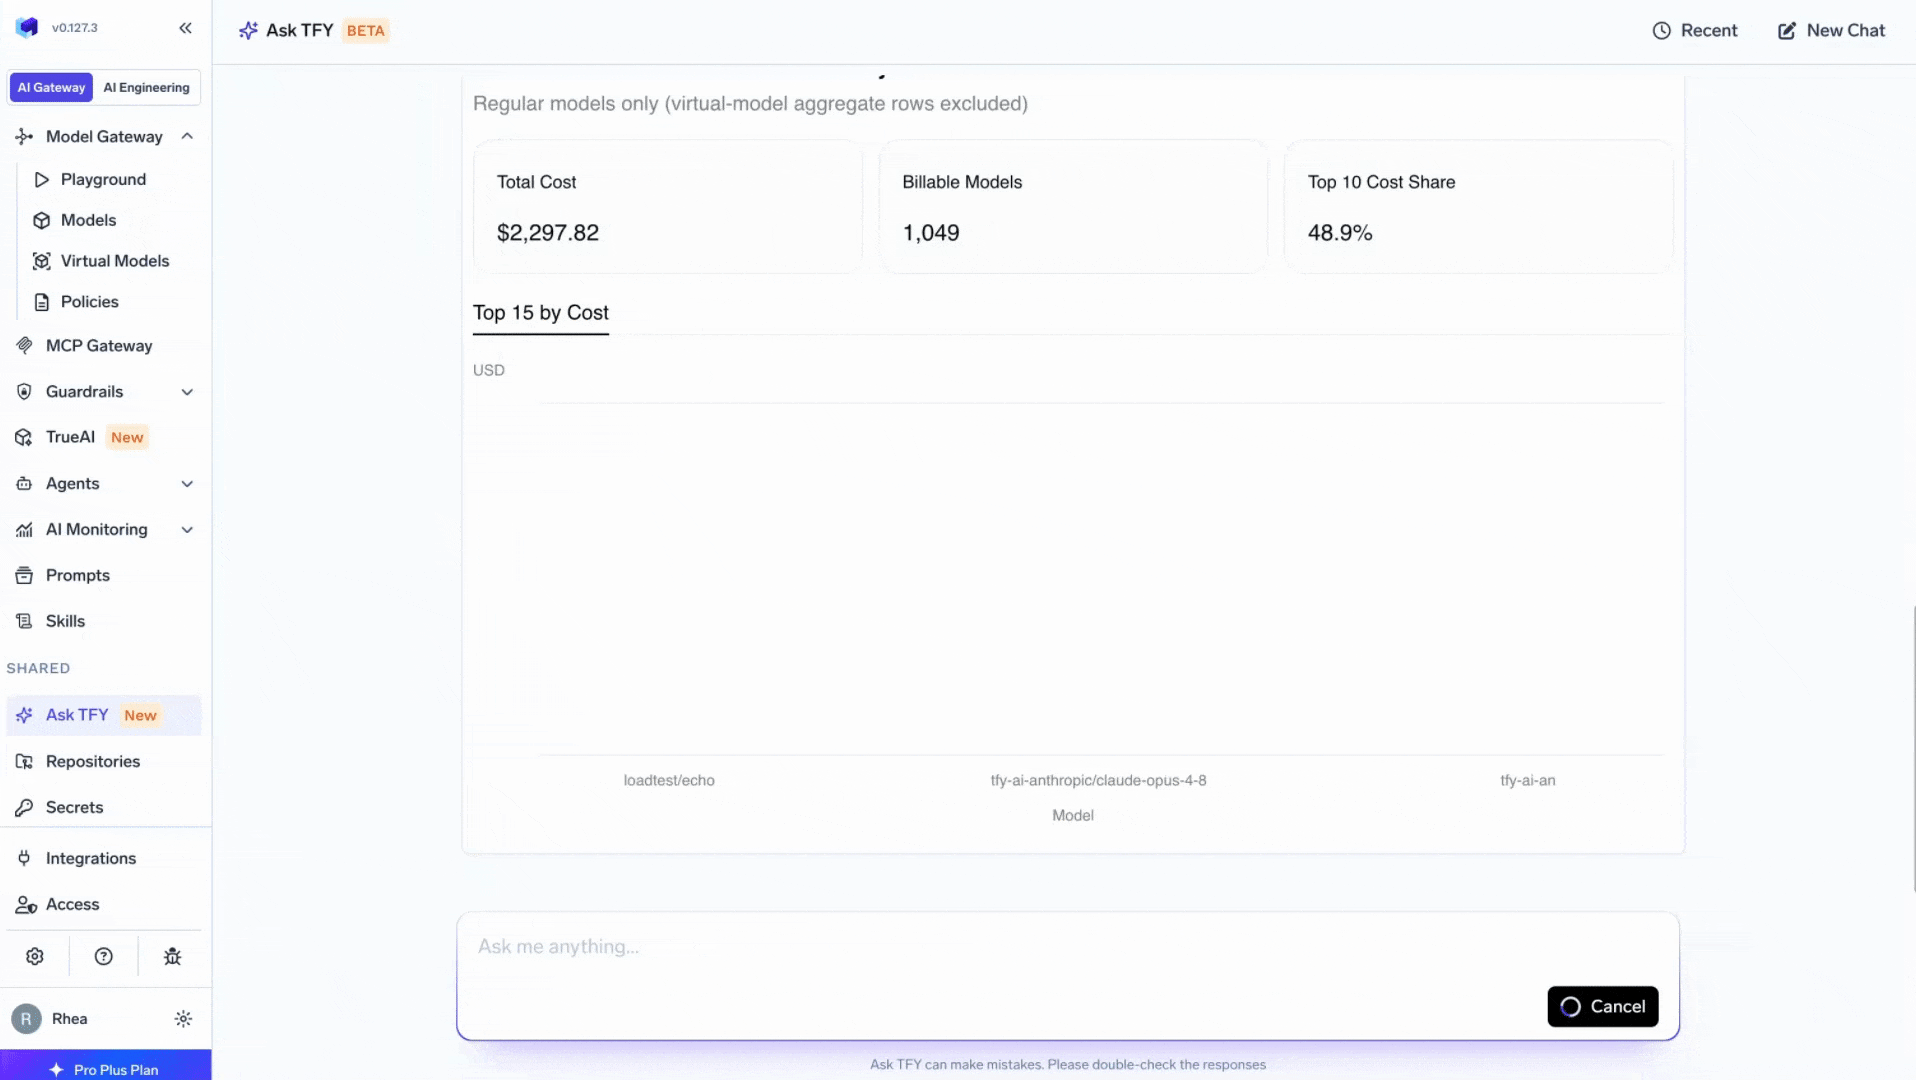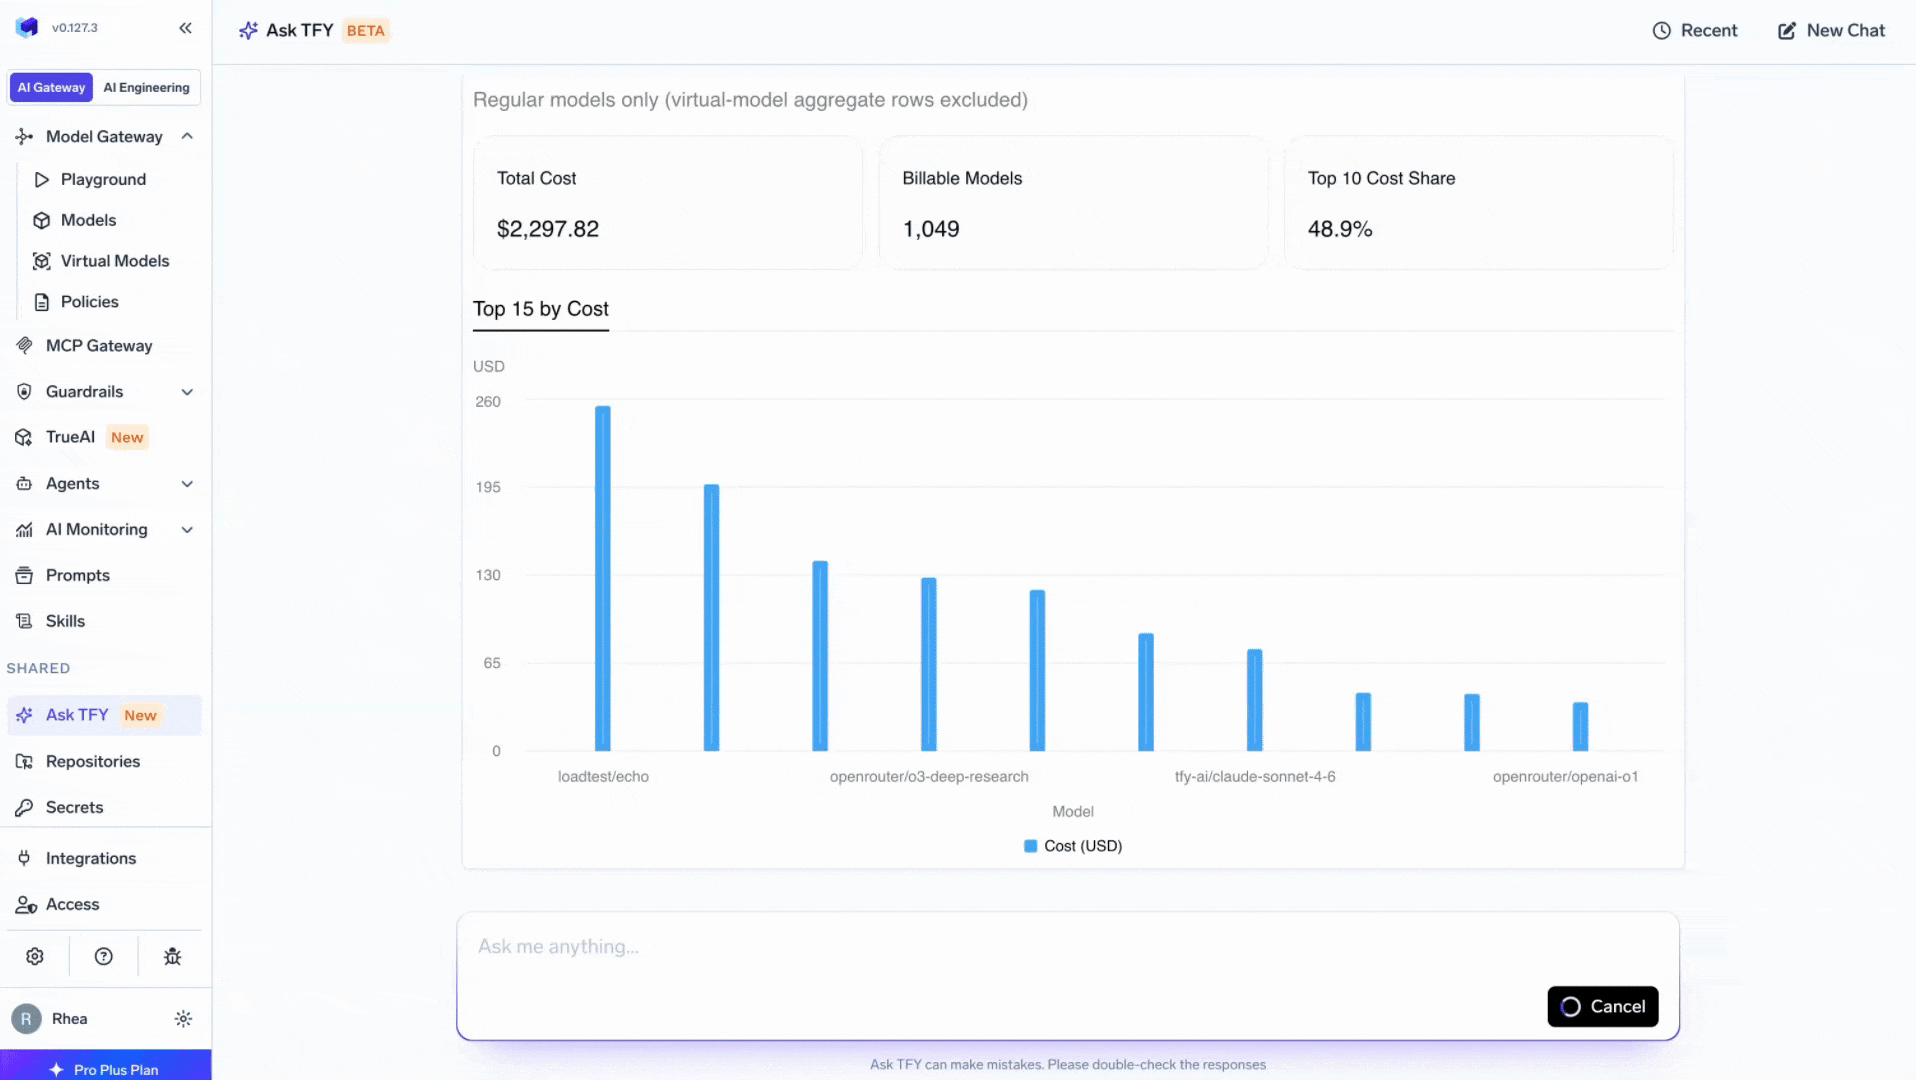
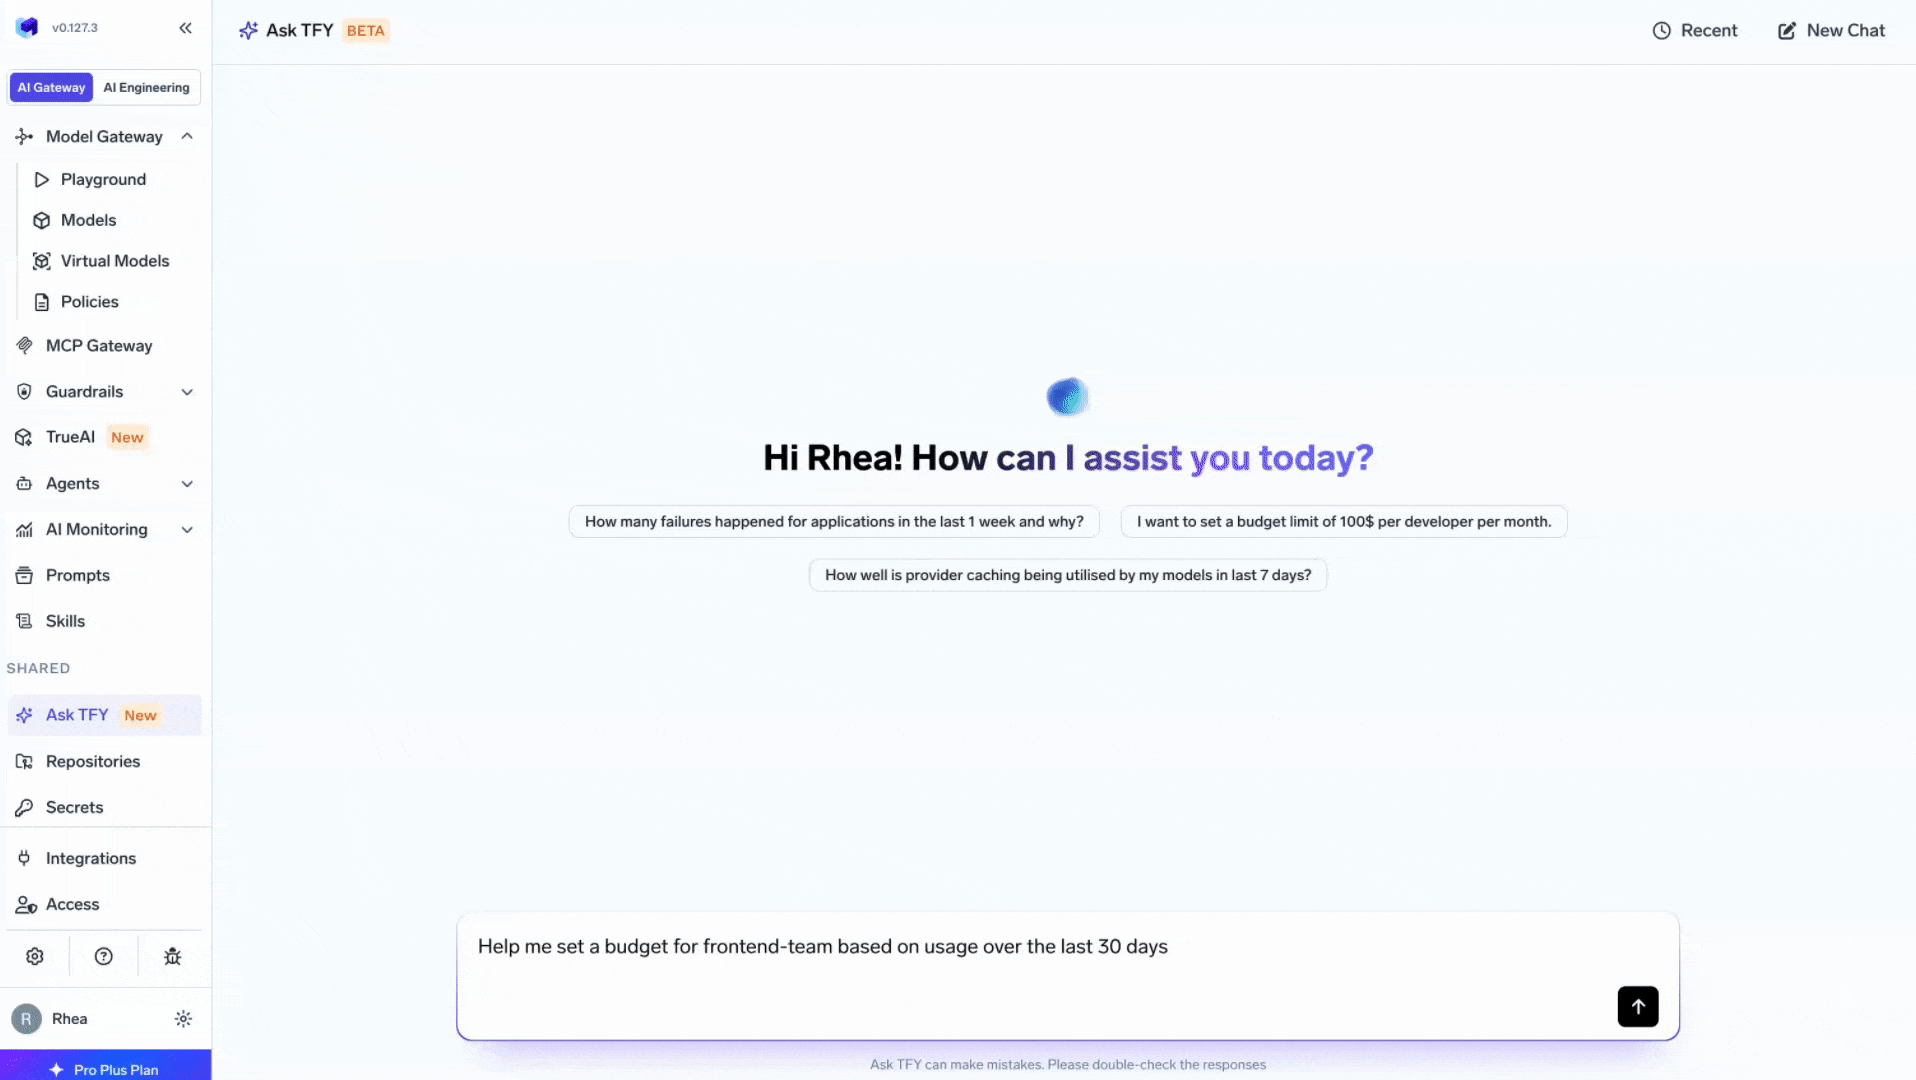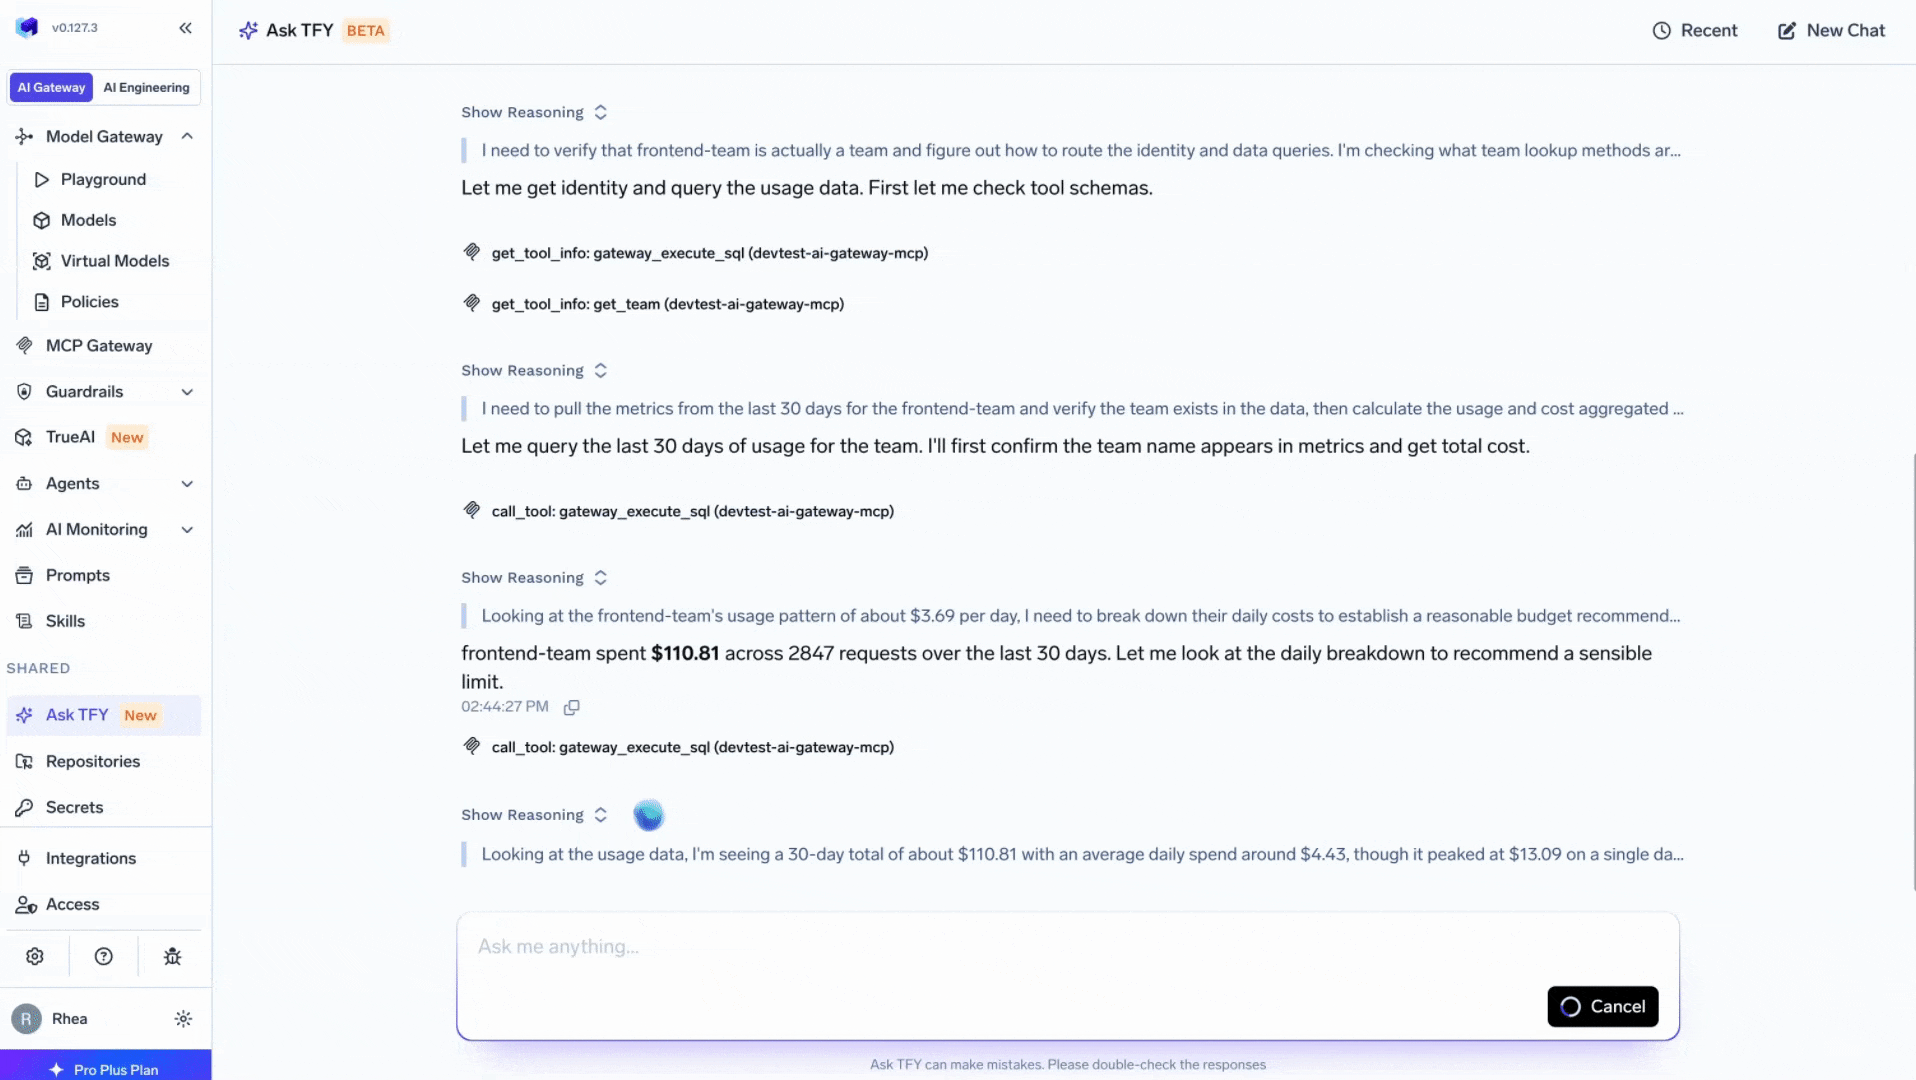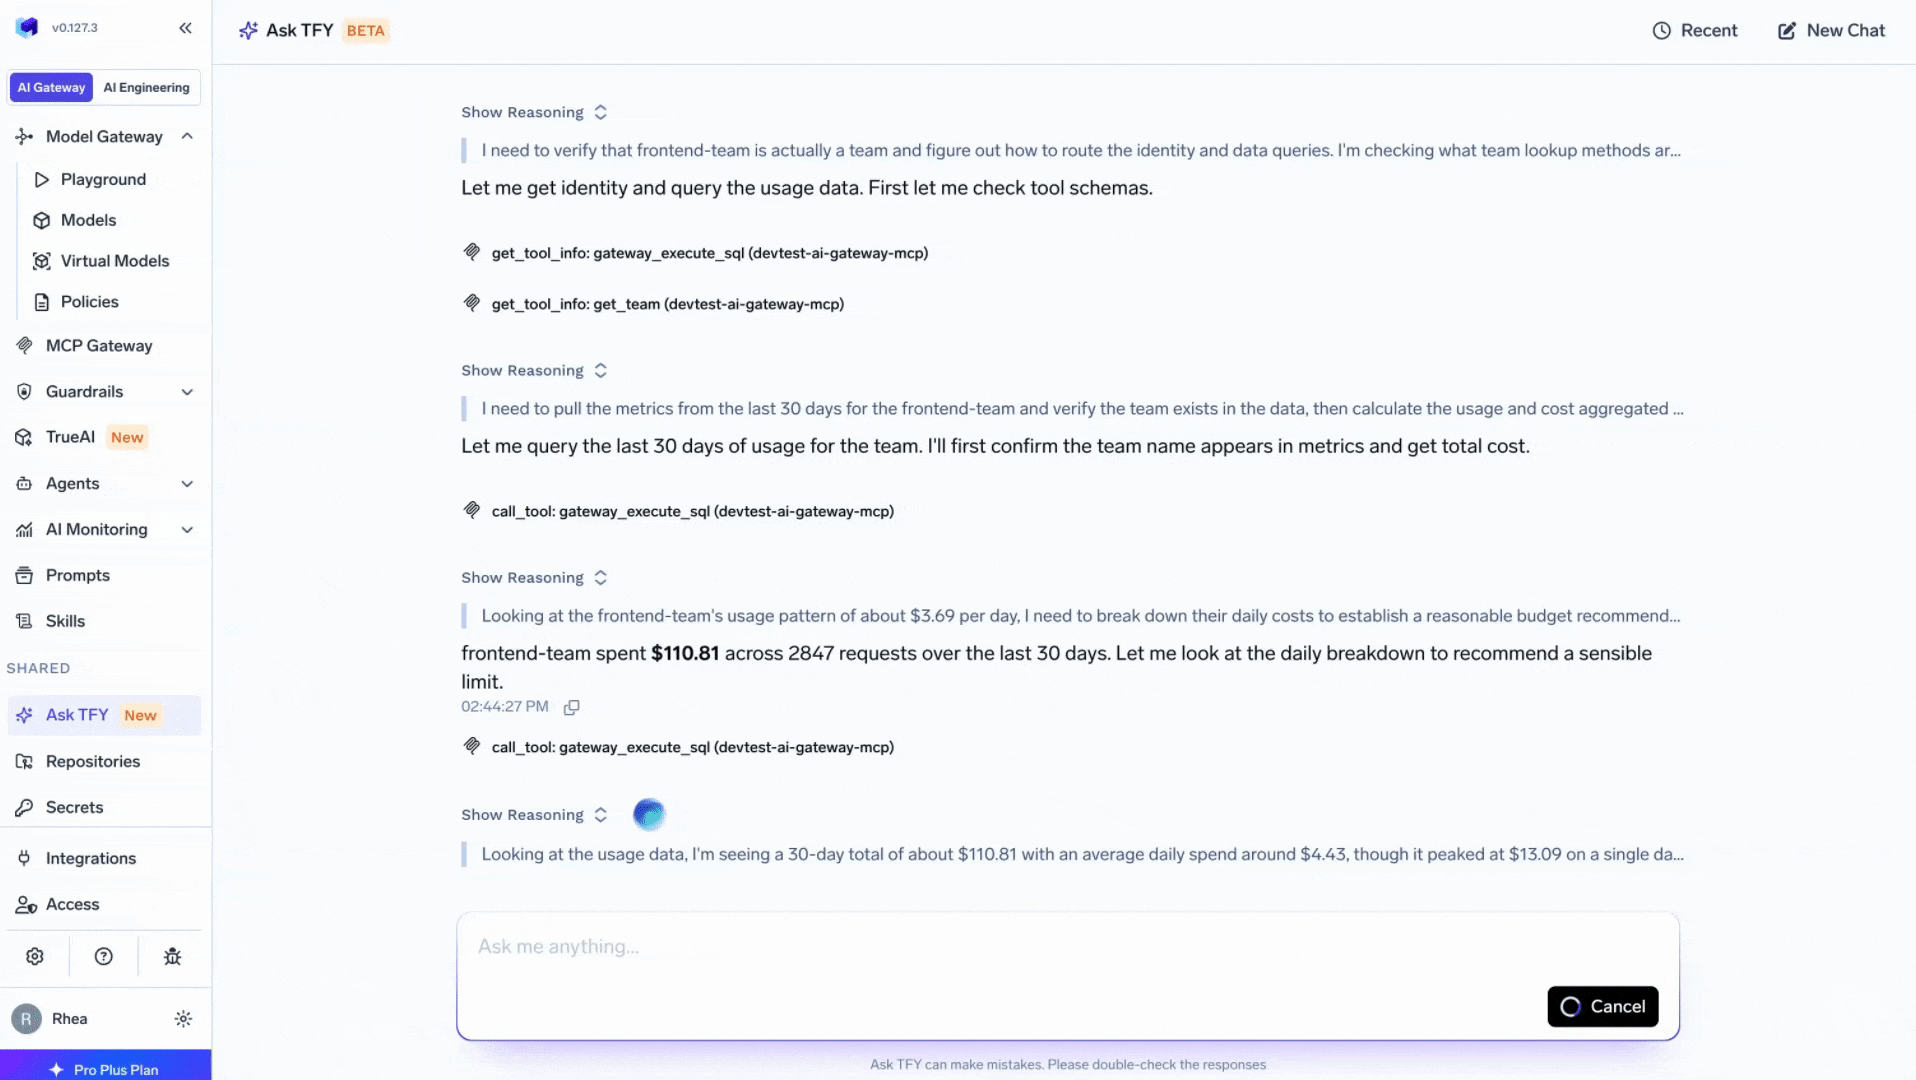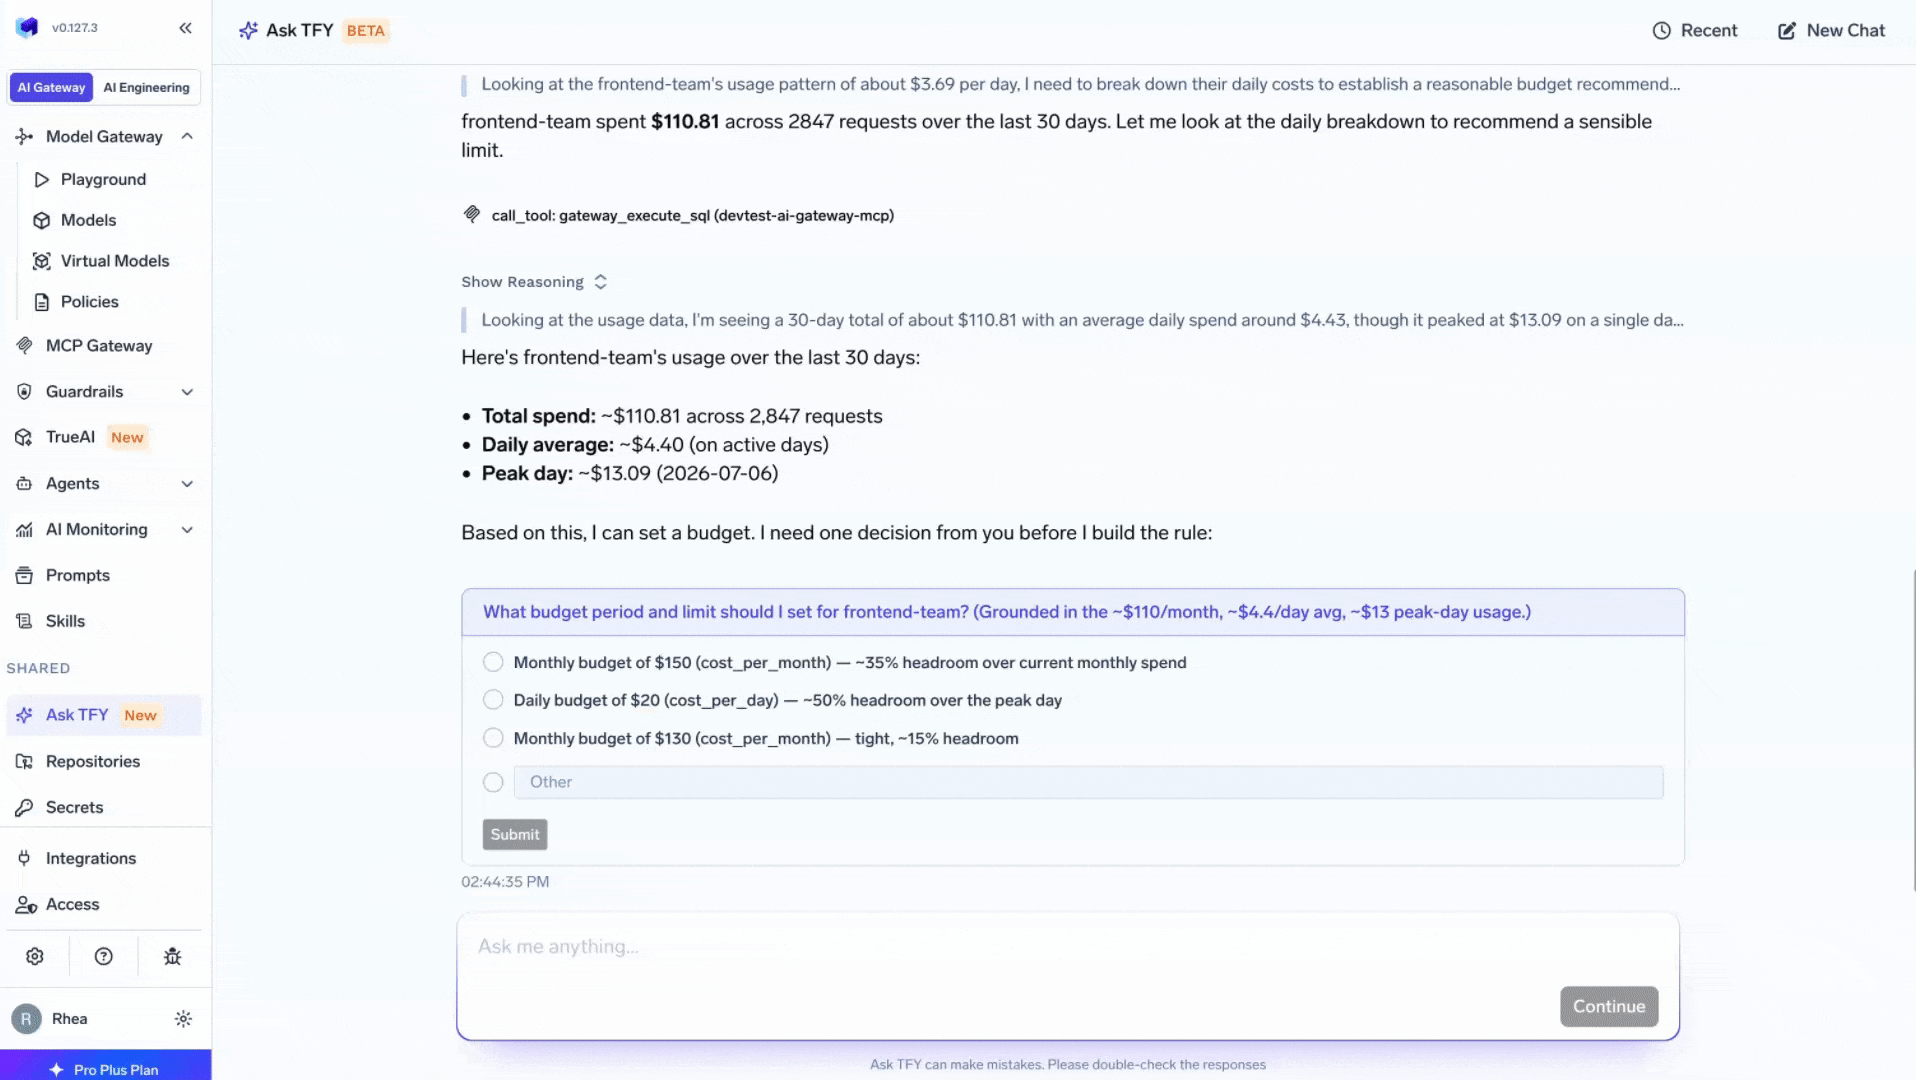
Ou pergunte sobre custos. Defina um intervalo de tempo, diga como deseja detalhar os gastos — por desenvolvedor, por aplicação, por modelo — e ele gerará a análise e proporá uma configuração de orçamento que você pode aplicar diretamente.
As perguntas que mais importam nas operações de IA raramente são aquelas que os dashboards padrão foram criados para responder. As ferramentas de observabilidade mostram o que aconteceu. O Ask TFY ajuda você a entender o porquê, decidir o que fazer e, então, executar a ação, sem sair da conversa.
Não há contexto para reconstruir entre abas, não há referências cruzadas manuais, não há necessidade de traduzir o que você encontrou no monitoramento para o que precisa ser alterado na configuração. O Ask TFY mantém tudo isso integrado e trabalha em cima disso para você.
Ele também sabe mais do que apenas seus dados. Pergunte algo que vá além do seu gateway, como uma nova biblioteca de terceiros se integra à sua configuração, o que a API de um determinado provedor de modelo espera ou como estruturar uma configuração que você nunca configurou antes, e ele buscará na documentação da TrueFoundry e na web para preencher as lacunas.
Da próxima vez que precisar entender o que sua IA está realmente fazendo em produção, ou precisar agir rapidamente, basta perguntar ao Ask TFY.
O Ask TFY já está disponível no TrueFoundry AI Gateway. Inscreva-se agora para começar.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada

















