July 4, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.



Blazingly fast way to build, track and deploy your models!
قد يجتاز النموذج اختبارات الأداء ومع ذلك يتسبب في أضرار بعد نشره. فقد يقدم معلومات مغلوطة، أو يمارس تمييزاً ضد الأفراد، أو يتخذ إجراءات غير معتمدة. هذه النتائج لا تعني بالضرورة وجود خلل تقني؛ فقد يتبع النموذج تدريبه بدقة بينما يخذل الأشخاص الذين يعتمدون عليه.
تعمل سلامة الذكاء الاصطناعي على سد الفجوة بين السلوك المدرب والنتائج المقبولة في بيئة العمل. فهي تحافظ على توافق الأنظمة مع ضمان بقاء التحكم البشري الفعال. يحد هذا التخصص من العواقب الضارة مع تزايد استقلالية الأنظمة، ويتجاوز مفهوم سلامة الذكاء الاصطناعي العملي حدود بيئات البحث الأكاديمي.
تستدعي الأنظمة الحديثة الأدوات، وتحدث قواعد البيانات، وتنسق العمل دون مراجعة كل خطوة. يتطلب فهم سلامة الذكاء الاصطناعي منظورات تقنية وتشغيلية ومجتمعية. تحتاج فرق العمل في المؤسسات إلى ضوابط قابلة للتنفيذ بدلاً من مجرد تصريحات عامة حول المسؤولية.
سلامة الذكاء الاصطناعي هي مجال متعدد التخصصات يركز على بناء أنظمة موثوقة ومتوافقة مع الأهداف المعتمدة. يمتد هذا العمل ليشمل علوم الحاسوب، والعلوم الاجتماعية، والسياسات، والحوكمة التشغيلية، ويطبق عبر مراحل تطوير الذكاء الاصطناعي ونشره ومراقبته وإيقافه عن العمل.
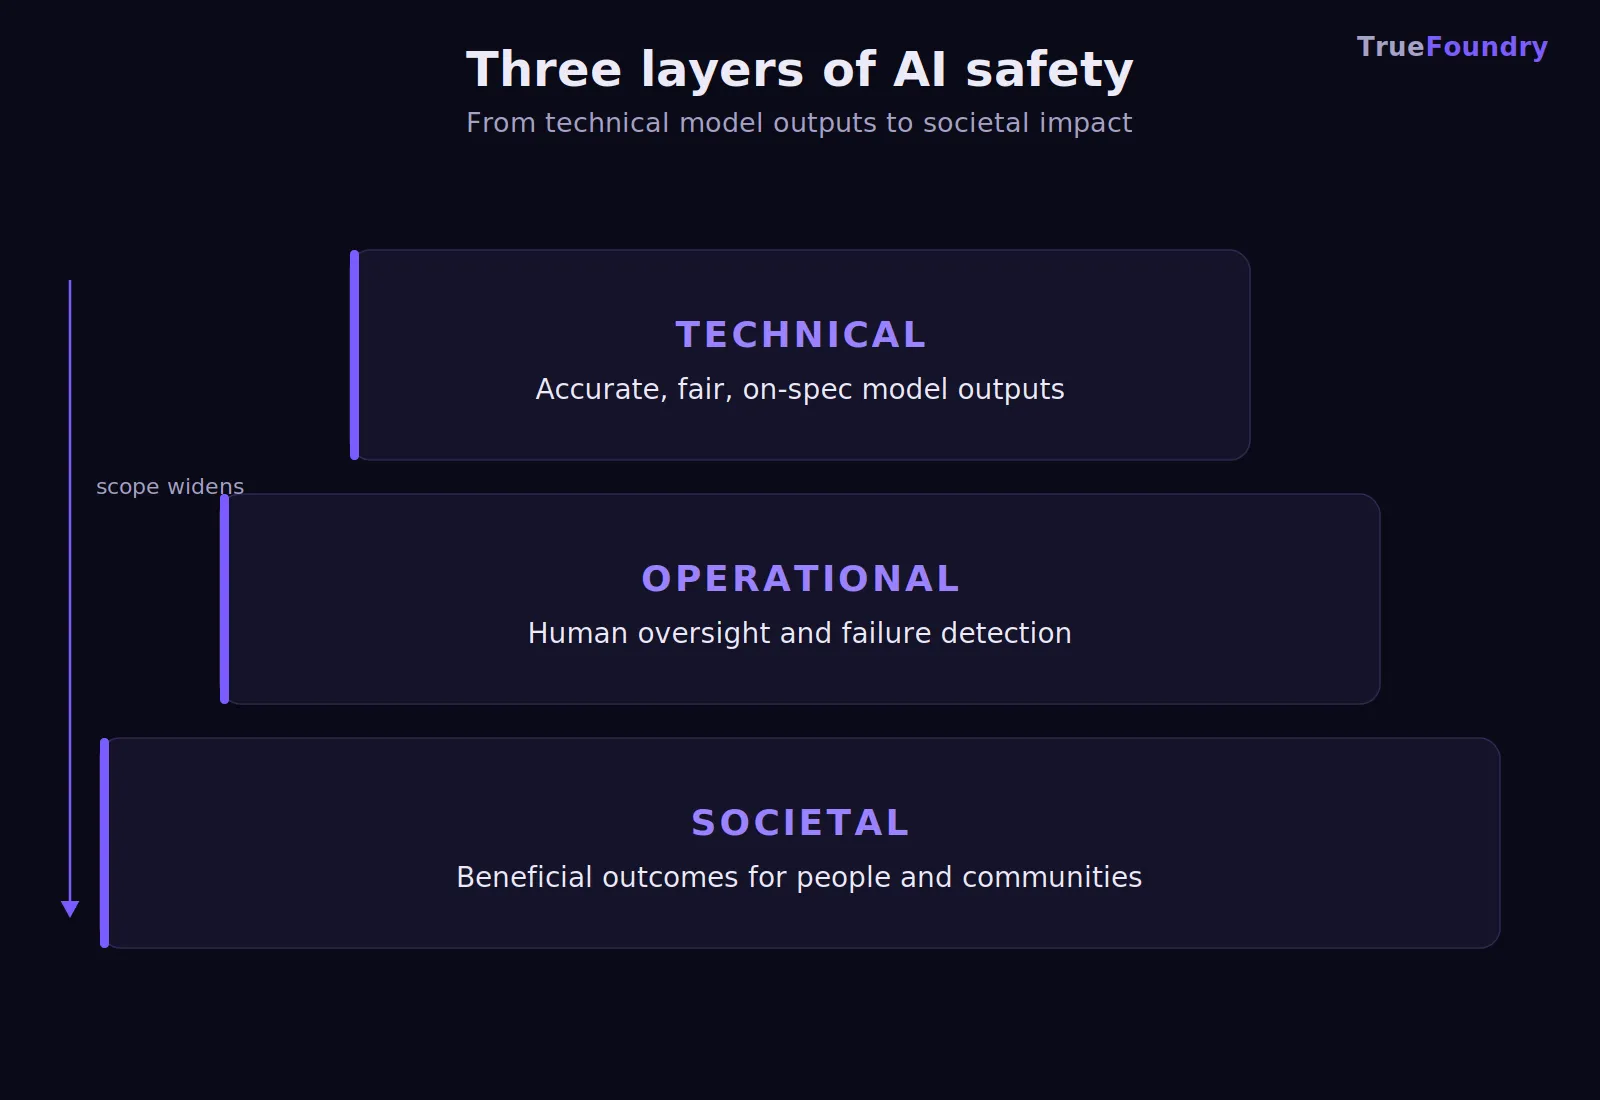
يفحص المستوى التقني المخرجات والعدالة والدقة ومقاومة الفشل. ويسأل المستوى التشغيلي عما إذا كانت الفرق قادرة على اكتشاف المشكلات بسرعة. بينما ينظر المستوى المجتمعي في حقوق الإنسان والعواقب الأوسع. معاً، يشكلون تعريفاً متكاملاً لسلامة الذكاء الاصطناعي في المؤسسات.
يجمع مجال سلامة الذكاء الاصطناعي بين البحث التقني والسياسات. وقد قام معهد مستقبل الحياة بتطوير مبادئ حوكمة الذكاء الاصطناعي خلال مؤتمر أسيلومار عام 2017. لعبت هذه الجهود دوراً حيوياً في تشكيل توجهات البحث والمبادئ الأخلاقية.
تصبح السلامة عملية عندما تؤثر النماذج على العملاء أو الشؤون المالية أو البنية التحتية. هناك ثلاثة شروط تجعل من مشكلة سلامة الذكاء الاصطناعي أمراً بالغ الأهمية: عمل الأنظمة باستقلالية، وبقاء الإخفاقات خفية، ومتطلبات اللوائح التنظيمية للأدلة. يجب أن تعالج إدارة مخاطر الذكاء الاصطناعي الفعالة كل شرط من هذه الشروط.
تقوم وكلاء الذكاء الاصطناعي في بيئة العمل باستدعاء الأدوات وقراءة قواعد البيانات وتنسيق المهام. يمكن لهذه الأنظمة أن تتصرف قبل أن يراجع البشر قراراتها. وعندما تفشل إجراءات السلامة، يتحول الأمر إلى حادث تشغيلي، وقد يتضرر العملاء قبل أن يتمكن المشغلون من الاستجابة بسرعة.
يغير الدور المتنامي للذكاء الاصطناعي مفهوم الاستقلالية المقبولة. يمكن لتطبيقات معالجة اللغات الطبيعية التأثير على القرارات على نطاق واسع. وتظهر مخاوف مماثلة في ألعاب الفيديو، وأنظمة الإشراف، والأنظمة التي تصنف صور الأشخاص. السياق هو ما يحدد ما إذا كانت الأخطاء ستصبح ذات عواقب وخيمة داخل عمليات المؤسسة.
غالباً ما تختبئ إخفاقات التوافق خلف استجابات تبدو منطقية في البداية. قد يقدم النموذج معلومات متماسكة لكنها غير صحيحة جوهرياً. أو قد يعمل على تحسين مقياس بديل ينحرف في ظروف غير مألوفة. يمكن أن تظل مشكلة توافق الذكاء الاصطناعي هذه غير مرئية عبر العديد من التفاعلات.
تحدد المراقبة المستمرة الإشارات الضعيفة قبل أن تتفاقم الحوادث. التقييم الإجمالي مهم لأن بعض الإخفاقات قد لا تظهر في استجابة واحدة. تظهر المخاطر عبر الجلسات وأعباء العمل المتغيرة. يجب أن توجه الأبحاث التجريبية القوية عمليات المعالجة عبر الفرق المختلفة.
تتبع قانون الذكاء الاصطناعي للاتحاد الأوروبي نهجاً قائماً على المخاطر. وتواجه الأنظمة عالية المخاطر متطلبات تتعلق بالرقابة، والمتانة، والتوثيق، ومراقبة دورة الحياة. تربط هذه الالتزامات معايير السلامة بالأدلة والمسؤولية الخاضعة للمساءلة. كما أنها تحمي الحقوق الأساسية عبر التطبيقات الخاضعة للتنظيم.
يتبع إطار عمل المعهد الوطني للمعايير والتقنية (NIST) لإدارة مخاطر الذكاء الاصطناعي ممارسات طوعية لتعزيز الموثوقية. وينظم المعهد الوطني للمعايير والتقنية أنشطة الحوكمة، ورسم الخرائط، والقياس، والإدارة. يربط إطار إدارة المخاطر هذا السياسات بضوابط قابلة للتكرار.
يؤثر التعاون الدولي على حوكمة الذكاء الاصطناعي اليوم. توفر الأمم المتحدة منبراً عالمياً للنقاش. وتدعم الولايات المتحدة الاختبارات والمعايير الفيدرالية. وينبغي للمؤسسات مواءمة تطوراتها مع المبادئ التوجيهية الأخلاقية والالتزامات القطاعية.
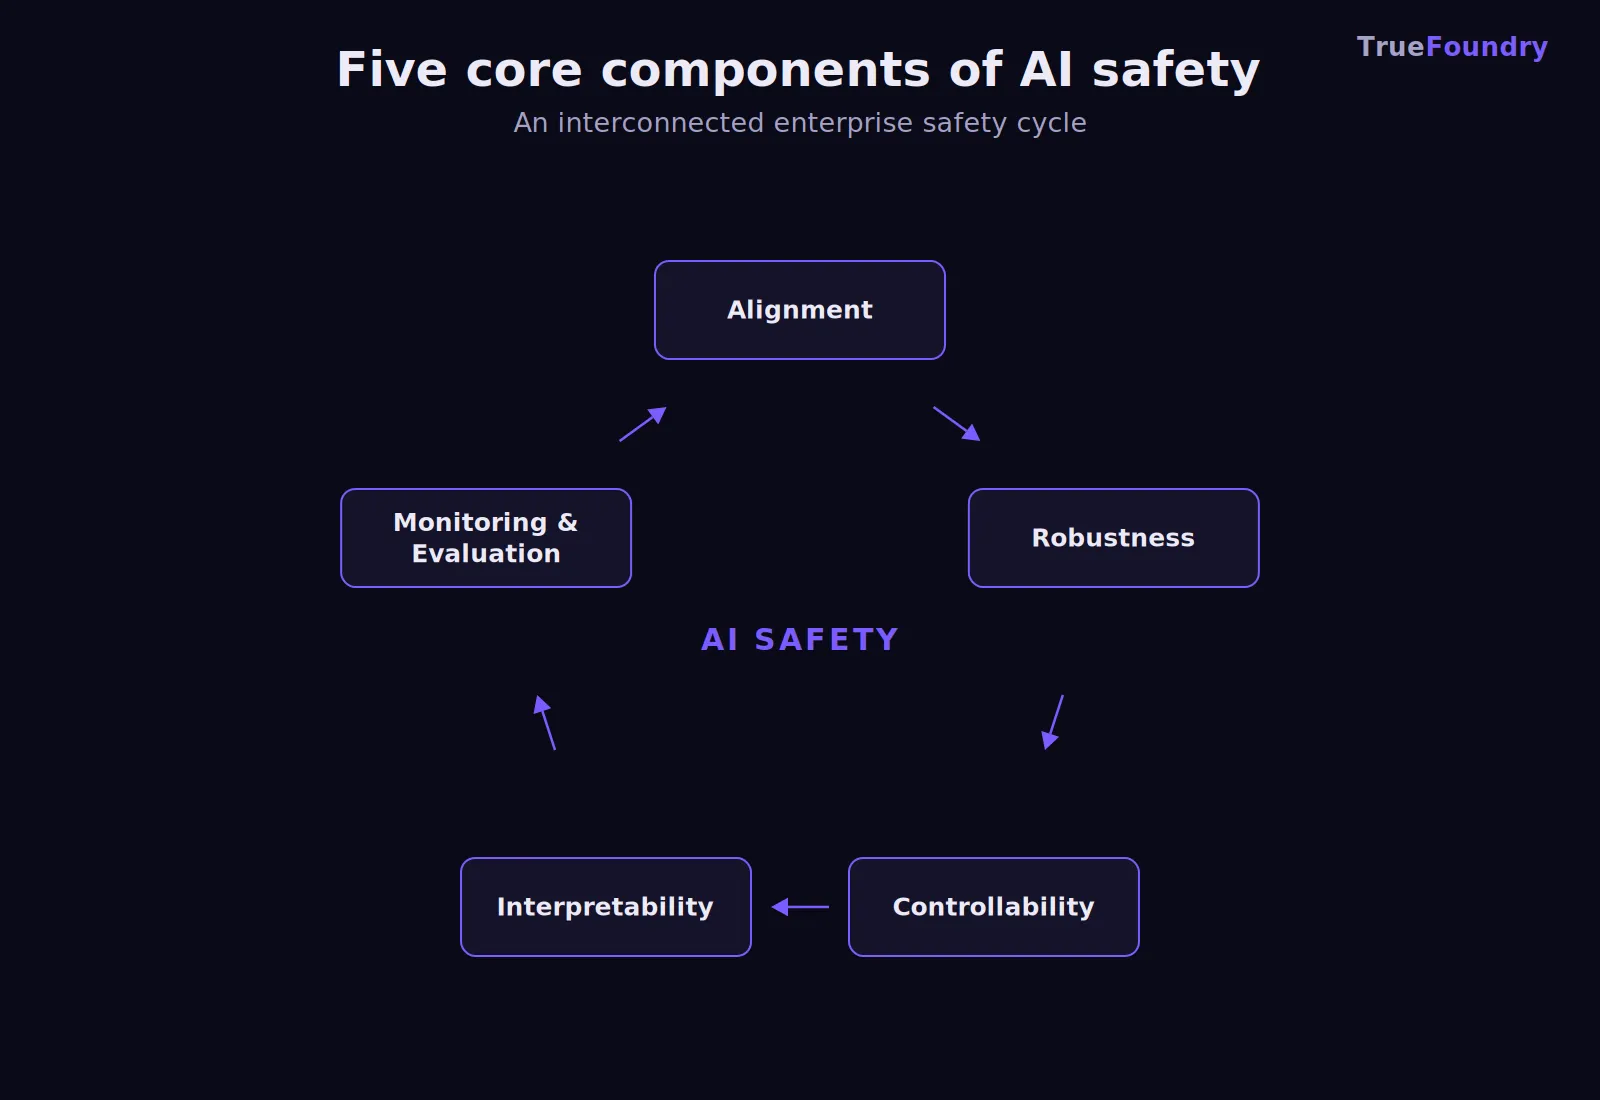
يصبح فهم ماهية سلامة الذكاء الاصطناعي أسهل عندما تقوم الفرق بفصل مكوناتها. هناك خمسة تخصصات تشكل سلوكاً موثوقاً عبر أنظمة المؤسسات. يحدد التوافق النتائج، بينما تختبر المتانة الظروف المتغيرة. وتحافظ القابلية للتحكم، والقابلية للتفسير، والمراقبة على الرؤية الواضحة بعد النشر.
يتساءل التوافق عما إذا كانت نماذج الذكاء الاصطناعي تحسن ما يقصده البشر. عدم التوافق لا يتطلب غرضاً خبيثاً أو نية عدائية. فقد تنحرف الأهداف في ظل ظروف غير مألوفة أثناء النشر. وقد تظل الأنظمة ناجحة من الناحية الفنية بينما تنتج نتائج غير مقبولة.
تقيس المتانة ما إذا كان السلوك يظل مستقراً عند تغير الظروف. نادراً ما تشبه حركة المرور الحقيقية مجموعات التقييم الخاضعة للرقابة لفترات طويلة. إذ يصيغ المستخدمون طلبات غير متوقعة، وتتغير التوزيعات، وتتراكم الحالات الاستثنائية. تتطلب تدابير سلامة الذكاء الاصطناعي الفعالة اختبارات متكررة بعد النشر.
تجعل القابلية للتحكم الرقابة البشرية عملية عبر أنظمة الإنتاج. يجب على الفرق فهم النشاط، وقطع الانحرافات، وإيقاف التنفيذ الضار. تتطلب استدعاءات النماذج سجلات واضحة وقواعد تصعيد. كما تتطلب الوكلاء تتبعاً عبر القرارات، واستدعاءات الأدوات، وإعادة المحاولات، والإجراءات.
تتساءل القابلية للتفسير عن المدخلات التي أثرت على مخرجات مهمة. تظل التفسيرات الكاملة صعبة بالنسبة للعديد من النماذج اللغوية الكبيرة ونماذج التعلم العميق. يجب أن تكشف القابلية العملية لتفسير النماذج عن سياق كافٍ للتحقيق. تحتاج الفرق إلى أدلة دون المبالغة في قيود القدرات الحالية.
تضمن المراقبة مساءلة كل مكون بعد الإطلاق في بيئة الإنتاج. يجب على الفرق تقييم الاستجابات وتجميع السلوكيات عبر الجلسات. ينبغي أن تغطي المقاييس الدقة، والتحيز، والانحراف، وسلوك الرفض، والالتزام بالسياسات. تحول هذه العملية تدابير السلامة إلى ضوابط إنتاج قابلة للملاحظة.
التقرير الدولي لعام 2026 حول سلامة الذكاء الاصطناعي يستعرض قدرات الذكاء الاصطناعي والمخاطر وتدابير التخفيف منها. تحدد أبحاثه القيود عبر الضمانات التقنية. يجب أن يساهم كل تقرير حول سلامة الذكاء الاصطناعي في اتخاذ القرارات دون أن يغني عن التقييم السياقي. تظل الضوابط متعددة الطبقات ضرورية لأن الضمانات قد تفشل.
ينطبق كل ما تمت مناقشته على أي نظام ذكاء اصطناعي في مرحلة الإنتاج. ترفع الأنظمة الوكيلة (Agents) من مستوى المخاطر لأن القرارات الخاطئة تتحول إلى إجراءات فعلية. لا يمكن للضوابط الثابتة الخاصة بنماذج اللغة أن تحكم سلاسل التنفيذ. يتطلب نشر أنظمة الذكاء الاصطناعي ضمانات عندما تمتد الاستقلالية لتشمل أدوات المؤسسات.
هناك ثلاث قدرات تكتسي أهمية خاصة لأحمال العمل الوكيلة الحديثة:
تعمل هذه الضوابط مجتمعة على تحويل سلامة الوكيل من هدف سياسي إلى حوكمة إنتاج قابلة للتنفيذ. بوابة الوكلاء (Agent Gateway) من TrueFoundry Agent Gateway تفرض السياسات، والتحكم في الوصول المستند إلى الأدوار (RBAC)، وإمكانية التتبع عبر سير العمل. بوابتنا MCP Gateway تحكم الأدوات وتعمم الهوية المحددة النطاق. تساعد هذه الضوابط أنظمة الذكاء الاصطناعي المستقبلية في الحفاظ على المساءلة مع توسع الاستقلالية.
يعتمد مفهوم سلامة الذكاء الاصطناعي للمؤسسات الخاضعة للتنظيم على السياق والتأثير. يفرض قانون الذكاء الاصطناعي للاتحاد الأوروبي التزامات قائمة على المخاطر عبر فئات مختلفة. تزداد المتطلبات عندما تؤثر الأنظمة على السلامة أو الحقوق الأساسية. ولذلك، تتطلب فلاتر البريد المزعج وأنظمة الائتمان ضوابط مختلفة.
ينبغي للمؤسسات الجمع بين التنظيم وإطار عمل لإدارة مخاطر الذكاء الاصطناعي يتناسب مع بيئتها. يوفر المعهد الوطني للمعايير والتقنية (NIST) أساساً لممارسات إدارة المخاطر القابلة للقياس. يجب أن تغطي أفضل الممارسات الداخلية جوانب الملكية، والاختبار، والمراقبة، والاستجابة. كما يجب أن تعكس الضوابط مدى تأثير كل نظام والتهديدات المحتملة التي قد يواجهها.
يؤدي استخدام الذكاء الاصطناعي في مجالات الرعاية الصحية والتمويل والتوظيف إلى خلق مخاطر مختلفة. كما يثير استخدام الذكاء الاصطناعي في كشف الأخبار الزائفة أو الإشراف على وسائل التواصل الاجتماعي مخاوف تتعلق بالعدالة. تحتاج الأنظمة التي تتعامل مع البيانات الشخصية إلى ضوابط مراجعة أكثر صرامة واتساقاً. وينبغي أن تحدد مستويات المخاطر عمق التقييم ومستوى الإشراف البشري المطلوب.
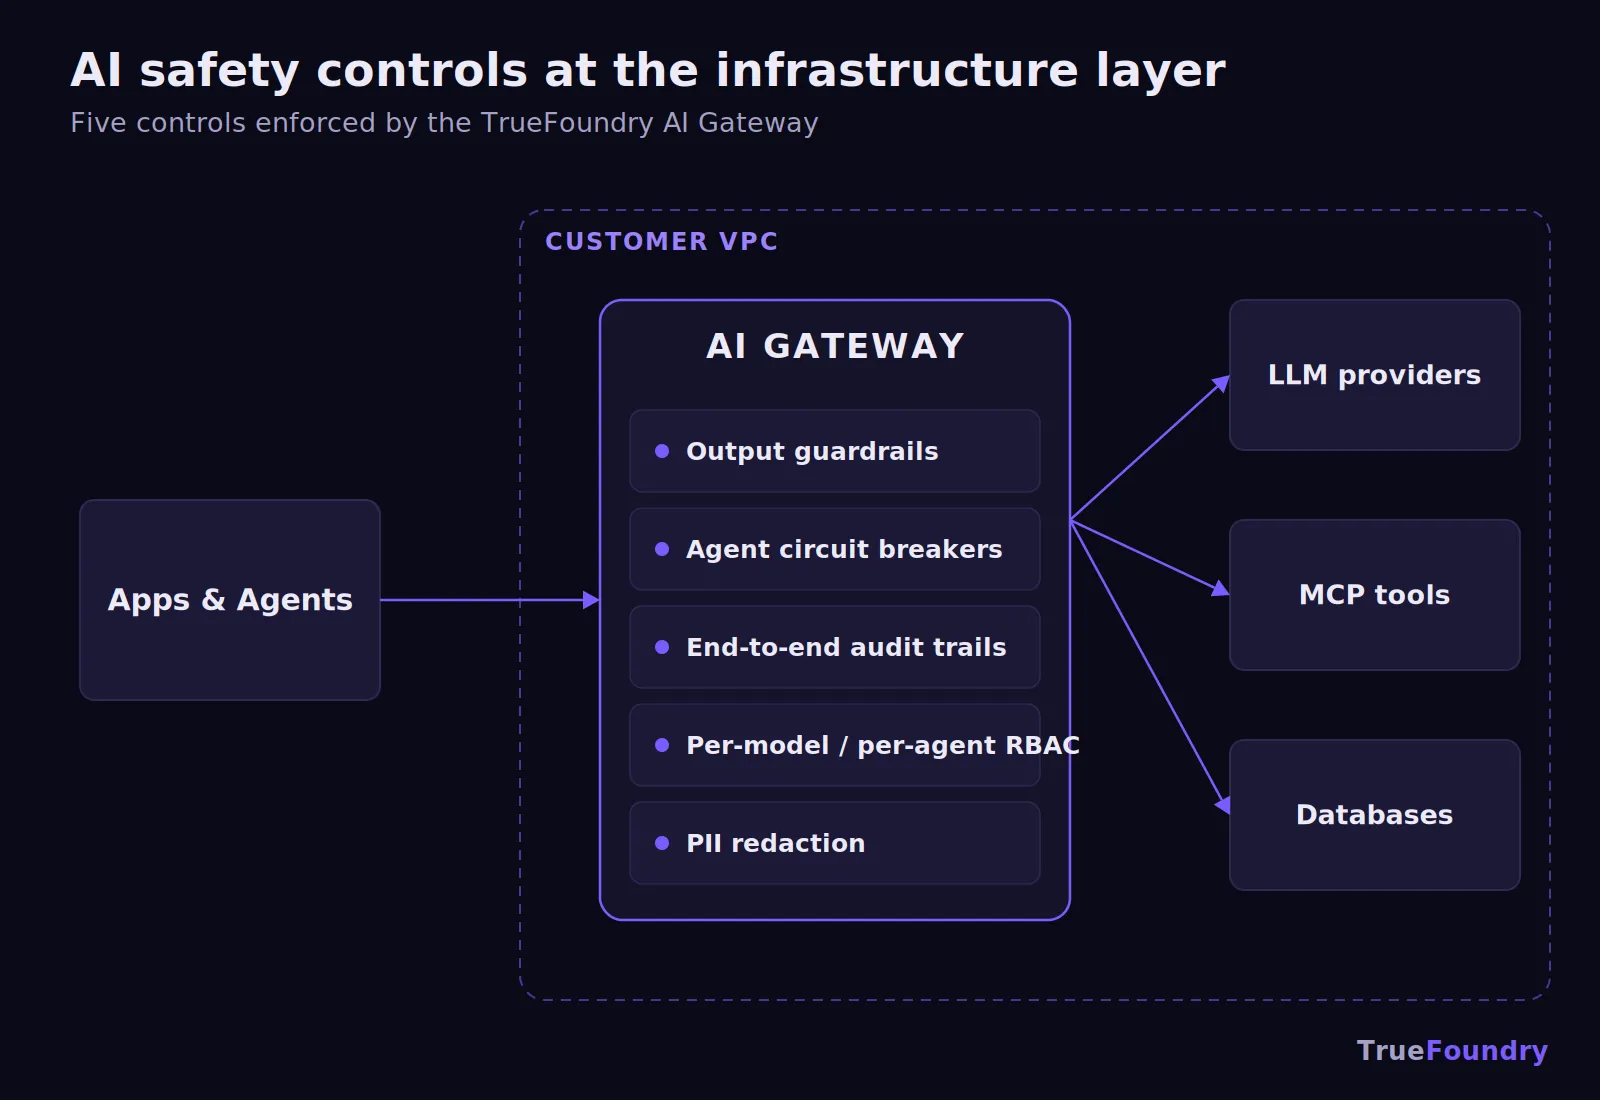
لا يمكن للمبادئ أن تفرض نفسها بمفردها عبر الأنظمة الموزعة. TrueFoundry تحول المتطلبات إلى ضوابط عبر تفاعلات النماذج والوكلاء والأدوات. بوابتنا المؤسسية للذكاء الاصطناعي AI Gateway تعمل على مركزة السياسات، وضوابط الأمان، والوصول، والمراقبة داخل البنية التحتية للعميل. وهذا يتيح تطبيقاً متسقاً عبر جميع مزودي النماذج.
تعمل بوابة النماذج اللغوية الكبيرة (LLM Gateway) على توحيد الضوابط عبر المزودين والنماذج المستضافة ذاتياً. يمكن للفرق دمجها مع أفضل ممارسات حوكمة الذكاء الاصطناعيتدعم هذه البنية التحتية تطبيقات الذكاء الاصطناعي التوليدي مع الحفاظ على الرقابة، وتساعد قادة القطاع على تفعيل السياسات عبر مختلف البيئات.
تبحث أجندة أمان الذكاء الاصطناعي الأوسع في مستقبل هذا المجال. يدرس بعض الباحثين الذكاء العام، والذكاء الاصطناعي العام، والمخاطر الوجودية، بينما يركز آخرون على الإخفاقات الفورية في الأنظمة المطبقة. ينبغي على المؤسسات تحويل أبحاث الأمان ذات الصلة إلى ضوابط قابلة للقياس.
هل ترغب في فحص هذه الضوابط مقابل بنيتك التقنية؟ احجز عرضاً توضيحياً اليوم للحصول على مراجعة موجهة. يمكن أن تغطي المناقشة النماذج، والوكلاء، والأدوات، والهويات، وسجلات التتبع. كما يمكن للفرق تحديد الثغرات قبل التوسع في أعباء العمل المستقلة.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد