October 14, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.


Published: October 12, 2026
Blazingly fast way to build, track and deploy your models!
استخدمنا أداة GuideLLM لإجراء اختبارات متزامنة على ثلاثة نماذج بحجم 8 مليار بارامتر على وحدة معالجة رسوميات NVIDIA A10 (سعة 24 جيجابايت): وهي Qwen3-8B، وLlama 3.1 8B Instruct، وMinistral 8B. شمل اختبار أداء vLLM هذا تدرجًا في التزامن من 4 إلى 256 مستخدمًا في وقت واحد عبر نوعين من أحمال العمل: الدردشة القصيرة وتصنيف النوايا. صمد نموذج واحد فقط عبر النطاق الكامل، بينما لم يتمكن النموذجان الآخران من ذلك.
تم تشغيل النماذج الثلاثة جميعها بصيغة FP16 على vLLM، وتم تقديمها عبر نقطة النهاية القياسية للبث /v1/chat/completions. حافظت أداة GuideLLM على عدد ثابت من الطلبات قيد المعالجة (N) لمدة 90 ثانية لكل مستوى تزامن (4، 8، 16، 32، 64، 128، 256)، مع فترة تهدئة مدتها 30 ثانية بين كل مستوى.
نوعان من أحمال العمل:
تم استخدام نفس إصدار vLLM، ونفس إعدادات البوابة، ونفس وحدة معالجة الرسوميات للنماذج الثلاثة. النتائج أدناه تعكس هذه الظروف.
يستخدم الجدول الملخص 64 مستخدمًا متزامنًا للمقارنة في الدردشة القصيرة. هذا هو آخر مستوى تزامن عمل فيه نموذج Llama بشكل سليم (بنسبة خطأ 0%)، لذا فهو يمثل الأساس الأكثر عدالة للمقارنة بين النماذج الثلاثة.
يتمتع نموذج Qwen3 بأقل متوسط انتظار (524 مللي ثانية عند النسبة المئوية 50) وأفضل استقرار في الذيل (2,840 مللي ثانية عند النسبة المئوية 95). يتفوق Llama في معالجة رموز أكثر بنسبة 11% في الثانية، لكن متوسط انتظار المستخدم للرمز الأول يبلغ 2,569 مللي ثانية مقارنة بـ 524 مللي ثانية لنموذج Qwen3. هناك ملاحظة بارزة في البيانات: النسبة المئوية 95 للزمن الكلي (E2E) لنموذج Llama (10.4 ثانية) أقل من Qwen3 (11.4 ثانية) على الرغم من أن زمن الوصول للرمز الأول (TTFT) أسوأ بكثير. يبدأ Llama ببطء ولكنه يفك التشفير بسرعة؛ فبمجرد بدء تدفق الرموز، فإنها تتدفق أسرع مما هي عليه في Qwen3. ومع ذلك، بالنسبة لواجهات المستخدم التي تعتمد على البث، فإن تأخير الرمز الأول هو ما يشعر به المستخدمون فعليًا.
تتوفر تفاصيل النسب المئوية الكاملة عند كل مستوى تزامن، ونتائج حركة المرور المفاجئة (Poisson)، وملفات CSV القابلة للتنزيل في تقرير اختبار الأداء التفاعلي التقرير.
عند مستويات التزامن المنخفضة، بدأت النماذج الثلاثة تقريبًا بنفس زمن الوصول للرمز الأول (TTFT) عند النسبة المئوية 50، بحوالي 350 مللي ثانية. حافظ Qwen3 على هذا المستوى، ففي حالة 16 مستخدمًا متزامنًا، بلغ زمن الوصول لـ Qwen3 عند النسبة المئوية 50 حوالي 388 مللي ثانية، بينما ارتفع لدى Llama إلى 794 مللي ثانية.
أكمل نموذج Qwen3 جميع الطلبات عند كل مستويات التزامن وصولاً إلى 256 طلباً دون أي إخفاق. بلغ زمن الوصول إلى الرمز الأول (TTFT) عند النسبة المئوية الخمسين (p50) مع 64 طلباً متزامناً 524 مللي ثانية، بمعدل إنتاجية 851 رمزاً في الثانية.
فرضيتنا حول سبب صمود النموذج تحت الضغط هي أن Qwen3 يستخدم تقنية QK-LayerNorm، التي تعمل على تثبيت درجات الانتباه (attention scores) في ظل ذاكرة التخزين المؤقت (KV cache) الطويلة، كما أن بصمة الذاكرة لكل طبقة أصغر قليلاً، مما يمنح vLLM مساحة أكبر في الجدولة قبل أن تبدأ الطلبات في الانتظار عند البوابة. أما نموذج Llama، فيمتلك طبقة تغذية أمامية (FFN) أكبر (14,336 مقابل 12,288 في Qwen3)، مما يعزز الإنتاجية لكل رمز، لكنه يملأ خط معالجة فك التشفير بسرعة أكبر، مما يترك مساحة أقل للطلبات الجديدة مع زيادة التزامن. لا نزال نبحث في الأمر، لكن يبدو أن اختلاف البنية المعمارية يلعب دوراً جوهرياً هنا.
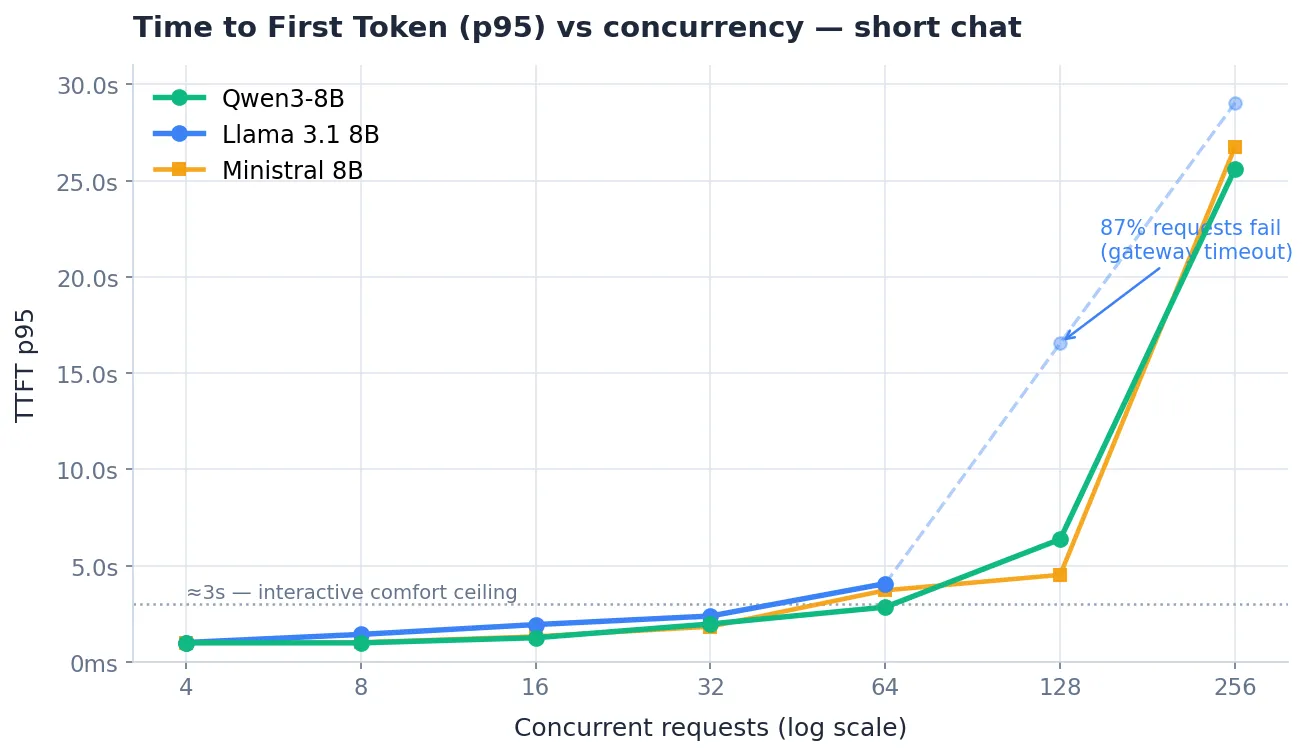
سجل Llama أعلى إنتاجية خام عند الذروة: 1,181 رمزاً في الثانية عند مستوى تزامن 256. ومع ذلك، عند مستوى تزامن 128، تلقت 86.9% من الطلبات خطأ 408 (انتهاء المهلة). رقم 1,181 رمزاً في الثانية مستمد من الطلبات القليلة التي نجحت في المرور بعد أن تخلص الخادم من معظم قائمة الانتظار الخاصة به.
عند 64 طلباً متزامناً (آخر نقطة أداء مستقر)، قدم Llama إنتاجية 947 رمزاً في الثانية مع زمن وصول للرمز الأول (TTFT) عند النسبة المئوية 95 (p95) بلغ 4,062 مللي ثانية ونسبة خطأ 0%. هذا يعني إنتاجية أعلى بنسبة 11% من Qwen3 عند نفس الحمل. بالنسبة للاستدلال بالدفعات (batch inference) أو خطوط المعالجة غير المتزامنة حيث تكون عمليات إعادة المحاولة مقبولة، فإن ميزة الإنتاجية هذه حقيقية. أما للاستخدام التفاعلي، فيُنصح بضبط التزامن بين 32 و64.
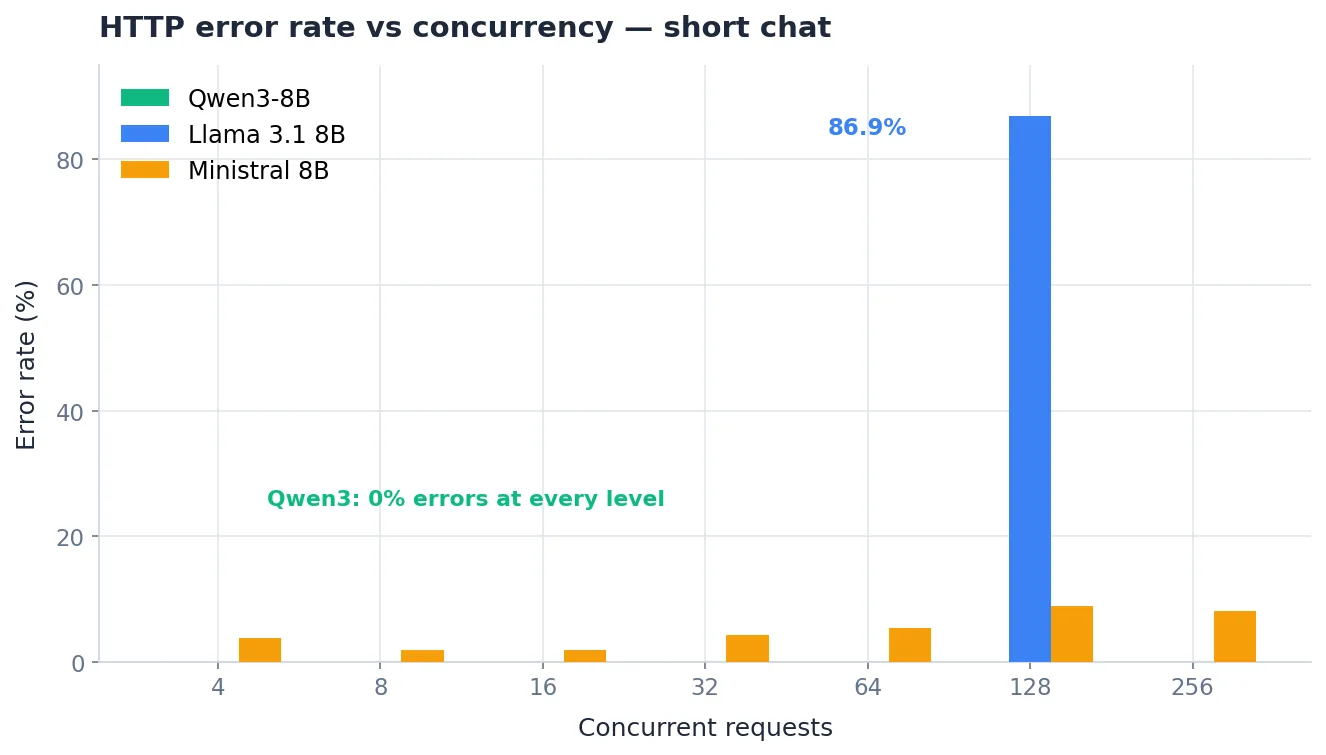
يجب أن نكون صادقين بشأن هذه النتيجة؛ فقد أظهر Ministral أخطاء HTTP حقيقية بنسبة 3.8% عند مستوى تزامن 4، وهو أخف حمل اختبرناه. وعند 64 طلباً متزامناً بلغت النسبة 5.3%، ووصلت إلى 8.9% عند 128. كانت هذه إخفاقات حقيقية من نوع 408/503 وليست مجرد خلل في الاختبار. من المحتمل أن يعكس هذا عدم استقرار في النشر خلال فترة الاختبار بدلاً من كونه قصوراً جوهرياً في النموذج، لكن البيانات هي البيانات.
حيثما نجحت الطلبات، كان زمن استجابة Ministral تنافسياً: زمن الوصول للرمز الأول (TTFT) عند النسبة المئوية 50 (p50) بلغ 350 مللي ثانية في الحالة الأساسية و512 مللي ثانية عند تزامن 64، وهو قريب من 524 مللي ثانية لنموذج Qwen3. ومع ذلك، لا تعني أرقام زمن الاستجابة الكثير إذا كان واحداً من كل 20 طلباً تقريباً لا يتلقى رداً أبداً.
بالنسبة لحمل عمل التصنيف، عملت النماذج الثلاثة بشكل سليم حتى 256 مستخدماً متزامناً دون أي أخطاء. تصدر Llama القائمة من حيث عدد الطلبات الخام في الثانية (173 طلباً)، يليه Qwen3 (157 طلباً)، ثم Ministral (143 طلباً).
الرقم الأكثر دلالة هو مدى تأثر زمن الاستجابة تحت الضغط. بلغ زمن الوصول للرمز الأول (TTFT) لنموذج Qwen3 عند النسبة المئوية 95 (p95) مع 128 طلباً متزامناً 541 مللي ثانية، وهو أعلى بنسبة 32% فقط من مستواه الأساسي البالغ 409 مللي ثانية. بينما انتقل زمن الوصول عند النسبة المئوية 50 (p50) من 358 مللي ثانية إلى 467 مللي ثانية. في المقابل، تضاعف زمن الوصول (p95) لنموذج Llama تقريباً (من 351 إلى 689 مللي ثانية)، وتضاعف لأكثر من ذلك في Ministral (من 390 إلى 823 مللي ثانية).
إذا كنت بحاجة إلى موجه نوايا (intent router) أو مصنف يتمتع بزمن استجابة يمكن التنبؤ به تحت حركة مرور متذبذبة، فإن المنحنى المستقر لنموذج Qwen3 يستحق الاهتمام. حيث تستوعب وحدة معالجة الرسومات طلبات التصنيف القصيرة في دفعة واحدة دون انتظار، وهذا يظهر بوضوح في الأرقام.
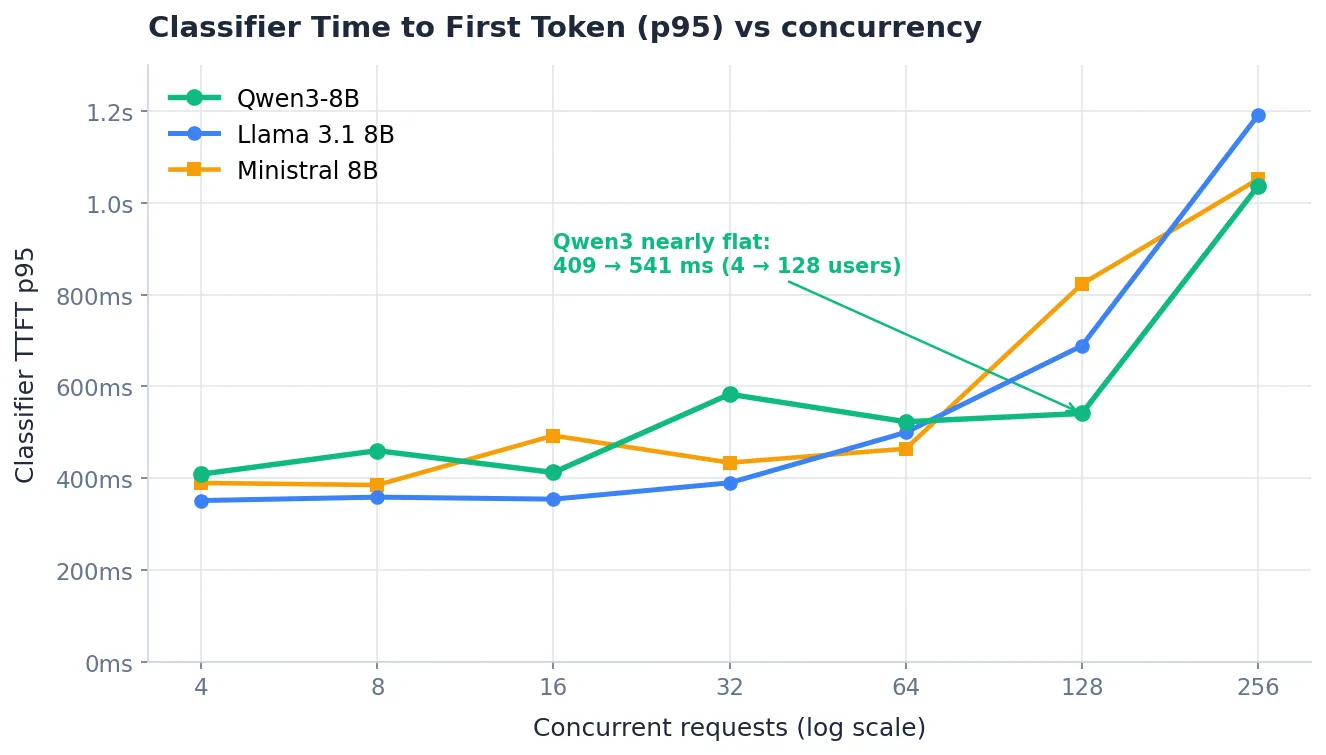
تبدأ النماذج الثلاثة من نفس النقطة وتتوسع خطياً حتى 16 مستخدماً متزامناً، ثم تبدأ الفجوة في الاتساع بعد ذلك.
بعد مستوى 64، تستمر إنتاجية Llama في الارتفاع نظرياً (1,181 رمزاً في الثانية عند 256)، لكن يتم رفض معظم الطلبات. يستقر أداء Qwen3 عند حوالي 830-850 رمزاً في الثانية مع خدمة كل طلب. أما Ministral فيقل أداؤه بنحو 15% عن Qwen3 عند 64 طلباً متزامناً، حتى بين الطلبات التي نجحت.
رقم الذروة الخام دون النظر إلى معدل الخطأ المصاحب له يكاد يكون بلا معنى عند التخطيط للسعة. وتوضح اختبارات vLLM الثلاثة هذه الحقيقة.

لقد أجرينا اختبار أداء vLLM هذا على مثيل A10 فوري (spot instance) تم نشره عبر TrueFoundry. سيتم نشر تكوين vLLM الكامل وأوامر GuideLLM مع المقال التفصيلي.
تقوم طبقة تقديم النماذج في TrueFoundry بنشر بيئات vLLM على أي فئة من وحدات معالجة الرسومات (A10، A100، H100) مباشرة من لوحة التحكم. أنت تختار النموذج، وتحدد max_model_len و tensor_parallel_size، وتتولى TrueFoundry إدارة الحاوية، وتخصيص وحدة معالجة الرسومات، وفحوصات السلامة. يصبح النموذج متاحاً عبر نقطة نهاية قياسية متوافقة مع OpenAI.
أمام vLLM، تقوم بوابة الذكاء الاصطناعي (AI Gateway) بإضافة حوالي 3-4 مللي ثانية من الحمل الإضافي مع معالجة أكثر من 350 طلباً في الثانية على وحدة معالجة مركزية (vCPU) واحدة. تمنحك هذه البوابة حدوداً لمعدل الطلبات لكل نموذج، وتوزيعاً للتكاليف، وتوجيهاً احتياطياً بين الموفرين، وتتبعاً كاملاً للطلبات. إذا كنت تقارن بين نماذج متعددة (كما في هذا الاختبار)، يمكنك توجيه النماذج الثلاثة عبر نفس نقطة نهاية البوابة والتبديل بينها عن طريق تغيير حقل النموذج في الطلب، مع بقاء الرابط وبيانات الاعتماد كما هي.
تدعم TrueFoundry أكثر من 1000 نموذج لغوي كبير (LLM) من خلال واجهة برمجة تطبيقات واحدة متوافقة مع OpenAI، لذا فإن الانتقال من نموذج مفتوح الأوزان تم اختباره إلى موفر تجاري لا يتطلب أي تغييرات من جانب العميل.
بالنسبة للفرق التي تستضيف نماذج مفتوحة الأوزان ذاتياً خلف بوابة، تحافظ هذه البنية على فصل طبقة التقديم عن التوجيه والحوكمة. راجع أفضل 10 أدوات لمراقبة النماذج اللغوية الكبيرة (LLM) في عام 2026 لمراقبة نشر vLLM الخاص بك بمجرد تشغيله.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



A vLLM benchmark measures how a model served via vLLM performs under concurrent load. The key metrics are time to first token (TTFT), end-to-end latency, token throughput, and error rates at different concurrency levels. The most useful vLLM benchmarks sweep from low to high concurrency to find the point where performance degrades or requests start failing, since peak throughput numbers without error rates are misleading.
In this benchmark, Qwen3-8B was the only model to complete every request at every concurrency level through 256 concurrent users with zero errors. Llama 3.1 8B was clean through 64 concurrent but hit 87% error rates at 128. Ministral 8B had persistent errors starting at concurrency 4.
Based on this vLLM performance benchmark, 64 concurrent users is the last clean operating point for Llama 3.1 8B on a 24 GB A10. At 128 concurrent, 87% of requests fail with gateway timeouts. For interactive workloads, stay at or below 64. For batch jobs with retry logic, you can push higher.
نعم. يعمل TrueFoundry في شبكتك الافتراضية الخاصة (VPC)، أو في موقعك، أو في بيئة معزولة، أو في بيئة هجينة، أو عبر سحابات متعددة، ولا تغادر أي بيانات نطاقك. هذا هو السبب الرئيسي الذي يجعل الشركات الخاضعة للتنظيم تفضلها على بوابات SaaS فقط.
Any LLM, embedding, or custom model via high-performance backends like vLLM, TGI, and Triton, all deployable in the same control plane as the gateway.



أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد