



November 16, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.


Blazingly fast way to build, track and deploy your models!
يصف هذا المنشور نمطًا معماريًا يمكنك تنفيذه باستخدام AI Gateway من TrueFoundry. يُرجى ملاحظة أن التقييم عبر الإنترنت ليس ميزة مدمجة أصلية — بل هو شيء تبنيه فوق إمكانيات الإمكانية للمراقبة والتوجيه الخاصة بالبوابة.
يمكنك التوجيه حسب التكلفة، وتجاوز الفشل عند انقطاع الخدمة، والتخزين المؤقت بقوة — ومع ذلك تقوم بشحن تغيير يجعل إجاباتك تسوء بهدوء. التكلفة، وزمن الانتقال، ومعدل الخطأ هي الإشارات الثلاث التي تراقبها كل بيئة إنتاجية، ويمكن أن تظل جميعها في النطاق الأخضر الآمن بينما تتراجع الإشارة الرابعة، وهي جودة الإجابة. يوضح هذا المنشور كيفية قياس تلك الإشارة الرابعة في الإنتاج: التقييم عبر الإنترنت، والتقييم باستخدام LLM كقاضٍ (LLM-as-judge) مع تحفظاته الصريحة، وأخذ العينات، واكتشاف التراجع، وإغلاق الحلقة لتعود إلى التوجيه.
لينا، وهي مهندسة تعلم آلي، قامت بإجراء تغيير أراده الجميع. كان هناك مسار دعم عالي الحجم يعمل على النموذج الرئيسي، وكان هناك نموذج أرخص يبدو شبه ممتاز في الاختبارات، لذا قامت بتبديل المسار — وهو خفض سهل للتكلفة بنسبة 60% على شريحة كبيرة من حركة المرور. وافقت كل لوحة قيادة على أنه مكسب: استقر زمن الانتقال، وكان معدل الخطأ مسطحاً، وانخفض الإنفاق في الجدول المحدد. تم شحن التغيير، وتحققت التوفيرات، وانتقل الفريق لمهام أخرى. بعد أسبوعين، بدأت تصعيدات الدعم في الارتفاع، وتتبعها مراجعة المحتوى لتجد إجابات أسوأ بدقة على ذلك المسار بالذات — أكثر إبهامًا، وخاطئة أحيانًا بطرق لم تثر أي خطأ. لقد انخفضت الجودة في اليوم الذي قامت فيه بالشحن. لم يقم أي شيء بقياس ذلك، لذلك لم يكتشفه أحد لمدة أسبوعين.
هذه هي النقطة العمياء في مركز عمليات LLM. الإشارات التي يسهل قياسها — التكلفة، وزمن الانتقال، والأخطاء — ليست هي الإشارة التي تحدد ما إذا كان المنتج جيدًا أم لا. الجودة أصعب في القياس، لذا غريبًا ما لا تقاس، والتغيير الذي يقايض الجودة بالتكلفة يبدو وكأنه مكسب خالص إلى أن تصل الشكاوى. التقييم عبر الإنترنت هو كيف تضع رقمًا على الإشارة الرابعة وتراقبها تمامًا مثل الثلاث الأخرى.
ثلاث إشارات إنتاجية مجانية تقريبًا لأن البنية التحتية تصدرها: زمن الانتقال هو مؤقت، والتكلفة هي عدد التوكنز مضروبًا في المعدل، والأخطاء هي رموز الحالة. الجودة ليست أيًا من هذه. يمكن للاستجابة أن تكون سريعة ورخيصة وتعيد رمز 200 نظيفًا بينما تكون مبهمة، أو خاطئة بدقة، أو مخالفة للسياسة، أو غير مفيدة — ولن تتحرك أي مقاييس تشغيلية. هذا عدم التماثل هو السبب في أن الفرق تجهز الإشارات الثلاث السهلة أدواتيًا وتطير عمياء عن الإشارة التي تحدد المنتج بالفعل.
جعل الجودة قابلة للملاحظة يعني تصنيع إشارة لا تأتي مجانًا: أخذ عينات من الاستجابات الحقيقية، وتقييمها مقابل ما يعنيه "جيد" لحالة الاستخدام، وتتبع تلك الدرجة بمرور الوقت وعبر التغييرات، جنبًا إلى جنب مع التكلفة وزمن الانتقال. باقي هذا المنشور يشرح كيفية إنتاج تلك الإشارة بمدعومية وموثوقية — بما في ذلك أن نكون صادقين بشأن مدى ضوضائها — وأين يمكن تشغيلها بحيث تكون متصلة بالقرارات، مثل التوجيه، التي تحركها.
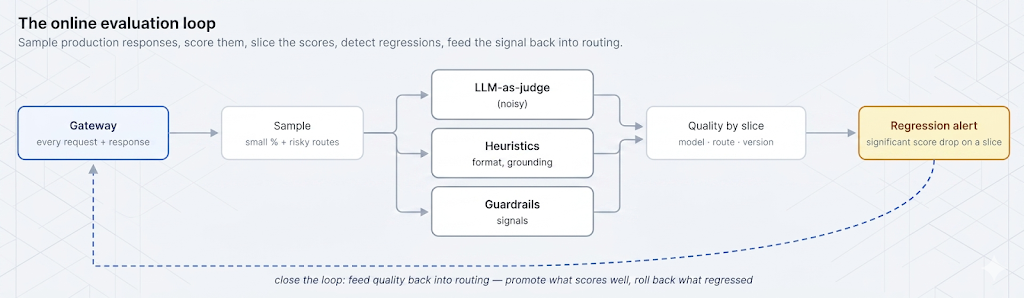
يشغل التقييم أوفلاين مجموعة اختبار ثابتة مقابل نموذج أو Prompt قبل الشحن — مجموعة منتقاة من المدخلات مع إجابات معروفة أنها جيدة أو قواعد تقييم، ويتم تقييمها في CI. إنه أمر أساسي ولكنه ليس كافيًا. تحتوي مجموعة الاختبار الثابتة فقط على الحالات التي فكرت فيها؛ بينما تحتوي حركة المرور في الإنتاج على الحالات التي لم تفكر فيها، بالإضافة إلى انحراف التوزيع مع تغير سلوك المستخدم والعالم. لقد نجح نموذج لينا الأرخص في الاختبار أوفلاين بدقة لأن مجموعة الاختبار لم تكن تشبه الذيل الطويل الفوضوي لمسار الدعم المباشر.
يقوم التقييم عبر الإنترنت بتقييم حركة المرور الحقيقية في الإنتاج، بعد وقوع الحدث، على عينة. فهو يكتشف ما يفوته التقييم أوفلاين: الحالات الحدية خارج مجموعة الاختبار الخاصة بك، والانحراف التدريجي، والتراجعات التي تسببت فيها أي تغييرات على النظام المباشر. الاثنين يكملان بعضهما — أوفلاين هو فحص ما قبل الطيران مقابل الحالات المعروفة، وعبر الإنترنت هو أداة القياس المستمرة على الواقع. يركز هذا المنشور على التقييم عبر الإنترنت، لأن تلك هي الفجوة التي سمحت بتراجع دام أسبوعين دون أن يلاحظه أحد.
هناك ثلاث طرق عملية لوضع رقم على استجابة ما، وعادة ما تجمع بينها. الفحوصات الاستكشافية (Heuristics) هي فحوصات حتمية ورخيصة: هل تم تحليل المخرج كـ JSON صريح، وهل يستشهد بمصدر عندما ينبغي عليه ذلك، وهل هو ضمن طول عاقل، وهل يحتوي على رفض. إشارات الحماية (Guardrail signals) تعيد استخدام أجهزة الكشف من الأجزاء السابقة في هذه السلسلة — فظهور PII، أو علم السُمّية، أو إطلاق كاشف الحقن على المخرجات هي جميعها إشارات جودة أيضًا. وLLM كقاضٍ (LLM-as-judge) يستخدم نموذجًا لتقييم استجابة مقابل معيار تقييم، وهو الوحيد من الثلاثة الذي يمكنه تقييم الصفات المفتوحة مثل الفائدة، أو الأمانة، أو النبرة.
أداة التقييم LLM كقاضٍ مع معيار تقييم صريح (توضيحي)
التقييم له تكلفته وزمن الانتقال الخاص به — أداة LLM كقاضٍ تستخدم أداة LLM لتقييم استجابة مقابل معيار تقييم، وهو الوحيد من الثلاثة الذي يمكنه تقييم الصفات المفتوحة مثل الفائدة، أو الأمانة، أو النبرة. الحل هو أخذ العينات، مع القليل من الصدق الإحصائي. توفر لك نسبة عشوائية صغيرة من كل مسار تقديرًا غير منحاز للجودة الإجمالية؛ وأخذ العينات المستهدف يرفع المعدل على المسارات التي تهتم بها أكثر — عالية الحجم، أو عالية المخاطر، أو التي تم تغييرها مؤخرًا. لأنك تقوم بالتقدير من عينة، فإن كل رقم جودة يحمل قدرًا من عدم اليقين، ويمكن لعينة صغيرة على مسار منخفض الحجم أن تتحرك لأسباب لا علاقة لها بتغيير حقيقي.
أخذ العينات والتقييم بشكل غير متزامن، بعيدًا عن المسار الرئيسي (توضيحي)
هناك انضباطان يبقيان هذا العمل صادقًا: تشغيل التقييم بشكل غير متزامن حتى لا يضيف أبدًا زمن انتقال إلى استجابة المستخدم، والإبلاغ عن الجودة مع حجم عينتها حتى لا يُخطأ في فهم شريحة منخفضة الحجم مليئة بالضوضاء على أنها اتجاه عام. تحول عملية أخذ العينات فكرة "تقييم كل شيء" غير المكلفة إلى أداة صحيحة إحصائيًا وميسورة التكلفة.
رقم الجودة العالمي الموحد يكاد يكون عديم الفائدة للتشخيص — فلا يمكنه إخبارُك بأن مسارًا واحدًا تراجع بينما استقر كل شيء آخر. يجب تقسيم الجودة بنفس الطريقة التي تُقسم بها التكلفة في منشور إسناد التكلفة الخاص بنا: حسب النموذج، وحسب المسار، وحسب إصدار Prompt، وحسب أي بعد آخر يمكن لتغيير ما أن يحركه. مفاتيح الشرائح هذه هي بالضبط البيانات الوصفية التي تربطها البوابة بالفعل بكل طلب، ولهذا السبب تنتمي الجودة بجانب التكلفة وزمن الانتقال بدلاً من وجودها في نظام منفصل.
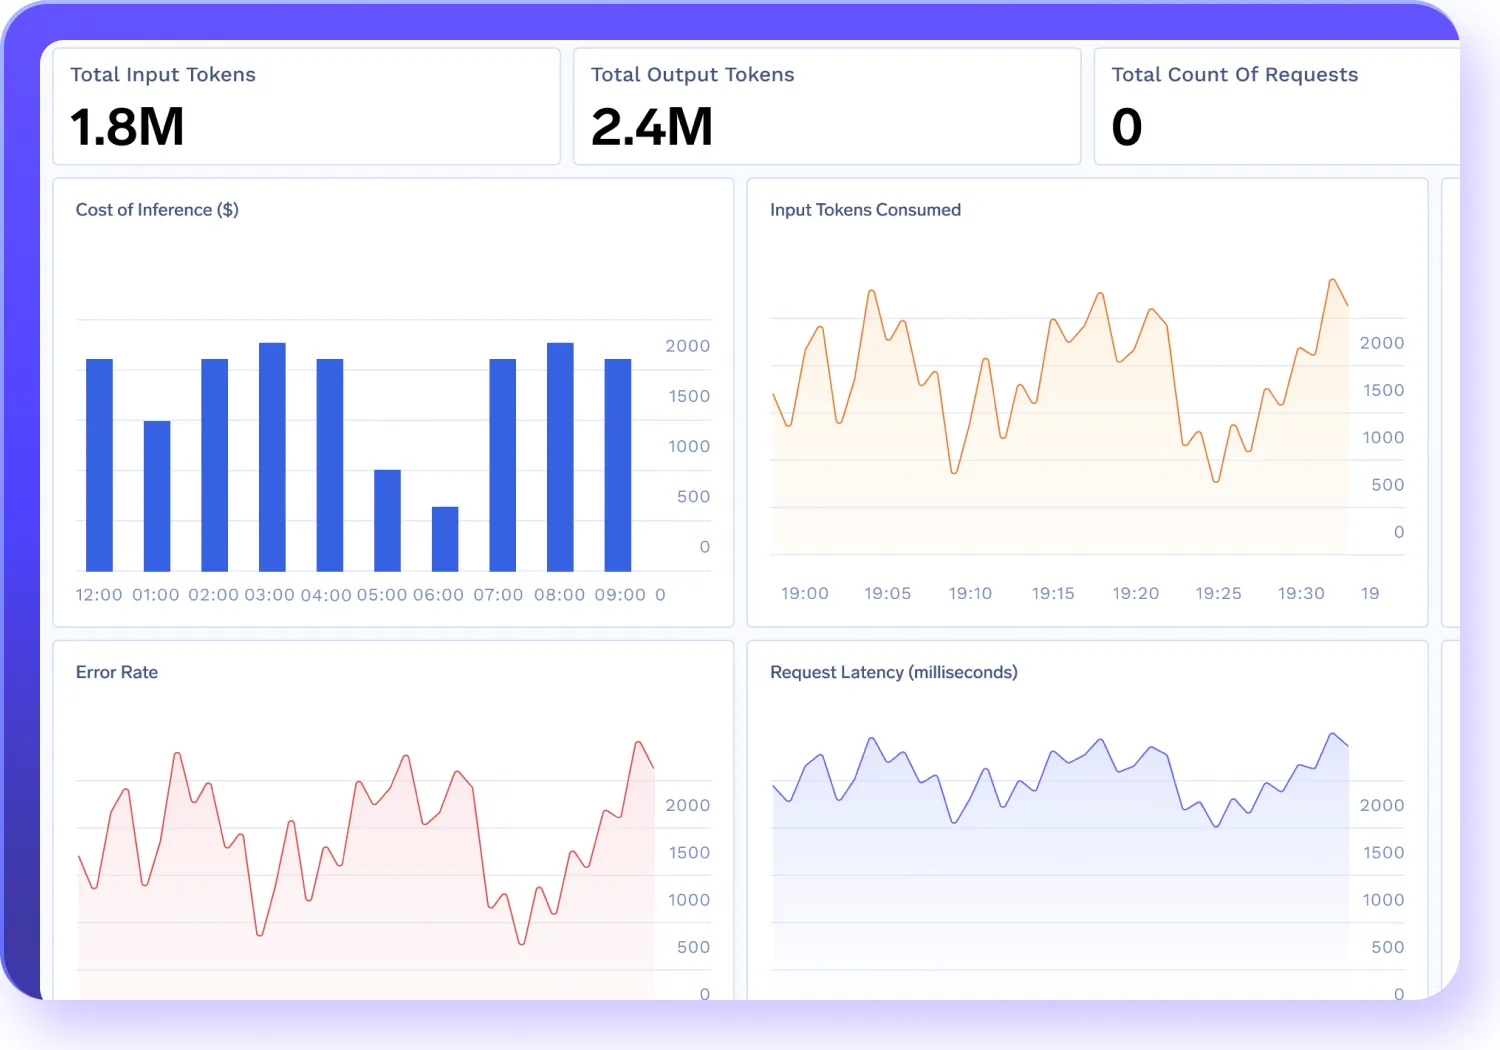
وضع الجودة على نفس محاور التكلفة وزمن الانتقال هو ما يجعل المقايضة مرئية بدلاً من مخفية. كان تغيير لينا سيظهر على الفور كخفاض في الجودة على مسار واحد، في اليوم الذي قامت فيه بالشحن، جالسًا بجانب انخفاض التكلفة الذي كانت تحتفل به — الرقمين اللذين يجب قراءتهما دائمًا معًا. يوفر AI Gateway من TrueFoundry ركيزة إمكانية المراقبة — سجلات الطلب/الاستجابة، ووسم البيانات الوصفية، والتتبع، والتكلفة، وزمن الانتقال، وسياق التوجيه، مقسمة حسب النموذج، والفريق، والبيانات الوصفية — التي يربط بها هذا التقييم. حلقة القاضي والتقييم الموصوفة هنا هي نمط معماري تبنيه فوق تلك القياسات عن بعد ما لم يتم توصيلها من خلال تكامل تقييم محدد؛ التقييم عبر الإنترنت هو ما يضيف تقدير الجودة إلى الإشارات التي تجمعها البوابة بالفعل.
بشكل ملموس، الوحدة التي يصدرها التقييم عبر الإنترنت هي حدث تقييم مرتبط بالاستجابة الأصلية. مخطط أدنى قابل للعمل يبدو كالتالي — الحقول هي ما يفصل الإشارة القابلة للتنفيذ عن الإشارة المضللة:
تقسيم الجودة هو ما يجعل اكتشاف التراجع ممكنًا: أنت تقارن تقدير الجودة على شريحة ما قبل وبعد التغيير — نموذج جديد على مسار، أو تعديل Prompt، أو تحديث سياسة التوجيه — وتطلق تنبيهًا عندما تنخفض بأكثر من مقدار الضوضاء. لأن الدرجات مأخوذة من عينات ومليئة بالضوضاء، يجب للمقارنة أن تحترم عدم اليقين: فالانخفاض ضمن هامش العينة ليس تراجعًا، وتحتاج الشريحة الصغيرة إلى عينة أكبر أو أطول قبل أن تثق في الحركة.
مقارنة شريحة عبر تغيير ما، مع مراعاة ضوضاء العينة (توضيحي)
المكسب الحقيقي هو التوقيت. الفحص الخاص بالتراجع على الشرائح الصحيحة يحول الفجوة ذات الأسبوعين لـ لينا إلى تنبيه في نفس اليوم: في اللحظة التي ينخفض فيها تقدير جودة مسار الدعم عن خط الأساس بأكثر من مقدار الضوضاء، يتم استدعاء شخص ما — قبل فترة طويلة من إظهار التصعيدات لها. ما إذا كنت تسترد الإصدار تلقائيًا أو تطلق تنبيهًا فقط هو قرار تقديري يعتمد على مدى ثقتك في الإشارة على تلك الشريحة، وهو بالضبط سبب أهمية المعايرة من القسم 3.
السبب في قياس الجودة عند البوابة، بدلاً من خط أنابيب التحليلات المنفصل، هو أن البوابة هي أيضًا المكان الذي تتخذ فيه قرارات التوجيه — لذا يمكن للإشارة أن تغذي القرار. وصف منشور التوجيه الخاص بنا التوجيه المكتفي بالجودة كطموح يحتاج إلى إشارة جودة ليكون حقيقيًا؛ التقييم عبر الإنترنت هو تلك الإشارة. مع وجود درجات الجودة لكل شريحة في اليد، يتوقف التوجيه عن كونه تخمينًا ثابتًا ويصبح حلقة تغذية راجعة: قم بترقية نموذج أرخص على مسار فقط طالما أن جودته المقاسة مستقرة، وأطلق تنبيهًا أو استردادًا عندما لا تكون كذلك — أيهما تعتمد على مخاطر المسار ومدى ثقتك في الإشارة على تلك الشريحة.
هذا يغلق الحلقة التي تركتها المقدمة مفتوحة. تغيير لينا لتوفير التكلفة هو بالضبط نوع القرار الذي يجب أن يكون مقيدًا بإشارة جودة مباشرة: اشحن النموذج الأرخص، وراقب تقدير الجودة على ذلك المسار، واحتفظ بالتوفير فقط طالما بقيت الجودة ضمن الحد المسموح به. البوابة هي المكان الوحيد الذي يرصد الاستجابات لتقييمها ويتخذ قرار التوجيه للتعديل، وهو ما يجعلها الموطن الصحيح للحلقة بدلاً من مجرد القياس.
لا ينتمي كل التقييم إلى مكان واحد، ومن المفيد أن نكون دقيقين بشأن التقسيم. يعيش التقييم أوفلاين في CI، مقابل مجموعات اختبار ثابتة، مما يمنع النشر بناءً على الحالات المعروفة. يعيش التقييم على مستوى التطبيق في التطبيق عندما يحتاج التقييم إلى سياق لا تملكه البوابة — الحقيقة المطلقة للمجال، ونتائج الأعمال، وما إذا كانت مهمة المستخدم قد نجحت بالفعل. يعيش التقييم عبر الإنترنت على مستوى البوابة عند البوابة للإشارة الشاملة: تقدير الجودة المأخوذ من عينة ومقسم على حركة المرور المباشرة، والمرتبط بقياسات التكلفة وزمن الانتقال عن بعد، والذي يغذي التوجيه.
لا تستبدل البوابة الاثنتين الأخريين؛ بل تملأ الفجوة التي تتركاها — مراقبة الجودة المستمرة والمتسقة عبر جميع حركة المرور، في المكان الوحيد الذي يمكنه مراقبة الاستجابات والتصرف بناءً على التوجيه. هذا هو الدور الذي جادلت هذه السلسلة بأكملها بأن البوابة تلعبه: لوحة التحكم الشاملة، والمطبقة هنا على الإشارة الأكثر صعوبة في القياس والأكثر أهمية.
لماذا لا يكفي التقييم أوفلاين؟
لأن مجموعة الاختبار الثابتة تحتوي فقط على الحالات التي توقعتها. يحتوي الإنتاج على الذيل الطويل الذي لم تتوقعه، بالإضافة إلى الانحراف بمرور الوقت، بالإضافة إلى التراجعات من أي تغيير مباشر. نجح نموذج لينا الأرخص في الاختبار أوفلاين ومع ذلك تراجع في الإنتاج، لأن مجموعة الاختبار لم تكن تشبه حركة مرور الدعم الحقيقية. أوفلاين هو فحص ما قبل الطيران؛ وعبر الإنترنت هو أداة قياس مستمرة على الواقع. أنت بحاجة إلى الاثنين.
هل يمكنني الثقة في LLM لتقييم LLM آخر؟
كإشارة اتجاه، مع المعايرة — وليس كحقيقة مطلقة. تملك نماذج القضاة تحيزات (الطول، التفضيل الذاتي، الموقع) وليست متسقة تمامًا، لذا قم بمعايرة القاضي مقابل أمثلة مصنفة بشريًا لمعرفة مدى تتبعه للحكم البشري لمهمتك، وتتبع الدرجات بمرور الوقت وعبر الشرائح بدلاً من التصرف بناءً على أي درجة فردية، ولا تجعل الإصدار مقيدًا بقرار قاضٍ غير معايَر فقط. إنها أداة مفيدة ولكنها غير كاملة.
ما الذي كان سيكتشف المشكلة في المقدمة؟
درجة جودة مأخوذة من عينة على مسار الدعم، مقسمة حسب النموذج وإصدار Prompt، مع فحص التراجع مقابل خط الأساس قبل التغيير. في اليوم الذي قامت فيه لينا بتبديل النماذج، كان تقدير جودة المسار سينخفض بجوار انخفاض التكلفة، وكان تنبيه التراجع سيعمل — مما يحول نقطة عمياء مدتها أسبوعان إلى إشارة في نفس اليوم. لم تكن توفيرات التكلفة هي الخطأ؛ بل كان شحنها بدون إشارة جودة هو الخطأ.
ما كمية حركة المرور التي أحتاج إلى تقييمها؟
ما يكفي لتكون الشريحة التي تهتم بها ذات مغزى إحصائي، وهو ما يعتمد على الحجم ومدى كبر التغيير الذي تحتاج إلى اكتشافه. خط أساس عشوائي صغير عبر جميع المسارات بالإضافة إلى معدل مستهدف أعلى على المسارات عالية المخاطر أو التي تم تغييرها مؤخرًا هو خيار افتراضي معقول. أبلغ دائمًا عن الجودة مع حجم عينتها، وكن متشككًا في التحركات على الشرائح منخفضة الحجم حتى تكون العينة كبيرة بما يكفي للثقة بها.
البوابة أم التطبيق للتقييم عبر الإنترنت؟
كلاهما، لإشارات مختلفة. تملك البوابة الإشارة الشاملة — الجودة المأخوذة من عينة على حركة المرور المباشرة، مقسمة ومربوطة بالتكلفة وزمن الانتقال، وتغذي التوجيه — لأنها ترى كل استجابة وتتخذ قرار التوجيه. يملك التطبيق التقييم الذي يحتاج إلى سياق تفتقده البوابة، مثل ما إذا كانت مهمة المستخدم الفعلية قد نجحت. هما يكملان بعضهما، وليسا متنافسين.
الإشارات الثلاث السهلة ستكون دائمًا هي الإشارات التي تجهزها أدواتيًا أولاً، لأن البنية التحتية تسلمها لك. الجودة هي الإشارة التي يتعين عليك بناء إشارة لها — عن طريق أخذ عينات من الاستجابات، وتقييمها بصدق، وتقسيم الدرجات، ومراقبة التراجعات. ابنِ تلك الإشارة عند البوابة، حيث توجد الاستجابات وقرارات التوجيه بالفعل، وتغيير توفير التكلفة القادم الذي يضر بالجودة بهدوء يصبح تنبيهًا في نفس اليوم بدلاً من لغز يدوم أسبوعين.
Northwind ولينا هما شخصيتان توضيحيتان، تمامًا مثل أرقام الجودة والعتبات المعروضة. LLM كقاضٍ هو مقدر مليء بالضوضاء مع تحيزات معروفة وليس حقيقة مطلقة؛ يجب معايرة الدرجات الموصوفة مقابل تصنيفات بشرية وتتبع اتجاهها بدلاً من التعامل معها كأحكام نهائية، والتقييم عبر الإنترنت يقلل النقاط العمياء دون ضمان الجودة. يتم تلخيص إمكانيات TrueFoundry من وثائق المنتجات العامة اعتبارًا من يونيو 2026 وستتطور. عينات الكود توضيحية للأنماط الموصوفة، وليست منسوخة من تنفيذ مرجعي.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد




















