



November 16, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.



Blazingly fast way to build, track and deploy your models!
مع تحول الذكاء الاصطناعي التوليدي إلى جزء أساسي من مسارات العمل في المؤسسات، تعيد العديد من المؤسسات النظر في مكان وكيفية تشغيل نماذج الذكاء الاصطناعي الخاصة بها. وبينما توفر الخدمات المستندة إلى السحاب الراحة والسرعة، فإنها تثير أيضاً مخاوف بشأن خصوصية البيانات، والامتثال، والارتباط بمورد معين، والتكلفة على المدى الطويل. بالنسبة للمؤسسات التي تتعامل مع بيانات حساسة أو تعمل في قطاعات خاضعة للتنظيم، يقدم الذكاء الاصطناعي التوليدي المحلي خياراً آمناً وقابلاً للتحكم. فهو يتيح للشركات تشغيل نماذج لغوية قوية، وقواعد بيانات المتجهات، والبنية التحتية للذكاء الاصطناعي ضمن بيئاتها الخاصة. تستكشف هذه المقالة ماهية الذكاء الاصطناعي التوليدي المحلي، وسبب اكتسابه زخماً، والمنصات التي تجعل عمليات النشر على مستوى المؤسسات ممكنة.

يشير الذكاء الاصطناعي التوليدي المحلي إلى نشر وتشغيل نماذج الذكاء الاصطناعي التوليدي، مثل النماذج اللغوية الكبيرة (LLMs)، أو مولدات الصور، أو الأنظمة متعددة الوسائط، ضمن البنية التحتية الخاصة بالمؤسسة. يمكن أن تشمل هذه البنية التحتية مراكز البيانات المحلية، أو السحب الخاصة، أو البيئات الهجينة، حيث تحتفظ المؤسسة بالتحكم الكامل في تدفق البيانات، والوصول إلى النماذج، وأمن النظام.
وعلى عكس حلول الذكاء الاصطناعي التوليدي المستندة إلى السحاب، والتي تعمل على بنية تحتية لجهات خارجية، تم تصميم عمليات النشر المحلية للعمل خلف جدران الحماية الخاصة بالمؤسسة. يضمن هذا الإعداد عدم مغادرة البيانات الحساسة لبيئة المؤسسة الموثوقة أبداً. كما يتيح ضبط النماذج بدقة، والتكامل الوثيق مع الأنظمة الداخلية، والامتثال للمعايير التنظيمية الصارمة مثل GDPR أو HIPAA أو SOC 2.
تتكون حلول الذكاء الاصطناعي التوليدي المحلية عادةً من عدة مكونات رئيسية: نماذج LLM مدربة مسبقاً أو مضبوطة دقة، ومحرك استدلال (مثل vLLM أو TGI)، ومنصة تنسيق حاويات مثل Kubernetes، وقواعد بيانات متجهات اختيارية لحالات استخدام التوليد المعزز بالاسترجاع (RAG).
باستخدام هذا الإعداد، يمكن للمؤسسات نشر قدرات الذكاء الاصطناعي التوليدي—مثل مساعدات الدردشة، ومحركات التلخيص، والبحث الذكي—دون الاعتماد على واجهات برمجة تطبيقات (APIs) خارجية أو مشاركة البيانات مع مزودي الخدمات السحابية. ويعد هذا النهج جذاباً بشكل خاص لقطاعات مثل الرعاية الصحية، والمالية، والدفاع، والخدمات القانونية، حيث تكون خصوصية البيانات والتحكم في البنية التحتية أمراً حاسماً.
يمثل الذكاء الاصطناعي التوليدي المحلي تحولاً من الراحة إلى التحكم، مما يمنح المؤسسات المرونة لتوسيع أعباء عمل الذكاء الاصطناعي بشروطها الخاصة مع الحفاظ على معايير الامتثال والأمان والأداء المخصصة لاحتياجاتها.
مع اصباح الذكاء الاصطناعي التوليدي أكثر ترسيخاً في العمليات المؤسسية، تبتعد العديد من المؤسسات عن الحلول السحابية فقط لصالح عمليات النشر المحلية. ويثار هذا التحول بسب الحاجة إلى تحكم أكبر في البيانات، والبنية التحتية، وإستراتيجية الذكاء الاصطناعي طويلة المدى.
السبب الرئيسي لاختيار الذكاء الاصطناعي التوليدي المحلي هو خصوصية البيانات والامتثال. يجب على المؤسسات في قطاعات مثل الرعاية الصحية، والمالية، والدفاع الامتثال للوائح صارمة مثل GDPR وHIPAA وCCPA. غلباً ما تثير الخدمات المستندة إلى السحاب مخاوف بشأن مكان تخزين البيانات، وكيفية الوصول إليها، ومن لديه الرؤية في المعلومات الحساسة. يبقي النشر المحلي البيانات ضمن بيئة المؤسسة، مما يحسن إمكانية التدقيق ويقلل من التعرض للمخاطر.
عامل آخر مهم هو التخصيص والتحكم. تحتاج المؤسسات غالباً إلى ضبط النماذج دقة، أو فرض سلوك مخرجات صارم، أو التكامل مع الأنظمة الداخلية. يتيح الذكاء الاصطناعي التوليدي المحلي للمؤسسات تعديل أنابيب النماذج، وإدارة سلوك المطالبات (Prompt)، ونشر تحسينات خاصة بالمجال دون الاعتماد على واجهات برمجة تطبيقات لجهات خارجية أو دورات إصدار خارجية.
كما أن تجنب الارتباط بمورد معين (Vendor Lock-in) يعد محفزاً قوياً. الاعتماد الحصري على مزود سحابي واحد يحدد المرونة ويمكن أن يدخل قيوداً على التكلفة والابتكار على المدى الطويل. توفر الإعدادات المحلية ملكية كاملة للمكدس (Full-Stack)، مما يتيح للفرق تبديل المكونات، وتجربة النماذج مفتوحة المصدر، وتطوير بنيتها التحتية دون تبعيات خارجية.
تعتبر قابلية التنبؤ بالتكلفة والتحسين على القدر نفسه من الأهمية عند تقييم تكلفة الذكاء الاصطناعي التوليدي. بالنسبة للشركات التي تشغل أعباء عمل استدلال واسعة النطاق، قد يصبح الفواتير القائمة على الاستخدام صعبة الإدارة. مع البنية التحتية المحلية، ترتبط التكاليف باستخدام الأجهزة بدلاً من الرسوم لكل رمز (Token) أو لكل طلب، مما يجعل التخطيط المالي أكثر شفافية.
يوفر الذكاء الاصطناعي التوليدي المحلي للمؤسسات القدرة على تشغيل أعباء عمل الذكاء الاصطناعي بأمان ومرونة وبتكلفة فعالة مع الحفاظ على الامتثال وتجنب الاعتماد على مزودي الخدمات الخارجيين.
يتطلب تشغيل الذكاء الاصطناعي التوليدي محلياً مكدساً مصمماً جيداً يوازن بين الأداء، والتحكم، وقابلية التوسع. أدناه المكونات الرئيسية للبنية التحتية المطلوبة لنشر أنظمة الذكاء الاصطناعي التوليدي ضمن بيئات المؤسسات.
تشكل هذه المكونات معاً الأساس لنشر ذكاء اصطناعي توليدي محلي قوي وقابل للتوسع.
بينما يوفر الذكاء الاصطناعي التوليدي المحلي تحكماً أكبر وأماناً للبيانات، إلا أنه يأتي مع مجموعة من التحديات الخاصة التي يجب على المؤسسات التخطيط لها بعناية. تمتد هذه التحديات عبر البنية التحتية، وقابلية التوسع، والعمليات، والصيانة.
شراء الأجهزة وإعدادها: قد يكون الحصول على وحدات GPU أو مصرعات الذكاء الاصطناعي المتخصصة وصيانتها مستهلكاً للوقت ومكلفاً. يمكن أن تمتد أوقات التوريد للأجهزة الراقية مثل NVIDIA A100s أو H100s لشهور، ويضيف إعداد التبريد، والطاقة، ومساحة الرفوف تعقيداً إضافياً.
تعقيد البنية التحتية وDevOps: يتطلب تشغيل النماذج الكبيرة محلياً إدارة تنسيق الحاويات، وجدولة GPU، والشبكات، وحدود الموارد. بدون فريق DevOps أو MLOps مخصص، يمكن أن يصبح ضمان وقت التشغيل وقابلية التوسع اختناقاً، خاصة مع نمو الاستخدام.
التوسع وإدارة الحمل: التوسع التلقائي أكثر تعقيداً في البيئات المحلية مقارنة بالمنصات السحابية. يجب على المؤسسات التخطيط لسيناريوهات الذروة وبناء سعة احتياطية، مما قد يؤدي إلى نقص الاستخدام وزيادة التكاليف إذا لم يتم تحسينه بشكل صحيح.
إدارة النماذج وإصداراتها: تستلزم استضافة نماذج متعددة لفرق أو حالات استخدام مختلفة التحكم في الإصدارات، ودعم الاسترداد (Rollback)، والتحكم الآمن في الوصول. بدون الأدوات المناسبة، يمكن أن يؤدي انتشار النماذج إلى عدم الاستقرار وعدم الكفاءة في أنابيب النشر.
المراقبة واستكشاف الأخطاء وإصلاحها: يتطلب تحديد الاختناقات، أو ارتفاعات زمن الانتقال، أو مشكلات الذاكرة أدوات مراقبة في الوقت الفعلي. بدون وجود إمكانية رؤية قوية، يصبح تشخيص مشكلات الأداء تفاعلياً بدلاً من أن يكون استباقياً.
على الرغم من هذه التحديات، تنجح العديد من المؤسسات في نشر الذكاء الاصطناعي التوليدي محلياً من خلال الاستثمار في الأدوات، والمنصات، والممارسات التشغيلية المناسبة منذ البداية.
يعد اختيار المنصة المناسبة أمراً أساسياً لنشر وإدارة أعباء عمل الذكاء الاصطناعي التوليدي محلياً بنجاح. تساعد هذه المنصات في تجريد تعقيدات البنية التحتية، والتنسيق، وتقديم النماذج. أدناه بعض من أفضل الحلول المصممة لعمليات نشر ذكاء اصطناعي توليدي محلي آمنة وقابلة للتوسع ومخصصة.

TrueFoundry هي منصة على مستوى المؤسسات قائمة على Kubernetes مصممة لتسهيل نشر واستدلال وتوسيع أعباء عمل الذكاء الاصطناعي والذكاء الاصطناعي التوليدي عبر البيئات السحابية والمحلية. وهي تجرد تعقيد إدارة البنية التحتية لـ LLM من خلال تقديم بوابة ذكاء اصطناعي (AI Gateway) قوية، وطبقات تقديم نماذج محسنة، وتكامل MLOps كامل المكدس.
صُممت TrueFoundry بعقلية المطور أولاً، وتُمكّن فرق تعلم الآلة (ML) والمنصات من التركيز على بناء النماذج وتحسينها بدلاً من إدارة البنية التحتية للحوسبة. وتوفر إمكانيات تكامل سلسة مع أطر الاستدلال الرائدة مثل vLLM وText Generation Inference (TGI)، مما يدعم عمليات نشر LLM فائقة السرعة وفعالة في استخدام الرموز.
أبرز الميزات:
بوابة ذكاء اصطناعي موحدة (Unified AI Gateway): تقديم 250+ نموذج LLM مفتوح المصدر ومملوك باستخدام طبقة API موحدة ومتوافقة مع OpenAI. التبديل بين نماذج مثل LLaMA 2 وMistral وMixtral وClaude وGPT عبر التوجيه متعدد النماذج—كل ذلك دون تغيير كود التكامل الخاص بك.
بنية قائمة على Kubernetes: توسيع أعباء عمل استدلال LLM تلقائياً عبر أي بيئة—AWS أو GCP أو Azure أو محلياً باستخدام تنسيق Kubernetes الأصلي. تأتي مسبقة البناء مع دعم GitOps القائم على Helm لإدارة البنية التحتية التقريرية.
محسنة للاستدلال بالحجم الكبير: تتكامل TrueFoundry ذاتياً مع vLLM لتقديم زمن انتقال أقل من 400 مللي ثانية وخدمة 100+ مستخدم متزامن لكل GPU. يتم دعم الدقة المختلطة، والتكميم (Quantization)، والمعالجة الدفعية دون الحاجة لإعدادات إضافية لتقليل التكلفة لكل رمز.
رؤية وتحكم كاملان: تحليلات على مستوى الرمز في الوقت الفعلي، ومقاييس زمن الانتقال، وتحديد المعدل، وموازنة الحمل التلقائية تمنح الفرق الهندسية رؤية وتحكماً كاملين في الاستدلال في الإنتاج.
إدارة المطالبات والإصدارات: إدارة المطالبات وإصداراتها واختبارها مباشرة داخل المنصة. تفعيل اختبار A/B ودعم الاسترداد للتكرار والتجريب السريعين.
الأمان والامتثال: نشر نماذج LLM في VPC الخاص بك أو محلياً مع RBAC مدمج، واتصالات مشفرة، وممارسات متوافقة مع SOC2. لا تغادر أي بيانات للنماذج أو المطالبات بنيتك التحتية أبداً.

NVIDIA Enterprise AI هي مجموعة كاملة المكدس من البرامج والبنية التحتية المسرعة بـ GPU والمصممة لتشغيل أعباء عمل الذكاء الاصطناعي، وتعلم الآلة، والذكاء الاصطناعي التوليدي القابلة للتوسع في بيئات المؤسسات. صُممت للنشر الهجين والمحلي، وهي تتيح للمؤسسات تشغيل أحدث تقنيات الذكاء الاصطناعي، بما في ذلك LLMs، والرؤية الحاسوبية، والتحليلات التنبؤية، على أنظمة معتمدة من NVIDIA باستخدام NVIDIA AI Enterprise، وهي طبقة برمجية محسنة للأداء، والأمان، والدعم.
سواء كنت تقوم بنشر النماذج في مراكز البيانات الخاصة أو على بنية تحتية سحابية هجينة، تُمكّن NVIDIA Enterprise AI المؤسسات من بناء تطبيقات ذكاء اصطناعي آمنة وبذمن انتقال منخفض دون إرسال البيانات خارج شبكتها. وهي مثالية لقطاعات مثل الرعاية الصحية، والمالية، والتصنيع التي تتطلب ذكاءً اصطناعياً محلياً مع سيادة كاملة على البيانات.
أبرز الميزات

Red Hat OpenShift AI (المعروفة سابقاً باسم Red Hat OpenShift Data Science) هي منصة MLOps جاهزة للمؤسسات تُمكّن المؤسسات من بناء وتدريب ونشر ومراقبة نماذج AI/ML عبر البيئات السحابية الهجينة. بنيت على Kubernetes عبر OpenShift، وتوفر بيئة متكاملة تماماً لتطوير النماذج والإنتاج، مع مرونة للنشر المحلي، أو السحابي، أو عند الحافة (Edge).
تجمع OpenShift AI بين الأدوات مفتوحة المصدر والدعم المؤسسي، مما يتيح التعاون السلس بين علماء البيانات، ومهندسي ML، وفرق DevOps. وهي تدعم النماذج المخصصة بالإضافة إلى التكامل مع نماذج LLM مفتوحة المصدر والتجارية، مما يوفر بنية تحتية آمنة ومتوافقة لأعباء العمل الحساسة.
أبرز الميزات

Ray هو إطار عمل حوسبة موزع وقابل للتوسع مصمم لبناء وتطبيق تطبيقات الذكاء الاصطناعي—من تدريب نماذج LLM إلى تقديمها بإنتاجية عالية. يمكن نشره بالكامل محلياً، مما يجعله خياراً رائعاً للمؤسسات التي تحتاج إلى تحكم كامل في البنية التحتية.
يشغل Ray مكدسات الذكاء الاصطناعي الحديثة مثل vLLM وDeepSpeed وHugging Face Transformers، ويدعم الاستدلال القابل للتوسع عبر Ray Serve. مع الدعم الأصلي لـ Kubernetes وجدولة GPU، يمكن لعناقيد Ray العمل بأمان في مراكز البيانات الخاصة لأعباء عمل LLMOps.
أبرز الميزات:

IBM Watson AI هي مجموعة من خدمات وأدوات الذكاء الاصطناعي المصممة لمساعدة المؤسسات على دمج الذكاء الاصطناعي في مسارات عملها مع تركيز قوي على الثقة، والشفافية، والحوكمة. أصبحت الآن جزءاً من IBM watsonx، وتتضمن المنصة watsonx.ai لبناء النماذج وضبطها، وwatsonx.data لإدارة البيانات القابلة للتوسع، وwatsonx.governance لضمان الاستخدام المسؤول للذكاء الاصطناعي عبر دورة الحياة.
تم تحسين Watson AI للبيئات السحابية الهجينة والمحلية باستخدام IBM Cloud Pak for Data وRed Hat OpenShift، مما يمنح المؤسسات تحكماً كاملاً في بياناتها ونشر نماذجها. وهي تدعم النماذج التأسيسية، والضبط الدقيق للنماذج المخصصة، والتكامل مع نماذج LLM مفتوحة المصدر، وكل ذلك مدعوم باتفاقيات مستوى الخدمة (SLAs) للمؤسسات.
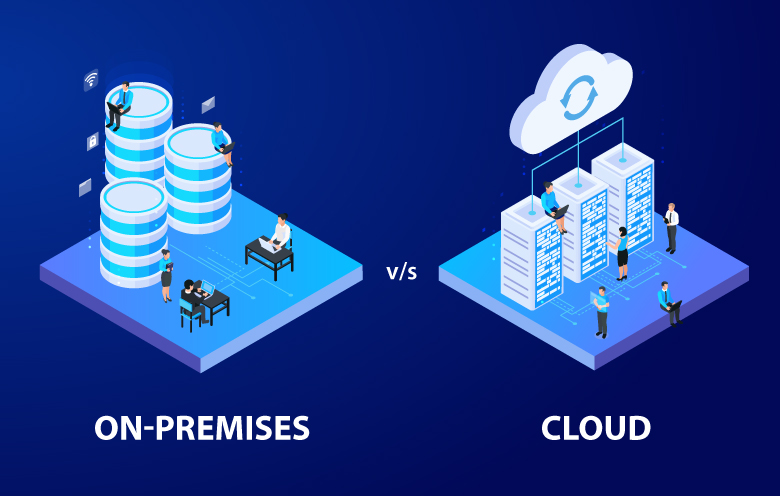
يوفر الذكاء الاصطناعي التوليدي المحلي للمؤسسات تحكماً كاملاً في بنيتها التحتية، ونماذجها، وبياناتها. وهو الخيار المفضل للمؤسسات التي تعمل في قطاعات خاضعة للتنظيم الشديد مثل الرعاية الصحية، أو المالية، أو الحكومة، حيث يكون الامتثال لمعايير الخصوصية مثل GDPR وHIPAA حاسماً. تتيح عمليات النشر المحلية للفرق الاحتفاظ بالبيانات الحساسة ضمن بيئاتها الخاصة، وتخصيص سلوك النموذج، وتحسين البنية التحتية للقابلية للتنبؤ بالتكلفة على المدى الطويل. بينما قد يتطلب الإعداد الأولي مزيداً من الجهد والاستثمار، فإنه يوفر مرونة أكبر، وإمكانية تدقيق، وتكاملاً مع الأنظمة الداخلية.
من ناحية أخرى، يوفر الذكاء الاصطناعي التوليدي السحابي السرعة، وقابلية التوسع، والراحة. فهو يتيح للفرق إنشاء نماذج أولية ونشر تطبيقات الذكاء الاصطناعي بسرعة دون القلق بشأن إدارة البنية التحتية. يتولى مزودو الخدمات السحابية التوسع التلقائي، وتوفير الأجهزة، وتحديثات النماذج، مما يتيح وقتاً أسرع للتسويق. ومع ذلك، قد يأتي ذلك مع مخاوف بشأن إقامة البيانات، والارتباط بمورد معين، والتسعير القائم على الاستخدام غير المتوقع. بالنسبة للعديد من المؤسسات، يتلخص الخيار في الموازنة بين احتياجات الامتثال والرشاقة التشغيلية.
في الختام، لم يعد الذكاء الاصطناعي التوليدي المحلي مجرد ملجأ للقطاعات الخاضعة للتنظيم. بل أصبح بسرعة ميزة إستراتيجية للمؤسسات التي تتطلب سيادة البيانات، والتحكم في البنية التحتية، وقابلية التوسع طويلة المدى. توفر حلول مثل TrueFoundry وNVIDIA Enterprise AI وRed Hat OpenShift AI وIBM Watson AI وRay قدرات قوية على مستوى الإنتاج لبناء وتقديم نماذج الذكاء الاصطناعي التوليدي بالكامل ضمن البنية التحتية الخاصة بالشركة.
مع تزايد تعقيد أنظمة الذكاء الاصطناعي وزيادة حساسية البيانات، يوفر النشر المحلي أساساً جاهزاً للمستقبل. فهو يُمكّن المؤسسات من الابتكار بثقة، والاطمئنان للامتثال، والحفاظ على الملكية الكاملة لكل من نماذجها وبياناتها.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد




















