



October 26, 2023
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.




Blazingly fast way to build, track and deploy your models!
اليوم، تطلق TrueFoundry سلسلة التعمق في Machine Learning، حيث نتحدث مع قادة ML و Data Science عبر الشركات التي تستخدم ML للتعمق في حالات الاستخدام وسير عمل ML داخل مؤسساتهم. كجزء من هذه السلسلة، سنستضيف ونستكشف بشكل أعمق البنية التحتية لـ ML (أو ML Stack) لشركات مثل Gong وStichFix وSalesForce وGusto وSimpl وغيرها الكثير.
📌
في هذه السلسلة، نتعمق في عالم Machine Learning للكشف عن طيف تطبيقات ML وإعدادات البنية التحتية عبر مختلف القطاعات.
ستدور محادثاتنا حول أربعة محاور رئيسية:
1. حالات استخدام Machine Learning للأعمال
2. كيف قاموا ببناء ML stack الخاص بهم بما في ذلك خطوط أنابيب التدريب والتجريب (Training and Experimentation Pipeline)، والنشر والتقديم (Deployment and Serving)، والمراقبة وتحسينها من حيث التكلفة وزمن الانتقال (Cost/Latency) أثناء العمل
3. التحديات التي واجهوها أثناء بناء ML stack مع تحديات محددة تتعلق بالقطاع
4. نظرة عامة على الابتكارات المتطورة المطبقة أثناء عملية بناء وتوسيع البنية التحتية لـ ML.
لبدء المناقشة الأولى في السلسلة، تحدثنا إلى Noam Lotner من Gong. تعد Gong منصة لذكاء الإيرادات (Revenue Intelligence). فهي تمكّن فرق الإيرادات من تحقيق كامل إمكاناتها من خلال كشف واقع العملاء من واقع محادثات فريق الإيرادات. تقوم Gong بتحليل التفاعلات الموجهة للعملاء عبر الهاتف والبريد الإلكتروني والويب وما إلى ذلك، لتقديم أفضل الرؤى لفرق الإيرادات حتى يتمكنوا من استخدامها لإغلاق المزيد من الصفقات.
Noam Lotner هو قائد فريق عمليات البحث (Research Operations Team Lead) في Gong. وهو يعمل على بناء المنصة التشغيلية لمجموعة أبحاث AI/ML - حيث يقوم بأتمتة عمليات إصدار النماذج، وإدارة التجارب، واختبارات الأداء، وبناء أدوات وضع العلامات (labeling) وإنشاء مجموعات البيانات، وتمكين الوصول الآمن إلى مصادر بيانات الإنتاج.
تقوم Gong بتحليل التفاعلات الموجهة للعملاء عبر الهاتف والبريد الإلكتروني والويب وما إلى ذلك. ويصبح Machine Learning أكثر أهمية لتحليل تفاعلات المبيعات تقديم الرؤى لفرق الإيرادات. يمكن لخوارزميات ML أتمتة المهام التي كانت تُجرى سابقًا يدويًا، مثل تحليل مكالمات الفيديو، والنسخ النصي، وتحليل مكالمات المبيعات الهاتفية. وهذا يوفر الوقت ويحسن كفاءة عملية المبيعات.
في حين أن هذا سؤال طرحناه على Gong، إلا أننا نرى أن جميع شركات SaaS بشكل غير مباشر:
📌
عدد النماذج: عدد العملاء × أنواع النماذج
📌
"نحن نستخدم نفس النموذج الأساسي للجميع. كما نتيح للعملاء في الواقع إجراء تدريب لنماذج معينة لمحتواهم الخاص."
من أجل تحسين التكاليف، تستخدم Gong تقديم النماذج المتعددة (multi-model serving) في طبقة الاستدلال (inference layer)، حيث إن تشغيل نماذج منفصلة في أجهزة منفصلة سيعني نظامًا عالي التكلفة.
إليك مدونة تفصيلية من Gong تتحدث عن استخدام ML في مبيعات B2B
في Gong، يتم هيكلة نظام ML وفقًا للهيكل التنظيمي لـ ML.
في هذه المدونة (وكذلك سلسلة المحادثات)، سوف نتعمق أكثر في تحديات البنية التحتية لجانب البحث في Gong
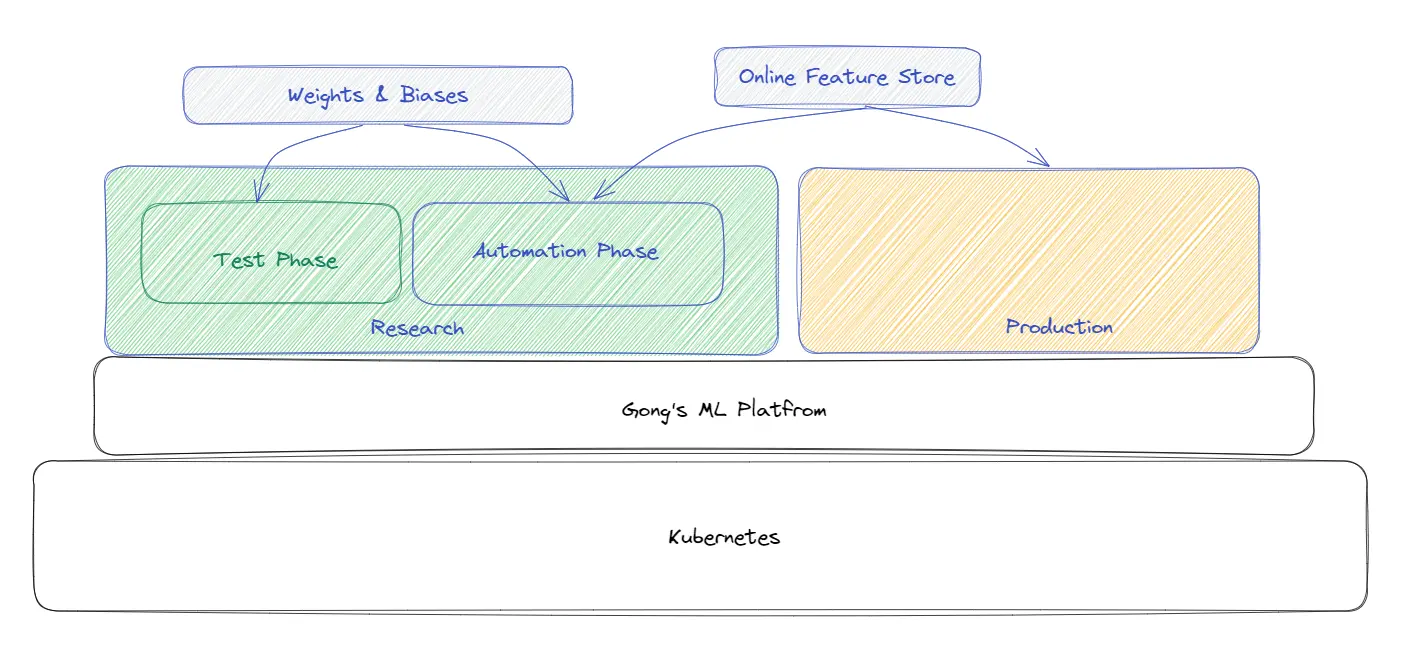
لتمكين الباحثين من تشغيل الأجهزة بسهولة، تم إعداد البنية التحتية بأكملها فوق Kubernetes للبنية التحتية للبحث. معظم النماذج في فريق البحث لا تستخدم ميزات عبر الإنترنت (online features).
السحابة: غالبية البنية التحتية موجودة على AWS ونعمل أيضًا مع مزودي سحابة آخرين بسعة أصغر نوعًا ما.
إدارة البنية التحتية: تقوم خطوط الأنابيب في الواقع بتشغيل النماذج تحديدًا لكل عميل. هناك جهاز يعمل ويتعامل مع جميع مكالمات تلك الشركة
كل ما يتم إنجازه في فريق البحث يتم نقله الآن إلى Kubernetes. جزء من عمل Noam هو مساعدة فريقه في الحصول على الموارد تلقائيًا من سحابة Kubernetes. إنه جهد مستمر حاليًا.
📌
"أوصي أي شخص يدخل في هذا المجال، أنه في وقت مبكر جدًا من رحلتك، تحتاج إلى التفكير في الحجم (Scale) وتحتاج إلى التفكير في كيفية عمل مجموعتك"
"أعتقد أن معظم أنظمة MLOps تتطلب Kubernetes لإدارة الموارد. لا أرى أي منصة في المستقبل يمكنها القيام بأي شيء يتعلق بـ MLOps دون استخدام Kubernetes"
بعض الأشياء المهمة التي يجب ملاحظتها:
📌
"وجهة نظري هي أن Gong كانت بحاجة إلى بناء هذه المنصة"
لا شيء يمكن أن يكون أكثر أهمية لشركة SaaS من الأمان. يجب أن يعطي خط أنابيب ML الأولوية للأمان بسبب خصوصية البيانات أثناء التعامل مع البيانات الحساسة للعملاء وكذلك للتحكم في الوصول غير المصرح به.
نأمل أن تكون المدونة الأولى في سلسلة حوارات TrueML Talks قد تمكنت من إعطائك رؤى قيمة حول كيفية التفكير في بناء البنية التحتية لأبحاث Machine Learning الخاصة بك لتمكين فرق ML لديك. #MLOps #MachineLearning #DataScience #DevOps #ModelOps #AIInfrastructure
توجه إلى الحلقة الثانية من حوارات TrueML حيث نتحدث مع قائد المنصة في Stitch. استمر في مشاهدة سلسلة youtube الخاصة بـ TrueML واعثر على جميع حلقات سلسلة مدونات TrueML هنا -
TrueFoundry هي منصة PaaS لنشر ML فوق Kubernetes لتسريع سير عمل المطورين مع إتاحة المرونة الكاملة لهم في اختبار النماذج ونشرها مع ضمان الأمان والتحكم الكامل لفريق البنية التحتية. من خلال منصتنا، نمكّن فرق Machine learning من نشر ومراقبة النماذج في 15 دقيقة بموثوقية وقابلية للتوسع بنسبة 100%، والقدرة على التراجع في ثوانٍ - مما يتيح لهم توفير التكلفة وإصدار النماذج للإنتاج بشكل أسرع، مما يتيح تحقيق قيمة أعمال حقيقية.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد





















