



November 5, 2025
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.



Blazingly fast way to build, track and deploy your models!
مع اتساع نطاق حالات استخدام تعلم الآلة بشكل كبير في السنوات الأخيرة، أصبحت الحاجة إلى توسيع نطاق العمليات المحيطة بتدريب هذه النماذج ونشرها ومراقبتها أمرًا بالغ الأهمية. العديد من هذه الشواغل تشبه تلك التي تم "حلها" لحالات استخدام البرمجيات العامة. وتعد Kubernetes إحدى هذه البرمجيات مفتوحة المصدر التي وحدت منظومة التقنيات السحابية الأصلية (cloud native) حول نفسها من خلال العمل كمنصة أساسية.
لذلك، أصبح من الضروري استكشاف ما إذا كان من المفيد الاستفادة من Kubernetes لحالات استخدام تعلم الآلة. لنبدأ أولاً بـ Kubernetes نفسها وما هو المثير للاهتمام فيها.
المصدر: Kubernetes
💡 Kubernetes هو محرك مفتوح المصدر لإدارة الحاويات (container orchestration) لأتمتة نشر التطبيقات الحاوية وتوسيع نطاقها وإدارتها.
بعبارات أبسط، يوفر Kubernetes طريقة بسيطة وموحدة لتشغيل وإدارة أعباء العمل التي تحتاج إلى توسيع نطاقها ديناميكيًا عبر أجهزة متعددة.
دعنا نمر على بعض من أشهر الميزات -
هذه فقط بعض الميزات المتاحة افتراضيًا. يتم حل عدد كبير من حالات الاستخدام فعليًا بواسطة الأدوات التي تم بناؤها باستخدام Kubernetes كطبقة أساسية. سنتطرق إلى أدوات محددة في عدد قادم.
مع فهم ما هو Kubernetes وما هي الميزات الرئيسية التي يوفرها في سيناريو تطوير البرمجيات، دعنا نتعمق في المشاكل المحددة التي يمكنه حلها في سير عمل عالم البيانات.
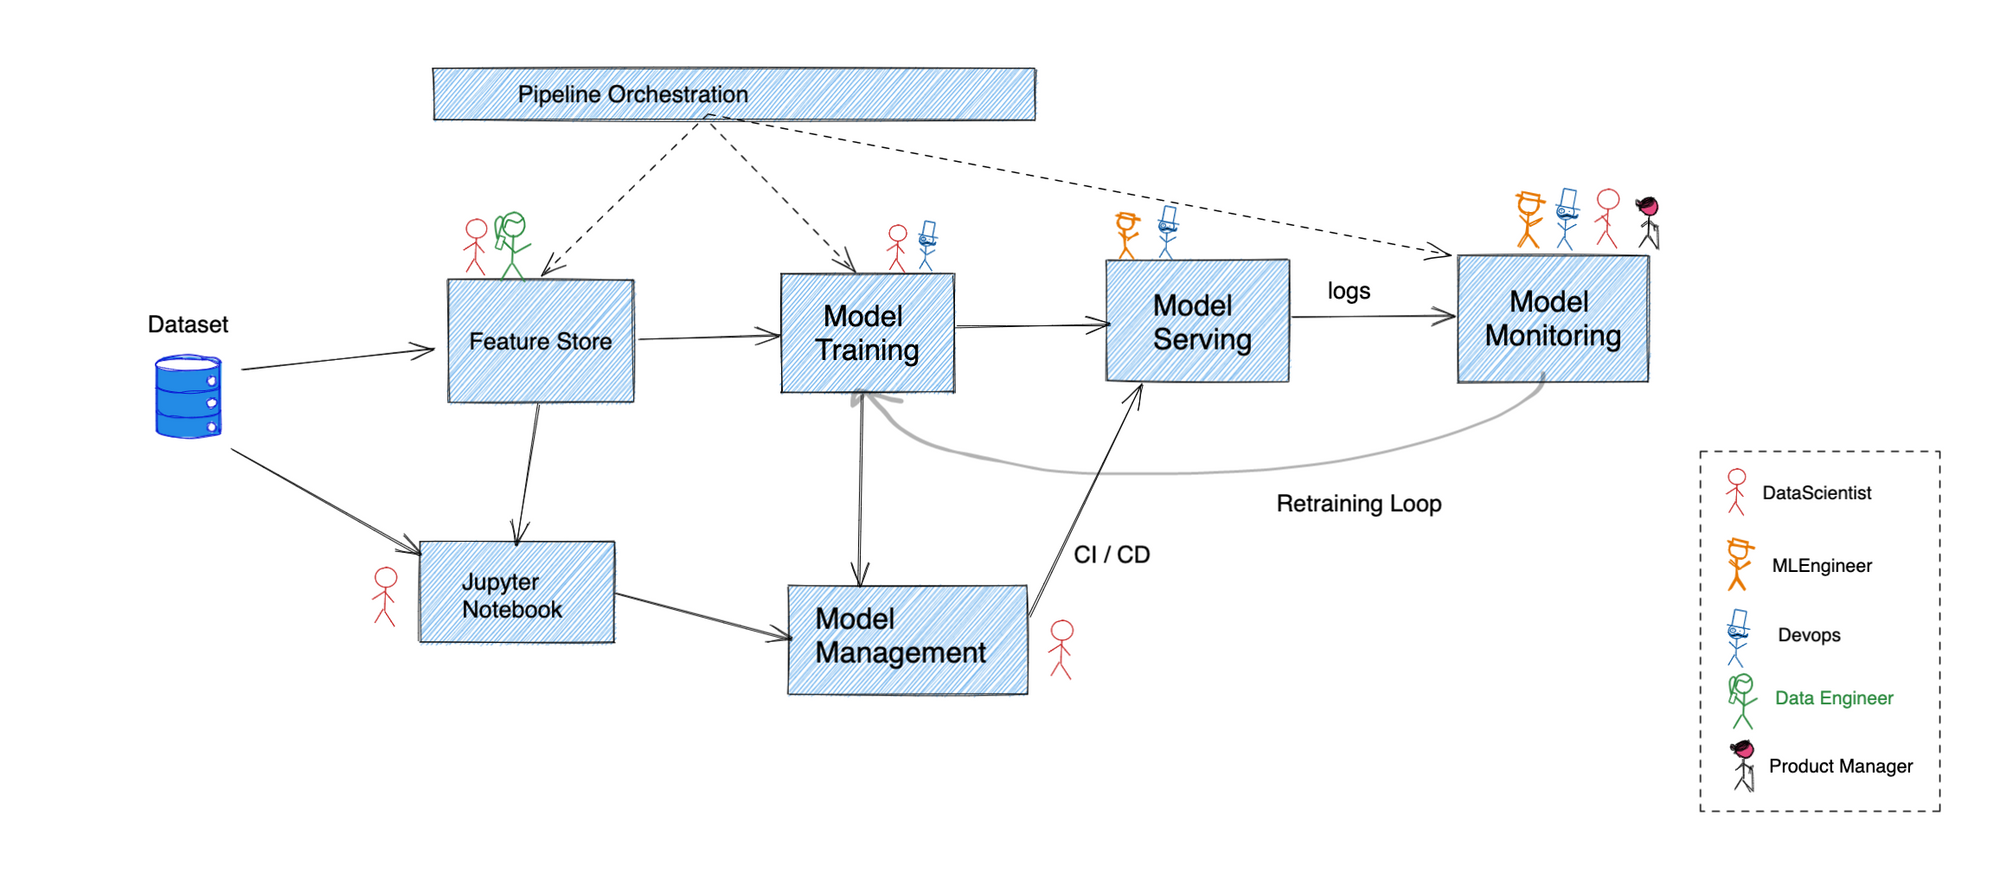
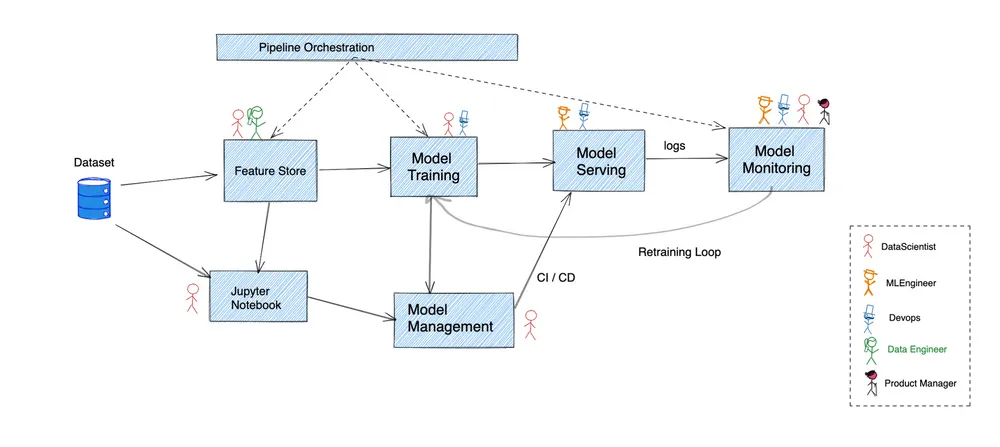
يوضح الشكل أعلاه مخططًا عامًا لكيفية عمل خط أنابيب علوم البيانات النموذجي. اختارت العديد من الشركات استخدام مجموعة واسعة من الحلول المخصصة ذات الميزات المتداخلة لربط كل ذلك معًا.
سنمر عبر كل خطوة من هذه الخطوات لمحاولة فهم أين يناسب Kubernetes الغرض -
قبل أن تصبح أي بيانات خام مفيدة، يجب أولاً تحويلها إلى مدخلات معالجة لخط أنابيب تدريب النموذج. هذا هو المكان الذي تدخل فيه متاجر الميزات (feature stores) إلى الصورة من خلال إجراء التحويل والتخزين والتقديم لبيانات الميزات.
يدعم Kubernetes نشر أعباء العمل ذات الحالة (stateful workloads) ويتكامل بشكل جيد جدًا مع مزودي الخدمات السحابية لتوفير الاستمرارية (persistence) بسلاسة.
يبدأ معظم تطوير النماذج بكتابة مهندس ML للكود في jupyter notebook، وبالنسبة للكثيرين، هذا هو كل ما يلزم تقريبًا. يوفر واجهة REPL لتشغيل كود python. يبدأ هذا باستضافته على أجهزة الكمبيوتر المحمولة الشخصية، ولكن من الأفضل تشغيل مجمع مركزي من دفاتر jupyter المستضافة والتي يمكن استخدامها من قبل أفراد متعددين.
النموذج التصريحي لـ Kubernetes إلى جانب دعم أنظمة التخزين الدائمة يجعلا استضافة مجمع من الدفاتر وتوفير التحكم في الوصول إلى الدفاتر الفردية أمرًا بسيطًا لفرض تعاون فعال.
أي خوارزمية مكتوبة على notebook تحتاج إلى تزويدها ببيانات التدريب للحصول على كائن نموذج (model artefact) كمخرج. يمكن القيام بذلك في notebook نفسه في حالات الاستخدام الأصغر، ولكنه يتطلب خط أنابيب أكثر قوة للمجموعات الكبيرة من البيانات. عادة ما يتم إجراء التحقق من الصحة مقابل مجموعة بيانات الاختبار هنا أيضًا قبل استخدام كائن النموذج لإجراء الاستدلالات في الإنتاج.
هناك حلول متعددة لتنسيق خط أنابيب DAG على Kubernetes. يتمتع Airflow بدعم أصلي لـ Kubernetes بينما تم بناء kubeflow بالكامل فوق Kubernetes. توفر جميع حلول المراقبة الرئيسية تكاملاً من الدرجة الأولى مع Kubernetes، وهو أمر ضروري لتشغيل خطوط أنابيب بدرجة الإنتاج.
تعتني هذه المرحلة بتخزين وتحديد إصدارات مجموعة البيانات والنموذج. يضمن ذلك بقاء أي كائن نموذج قابلاً للتكرار لطالما دعت الحاجة. يمكن إجراء مقارنة مع كيفية إجراء إدارة الكود باستخدام git.
على الرغم من أن مخزن البيانات الأساسي لجميع أنظمة الإدارة هذه يمكن استضافته على Kubernetes نفسه، فإنه في كثير من الحالات يكون من الأفضل استخدام حل مدراء من مزود خدمة سحابية. في مثل هذه الحالات، يدمج معظم مزودي الخدمات السحابية أنظمة IAM الخاصة بهم بسلاسة مع تلك الخاصة بـ Kubernetes، مما يجعل الوصول إلى البيانات من خارج العنقود (cluster) آمنًا دون الحاجة إلى تخزين بيانات أوراق الاعتماد.
أخيرًا، يتم إعداد كائن النموذج حتى يتمكن نظام الإنتاج من إجراء الاستدلالات عليه. يتضمن هذا عادةً تغليف نموذج في إطار عمل API والسماح للخدمات الأخرى باستدعاء النموذج لإجراء الاستدلالات. تظهر هنا شواغل مماثلة لهندسة البرمجيات مثل authn/authz، القابلية للتوسع، الموثوقية، إلخ.
هذا هو المكان الذي يتألق فيه Kubernetes. تصبح معظم الميزات التي تحدثنا عنها في القسم السابق حاسمة في هذه المرحلة.
مثل أي نظام إنتاج، فإن المراقبة المستمرة للنموذج المنشور حاليًا أمر ضروري للتأكد من أن نظامك يتصرف بالطريقة المتوقعة منه. يمكن أن تشمل المقاييس التي يجب مراقبتها كل شيء بدءًا من الدقة الفعلية للتنبؤات إلى زمن الانتقال (latency) والإنتاجية (throughput) التي يستطيع النظام دعمها.
تتكامل الكثير من حلول المراقبة عن كثب مع Kubernetes. إن اكتشاف هدف لسحب المقاييس فعليًا، وإجراء الحسابات عليها، وتخزينها لاستخدامها لاحقًا، كلها أمور يمكن إجراؤها دون أي تبعية خارجية.
إن المشهد العام المحيط بـ Kubernetes ينفجر بشكل كبير وهناك الكثير من الأدوات المتاحة بالفعل. ومع ذلك، هناك بعض المآزق التي يجب على أي مؤسسة أخذها في الاعتبار قبل تبنيها بالكامل. سنتطرق إليها وكيفية التخفيف منها في العدد القادم.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد
























