



November 16, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.



Blazingly fast way to build, track and deploy your models!
تتسابق المؤسسات اليوم للاستفادة من قوة نماذج اللغات الكبيرة (LLMs) في كل شيء بدءاً من روبوتات الدردشة لخدمة العملاء وحتى خطوط تجميع التحليلات المتقدمة. ولكن مع انتقالك لما بعد مرحلة إثبات المفاهيم إلى الإنتاج، ستكتشف سريعاً أن استدعاء LLM مباشرة لا يكفي، خاصة عندما تتطلب اتفاقيات مستوى الخدمة (SLAs) أداءً راسخاً، وأماناً مشدداً، والمرونة للتعامل مع مزودي نماذج متعددين أو جلب النماذج الخاصة بك. هنا يأتي دور LLM gateway، وهي طبقة خفيفة ومصممة خصيصاً تجلس بين تطبيقاتك والنظام البيئي المتطور باستمرار لنقاط نهاية LLM.
في الأقسام التالية، سنستعرض إطار عمل تقييمي يتكون من خمسة أركان، يغطي الأداء وزمن الانتقال، ومرونة النماذج، وعناصر التحكم التشغيلية، والقابلية للملاحظة، والامتثال الأمني، والتي ينبغي لكيل مؤسسة استخدامها قبل الالتزام بحل البوابة.
تعد LLM gateway الخاصة بالمؤسسات طبقة مركزية بين تطبيقاتك ونماذج LLMs أو خدمات AI التي تستخدمها.
بدلاً من ربط كل تطبيق مباشرة بـ OpenAI أو Anthropic أو Google أو Amazon Bedrock أو النماذج المستضافة ذاتياً، يمكنك توجيه تلك الطلبات عبر بوابة مشتركة.
يمنح هذا فريق المنصة لديك مكاناً واحداً لإدارة المصادقة، والوصول إلى النماذج، والتوجيه، وحدود المعدل، وإعادة المحاولة، وتسجيل السجلات، والسياسات الأخرى.
على سبيل المثال، يمكن لتطبيقك إرسال طلب إلى البوابة دون الحاجة إلى معرفة ما إذا كان سيصل في النهاية إلى نموذج مستضاف، أو نموذج يعمل في VPC الخاص بك، أو مزود آخر. تتولى البوابة هذا التوجيه بناءً على القواعد التي تحددها.
يصبح هذا التجريد مفيداً عندما تبدأ بنية AI لديك في التغير بشكل متكرر. يمكنك إضافة أو تبديل النماذج دون إجبار كل فريق تطوير على إعادة كتابة التكامل الخاص به.
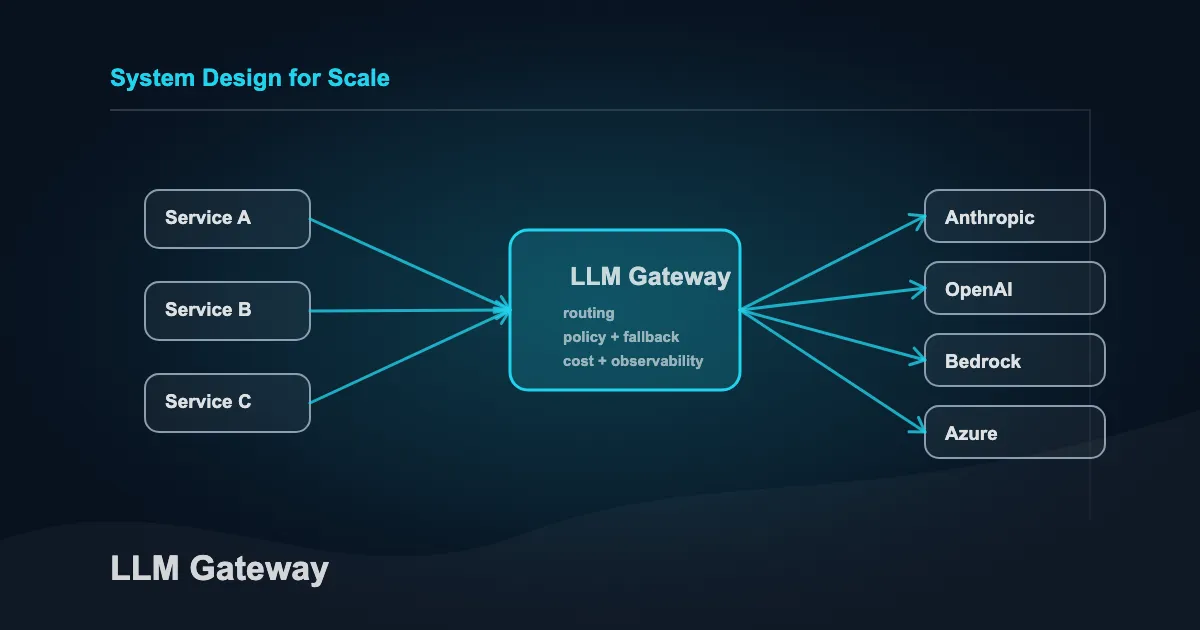
يمكن أن تعمل عمليات التكامل المباشر للنماذج بشكل جيد مع عمليات إثبات المفاهيم المبكرة. ولكن على مستوى المؤسسات، يمكن أن تخلق مشاكل تشغيلية.
قد ينفذ كل تطبيق المصادقة، وإعادة المحاولة، و SDKs الخاصة بالمزود، وتسجيل السجلات، و rate limiting بشكل مختلف. يجعل ذلك من الصعب تأمين البيئة وإصلاح أخطائها.
توفر لك LLM gateway طبقة تحكم مركزية. يمكنك استخدامها من أجل:
كلما اتسعت بصمة AI لديك، أصبحت تلك المركزية أكثر قيمة.
قبل المقارنة بين الموردين، حدد ما تتطلبه بيئتك الخاصة. وإلا فقد ينتهي بك الأمر إلى تقييم ميزات تبدو مثيرة للإعجاب ولكن لها صلة ضئيلة بأعباء العمل لديك.
ابدأ بحركة المرور لديك. قم بتقدير طلباتك في الثانية (RPS) الحالية والمتوقعة وحركة المرور في أوقات الذروة. خذ في الاعتبار المستخدمين المتزامنين، ومتوسط أحجام المطالبات والاستجابات، واحتياجات البث (streaming)، وأهداف زمن الانتقال.
قم أيضاً بفصل أعباء العمل حيثما كان ذلك ضرورياً. قد تكون لـ chatbot الموجه للعملاء متطلبات زمن انتقال مختلفة تماماً عن خط تجميع التلخيص الدفعي (batch summarization).
يجب اختبار البوابة الخاصة بك مقابل النمط الفعلي لحركة المرور لديك، وليس فقط مقابل المعيار المرجعي المعلن من المورد.
حدد المكان الذي يجب أن تعمل فيه البوابة. ترتاح بعض المؤسسات للخدمات المُدارة. بينما تحتاج مؤسسات أخرى إلى البوابة داخل VPC خاص، أو في المقر الرئيسي (on-premises)، أو عبر سحب متعددة، أو في بيئة معزولة تماماً (air-gapped).
يمكن أن يؤثر قرار النشر الخاص بك على نقل البيانات، والشبكات، والمراجعات الأمنية، والامتثال، والملكية التشغيلية.
قم بإدراج عناصر التحكم التي تتطلبها مؤسستك بالفعل. قد تشمل هذه تسجيل الدخول الموحد (SSO)، و Role based access control (RBAC)، والتشفير، وسجلات المراجعة، وإقامة البيانات، واكتشاف PII، وإدارة المفاتيح، والتكامل مع مزود الهوية الحالي لديك.
لا تفترض وجود ميزة لمجرد أن المورد يستخدم كلمة "مؤسسي". اسأل كيف يعمل عنصر التحكم بالفعل وأين تُعالج البيانات.
فكّر فيما هو أبعد من النماذج التي تستخدمها اليوم. قد تبدأ بمزود واحد ثم تقدم مزوداً آخر لاحقاً لأسباب تتعلق بالتكلفة أو التوفر أو الأداء أو الأسباب التنظيمية. قد تضيف أيضاً نماذج مفتوحة المصدر تعمل في البنية التحتية الخاصة بك.
يجب أن تجعل البوابة الخاصة بك هذه التغييرات أسهل بدلاً من إنشاء طبقة أخرى من الانغلاق مع المورد (vendor lock-in).
يجب أن يتجاوز تقييم LLM gateway قائمة الميزات. إذا كنت تريد تقييم LLM gateway بشكل صحيح، فاختبر كيفية تصرفها في المواقف التي من المحتمل أن تواجهها أنظمة الإنتاج لديك.
تقع LLM gateway مباشرة في مسار الطلب، لذا فإن الحمل الإضافي (overhead) الخاص بها يمثل أهمية كبيرة.
قس زمن الانتقال المضاف بواسطة البوابة بدلاً من النظر فقط إلى وقت استجابة النموذج. اختبر حركة المرور العادية، وحركة المرور في الذروة، والطلبات المتزامنة، واستجابات البث، وسيناريوهات الفشل.
انظر أيضاً إلى مقاييس مثل الوقت حتى أول رمز (time to first token) وزمن الانتقال الذيلِي (tail latency). البوابة التي تؤدي بشكل جيد مع حركة المرور المنخفضة ولكنها تصبح عنق زجاجة أثناء الارتفاعات المفاجئة قد لا تكون مناسبة للإنتاج.
ينبغي ألا تضطر إلى إعادة كتابة كود التطبيق في كل مرة تغير فيها المزودين.
تحقق مما إذا كانت البوابة يمكنها العمل مع النماذج التي تستخدمها بالفعل وتلك التي تتوقع إضافتها. اختبر APIs المستضافة، وخدمات النماذج السحابية، والنماذج المستضافة ذاتياً حيثما كان ذلك مناسباً.
انتبه للفروق في تنسيقات الطلبات، والبث، والمصادقة، والتضمينات (embeddings)، وإعادة الترتيب (reranking)، ومدخلات متعددة الوسائط (multimodal).
يجب على البوابة المستقلة حقاً عن النماذج أن تخفي التعقيدات غير الضرورية الخاصة بالمزود عن تطبيقك.
يصبح التوجيه مهماً عندما يكون لديك نماذج أو مزودون متعددون.
يجب أن تمنحك البوابة طرقاً لتوزيع حركة المرور بناءً على عوامل مثل توفر النموذج، أو زمن الانتقال، أو الأولوية، أو الأوزان المكونة.
التجاوز عند الفشل لا يقل أهمية. إذا أعاد المزود خطأً أو أصبح غير متاح، فيجب أن تكون البوابة قادرة على إعادة المحاولة أو نقل الطلب إلى بديل مناسب حيث يسمح تطبيقك بذلك.
لا يمكن أن يكون الأمان فكرة لاحقة عندما قد تحتوي المطالبات على معلومات العملاء أو المستندات الداخلية أو غيرها من البيانات الحساسة.
ابحث عن LLM access control، والمصادقة المركزية، و RBAC، والتشفير، وإدارة المفاتيح، و audit logging، والتكامل مع أنظمة الهوية الحالية لديك.
يجب عليك أيضاً التحقق مما إذا كانت البوابة تدعم عناصر التحكم مثل اكتشاف PII، وإخفائها، وتصفية المحتوى، والحماية من حقن المطالبات (prompt-injection).
عندما يصبح تطبيق AI بطيئاً أو يبدأ في إنشاء أخطاء، فأنت بحاجة إلى معرفة ما حدث بين التطبيق والنموذج.
يجب أن تساعدك البوابة في الإجابة على أسئلة مثل:
لمزيد من التفاصيل، اقرأ دليلنا التفصيلي حول what is LLM observability.
بمجرد أن تبدأ عدة فرق في استخدام AI، يصبح من الصعب الحفاظ على القواعد غير الرسمية.
يجب أن تتيح لك البوابة تحديد من يمكنه الوصول إلى أي نماذج، وكم يمكنهم الاستخدام، وأي السياسات تنطبق على طلباتهم.
يمكن أن تساعدك الحوكمة المركزية أيضاً في تقديم حصص متسقة، وحدود للمعدل، وحواجز حماية (guardrails)، وعمليات موافقة بدلاً من إجبار كل فريق تطبيق على تنفيذها بشكل مستقل.
بالنسبة للمؤسسات التي تستخدم GitOps، يمكن أن تكون السياسة ككود (policy-as-code) مفيدة بشكل خاص حيث يمكن مراجعة التغييرات وإصدارها والتراجع عنها.
يصبح AI cost optimization تحدياً عندما تستخدم فرق مختلفة مزودين ونماذج مختلفين، مما يجعل من الصعب تتبع الإنفاق والتحكم فيه.
يجب أن توفر البوابة رؤية لاستخدام الرموز والإنفاق عند مستويات مفيدة، مثل التطبيق، أو الفريق، أو النموذج، أو المستخدم.
والأهم من ذلك، يجب أن تساعدك في التحكم في الإنفاق.
يمكنك، على سبيل المثال، توجيه طلب أقل تطلباً إلى نموذج أرخص مع حجز نموذج أكثر قدرة للمهام التي تتطلب ذلك بالفعل. يمكن للميزانيات، والحصص، وحدود المعدل، والتخزين المؤقت (caching)، والتجميع (batching)، والتوجيه الذكي أن تسهم جميعها في التحكم في التكاليف.
يجب أن تناسب best LLM gateway بنيتك التحتية بدلاً من إجبارك على إعادة تصميمها.
تحقق مما إذا كانت تدعم البيئات التي تحتاجها اليوم وتلك التي قد تحتاجها لاحقاً، بما في ذلك السحابة، أو VPC الخاص، أو المقر الرئيسي، أو البيئات الهجينة، أو المعزولة تماماً.
توجد البوابة جزئياً لجعل البنية التحتية لـ AI أسهل للمطورين.
تحقق من السرعة التي يمكن للمطور بها ربط تطبيق، وإضافة نموذج، وإدارة أوراق الاعتماد، واختبار الطلبات، وفحص الأخطاء، وتبديل المزودين.
ابحث عن API متسق، ووثائق، و SDKs، ودعم CLI، وتكاملاً مع الأدوات التي تستخدمها فرقك بالفعل.
إذا كان المطورون بحاجة إلى فهم البنية الداخلية للبوابة في كل مرة يقومون فيها باستدعاء نموذج، فأنت لا تحصل على الفائدة الكاملة للتجريد.
استخدم قائمة المراجعة التالية أثناء تقييم LLM gateway لديك:
الهدف ليس وضع علامة صح على كل صندوق. اسأل الموردين إثبات هذه القدرات مقابل بنيتك التحتية الفعالية وأعباء العمل المتوقعة لديك.
سيخبرك إثبات المفاهيم مع حركة مرور شبيهة بالإنتاج بأكثر بكثير مما تخبرك به مقارنة الميزات الطويلة.
يمكن للبوابة المؤسسية معالجة العديد من المشكلات التي تظهر مع انتشار اعتماد AI عبر المؤسسة.
لا تقضي البوابة على كل مشكلة في البنية التحتية لـ AI. إنها تمنحك مكاناً مركزياً لإدارة العديد من المخاوف التي كانت لتكون موزعة عبر التطبيقات.
تُستخدم LLM gateways in enterprise بشكل شائع عبر مجموعة من تطبيقات AI، بما في ذلك:
تم تصميم بوابة TrueFoundry للتميز عبر أركان التقييم الخمسة، حيث تجمع بين الأداء العالي، والإدارة السلسة، وعناصر التحكم من الدرجة المؤسسية. أدناه، نوضح كل ميزة أساسية بتنسيق منظم.
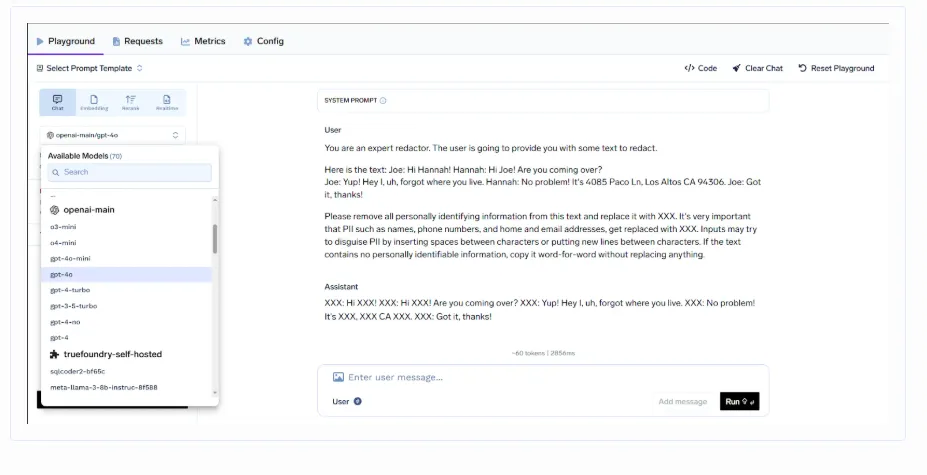
تعرض TrueFoundry واجهة RESTful واحدة تخفي الفروق الدقيقة الخاصة بكل مزود. سواء كنت تستدعي نموذج LLaMA يعمل في المقر الرئيسي أو نقطة نهاية OpenAI مُدارة، يظل الكود الخاص بك كما هو.
تقلل طبقة الوصول الموحدة هذه للنماذج من جهد التجميع وتؤمن تطبيقاتك للمستقبل. يمكنك إضافة أو تبديل المزودين دون المساس بالكود الحالي.
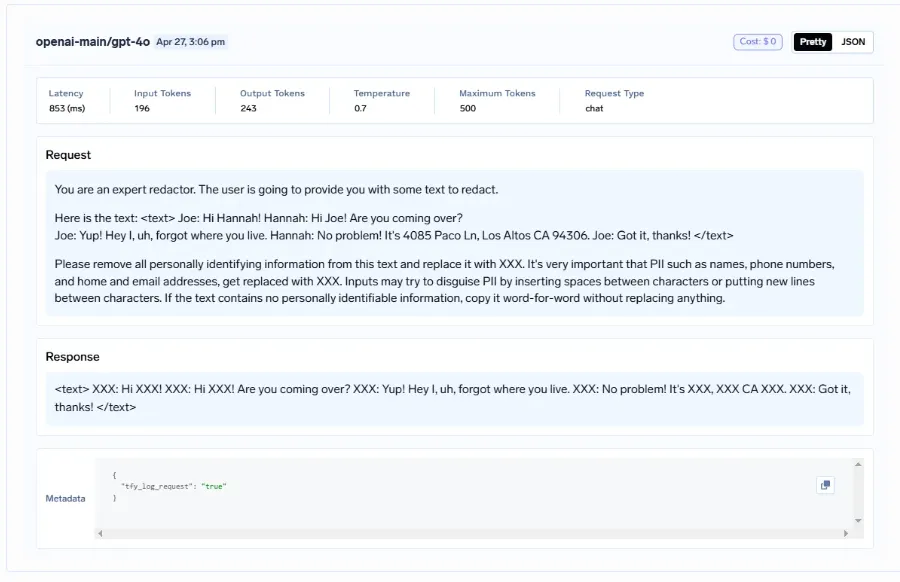
تحافظ LLM Gateway من TrueFoundry على حمل إضافي يقارب الصفر حسب التصميم. في الأرقام القياسية المنشورة لـ TrueFoundry، أضافت البوابة حوالي 3 ميللي ثانية من زمن الانتقال عند ما يصل إلى 250 RPS و 4 ميللي ثانية فوق 300 RPS. أظهر الاختبار أيضاً حوالي 350 RPS على إعداد 1-vCPU و 1-GB.
على سبيل المثال، يمكن لمثيل spot من نوع t2.2xlarge AWS (حوالي 43 دولاراً شهرياً) استيعاب حوالي 3000 RPS دون أي تدهور في الأداء. نظراً لإمكانية نشر البوابة عند الحافة (edge)، بالقرب من تطبيقاتك، يتم تقليل قفزات الشبكة، وتظل أوقات الاستجابة متسقة. تُظهر هذه المقاييس الموثقة أن LLM Gateway من TrueFoundry توفر أداءً متوقعاً عالي الإنتاجية حتى تحت الأحمال الثقيلة، مما يتيح للفرق الحفاظ على التزامات SLA دون الإفرط في تجهيز البنية التحتية.
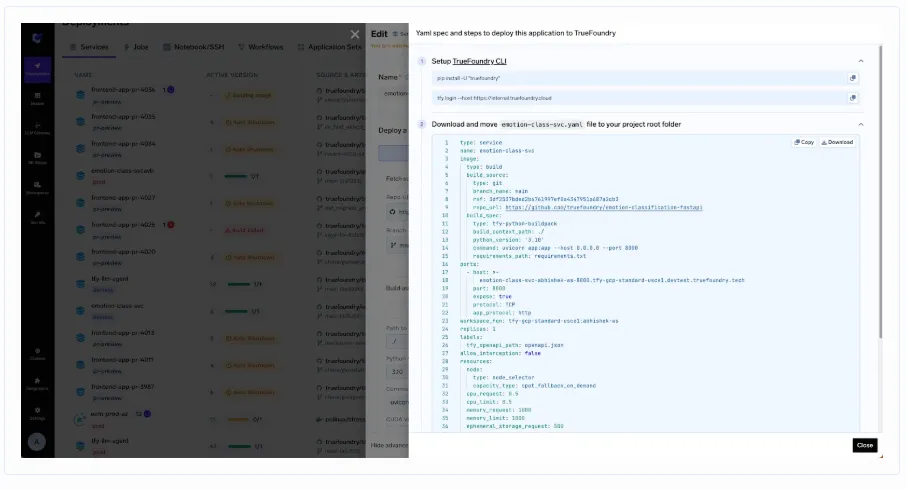
كل جانب من سلوك البوابة لديك يعيش في مستودعات Git المتحكم بإصداراتها. تُحدد مخططات Helm وملفات YAML، مثل ملف config.YAML الخاص بحدود المعدل، نقاط نهاية النماذج، وقواعد حد المعدل، وإعدادات موازنة الحمل، وقوالب المطالبات، مما يضمن القابلية الكاملة للمراجعة.
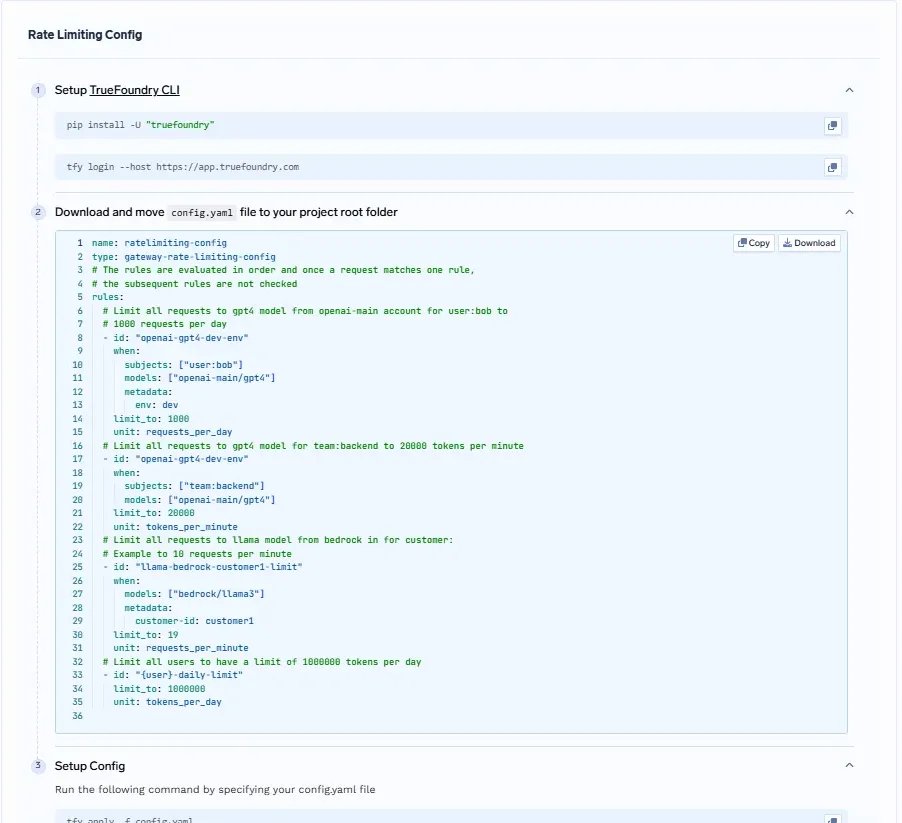
من خلال تضمين هذه السياسات في Git (ونشرها عبر TrueFoundry CLI)، فإنك تفرض أفضل الممارسات، وتقلل من الخطأ البشري، وتسرع من حوكمة السياسات عبر الفرق. توضح اللقطة أعلاه مدى سهولة إنشاء خطة تحديد معدل معقدة وإصدارها، ثم دفعها عبر عملية المراجعة الحالية لديك.
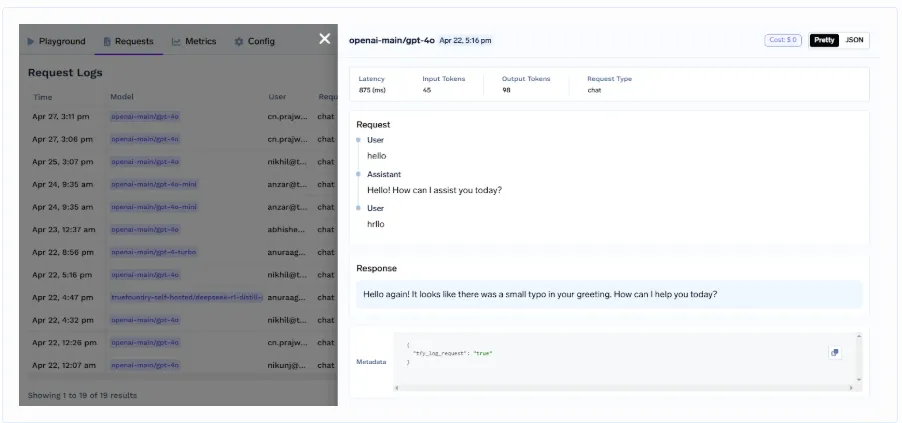
تلتقط TrueFoundry قياسات أداء غنية عن بُعد لكل استدعاء، بدءاً من الطوابع الزمنية وزمن الانتقال ووصولاً إلى سجلات الإدخال/الإخراج. تتدفق البيانات إلى ClickHouse للاستعلام في الوقت الفعلي أو إلى S3 للأرشفة طويلة المدى.
مع هذا المستوى من الرؤية، يمكنك إصلاح المشكلات في دقائق، وتتبع اتجاهات الاستخدام، وإثبات مسارات المراجعة للمنظمين. يكتسب فريقك الثقة في الوضوح التشغيلي.
الأمان مدمج في كل طبقة من طبقات البوابة، من المصادقة إلى التحصين أثناء التشغيل. يضمن التكامل مع مزودي OIDC و SAML وسياسات PodSecurity الامتثال.
يلبي الوضع الأمني لـ TrueFoundry حتى أشد متطلبات المؤسسات قسوة. تظل البيانات الحساسة محمية دون التضحية بالأداء.
تستطيع TrueFoundry’s LLM gateway القيام بأكثر من مجرد تلبية أركان التقييم—إنها ترفع معايير عمليات النشر في الإنتاج. من خلال الجمع بين وكيل خفيف الوزن في الذاكرة (in-memory proxy)، وحوكمة GitOps، وعناصر تحكم محصنة، فإنها توفر الاتساق والمرونة عبر البيئات العالمية.
أولاً، يعمل وكيل FastLight بالكامل في الذاكرة ويضيف أقل من 5 ميللي ثانية من الحمل الإضافي حتى عندما تنمو من عشرات إلى آلاف الطلبات في الثانية. يتم توفير الحاويات (pods) وإلغاء توفيرها تلقائياً بناءً على حركة المرور، وتتجنب بالتالي كلاً من الإفراط في التجهيز وتأخيرات البدء البارد (cold-start). ثانياً، تحافظ لوحة التحكم الموزعة (hub-and-spoke) على الإدارة مركزية ورشيقة، بينما تعيش حاويات البوابة الإقليمية بالقرب من المستخدمين أو البيانات للحصول على أقل زمن انتقال.
تشغيلياً، يتم تخزين تكوينك بالكامل في Git. قم بضبط حدود المعدل أو تقديم نقطة نهاية خاصة جديدة عن طريق تحديث مخطط Helm، ودمج طلب السحب (pull request)، والسماح لخطوط تجميع CI/CD بنشر التغييرات. إذا أساء التحديث التصرف، فما عليك سوى التراجع عن PR للعودة إلى حالة جيدة معروفة.
تضمن TrueFoundry أيضاً الأمان المؤسسي افتراضياً. ترفق عناصر التحكم في الوصول القائمة على الأدوار، وتكامل SSO، وسياسات PodSecurity بكل نشر. تتدفق سجلات المراجعة إلى ClickHouse أو S3، مما يمنح فرق الأمان رؤية في الوقت الفعلي مع توسع الاستخدام.
سواء كنت تشغل 100 RPS في منطقة واحدة أو 10K RPS عبر خمس قارات، فإن بوابة TrueFoundry تقدم الأداء والموثوقية والتحكم الذي تتطلبه المؤسسات. إنها تنقل عمليات LLM من مجرد "جعلها تعمل" إلى "جعلها تتوسع".
شاهد كيف يمكن لـ TrueFoundry مساعدتك في توسيع أعباء عمل LLM بتحكم ورؤية أكبر. Sign up اليوم.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد




















