



November 6, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.



Blazingly fast way to build, track and deploy your models!
وصل GPT-6 Astra في 3 سبتمبر 2026. وسلسلة النص البرمجي لـ API هي gpt-6-astra — دون لقطة مؤرخة (dated snapshot) ودون اسم مستعار منفصل؛ وتدرج صفحة النموذج gpt-6-astra كلقطة واسم مستعار في آن واحد.
المواصفات، بحسب وثائق النموذج من OpenAI:
ثلاثة أمور في التفاصيل الدقيقة أكثر أهمية من العنوان الرئيسي.
أولاً، لم يعد خيار reasoning.effort يقبل القيمة none. بينما كان GPT-5.6 Sol يقبلها. إذا كان لديك مسار سريع ورخيص مثبت على none، فلن تتمكن من نقله كما هو.
ثانياً، تمت إزالة temperature وtop_p وlogprobs. ينص سجل التغييرات على أن Astra "لا يدعم قيم temperature أو top_p المخصصة أو احتمالات السجلات (log probabilities)." أي شيء في بنيتك التقنية يقوم بضبط معلمات العينات (sampling parameters) يحتاج إلى مراجعة وتدقيق قبل الانتقال.
ثالثاً، يتطلب استدعاء الأدوات (tool calling) استخدام Responses API. إذا كنت تستدعي الأدوات عبر Chat Completions اليوم، فهذا يتطلب عملية نقل برمجية (migration) وليس مجرد تبديل نموذج.
[SCREENSHOT: OpenAI Platform — the gpt-6-astra model page showing context window, max output and per-token pricing]
لم تتغير نافذة السياق ولا حد الإخراج. بل السعر هو الذي تغير.
المصادر: وثائق نموذج GPT-6 Astra، ووثائق نموذج GPT-5.6 Sol، سبتمبر 2026. يُشار إلى أن OpenAI تصف أسعار GPT-5.6 Sol بأنها أسعار ترويجية متاحة على الأقل حتى 21 نوفمبر 2026، لذا قد لا تستمر هذه النسبة بعد ذلك التاريخ.
تغير كل معدل بنفس المعامل تماماً. وتبين أن هذا الأمر مهم بالنسبة لمسألة التخزين المؤقت أدناه.
تظل ميزتا Batch وFlex بنسبة 50% من خيار Standard. أما الوضع السريع (Fast mode)، الذي تقول OpenAI إنه يوفر سرعة تصل إلى ضعفي سرعة المعالجة القياسية Standard، فيتم تسعيره بضعف (2x) المعدلات المطبقة — وبالتالي فإن وضع Fast في Astra يبلغ 20$ للإدخال و100$ للإخراج.
نشرت OpenAI جدول مقارنة مباشراً كبيراً في منشور الإطلاق. إليك الجزء الذي يستحق إعادة العرض، ثم الجزء الذي تتجاهله معظم التغطيات الإعلامية.
المصدر: منشور إطلاق GPT-6 Astra، سبتمبر 2026. الدرجات هي الحد الأقصى لأي مستويات جهد تفكير (reasoning effort).
أين يتفوق Astra بوضوح. الأعمال الوكيلة طويلة المدى (Long-horizon agentic work). ففي اختبار Terminal-Bench 4.0 ارتفعت النتيجة بأكثر من عشرين نقطة مقارنة بنموذج Sol. وفي Terminal-Bench Science تضاعفت النتيجة ثلاث مرات تقريباً. وفي AutomationBench تضاعفت بأكثر من الضعف. وارتفعت نسبة استرجاع السياق الطويل عند 512K-1M من 73.8% إلى 96.3%. هذه هي بيئات العمل التي بُني النموذج من أجلها، والفرق واضح وليس طفيفاً.
أين يتقلص الفارق ليكون مجرد هامش بسيط. المعرفة والتفكير المنطقي لمرة واحدة (Single-shot). حيث ارتفعت نتيجة GPQA Diamond من 94.6% إلى 96.0%. وارتفعت DeepSWE من 72.7% إلى 74.1%. إذا كانت حركة البيانات لديك عبارة عن أسئلة وإجابات وليست مهام ذات خطوات متسلسلة، فأنت تدفع 2.5 ضعف للحصول على نقطة واحدة تقريباً.
أين لا يتفوق Astra. في المؤشرين المركبين التابعين لجهات خارجية واللذين اختارت OpenAI تضمينهما، لا يحتل Astra المركز الأول. حيث يضع مؤشر Artificial Analysis Intelligence Index نموذج Claude Fable 5.1 في المرتبة 65.7 مقابل 61.2 لـ Astra. ويضع مؤشر Coding Agent Index نموذج Claude Opus 5 في المرتبة 68.1 مقابل 67.0 لـ Astra. نشرت OpenAI كلا الرقمين، وتُشكر على ذلك، وهما يشكلان التوازن الحقيقي والشفاف مقابل التفوق الوكيلي المذكور أعلاه.
أمر يربك الرواية المتعلقة بالسعر. تتطلب تقديرات التكلفة لكل مهمة من OpenAI في بعض الأحيان تكلفة أقل من Sol على الرغم من معدلات 2.5x، لأن Astra ينهي المهمة في عدد أقل من tokens. يدعي منشور الإطلاق انخفاضاً بنسبة 9% تقريباً في تكلفة API المقدرة لكل مهمة على Terminal-Bench 4.0 مقارنة بـ Sol، ونحو 27% أقل على Terminal-Bench Science عند إعدادات تكلفة أقل، ونحو 43% أقل على BenchCAD. هذه تقديرات OpenAI الخاصة في تكوينات معينة، وليست تجارب مستقلة، ولن تنطبق بالضرورة على حركة البيانات الخاصة بك. ولكنها تعني أن عبارة "أغلى بـ 2.5 ضعف" ليست الملخص الصحيح للأعمال الوكيلة. قِس عدد tokens لكل مهمة مكتملة، وليس السعر لكل token.
قامت TrueFoundry بحسابات نقطة التعادل للتخزين المؤقت على GPT-5.6 عندما أصبحت عمليات كتابة الكاش مدفوعة لأول مرة. وينطبق السؤال نفسه هنا، والإجابة أكثر إثارة للاهتمام مما تبدو عليه.
مضاعفات الكاش في Astra متطابقة مع تلك الخاصة بـ GPT-5.6. تنص وثائق النموذج على أن كتابة الكاش تُحسب بنسبة 1.25x من معدل الإدخال غير المخزن، ومعدل الإدخال المخزن المنشور وهو 1.00$ مقابل معدل إدخال 10.00$ يمثل بالضبط 0.10x. بالتالي:
لنفترض أن w هي حصة الطلبات مقابل بادئة مشتركة (shared prefix) تُمثل عمليات كتابة كاش بدلاً من القراءة. يتحقق تعادل التكلفة للتخزين المؤقت عندما يكون:
1.25w + 0.10(1 - w) = 1
1.15w = 0.90
w = 78.3%
نقطة التعادل هي 78.3%، بدون تغيير عن GPT-5.6. ينلغي P من المعادلة، ولهذا السبب لم تتأثر نقطة التعادل بزيادة السعر بمقدار 2.5 ضعف. يتوقف التخزين المؤقت عن تقديم فائدة مادية فقط عندما تكون أكثر من 78% تقريباً من طلباتك مقابل بادئة معينة عبارة عن عمليات كتابة — أي عندما يصمد سياقك المشترك لأقل من 1.3 طلب في المتوسط قبل أن يتغير أو تنتهي صلاحيته. ولا توجد أي بيئة عمل حقيقية للوكلاء تعمل عند هذا المستوى.
ما تغيره زيادة الأسعار هو حجم الوفر المالي. خذ بادئة مشتركة بحجم 32K-token يُعاد استخدامها عبر جلسة من 25 طلباً — كتابة واحدة، وأربع وعشرون قراءة:
النسبة المئوية متطابقة. لكن المبالغ بالدولار أكبر بـ 2.5 ضعف. كان التخزين المؤقت دائماً أمراً يستحق القيام به؛ وعلى Astra، يتسبب عدم القيام به في تكلفة أكبر بمرتين ونصف.
نمط الفشل يظل دون تغيير أيضاً: السياق الذي يتغير بسرعة (churns fast). إذا كان الوكيل الخاص بك يعيد بناء الموجه الأساسي (system prompt) أو مخطط الأدوات (tool schema) كل بضع جولات، فإنك تدفع 12.50$ لكل مليون لكتابة كاش نادراً ما تقرأه. أصبح هذا خطأً يكلف 12.50$ بدلاً من 5.00$.
نافذة السياق المعلن عنها لـ GPT-6 هي 1,050,000 tokens. لكن الفواتير لا تزيد بشكل متناسب وتدريجي عبر هذه النافذة.
من وثائق النموذج: "الموجهات (Prompts) التي تتجاوز 272K input tokens تُسعر بمعدل 2x للإدخال والكاش و1.5x للإخراج للطلب بالكامل."
اقرأ ذلك بعناية. إنه ينطبق على الطلب بالكامل، وليس على الزيادة عن 272K فقط. وتجاوز الحد لا يكلفك الضعف على tokens الإضافية فحسب؛ بل يكلفك الضعف على جميع الـ tokens.
تؤدي زيادة بنسبة 0.7% في حجم الموجه إلى زيادة بنسبة 101% في فاتورة الإدخال. وتتضاعف القراءات المخزنة مؤقتاً أيضاً، من 1.00$ إلى 2.00$ لكل مليون، ويزيد الإخراج من 50.00$ إلى 75.00$. يتضمن GPT-5.6 Sol القاعدة نفسها، لذا فهذا ليس أمراً جديداً — ولكن بمعدلات Astra أصبحت هذه الفجوة أعلى بـ 2.5 ضعف.
النتيجة العملية: إذا كانت موجهاتك قريبة من 272K، فإن أكبر تحسين للتكلفة متاح لك هو إبقاؤها تحت هذا الحد. تقليل 5K tokens من موجه بحجم 275K يساوي أكثر من أي تغيير في توجيه النماذج (routing change) قد تقوم به.
[SCREENSHOT: OpenAI Platform — usage dashboard showing input, cached input and output token spend by model]
تظهر أربعة أنماط من الفشل بشكل متكرر في الأسابيع الأولى بعد إطلاق أي نموذج رائد، ويحتوي Astra على الأربعة جميعاً.
توجيه كل شيء إلى النموذج الجديد. إن أغلى شيء تفعله الفرق بعد الإطلاق هو توجيه النموذج الافتراضي إليه. عند سعر 10$ للإدخال و50$ للإخراج، فإن استدعاء التصنيف (classification call) الذي يجيب عليه نموذج رخيص بشكل صحيح أصبح يكلف الآن 2.5 ضعف ما كان يكلفه الشهر الماضي دون أي زيادة في الجودة. إن تباين الاختبارات القياسية الموضح أعلاه يدعو لإنشاء أسطول متنوع من النماذج (mixed fleet)، وليس الترحيل الكلي.
الترحيل ليس مجرد تغيير نصي. لا وجود لجهد تفكير none، ولا وجود لـ temperature أو top_p أو logprobs، وتوجيه الأدوات يتطلب Responses API. الكود الذي كان يعمل مع gpt-5.6-sol قد يفشل مع gpt-6-astra بطرق قد لا تكون واضحة حتى يصل إلى بيئة الإنتاج الفعلية.
قد يتسبب مراقبة عدم الاتساق (Misalignment monitoring) في إيقاف طلبك. تجري OpenAI فحصاً غير متزامن على عمل الوكلاء في طلبات Responses API المدعومة. منشور الإطلاق صريح بشأن النتيجة: في ChatGPT أو Codex قد يُطلب منك مراجعة إجراء ما، ولكن "في API، ستتوقف المهمة." تقر OpenAI بأن هذه الفحوصات "قد تقاطع في بعض الأحيان العمل المشروع." هذه خاصية موثوقية جديدة يجب التصميم بناءً عليها، وليست مجرد ملاحظة هامشية.
لا أحد يعرف التكلفة الفعلية حتى تصل الفاتورة. يخبرك السعر لكل token بقليل جداً عندما يستخدم النموذج عدداً مختلفاً من tokens لكل مهمة. بدون إسناد التكلفة لكل طلب ولكل فريق، يظل سؤال "هل Astra أرخص أم أغلى بالنسبة لنا" بلا إجابة.
وجود نموذج رائد أكثر تكلفة لا يضعف الحاجة إلى بوابة (gateway)، بل يعززها، لأن كل قرار توجيه أصبحت قيمته الآن أعلى بـ 2.5 ضعف.
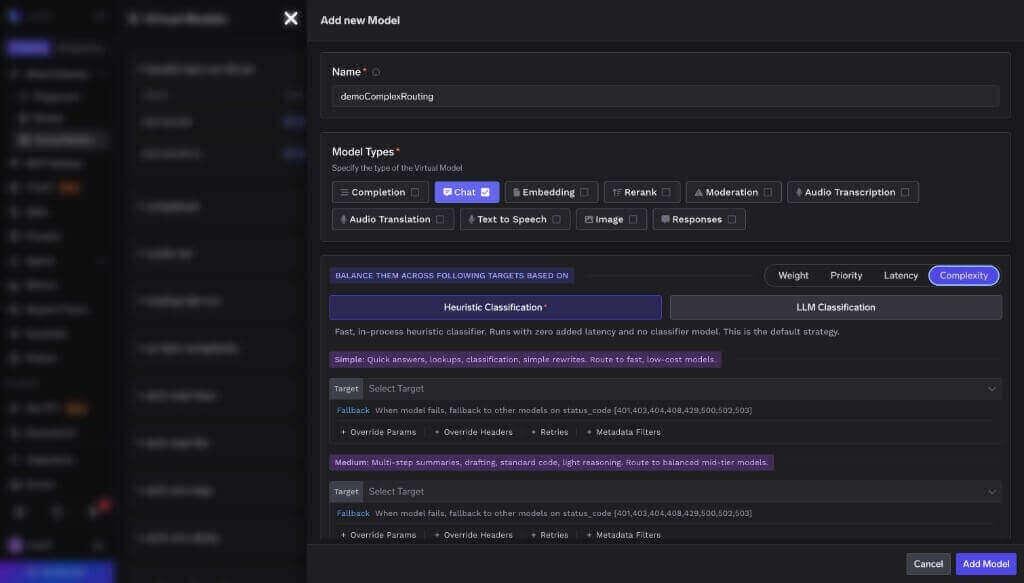
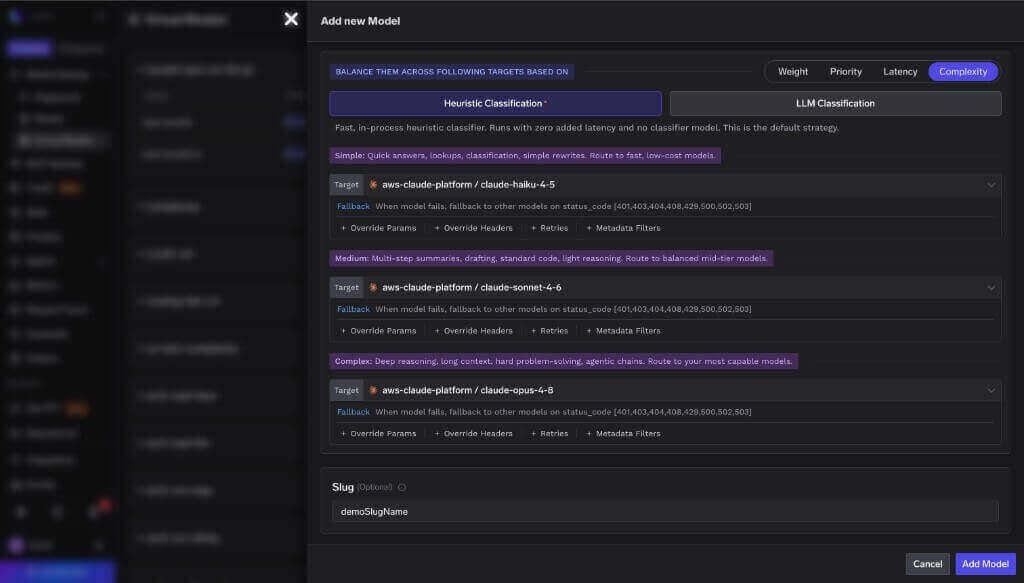
التوجيه حسب التعقيد، وليس حسب العادة. تقوم بوابة الذكاء الاصطناعي (AI Gateway) بتصنيف الطلبات الواردة وإرسال كل منها إلى المستوى المناسب، بحيث تصل الأعمال الوكيلة الصعبة إلى Astra بينما تذهب عمليات الاستخراج والتصنيف والتخليص إلى نماذج أخرى. وفي الاختبار القياسي التلقائي للتوجيه من TrueFoundry عبر 550 موجهاً، خفض تقسيم المستويات التكلفة بنسبة 69% مع الحفاظ على 98% من الجودة الأساسية، مع انخفاض متوسط زمن الانتقال من 7.6 ثوانٍ إلى 4.0 ثوانٍ. وفي حركة البيانات الشبيهة ببيئات الإنتاج، وصلت نسبة الخفض إلى 80%. وهذه النسب المئوية المطبقة على معدلات 10$/50$ تساوي أكثر بكثير مما كانت عليه عند معدلات 4$/20$.
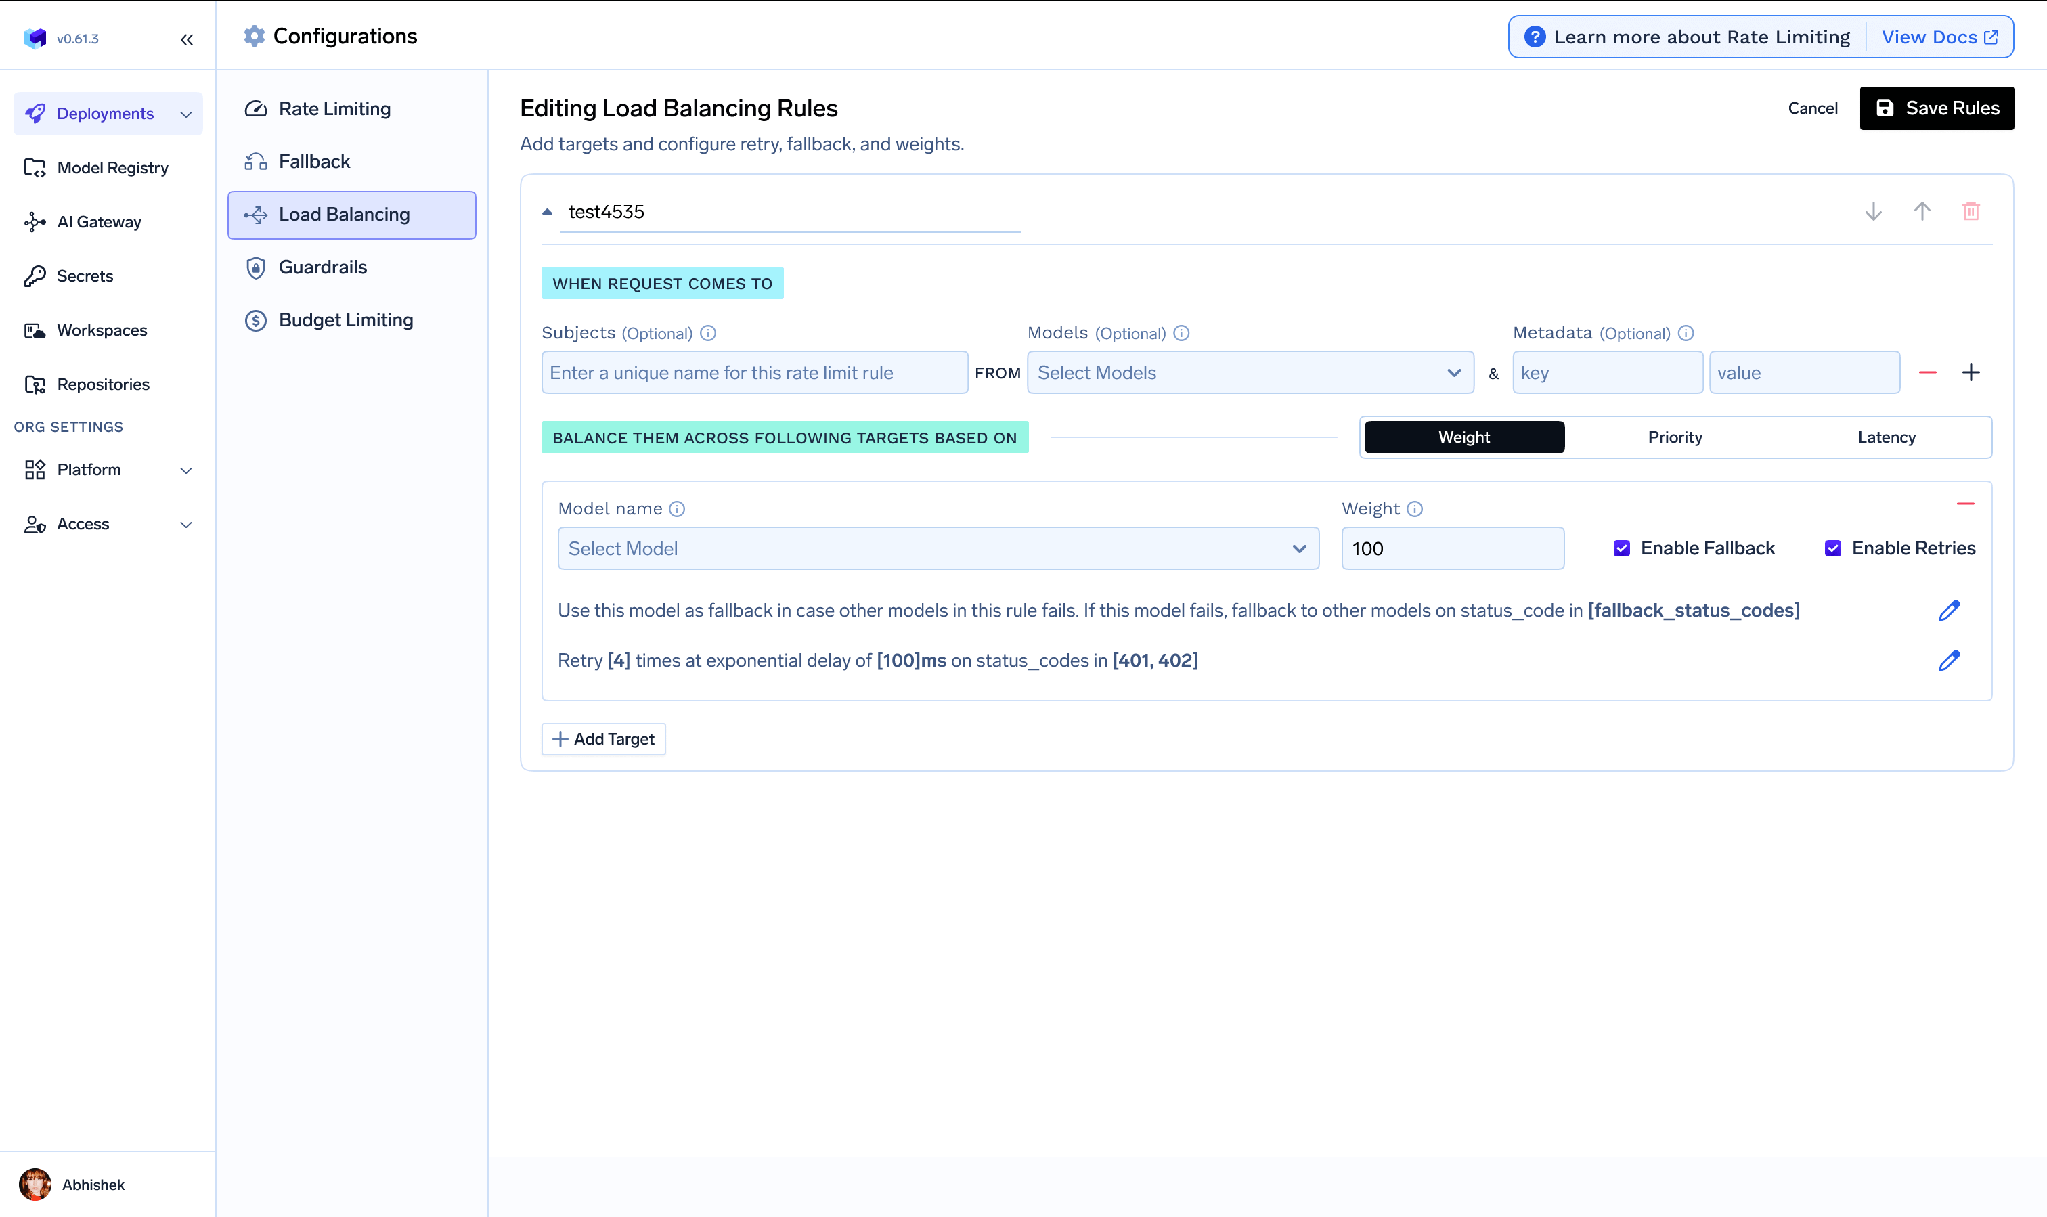
توحيد التخزين المؤقت عبر المزودين. قواعد الكاش في Astra خاصة بـ OpenAI. وتختلف عنها في Anthropic، وتختلف مجدداً في Bedrock. وجود تخزين مؤقت للموجهات مستقل عن المزود (Provider-agnostic prompt caching) على مستوى البوابة يعني أنك تكتب البادئة مرة واحدة وتظل قاعدة 78.3% المذكورة أعلاه صحيحة بغض النظر عن النموذج الذي يختاره الموجه.
قياس التكلفة لكل مهمة، وليس التكلفة لكل token. تعتمد فكرة تسعير Astra بأكملها على كفاءة الـ tokens، ولا يمكنك حسم ذلك من قائمة الأسعار. التكلفة لكل طلب، وعدم الـ tokens، وزمن الانتقال مقسمة حسب الفريق والنموذج هي الطريقة التي تكتشف بها ما إذا كان ادعاء Astra بـ "عدد أقل من tokens لكل مهمة" ينطبق على بيئة عملك.

الحفاظ على مسار دروع حماية (guardrails) موحد عبر النماذج. تعمل دروع الحماية على مستوى البوابة في مسار الطلب والاستجابة بغض النظر عن النموذج الذي يجيب، لذا فإن تغيير التوجيه لا يغير من مستوى الأمان لديك دون أن تشعر.

النسخة المختصرة، اعتباراً من سبتمبر 2026:

نموذج GPT-6 Astra يمثل خطوة حقيقية إلى الأمام في المهام التي صُمم من أجلها. ارتفاع Terminal-Bench 4.0 بمقدار عشرين نقطة، وارتفاع استرجاع السياق الطويل بمقدار اثنتين وعشرين نقطة، وتضاعف AutomationBench لأكثر من الضعف — هذه ليست تحسينات طفيفة. أما في المؤشرات المركبة التابعة لجهات خارجية والتي نشرتها OpenAI بنفسها، فهو ليس المتصدر، وفي أسئلة المعرفة لمرة واحدة (single-shot)، يقل الفارق عن GPT-5.6 Sol لدرجة تقترب من خطأ التقريب.
التسعير يروي نفس القصة المنقسمة. ارتفع كل معدل بمقدار 2.5 ضعف، وهو ما يبدو كزيادة مباشرة حتى تلاحظ أن تقديرات OpenAI الخاصة لكل مهمة تنتهي بتكلفة أقل من Sol في العديد من الاختبارات الوكيلة القياسية لأن Astra ينهي المهام في عدد أقل من tokens. كلا الأمرين يمكن أن يكون صحيحاً. وأيهما ينطبق عليك هو سؤال عملي يعتمد على حركة البيانات الخاصة بك، والطريقة الوحيدة للإجابة عنه هي تشغيل الاثنين وقراءة التكلفة لكل مهمة مكتملة.
هناك أمران لا يحتاجان إلى قياس. التخزين المؤقت لا يزال مجدياً عند نفس نقطة التعادل البالغة 78.3% التي كان عليها في GPT-5.6، فإذا كنت تستخدم التخزين المؤقت اليوم، فاستمر في استخدامه. كما أن حد 272K الفاصل في الفواتير هو دالة قفزية ستضاعف فاتورة الإدخال بهدوء لموجه زاد بحجم بضعة آلاف من tokens فقط.
لذا فإن الأمر يعتمد على ما تريد إدارته. إذا كنت تريد نموذجاً واحداً وفاتورة بسيطة، فوجه كل شيء إلى Astra وتقبّل أنك تدفع مبالغ إضافية للنصف السهل من حركة البيانات لديك. أما إذا كنت تفضل إرسال المهام الصعبة إلى النموذج التنافسي الرائد وكل شيء آخر إلى خيار أرخص، فهذا يتطلب طبقة توجيه (routing layer) — وعند 10$ للإدخال و50$ للإخراج، أصبحت الحسابات الاقتصادية لبناء هذه الطبقة أكثر إقناعاً بمرتين ونصف.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



GPT-6 Astra هو النموذج الأحدث والأكثر تقدماً من OpenAI، صدر في 3 سبتمبر 2026 ويمكن استدعاؤه في API باسم gpt-6-astra. وهو متاح عبر OpenAI API وMicrosoft Azure وAWS Bedrock، ولمستخدمي ChatGPT Plus وPro وBusiness وEnterprise.
حتى سبتمبر 2026، لكل مليون رمز: 10.00 دولارات للإدخال، و1.00 دولار للإدخال المخزَّن مؤقتاً، و12.50 دولاراً للكتابة في الذاكرة المؤقتة، و50.00 دولاراً للإخراج. وتبلغ أسعار Batch وFlex 50% من هذه الأسعار، أما وضع Fast فبضعفها. والطلبات التي تتجاوز 272K رمز إدخال تُحتسب بضعف أسعار الإدخال والذاكرة المؤقتة وبمرة ونصف سعر الإخراج للطلب كله.
1,050,000 رمز، مع حد أقصى للإخراج يبلغ 128,000 رمز. وكلاهما مطابق لـ GPT-5.6 Sol. والحد العملي تجاري لا تقني: بعد 272K رمز إدخال يُحتسب الطلب كله بضعف سعر الإدخال.
يعتمد ذلك كلياً على طبيعة المهمة. في أعمال الوكلاء طويلة المدى المكاسب كبيرة، إذ يرتفع Terminal-Bench 4.0 من 37.3% إلى 57.9%. أما في أسئلة المعرفة ذات الإجابة الواحدة فهي هامشية، وأنت تدفع مقابلها 2.5 ضعف لكل رمز. وجّه الطلبات وفقاً لذلك بدلاً من الانتقال الكامل دفعة واحدة.
نعم، وبالهامش نفسه. تكلفة الكتابة في الذاكرة المؤقتة 1.25 ضعف سعر الإدخال وتكلفة القراءة 0.10 ضعف، تماماً كما في GPT-5.6، ولذلك تقع نقطة التعادل عند نسبة كتابة تبلغ 78.3% في الحالتين. والأسعار المعلنة الأعلى ترفع قيمة التوفير المطلقة لا العتبة.
تضيف بوابة AI Gateway من TrueFoundry نحو 3 إلى 4 مللي ثانية وتتحمل أكثر من 350 طلباً في الثانية على وحدة vCPU واحدة، وهو مقدار لا يُذكر مقارنةً بأزمنة توليد تبلغ عدة ثوانٍ.



أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد



















