November 5, 2025
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.



Blazingly fast way to build, track and deploy your models!
ليس من قبيل المبالغة القول إن كل شركة تحتاج إلى التعامل مع حركة مرور أعلى، ومباشرة المزيد من البيانات، ودعم عدد أكبر من العملاء مع نموها. وغالبًا ما تحتاج إلى توسيع بنيتها التحتية لمواكبة هذه المتطلبات المتزايدة. ينطبق هذا أيضًا إذا كانت أعمالك تتأثر بالمواسم. تخيل موقعًا للتجارة الإلكترونية يشهد حركة مرور كثيفة خلال العطلات، مثل Black Friday أو Cyber Monday. قد تزداد حركة المرور على الموقع بشكل هائل خلال هذه الأوقات المزدحمة. وقد يواجه الموقع مشكلات في تأخر تحميل الصفحات وإزعاج المستخدمين إذا لم يستطع التعامل مع الطلب الزائد. نتيجة لذلك، قد تواجه الشركة خسارة في المبيعات وتدهورًا في سمعتها.
إحدى الطرق لمعالجة هذه المشكلة هي زيادة عدد خوادم البنية التحتية يدويًا للتعامل مع حركة المرور الزائدة. ومع ذلك، فإن التوسيع والتقليص اليدوي قد يستغرق وقتًا طويلاً، ويكون عرضة للأخطاء، وصعب الإدارة. هنا يأتي دور التوسيع التلقائي للمجموعات (cluster autoscaling). يقوم cluster autoscaling بضبط عدد الخوادم في البنية التحتية تلقائيًا بناءً على شروط معينة، مثل استخدام CPU، أو استخدام الذاكرة، أو الطلبات الواردة. هذا يعني أن البنية التحتية يمكنها التوسع أو التقلص بناءً على الطلب الحالي دون تدخل يدوي.
ستستكشف هذه المقالة ماهية cluster autoscaling، ولماذا نحتاجه، وكيف يمكن تطبيقه لدى مختلف مزودي الخدمات السحابية.
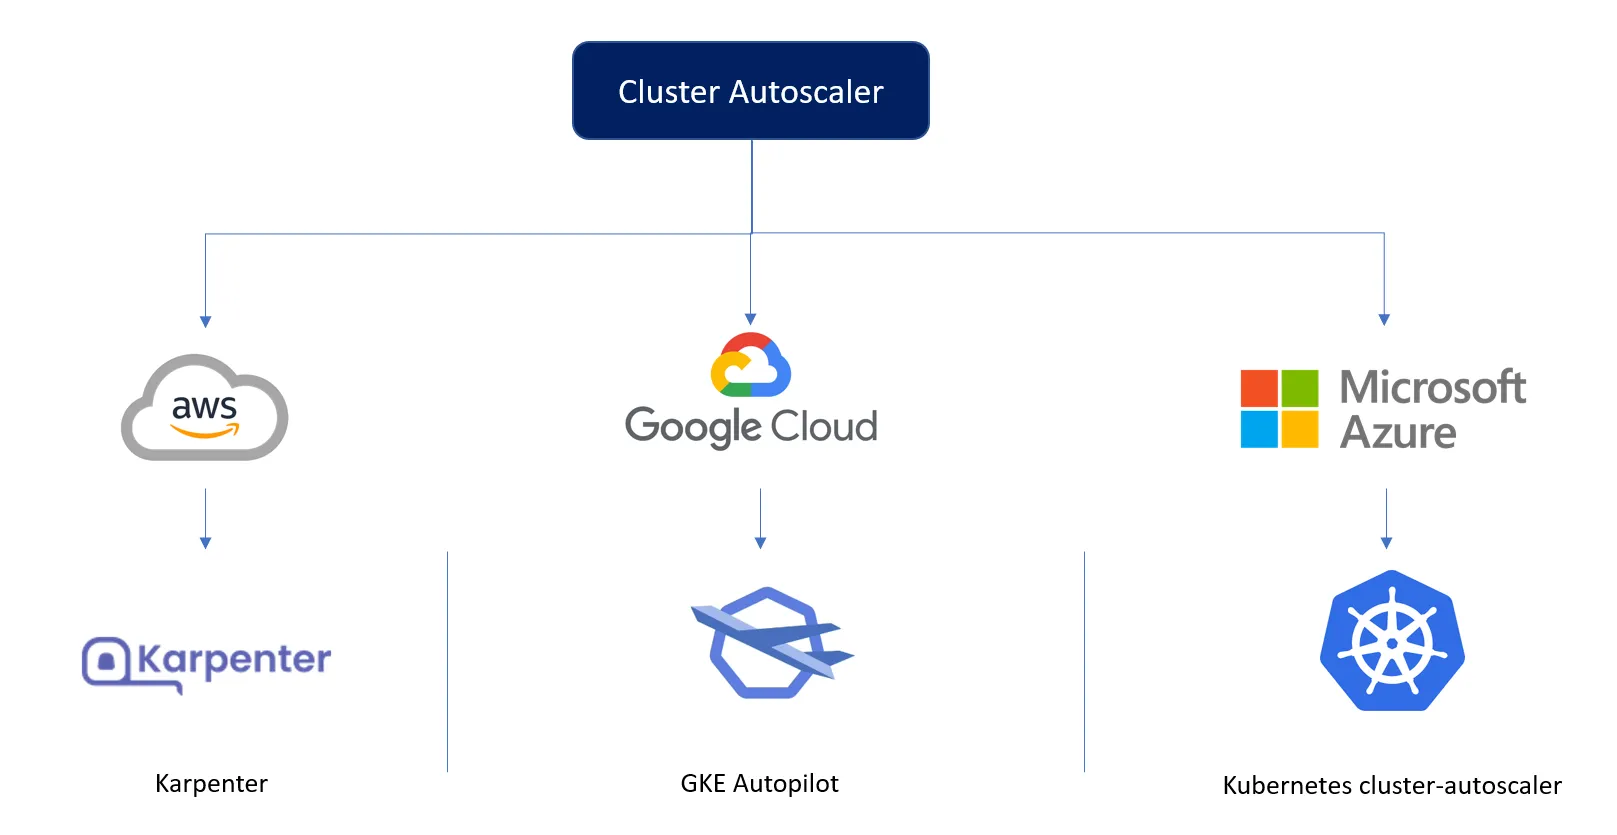
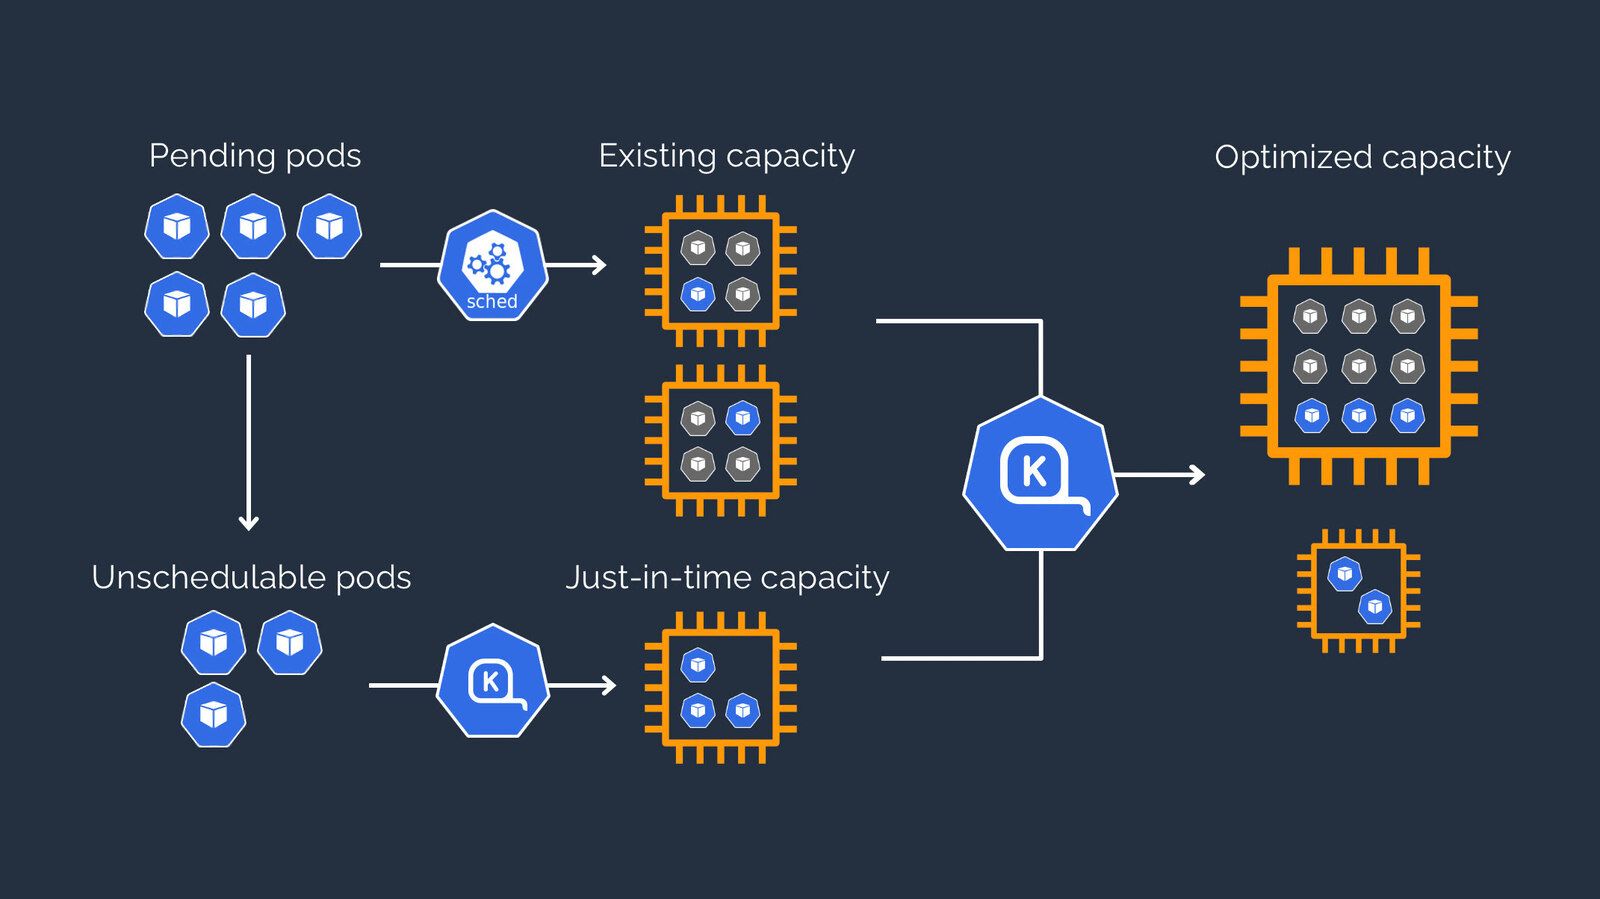
من أجل ضمان عمل المجموعة (cluster) لدينا بشكل صحيح على جميع مزودي الخدمات السحابية الرئيسيين، يتعين علينا تكييف طريقة توسيع العقد (nodes) في المجموعة.
💡
على AWS، نستخدم Karpenter، الذي يمكنه مع الحد الأدنى من التكوين اختياري العقدة الأرخص والأكثر كفاءة لطلبات pod الواردة.
💡
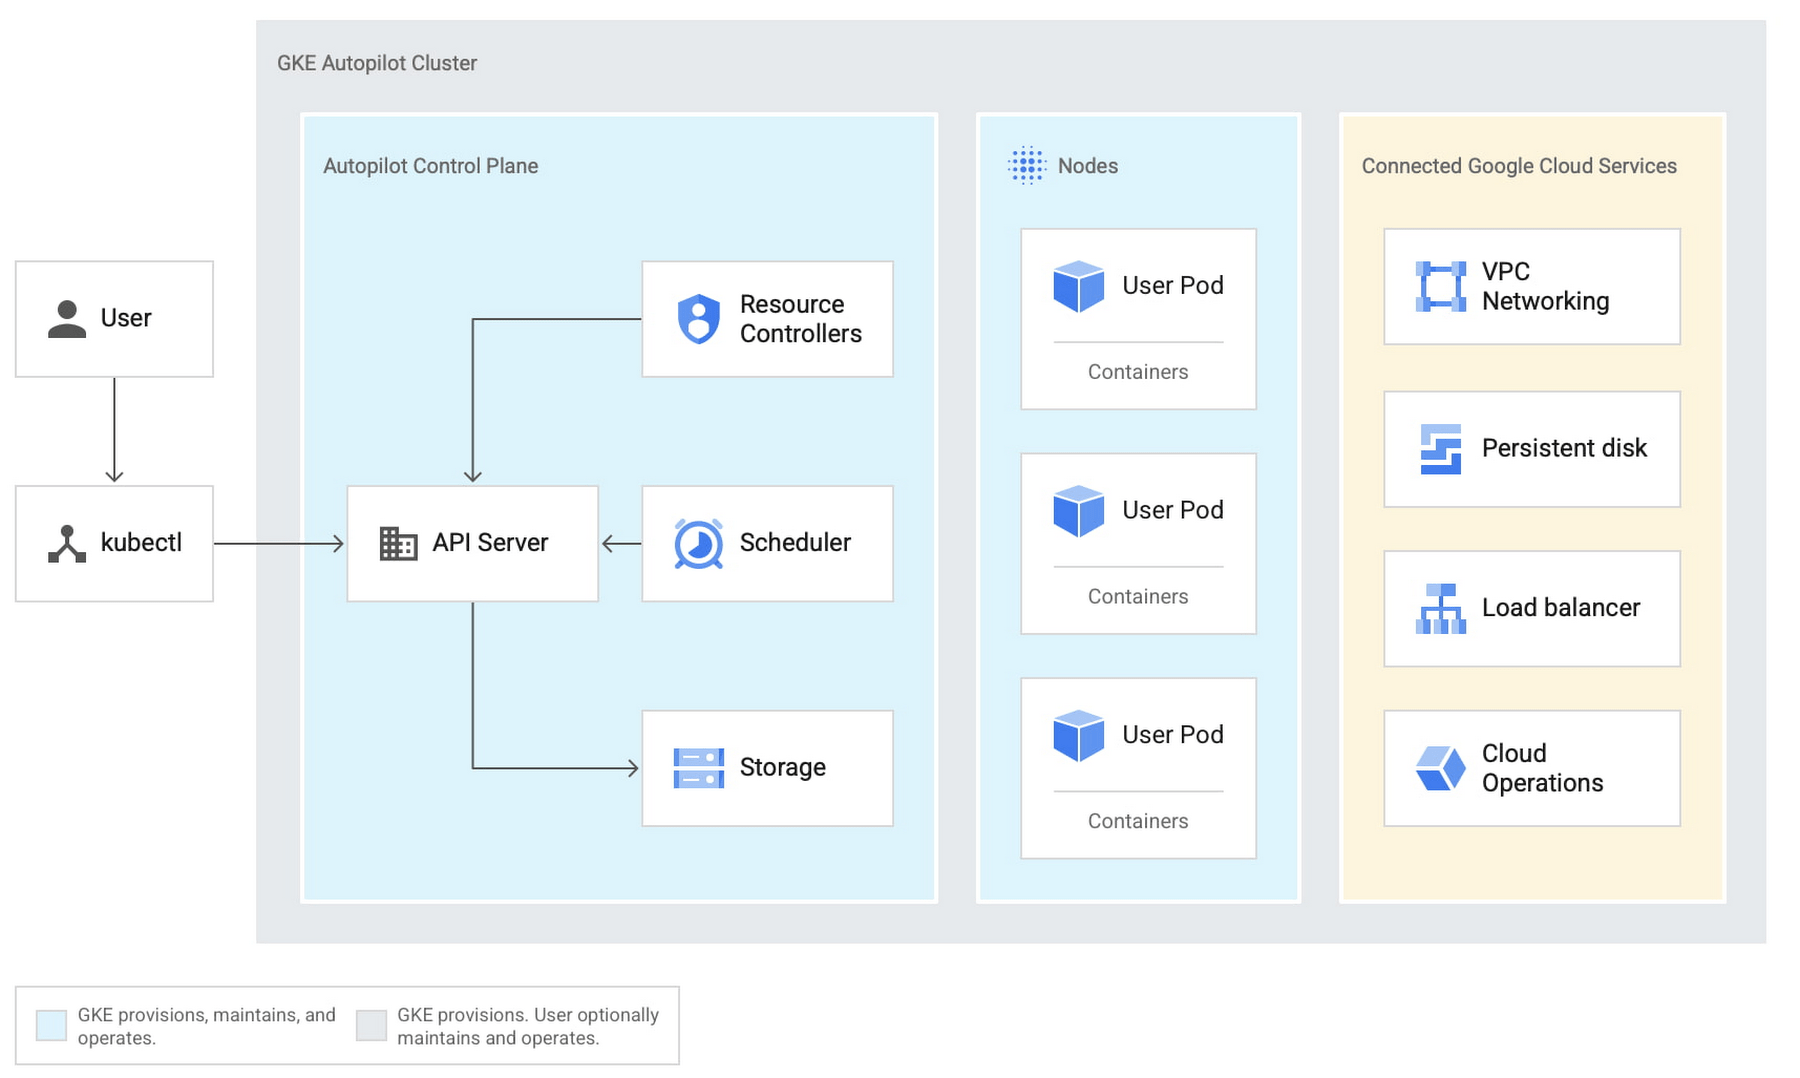
على GCP، نعتمد على GKE Autopilot، الذي يوفر لنا مجموعة مدارة قادرة على التوسع والتقليص اعتمادًا على الطلبات.
💡
لا توجد حلول مخصصة على Azure، ونحن نستخدم Kubernetes cluster-autoscaler، وهو أقل تحسينًا من Karpenter ويتطلب تكوينًا أكثر من autopilot.
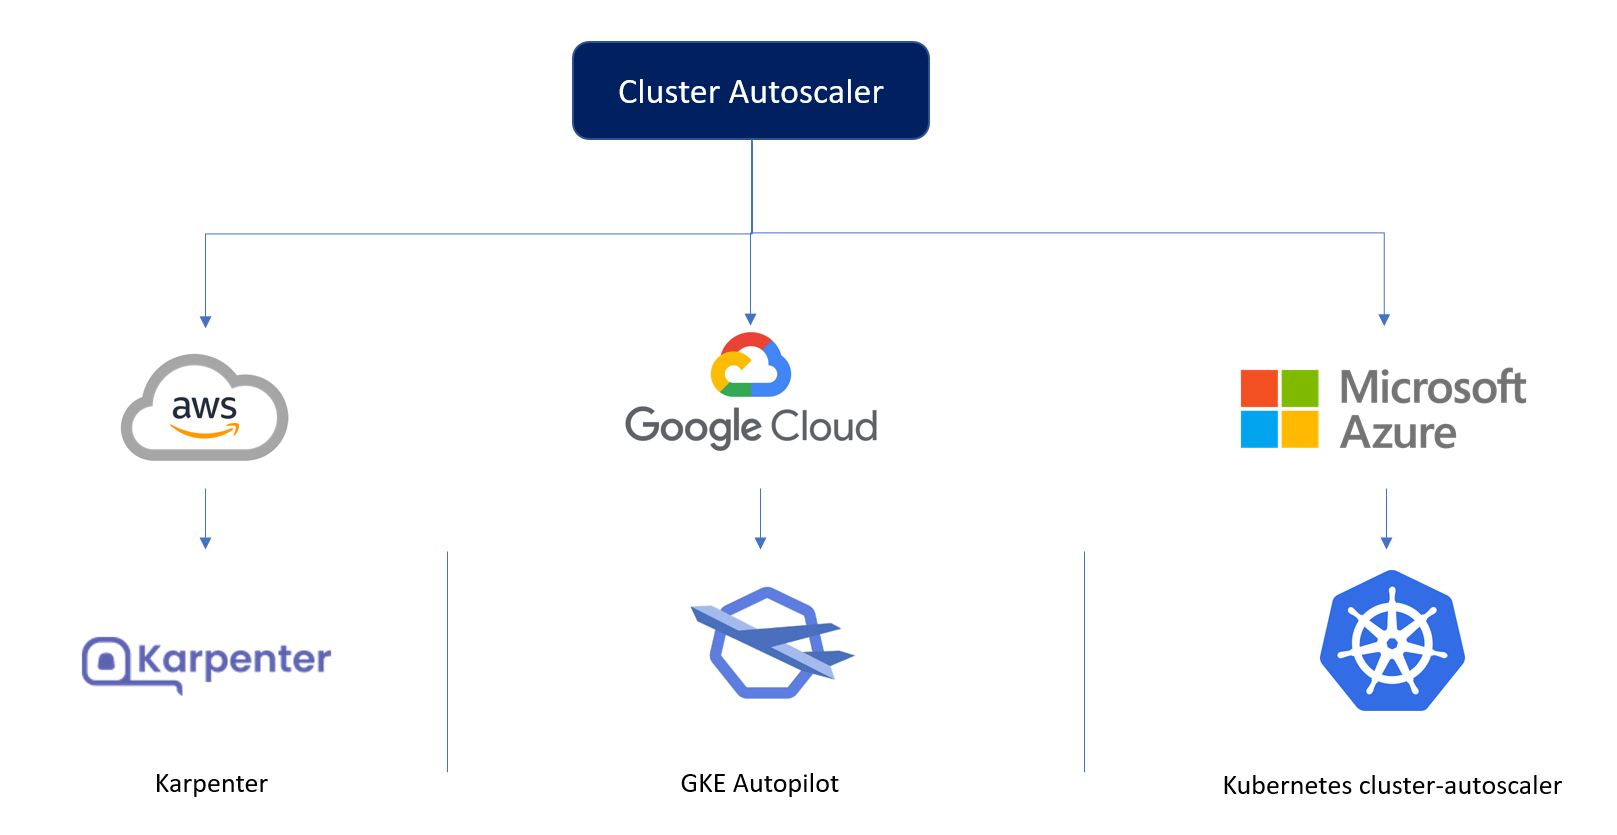
يراقب Karpenter إجمالي طلبات الموارد الخاصة بـ pods غير المجدولة ويتخذ قرارات لتشغيل العقد وإنهائها لتقليل زمن تأخير التجدول وتكاليف البنية التحتية.
ولكن لسوء الحظ، يعمل Karpenter على AWS فقط.
Autopilot هو خدمة مدارة تستخدم خوارزميات تعلم الآلة لتحديد العدد الأمثل للعقد للمجموعة بناءً على حمل العمل الحالي. كما يوفر ميزات مثل الترقيات والإصلاحات التلقائية، مما يسهل الحفاظ على أمان المجموعات مع دعم cloud scalability.
بالإضافة إلى التوسيع التلقائي، يوفر Cluster Autopilot أيضًا مزايا أخرى، مثل تحسين استخدام الموارد وتوفير التكاليف عن طريق تجنب التخصيص المفرط للموارد. كما يقدم نهجًا يتطلب تدخلًا أقل في إدارة المجموعات، حيث تتعامل الخدمة مع جميع عمليات التوسيع التلقائي.
لا يوجد عرض مداد على سحابة Azure مثل GKE Autopilot أو نهج مخصص للتوسيع التلقائي مثل Karpenter؛ لذلك نعتمد على cluster-autoscaler.
Kubernetes Cluster Autoscaler هو أداة مفتوحة المصدر تمكّن التوسيع التلقائي لمجموعات Kubernetes. يعمل كـ pod داخل المجموعة ويراقب استخدام الموارد فيها، مع تعديل عدد العقد اللازمة لتلبية احتياجات التطبيقات التي تعمل بداخلها. يساعد هذا في تحسين استخدام الموارد وتقليل التكاليف عن طريق تجنب التخصيص المفرط للموارد عندما يكون الطلب منخفضًا. يتطلب Cluster Autoscaler تكوينًا يدويًا لأنواع مجموعات العقد (node groups).
تغطي هذه المقالة تفاصيل حول Kubernetes Autoscaling.
تعد TrueFoundry منصة PaaS لنشر ML فوق Kubernetes لتسريع مسارات عمل المطورين مع منحهم مرونة كاملة في اختبار النماذج ونشرها، مع ضمان الأمان والتحكم الكامل لفريق البنية التحتية. من خلال منصتنا، نمكّن فرق تعلم الآلة من نشر ومراقبة النماذج في 15 دقيقة بموثوقية وقابلية توسع بنسبة 100%، مع القدرة على التراجع في ثوانٍ - مما يتيح لهم توفير التكاليف وإطلاق النماذج إلى البيئة الإنتاجية بشكل أسرع، وتحقيق قيمة تجارية حقيقية.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد