احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.
٩.٩
بناء تطبيق RAG باستخدام TrueFoundry وMongoDB Atlas
Updated: November 3, 2026
Published: July 2, 2026
Built for Speed: ~10ms Latency, Even Under Load
Blazingly fast way to build, track and deploy your models!
Handles 350+ RPS on just 1 vCPU — no tuning needed
يجمع توليد النصوص المعزز بالاسترجاع (RAG) بين نقاط قوة أنظمة الاسترجاع والنماذج التوليدية لإنتاج مخرجات عالية الصلة ومدركة للسياق. فهو يستعلم من مصادر المعرفة الخارجية—مثل قواعد البيانات أو الفهارس البحثية—لاسترجاع المعلومات ذات الصلة، والتي يتم صقلها بعد ذلك بواسطة نموذج توليدي.
لماذا RAG؟
مخرجات عالية الصلة ومدركة للسياق.
من خلال دمج المعرفة الديناميكية والمحدثة، تتغلب أنظمة RAG على قيود التدريب المسبق الثابت في النماذج التوليدية، مما يجعلها فعالة للغاية لتطبيقات مثل الإجابة عن الأسئلة، والمهام الكثيفة المعرفة، وإنشاء المحتوى المخصص.
تسمح الطبيعة الموديلارية (النمطية) لـ RAG بتحسين كل من مرحلتي الاسترجاع والتوليد، مما يمنح مرونة وقابلية للتوسع أكبر في تصميم النظام.
Cognita من TrueFoundry: تبسيط RAG للتطبيقات القابلة للتوسع
على الرغم من إمكانياته، إلا أن تطبيق RAG قد يكون معقدًا، حيث يتضمن اختيار النماذج، وتنظيم البيانات، واتباع أفضل الممارسات. تبسط الأدوات الحالية إنشاء النماذج الأولية ولكنها تفتقر إلى قالب مفتوح المصدر للنشر القابل للتوسع—وهنا يأتي دور Cognita.
إن Cognita هو إطار عمل RAG مفتوح المصدر يبسط بناء ونشر التطبيقات القابلة للتوسع. من خلال تقسيم RAG إلى خطوات موديلارية، فإنه يضمن سهولة الصيانة، والتوافقية مع أدوات AI الأخرى، والتخصيص، والامتثال. يوازن Cognita بين القابلية للتكيف وسهولة الاستخدام مع الحفاظ على القابلية للتوسع للتطورات المستقبلية.
مزايا Cognita
مستودع مركزي قابل لإعادة الاستخدام للمحللات (parsers)، والمحملات (loaders)، وأدوات تضمين المتجهات (embedders)، وأدوات الاسترجاع (retrievers).
إمكانية تفاعل المستخدمين غير التقنيين مع UI—تحميل المستندات وإجراء QnA باستخدام وحدات مصممة من قبل فريق التطوير.
يعتمد بالكامل على API—مما يسمح بالتكامل مع الأنظمة الأخرى.
نماذج اللغات الكبيرة (LLMs) للتفاعل السهل مع النماذج التوليدية مثل GPT من OpenAI، أو نماذج Hugging Face، أو غيرها من LLM APIs.
تكاملات مسبقة البناء للاتصال بسهولة بـ Pinecone، أو Weaviate، أو ChromaDB، أو MongoDB Atlas Vector Search.
يمكن أن يكون استخدام MongoDB كقاعدة بيانات متجهة لتطبيق توليد النصوص المعزز بالاسترجاع (RAG) مفيدًا بناءً على متطلباتك. إليك سبب كون MongoDB خيارًا جيدًا:
1. دعم أصلية لـ Vector Search
يدعم MongoDB فهرسة المتجهات من خلال Atlas Vector Search الخاص به. يتفق هذا مع إجراء عمليات بحث عن التشابه بكفاءة على البيانات عالية الأبعاد، وهو أمر محوري لسير عمل RAG. المزايا الرئيسية:
التكامل مع لغة استعلام MongoDB: يجمع بين البحث المتجهي والاستعلامات التقليدية، مما يسمح بتكوين استعلامات أكثر مرونة وقوة.
بحث عالي الأداء: يستخدم خوارزميات الجار الأقرب التقريبي (ANN) مثل HNSW (Hierarchical Navigable Small World) لاسترجاع المتجهات بشكل سريع وقابل للتوسع.
2. إدارة بيانات موحدة
غالباً ما تتطلب تطبيقات RAG إدارة كل من البيانات غير الهيكلية (مثل النصوص والتضمينات) والبيانات الهيكلية (مثل البيانات الوصفية وتفضيلات المستخدم).
يتيح لك MongoDB، بصفته قاعدة بيانات مستندات، تخزين التضمينات جنباً إلى جنب مع البيانات الوصفية المرتبطة بها في سجل واحد. على سبيل المثال:
هذا يجنبك تعقيد إدارة التضمينات في نظام منفصل.
3. المرونة والقابلية للتوسع
تصميم بدون مخطط محدد (Schema-less): تجعل مرونة مخطط MongoDB من السهل التكرار والتعديل على نموذج البيانات الخاص بك مع تطور تطبيق RAG.
التوسع الأفقي: يدعم MongoDB تجزئة قاعدة البيانات (sharding) لتوزيع البيانات عبر خوادم متعددة، مما يساعد التطبيقات على التعامل مع مجموعات البيانات الكبيرة والتوسع مع نموها.
ميزات سحابية أصلية: يوفر MongoDB Atlas خدمات مدارة بالكامل، بما في ذلك التوسع، والنسخ الاحتياطي، والمراقبة.
قبل بدء الخدمات، نحتاج إلى تهيئة مزودي النماذج الذين سنحتاجهم للتضمين وإنشاء الإجابات. للبدء، قم بنسخ models_config.sample.yaml إلى models_config.yaml.
cp models_config.sample.yaml models_config.yaml
أنشئ مجموعة (collection) في قاعدة بيانات mongo db التي تم إنشاؤها حديثًا، وليكن اسمها "cognita". هذه هي الـ collection التي سيتم فيها تخزين جميع الأجزاء (chunks) واستخدامها في عملية الاسترجاع.
يستخدم ملف compose ملف compose.env لمتغيرات البيئة. يمكنك تعديله حسب احتياجاتك.
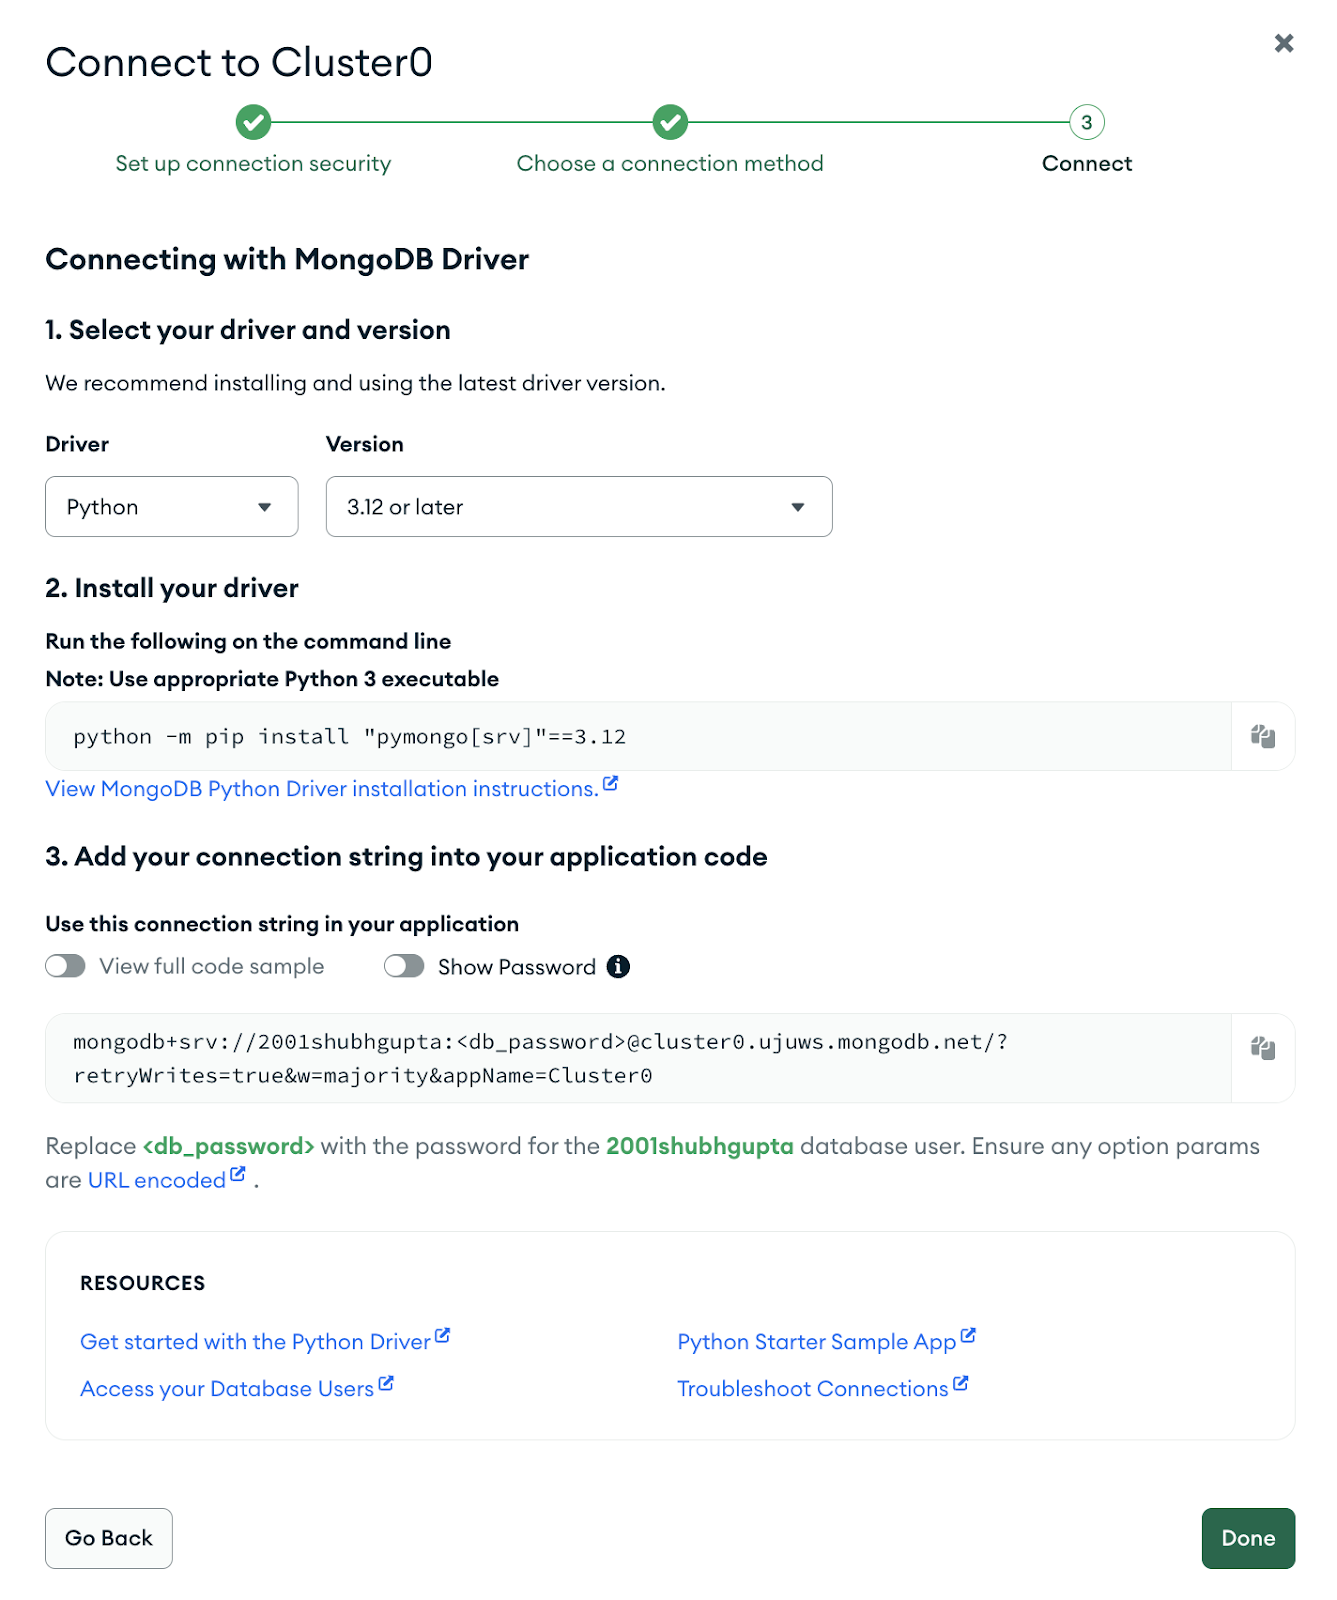
قم بتعديل مفتاح "VECTOR_DB_CONFIG" في ملف البيئة. سيتم استخدام هذا التكوين في عملية التمهيد لضمان استخدام MongoDB كمتجر متجهات طوال وقت التشغيل. سيتم استخدام connection string لـ mongo DB هنا. فيما يلي مثال على كيفية ظهور ذلك:
بشكل افتراضي، يحتوي التكوين على مزودين محليين مفعّلين يتطلبون تشغيل خادم infinity وollama لتشغيل التضمين وLLMs محليًا. ومع ذلك، إذا كان لديك مفتاح OpenAI API Key، يمكنك إلغاء التعليق عن مزود openai في models_config.yaml وتحديث OPENAI_API_KEY في compose.env. الآن، يمكنك تشغيل الأمر التالي لبدء الخدمات:
docker-compose --env-file compose.env --profile ollama --profile infinity up
cognita-backend - يُستخدم لبدء خادم خلفية FastAPI لـ Cognita.
cognita-frontend - يُستخدم لبدء الواجهة الأمامية لـ Cognita.
بمجرد تشغيل الخدمات، يمكنك الوصول إلى الواجهة الأمامية عبر http://localhost:5001.
الخطوة 3: إعداد مجموعة بيانات في Cognita
بمجرد إعداد cognita، ستوضح الخطوات التالية كيفية استخدام UI للاستعلام عن المستندات:
1. إنشاء مصدر بيانات (Data Source)
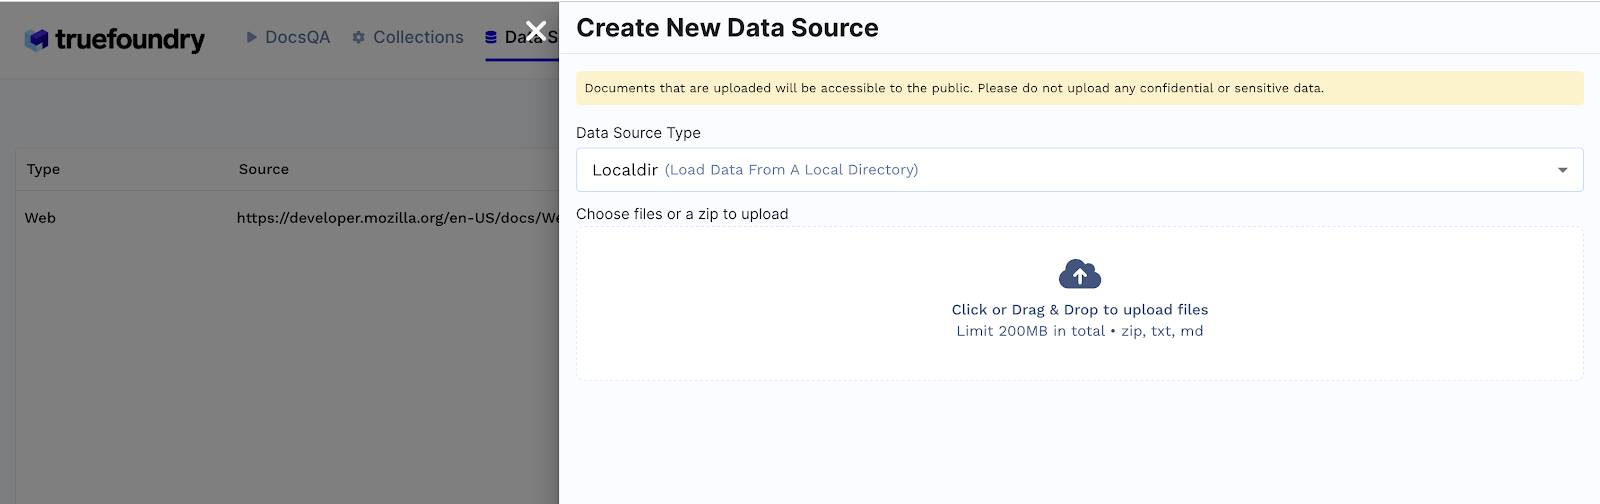
انقر على علامة التبويب Data Sources
انقر على + New Datasource
يمكن أن يكون نوع مصدر البيانات إما ملفات من الدليل المحلي، أو رابط web url، أو رابط github url، أو تقديم FQN لـ Truefoundry artifact. مثال: إذا تم تحديد Localdir، قم بتحميل الملفات من جهازك وانقر على Submit.
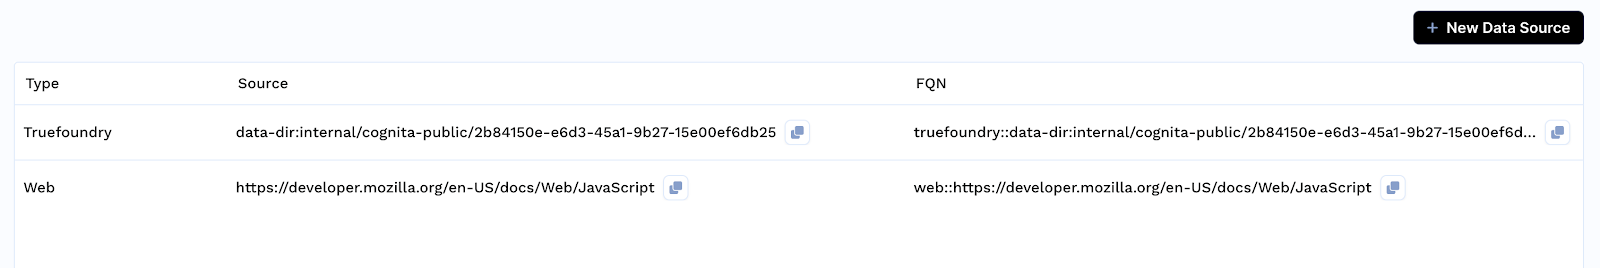
ستكون قائمة مصادر البيانات المنشأة متاحة في علامة التبويب Data Sources.
2. إنشاء مجموعة (Collection)
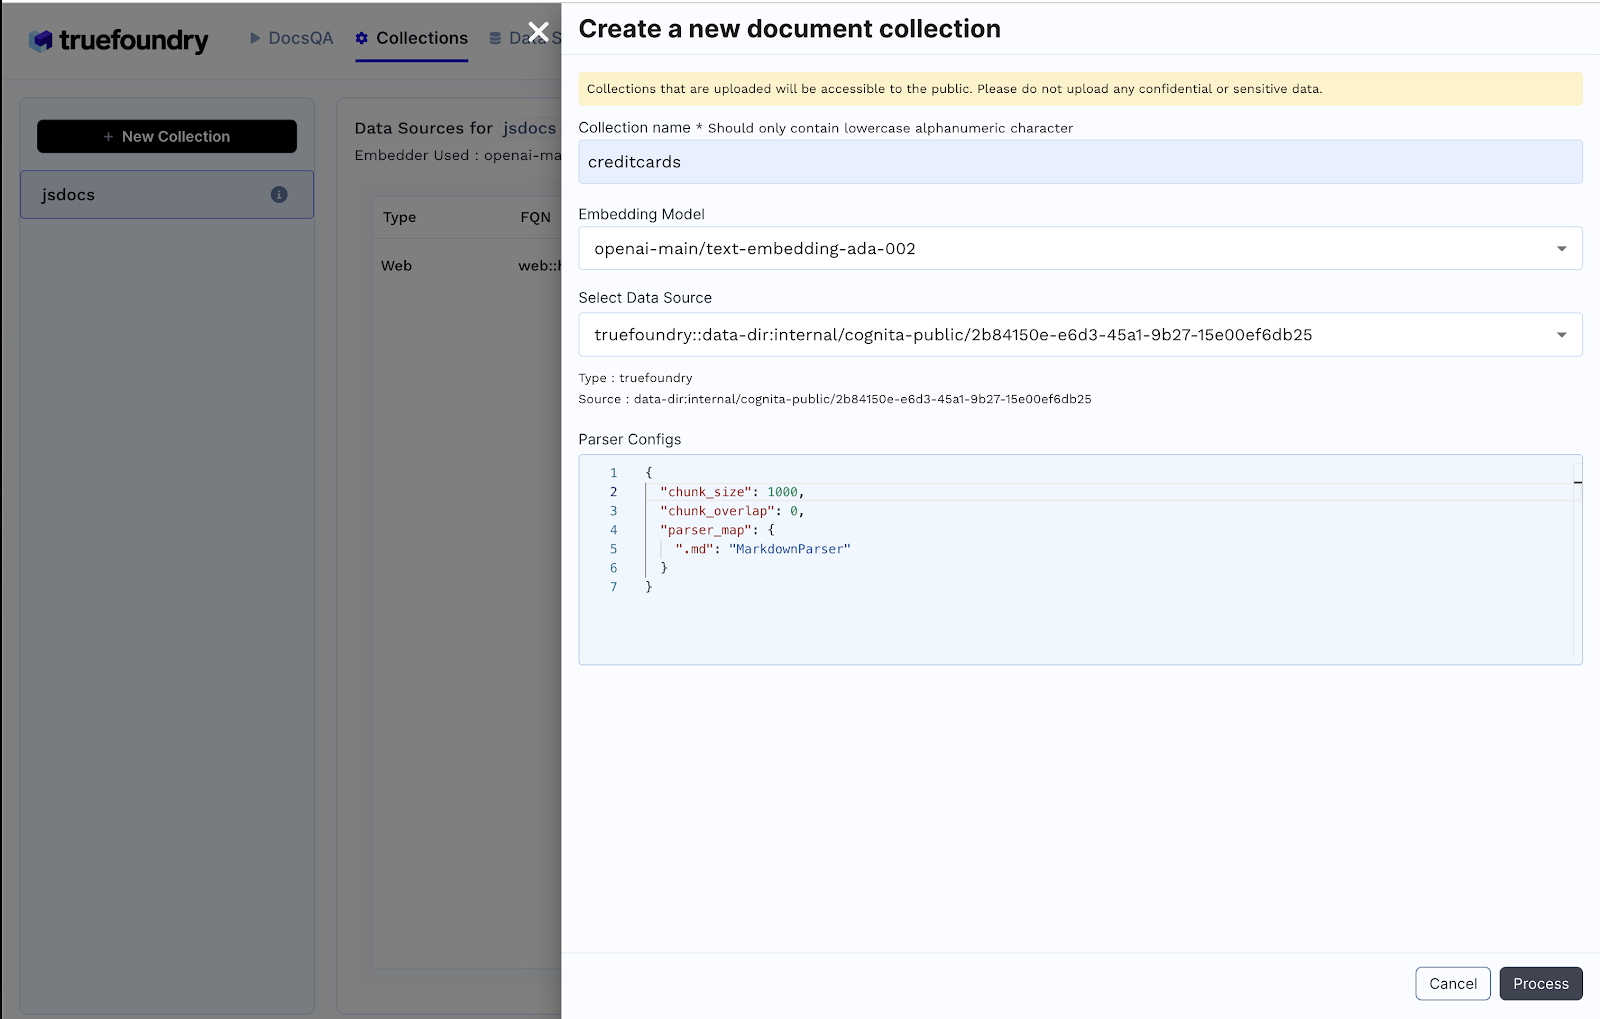
انقر على علامة التبويب Collections
انقر على + New Collection
أدخل اسم المجموعة (Collection Name)
حدد نموذج التضمين (Embedding Model)
أضف مصدر البيانات المنشأ سابقًا والتكوين اللازم
انقر على Process لإنشاء المجموعة وفهرسة البيانات
3. عند إنشاء مجموعة جديدة، إليك ما يحدث خلف الكواليس
إنشاء مجموعة جديدة في قاعدة بيانات MongoDB المهيأة. على سبيل المثال، إذا كان اسم قاعدة البيانات هو `cognita`، فإن هذه الخطوة تنشئ مجموعة بالإدخال المحدد في قاعدة بيانات cognita في mondo db.
عند إنشاء مجموعة، يتم إنشاء فهرس بحث متجهات (vector search index) باستخدام مقتطف الكود التالي:
هذا يضمن أن المجموعة المنشأة حديثًا جاهزة لاستعلامات البحث المتجهي. يرجى ملاحظة أن إنشاء فهرس على MongoDB قد يستغرق ما يصل إلى دقيقة واحدة.
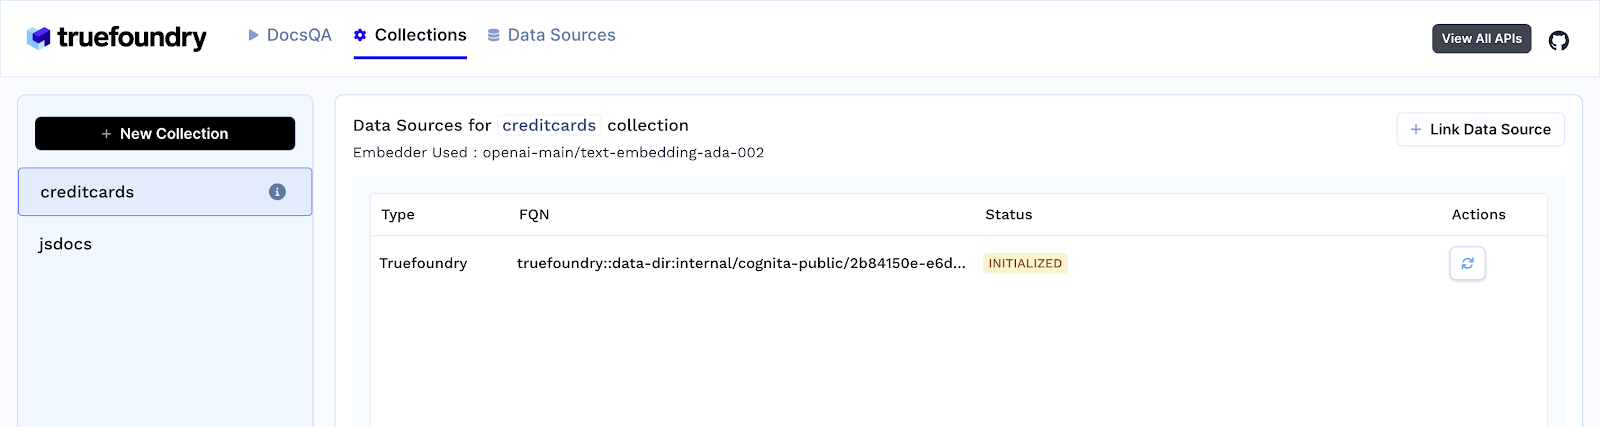
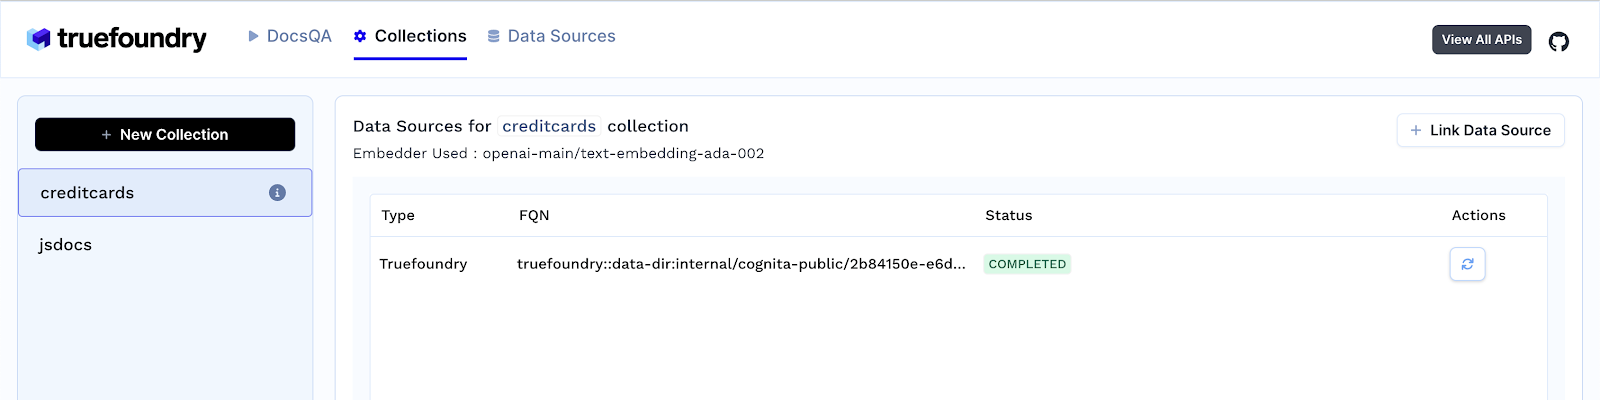
4. بمجرد إنشاء المجموعة، تبدأ عملية استيعاب البيانات (data ingestion)، ويمكنك عرض حالتها عن طريق تحديد مجموعتك في علامة التبويب collections. هذه الخطوة مسؤولة عن تحليل ملفاتك، وتقسيمها إلى أجزاء (chunking)، وإضافتها إلى MongoDB الخاص بك. يمكنك أيضًا إضافة مصادر بيانات إضافية لاحقًا وفهرستها في المجموعة. انتقل إلى الخطوة التالية بمجرد أن تصبح الحالة "Completed".
الخطوة 4: العثور على التكوين المناسب لتطبيقك
في علامة التبويب DocsQA، استخدم بيئة تجربة Cognita (playground) للتجريب بإعدادات مختلفة لمعرفة ما يعمل بشكل أفضل لتطبيقك. يمكنك تجربة مختلف:
تقنيات الاسترجاع
نماذج LLM، ودرجات الحرارة (temperatures)، وما إلى ذلك.
مطالبات (prompts) LLM
نماذج التضمين
أياً كان الإعداد الذي يعمل بشكل أفضل لتطبيقك، اضغط على "Create Application" وستتم محاذاة بنية وDeploy لنقطة نهاية API لتطبيقك. يمكنك الذهاب إلى علامة التبويب "Applications" لرؤية جميع تطبيقاتك المنشورة.
الخاتمة
أوضح هذا البرنامج التعليمي كيفية بناء تطبيق RAG جاهز للإنتاج باستخدام Cognita وMongoDB في 10 دقائق فقط. يقدم التآزر بين قابلية Cognita للتكيف وسهولة استخدامها مع نموذج المستندات المرن لـ MongoDB والمدعوم بـ vector search أساسًا متينًا لإنشاء تطبيقات AI متقدمة.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.