November 16, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.


Blazingly fast way to build, track and deploy your models!
في أوائل العقد الأول من القرن الحادي والعشرين، اصطدمت ثورة الخدمات المصغرة (microservices) بحائط سدود. لقد قمنا بتفكيك أنظمتنا الأحادية (monoliths) إلى مئات الخدمات، لكننا لم نتفق على كيفية تواصلها معًا. استخدمت بعض الفرق REST، واستخدمت فرق أخرى XML-RPC، واستخدمت غيرها TCP الخام. وكانت النتيجة "برج بابل"—منظومة مجزأة كان التكامُل فيها مؤلمًا وكانت الإمكانية على المراقبة (observability) مستحيلة.
قام القطاع بحل هذه المشكلة من خلال التوحيد القياسي: gRPC لطبقة النقل (transport)، وProtobuf للبنية (schema)، وOpenTelemetry للمراقبة (observability).
اليوم، تمر منظومة Agentic AI بنفس الفوضى التي سبقت التوحيد القياسي تمامًا.
لا يمكن لـ agents هؤلاء التعاون بطريقة طبيعية أصلية. فهم يمتلكون تمثيلات مختلفة للحالة (state)، وآليات مختلفة للتعامل مع الأخطاء، ولا يوجد لديهم مفهوم مشترك للهوية.
لحال هذه المشكلة، تقدم TrueFoundry الدعم لـ A2A (Agent-to-Agent) Protocol. وهو عبارة عن طبقة نقل صريحة تقوم بتطبيع الاتصالات (normalizes communication)، مما يحول مجموعة مجزأة من البرامج النصية (scripts) إلى Cognitive Mesh موحدة.
الخطأ الأساسي في العديد من التصميمات المبكرة لـ agent هو التعامل مع الاتصال بين agent وآخر كأنه مجرد استدعاء API بسيط (POST /chat { "prompt": "..." }). هذا غير كافٍ لأنه يفتقر إلى Meta-Cognition (ما وراء المعرفة).
لا يحتاج agent إلى نص الرسالة فحسب. بل يحتاج إلى معرفة:
يحل بروتوكول A2A هذه المشكلة عن طريق تغليف كل تفاعل داخل Envelope قياسي. نحن نتعامل مع منطق الأعمال الخاص بـ agent (أي الـ prompt) باعتباره Payload، ولكننا نغلفه داخل Control Plane صارم.
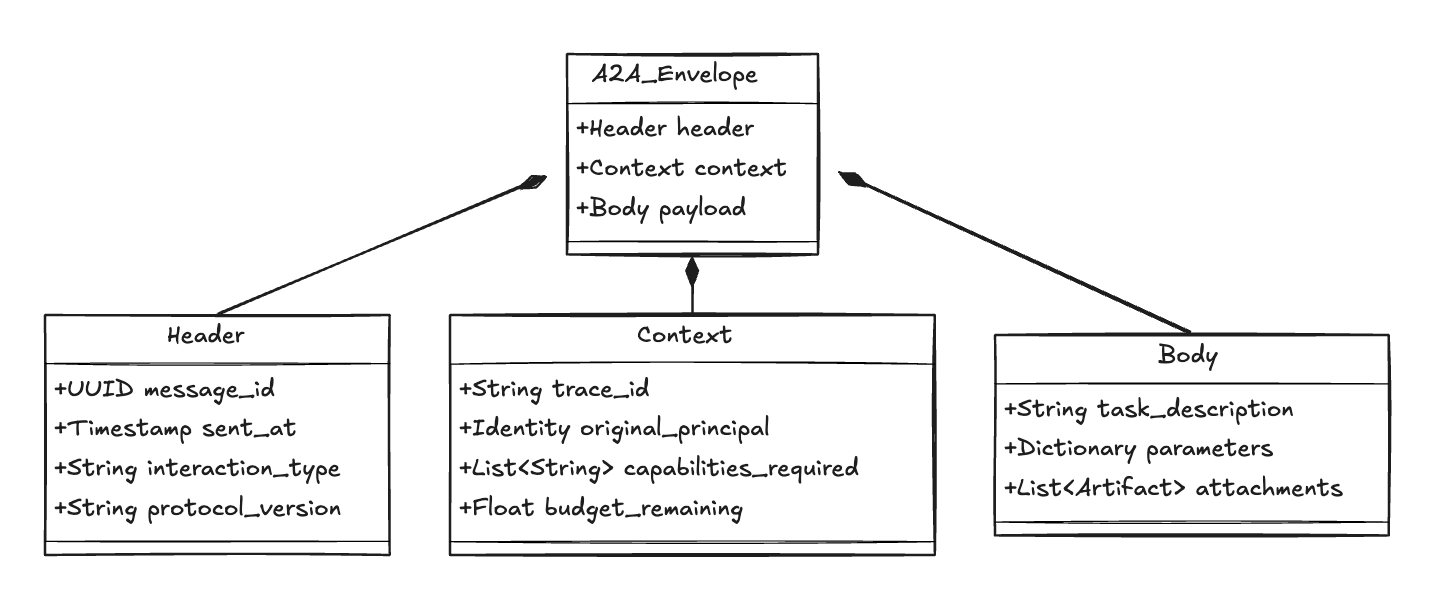
شكل 1: غلاف A2A Envelope وبنيته التحتية
اقرأ أيضاً: MCP vs A2A
لتوضيح قوة هذا البروتوكول، دعنا ننظر إلى سيناريو معقد متعدد التقنيات: M&A Due Diligence System (نظام الفحص النافي للجهالة لعمليات الاندماج والاستحواذ).
يتطلب هذا النظام ثلاثة agents متخصصين للغاية يعملون على حزم تقنية (technology stacks) مختلفة تمامًا:
بدون وجود بروتوكول، لا يمكن للمدير المبني بلغة Python تفعيل فريق AutoGen بسهولة. حيث يتوقع AutoGen نسقًا محددًا لسجل المحادثات، بينما يتوقع LangChain وجود "Chain". وإذا أطلق المراجع القانوني (Node) خطأً، فقد يفسره مدير Python على أنه هلوسة (hallucination) بدلاً من خطأ في النظام.
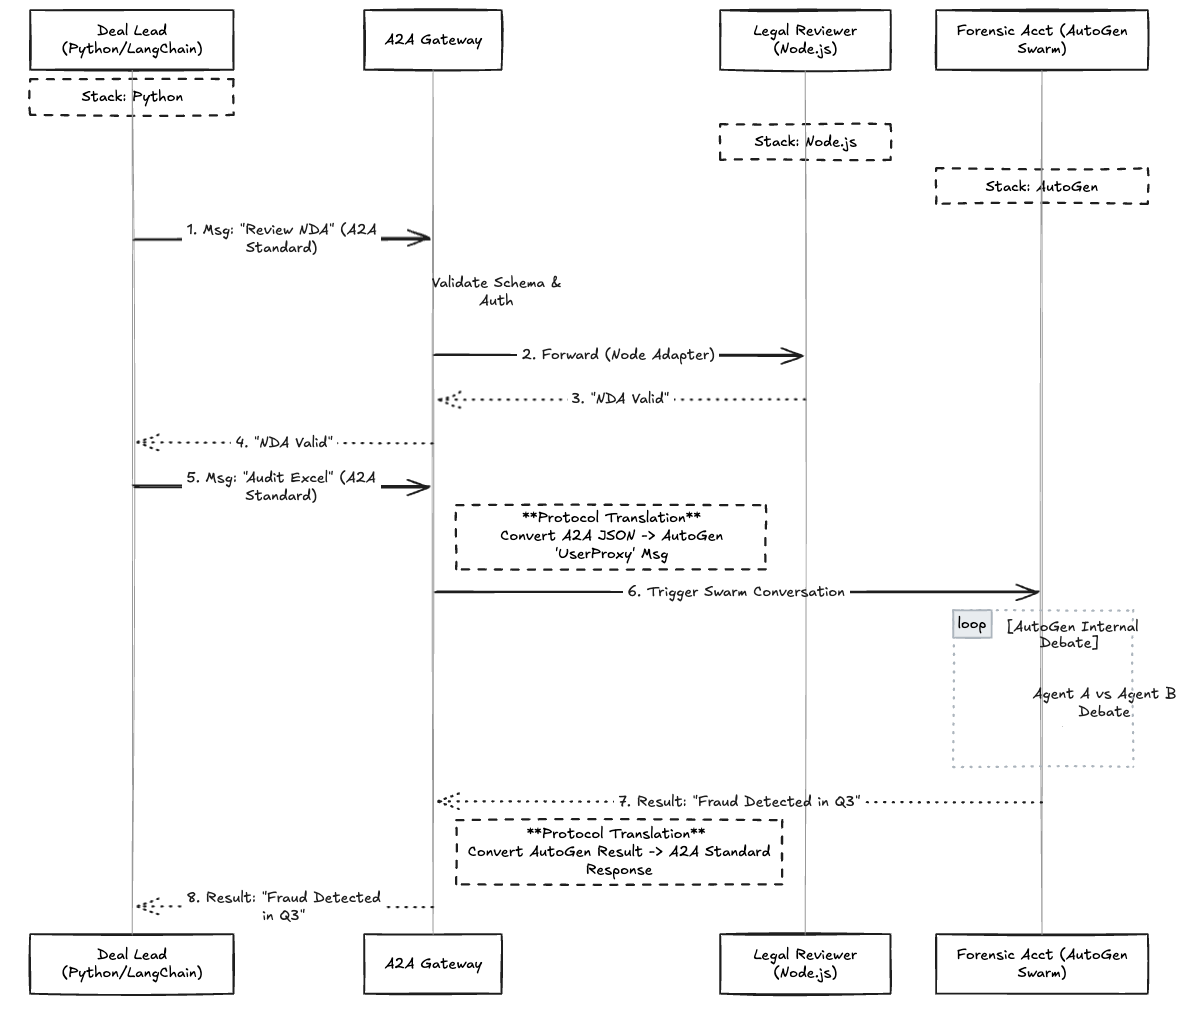
شكل 2: التدفق التفصيلي لعملية المراجعة القانونية
في شبكة agents الند للند (peer-to-peer)، يستدعي Agent A الـ Agent B مباشرة. هذا أمر خطير لأنه يكسر المراقبة والأمان. إذا تم اختراق Agent A، فيمكنه إغراق Agent B بالطلبات، ولن يعلم أحد بذلك حتى تصل الفاتورة.
يفرض بروتوكول A2A نموذج Hub-and-Spoke.

تتبع أخطاء LLM فردي واستكشافها أمر صعب. وتتبع سلسلة متكررة من 5 agents أمر مستحيل بدون تتبع موزع (distributed tracing).
عندما يفشل "قائد الصفقة" في إغلاق صفقة الاندماج والاستحواذ، فأنت بحاجة إلى معرفة السبب. هل كان ذلك بسبب انتهاء المهلة (timeout) لدى agent القانوني؟ أم أن المحاسب الجنائي نفدت منه الـ tokens؟
يفرض بروتوكول A2A مفهوم Header Propagation. عندما يتلقى Gateway الطلب الأولي، فإنه ينشئ TraceID. ويجبر كل agent فرعي على تضمين هذا المعرف في استدعاءاته الفرعية.
يسمح لنا هذا بتصور "Thought Stack"—مخطط جانت (Gantt chart) زمني للتفكير. حيث يمكننا أن نرى أن Agent القانوني استغرق 45 ثانية (عنق زجاجة في زمن الاستجابة) بينما استغرق المحاسب ثانيتين فقط.
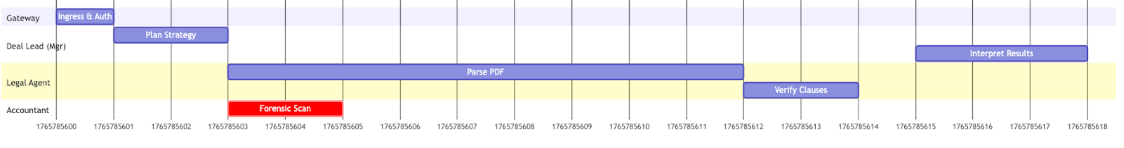
شكل 3: مخطط جانت لصفقة الاندماج والاستحواذ هذه
الجزء الأخير من بروتوكول A2A هو Universal Adapter.
نحن ندرك أن المطورين سيستخدمون دائمًا أدوات مختلفة. فبعضهم يحب LangGraph للتحكم الذي يوفره؛ والبعض الآخر يفضل CrewAI لميزات لعب الأدوار (role-playing).
يعمل Gateway كـ Translation Layer (طبقة ترجمة).
يسمح لك هذا ببناء Heterogeneous Agent Mesh (شبكة agents غير متجانسة). فأنت غير مقيد بمكتبة Python واحدة. يمكنك اختيار أفضل أداة لمهمة كل agent محدد وترك البروتوكول يتعامل مع الاتصالات.
التوحيد القياسي هو الشرط الأساسي للتوسع. تمامًا كما سمح TCP/IP للإنترنت بربط أجهزة كمبيوتر مختلفة، يتيح بروتوكول A2A Protocol بالإضافة إلى إمكانيات TrueFoundry AI agent gateway للمؤسسات ربط قدرات ذكاء اصطناعي مختلفة. إنه يحول مجموعة من "Chatbots" إلى Digital Workforce منسقة، وقابلة للمراقبة، وآمنة.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد