



November 16, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.



Blazingly fast way to build, track and deploy your models!
تُغيّر أدوات البرمجة المدعومة بالذكاء الاصطناعي مثل OpenCode بشكل جذري طريقة تفاعل المطورين مع الشفرات البرمجية. فبدلاً من العمل على أجزاء برمجية معزولة، تقوم هذه الأنظمة بالتحليل والاستنتاج عبر الملفات، والتبعيات (dependencies)، والسياق التاريخي. والنتيجة هي دفعة كبيرة في الإنتاجية، ولكنها تأتي أيضاً بتحدٍ جديد في التكلفة والقابلية للتوسع يقلل العديد من الفرق من شأنه: استهلاك الرموز (token usage).
على عكس أدوات المطورين التقليدية ذات تكاليف التراخيص المتوقعة، يخضع استخدام OpenCode للتسعير القائم على الرموز. فكل تفاعل - سواء كان توليد شفرة، أو إعادة هيكلة (refactoring)، أو تصحيح أخطاء (debugging)، أو مراجعة - يستهلك رموزاً. ومع توسع الفرق في الاستخدام عبر المطورين، ومستودعات الشفرات (repositories)، والوكلاء المؤتمتين (automated agents)، يصبح استهلاك الرموز هو المحرك الرئيسي للتكلفة.
ما يجعل هذا الأمر معقداً بشكل خاص هو أن استهلاك الرموز غالباً ما يكون غير بديهي. فالتغييرات الصغيرة في حجم السياق (context size)، أو بنية المطالبة (prompt structure)، أو سلوك الوكيل يمكن أن تؤدي إلى تقلبات كبيرة في استهلاك الرموز. وبدون نموذج ذهني واضح لكيفية استخدام الرموز، تواجه الفرق صعوبة في التنبؤ بالتكاليف، أو تحسين سير العمل، أو فرض ضوابط حماية (guardrails).
تستعرض هذه المقالة كيفية عمل استهلاك الرموز في OpenCode على مستوى تقني، ولماذا تعتبر أعباء العمل المتعلقة بالشفرات البرمجية كثيفة الاستخدام للرموز بشكل خاص، وما الذي ينبغي لفرق المنصات فهمه قبل توسيع الاستخدام في بيئات الإنتاج.
في جوهره، يتبع استهلاك الرموز في OpenCode نفس آليات معظم الأنظمة المدعومة بنماذج اللغات الكبيرة (LLM): يتم استهلاك الرموز لكل من المدخلات والمخرجات. ومع ذلك، فإن طبيعة أعباء عمل البرمجة تفرض تعقيداً إضافياً.
يمكن تقسيم استهلاك الرموز في OpenCode بشكل عام إلى فئتين:
في OpenCode، تتضمن رموز المطالبة عادةً ما يلي:
تتضمن رموز الإكمال ما يلي:
من منظور التكلفة، غالباً ما تكون رموز المطالبة هي العامل المهيمن في استهلاك OpenCode، خاصة مع نمو مستودعات الشفرات وأحجام السياق.
تتصرّف المهام المتعلقة بالشفرة البرمجية بشكل مختلف تماماً عن استعلامات اللغة الطبيعية. وتساهم عدة عوامل في زيادة استهلاك الرموز:
على عكس حالات الاستخدام القائمة على المحادثة، غالباً ما يرسل OpenCode:
حتى قاعدة الشفرة البرمجية (codebase) "الصغيرة" يمكن أن تترجم سريعاً إلى عشرات أو مئات الآلاف من الرموز عند تضمين ملفات متعددة.
الشفرة المصدريّة كثيفة. فالصياغة (syntax)، والمسافات البادئة (indentation)، والرموز، والتنسيق تُحسب جميعها ضمن الرموز. ويمكن لبضعة آلاف من أسطر الشفرة البرمجية أن تستهلك رموزاً أكثر بكثير من كمية معادلة من النص العادي.
غالباً ما تتضمن مسارات عمل OpenCode ما يلي:
قد تعيد كل خطوة إرسال السياق أو المخرجات المتوسطة، مما يضاعف استهلاك الرموز عبر مهمة واحدة.
عند استخدام OpenCode عبر الوكلاء أو الأتمتة (على سبيل المثال، إعادة الهيكلة عبر ملفات متعددة أو التشغيل في خطوط أنابيب التكامل المستمر CI)، يتضاعف استهلاك الرموز بسرعة:
هذا يجعل الاستخدام الموجه بالوكلاء قوياً ولكنه مكلف أيضاً إذا لم يتم تقييده.
أحد أكبر التحديات في استهلاك رموز OpenCode هو أن المطورين نادراً ما يرون السياق الكامل الذي يتم إرساله إلى النموذج. فالمحررات والأدوات تُخفي وتُجرّد:
نتيجة لذلك، يمكن لمهمتين تبدوان متشابهتين أن تكون لهما بصمة رموز مختلفة تماماً. وبدون تتبع صريح على مستوى الطلب، غالباً ما تكتشف الفرق مشكلات التكلفة فقط بعد ارتفاع الاستهلاك بشكل مفاجئ.
لهذا السبب، فإن فهم آليات الرموز لا يكفي بمفرده. تحتاج الفرق إلى رؤية واضحة لاستهلاك الرموز الفعلي لكل مهمة، ولكل مطور، ولكل سير عمل لاتخاذ قرارات تحسين مستنيرة.
يعد فهم استهلاك الرموز أمراً مهماً لأي تطبيق مدعوم بالذكاء الاصطناعي، ولكنه يصبح حاسماً بشكل خاص مع توسع تبني الذكاء الاصطناعي عبر المطورين، والوكلاء، ومؤسسات الأعمال. وتساعد مراقبة استهلاك الرموز وتحسينه المؤسسات على التحكم في التكاليف، وتحسين الكفاءة، والحفاظ على إنفاق متوقع على الذكاء الاصطناعي.
معاونو البرمجة بالذكاء الاصطناعي مثل OpenCode وClaude Code والأدوات المشابهة معالجة قواعد الشفرات البرمجية الكبيرة، ونوافذ السياق الواسعة، والمحادثات متعددة الجولات بشكل متكرر. ومع تفاعل المطورين مع هذه الأدوات على مدار اليوم، يمكن أن ينمو استهلاك الرموز بسرعة.
تتبع استهلاك الرموز يساعد فرق الهندسة على:
غالباً ما ينفذ وكلاء الذكاء الاصطناعي مسارات عمل معقدة تتضمن التخطيط، والاستنتاج، واستخدام الأدوات، والاسترجاع، وتوليد الشفرة البرمجية. ويمكن لهذه التفاعلات متعددة الخطوات أن تولد استهلاكاً للرموز أعلى بكثير من تطبيقات الدردشة التقليدية.
مراقبة استهلاك الرموز تتيح للفرق:
مع نمو نشر الوكلاء، تكتسب رؤية استهلاك الرموز أهمية أساسية للحفاظ على تكاليف تشغيلية متوقعة.
غالباً ما تنشر المؤسسات الكبيرة تطبيقات الذكاء الاصطناعي عبر فرق ومنتجات ووحدات أعمال متعددة. وبدون رؤية مركزية، قد يكون من الصعب فهم كيفية استهلاك الرموز وأين تزداد التكاليف.
تستخدم المؤسسات مراقبة الرموز من أجل:
مع توسع تبني الذكاء الاصطناعي، يصبح استهلاك الرموز مقياساً تشغيلياً مهماً إلى جانب زمن الانتقال (latency)، والموثوقية، وأداء النموذج. وغالباً ما تكون المؤسسات التي تراقب استهلاك الرموز وتحسّنه بفاعلية في موقع أفضل لتوسيع أعباء عمل الذكاء الاصطناعي بكفاءة مع التحكم في التكاليف.
معظم الارتفاعات الحادة في استهلاك رموز OpenCode لا تنتج عن خطأ واحد واضح. بل تنشأ من كيفية استخدام OpenCode في مسارات عمل الهندسة في العالم الفعلي - خاصة عند دمج الأدوات والوكلاء بعمق في خطوط أنابيب التطوير والأتمتة.
فيما يلي السيناريوهات الأكثر شيوعاً التي تزيد من استهلاك الرموز بشكل غير متناسب.
أحد أكبر العوامل المساهمة في ارتفاع استهلاك الرموز هو التضمين المفرط للسياق. تتضمن العديد من مسارات عمل OpenCode أدلة (directories) بأكملها أو مجموعات فرعية كبيرة من المستودع لـ "توخي الحذر"، حتى عندما يكون جزء صغير فقط من الشفرة هو المرتبط بالمهمة.
وتشمل الأمثلة ما يلي:
نظراً لأن رموز المطالبة تتزايد خطياً مع حجم السياق، فإن هذا النمط بمفرده يمكن أن يضاعف التكاليف بسرعة.
غالباً ما يعمل OpenCode بشكل تكراري: توليد الشفرة، ثم المراجعة، والتعديل، وإعادة التوليد. في العديد من الإعدادات، تعيد كل جولة تكرار إرسال السياق الكامل، بما في ذلك الملفات والمخرجات السابقة.
يؤدي هذا إلى:
بدون التخزين المؤقت (caching) أو إعادة الاستخدام الذكي للسياق، يصبح التكرار أحد أكثر الأنماط كلفة.
عند استخدام OpenCode عبر الوكلاء أو مسارات العمل المؤتمتة، يمكن أن يتصاعد استهلاك الرموز بسرعة إذا لم يتم تقييد التنفيذ بشكل صريح.
وتشمل الأسباب الشائعة ما يلي:
نظراً لأن هذه العمليات غالباً ما تعمل في الخلفية، فقد لا تلاحظ الفرق الاستخدام المنفلت إلا بعد ارتفاع التكاليف.
تميل مهام إعادة الهيكلة والمراجعة إلى استهلاك رموز أكثر من توليد الشفرة البرمجية لأنها تتطلب:
عند تطبيق هذه المهام عبر قواعد شفرات برمجية كبيرة أو طلبات سحب (pull requests) متعددة، يزداد استهلاك الرموز بشكل كبير.
يمثل استخدام OpenCode المدمج في خطوط أنابيب التكامل المستمر (CI) أو مسارات عمل الأتمتة نمط مخاطر مختلف. فهذه الأنظمة:
حتى الاستهلاك المعتدل للرموز في كل تشغيل يمكن أن يصبح مكلفاً عند مضاعفته عبر العديد من عمليات البناء أو النشر.
أخيراً، أحد أكثر العوامل إغفالاً لارتفاع استهلاك الرموز هو غياب الرؤية والشفافية. عندما لا تتمكن الفرق من رؤية:
يصبح التحسين مجرد تخمين. وغالباً ما تستجيب الفرق بفرض قيود على الاستخدام بشكل عام، بدلاً من معالجة مسارات عمل محددة تؤدي إلى زيادة التكاليف.
بمجرد أن تفهم الفرق مصدر استهلاك الرموز، فإن الخطوة التالية هي التحسين. ومن المهم الإشارة إلى أن التحسين لا يعني الحد من الاستخدام بشكل عشوائي، بل يتعلق بـ استخدام الرموز بوعي واستهداف حتى لا تتحول مكاسب الإنتاجية إلى تكاليف غير منضبطة.
فيما يلي أفضل الممارسات العملية التي تقلل باستمرار من استهلاك رموز OpenCode دون التأثير على جودة المخرجات.
أكثر رافعة تحسين فعالية هي التحكم في السياق الذي يتم إرساله إلى النموذج. فزيادة السياق ليست أفضل دائماً، خاصة عندما يكون غير مرتبط بالمهمة.
وتشمل التقنيات العملية ما يلي:
قاعدة عامة جيدة: إذا كان الملف غير مطلوب لـ فهم التغيير والتفكير فيه، فلا ينبغي أن يكون جزءاً من المطالبة.
بدلاً من إرسال كميات كبيرة من الشفرة البرمجية مسبقاً، يجب على الفرق الانتقال نحو الاسترجاع عند الطلب (on-demand retrieval).
أمثلة:
يقلل هذا النهج من حجم المطالبة مع تحسين جودة الاستنتاج غالباً، نظرًا لأن النموذج يتلقى معلومات أكثر استهدافاً.
تميل المطالبات العامة إلى تشجيع الاستنتاج الأوسع والمخرجات الأكبر، مما يزيد من رموز المطالبة والإكمال معاً.
أنماط أفضل:
المطالبات محدودة النطاق لا تقلل من استهلاك الرموز فحسب، بل تحسن أيضاً من حتمية النتائج (determinism).
تضاعف مسارات العمل القائمة على الوكلاء من استهلاك الرموز إذا تُركت دون مراقبة. يجب أن يعمل كل وكيل ضمن حدود محددة بوضوح.
وتشمل ضوابط الحماية الرئيسية ما يلي:
بدون هذه الحدود، يمكن للوكلاء إعادة معالجة سياقات كبيرة عدة مرات عن غير قصد، مما يؤدي إلى زيادة الاستهلاك.
تكرر العديد من مسارات عمل OpenCode مهام متشابهة عبر التكرارات أو المستخدمين. ويمكن للتخزين المؤقت (caching) تقليل استهلاك الرموز الزائد بشكل كبير.
الحالات القابلة للتطبيق:
حتى التخزين المؤقت الجزئي على مستوى سير العمل يمكن أن يحقق توفيراً ملموساً.
في حين أن رموز المطالبة غالباً ما تكون هي المهيمنة، فإن رموز الإكمال مهمة أيضاً، خاصة في مسارات عمل إعادة الهيكلة أو تلك التي تتطلب شروحات كثيفة.
وتشمل التقنيات ما يلي:
تقيد المخرجات الواضحة يقلل من الإطناب غير الضروري.
أخيراً، لا ينبغي أن يكون التحسين رد فعل عاطفي أو مؤقت. يجب على الفرق تجهيز أدوات قياس استهلاك الرموز منذ اليوم الأول.
على الأقل، يعني هذا تتبع ما يلي:
بدون هذه البيانات، لا يمكن للفرق التمييز بين الاستخدام المنتِج والهدر.
معظم الفرق لا تواجه صعوبة في استهلاك رموز OpenCode في اليوم الأول. بل تظهر المشكلات تدريجياً مع انتشار الاستخدام عبر المطورين، والمستودعات، ومسارات العمل المؤتمتة. وما يبدأ كأداة إنتاجية فردية سرعان ما يتحول إلى بنية تحتية مشتركة، ويزداد استهلاك الرموز بطرق يصعب التنبؤ بها أو إدارتها.
عند التوسع، لم يعد OpenCode مستخدماً بواسطة مطور واحد في محرر. بل يتم استخدامه بواسطة:
كل مستهلك من هؤلاء يولد استهلاكاً للرموز بشكل مستقل. وبدون رؤية مركزية، يصبح من الصعب الإجابة على أسئلة أساسية مثل من يستخدم الرموز، ولأي غرض، وبأي تكلفة.
غالباً ما يتم تطبيق جهود التحسين المبكرة على مستوى التطبيق أو الأداة، مثل قيود المطالبات المخصصة، أو تقليم السياق، أو منطق إعادة المحاولة. ورغم أن هذه الإجراءات تساعد محلياً، إلا أنها لا تتوسع عبر:
نتيجة لذلك، تصبح السياسات مجزأة وغير متسقة. فقد يقوم فريق بالتحسين بشكل مكثف بينما يتسبب فريق آخر دون علم في زيادة التكاليف.
تُغيّر الأتمتة الحسابات. فسير العمل الذي يستهلك عدداً معتدلاً من الرموز لكل تشغيل يمكن أن يصبح مكلفاً عندما:
نظراً لأن هذه المهام تعمل دون رؤية بشرية مباشرة، فإن أوجه عدم الكفاءة تتراكم بسرعة. وغالباً ما تنشأ الارتفاعات الحادة في استهلاك الرموز من الأتمتة بدلاً من الاستخدام التفاعلي.
بدون إسناد دقيق، ترى الفرق أرقام الاستخدام الإجمالية فقط. وهذا يجعل التحسين تفاعلياً وغير دقيق.
وتشمل أنماط الفشل الشائعة ما يلي:
يتطلب التحكم الفعال معرفة مسارات العمل التي تحقق قيمة وتلك التي تسبب الهدر، وهو أمر لا يمكن للمقاييس الإجمالية كشفه.
في العديد من المؤسسات، يتجاوز تبني أدوات الذكاء الاصطناعي وتيرة الحوكمة. فينتشر استخدام OpenCode أسرع من:
بحلول الوقت الذي يصبح فيه استهلاك الرموز موضع قلق، تكون الأدوات قد أصبحت مدمجة بعمق في مسارات العمل، مما يجعل عناصر التحكم الاسترجاعية صعبة ومربكة.
المشكلة الأساسية ليست سوء الاستخدام - بل هي الاستخدام اللامركزي دون تحكم مركزي. مع تحول OpenCode إلى بنية تحتية مشتركة، يجب إدارة استهلاك الرموز بنفس الطريقة التي تدير بها الفرق موارد الحوسبة، أو التخزين، أو التكامل المستمر (CI).
وهذا يتطلب:
بدون هذا التحول، يظل استهلاك الرموز غير متوقع، وتبقى جهود التحسين مجرد ردود أفعال.
بمجرد أن يصل استخدام OpenCode إلى نطاق الإنتاج، تتوقف التتبع العشوائي والتحسينات اليدوية عن العمل. في هذه المرحلة، يجب التعامل مع استهلاك الرموز مثل أي مورد بنية تحتية مشترك آخر - قياسه باستمرار، وحوكمته مركزياً، وربطه بالملكية.
تبدأ العديد من الفرق بتتبع استهلاك الرموز داخل الأدوات أو مسارات العمل الفردية. ورغم أن هذا يوفر رؤية محلية، إلا أنه ينهار سريعاً عندما:
تُبلغ كل أداة عن الاستخدام بشكل مختلف، ولا توفر أي منها رؤية شمولية. نتيجة لذلك، تفتقر فرق المنصات إلى مصدر واحد للحقيقة فيما يتعلق باستهلاك الرموز.
عند التوسع، يجب أن تتم المراقبة على مستوى الطلب، وليس فقط على مستوى الأداة. والإعدادات الفعالة تسجل ما يلي:
يتيح هذا للفرق الإجابة على أسئلة مثل:
بدون هذه التفاصيل الدقيقة، تظل جهود التحسين غير دقيقة وغالباً ما توجّه بشكل خاطئ.
تبدأ الحوكمة بالإسناد. يجب تعيين استهلاك الرموز إلى مالكين يمكنهم التصرف بناءً على ذلك.
وتشمل نماذج الإسناد الشائعة ما يلي:
بمجرد أن تتضح الملكية، تتحول مناقشات التكلفة من ميزانيات مجردة إلى قرارات ملموسة حول مسارات العمل التي تقدم قيمة كافية.
المراقبة وحدها لا تمنع تجاوز التكاليف. تقتضي أنظمة الإنتاج آليات إنفاذ تعمل في الوقت الفعلي.
وتشمل ضوابط الحماية النموذجية ما يلي:
يجب فرض هذه الضوابط مركزياً بحيث ترثها جميع مسارات العمل المدعومة بـ OpenCode تلقائياً.
العنصر المشترك بين إعدادات الحوكمة الفعالة هو المركزية. يجب أن تعيش سياسات استخدام الـ tokens والحدود والرؤية في نقطة تحكم مشتركة بدلاً من إعادة تطبيقها عبر الأدوات المختلفة.
وهنا يأتي دور المنصات الموجهة للبنية التحتية مثل TrueFoundry بشكل طبيعي. من خلال مركزية حركة مرور AI، و القابلية والملاحظة Observability، وتطبيق السياسات، يمكن لفرق المنصات إدارة استخدام OpenCode للـ tokens بشكل متسق عبر المطورين و الوكلاء Agents والأنظمة المؤتمتة - دون إبطاء الفرق الفردية.
مع نمو اعتماد AI، يصبح تتبع استخدام الـ tokens والتحكم فيه أمرًا بالغ الأهمية بشكل متزايد. بينما يمكن للمطورين الفراديين غالبًا إدارة استهلاك الـ tokens يدويًا، فإن المؤسسات التي تشغل تطبيقات وفريقًا ونماذج متعددة تتطلب عادةً رؤية وحوكمة مركزية.
يمكن أن تعمل المراقبة اليدوية مع عمليات النشر صغيرة الحجم، ولكن غالبًا ما يصبح من الصعب تتبع الإنفاق، وتحديد أوجه عدم الكفاءة، وتطبيق عناصر التحكم في الاستخدام مع توسع أحمال عمل AI. توفر بوابات AI Gateway طبقة مركزية لمراقبة استخدام الـ tokens، وإدارة التكاليف، وتحسين استخدام النماذج عبر المؤسسة.
من وجهة نظر المنصة، فإن التحدي الأساسي في استخدام OpenCode للـ tokens ليس فهم كيفية استهلاك الـ tokens، بل أين يجب أن تعيش الرؤية والتحكم.
تتعامل TrueFoundry مع هذه المشكلة من خلال التعامل مع استخدام AI و LLM - بما في ذلك الأدوات الموجهة للمطورين مثل OpenCode - كبنية تحتية مشتركة يجب أن تكون قابلة للملاحظة وقابلة للحوكمة ومدركة للتكاليف بشكل افتراضي. وفي مركز هذا النهج يوجد AI Gateway، والذي يعمل كطبقة تحكم Control Plane لجميع حركة مرور LLM عبر المؤسسة.
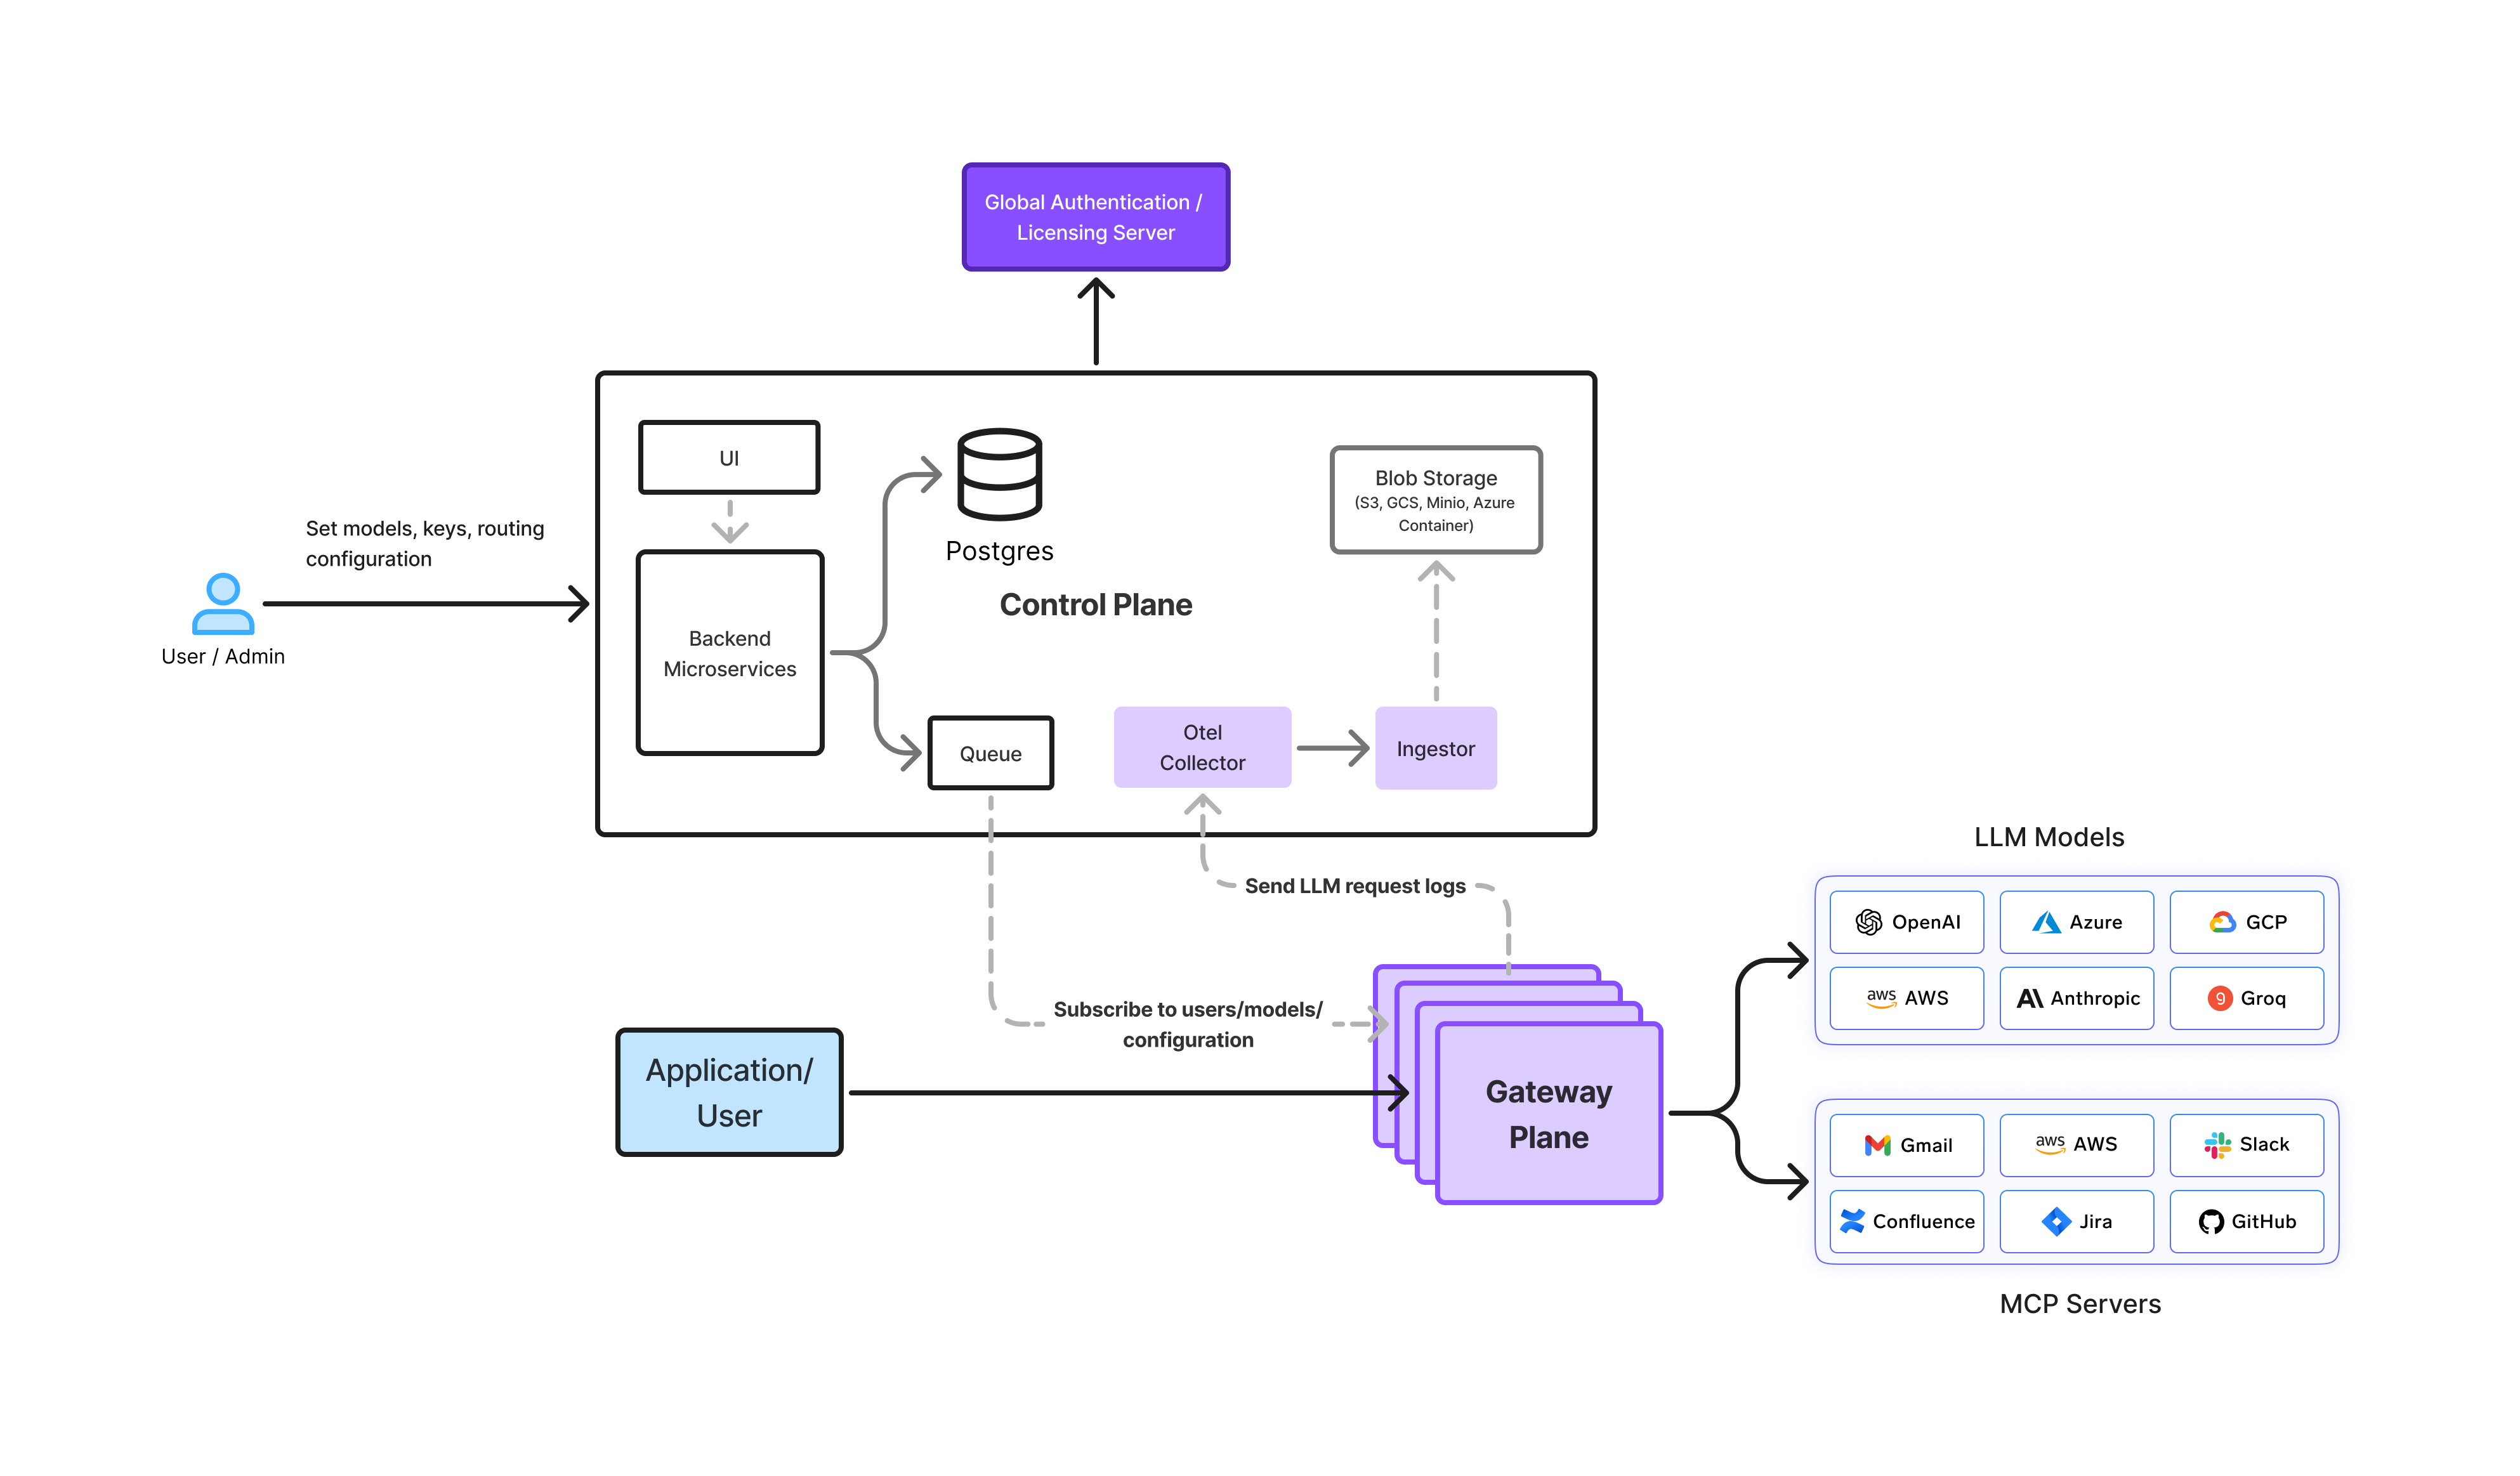
في إعداد TrueFoundry، لا يتفاعل OpenCode بشكل مباشر مع مزودي LLM الأساسيين. بدلاً من ذلك، تتدفق جميع الطلبات عبر AI Gateway، الذي يوفر واجهة واحدة ومتسقة للاستدلال Inference.
معماريًا، يتيح هذا ما يلي:
من خلال إزالة الوصول المباشر إلى النموذج من الأدوات الفردية، تكتسب فرق المنصات رؤية كاملة لكيفية استخدام OpenCode بالفعل عبر المطورين و الوكلاء Agents والأتمتة Automation.
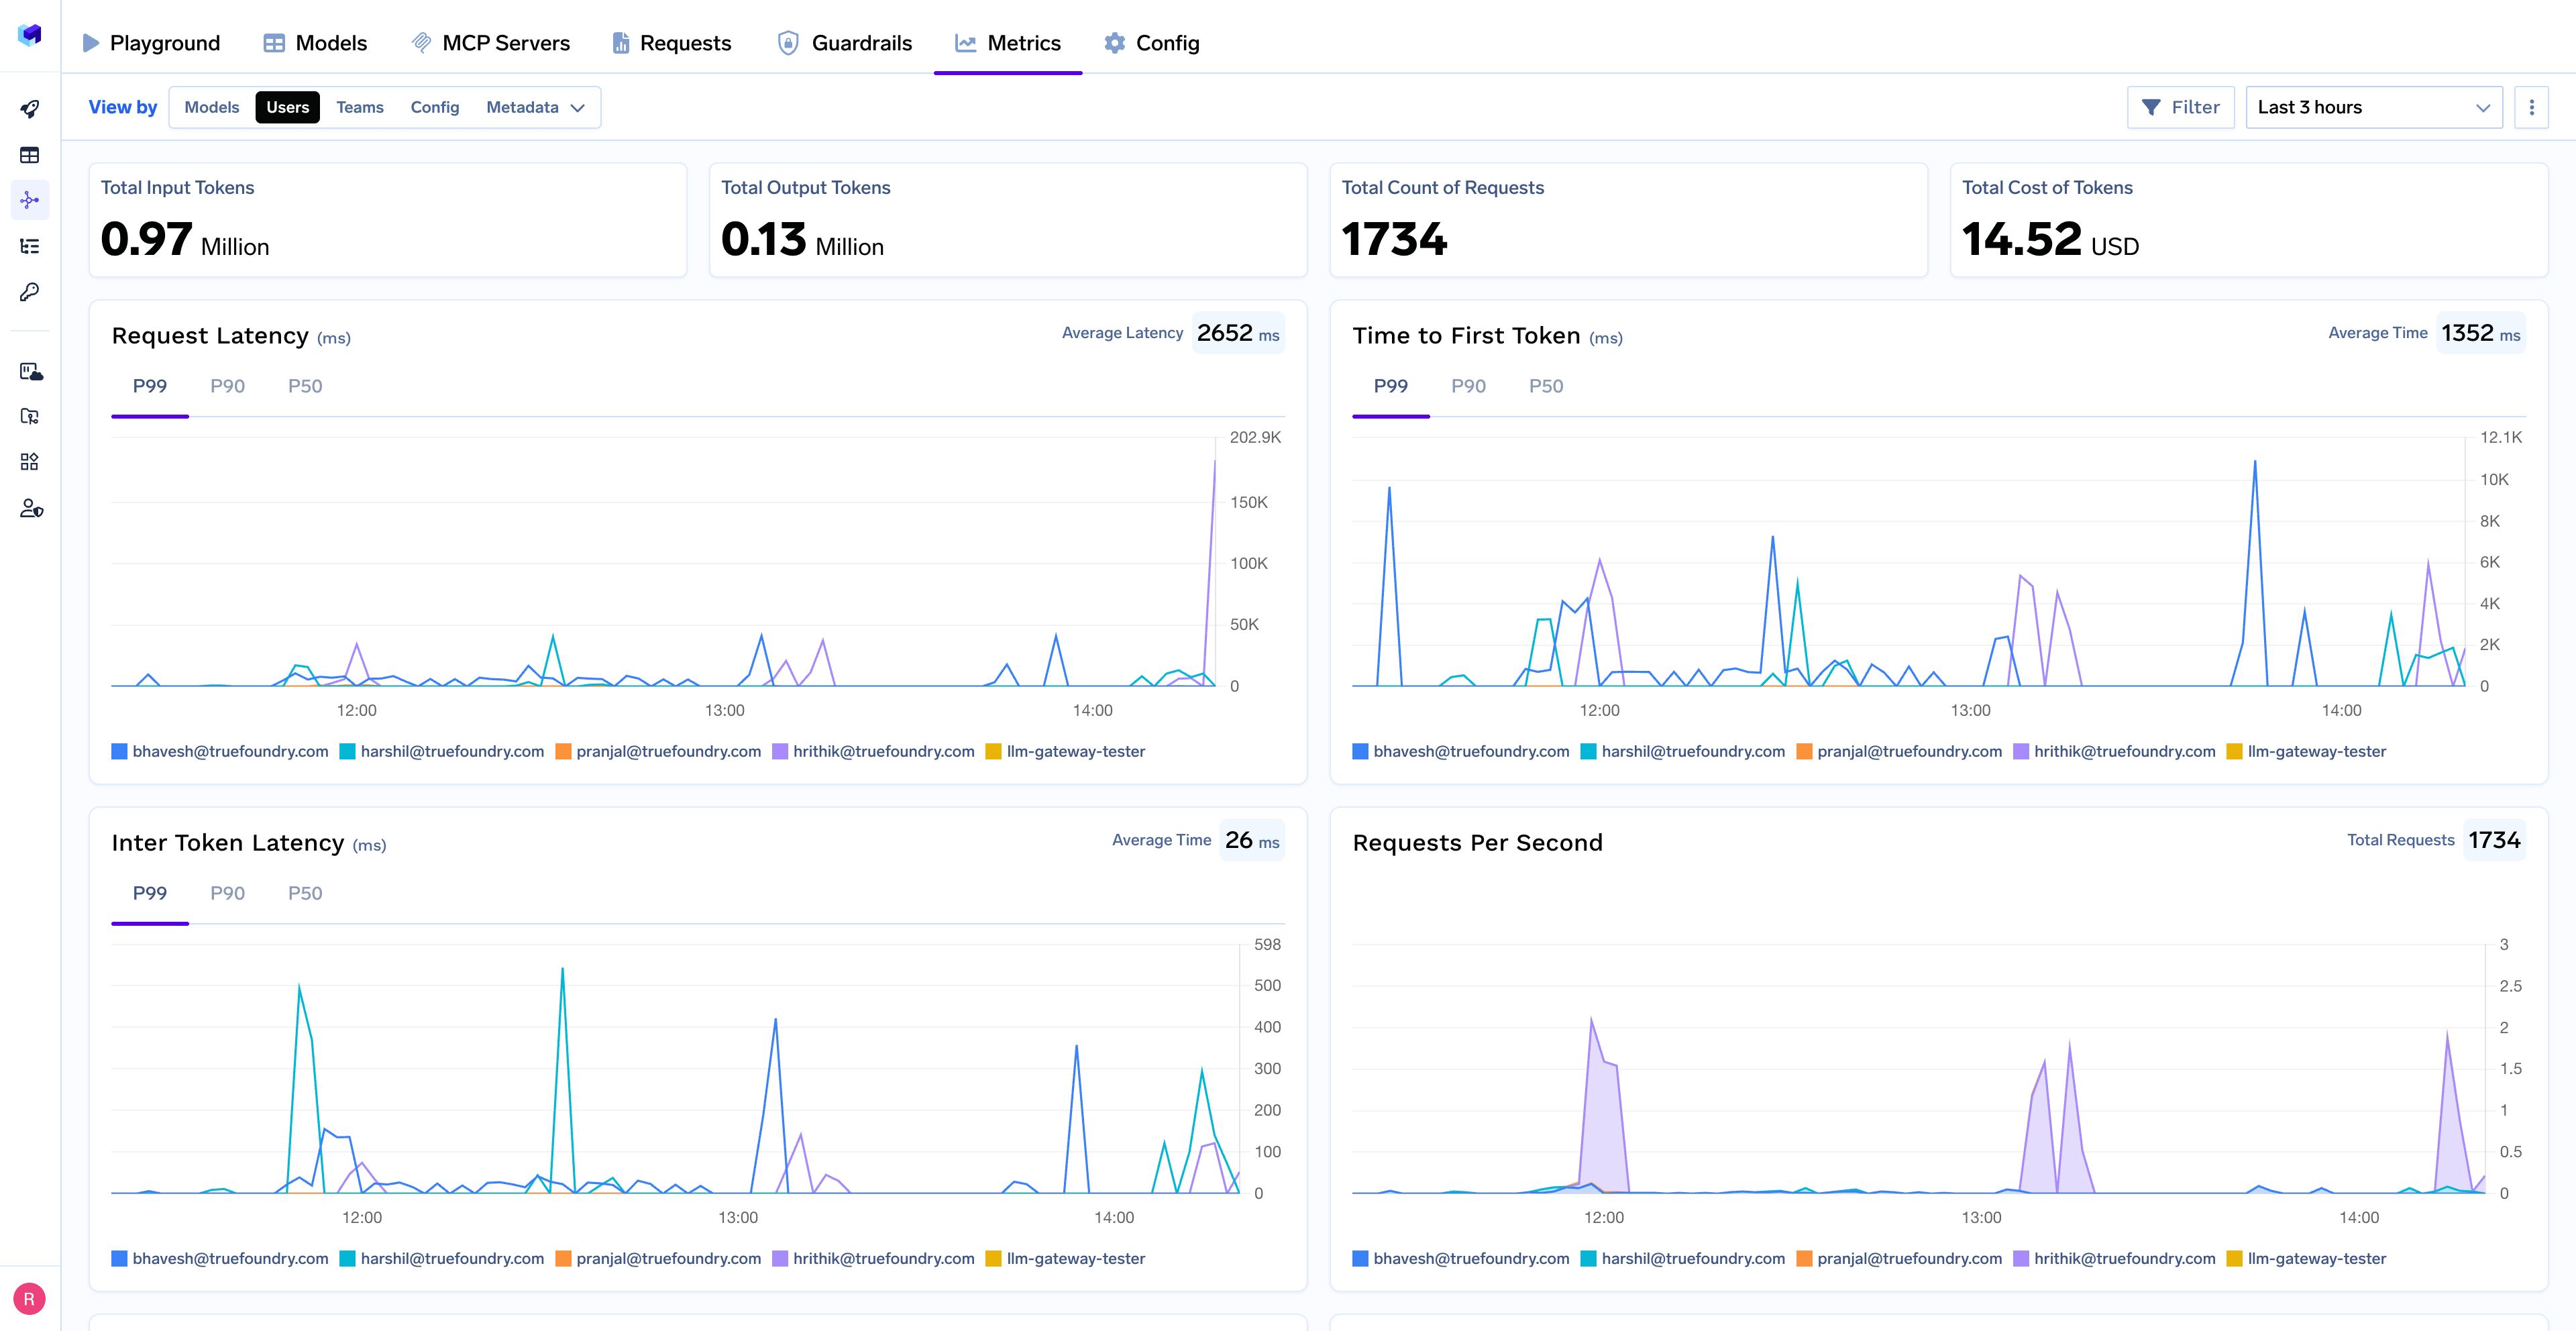
يلتقط AI Gateway الخاص بـ TrueFoundry استخدام الـ tokens على مستوى الطلب، بما في ذلك:
والأهم من ذلك، أن هذه البيانات Telemetry ليست محبوسة في نظام يتحكم فيه المورد. يتم حفظ السجلات والقياسات في السحابة والتخزين الخاصين بالعميل، مما يسمح للفرق بما يلي:
وهذا يتجنب مشكلة "الصندوق الأسود" الشائعة في أدوات AI ويجعل التحسين طويل الأجل ممكنًا.
نظرًا لأن جميع حركة مرور OpenCode تمر عبر البوابة، يمكن تطبيق عناصر التحكم في التكلفة بشكل متسق وفي الوقت الفعلي.
يمكن لفرق المنصات:
يتم تطبيق هذه السياسات مرة واحدة عند البوابة وتطبق تلقائيًا على كل مسار عمل يعمل بـ OpenCode دون الحاجة إلى تغييرات في المحررات، أو الإضافات Plugins، أو الأدوات الداخلية.
تم تصميم بنية TrueFoundry للبيئات التي يمتد فيها استخدام OpenCode إلى ما هو أبعد من IDE. غالبًا ما تولد أنابيب CI، والوظائف الخلفية، و الوكلاء Agents الاستهلاك الأكبر والأقل وضوحًا للـ tokens.
من خلال توجيه أحمال العمل هذه عبر نفس AI Gateway، يمكن للفرق:
هذا يجعل من الممكن توسيع استخدام OpenCode عبر المؤسسة دون فقدان القابلية للتنبؤ أو التحكم.
استخدام OpenCode للـ tokens هو القيد الحقيقي للتوسع في البرمجة المدعومة بـ AI. مع انتشار الاستخدام عبر المطورين، والمستودعات Repos، والأتمتة، و الوكلاء Agents، يصبح استهلاك الـ tokens صعب التنبؤ به والتحكم فيه دون رؤية وحوكمة مركزية.
إدارة هذا على مستوى الأداة أو التطبيق لا تتوسع. يحتاج استخدام الـ tokens إلى القابلية والملاحظة Observability على مستوى الطلب، والإسناد الواضح، والتطبيق في الوقت الفعلي، والتعامل مع البرمجة المدعومة بـ AI كبنية تحتية مشتركة، وليس كميزة معزولة.
تعكس المنصات مثل TrueFoundry هذا النهج من خلال مركزية حركة مرور OpenCode عبر AI Gateway، مما يسمح للفرق بمراقبة وحوكمة وتحسين استخدام الـ tokens بشكل متسق. بالنسبة لقادة المنصات والهندسة، الفائدة العملية بسيطة: إذا كان OpenCode أساسيًا لكيفية بناء البرمجيات، فيجب إدارة استخدام الـ tokens بنفس الصرامة مثل أي مورد بنية تحتية حيوي آخر.
يتطلب التحقق الدقيق من استخدام opencode للـ tokens تتبعًا وقياسًا صريحين على مستوى الطلب. نظرًا لأن الأدوات غالبًا ما تجرد السياق الكامل المرسل إلى النموذج، فإن الحصول على رؤية لاستجابة استهلاك الـ tokens الفعلي لكل مهمة ومطور ومسار عمل أمر حاسم للتنبؤ بالتكاليف وتحسين استخدامك بشكل فعال.
استخدام opencode للـ tokens هو نموذج تسعير قائم على الـ tokens لأدوات البرمجة المدعومة بـ AI مثل OpenCode. كل تفاعل، بدءًا من الـ prompts ومدخلات سياق الكود وحتى الكود المولد والشروحات، يستهلك tokens. تعد إدارة استخدام opencode للـ tokens أمرًا حاسمًا لأنه يصبح محرك التكلفة الرئيسي لفرق التطوير.
لتقليل استخدام opencode للـ tokens، قم بحد حقن السياق على الملفات الأساسية فقط، وتجنب تضمين المستودع كاملاً. أوقف إعادة ترطيب السياق المكررة من خلال إعادة استخدام المخرجات بذكاء عبر التكرارات. قم بتقسيم المهام المعقدة إلى خطوات أصغر واستخدم prompts دقيقة. توفر مراقبة استهلاك الـ tokens لكل مهمة رؤى حاسمة لتحسين التكاليف والكفاءة.
يمكنك تقليل استخدام OpenCode للـ tokens من خلال تحسين طول الـ prompt، والحد من السياق غير الضروري، واستخدام النموذج المناسب للمهمة. يمكن للـ prompts الكبيرة، وسجل المحادثة الطويل، وسياقات الكود الضخمة أن تزيد بشكل كبير من استهلاك الـ tokens. يمكن أن تساعد المراجعة المنتظمة لأنماط الاستخدام في تحديد الفرص لتحسين الكفاءة وتقليل التكاليف.
يمكن لعدة عوامل زيادة استخدام الـ tokens في OpenCode، بما في ذلك:
يمكن لفهم هذه العوامل أن يساعد الفرق في تحسين استخدام AI والتحكم في الإنفاق بشكل أكثر فعالية.
تراقب المؤسسات عادةً استخدام الـ tokens من خلال لوحات التحكم المركزية، أو أدوات التحليلات، أو منصات AI Gateway. توفر هذه الحلول رؤية لاستجابة استهلاك الـ tokens عبر المستخدمين والفرق والتطبيقات والنماذج، مما يساعد المؤسسات على تتبع الإنفاق، وتحديد الشذوذ Anomaly، وتخصيص ميزانيات AI بشكل أكثر فعالية.
كما أن مراقبة استخدام الـ tokens على مستوى الفريق تجعل من السهل تحديد فرص التحسين ومنع الزيادات غير المتوقعة في التكاليف.
نعم. يمكن لـ AI Gateways مساعدة المؤسسات في تحسين استهلاك الـ tokens من خلال توفير الرؤية في أنماط الاستخدام، وتطبيق الميزانيات وحدود المعدلات Rate limits، وتمكين التوجيه الذكي للنماذج Intelligent model routing.
على سبيل المثال، يمكن لـ AI Gateway توجيه الطلبات الأبسط تلقائيًا إلى نماذج أقل تكلفة مع حجز النماذج المتميزة للمهام الأكثر تعقيدًا. جنبًا إلى جنب مع تحليلات الاستخدام وعناصر تحكم الحوكمة، يساعد هذا المؤسسات على تقليل تكاليف AI مع الحفاظ على الأداء والموثوقية.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد




















