



November 5, 2025
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.



Blazingly fast way to build, track and deploy your models!
يُعد تتبع التجارب جانبًا حاسمًا في تطوير تعلم الآلة، حيث يُمكّن الممارسين من إدارة وتتبع تقدم تجاربهم بنجاعة. يتضمن تتبع التجارب تسجيل ومراقبة عوامل مختلفة، مثل أداء النموذج، والبارامترات الفائقة (hyperparameters)، وبيانات التدريب، للحصول على رؤى حول أداء نموذج تعلم الآلة.
يمكن أن تكون إدارة التجارب وتتبع النتائج مهمة صعبة لممارسي تعلم الآلة نظرًا لتعقيد النماذج، والكميات الكبيرة من البيانات المشاركة، وتنوع الأدوات وأطر العمل المستخدمة في تطوير تعلم الآلة. فيما يلي بعض التحديات الرئيسية التي يواجهها الممارسون في إدارة التجارب وتتبع النتائج:
Weights & Biases (W&B) هي منصة صُممت لمساعدة ممارسي تعلم الآلة على إدارة وتتبع تجاربهم بفعالية. توفر مجموعة من الأدوات لـ تتبع التجارب، والتصور، والتعاون، مما يسهل على الممارسين تطوير نماذج تعلم آلة قوية وقابلة للتوسع.الميزات والمزايا الرئيسية لمنصة W&B هي:
يتضمن إعداد W&B لـ تتبع التجارب عدة خطوات:
wandb.init(). تقوم هذه الدالة بتهيئة مكتبة W&B وإعداد تشغيل جديد.wandb.log(). تأخذ هذه الدالة قاموسًا من المقاييس كمدخلات وتسجلها في لوحة تحكم W&B.wandb.config. تأخذ هذه الدالة قاموسًا من البارامترات الفائقة كمدخلات وتسجلها في لوحة تحكم W&B.wandb.log() مع بيانات التصور المناسبة. توفر W&B مجموعة واسعة من أدوات التصور، بما في ذلك التصورات ثلاثية الأبعاد، ومصفوفات الارتباك، والمخططات المبعثرة، من بين أمور أخرى.إليك مثالاً على كيفية تسجيل المقاييس، والنماذج، والبارامترات الفائقة، والتصورات باستخدام W&B:
import wandb
import numpy as np
import matplotlib.pyplot as plt
import tensorflow as tf

# Step 1: Initialize W&B
wandb.init(project="my-project")

# Step 2: Log hyperparameters
config = {
    "learning_rate": 0.001,
    "batch_size": 32,
    "epochs": 10
}
wandb.config.update(config)

# Step 3: Train model and log metrics
model = tf.keras.models.Sequential([
    tf.keras.layers.Dense(10, activation='relu', input_shape=(10,)),
    tf.keras.layers.Dense(1)
])
model.compile(optimizer=tf.keras.optimizers.Adam(config['learning_rate']),
              loss=tf.keras.losses.MeanSquaredError(),
              metrics=[tf.keras.metrics.MeanAbsoluteError()])
for epoch in range(config['epochs']):
    # ... train model ...
    history = model.fit(x_train, y_train, batch_size=config['batch_size'])
    loss = history.history['loss'][-1]
    mae = history.history['mean_absolute_error'][-1]
    wandb.log({"epoch": epoch, "loss": loss, "mae": mae})

# Step 4: Log visualizations and model
x = np.linspace(0, 10, 100)
y = np.sin(x)
fig, ax = plt.subplots()
ax.plot(x, y)
wandb.log({"my_plot": wandb.Image(fig)})
wandb.save('my_model.h5')

# Step 5: Finish run
wandb.finish()
c
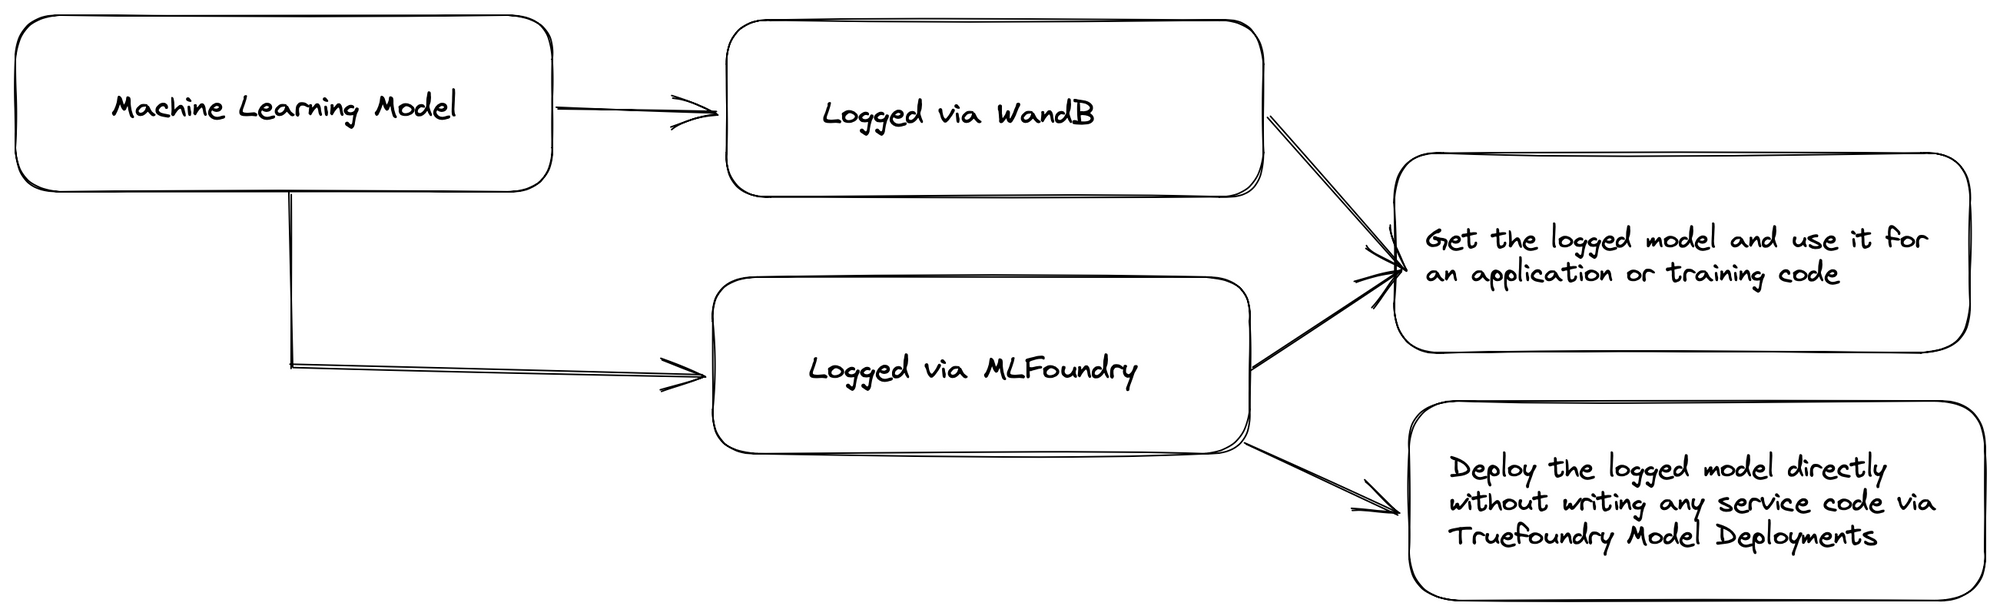
تتكامل TrueFoundry بسلاسة مع Weights & Biases Model Registry للسماح لك بنشر النماذج المسجلة في Weights & Biases إلى عنقود Kubernetes الخاص بك باستخدام TrueFoundry.
📌
بصرف النظر عن استخدام Weights & Biases لإدارة النماذج وتتبع التجارب، يمكنك أيضًا استخدام MLFoundry من TrueFoundry لـ تتبع التجارب.
📌
يمكنك أيضًا متابعة الكود أدناه عبر دفتر Colab التالي:
Colab Notebook
الخطوة 1 - التثبيت والإعداد:
pip install wandb -qU
import wandb
wandb.login()
pip install -U "servicefoundry"
sfy login
الخطوة 2 - تدريب النموذج وتسجيله:
سنستخدم أولاً wandb.init() لتهيئة المشروع
ثم سنقوم بتدريب نموذج ML الخاص بنا وحفظه كملف joblib
ثم سنقوم بحفظ ملف joblib الخاص بنا في wandb عبر wandb.save()
import wandb
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report
import joblib

# Initialize W&B
wandb.init(project="iris-logistic-regression")

# Load and preprocess the data
X, y = load_iris(as_frame=True, return_X_y=True)
X = X.rename(columns={
        "sepal length (cm)": "sepal_length",
        "sepal width (cm)": "sepal_width",
        "petal length (cm)": "petal_length",
        "petal width (cm)": "petal_width",
})

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

# Initialize the model
clf = LogisticRegression(solver="liblinear")

# Fit the model
clf.fit(X_train, y_train)

# Evaluate the model
preds = clf.predict(X_test)

# Log the model and the evaluation metrics to W&B
joblib.dump(clf, "model.joblib")
wandb.save("model.joblib")

# Finish the run
wandb.finish()
الخطوة 3 - إنشاء تطبيق استدلال (inference) وملف التبعيات:
سيتعين علينا إنشاء ملفين للنشر على TrueFoundry، ملف app.py يحتوي على كود التطبيق الخاص بنا، وملف requirements.txt يحتوي على التبعيات الخاصة بنا.
.
├── app.py
├── deploy.py
└── requirements.txt
c
wandb.restore() : <name_of_saved_file> و "username/project/run_id"wandb.restore("model.joblib", "adityajha-tfy/iris-logistic-regression/00r5xvyv")import os
import wandb
import joblib
import pandas as pd
from fastapi import FastAPI
wandb.login(key=os.environ["WANDB_API_KEY"])
# Retrieve the model from W&B
model_joblib = wandb.restore(
'model.joblib',
run_path="adityajha-tfy/iris-logistic-regression/00r5xvyy",
)
model = joblib.load(model_joblib.name)
# Load the model
app = FastAPI(root_path=os.getenv("TFY_SERVICE_ROOT_PATH"))
@app.post("/predict")
def predict(
sepal_length: float, sepal_width: float, petal_length: float, petal_width: float
):
data = dict(
sepal_length=sepal_length,
sepal_width=sepal_width,
petal_length=petal_length,
petal_width=petal_width,
)
prediction = int(model.predict(pd.DataFrame([data]))[0])
return {"prediction": prediction}
fastapi
joblib
numpy
pandas
scikit-learn
uvicorn
wandb
الخطوة 4 - استخدام Python SDK من TrueFoundry وتكوين النشر
import argparse
import logging
from servicefoundry import Build, PythonBuild, Service, Resources, Port

# Setup the logger
logging.basicConfig(level=logging.INFO)

# Setup the argument parser
parser = argparse.ArgumentParser()
parser.add_argument("--workspace_fqn", required=True, type=str)
parser.add_argument("--wandb_api_key", required=True, type=str)
args = parser.parse_args()

service = Service(
    name="fastapi",
    image=Build(
        build_spec=PythonBuild(
            command="uvicorn app:app --port 8000 --host 0.0.0.0",
            requirements_path="requirements.txt",
        )
    ),
    ports=[
        Port(
            port=8000,
            host="ml-deploy-aditya-ws-8000.demo.truefoundry.com",
        )
    ],
    resources=Resources(
        cpu_request=0.25,
        cpu_limit=0.5,
        memory_request=200,
        memory_limit=400,
        ephemeral_storage_request=200,
        ephemeral_storage_limit=400,
    ),
    env={
        "WANDB_API_KEY": args.wandb_api_key
    }
)
service.deploy(workspace_fqn=args.workspace_fqn)
الخطوة 5 - نشر الخدمة الخاصة بك عبر TrueFoundry
قم بتشغيل الأمر التالي وقم بتمرير
python deploy.py --workspace_fqn "<Your Workspace FQN>" --wandb_api_key "<Your Wandb API Key>"
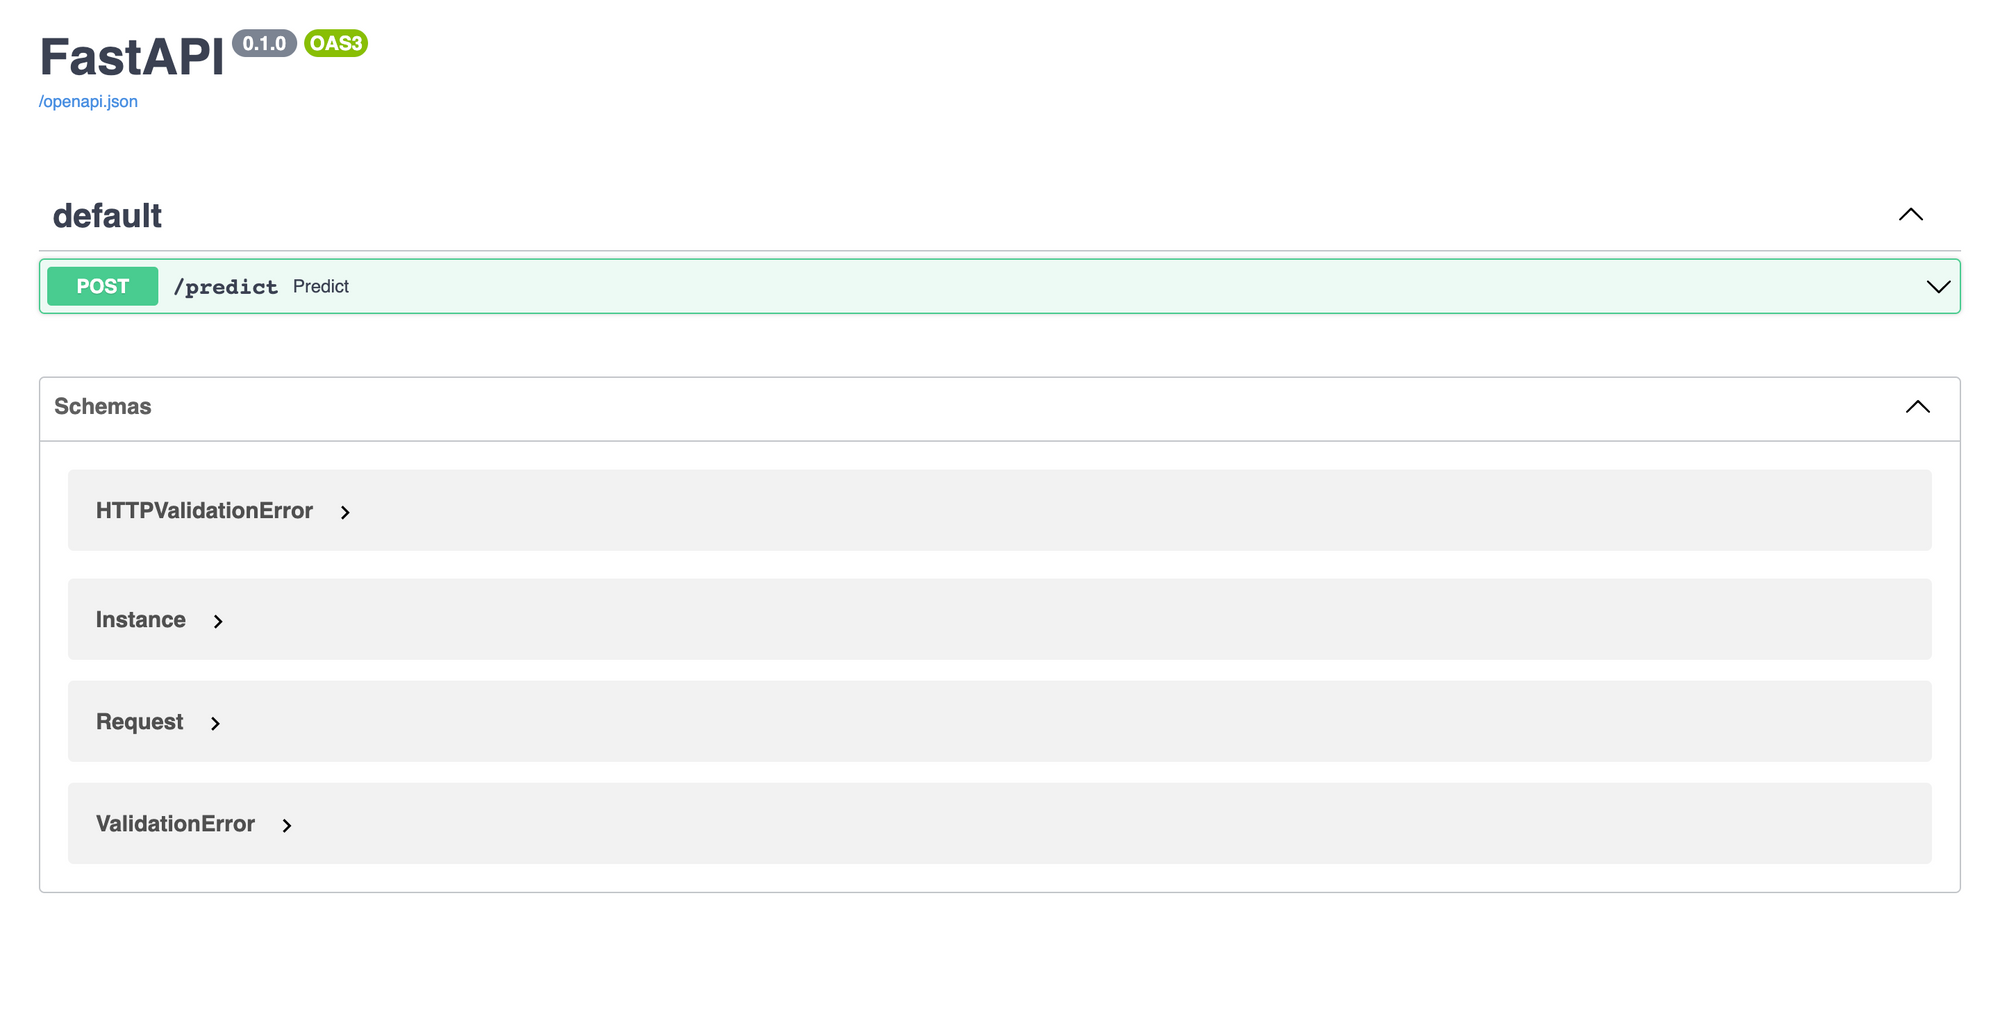
وهكذا ينتهي الأمر!!! في السجلات (logs)، يمكنك العثور على لوحة تحكم الخدمة التي تم نشرها. ثم في الزاوية العلوية اليمنى، ستجد نقطة النهاية (endpoint) لتطبيقك المُنشر.
TrueFoundry هي منصة كخدمة (PaaS) لنشر ML فوق Kubernetes لتسريع سير عمل المطورين مع منحهم المرونة الكاملة في اختبار النماذج ونشرها مع ضمان الأمان والتحكم الكامل لفريق البنية التحتية. من خلال منصتنا، نمكّن فرق تعلم الآلة من نشر ومراقبة النماذج في 15 دقيقة بموثوقية بنسبة 100%، وقابلية للتوسع، والقدرة على التراجع في ثوانٍ - مما يتيح لهم توفير التكاليف وإصدار النماذج إلى الإنتاج بسرعة أكبر، وتحقيق قيمة تجارية حقيقية.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد
























