



November 5, 2025
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.



Blazingly fast way to build, track and deploy your models!
تُعد إدارة إصدارات البيانات (DVC) أداة قوية لإدارة وإصدار مجموعات البيانات الكبيرة والنماذج في مشاريع تعلم الآلة (ML).
تُعتبر DVC أداة مفتوحة المصدر تعمل مع مجموعة واسعة من خيارات التخزين، بما في ذلك القرص المحلي، وأنظمة ملفات الشبكة، وAmazon S3، وGoogle Cloud Storage، وغيرها الكثير. يمكن استخدام DVC جنبًا إلى جنب مع أطر عمل تعلم الآلة الشهيرة مثل TensorFlow وPyTorch وscikit-learn.
بالإضافة إلى تتبع التغييرات في البيانات والنماذج، يمكن لـ DVC أيضًا مساعدة المستخدمين في إدارة التبعيات بين المكونات المختلفة لمشروع تعلم الآلة، مثل الكود والبيانات والنماذج. ومن خلال تتبع هذه التبعيات، تجعل DVC من السهل إعادة إنتاج تجارب تعلم الآلة ومشاركة المشاريع مع الآخرين.
يُعد التحكم بالإصدارات في تعلم الآلة مهمة أكثر صعوبة مقارنة بهندسة البرمجيات للأسباب التالية:
تُعالج DVC هذه المشكلات عن طريق توفير طريقة بسيطة وفعالة للتحكم بإصدارات كل من البيانات والنماذج في مشاريع تعلم الآلة. تُمكنك DVC من التحكم بإصدارات الكود ليس فحسب، بل وأيضًا البيانات والنماذج، وتتبع العلاقات بينها. مع DVC، يمكنك بسهولة إعادة إنتاج التجارب السابقة، والتعاون مع أعضاء الفريق، وأتمتة مسارات العمل لتبسيط عملية التطوير.
للتحكم بـ DVC والبدء باستخدامه، تحتاج إلى تثبيته وإعداده على جهازك المحلي. في هذا القسم، سنقدم تعليمات خطوة بخطوة حول كيفية القيام بذلك، بما في ذلك كيفية تكوين DVC للعمل مع خدمات التخزين السحابي المختلفة وكيفية إنشاء مشروع DVC جديد.
dvc init
سيؤدي هذا إلى إنشاء مشروع DVC جديد في مجلدك الحالي.
dvc remote add -d <remote-name> <storage-url>
على سبيل المثال، إذا كنت تريد إضافة وحدة تخزين بعيدة في Amazon S3 باسم "my-s3-remote"، يمكنك تشغيل الأمر التالي:
dvc remote add -d my-s3-remote s3://my-bucket-name
سيؤدي هذا إلى إضافة وحدة تخزين بعيدة جديدة إلى مشروع DVC الخاص بك مُهيأة للعمل مع Amazon S3.
dvc add <path-to-data-file>
سيؤدي هذا إلى إضافة ملف البيانات إلى مشروع DVC الخاص بك وإنشاء ملف DVC مقابل يتتبع التغييرات في البيانات.
dvc push
سيؤدي هذا إلى رفع أي تغييرات قمت بإجرائها على بياناتك أو نماذجك إلى التخزين البعيد.
توفر DVC عددًا من الأوامر المفيدة لإدارة مشاريع تعلم الآلة وإصدارها. فيما يلي قائمة ببعض أوامر DVC الأكثر استخدامًا:
dvc init: يقوم بتهيئة مشروع DVC جديد في المجلد الحالي.dvc add <path-to-file>: يضيف ملفًا إلى DVC وينشئ ملف DVC مقابل لتتبع التغييرات في الملف.dvc run: يشغّل أمرًا أو برنامجًا نصيًا مع تمكين تتبع DVC، بحيث يتم تتبع أي مدخلات ومخرجات بواسطة DVC.dvc repro: يعيد إنتاج أمر أو برنامج نصي مُتتبع بواسطة DVC، مما يضمن أن جميع التبعيات محدثة.dvc push: يرفع جميع ملفات البيانات وملفات النماذج إلى التخزين البعيد، مثل AWS S3 أو Google Cloud Storage.dvc pull: يسحب جميع ملفات البيانات وملفات النماذج من التخزين البعيد إلى الجهاز المحلي.dvc status: يعرض حالة الملفات المُتتبعة، بما في ذلك ما إذا تم تعديلها أو إضافتها أو حذفها.dvc log: يعرض قائمة بجميع إصدارات الملف، إلى جانب رسائل التثبيت (commit) المقابلة والبيانات الوصفية الأخرى.تُعد القدرة على إعادة إنتاج تجارب تعلم الآلة واحدة من أهم مزايا استخدام DVC. باستخدام DVC، يمكنك تحديد وتتبع التبعيات بين الكود والبيانات والنماذج لديك، واستخدام الأمر dvc repro لإعادة إنتاج التجارب السابقة.
سير عمل نموذجي:
إليك مثال لسير عمل ينطبق على مجموعة بيانات sklearn iris باستخدام ملف yaml.:
dvc init.data في مجلد مشروعك لتخزين مجموعة البيانات، وقم بتنزيل مجموعة بيانات sklearn iris في هذا المجلد.dvc add data/iris.csv..yaml لتحديد خط الأنابيب (pipeline). على سبيل المثال، iris.yaml. سيحتوي هذا الملف على أوامر المعالجة المسبقة، والتدريب، وتقييم النموذج..yaml باستخدام أوامر DVC. على سبيل المثال:stages:
preprocess:
cmd: python preprocess.py data/iris.csv data/preprocessed.csv
deps:
- data/iris.csv
outs:
- data/preprocessed.csv
train:
cmd: python train.py data/preprocessed.csv models/model.pkl
deps:
- data/preprocessed.csv
outs:
- models/model.pkl
evaluate:
cmd: python evaluate.py models/model.pkl data/iris.csv
deps:
- models/model.pkl
- data/iris.csv
dvc repro iris.yaml.من خلال تحديد خط الأنابيب الخاص بك في ملف .yaml واستخدام الأمر dvc repro، يمكنك بسهولة إعادة إنتاج تجاربك، وتتبع إصدارات بياناتك ونماذجك، والتعاون مع أعضاء الفريق في مشروع تعلم الآلة الخاص بك.
فيما يلي مثال لسير العمل:
dvc remote add -d s3remote s3://your-s3-bucket-name/path/to/models
dvc pull -r s3remote path/to/models/model.pkl
scp path/to/models/model.pkl user@target-remote-server:/path/to/models/
# Load the model
import pickle
with open('/path/to/models/model.pkl', 'rb') as f:
    model = pickle.load(f)

# Make predictions
X_test = [[5.1, 3.5, 1.4, 0.2], [7.7, 3.0, 6.1, 2.3], [6.0, 3.0, 4.8, 1.8]]
y_pred = model.predict(X_test)
print(y_pred)
يفترض سير العمل هذا أنك قمت بإعداد الاعتمادات ومعلومات نقطة النهاية اللازمة لخادم S3، وأن لديك إمكانية الوصول إلى كل من الخادم المحلي والخادم البعيد المستهدف. يمكنك تعديل سير العمل بناءً على احتياجاتك وإعداداتك الخاصة.
يتكامل TrueFoundry بسلاسة مع DVC Model Registry للسماح لك بنشر النماذج المسجلة في DVC على عنقود Kubernetes الخاص بك باستخدام TrueFoundry.
📌
بصرف النظر عن استخدام DVC لإدارة النماذج وتتبع التجارب، يمكنك أيضًا استخدام MLFoundry من TrueFoundry لتتبع التجارب.
الخطوة 1 - التثبيت والإعداد:
# Install DVC and S3 support
pip install dvc dvc-s3

# Initialize Git in the local directory
git init

# Initilize DVC in the local directory
dvc init

# Set DVC remote storage as your bucket
dvc remote add s3://<your_bucket_name>
ملاحظة: سيتعين عليك تكوين s3 cli الخاص بك لكي يعمل هذا
import dvc
x
pip install -U "servicefoundry"
sfy login
الخطوة 2 - تدريب النموذج وتسجيله:
سنقوم بتدريب نموذج ML الخاص بنا وحفظه كملف joblib
ثم سنضيف النموذج ومقاييس التقييم باستخدام **`dvc add`**
ثم سنرفع ملف joblib الخاص بنا إلى dvc عبر **`dvc push`**
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report
import joblib
import os

# Load and preprocess the data
X, y = load_iris(as_frame=True, return_X_y=True)
X = X.rename(columns={
        "sepal length (cm)": "sepal_length",
        "sepal width (cm)": "sepal_width",
        "petal length (cm)": "petal_length",
        "petal width (cm)": "petal_width",
})

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

# Initialize the model
clf = LogisticRegression(solver="liblinear")

# Fit the model
clf.fit(X_train, y_train)

# Evaluate the model
preds = clf.predict(X_test)

# Save the model using joblib and DVC
joblib.dump(clf, "model.joblib")
os.system("dvc add model.joblib")

# Log the evaluation metrics
report = classification_report(y_test, preds, output_dict=True)
with open("classification_report.txt", "w") as f:
    f.write(str(report))

# Push the model and evaluation metrics to the remote storage
os.system("dvc push")
الخطوة 3 - إنشاء تطبيق استدلال وملف التبعيات:
سيتعين علينا إنشاء ملفين للنشر على truefoundry، ملف app.py يحتوي على كود التطبيق الخاص بنا، وملف requirements.txt يحتوي على تبعياتنا.
.
├── app.py
├── deploy.py
└── requirements.txt
import os
import joblib
import pandas as pd
from fastapi import FastAPI

# Retrieve the model from S3 using DVC
os.system("dvc pull model.joblib.dvc")

# Load the model
model = joblib.load("model.joblib")

# Load the model
app = FastAPI()

@app.post("/predict")
def predict(
    sepal_length: float, sepal_width: float, petal_length: float, petal_width: float
):
    data = dict(
        sepal_length=sepal_length,
        sepal_width=sepal_width,
        petal_length=petal_length,
        petal_width=petal_width,
    )
    prediction = int(model.predict(pd.DataFrame([data]))[0])
    return {"prediction": prediction}
fastapi
pandas
joblib
dvc
الخطوة 4 - استخدام Python SDK الخاص بـ truefoundry وتكوين النشر
import argparse
import logging
from servicefoundry import Build, PythonBuild, Service, Resources, Port

# Setup the logger
logging.basicConfig(level=logging.INFO)

# Setup the argument parser
parser = argparse.ArgumentParser()
parser.add_argument("--workspace_fqn", required=True, type=str)
args = parser.parse_args()

service = Service(
    name="fastapi",
    image=Build(
        build_spec=PythonBuild(
            command="uvicorn app:app --port 8000 --host 0.0.0.0",
            requirements_path="requirements.txt",
        )
    ),
    ports=[
        Port(
            port=8000,
            host="ml-deploy-aditya-ws-8000.demo.truefoundry.com",
        )
    ],
    resources=Resources(
        cpu_request=0.25,
        cpu_limit=0.5,
        memory_request=200,
        memory_limit=400,
        ephemeral_storage_request=200,
        ephemeral_storage_limit=400,
    ),
)
service.deploy(workspace_fqn=args.workspace_fqn)
الخطوة 5 - نشر خدمتك عبر Truefoundry
قم بتشغيل الأمر التالي وتمرير
python deploy.py --workspace_fqn your_workspace_fqn
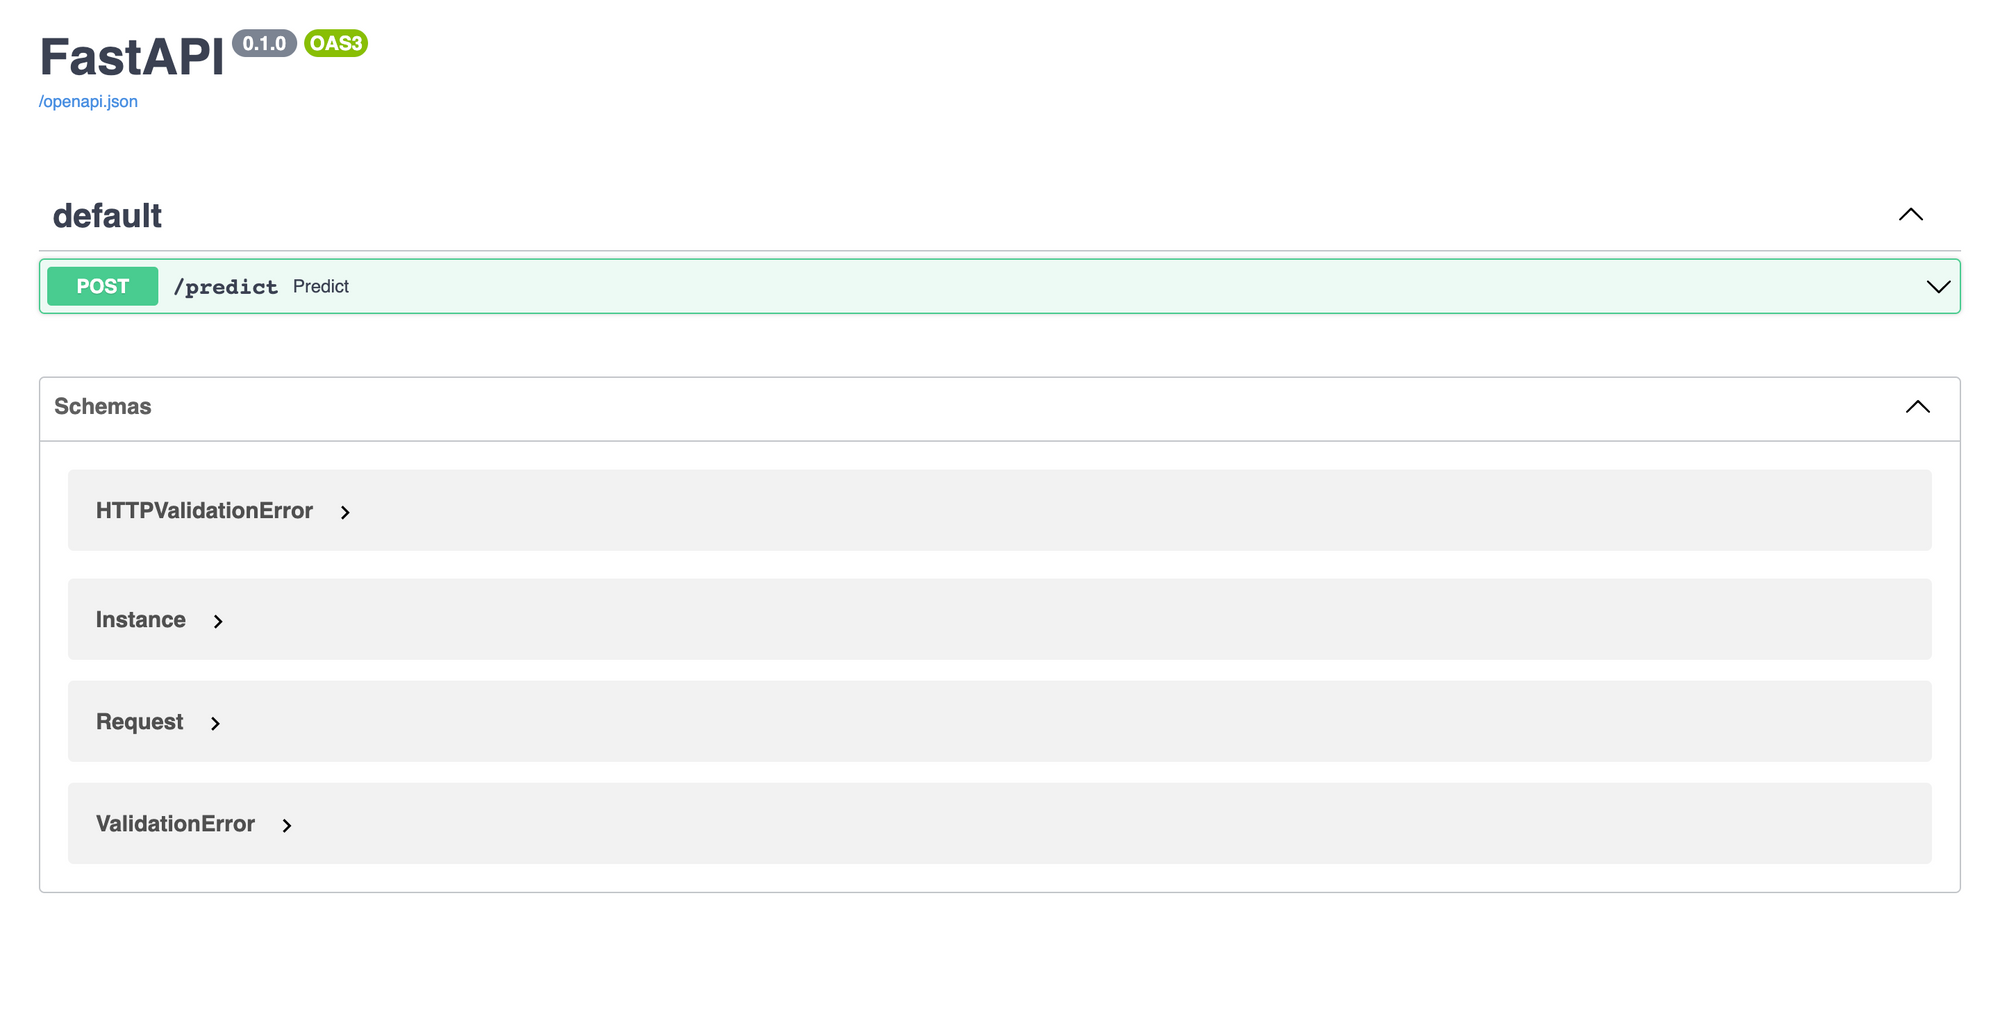
وهكذا انتهينا!!! في السجلات يمكنك العثور على لوحة تحكم الخدمة المنشورة الخاصة بك. ثم في الزاوية اليمنى العليا ستجد نقطة النهاية (endpoint) للتطبيقات المنشورة.
TrueFoundry هي منصة كخدمة (PaaS) لنشر ML عبر Kubernetes لتسريع مسارات عمل المطورين مع منحهم المرونة الكاملة في اختبار النماذج ونشرها، مع ضمان الأمان والتحكم الكلي لفريق البنية التحتية. من خلال منصتنا، نمكّن فرق تعلم الآلة من نشر ومراقبة النماذج في 15 دقيقة بموثوقية 100٪، وقابلية توسع، والقدرة على التراجع في ثوانٍ - مما يتيح لهم توفير التكاليف وإطلاق النماذج إلى البيئة الإنتاجية بشكل أسرع، وتحقيق قيمة عمل حقيقية.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد
























