August 27, 2025
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.



Blazingly fast way to build, track and deploy your models!
في العدد السابق، استعرضنا سير عمل عالم البيانات، وأين بالضبط يمكن أن يثبت Kubernetes أنه قاعدة مفيدة لبناء منصة له.
في هذا العدد، فلنمر بمثال بسيط لاكتساب خبرة عملية حول ذلك.
قبل البدء، نحتاج إلى بيئة تجريبية لتنفيذ العرض التوضيحي. سنقوم بإنشاء عنقود Kubernetes على الجهاز المحلي للقيام بذلك. على الرغم من أن العنقود يجب أن يحتوي على عقد متعددة لتحمل الأخطاء والتوفر العالي، إلا أننا سنحاكي هذا السلوك باستخدام أداة رائعة هي kind (kubernetes-in-docker).
في نهاية هذا القسم، سيكون لدينا حاويات متعددة قيد التشغيل، حيث تعمل كل حاوية كعقدة عنقود منفصلة.
اتبع التوجيهات الموضحة هنا
اختبر التثبيت عن طريق تشغيل
$ kind --version
kind version 0.14.0
الآن نبدأ عنقودًا محليًا باستخدام kind. سننشئ مستوى تحكم واحد وعقدتي عمل. ومن الممكن أن يكون لديك عقد متعددة لكليهما.
<aside> 💡 يمكن أن يحتوي Kubernetes على مستويات تحكم وعقد عمل متعددة. تقع جميع مكونات إدارة العنقود المركزية على عقد مستوى التحكم بينما تعمل أحمال عمل المستخدم على عقد العمل. اقرأ المزيد هنا
</aside>
أولاً، أنشئ تكوين kind في ملف باسم kind-config.yaml. يمكنك العثور عليه هنا. سيحدد هذا هيكل العنقود الخاص بنا -
kind: Cluster
apiVersion: kind.x-k8s.io/v1alpha4
nodes:
- role: control-plane
- role: worker
- role: worker
هنا، قمنا بتحديد ثلاث عقد، واحدة بدور مستوى التحكم والأخريان كعقدتي عمل.
قم بإطلاق العنقود باستخدام هذا التكوين. قد يستغرق هذا بعض الوقت. تأكد من أن Docker daemon يعمل على نظامك قبل تنفيذ هذا -
$ kind create cluster --config kind-config.yaml
...
Thanks for using kind! 😊
kubectl للتأكد من أن العنقود يعلم بشكل صحيح -$ kubectl cluster-info
Kubernetes control plane is running at <https://127.0.0.1:63122>
CoreDNS is running at <https://127.0.0.1:63122/api/v1/namespaces/kube-system/services/kube-dns:dns/proxy>
...
هذا يخبرنا أن العنقود يعمل بالفعل. يمكننا أيضًا رؤية الحاويات الفردية التي تعمل كعقد عن طريق تنفيذ docker ps.
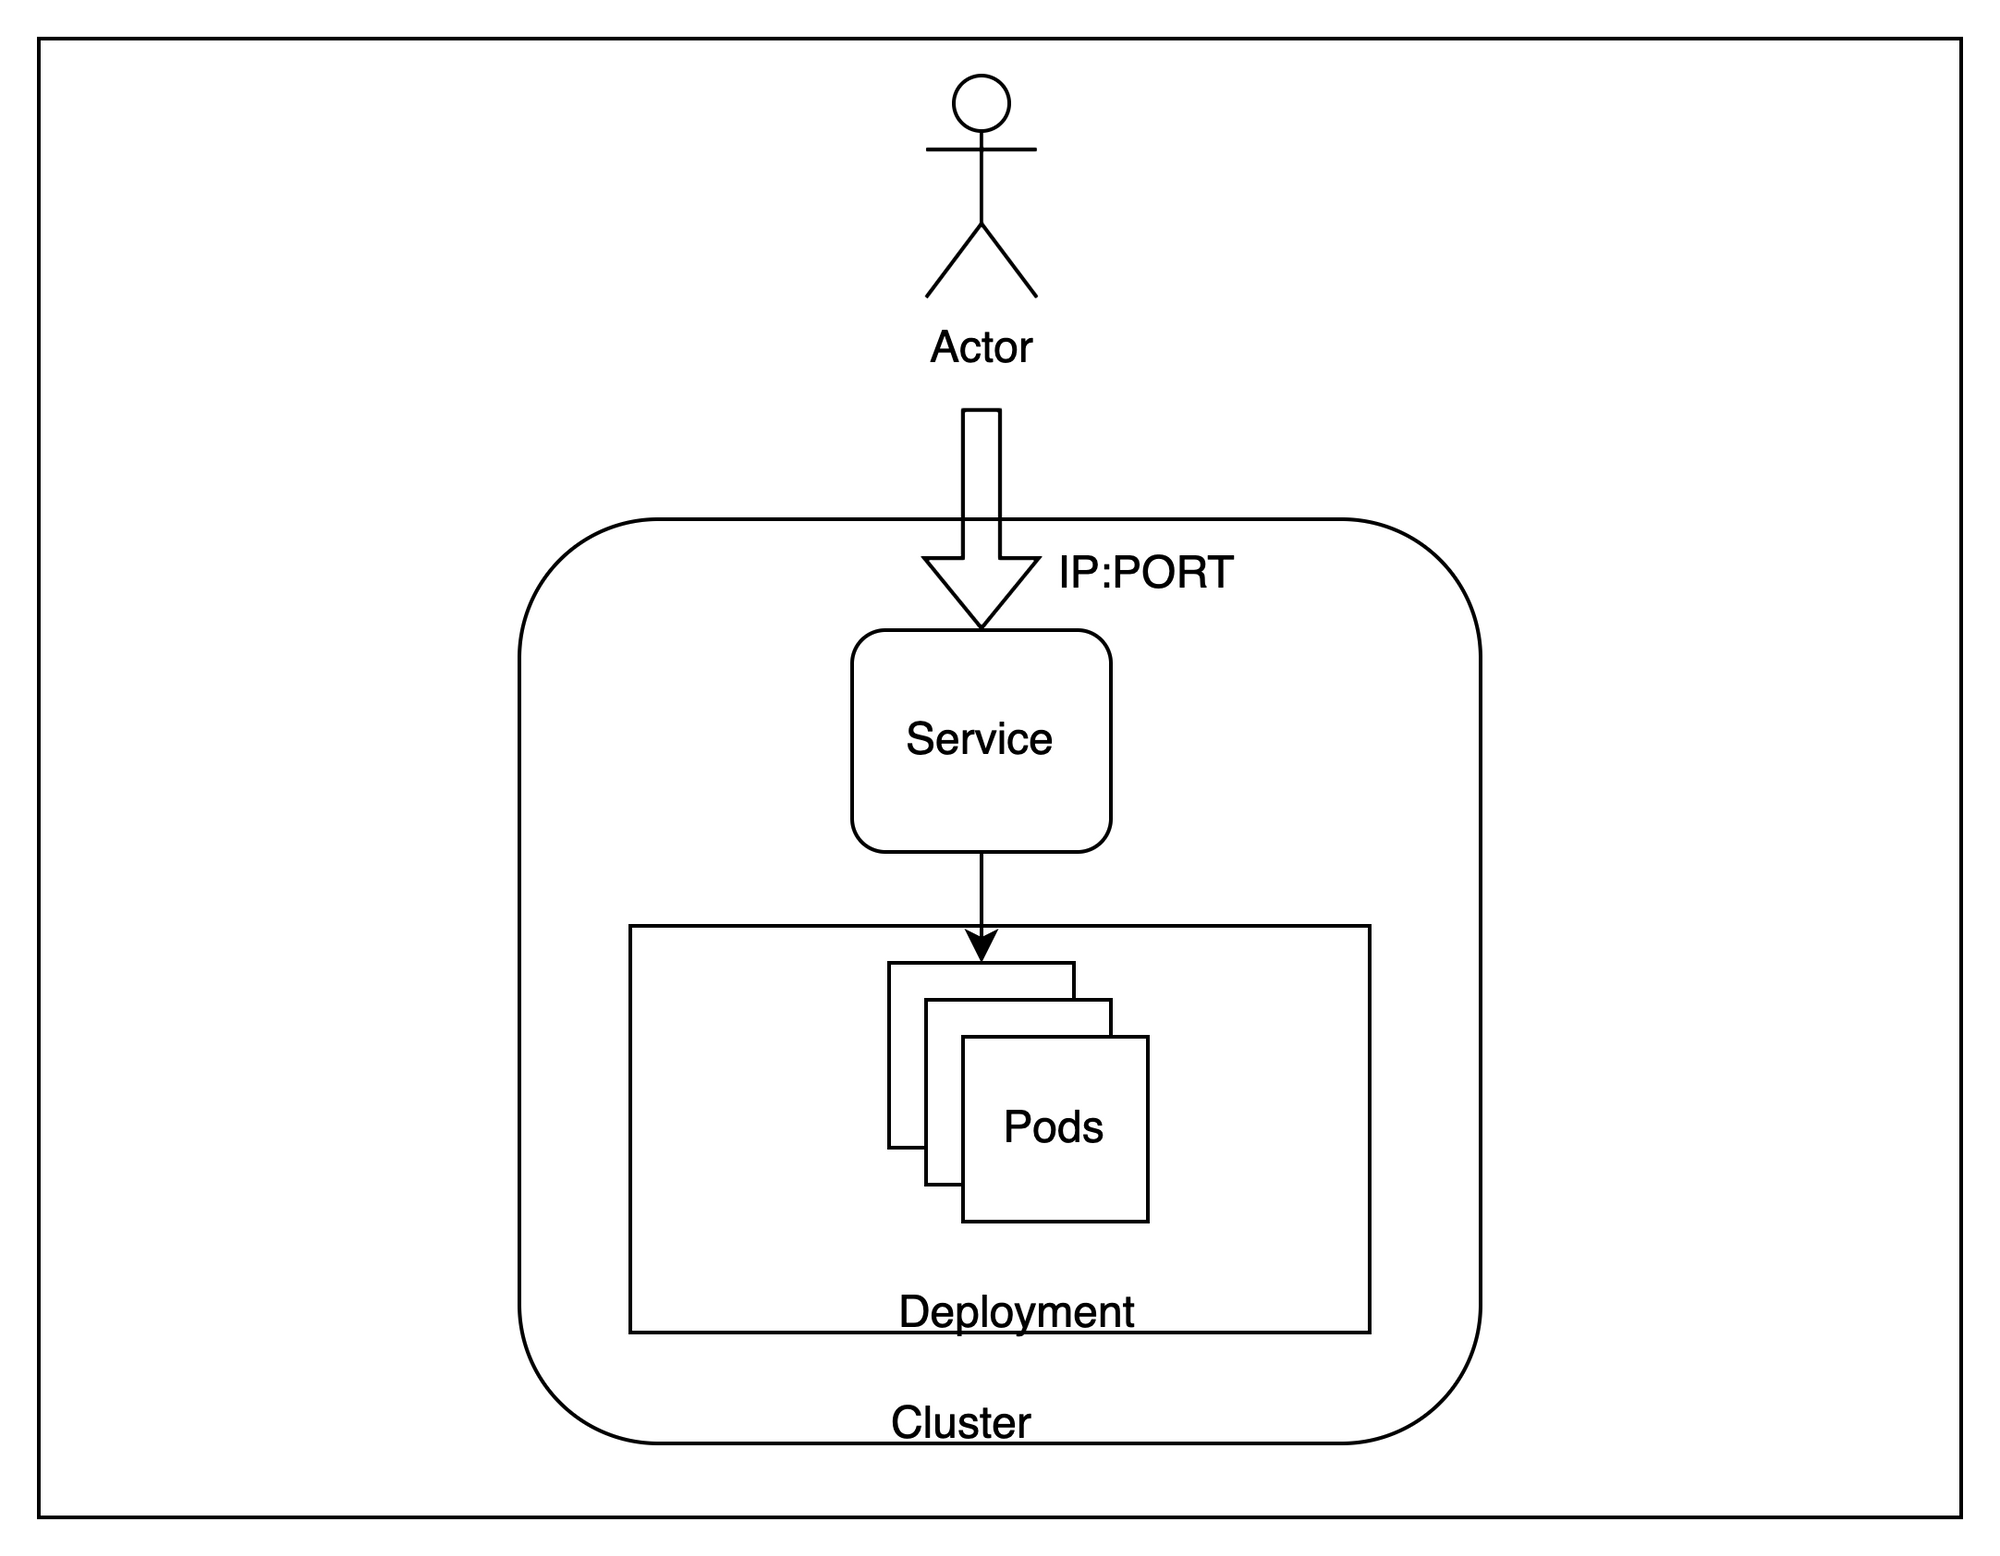
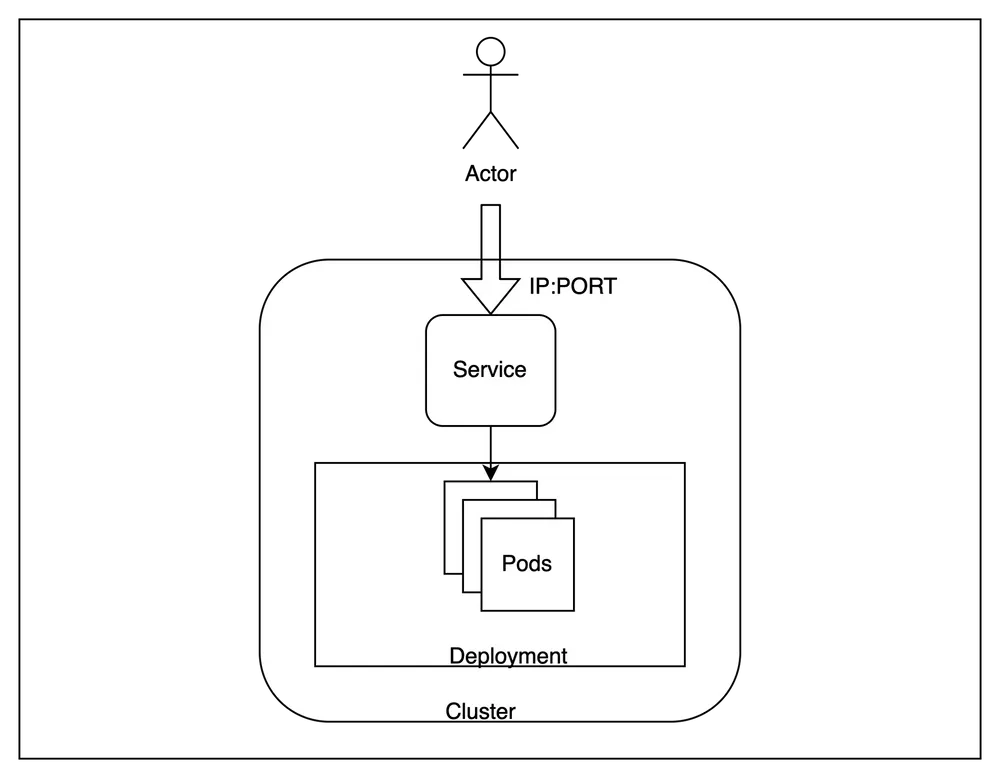
مع تشغيل العنقود الخاص بنا، دعنا نلقي نظرة على المعمارية العامة لما نحن على وشك تهيئته.
بشكل عام، سنستضيف نسخًا متماثلة متعددة من تطبيقنا داخل العنقود ونحاول الوصول إليها من الخارج مع توزيع حمل الطلبات عبر الحالات المختلفة.
لتحقيق ذلك، هناك بعض المصطلحات الخاصة بـ Kubernetes التي نحتاج إلى أن نكون على دراية بها -
Pod - Pods هي أصغر وحدات حوسبة قابلة للنشر يمكنك إنشاؤها وإدارتها في Kubernetes. في حالتنا، ستعمل نسخة واحدة من التطبيق داخل Pod مستقل واحد. هذه موارد مؤقتة ويمكن لمستوى التحكم نقلها عبر العقد إذا لزم الأمر.Deployment - يكون Deployment مفيدًا عندما نريد الحصول على أكثر من نسخة متماثلة واحدة للتطبيق. يحاول Kubernetes دائمًا الحفاظ على عدد النسخ المتماثلة ليكون مساويًا لما هو محدد في Deployment. سننشئ ثلاث نسخ متماثلة متطابقة لتطبيقنا.Service - تكون Service مفيدة لموازنة الحمل عبر مجموعة من Pods التي تعمل على العنقود. نظرًا لأن Pods مؤقتة بطبيعتها ويمكن استبدالها في أي وقت، توفر Service واجهة مستقرة للوصول إلى Pods التي تعمل خلفها. سنستخدم Service لاختبار تطبيقنا.ستمكننا هذه الموارد الثلاثة من استضافة نقطة نهاية قابلة للتوسع لتقديم تطبيقنا.
مع تشغيل العنقود، يمكننا الآن نشر تطبيق واختباره. سننشئ تطبيقًا باستخدام مجموعة بيانات مصنف iris الشهيرة.
المستودع متاح في https://github.com/shubham-rai-tf/iris-classifier-kubernetes. يحتوي بالفعل على الكود البرمجي لبناء التنبؤات وتقديمها عند نقطة النهاية /iris/classify_iris باستخدام fastapi.
نحتاج إلى حزم هذا الكود في صورة Docker لتجهيزه لـ kubernetes. يتم توفير Dockerfile في المستودع للقيام بذلك - هنا.
يحدد Dockerfile هذا الصورة التي سنحتاجها لإنشاء حاوية تستضيف نقاط نهاية التنبؤ في خادم uvicorn على المنفذ 5000. تتوفر المزيد من التفاصيل حول الصيغة هنا.
نفذ هذا الأمر لبناء صورة محلية -
$ docker build . -t iris-classifier:poc
...
$ docker image ls
REPOSITORY       TAG  IMAGE ID      CREATED         SIZE
iris-classifier  poc  549913d5b1f9  12 seconds ago  737MB
يمكننا أن نرى أن الصورة قد تم إنشاؤها بنجاح باسم iris-classifier وعلامة poc. سنقوم الآن بتحميل هذه الصورة إلى العنقود لاستخدامها داخل العنقود
<aside> 💡 هذه الخطوة مطلوبة فقط لأننا لا نملك سجل صور لسحب الصورة المبنية حديثًا منه. في الإنتاج، يجب استضافة الصورة في سجل خاص مثل Dockerhub أو AWS ECR ثم سحبها إلى العنقود مباشرة
</aside>
نفذ هذا الأمر لتحميل الصورة المبنية محليًا إلى العنقود -
$ kind load docker-image iris-classifier:poc
Image: "iris-classifier:poc" with ID "sha256:549913d5b1f9456a4beedc73e04c3c0ad70da8691a8745a6b56a4f483c4f0862" not yet present on node "kind-worker2", loading...
Image: "iris-classifier:poc" with ID "sha256:549913d5b1f9456a4beedc73e04c3c0ad70da8691a8745a6b56a4f483c4f0862" not yet present on node "kind-control-plane", loading...
...
يمكنك التحقق من تحميل الصور من خلال إدراج الصور داخل أي من الحاويات الثلاث -
$ docker exec -it kind-worker crictl images
IMAGE                                TAG    IMAGE ID         SIZE
docker.io/library/iris-classifier    poc    549913d5b1f94    753MB
Kubernetes هو في الأساس نظام تصريحي. هذا يعني أننا نصف خطوط ما نريد القيام به وتعمل مكونات مستوى التحكم باستمرار على توجيه النظام نحو الوصول إلى تلك الحالة.
لتنفيذ المعمارية التي ناقشناها سابقًا، سنصف قصدنا في شكل ملف yaml الذي يعمل كسجل للقصد. في مصطلحات Kubernetes، تُسمى هذه manifests.
تحتوي جميع بيان تصريحات (manifests) Kubernetes على الحقول التالية -
apiVersion - يتم تجميع موارد متعددة معًا في نفس إصدارات api. يوفر هذا طريقة موحدة لإلغاء استخدام ميزة أو ترفيع مورد عبر إصدارات Kubernetes.kind - يحدد نوع الكائن الضبط الذي سيتم إنشاؤهmetadata - يحتوي على حقول تعمل كبيانات وصفية (metadata) للكائن المنشأ. تحدد الحقول apiVersion وkind وmetadata.name معًا موردًا فريدًا داخل namespacespec - يحتوي هذا الحقل على المواصفات الخاصة بالكائن المراد إنشاؤه. يحدد كل نوع (kind) بنيته الخاصة لهذا الحقل مع التنفيذ الخاص به.سنستخدم بيان التصريحات الموجودة في المستودع في الملفات داخل دليل manifests هنا.
يحدد الموردين لـ Kubernetes، وهما Deployment وService في deployment.yaml وservice.yaml على التوالي. فلنمر على كلا القسمين.
apiVersion: apps/v1
kind: Deployment
spec:
	# number of replicas
  replicas: 3
  template:
    spec:
      containers:
			# name of the image
      - image: iris-classifier:poc
        name: iris-classifier
يحدد بيان تصريح Deployment في deployment.yaml بشكل رئيسي مواصفات pod التي نريد نشرها من حيث اسم الصورة وعدد النسخ المتماثلة. بمجرد تطبيق هذا، سيتخذ Kubernetes خطوات باستمرار للحفاظ على عدد النسخ المتماثلة لما نحدده هنا.
apiVersion: v1
kind: Service
spec:
	# Type of the service
  type: ClusterIP
  ports:
	# Port where the service will be accessible
  - port: 8080
		# Port on the container where the traffic is to be forwarded
    targetPort: 5000
    protocol: TCP
  selector:
    app: iris-classifier
يحدد بيان تصريح Service في service.yaml كيفية موازنة الحمل عبر النسخ المتماثلة التي تم إنشاؤها بواسطة Deployment. هنا قمنا بتحديد كيفية تعيين المنفذ في الخدمة إلى المنفذ في الحاويات. نظرًا لأن تطبيقنا يعمل عند المنفذ 5000، يتم ضبط targetPort على 5000. يتم الكشف عن الخدمة على المنفذ 8080. سيتم موازنة حمل حركة مرور TCP المرسلة إلى 8080 عبر المنفذ 5000 في الحاويات.
قم بتشغيل الأمر التالي لتطبيق بيان التصريحات على Kubernetes -
$ kubectl apply -f manifests/
deployment.apps/iris-classifier created
service/iris-classifier created
تم إنشاء كلا الموردين بنجاح على العنقود. يمكننا التحقق من خلال تشغيل الأوامر التالية -
$ kubectl get service iris-classifier
NAME              TYPE        CLUSTER-IP      EXTERNAL-IP   PORT(S)    AGE
iris-classifier   ClusterIP   10.96.107.238   <none>        8080/TCP   37m
$ kubectl get deployment iris-classifier
NAME              READY   UP-TO-DATE   AVAILABLE   AGE
iris-classifier   3/3     3            3           38m
$ kubectl get pods
NAME                               READY   STATUS    RESTARTS   AGE
iris-classifier-5d97498ff9-77wqw   1/1     Running   0          39m
iris-classifier-5d97498ff9-8twjm   1/1     Running   0          39m
iris-classifier-5d97498ff9-znrz8   1/1     Running   0          39m
كما نرى، تم الكشف عن الخدمة عند المنفذ 8080 وتم إنشاء ثلاث pods كما حددنا.
قم بتعديل deployment.yaml ليحتوي على نسختين متماثلتين بدلاً من 3 وأعد التطبيق. سيقوم Kubernetes بحذف إحدى النسخ المتماثلة لتتوافق مع المواصفات.
الآن بعد أن تم إنشاء الموارد في العنقود، يمكننا التحقق من النشر الخاص بنا من خلال استدعاء النموذج باستخدام نقطة نهاية الخدمة. نظرًا لأننا نستخدم إعدادًا محليًا، سيتعين علينا إجراء port-forward للخدمة إلى منفذ على الجهاز المحلي.
<aside> 💡 في إعداد موفر السحابة، ستكون هذه الخدمة مرتبطة بموازن حمل خارجي يمكن الوصول إليه من الإنترنت إذا لزم الأمر.
</aside>
قم بتشغيل الأمر التالي لإجراء توجيه المنفذ (port forwarding) للخدمة -
$ kubectl port-forward services/iris-classifier 8080
Forwarding from 127.0.0.1:8080 -> 5000
Forwarding from [::1]:8080 -> 5000
يمكننا التحقق من خلال استدعاء نقطة النهاية /healthcheck على النموذج -
$ curl '<http://localhost:8080/healthcheck>'
"Iris classifier is ready!"
لإجراء تنبؤ اختباري، سنرسل إدخال عينة للحصول على تنبؤ -
$ curl '<http://localhost:8080/iris/classify_iris>' -X POST \\
	-H 'Content-Type: application/json' \\
	-d '{"sepal_length": 2, "sepal_width": 4, "petal_length": 2, "petal_width": 4}'
{"class":"setosa","probability":0.99}
نحصل على تنبؤ للفئة setosa باحتمالية 99%. من خلال تشغيل تنبؤات متعددة من هذه، يمكننا التحقق من أن الطلبات توجّه بالفعل إلى pods مختلفة بطريقة بالتناوب الدائري (round robin).
دعنا نحدد أولاً إزالة جميع موارد Kubernetes التي قمنا بتثبيتها -
$ kubectl delete -f manifests/
سيؤدي هذا إلى تنظيف جميع موارد Kubernetes التي أنشأناها في الأقسام السابقة. الآن يمكننا إيقاف العنقود أيضًا -
$ kind delete cluster
Deleting cluster "kind" ...
في هذا العدد، استعرضنا كيفية استضافة نموذج كخدمة قابلة للاستدعاء في Kubernetes. على الرغم من أن هذا كان مثالاً توضيحيًا حيث بنينا صورة Docker محليًا وقمنا بتشغيلها على عنقود يعمل على نفس الجهاز، إلا أن إعداد الإنتاج النموذجي يعمل بناءً على مبادئ مماثلة. يمكن تحقيق الكثير باستخدام هذين الموردين فقط.
في الأعداد القادمة، سنستكشف ميزات أخرى أكثر تقدمًا مثل تعدديّة المستأجرين (multi tenancy) والتحكم في الوصول، والتي تصبح أساسية أثناء انتقالنا إلى عمليات اليوم الثاني (day 2 operations).
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد