August 31, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.


Blazingly fast way to build, track and deploy your models!
مع تسارع المؤسسات في اعتماد النماذج اللغوية الكبيرة (LLMs)، يتحول الحوار بسرعة من مرحلة التجريب إلى الجاهزية للإنتاج. لم تعد الفرق تسأل عما إذا كان يمكن استخدام الذكاء الاصطناعي، بل كيف يمكن نشره بموثوقية وأمان وعلى نطاق واسع. يفرز هذا الانتقال مجموعة جديدة من التحديات: ضمان جودة المطالبات (Prompts)، ومنع التراجع في الأداء (Regressions)، والحفاظ على الحوكمة مع تطور النماذج والمطالبات وحالات الاستخدام.
لمواجهة هذه التحديات، تعاونت TrueFoundry وPromptfoo لتقديم حل مدمج وثيق يدمج تقييم المطالبات المنظم داخل البنية التحتية للذكاء الاصطناعي للمؤسسات. من خلال الجمع بين إمكانيات اختبار المطالبات القوية من Promptfoo وTrueFoundry AI Gateway، يمكن للمؤسسات بثقة نقل أعباء عمل الذكاء الاصطناعي إلى مرحلة الإنتاج مع الحفاظ على معايير عالية من الجودة والموثوقية والحوكمة.
في تطبيقات الذكاء الاصطناعي الحديثة، تُعد المطالبات جزءًا أساسيًا من منطق التطبيق. التغييرات الصغيرة في المطالبة — أو حتى التغيير في النموذج الأساسي — يمكن أن تؤثر بشكل كبير على جودة المخرجات، أو النبرة، أو الصحة، أو الأمان. ورغم ذلك، لا تزال العديد من المؤسسات تعتمد على الاختبار يدويًا أو المراجعات غير الرسمية للتحقق من صحة تغييرات المطالبات قبل الإصدار.
مع توسع أنظمة الذكاء الاصطناعي عبر الفرق والمنتجات، يصبح هذا النقص في الهيكلية خطرًا على الأعمال. المخرجات غير المتناسقة يمكن أن تضر بتجربة العملاء، وقد تتسلل التراجعات إلى الإنتاج دون ملاحظتها، وتواجه فرق المنصات صعوبة في تطبيق معايير الجودة عبر النطاق المتنامي للذكاء الاصطناعي. ما تحتاجه المؤسسات هو طريقة للتعامل مع المطالبات بنفس الصرامة المتبعة مع البرمجيات (Code) — تقييمها واختبارها وحوكمتها كجزء من مسار النشر (Deployment pipeline).
تم بناء Promptfoo لحل هذه المشكلة بالتحديد. فهو يوفر إطار عمل لتقييم مطالبات LLM عبر مجموعات البيانات والنماذج وحالات الاختبار، مما يتيح للفرق قياس الجودة كمياً بدلاً من الاعتماد على حدسهم. باستخدام Promptfoo، يمكن للفرق مقارنة المخرجات عبر النماذج، وتحديد معايير تقييم مخصصة، واكتشاف التراجعات مبكرًا في دورة حياة التطوير.
والأهم من ذلك، يتيح Promptfoo أن يصبح تقييم المطالبات قابلاً للتكرار والترقية إلى الآلية (Automated). بدلاً من الاعتماد على المراجعات المؤقتة، يمكن للفرق دمج اختبارات المطالبات في سير عمل CI/CD، مما يدعم هندسة المطالبات المؤتمتة من خلال ضمان التحقق من صحة كل تغيير في المطالبة مقابل توقعات محددة بوضوح قبل وصوله إلى الإنتاج.
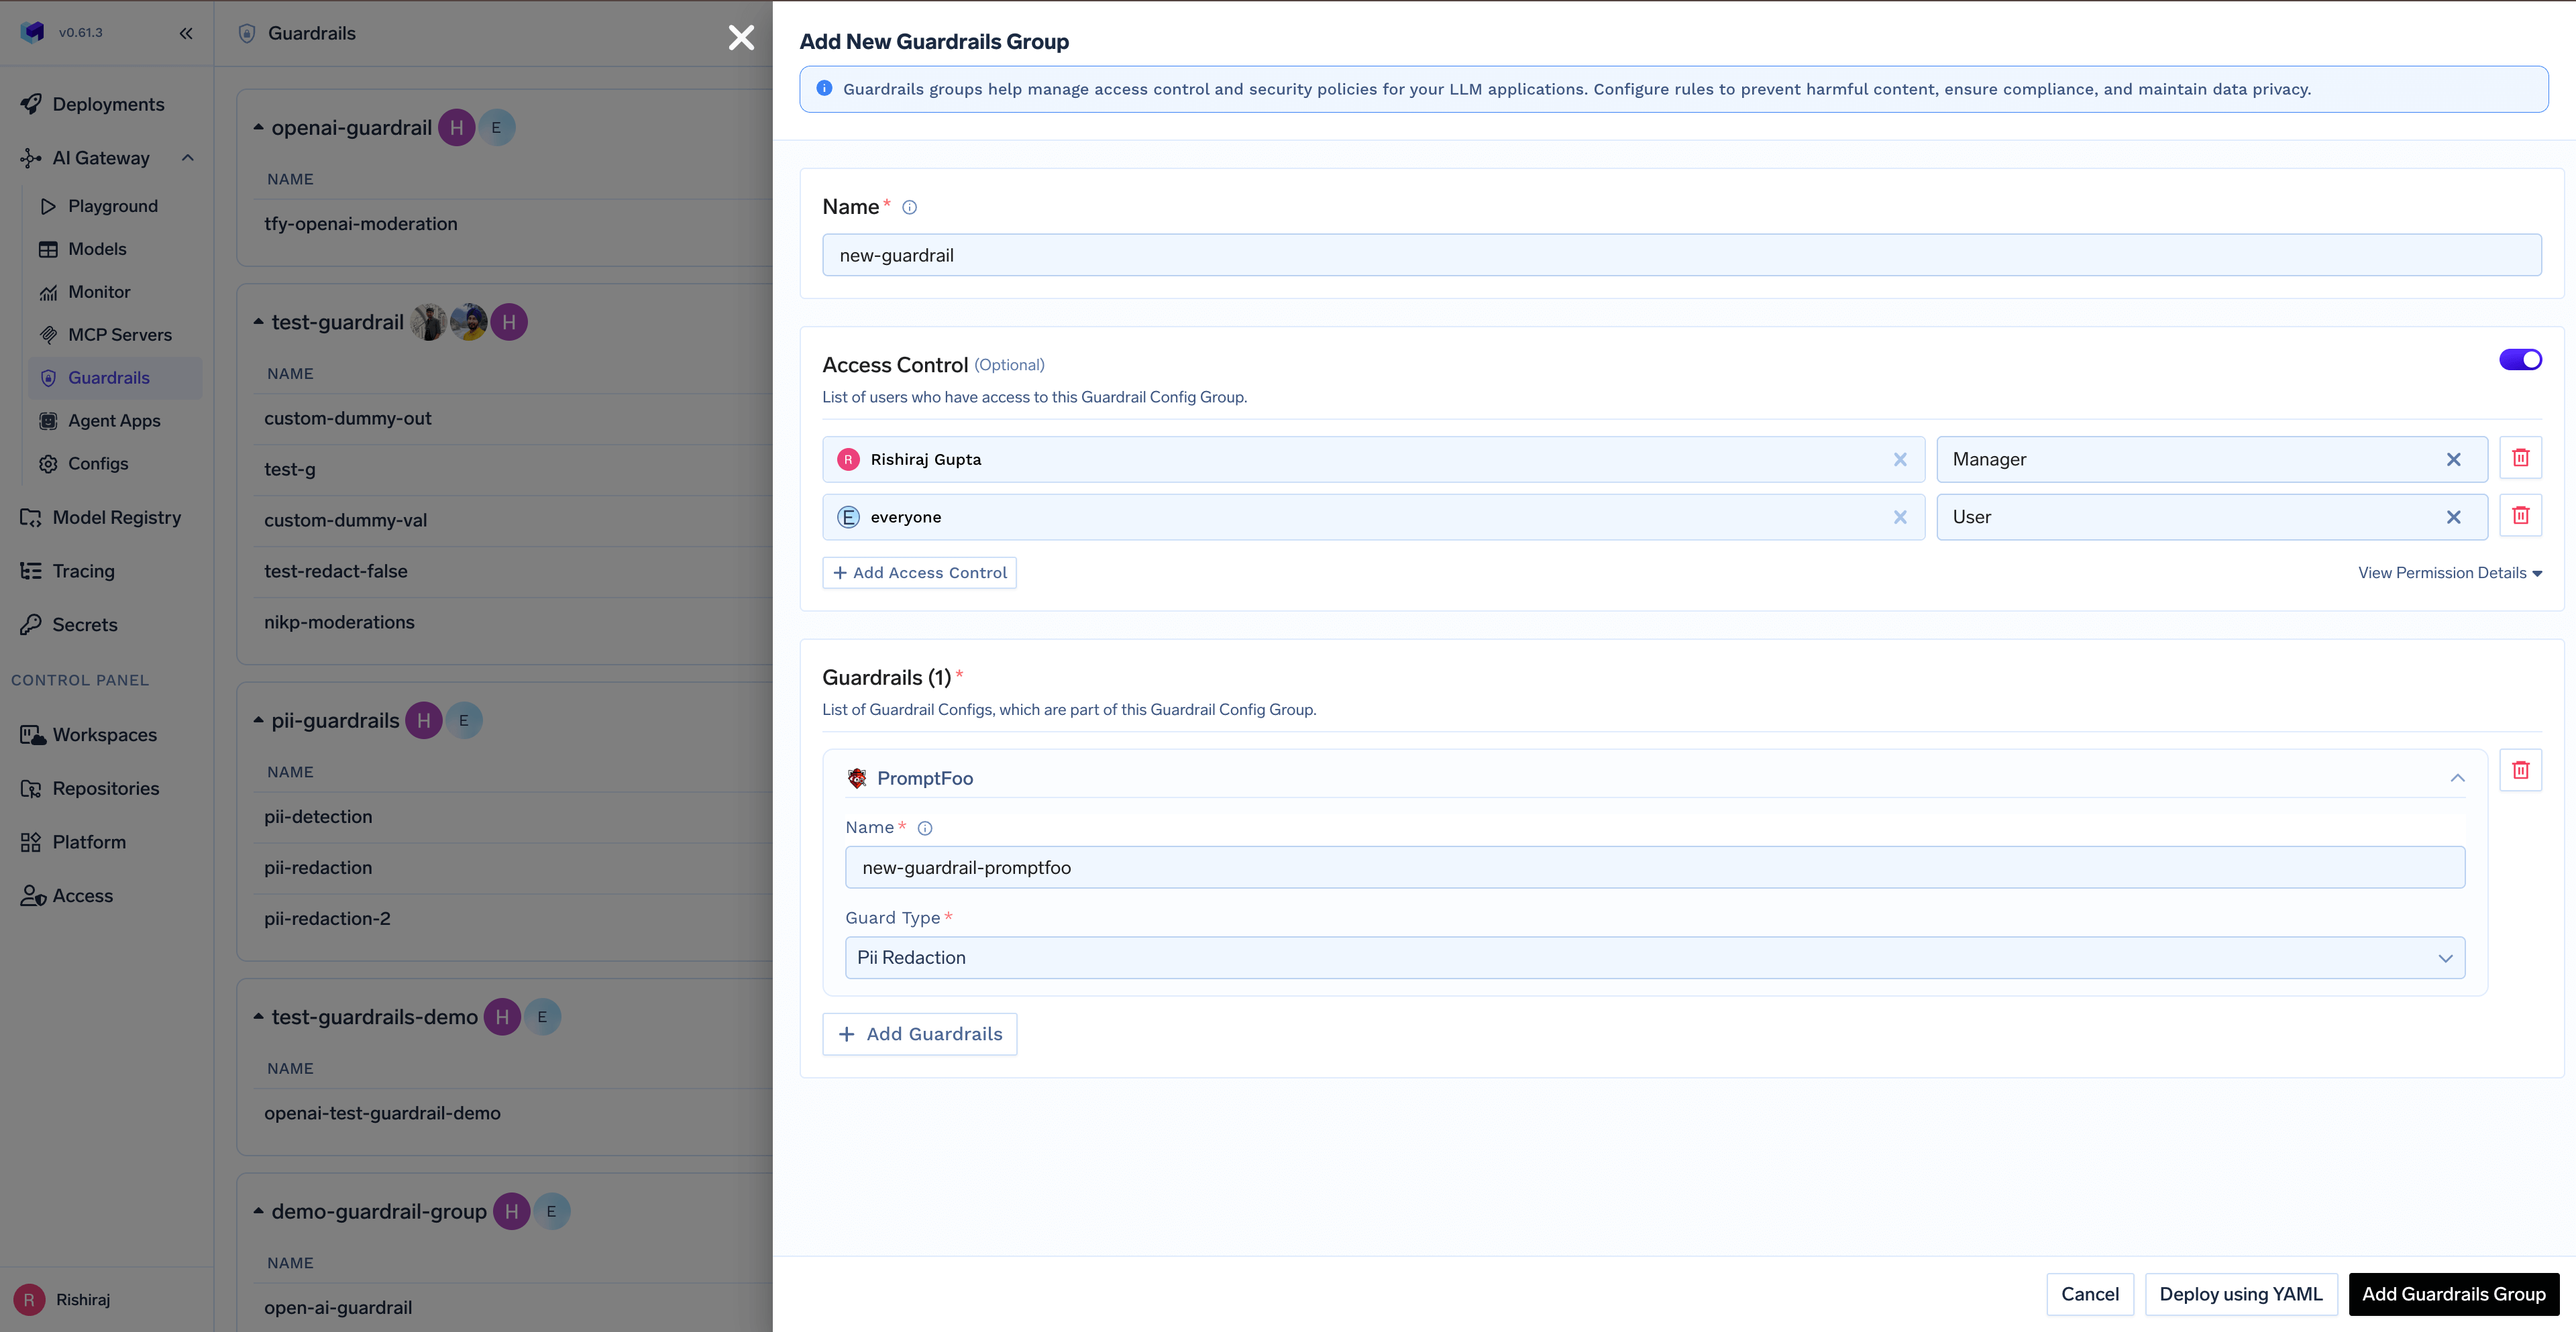
في حين أن تقييم المطالبات أمر ضروري، تحتاج المؤسسات أيضًا إلى طريقة آمنة وموحدة لتشغيل الذكاء الاصطناعي على نطاق واسع. هنا يأتي دور TrueFoundry AI Gateway الحيوي. يوفر AI Gateway طبقة API موحدة للوصول إلى المئات من LLMs وخوادم MCP وإدارتها، مع تطبيق متطلبات المؤسسات مثل المصادقة، والتحكم في الوصول، وإمكانية الملاحظة (Observability)، وتطبيق السياسات.
من خلال تركيز حركة مرور الذكاء الاصطناعي عبر Gateway، تكتسب المؤسسات الرؤية والتحكم في كيفية استخدام النماذج عبر الفرق والبيئات. يضمن هذا النهج المعماري أن الابتكار في الذكاء الاصطناعي لا يأتي على حساب الأمان أو الامتثال أو التعقيد التشغيلي.
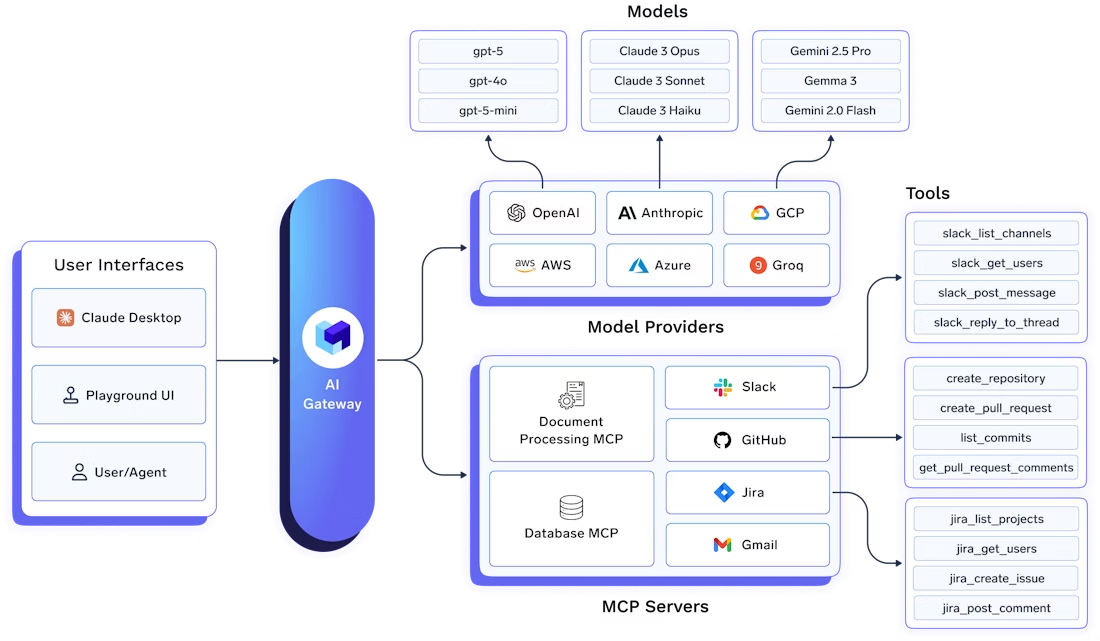
يجمع التكامل بين Promptfoo وTrueFoundry AI Gateway هاتين الإمكانيتين معًا في سير عمل سلس. يمكن الآن تهيئة تقييمات Promptfoo كـ حواجز حماية (Guardrails) داخل Gateway، مما يسمح بتقييم كل طلب مقابل معايير الجودة والسلوك المحددة.
هذا يعني أن تقييم المطالبات لم يعد مقتصرًا على بيئات التطوير أو الاختبار. بدلاً من ذلك، يصبح سياسة قابلة للتطبيق على مستوى البنية التحتية. الطلبات التي تفشل في معايير التقييم يمكن وضع علامة عليها، أو تسجيلها في السجلات، أو حظرها، مما يضمن وصول سلوك الذكاء الاصطناعي المعتمد فقط إلى المستخدمين الأنظمة التابعة.
من خلال تضمين تقييم المطالبات مباشرة في AI Gateway، تكتسب المؤسسات آلية واحدة ومستمرة لتطبيق الجودة عبر النماذج والفرق والتطبيقات.
من منظور الأعمال، يساعد هذا التعاون المؤسسات على التحرك بشكل أسرع دون زيادة المخاطر. يقلل تقييم المطالبات المؤتمت من الوقت المستغرق في المراجعات اليدوية واستكشاف الأخطاء وإصلاحها، مما يتيح للفرق إطلاق ميزات الذكاء الاصطناعي بسرعة أكبر وبثقة أكبر. في الوقت نفسه، يضمن التطبيق المركزي عبر Gateway الاتساق، حتى مع توسع استخدام الذكاء الاصطناعي عبر المؤسسة.
بالنسبة لقادة المنصات والهندسة، يبسط هذا التكامل الحوكمة. بدلاً من الاعتماد على أدوات مجزأة وعمليات غير رسمية، يمكن للفرق تحديد معايير للجودة على مستوى المؤسسة للمطالبات وتطبيقها بانتظام. يؤدي هذا إلى وقوع حوادث إنتاج أقل، وتحسين ثقة العملاء، وتحقيق توافق أفضل بين سرعة الهندسة وتوقعات الأعمال.
يعكس الشراكة بين TrueFoundry وPromptfoo تحولاً أوسع في كيفية تعامل المؤسسات مع الذكاء الاصطناعي. مع أيلولة LLMs لتصبح حجر الزاوية للمنتجات وسير العمل، تحتاج المؤسسات إلى بنية تحتية لا تدعم التجريب فحسب، بل تدعم أيضًا الموثوقية والحوكمة على المدى الطويل.
من خلال الجمع بين البنية التحتية للذكاء الاصطناعي على مستوى المؤسسات وتقييم المطالبات المنظم، تمكّن TrueFoundry وPromptfoo الفرق من التعامل مع المطالبات كمكونات أساسية من الدرجة الأولى في دورة حياة البرمجيات — يتم اختبارها، وحوكمتها، ونشرها بثقة.
يمكن للمؤسسات بدء استخدام هذا التكامل عن طريق تهيئة Promptfoo كـ guardrail داخل TrueFoundry AI Gateway وتحديد معايير التقييم المتوافقة مع متطلبات أعمالها ومنتجاتها. من هناك، تصبح جودة المطالبة معيارًا قابلاً للتطبيق بدلاً من أن تكون مجرد ممارسة تعتمد على أفضل الجهود.
لمعرفة المزيد حول كيفية إعداد واستخدام هذا التكامل، استكشف وثائق TrueFoundry:
https://truefoundry.com/docs/ai-gateway/promptfoo
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد