



November 16, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.


Blazingly fast way to build, track and deploy your models!
لقد مررنا جميعًا بتلك اللحظة مع Code Interpreter الخاص بـ ChatGPT (المعروف حاليًا بـ "Advanced Data Analysis"). تقوم بتحميل ملف CSV غير منظم، وتطلب منه "تعديل التواريخ ورسم الاتجاه بيانيًا"، وتراقب بذهول كيف يكتب وينفذ كود Python في الوقت الفعلي.
إنها أداة خارقة للإنتاجية. ولكنها في الوقت نفسه ثغرة أمنية هائلة إذا كنت تعمل مع بيانات حساسة.
في اللحظة التي تقوم فيها بتحميل ملف CSV هذا، فإنه يغادر محيطك الأمني. بالنسبة لفريقنا، كان الهدف هو تكرار قدرة "OpenCode" هذه – بمنح وكلاء LLM لدينا القدرة على كتابة الأكواد وتنفيذها – دون مخاطر تسريب البيانات. لم نكن نريد API عبارة عن "صندوق أسود"؛ بل كنا بحاجة إلى Private Code Interpreter حيث تتم الحوسبة بجوار البيانات مباشرة.
إليك كيفية تطبيق Tool Usage وتنفيذ الأكواد بأمان باستخدام مكونات البنية التحتية لـ TrueFoundry.
لا يقتصر "OpenCode" على مجرد امتلاك نموذج يمكنه كتابة Python. بل يتطلب ثلاثة مكونات متميزة تعمل بتناغم:
يعلق معظم الأشخاص عند مرحلة "الأيدي". لا يمكنك مجرد السماح لـ LLM بتشغيل os.system('rm -rf /') على بيئة الإنتاج الخاصة بك. أنت بحاجة إلى sandbox.
تعالج TrueFoundry هذه المشكلة عن طريق السماح لنا بنشر بيئات تنفيذ مؤقتة (Services أو Jobs) تعمل كـ sandbox. يتولى LLM Gateway التعامل مع تعريفات استخدام الأدوات، بينما يتم التنفيذ الفعلي داخل حاوية مقفلة تمامًا ضمن VPC الخاص بنا.
إليك سير العمل لكيفية تحول طلب المستخدم إلى تنفيذ آمن للكود.
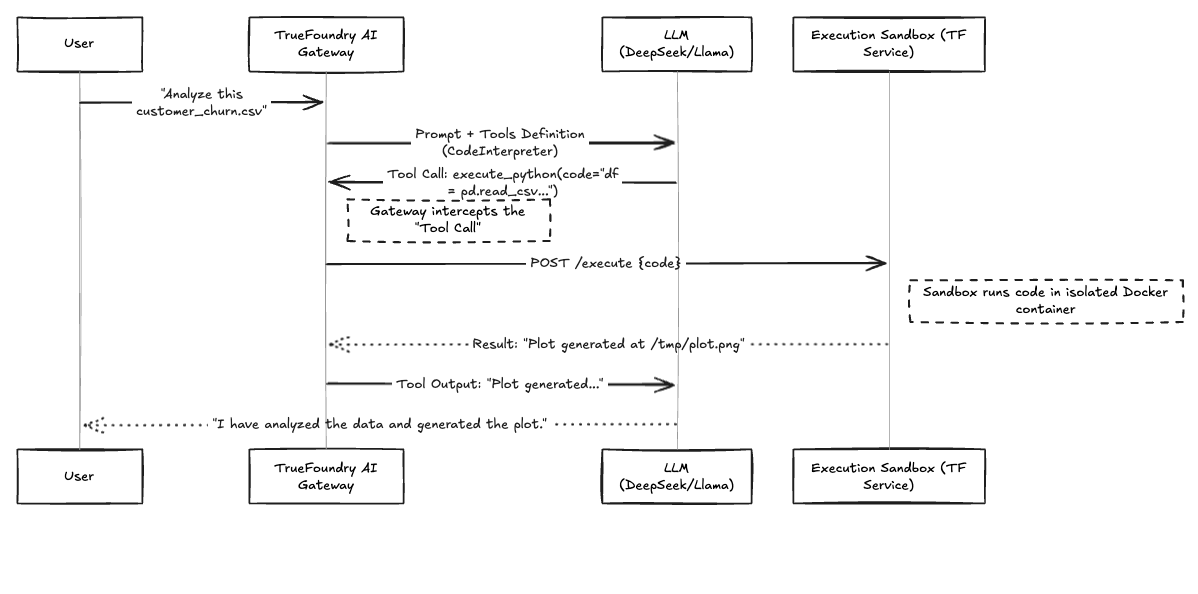
الشكل 1: سير عمل حلقة تنفيذ OpenCode
عندما حاولنا بناء هذا لأول مرة، استخففنا بمدى تعقيد بيئة التنفيذ. إذا كنت تستخدم API قياسيًا لـ SaaS Code Interpreter، فإنك ترسل بياناتك إليهم. وإذا قمت بتشغيله محليًا، فإنك تخاطر بالمساس بالجهاز المستضيف.
نحن نستخدم TrueFoundry Services لاستضافة "Code Execution Agent" مخصص. هذا عبارة عن خدمة Python FastAPI مغلفة في حاوية Docker تحتوي على:
نظرًا لأن TrueFoundry تدير بيان Kubernetes الأساسي، يمكننا حقن هذه القيود الأمنية (SecurityContext، NetworkPolicies) مباشرة من واجهة مستخدم النشر أو Terraform، مما يضمن أن الـ sandbox يعمل كبيئة معزولة بحق.
طالمات كانت المفاضلة بين الراحة والتحكم. من خلال استغلال TrueFoundry لتنسيق نمط "OpenCode"، نغير هذه المعادلة. نحصل على راحة النشر المُدار دون مخاطر البيانات.
الجدول 1: هذا مثال على مقارنة Gateway و Sandbox
تظهر القوة الحقيقية عندما تجمع بين Tool Usage و APIs الداخلية لديك.
قمنا بتهيئة TrueFoundry LLM Gateway لإظهار ليس فقط أداة "Python Interpreter"، بل وأيضًا أدوات لبحيرة البيانات الداخلية لدينا (مثل get_user_churn_metrics(user_id)).
نظرًا لأن LLM يوجه الطلبات عبر Gateway، و Gateway متصل بخدماتنا الخاصة، يمكن للنموذج الآن:
كل هذا يحدث دون خروج بايت واحد من بيانات العملاء من الشبكة الفرعية الخاصة بنا.
لم يعد تطبيق "OpenCode" مجرد مشروع هافاثون ممتع؛ بل أصبح متطلبًا لوكلاء AI الحديثين. ولكن لا يمكنك مجرد تجميعه بشكل عشوائي مع LangChain وتأمل الأفضل.
نحن نتعامل مع Code Interpreter كـ بنية تحتية حيوية. نقوم بمراقبته باستخدام حزمة الملاحظة والترصد (observability) الخاصة بـ TrueFoundry – حيث نترقب ليس فقط tokens الـ LLM، بل وارتفاعات CPU في الـ sandbox وزمن انتقال التنفيذ. إذا كتب مستخدم برنامجًا نصيًا يحاول تخصيص 50 جيجابايت من RAM، فإن TrueFoundry تقوم بإنهاء الـ pod قبل أن يؤثر على العنقود (cluster)، ويتلقى المستخدم رسالة خطأ مهذبة.
هذا هو الفرق بين العرض التوضيحي والمنصة الحقيقية.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد




















