



November 6, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.



Blazingly fast way to build, track and deploy your models!
من السهل مراقبة واجهة برمجة تطبيقات المدفوعات لأنها روتينية. فالمُدخلات نفسها تنتج مسار الكود نفسه، لذا فإن ثلاثة مقاييس — معدل الطلبات، ومعدل الخطأ، والمدة — تخبرك بكل شيء تقريبًا. وعندما يحدث خلل، يمكنك قراءة تتبع المكدس (stack trace)، وهو حقيقة برمجية وليس مجرد تخمين للنوايا.
يكسر الوكيل كل الافتراضات الواردة في تلك الجملة. فالنموذج يختار المسار أثناء التشغيل، لذا لا تؤدي المُدخلات نفسها بالضرورة إلى مسار الكود نفسه. وغالبًا لا يوجد خطأ على الإطلاق: ينتهي الوكيل من عمله، ويعيد نصًا، وتكون جميع استدعاءات HTTP التي أجراها قد نجحت (200). وما يحدث من خطأ عادةً ليس تعطلًا، بل هو قرار — لقد اختار الأداة الخطأ، أو أعاد قراءة ملف كان بحوزته بالفعل، أو استمر في إعادة محاولة بحث لن يكتب له النجاح أبدًا.
لذا يتحول السؤال من: هل كان يعمل، إلى لماذا فعل ذلك. وكلمة "لماذا" هي خاصية تتعلق بالتسلسل الكامل، وليس بأي طلب فردي — وهذا هو السبب في أن لوحة التحكم قد تبدو سليمة بينما يفشل وكيلك. فزمن الاستجابة (P99) البالغ 900 مللي ثانية عبر كل استدعاء للنموذج لا يخبرك بشيء عن عملية تشغيل أجرت 140 استدعاءً.
تتكون البيانات من أربعة مستويات متداخلة، اثنان منها فقط في الأسفل يشبهان الطلبات التقليدية.
المستويان الأوسطان هما اللذان يحملان القيمة الحقيقية، وهما بالضبط المستويان اللذان لا يغطيهما متتبع نطاق الطلب التقليدي. فهو يرى مجموعة من الاستدعاءات الخارجية دون أصل ذي معنى، ولا يمكنه إخبارك بأن الاستدعاءات من 11 إلى 27 كانت عبارة عن دورة واحدة تحاول القيام بالشيء نفسه سبع مرات.
هناك خاصية واحدة تجعل هذا الأمر مختلفًا تمامًا عن التتبع الموزع: أي مستوى يمكن أن يدخل في حلقة تكرارية. لا يوجد ما يعادل هذا في مخطط الخدمة العادي — حيث تستدعي A الخدمة B التي تستدعي C، وإذا استدعت A نفسها، فهذا يعني وجود خطأ برمجي. أما في الوكيل، فإن الخطوة التي تقرر استدعاء نفسها مرة أخرى هي حالة طبيعية، والطريقة الوحيدة للتمييز بين الحلقة التكرارية المثمرة وتلك العالقة هي قراءة التسلسل.
يحتاج كل مستوى إلى إشاراته الخاصة. فجمع كل شيء في كل مكان ينتج بيانات بلا رؤى، لذا فهذا هو الحد الأدنى الذي يستحق الجهد.
تُعد الخلية الأخيرة هي الإشارة الأكثر قيمة في مراقبة الوكلاء، ومع ذلك لا يكاد أحد يسجلها: استدعاء الأداة نفسها مرتين بنفس الوسائط ضمن دورة واحدة يعني وجود حلقة تكرارية. يصبح الأمر بديهياً بمجرد وضع الوسائط على النطاق (span)، لكنه مستحيل باستخدام المقاييس الإجمالية.
ثلاثة أنماط تغطي تقريباً كل حوادث الإنتاج.
1. حلقة إعادة المحاولة الصامتة. يقوم الوكيل بالبحث في قاعدة معرفية، ولا يحصل على أي نتيجة مفيدة، فيعيد صياغة البحث، ثم يبحث مجدداً — عشرين مرة. كل عملية بحث تعيد رمز الحالة 200 في 300 مللي ثانية، لذا تظهر لوحات تحكم معدل الطلبات ومعدل الأخطاء زيادة طفيفة في حركة المرور ولا شيء غير ذلك. أما على مستوى الجلسة، فالأمر لا يمكن تفويته: دورة واحدة، عشرون استدعاء للأداة، ومدة زمنية تصل إلى دقيقتين. التشخيص لا يكمن في أي نطاق (span) منفرد، بل في التكرار.
2. الأداة التي تنجح بينما تعيد بيانات غير مفيدة. تصل أداة جلب المستندات إلى حاجز أذونات وتعيد رمز حالة 200 مهذباً، بينما يكون محتوى الاستجابة صفحة تسجيل دخول بتنسيق HTML. يقرأ النموذج الصفحة ويبلغ بأنه لا توجد سياسة بهذا الاسم. لا توجد أخطاء في أي مكان. الطريقة الوحيدة لاكتشاف ذلك هي التقاط النتيجة الخام، ولهذا السبب يعد التقاط النتائج، وليس مجرد رموز الحالة، أمراً أساسياً لا غنى عنه.
3. تشغيل الـ 40x. متوسط تكلفة الجلسة هو 0.04 دولار؛ بينما كلفت إحدى الجلسات 1.60 دولار، ولم يحدث أي فشل. في خطوة واحدة، تمت إعادة قراءة ملف كبير إلى السياق، واستمر هذا الملف في مرافقة كل دورة لاحقة، وتراكمت الرموز (tokens) المدخلة لبقية فترة التشغيل. يمكنك العثور على ذلك من خلال ترتيب الجلسات حسب التكلفة وقراءة عدد الرموز لكل دورة في الحالات الشاذة حتى تلاحظ التغير المفاجئ. لن تجد ذلك أبداً في المتوسط.
النمط المشترك بين الحالات الثلاث هو: الشذوذ عبارة عن علاقة بين الخطوات. الأداة التي تخزن الخطوات بشكل مستقل قد تخلصت من الشيء الذي تحتاجه.
يمكن التقاط هذا دون الحاجة إلى إضافة أدوات قياس إلى كود الوكيل الخاص بك، لأن التنفيذ والمراقبة يحدثان في مكان واحد. يمر كل استدعاء للنموذج والأداة عبر بوابة، لذا يتم تسجيل مسار العمل كأثر جانبي لخدمته — لا شيء يتم إعادة بنائه من سجلات متناثرة، ولا مجال للاستثناء.
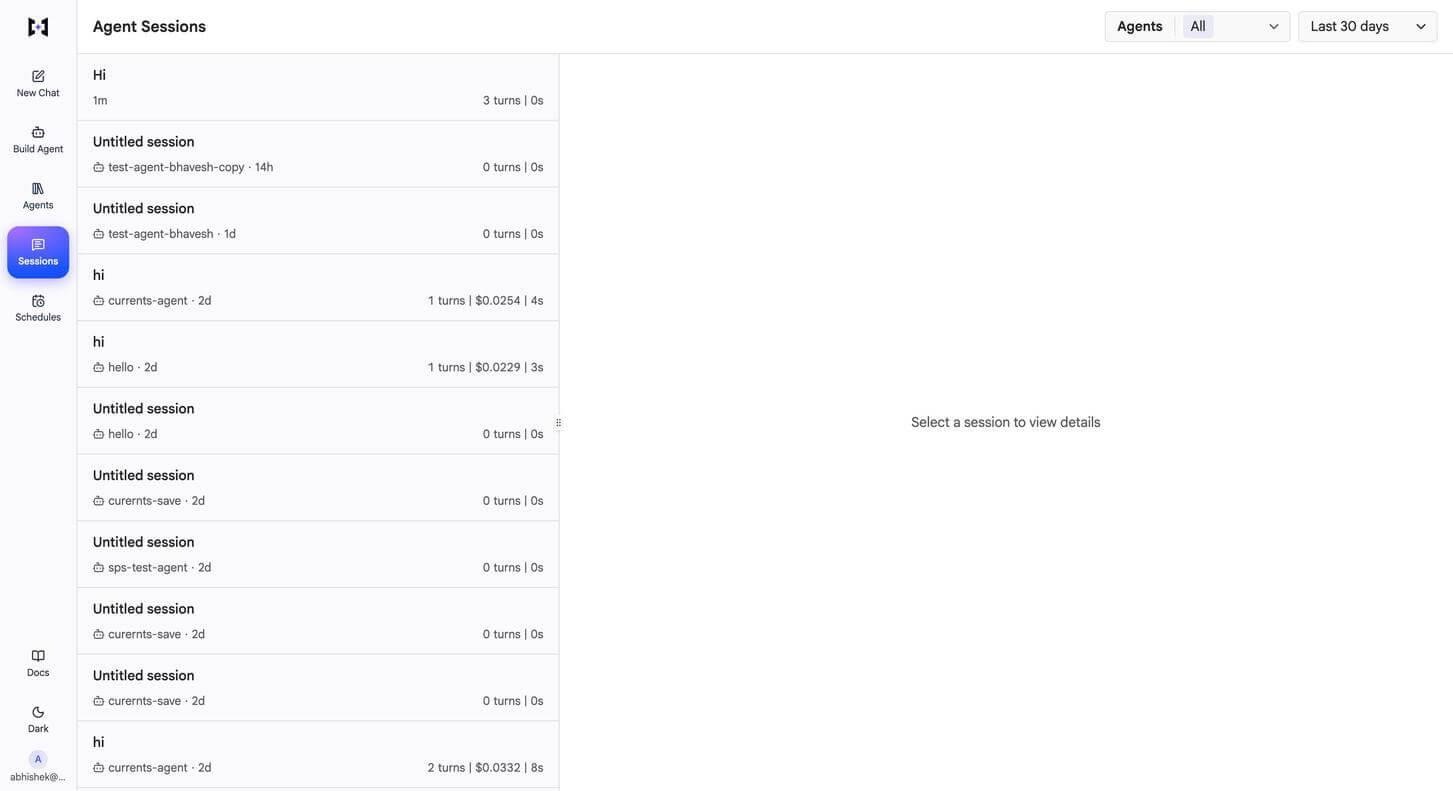
بالنسبة للوكلاء على منصة TrueFoundry، الجلسات تسرد كل محادثة عبر كل وكيل — رسالة البدء، الوكيل، عدد الدورات، التكلفة، والمدة. هذا كافٍ للمسح السريع بحثاً عن عمليات التشغيل المكلفة أو الطويلة جداً دون الحاجة لفتح أي شيء، وهو بالضبط ما يتطلبه نمط الفشل الثالث.
يؤدي فتح الجلسة إلى توفير العناصر الثلاثة التي تتطلبها التسلسلات الهرمية. تغطي المقاييس الإجمالية الأدوار، والمدة، والتكلفة، والرموز (tokens)، والسياق، واستدعاءات الأدوات، والوكلاء الفرعيين، والأخطاء.. يقوم جدول زمني من نوع الأحداث بتقسيم التشغيل إلى قطاعات النظام، والمستخدم، والنموذج، واستدعاءات الأدوات لكل دور؛ فالدور الذي يطغى عليه لون استدعاء الأداة يكون مرتبطاً بالأداة، والدور الذي يطغى عليه لون النموذج يكون مرتبطاً بالنموذج، مما يتيح الرؤية بلمحة سريعة بدلاً من الحساب. أسفل ذلك يوجد سجل المحادثة، مع الرموز لكل دور، والمدة، والتكلفة، ولوحة قابلة للتوسيع لـ خطوات الوكيل تعرض استدعاءات الأدوات بالترتيب مع نتائجها.
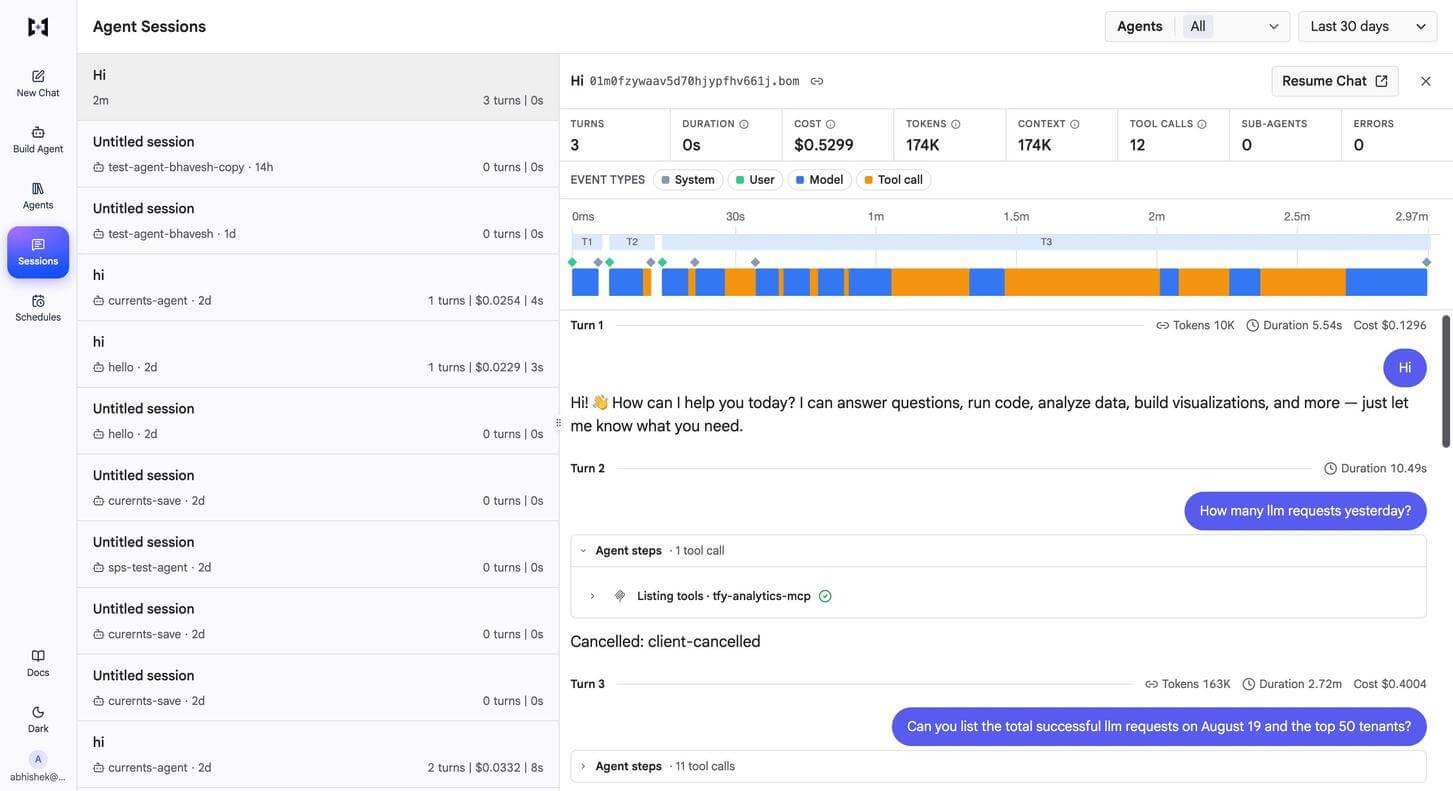
تلك القائمة المرتبة للخطوات هي المكان الذي يصبح فيه الدور الملغي، أو خادم MCP المتعطل، أو نتيجة الأداة الفارغة مرئياً. يمكن استئناف الجلسة كمحادثة مباشرة من نفس العرض، وهي الطريقة التي تؤكد بها الإصلاح.
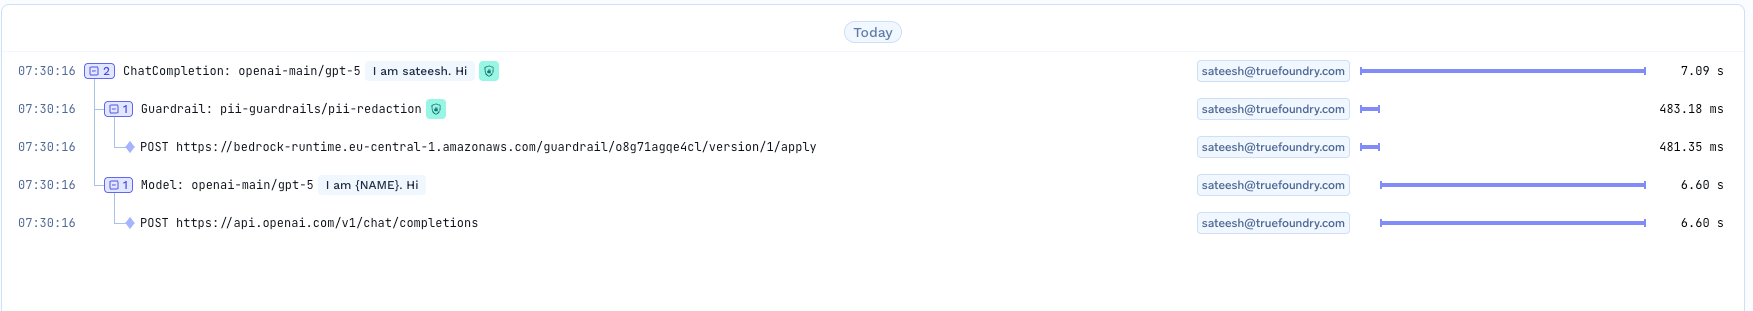
على مستوى أدنى، التتبع هو تسلسل هرمي حقيقي للنطاقات، وليس سجلاً مسطحاً. ينتج عن إكمال محادثة واحدة مع وجود حاجز حماية (guardrail) للبيانات الشخصية خمسة نطاقات: ChatCompletion جذر بدون أصل، ونطاق Guardrail تحته، والاستدعاء الصادر لحاجز الحماية تحته، ونطاق Model ، والاستدعاء الصادر للنموذج تحته.
تجعل سمات النطاق التكلفة وزمن الاستجابة قابلة للنسب بدلاً من التقدير. يحمل النطاق الجذري tfy.model.metric.cost_in_usd، وinput_tokens، وoutput_tokens، وlatency_in_ms، وtime_to_first_token_in_ms، وinter_token_latency_in_ms، إلى جانب tfy.input وtfy.output وtfy.triggered_guardrail_fqns، ويسجل كل نطاق الموضوع الذي أنشأه. النطاقات قابلة للاستعلام: client.traces.query_spans(...) مع عامل تصفية trace_ids ونافذة زمنية تعيد التسلسل الهرمي بأكمله، مقسماً إلى صفحات، وهي الطريقة التي تنتقل بها من "هذه الجلسة كانت مكلفة" إلى "هذا النطاق كان مكلفاً".
يظهر تنفيذ حاجز الحماية كنطاق خاص به مع النتيجة وزمن الاستجابة والنتائج المكتشفة، كما يتم تتبع الطلبات المحظورة أيضاً؛ فالدعوة المرفوضة تعتبر دليلاً، وليست فجوة.
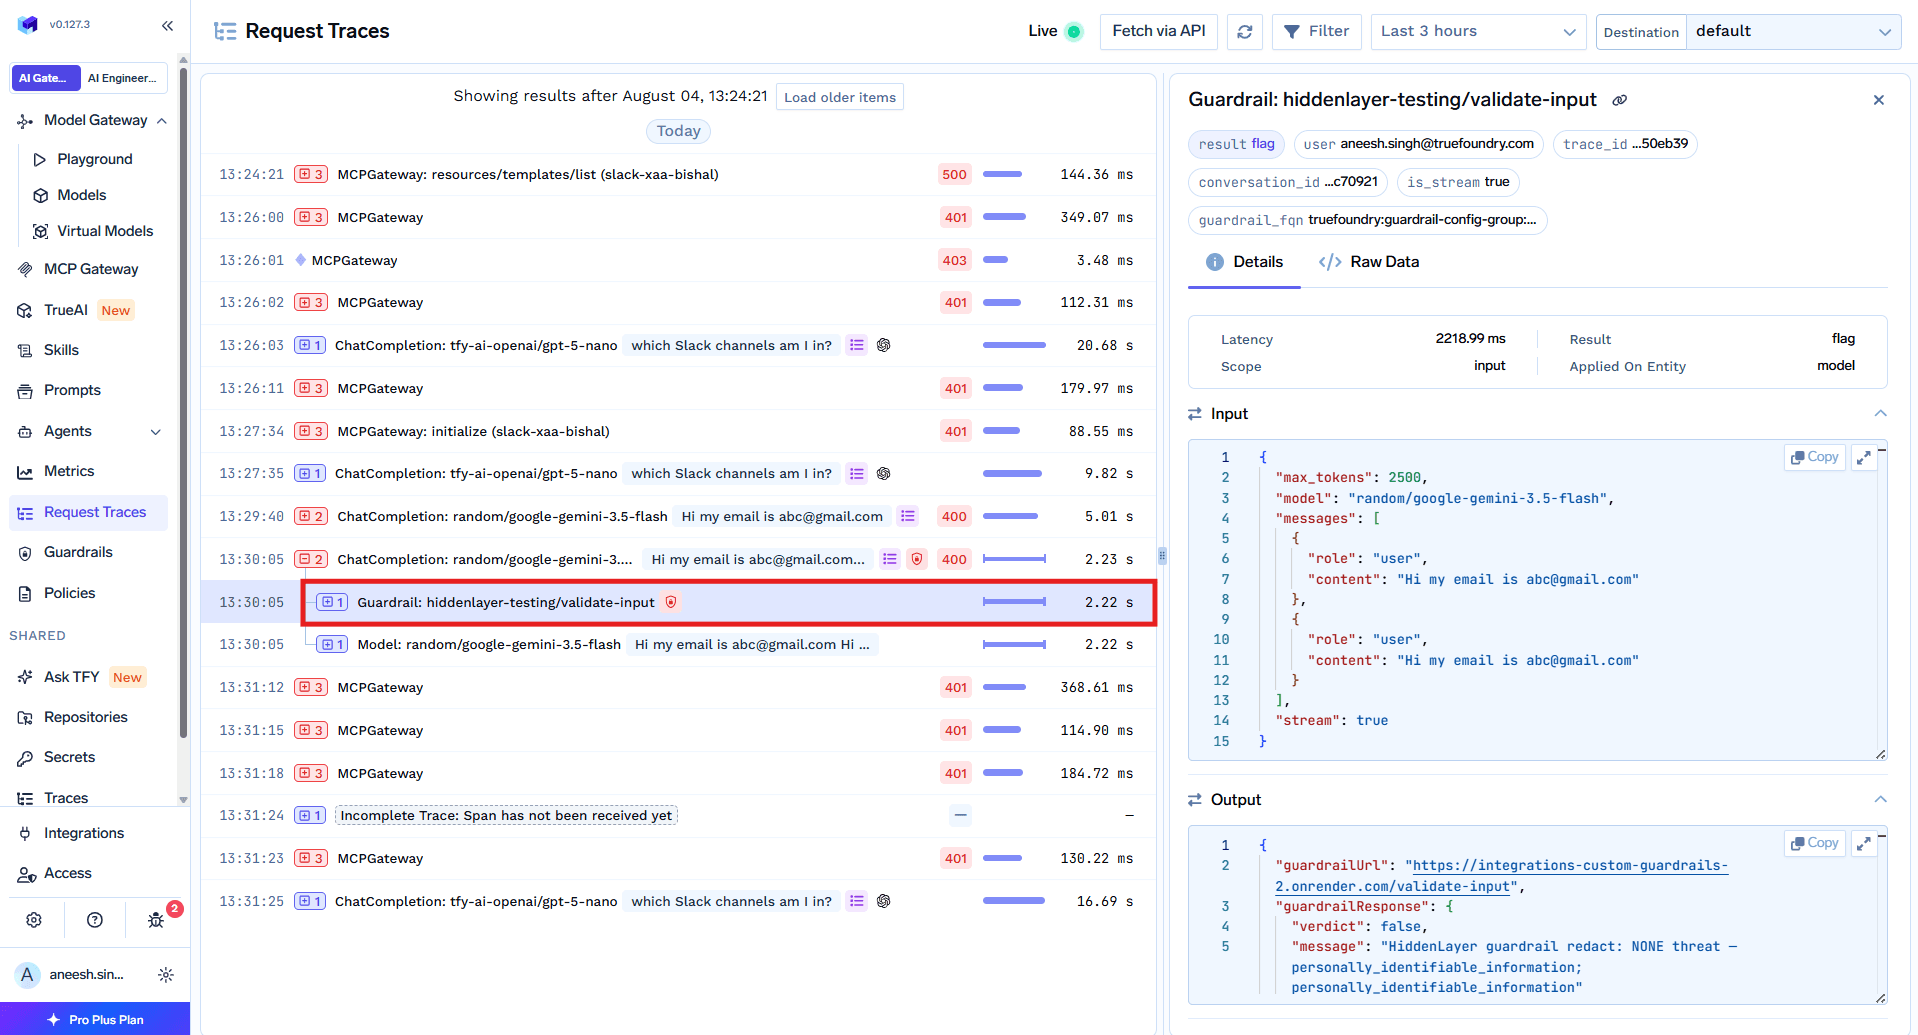
توجد التجميعات في لوحة تحكم المقاييس. تتضمن مقاييس النموذج رموز الإدخال والإخراج، وعدد الطلبات، والتكلفة الإجمالية، بالإضافة إلى الإنتاجية، ومعدل الفشل، وتفصيل الفشل حسب نوع الخطأ. يأتي زمن الاستجابة عند P50 و P75 و P90 و P99 عبر أربعة مقاييس — زمن الاستجابة الشامل، والوقت المستغرق للرمز الأول، وزمن الاستجابة بين الرموز، والوقت لكل رمز إخراج — وهو أمر مهم لأن بطء الرمز الأول وبطء تدفق الرموز لهما أسباب مختلفة.
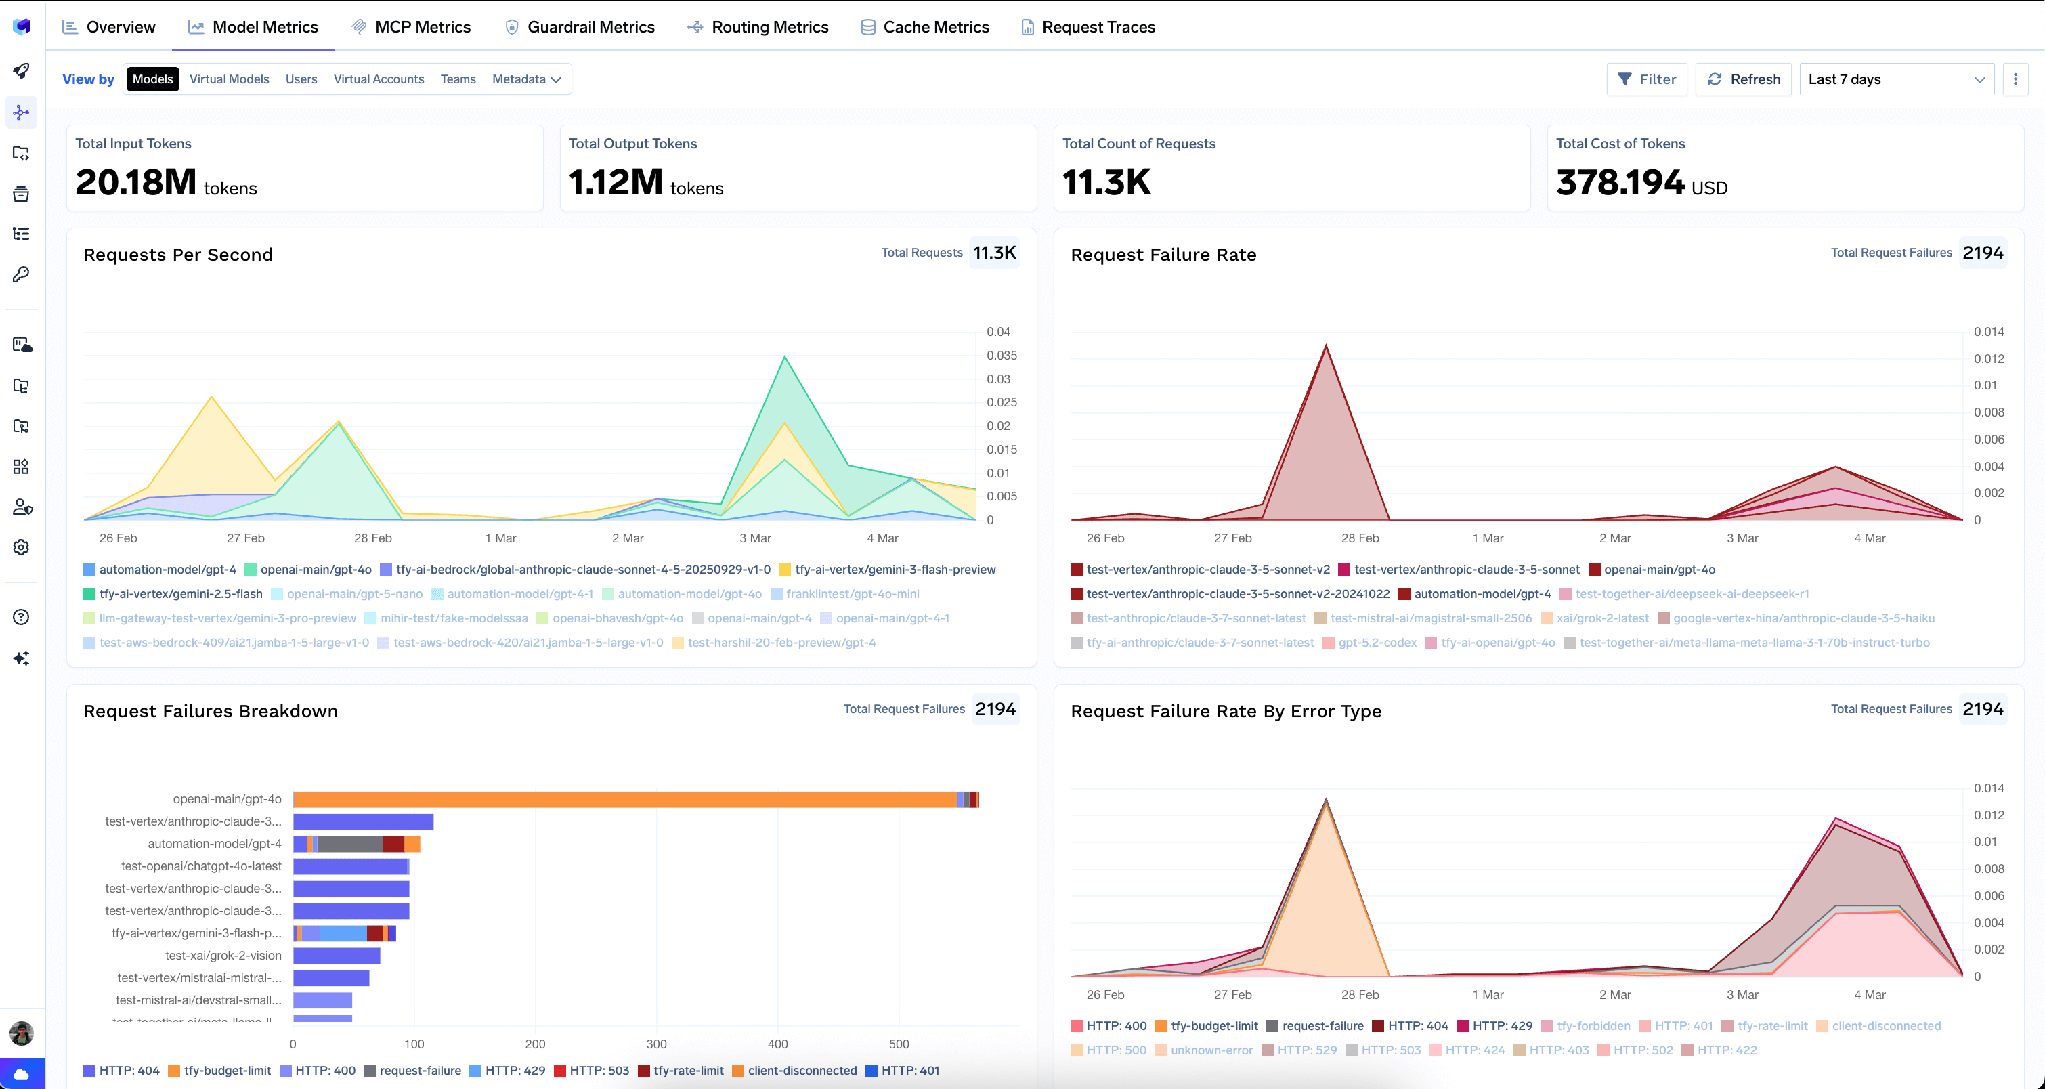
يتم تدوير كل مخطط من خلال عرض حسب محدد — النماذج، أو النماذج الافتراضية، أو المستخدمون، أو الحسابات الافتراضية، أو الفرق، أو مفاتيح البيانات الوصفية المخصصة المرسلة كرؤوس طلبات. خطط للبيانات الوصفية مبكراً: أرسل اسم الوكيل أو معرف التشغيل وستحصل على رؤى حول التكلفة وزمن الاستجابة لكل وكيل دون الحاجة لبناء أي شيء.
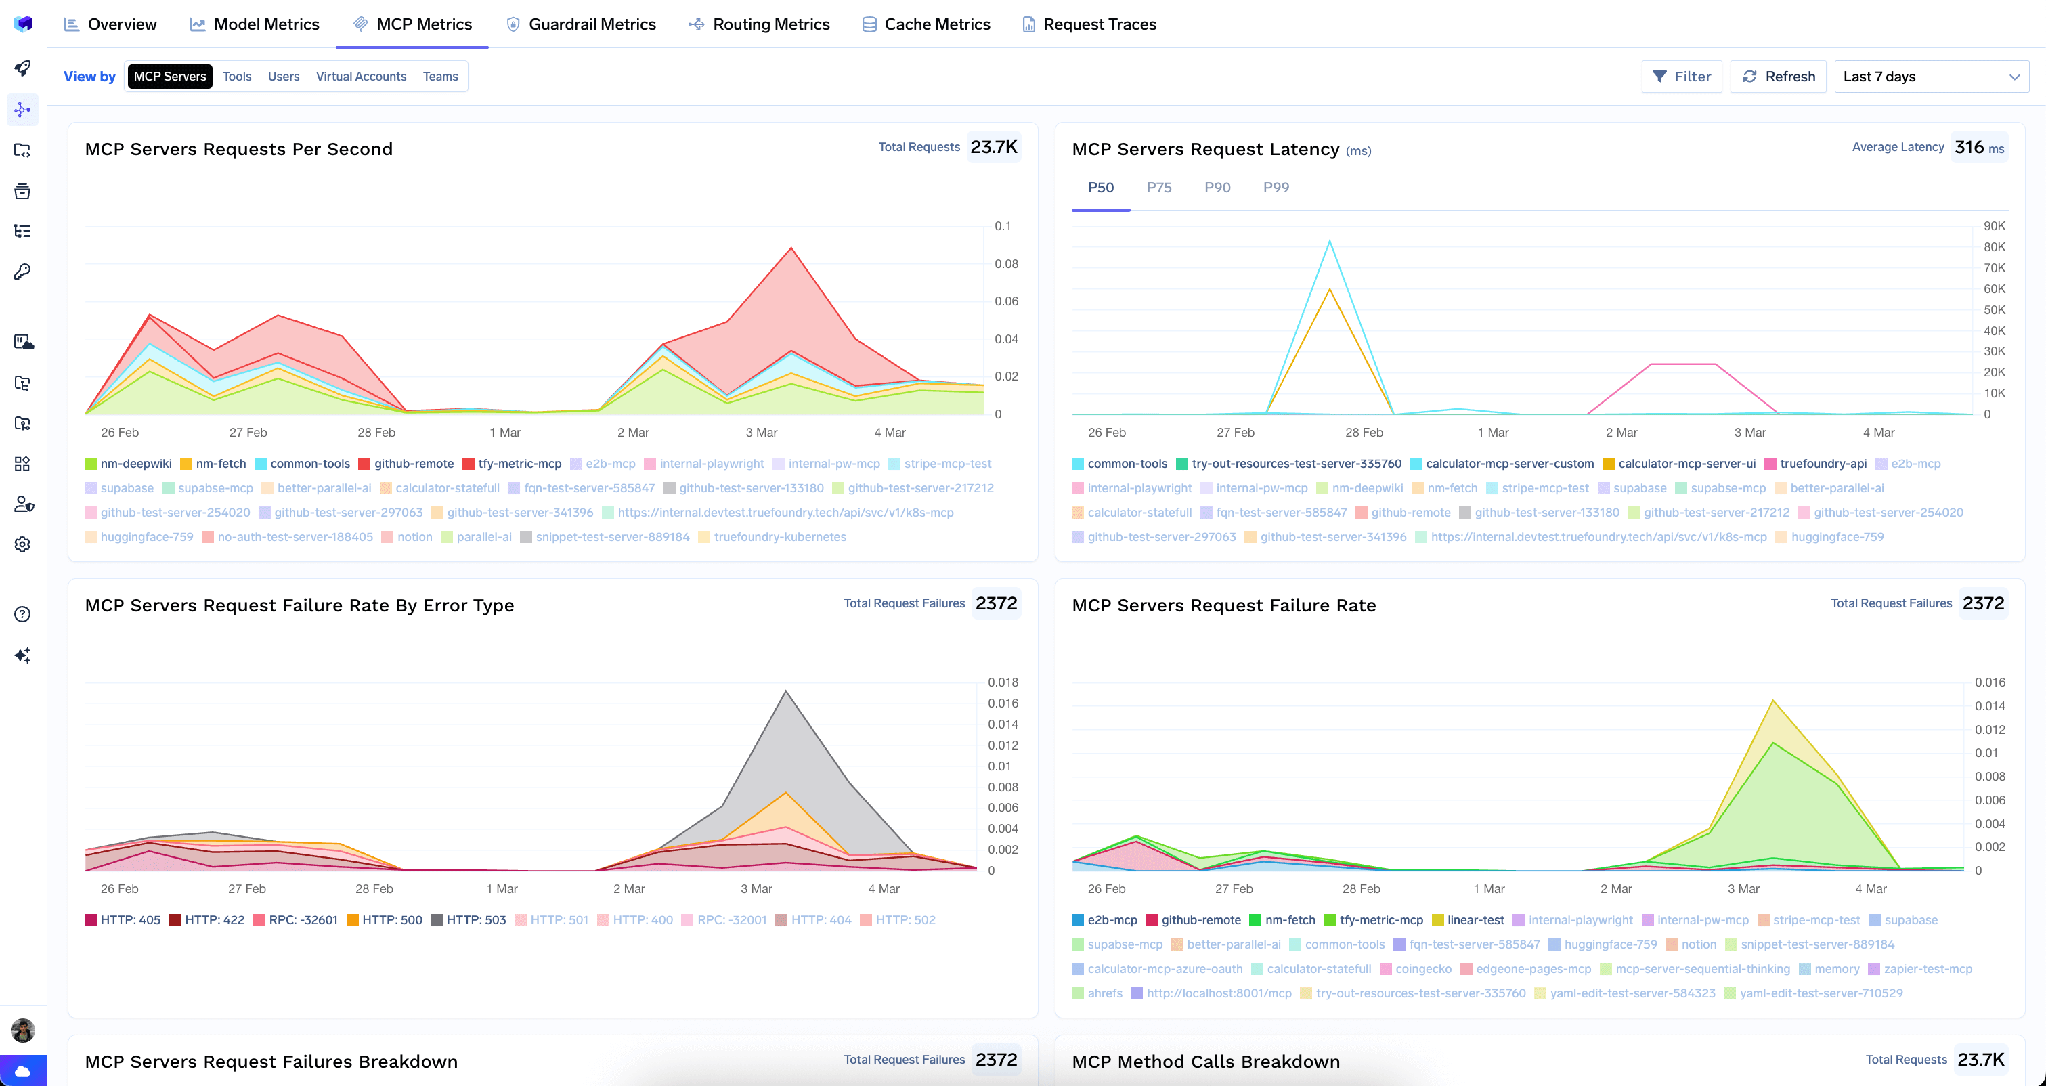
تحصل استدعاءات الأدوات على نفس المعالجة من خلال مقاييس MCP — وهو الجزء الذي تتجاهله معظم الإعدادات التي تركز على النماذج اللغوية الكبيرة. يوفر عرض الخوادم الإنتاجية لكل خادم، ومئويات زمن الاستجابة، ومعدل الفشل، وتفصيل الأخطاء، بالإضافة إلى تفصيل استدعاءات الطرق عبر tools/list و tools/call و resources/list وبقية الطرق. الوكيل الذي يستهلك الطلبات في استدعاءات متكررة لـ tools/list لديه مشكلة في الاكتشاف، وليس مشكلة في المهمة.
يتعمق عرض الأدوات في الأدوات الفردية عبر جميع الخوادم: الطلبات في الثانية، ومئويات زمن الاستجابة، ومعدل الفشل حسب نوع الخطأ، وملخص زمن الاستجابة جنباً إلى جنب، وترتيب الأدوات حسب عدد الطلبات. هذا الترتيب هو أسرع طريقة لاكتشاف أداة يعتمد عليها الوكيل بشكل أكبر مما كنت تتوقع.
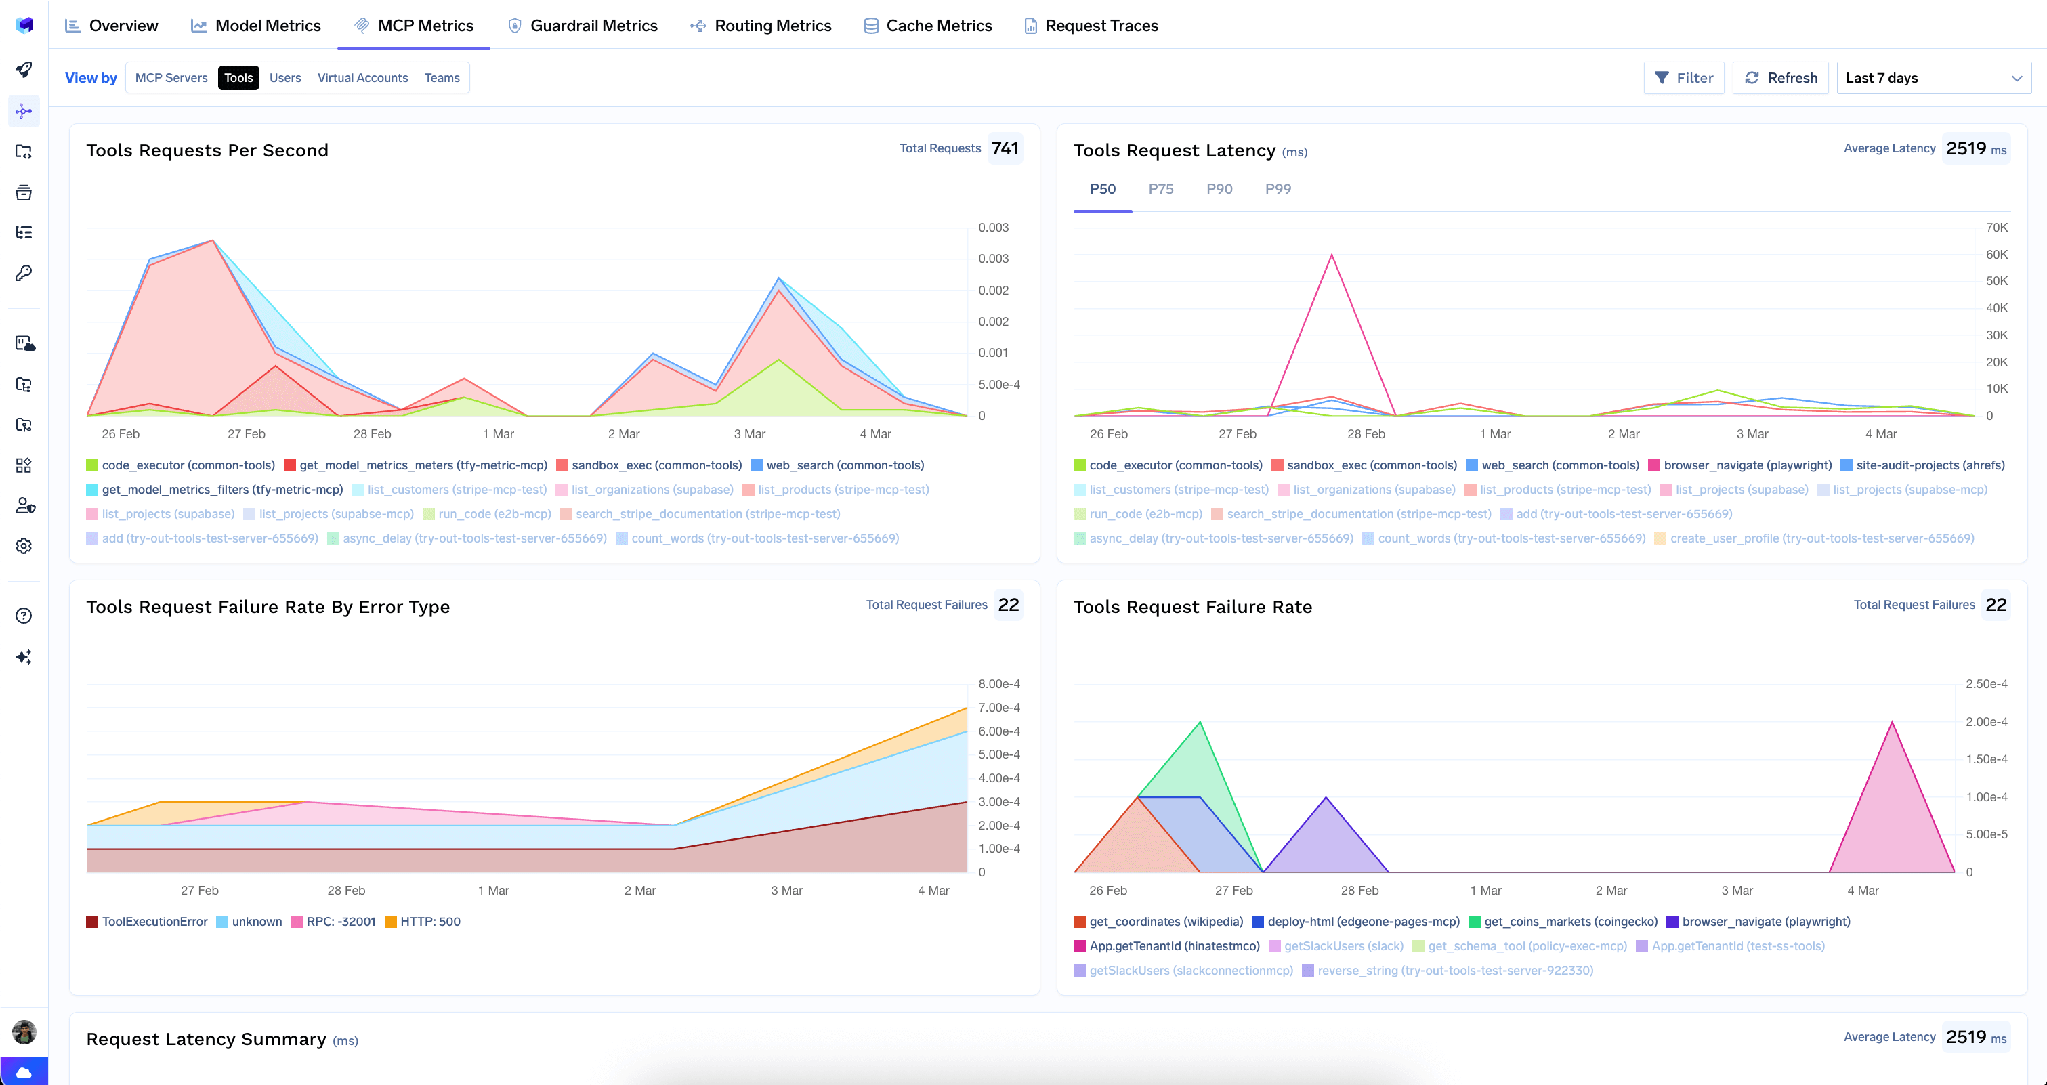
تستمر عوامل التصفية عبر علامات التبويب، لذا فإن التضييق على مستخدم واحد في علامة تبويب النموذج يحافظ على هذا الفلتر عند التبديل إلى MCP — وهي الطريقة التي تعرف بها ما إذا كانت جلساتهم البطيئة مشكلة في النموذج أو مشكلة في الأداة دون إعادة بناء الاستعلام.
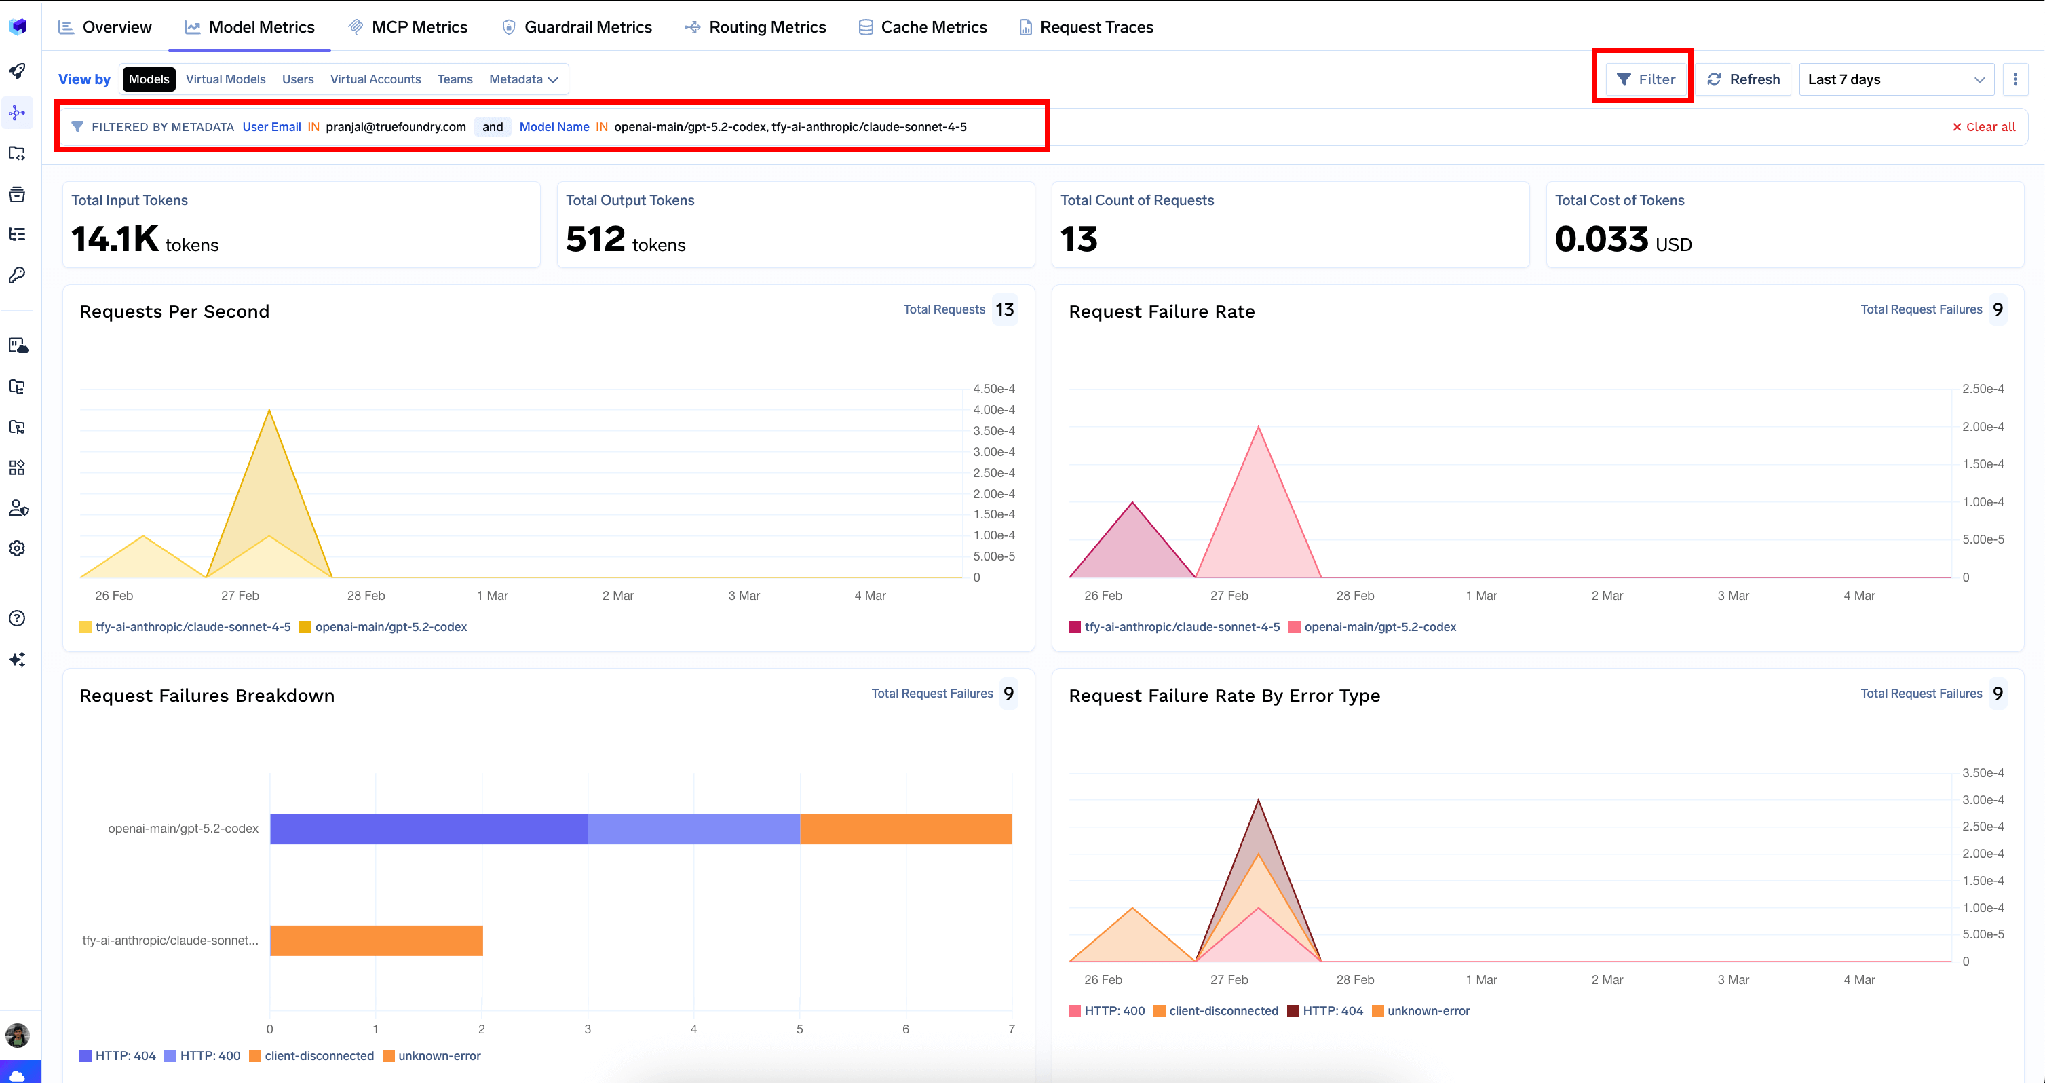
تحصل الوكلاء المسجلون على لوحة تحكم واحدة تغطي أعداد الطلبات، ومئويات زمن الاستجابة، ومعدلات الخطأ، والاستخدام بمرور الوقت — وهي متطابقة سواء كان الوكيل يعمل على Bedrock أو LangGraph أو خدمة مخصصة.

يمكن الاستعلام عن البيانات نفسها: توفر واجهة برمجة تطبيقات المقاييس مصدر بيانات agentMetrics الذي يعيد نتائج التوزيع أو السلاسل الزمنية مجمعة حسب اسم الوكيل (agentName)، أو إطار عمل الوكيل (agentFramework)، أو نوع خادم الوكيل (agentServerType)، مع تجميعات مئوية لزمن الاستجابة بالمللي ثانية (latencyMs). في الأنظمة متعددة الوكلاء، تتبعات الطلبات تسجل أي وكيل قام بكل استدعاء ولأي مستخدم عمل — وهو الإسناد الذي يجعل استدعاء الأداة من قبل وكيل فرعي قابلاً للتتبع وصولاً إلى الشخص المسؤول.
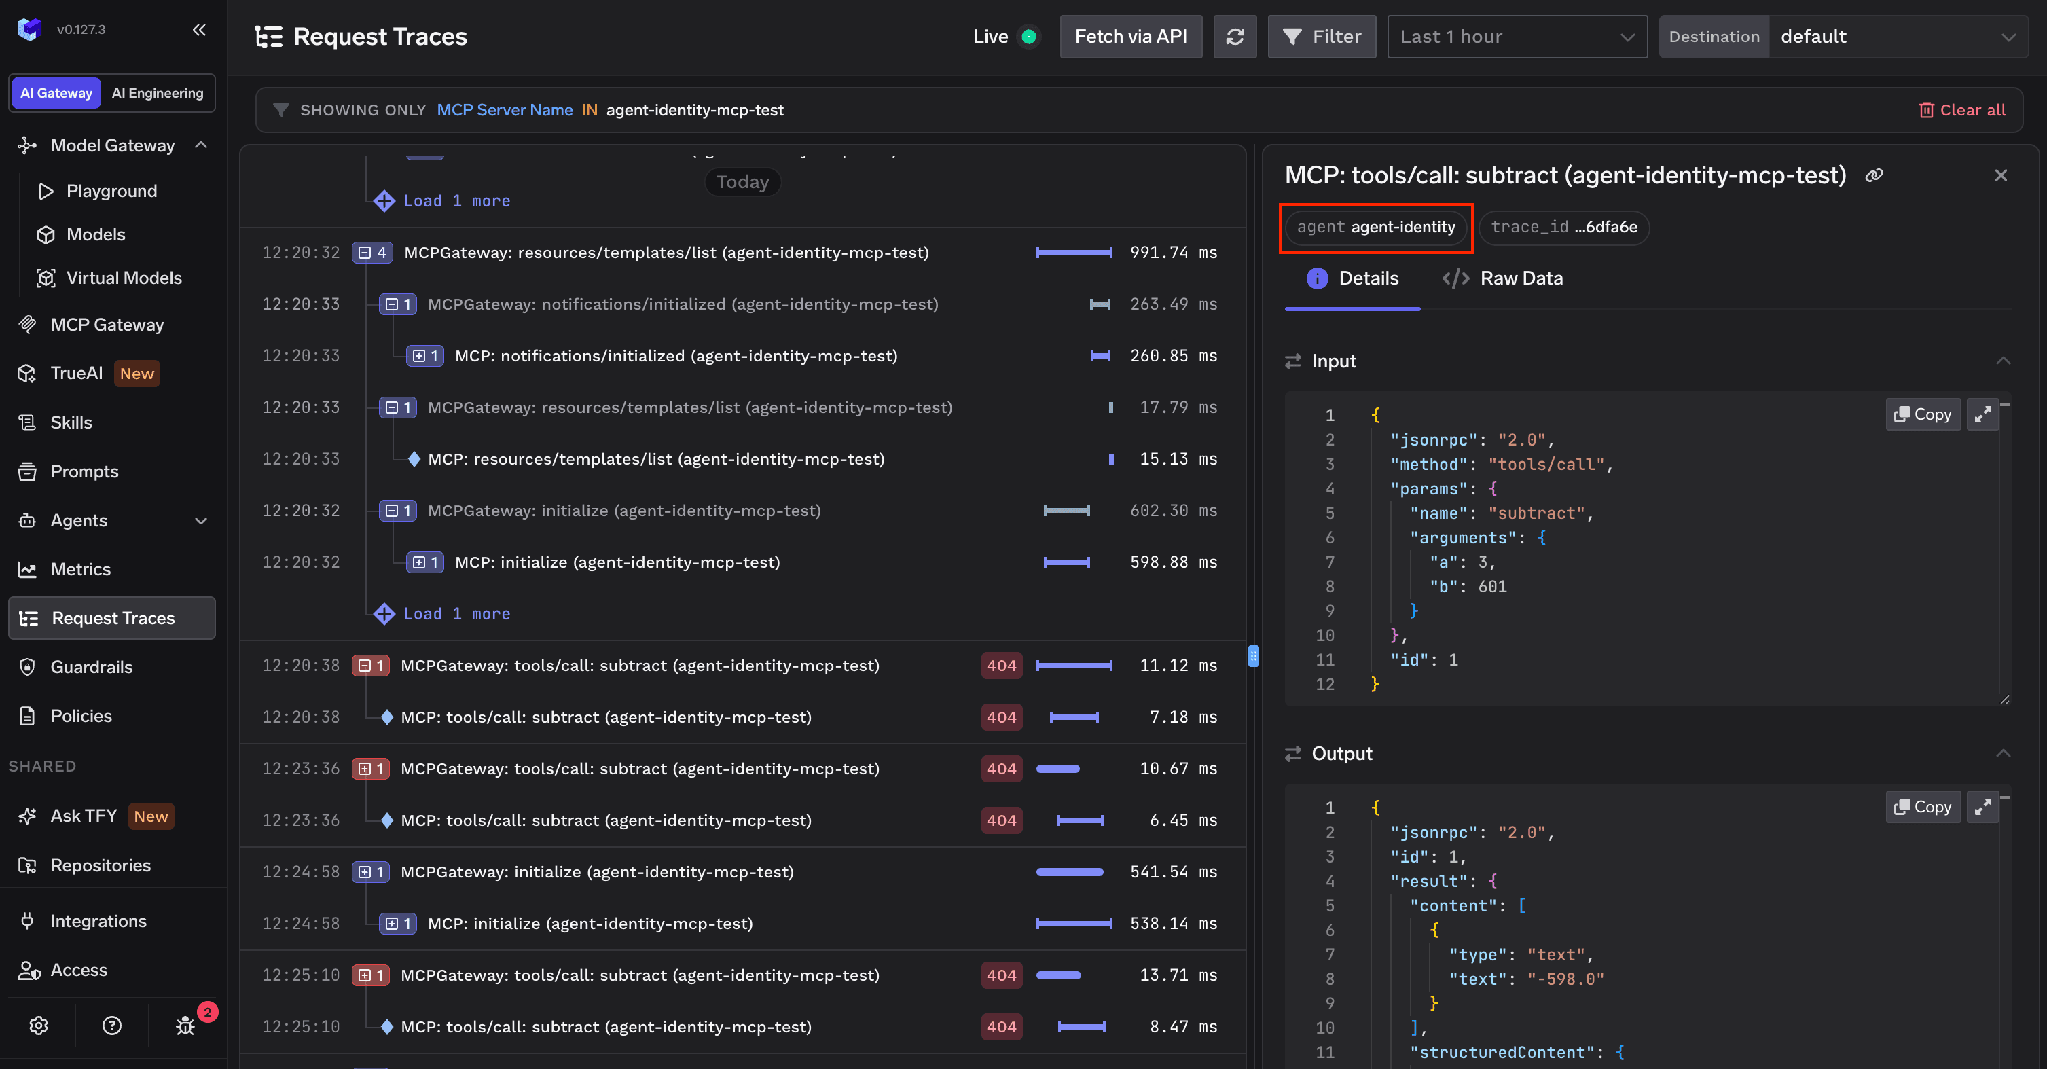
قيد واحد صريح: عرض سلسلة الفاعلين بالكامل الذي يربط المستخدم ← الوكيل ← الوكيل الفرعي ← الأداة في تتبع واحد مرسوم سيتاح قريباً، وكذلك اكتشاف الانحراف، وتنبيهات الشذوذ، وتعليق الوكيل بنقرة واحدة. حالياً، تحصل على إسناد لكل قفزة (hop) في كل تتبع بدلاً من رسم السلسلة كصورة واحدة.
يمكن قياس زمن الاستجابة والتكلفة، لكن لا يمكن قياس جودة الإجابة، ولهذا السبب يجب أن تكون الملاحظات مرتبطة بالتتبع بدلاً من جدول منفصل. تُرجع كل استجابة من البوابة ترويسة x-tfy-feedback-target-id. قم بإرسال ذلك إلى /api/svc/v1/gateway-feedback مع تقييم من 1 إلى 5 وتعليق اختياري، وسيظهر بجانب النطاق (span) وفي البيانات الأولية تحت tfyGatewayFeedbacks، مع إمكانية التحديث أو الحذف باستخدام المعرف المُعاد. يستهدف معرف الهدف حالياً النطاق الجذري (root span)، لذا يتم إرفاق الملاحظات بالطلب، وليس بخطوة فرعية.
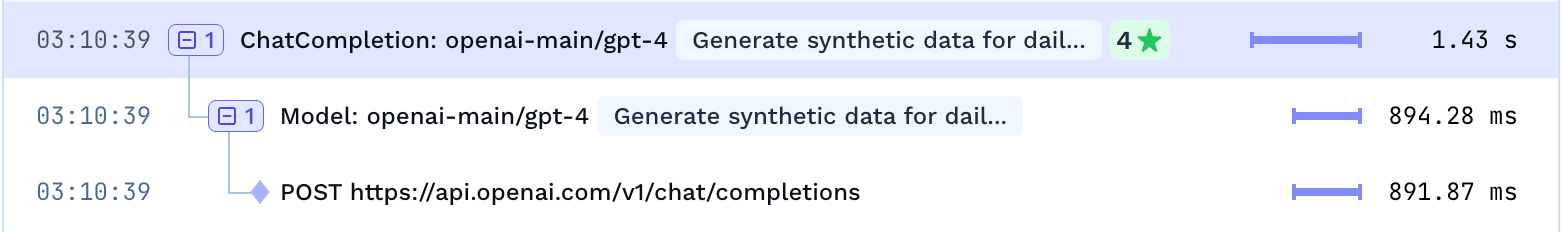
اربط ذلك بعنصر تحكم "إعجاب" في منتجك، وستحصل جلسات القيم المتطرفة على تصنيف جودة، مما يحول "هذه العملية كلفت 40 ضعفاً" إلى "هذه العملية كلفت 40 ضعفاً وقيمها المستخدم بـ 2".
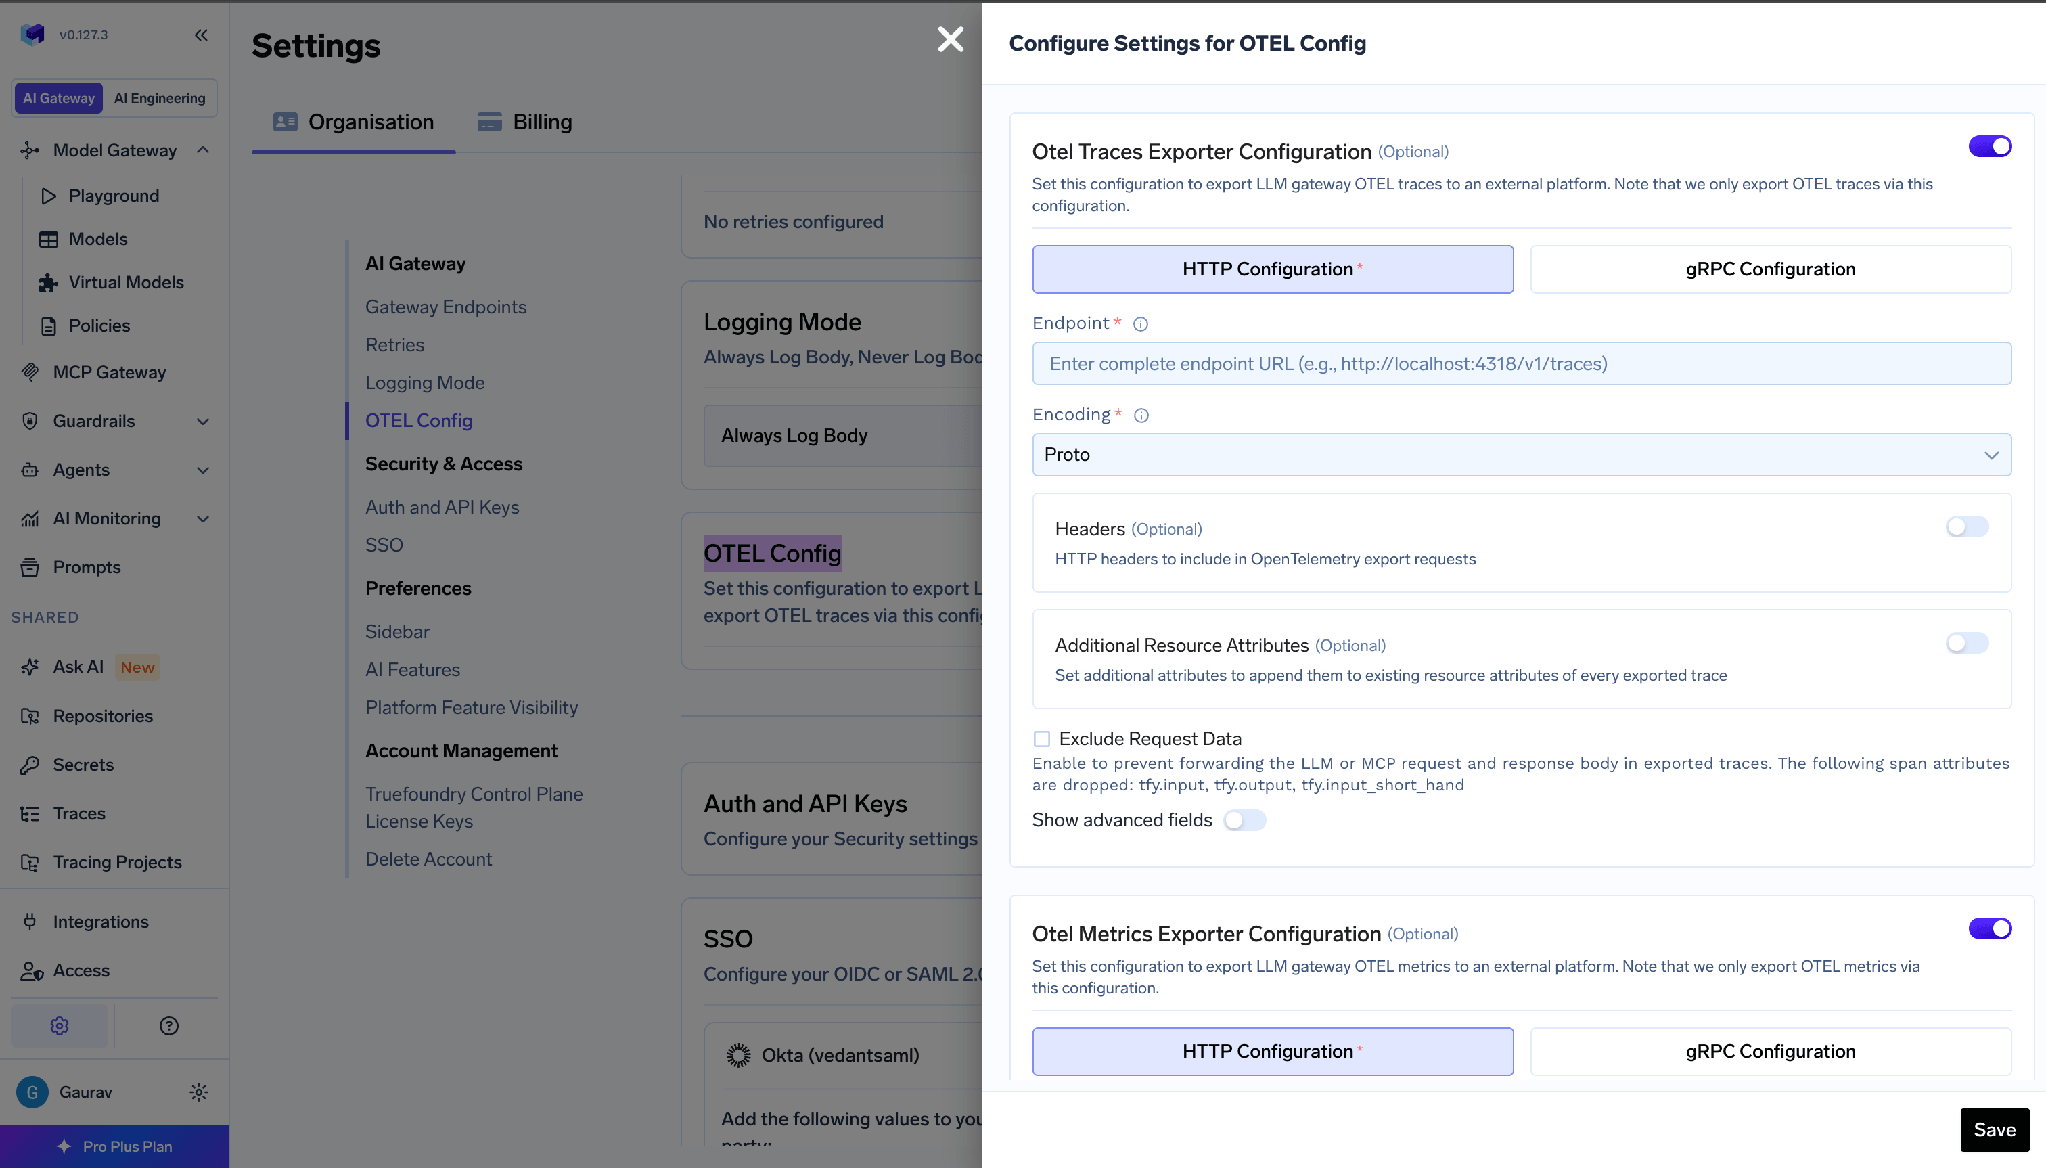
لا يتطلب أي من هذا الانتقال من البنية التي تستخدمها حالياً. البوابة متوافقة مع OpenTelemetry، ويتم تصدير التتبعات والمقاييس بشكل مستقل — كلاهما يتم تكوينه تحت AI Gateway → Controls → Settings → OTEL Config، عبر HTTP أو gRPC، مع ترميز proto أو json وترويسات مصادقة اختيارية. الأنظمة التي تتوقع مقاييس مشفرة دلتا (delta-encoded)، مثل Datadog وCloudWatch، تحتاج إلى تصدير مقاييس دلتا (Export Delta Metrics) مفتاح التبديل بالإضافة إلى متغير بيئة التوقيت (temporality) في إعدادات البوابة. يمكن لـ Prometheus سحب البيانات من /metrics على البوابات المستضافة ذاتياً.
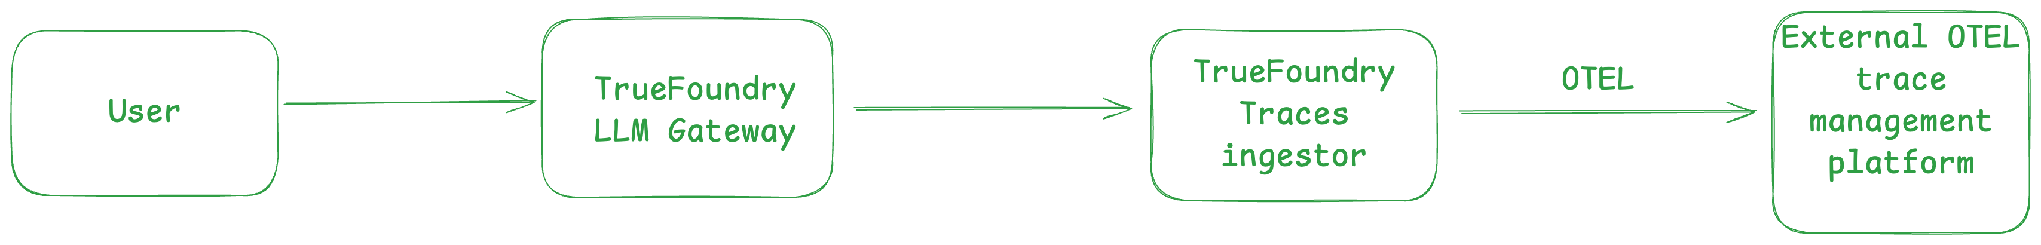
OpenTelemetry trace flow: traces stored by TrueFoundry and exported to an external backend
Export is additive, not a handoff: TrueFoundry keeps storing traces either way, so the in-product session and span views stay available while Grafana or Datadog gets the same data.
Support copilot, a week in production. Finance asks why the bill tripled.
Start at session level. Sort by cost. Median is a few cents; four sessions are over a dollar, all with single-digit turn counts — so this is not long conversations, it is individual turns doing too much.
Open one and read the timeline. Turn 3 is almost entirely tool-call coloured. Tool calls: 31. Errors: 0. Nothing failed, which is why no alert fired.
Expand agent steps for turn 3. The ordered list shows one document-fetch tool called repeatedly, and per-turn tokens climb sharply from turn 3 onward without coming back down — a large document entered context and stayed.
Confirm at the tool level. In MCP metrics, Tools view, that tool tops the request-count ranking by a wide margin and has the worst p90.
Fix, then verify. Whether the fix is a narrower tool, pagination, or a prompt change telling the agent it already has the file, verification is the same: filter sessions to that agent for the next day and check the cost distribution flattened. If you wired feedback, check whether the outliers were also the badly rated runs — they usually are.
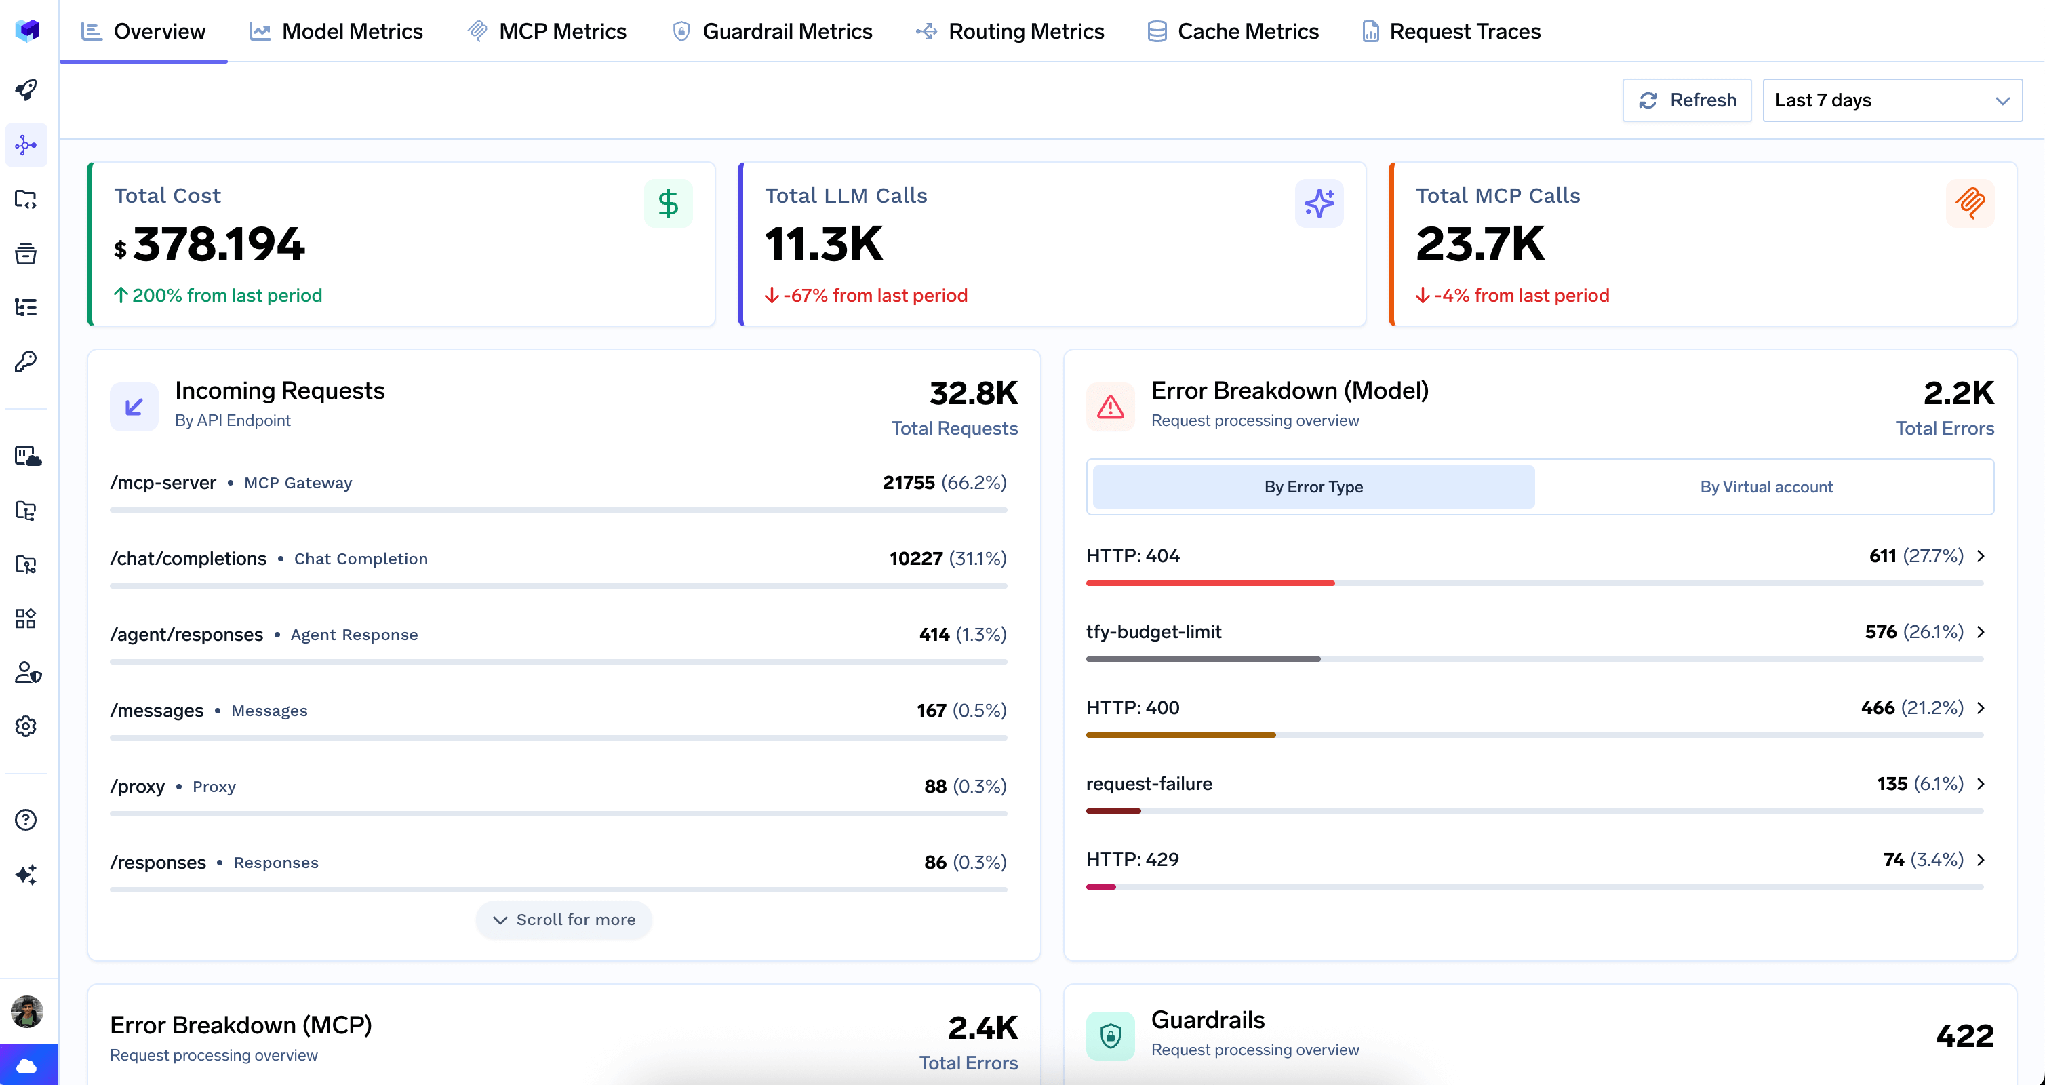
Five steps, no custom instrumentation, every one a question about the trajectory.
Agent metrics include every gateway request by default. Rows that did not go through an agent return null for agentName, agentFramework and agentServerType, and appear as null buckets in groupBy output. IS_NULL is not supported on those three fields, so scope with agentName IN [...] or a STRING_* operator.
Trace and metrics export are configured separately. The traces exporter sends only traces, the metrics exporter only metrics. Enabling one and assuming the other followed is a common way to end up with half a picture.
Plan metadata before you need it. Custom metadata keys sent as request headers become a View by dimension across the dashboard. Adding an agent name, environment or run ID up front costs nothing; retrofitting means last quarter’s data cannot be sliced that way.
The temptation with agent monitoring is to bolt an agent onto the dashboards you have, watch p99 and error rate, and call it observed. That works right up to the first incident, when you find that the run which burned your budget returned 200 at every hop and appears on no chart.
The fix is not more metrics but a different unit of observation. Record the trajectory — session, turn, model call, tool call, with arguments and results on the spans — and the three failures that actually happen become straightforward: a loop is a repeated call with identical arguments, a bad tool result is visible because you kept it, and a 40x run is the outlier you sort to the top.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



تسجيل مسار التنفيذ الكامل للوكيل، أي الجلسات والأدوار واستدعاءات النماذج واستدعاءات الأدوات، مع المعطيات والنتائج والرموز والتكلفة وزمن الاستجابة، حتى تتمكن من الإجابة عن سبب تصرفه على ذلك النحو. وتختلف عن مراقبة التطبيقات في وحدة الرصد: فللطلب بداية ونهاية، أما المسار فتسلسل متداخل يمكن لأي مستوى فيه أن يدخل في حلقة.
مراقبة LLM مجموعة فرعية تغطي استدعاء النموذج: التعليمات والرد والرموز وزمن الاستجابة والتكلفة. ومراقبة الوكلاء تضيف كل ما يحيط به: أي الأدوات نُفّذت، وبأي ترتيب، وبأي معطيات ونتائج، وكم مرة دار الدور قبل أن يتوقف. ومعظم الإخفاقات الفعلية تكمن في هذه البنية لا في رد واحد.
لا، إذا كانت حركة بيانات النماذج والأدوات تمر أصلاً عبر بوابة، لأنها تسجّل كل قفزة كأثر جانبي لمعالجتها. أما القياس عبر SDK على مستوى إطار العمل فيضيف خطوات الاستدلال الداخلية التي لا تراها البوابة أبداً، ولذلك فالاثنان متكاملان وليسا بديلين.
نعم، في VPC أو محلياً أو في بيئة معزولة عن الشبكة أو هجينة أو عبر سحابات متعددة، دون أن تغادر أي بيانات نطاقك.
نعم. تتضمن MCP Gateway وAgent Gateway وMCP & Agents Registry مع تحكم في الوصول على مستوى الأدوات. ويمكن حوكمة الوكلاء المبنيين على LangGraph أو CrewAI أو AutoGen أو إطار عمل مخصص مركزياً.
نعم. البوابة متوافقة مع OpenTelemetry وتتكامل مع Grafana أو Datadog أو Prometheus أو حزمتك المفضلة. فهي تتتبع كل طلب من المطالبة إلى تنفيذ الأداة والنموذج، لتحصل على تسجيل موحد دون الحاجة إلى تغيير ما تستخدمه حاليًا.



أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد



















