



November 16, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.



Blazingly fast way to build, track and deploy your models!
عندما قامت Moonshot AI بطرح Kimi K2 كنموذج مفتوح المصدر، لفت ذلك انتباه مجتمع الذكاء الاصطناعي. وعندما أتبعته بنموذج Kimi K2 Thinking، وهو نموذج يمكنه التفكير عبر مئات استدعاءات الأدوات بترابط لافت، بدأ الممارسون يمنحونه اهتمامًا جادًا. والآن، مع Kimi K2.6، دفعت Moonshot بالحدود إلى أبعد من ذلك: نموذج مفتوح المصدر فائق التطور يتربع على قمة اختبارات القياس للبرمجة والأنظمة القائمة على الوكلاء (agentic) طويلة المدى، منافسًا أفضل العروض مغلقة المصدر في العالم.
يقدم هذا المنشور غوصًا عميقًا فيما يجعل K2.6 متميزًا، وما تعنيه أرقام اختبارات القياس حقًا لأحجام العمل الفعلية، وكيف يمكنك توظيفه في العمل دون الحاجة إلى مشروع نشر يستغرق ستة أسابيع.
نموذج Kimi K2.6 هو الجيل الجديد متعدد الوسائط من Moonshot AI، والمتاح على Hugging Face وعبر Kimi API. ومثل أسلافه، جرى بناؤه على بنية خلط الخبراء (MoE) مع نافذة سياق تصل إلى 262,144 سياقًا (token). لكن K2.6 يعد أكثر من مجرد تحسين تدريجي — فهو يمثل تحولًا تصميميًا جوهريًا نحو ثلاثة أشياء كان الجيل السابق يتعامل معها بشكل غير متسق: البرمجة طويلة المدى (long-horizon coding)، والتصميم الموجه بالبرمجة (coding-driven design)، وتنسيق أسراب الوكلاء (agent swarm coordination).
إليك توضيحًا سريعًا لما تعنيه "طويلة المدى" في الممارسة العملية. في أحد العروض التوضيحية لاختبارات القياس، قام K2.6 بنشر نموذج Qwen3.5-0.8B ذاتيًا ومحليًا على جهاز Mac، ونفذ الاستدلال بلغة Zig (وهي لغة برمجة أنظمة متخصصة)، وعبر أكثر من 4,000 استدعاء للأدوات وأكثر من 12 ساعة من التنفيذ المستمر، قام بتحسين الإنتاجية من ~15 إلى ~193 سياقًا في الثانية (أسرع بنحو 20% تقريبًا من LM Studio). هذا ليس مجرد ريبوت دردشة يجيب عن سؤال؛ بل هو ذكاء اصطناعي يعمل كمهندس أداء أول عبر مهمة مستمرة.
وفي عرض توضيحي آخر، قام K2.6 بتحديث محرك مطابقة مالي مفتوح المصدر يعود لتاريخ 8 سنوات خلال جلسة استمرت 13 ساعة، حيث أجرى أكثر من 1,000 تغيير برلمجي مستهدف لتحقيق تحسين بنسبة 185% في متوسط الإنتاجية وزيادة بنسبة 133% في ذروة الإنتاجية — دون أي توجيه بشري بعد التحديد الأولي للمهمة.
الأرقام مهمة، لكن السياق أكثر أهمية. إليك كيف يؤدي K2.6 عبر اختبارات القياس الأكثر أهمية لأنظمة الوكلاء الإنتاجية:
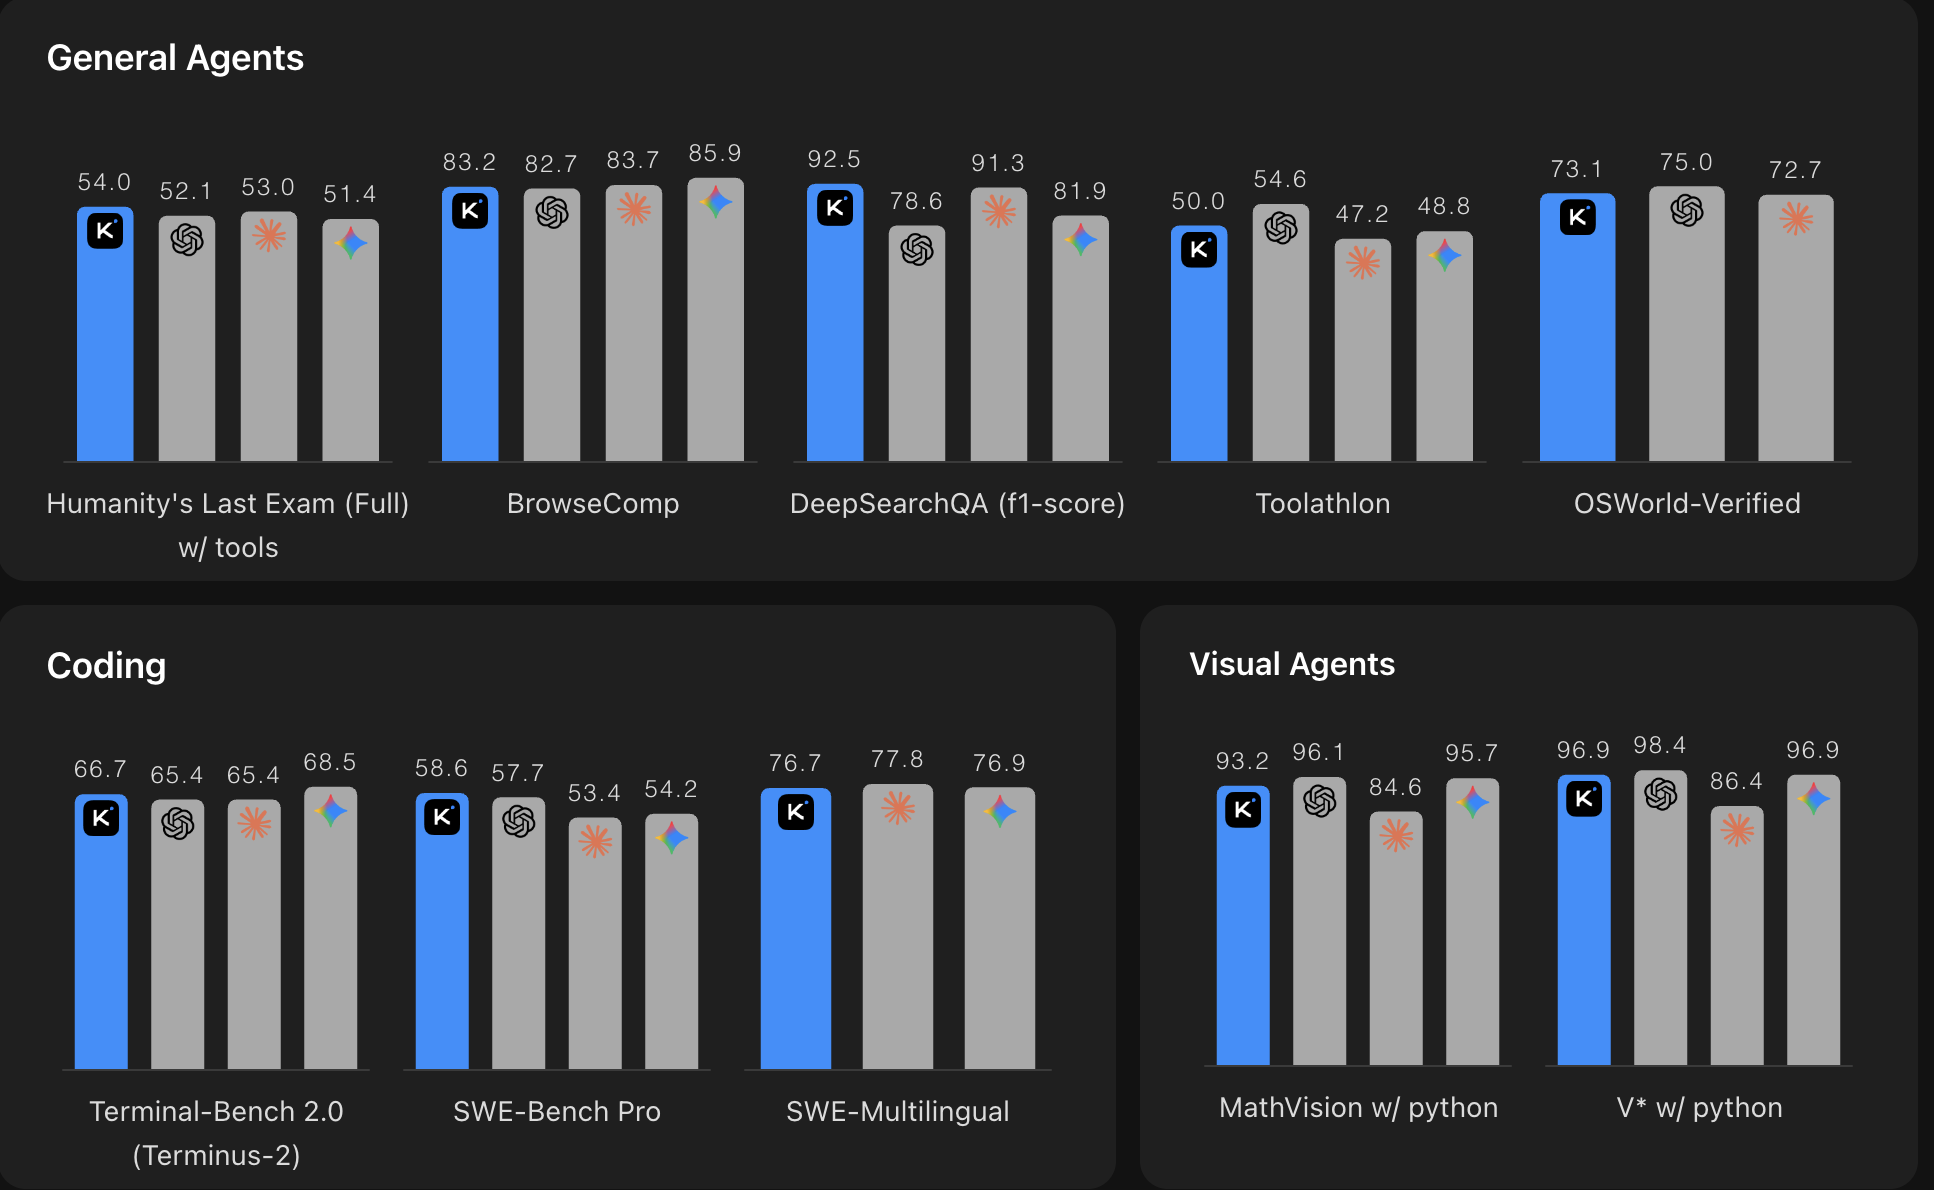
*المصدر: مقارنة اختبارات القياس لـ Moonshot AI Kimi K2.6. القيمة الأعلى هي الأفضل. يقارن الرسم البياني بين Kimi K2.6 وأبرز النماذج مغلقة المصدر عبر اختبارات القياس للوكلاء العامين، والبرمجة، والوكلاء البصريين.*
ينافس K2.6 أفضل النماذج مغلقة المصدر، بما في ذلك Claude Opus 4.6 وGPT-5.4، عبر كل بعد تقريبي يهم برمجة الوكلاء والمهام طويلة المدى. ويحقق ذلك كنموذج مفتوح الأوزان بتكلفة $0.74 / $3.50 لكل مليون سياق إدخال/إخراج، وهو ما يمثل جزءًا ضئيلًا من تكلفة البدائل المملوكة المقارنة.
كما أن القفزة مقارنة بـ Kimi K2.5 كبيراً جداً: تحسن بنسبة 80% تقريبًا في Toolathlon، ونحو 8 نقاط مئوية في BrowseComp وSWE-Bench Pro. هذه ليست مكاسب هامشية.
ويستعرض الشركاء المؤسسيون الذين حصلوا على وصول مبكر نتائج مقنعة مماثلة: حيث أشار المدير التكنولوجي لشركة Augmentcode إلى "الدقة الجراحية لـ K2.6 في قواعد البرمجة الكبيرة"؛ وشهدت Vercel تحسنًا يزيد عن 50% في اختبار قياس Next.js الخاص بها مقارنة بـ K2.5؛ وسجلت CodeBuddy تحسنًا بنسبة 12% في دقة إنشاء البرمجيات مع وصول نسبة نجاح استدعاء الأدوات إلى 96.6%.
معظم نماذج LLM مناسبة لإنشاء البرمجيات من محاولة واحدة (one-shot). أما K2.6 فقد تم بناؤه للمهام التي تستغرق ساعات: إعادة هيكلة عدة ملفات، والتحسينات عبر لغات متعددة، وتحسين خطوط بناء البرمجيات، وحلقات تصحيح الأخطاء التكرارية حيث يتعين على النموذج قراءة مخرجات المترجم (compiler)، وتعديل فرضيته، والمحاولة من جديد.
يظهر النموذج تعميمًا قويًا عبر Python وRust وGo، وحتى اللغات النادرة مثل Zig، وهو أمر لافت لأنه يشير إلى أن النموذج قد استوعب المفاهيم البرمجية بعمق كافٍ لنقلها، بدلاً من مجرد حفظ الأنماط من بيانات التدريب.
يمكن لـ K2.6 تحويل موجه واحد باللغة الطبيعية إلى واجهة أمامية كاملة وجاهزة للإنتاج — ليس مجرد نموذج مبدئي ثابت، بل واجهة تفاعلية تحتوي على عناصر متحركة عند التمرير، ومصادقة مدعومة بسباقات بيانات. في اختبار Kimi Design Bench الداخلي لشركة Moonshot، يتفوق K2.6 على Google AI Studio عبر مهام الإدخال البصري، وبناء صفحات الهبوط، وتطوير التطبيقات كاملة الواجهات (full-stack)، والبرمجة الإبداعية العامة.
بالنسبة للفرق التي تبني مسارات عمل للتطوير المدعوم بالذكاء الاصطناعي، يعني هذا عمليًا نموذجًا واحدًا يتولى الحزمة الكاملة: الهندسة المعمارية، والمنطق، وواجهة المستخدم، وهياكل النشر.
يقدم K2.6 توسعًا معماريًا رئيسيًا لنظام أسراب الوكلاء الذي تم استعراضه لأول مرة في K2.5. يتوسع السرب الآن إلى 300 وكيل فرعي يتم تنفيذها عبر 4,000 خطوة منسقة في وقت واحد، مقارنة بـ 100 وكيل و1,500 خطوة في K2.5. هذا ليس مجرد تحسين في الحجم؛ بل هو تغيير نوعي في أنواع المهام التي تصبح ممكنة.
المهمة التي كانت تتطلب سابقًا إنسانًا لتنسيقها (مثل "ابحث في 100 شركة لشبه الموصلات، وابنِ خمس استراتيجيات استثمار كمي، وأنتج عرضًا تفاعليًا بأسلوب McKinsey") يمكن الآن إصدارها كتعليمات واحدة لـ K2.6 واستلامها كمخرج كامل.
هنا عادة ما يتوقف النقاش: يقرأ الفريق أرقام اختبارات القياس، ويتحمس، ثم يقضي الأسابيع الثلاثة التالية في محاولة فهم كيفية تقديم النموذج بشكل موثوق فعليًا.
إن K2.6 هو نموذج MoE كبير. وتستلزم نافذة السياق البالغة 262 ألف سياق متطلبات ذاكرة كبيرة. كما أن أحجام عمل الوكلاء — بحكم تعريفها — تولد أنماط حركة مرور متغيرة للغاية: هدوء لساعات، ثم فجأة مئات الوكلاء الفرعيين المتوازية التي تجري طلبات في وقت واحد. واستراتيجيات النشر البسيطة تنهار تحت هذا الحمل.
هذه هي مشكلة البنية التحتية التي تم تصميم TrueFoundry AI Gateway لحلها.
بدلاً من توفير تكتل GPU الخاص بك، وبناء موازن حمل مخصص، وضبط معلمات الاستدلال يدويًا، تتيح لك TrueFoundry توجيه تطبيقك إلى نقطة نهاية واحدة — وتتولى هي الباقي. تقوم البوابة (Gateway) بتوجيه الطلبات بذكاء عبر المزودين، وتدير التزامن لأحجام العمل المندفعة (مثل إطلاق سرب لـ 300 وكيل فرعي في وقت واحد)، وتمنحك أدوات القابلية للملاحظة — التتبعات، والرسوم البيانية لزمن الانتقال، واستخدام السياقات حسب الفريق — والتي كان عليك بناؤها بنفسك بخلاف ذلك.
في اختباراتنا الداخلية مع Kimi K2 Thinking، تعاملت بوابة TrueFoundry مع أكثر من 350 RPS على وحدة vCPU واحدة مع حمولة زائدة تبلغ ~10 مللي ثانية. بالنسبة لأحجام عمل الوكلاء حيث قد تتفرع مهمة واحدة يبدأها المستخدم إلى عشرات أو مئات استدعاءات API، فإن هذا الهامش يحدث فارقًا.
هناك أيضًا بعد تنظيمي عملي. عادةً ما تمتلك الفرق المؤسسية التي تشغل K2.6 فرقًا متعددة — علوم البيانات، وهندسة المنتجات، والمنصة — ترحب جميعها بالتجربة على نفس النموذج. توفر البوابة لوحة تحكم واحدة للحد من المعدل، وتحديد التكاليف، وسياسات الوصول، دون حاجة كل فريق لإدارة مفاتيح API الخاصة به.
أسرع طريق لتشغيل K2.6 في بيئة مُدارة وجاهزة للإنتاج:
1. عبر TrueFoundry AI Gateway (API)
إذا كنت تستخدم بالفعل حزمة SDK الخاصة بـ OpenAI أو أي عميل متوافق مع OpenAI، يمكنك التبديل إلى K2.6 بتغيير سلسلة النموذج فقط:
تتولى البوابة اختيار المزود، والتوجيه الاحتياطي، والحد من المعدل بكل شفافية.
2. لأحجام عمل الوكلاء
تتبع واجهة استدعاء الأدوات في K2.6 مخطط استدعاء الدوال القياسي لـ OpenAI. بالنسبة للمهام طويلة المدى، ستوفر ما يلي:
- ضبط `max_tokens` بنوع من السخاء (يمكن للنموذج الاستفادة الإنتاجية من ميزانية إنشاء كبيرة)
- تمكين البث (streaming) للحصول على مخرجات تدريجية من سلاسل الأدوات الطويلة
- استخدام لوحة تتبع TrueFoundry لتصور استدعاءات الأدوات التي تستغرق وقتًا وأين يتم استهلاك السياق
3. لتنسيق أسراب الوكلاء
إذا كنت تبني أنظمة متعددة الوكلاء، توفر بوابة TrueFoundry بيانات وصفية على مستوى الطلب — حيث يمكنك وسم طلبات كل وكيل فرعي بمعرف المهمة الأصلية، ثم إعادة بناء تتبع التنفيذ الكامل بعد ذلك. هذا أمر لا يقدر بثمن لتصحيح سلوك السرب وفهم أين تفيد التوازيات (أو تضر).
فرق الهندسة التي تبني أدوات برمجة قائمة على الوكلاء: يعد K2.6 أول نموذج مفتوح المصدر ينافس بجدية GPT-5.4 وClaude Opus على SWE-Bench Pro. إذا كنت تنتظر نموذجًا مفتوح الأوزان يمكنه التعامل مع مهام قواعد البرمجة على مستوى الإنتاج، فهذا هو المطلوب.
فرق منصات ML التي تدير الوصول إلى النماذج: تستفيد المؤسسة التي تقيم K2.6 إلى جانب النماذج الرائدة الأخرى من تشغيل كل شيء عبر بوابة واحدة. يتيح لك نهج كتالوج النماذج من TrueFoundry إجراء اختبارات A/B لـ K2.6 مقابل Claude أو GPT-5.4 على أحجام عملك الفعلية، مع تتبع التكلفة وزمن الانتقال جنبًا إلى جنب.
الفرق التي لديها متطلبات إقامة البيانات: تعني الأوزان المفتوحة لـ K2.6 أنه يمكن نشره على البنية التحتية التي تتحكم فيها. تتولى منصة النشر من TrueFoundry التنسيق، بحيث تحصل على حوكمة النماذج للمؤسسات دون وجود مورد مملوك في مسار الاستدلال الخاص بك.
أي شخص تعب من دفع أسعار النماذج مغلقة المصدر: بسعر $0.74 / $3.50 لكل مليون سياق وأداء اختبارات قياس يطابق أو يتجاوز البدائل المملوكة في معظم مهام الوكلاء، تصبح حجة التكلفة مقابل الأداء لـ K2.6 من الصعب تجاهلها.
نموذج Kimi K2.6 هو نموذج رائد حقيقي. ليس مجرد "جيد بالنسبة لكونه مفتوح المصدر" — بل ينافس بجدية أفضل النماذج في العالم عبر اختبارات القياس التي تهم العمل الهندسي الحقيقي. موثوقيته طويلة المدى، وبنية أسراب الوكلاء لديه، وتسعيره التنافسي تجعله النموذج مفتوح الأوزان الأكثر إقناعًا والمتاح لأنظمة الوكلاء الإنتاجية اليوم.
السؤال العلمي ليس ما إذا كان K2.6 يستحق الاستخدام أم لا. إنه يستحق فعلاً. السؤال هو كيف يمكنك إدخاله في الإنتاج بسرعة وموثوقية. توفر TrueFoundry AI Gateway الإجابة عن هذا السؤال — بحيث يقضي فريقك وقته في البناء باستخدام النموذج، وليس بناء البنية التحتية من حوله.
جربه الآن: احصل على إمكانية الوصول إلى Kimi K2.6 عبر [TrueFoundry AI Gateway](https://www.truefoundry.com/ai-gateway)، أو [احجز عرضًا توضيحيًا](https://www.truefoundry.com/book-demo) لرؤية كيف يناسب مسار عمل فريقك.
*جميع أرقام اختبارات القياس المذكورة مأخوذة من المدونة التقنية الرسمية لـ Kimi K2.6 والتقييمات الموثقة من أطراف خارجية على OpenRouter. أرقام أداء البنية التحتية من الاختبارات الداخلية لـ TrueFoundry.*
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد




















