



November 16, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.



Updated: November 3, 2026
Published: July 2, 2026

Blazingly fast way to build, track and deploy your models!
أصبح اختيار نموذج لغوي كبير (LLM) أكثر تعقيداً بكثير مما كان عليه قبل عام أو عامين. تُطلق نماذج جديدة باستمرار، وتحصل النماذج الحالية على تحديثات رئيسية، ويدعي كل منها أنه يقدم استدلالاً أفضل، أو استجابات أسرع، أو نوافذ سياق أكبر، أو تكاليف أقل. في حين أن توفر المزيد من الخيارات يعد أمراً جيدا، إلا أنه يجعل اختيار النموذج المناسب أكثر صعوبة بكثير.
الحقيقة هي أنه لا يوجد نموذج LLM واحد هو الأفضل في كل شيء. فالنموذج الذي يؤدي بشكل استثنائي في البرمجة قد لا يكون الأكثر فاعلية من حيث التكلفة لدعم العملاء. وقد يتفوق نموذج آخر في الاستدلال ولكنه يقصر عندما يتعلق الأمر بزمن الاستجابة أو استدعاء الأدوات. لهذا السبب، فإن الاعتماد فقط على درجات الاختبارات القياسية أو الشعبية ليس كافياً.
وهنا تبرز أهمية مقارنة إمكانيات LLM. بدلاً من السؤال "ما هو النموذج الأفضل؟"، فإن السؤال الأفضل هو "ما هو النموذج الأفضل لحالة الاستخدام الخاصة بي؟"
في هذا الدليل، سنناقش ما هي إمكانيات LLM، وكيف يجب أن تقارن بينها، ولماذا تعتبر هذه المقارنة مهمة.
إمكانيات LLM هي القدرات الفردية التي تحدد ما يمكن لـ نموذج لغوي كبير القيام به ومدى جودة أدائه للمهمة. في حين تم تصميم نماذج LLM لفهم اللغة وإنشائها، إلا أن إمكانياتها تختلف اعتماداً على كيفية تدريبها، والبيانات المستخدمة أثناء التدريب، وبنيتها الأساسية.
ليست مقارنة إمكانيات LLM مجرد تمرين تقني، بل هي طريقة لتقليل المخاطر قبل دخول تطبيقك مرحلة الإنتاج. فهي تساعدك على التحقق مما إذا كان النموذج يمكنه تلبية متطلباتك الوظيفية اليوم والاستمرار في دعم تطبيقك مع نموه.
بدلاً من اكتشاف القيود في منتصف عملية التطوير، يمكنك تحديدها مبكراً وإجراء مفاضلات مدروسة.
إليك ما تساعدك مقارنة الإمكانيات على تحقيقه:
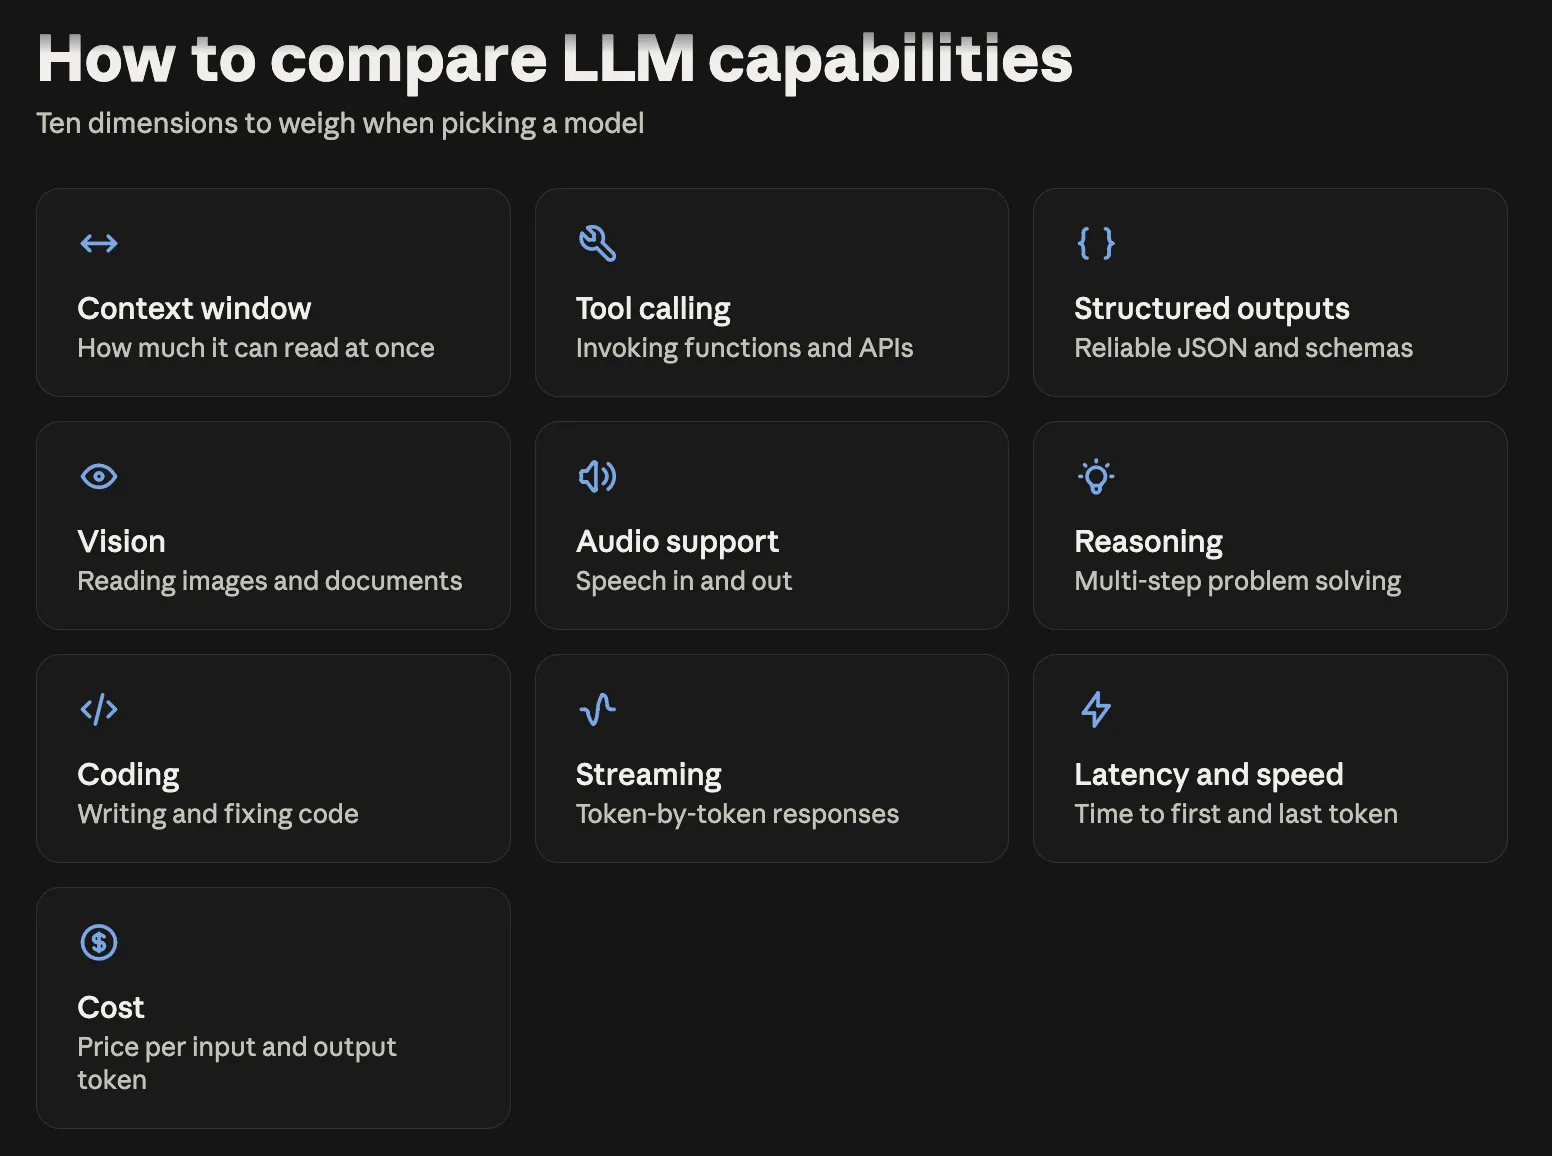
تركز المقارنة الفعالة لإمكانيات LLM على الميزات التي تؤثر بشكل مباشر على تطبيقك. بدلاً من الاعتماد فقط على درجات الاختبارات القياسية، قم بتقييم ما إذا كان النموذج يدعم الإمكانيات التي تتطلبها حالة الاستخدام الخاصة بك.
قارن الإمكانيات التالية لفهم مدى ملاءمة كل نموذج لمتطلبات تطبيقك:
تساعد نافذة السياق الكبيرة النموذج على معالجة المستندات الطويلة، أو المحادثات، أو البرمجيات في طلب واحد. قارن بين طول السياق المدعوم والأداء مع المدخلات الأكبر.
يتيح استدعاء الأدوات لنماذج LLM التفاعل مع APIs، وقواعد البيانات، والنظم الخارجية الأخرى. قم بتقييم مدى موثوقية النموذج في تنفيذ هذه الإجراءات.
إذا كان تطبيقك يعتمد على صيغ مثل JSON، فقارن مدى اتساق النماذج في إنشاء استجابات مهيكلة ومتوافقة مع المخطط (schema-compliant).
يمكن للنماذج المزودة بإمكانيات الرؤية تحليل الصور، وملفات PDF، والمخططات، ولقطات الشاشة. تحقق من أنواع المدخلات المدعومة وجودة الفهم البصري.
بالنسبة للتطبيقات القائمة على الصوت، قارن ما إذا كانت النماذج تدعم الإدخال الصوتي، أو تفريغ الصوت، أو إنشاء الصوت.
تحدد قدرة الاستدلال مدى جودة تعامل النموذج مع التحليل متعدد الخطوات، والتخطيط، وحل المشكلات. اختبر ذلك باستخدام مهام مشابهة لسير العمل في العالم الحقيقي.
إذا كنت تبني أدوات للمطورين، فقم بتقييم مدى جودة إنشاء النموذج للكود وشرحه واستكشاف أخطائه وإصلاحها عبر لغات برمجة مختلفة.
يعيد البث التدفيقي الاستجابات فور توليدها، مما يضمن استجابة أفضل لروبوتات الدردشة والتطبيقات التفاعلية الأخرى في الوقت الفعلي.
يعد زمن الاستجابة المنخفض أمراً ضرورياً للتجارب التفاعلية. قارن أوقات الاستجابة تحت أحمال عمل واقعية بدلاً من الاعتماد فقط على الأرقام المنشورة.
ضع تسعير الـ tokens في الاعتبار جنباً إلى جنب مع الأداء لتحديد ما إذا كان النموذج فعالاً من حيث التكلفة للاستخدام المتوقع.
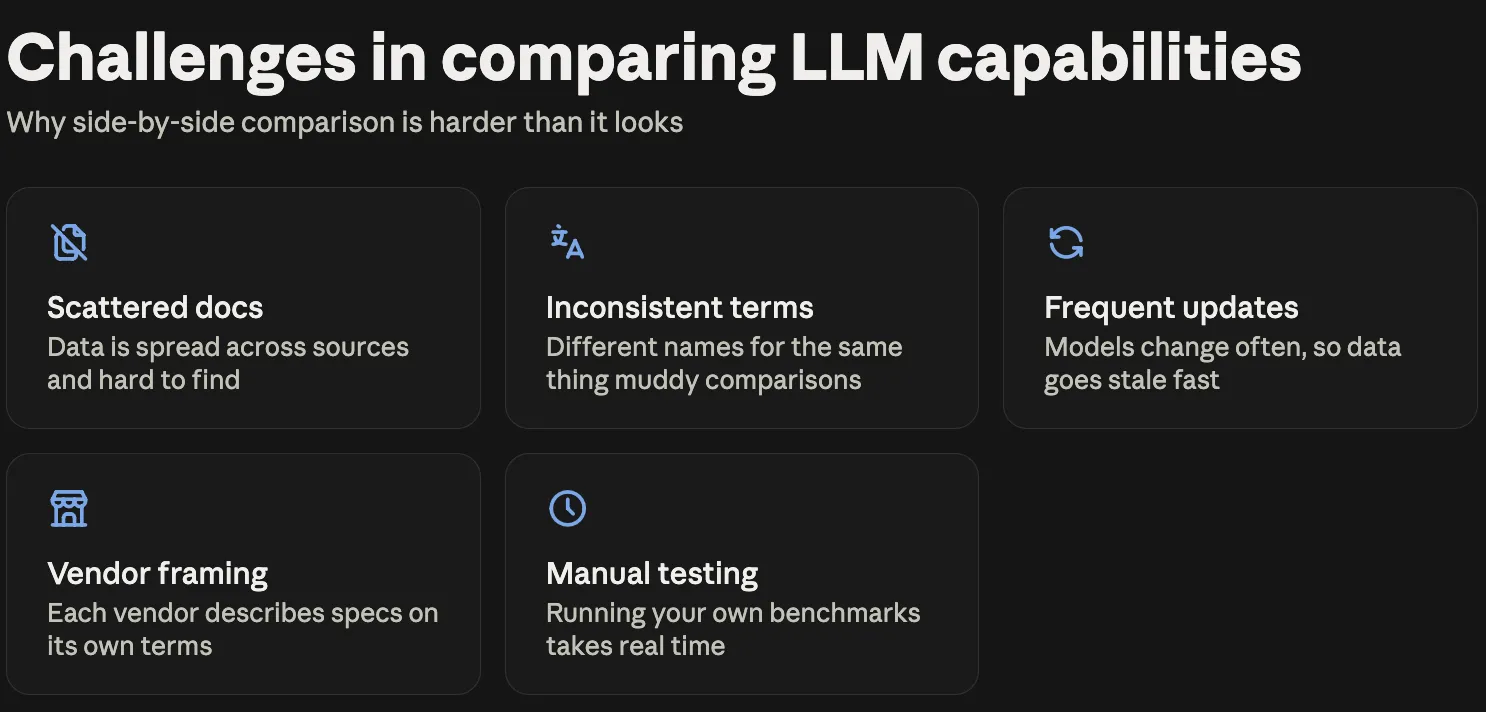
تقييم إمكانيات LLM أصعب مما يبدو. إذ تجعل معايير التوثيق المختلفة والتحديثات المتكررة للنماذج إجراء مقارنات دقيقة أمراً صقلاً.
بمجرد أن تعرف الإمكانيات المهمة، فأنت بحاجة إلى طريقة سهلة للمقارنة بينها عبر النماذج. بدلاً من البحث في وثائق المزودين المختلفين، يمكنك استخدام ملفات تعريف النماذج للحصول على المعلومات في قالب معياري واحد.
فكر في ملف تعريف النموذج كبطاقة إمكانيات لـ LLM. بدلاً من البحث في التوثيق أو التكهن بما يدعمه النموذج، يمكنك عرض إمكانياته بنسق موحد.
تتضمن ملفات تعريف النماذج معلومات مثل نافذة السياق، واستدعاء الأدوات، والمخرجات المهيكلة، ودعم الرؤية، وإمكانيات الصوت، والميزات الرئيسية الأخرى التي تهم أثناء مقارنة إمكانيات LLM. وبما أن كل نموذج يتبع نفس الهيكل، فمن الأسهل بكثير مقارنة المزودين جنباً إلى جنب.
تأتي البيانات من models.dev، وهو مشروع مفتوح المصدر تتبع الإمكانيات عبر النماذج من مزودين مثل OpenAI، وAnthropic، وGoogle، وغيرهم. تتوفر ملفات التعريف هذه من خلال حزم LangChain، مما يعطي المطورين طريقة متسقة للوصول إلى معلومات الإمكانيات في الكود الخاص بهم.
تخيل أنك قرأت أن نموذجاً ما يدعم الرؤية الحاسوبية، ثم قمت ببناء ميزة تحليل الصور بناءً على ذلك. بعد أسابيع قليلة، تكتشف أن دعم الرؤية كان متاحاً فقط في إصدار معاينة (preview) أو يتطلب تكويناً خاصاً لـ API. فجأة، يتوقف تنفيذك عن العمل، ليس بسبب خطأ برمجي (bug)، بل بسبب عدم تطابق الإمكانيات.
أو ربما تقارن بين خمسة نماذج مختلفة لمشروع جديد. تفتح التوثيق من عدة مزودين، وتنشئ جدول بيانات، وتحاول معرفة ما إذا كانت مصطلحات مثل استدعاء الأدوات، واستدعاء الدوال، وتكامل API تشير جميعها إلى الإمكانية نفسها. وسرعان ما يستغرق مقارنة النماذج وقتاً أطول من تقييمها الفعلي.
تساعد ملفات تعريف النماذج في تجنب هذه المواقف. بدلاً من ترجمة التوثيق الخاص بكل مزود، تحصل على رؤية معيارية لما يدعمه كل نموذج. يمكن لتطبيقك حتى التحقق من الإمكانيات برمجياً قبل استخدام ميزة ما، مما يقلل من المفاجآت أثناء التطوير ويجعل مقارنة إمكانيات LLM أسرع، وأكثر اتساقاً، وأكثر موثوقية.
غالباً ما يتضمن اختيار LLM الكثير من التنقل بين صفحات التوثيق. تبسط ملفات تعريف النماذج ذلك من خلال منح المطورين نظرة سريعة على ما يمكن لكل نموذج القيام به.
غالباً ما يبدأ اختيار LLM بصلة طويلة من الأسئلة: هل يدعم استدعاء الأدوات؟ ما مقدر السياق الذي يمكنه التعامل معه؟ هل يمكنه معالجة الصور؟ يمكن أن يستغرق العثور على هذه الإجابات عبر مزودين متعددين وقتاً طويلاً.
باستخدام ملفات تعريف النماذج، يمكن للمطورين تصفية النماذج بسرعة بناءً على الإمكانيات التي يحتاجونها. على سبيل المثال، يمكن لفريق يبني روبوت دعم عملاء التحقق من النماذج التي تدعم استدعاء الأدوات للبحث عن الطلبات ولديها سعة سياق كافية للمحادثات المستمرة. يتيح لهم ذلك قضاء المزيد من الوقت في اختبار أداء النموذج بدلاً من التحقق من الإمكانيات الأساسية.
غالباً ما تستخدم التطبيقات الحديثة نماذج متعددة لمهام مختلفة. قد يتعامل أحد النماذج مع الاستدلال المعقد، بينما يدير نموذج آخر الطلبات الأبسط بتكلفة أقل.
تسمح ملفات تعريف النماذج للتطبيقات بالتحقق مما إذا كان النموذج يدعم الإمكانيات المطلوبة قبل إرسال الطلبات. وهذا يسهل بناء أنظمة يمكنها التنقل بين النماذج عند الحاجة والتعامل مع التغييرات دون أخطاء غير متوقعة.
تعتمد العديد من الفرق بشكل افتراضي على استخدام النموذج الأكثر قوة لأنه موثوق ومألوف. ومع ذلك، لا تتطلب كل مهمة نموذجاً بذروة الإمكانيات.
من خلال مقارنة ملفات تعريف النماذج، يمكن للمطورين تحديد النماذج الأصغر أو الأكثر كفاءة من حيث التكلفة والتي تظل داعمة للميزات التي يحتاجها تطبيقهم. يساعد هذا الفرق على تحسين التكاليف مع الحفاظ على الأداء المطلوب لأحمال العمل المختلفة.
ملفات تعريف النماذج مفيدة ليس فقط للمطورين الذين يكتبون الكود، ولكن أيضاً للفرق التي تتخذ قرارات بشأن تبني الذكاء الاصطناعي. من خلال توفير رؤية معيارية لإمكانيات النماذج، فإنها تساعد الفرق الهندسي على بناء تطبيقات أكثر موثوقية وتساعد فرق المنتجات على تقييم الخيارات بشكل أسرع.
تجعل ملفات تعريف النماذج مقارنة LLM أسهل، لكنها ليست الحل النهائي. فهي تظهر ما يدعمه النموذج، ولكنك ما زلت بحاجة إلى تقييم الأداء والتكلفة ومدى الملاءمة لحالة الاستخدام الخاصة بك.
ضع القيود التالية في الاعتبار عند استخدام ملفات تعريف النماذج للمقارنة:
النهج المنظم يجعل مقارنة LLM أكثر فاعلية. بدلاً من اختيار نموذج بناءً على الشهرة أو درجات الاختبارات القياسية وحدها، ركز على مدى ملاءمته لاحتياجات تطبيقك. يمكن أن تساعدك الممارسات التالية في تقييم النماذج مقابل تلك المتطلبات:
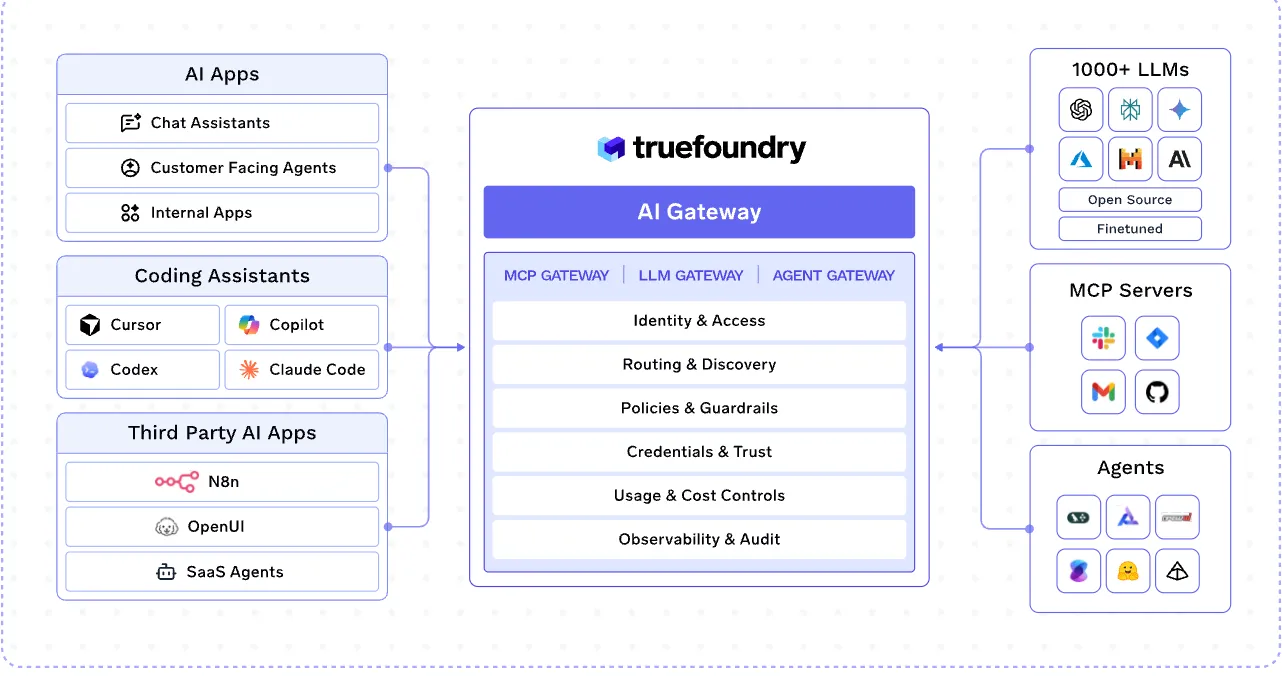
يمكن أن تتحول مقارنة نماذج LLM يدوياً بسرعة إلى عملية مستهلكة للوقت. يتعين عليك مراجعة المواقع الإلكترونية لمزودين مختلفين، وفهم توصيفات الميزات المتنوعة، وإنشاء إطار المقارنة الخاص بك قبل اتخاذ القرار.
يبسط تطبيق Model Comparison من TrueFoundry هذه العملية من خلال تجميع إمكانيات LLM في عرض معياري واحد. مدعوماً بـ TrueFoundry AI Gateway، يتيح لك المقارنة بين النماذج من مزودين مثل OpenAI، وAnthropic، وGoogle عبر إمكانيات هامة مثل نافذة السياق، واستدعاء الأدوات، ودعم الرؤية، والمخرجات المهيكلة.
باستخدام الأداة، يمكنك:
بدلاً من صيانة جداول بيانات المقارنة الخاصة بك، استخدم تطبيق Model Comparison لتصفية النماذج وحصرها بناءً على الإمكانيات التي يحتاجها تطبيقك بالفعل.
يتغير مشهد LLM أسرع من أي وقت مضى، والطريقة التي نقيّم بها النماذج تحتاج إلى التطور معها. النموذج الذي يعمل بشكل جيد لسير عمل معين قد لا يقدم نفس النتائج لسير عمل آخر، مما يجعل المرونة والتقييم المستمر أمران هامان للنجاح طويل الأمد في الذكاء الاصطناعي.
بدلاً من السعي وراء أحدث إصدار للنماذج، ركز على بناء أنظمة ذكاء اصطناعي يمكنها التكيف مع ظهور إمكانيات ومزودين وحالات استخدام جديدة. إن اختيار LLM الصحيح في النهاية هو ذلك الذي يدعم أهدافك، و يناسب احتياجاتك التشغيلية، ويقدم قيمة مستمرة بمرور الوقت.
هل أنت مستعد لتحديد خيارات النماذج الخاصة بك؟ جرب تطبيق Model Comparison لمقارنة إمكانيات LLM عبر المزودين في عرض معياري واحد.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد




















