


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


Wat is AI-inferentie en waarom is het belangrijk?

AI-inferentie is het proces waarbij een getraind AI-model wordt gebruikt om output te genereren op basis van nieuwe gegevens. Het model past parameters toe die tijdens de training zijn geleerd om een voorspelling, classificatie, aanbeveling of gegenereerd antwoord te produceren.
In tegenstelling tot training of fine-tuning, gebruikt inferentie normaal gesproken de bestaande parameters van het model in plaats van deze bij te werken. Wanneer een getraind model voor fraudedetectie bijvoorbeeld een nieuwe transactie evalueert, voert het inferentie uit om in te schatten of die transactie frauduleus is.
Deze gids legt uit hoe AI-inferentie werkt, wat de belangrijkste soorten inferentie zijn, hoe het verschilt van training, wat de infrastructuurvereisten zijn, wat de veelvoorkomende toepassingen zijn, wat de voordelen zijn en wat de belangrijkste uitdagingen zijn.
Hoe werkt AI-inferentie?
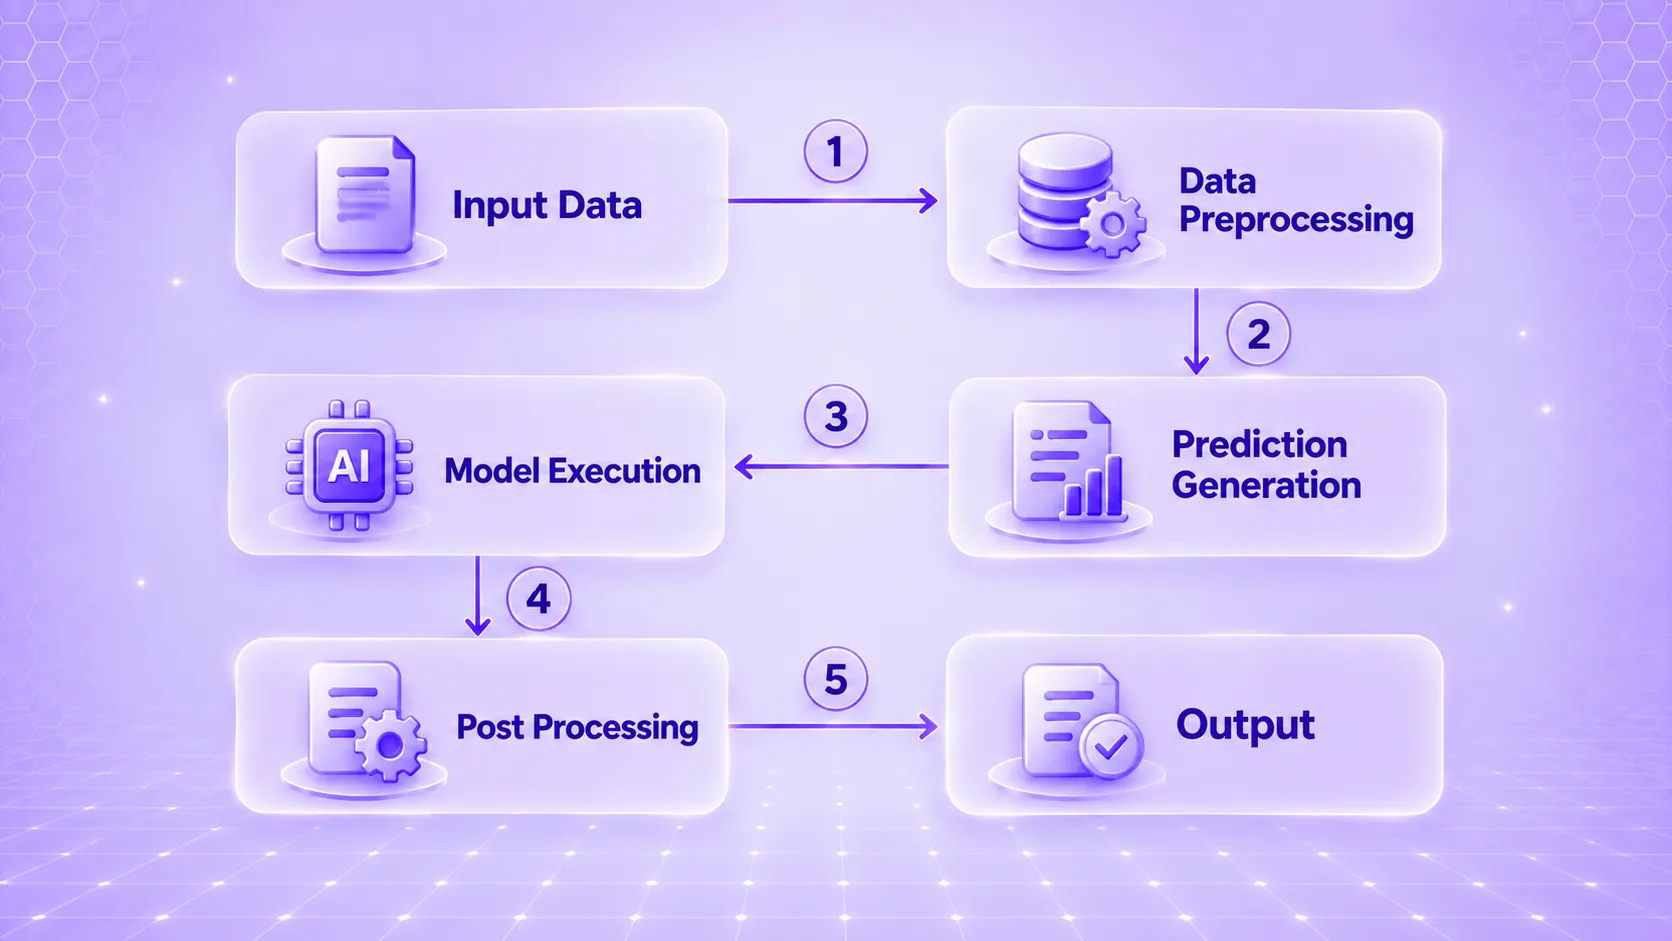
AI-inferentie volgt een proces dat begint bij het ontvangen van nieuwe gegevens en eindigt bij het retourneren of gebruiken van de output van het model.
1. De input ontvangen
Inferentie begint wanneer een getraind model nieuwe input ontvangt van een gebruiker, applicatie, sensor of een ander systeem.
2. De input voorbereiden
De applicatie bereidt de input voor in het formaat dat het model vereist. Een LLM zet tekst bijvoorbeeld om in tokens, terwijl een computervisiemodel een verwerkte afbeelding kan ontvangen die wordt weergegeven als numerieke waarden.
3. De input verwerken
De voorbereide input doorloopt het model in een 'forward pass'. Het model past zijn geleerde parameters toe om een output te berekenen zonder deze parameters normaal gesproken bij te werken.
Bij een LLM vindt generatie doorgaans token voor token plaats, waarbij eerder gegenereerde tokens onderdeel worden van de context voor volgende generatiestappen. Een key-value (KV) cache kan de key- en value-tensors opslaan die zijn berekend voor eerder verwerkte tokens, zodat deze niet bij elke generatiestap opnieuw hoeven te worden berekend, hoewel dit ook het geheugengebruik verhoogt naarmate de sequentielengtes en het aantal gelijktijdige verzoeken toenemen.
4. De output produceren
De output hangt af van het model en de taak. Een classificatiemodel kan een klasse of waarschijnlijkheid retourneren, terwijl een generatief model tekst, een afbeelding, audio of een ander type inhoud kan produceren.
5. Het resultaat retourneren of gebruiken
De applicatie kan de output direct aan een gebruiker retourneren of doorgeven aan een andere component. Een AI-agent kan de output van een model bijvoorbeeld gebruiken om te bepalen of er informatie moet worden opgehaald of een tool moet worden aangeroepen.
Wat zijn de soorten AI-inferentie?
AI-inferentie kan verschillende verwerkingspatronen gebruiken, afhankelijk van hoe de input binnenkomt en wanneer de resultaten nodig zijn. Drie veelvoorkomende patronen zijn online inferentie, batch-inferentie en streaming-inferentie. Online inferentie verwerkt individuele verzoeken, batch-inferentie verwerkt groepen inputs tegelijk, en streaming-inferentie werkt op continue stromen van gegevens of gebeurtenissen.
Online inferentie
Online inference volgt een request-response patroon. Het verwerkt een individueel verzoek zodra dit binnenkomt en geeft een resultaat terug, meestal met strikte eisen voor een lage latentie.
Een chatbot die reageert op de prompt van een gebruiker of een fraudedetectieservice die een transactie beoordeelt, kan bijvoorbeeld gebruikmaken van online inference. Lage latentie en consistente responstijden zijn belangrijk omdat elk verzoek wacht op een resultaat.
Batch-inference
Batch-inference verwerkt veel invoergegevens tegelijk in plaats van direct op elk verzoek te reageren.
Een bedrijf kan bijvoorbeeld 's nachts een model draaien om klantgegevens te beoordelen of aanbevelingen voor de volgende dag te genereren. Batchverwerking is nuttig wanneer directe resultaten niet vereist zijn en de algehele doorvoer belangrijker is dan de latentie per verzoek.
Streaming-inference
Streaming-inference verwerkt een continue stroom van gebeurtenissen of gegevens in plaats van geïsoleerde request-response interacties. Voorspellingen worden continu gegenereerd of zodra er nieuwe gebeurtenissen binnenkomen.
Dit patroon is nuttig voor workloads zoals sensormonitoring, event-streams, het monitoren van financiële transacties en spraakverwerking, waarbij continu nieuwe gegevens binnenkomen die moeten worden geanalyseerd zodra ze beschikbaar zijn.
Managing inference across multiple AI models?

Wat is het verschil tussen AI-inference en training of fine-tuning?
Bij training wordt een model gecreëerd door de parameters bij te werken met trainingsdata. Fine-tuning past een voorgetraind model verder aan met taak- of domeinspecifieke data. Inference gebruikt het resulterende model om nieuwe invoer te verwerken zonder de parameters normaal gesproken aan te passen.
Een bedrijf kan bijvoorbeeld een groot taalmodel (LLM) fine-tunen op ondersteuningsgegevens en vervolgens inference uitvoeren telkens wanneer het model een antwoord voor een klant genereert.
Wat is het verschil tussen AI-inference en AI-serving?
AI-inference verwijst naar de uitvoering van een getraind model, terwijl AI-serving verwijst naar de infrastructuur die het model beschikbaar stelt voor applicaties.
Een serving-systeem kan het model via een API ontsluiten, verzoeken beheren, rekenkracht toewijzen, modelinstanties schalen en verkeer routeren. Het model voert de inference uit wanneer het een specifieke invoer verwerkt.
Dit onderscheid is belangrijk in productie, omdat het succesvol draaien van een model iets anders is dan het betrouwbaar serveren ervan op de vereiste schaal, latentie en beschikbaarheid.
Waar kan AI-inference worden uitgevoerd?
AI-inference kan worden uitgevoerd in de cloud, on-premises of in edge-omgevingen. Sommige architecturen gebruiken een hybride aanpak die twee of meer omgevingen combineert. De juiste aanpak hangt af van factoren zoals modelgrootte, latentie-eisen, datagevoeligheid, verkeerspatronen, hardwarebeschikbaarheid en kosten.
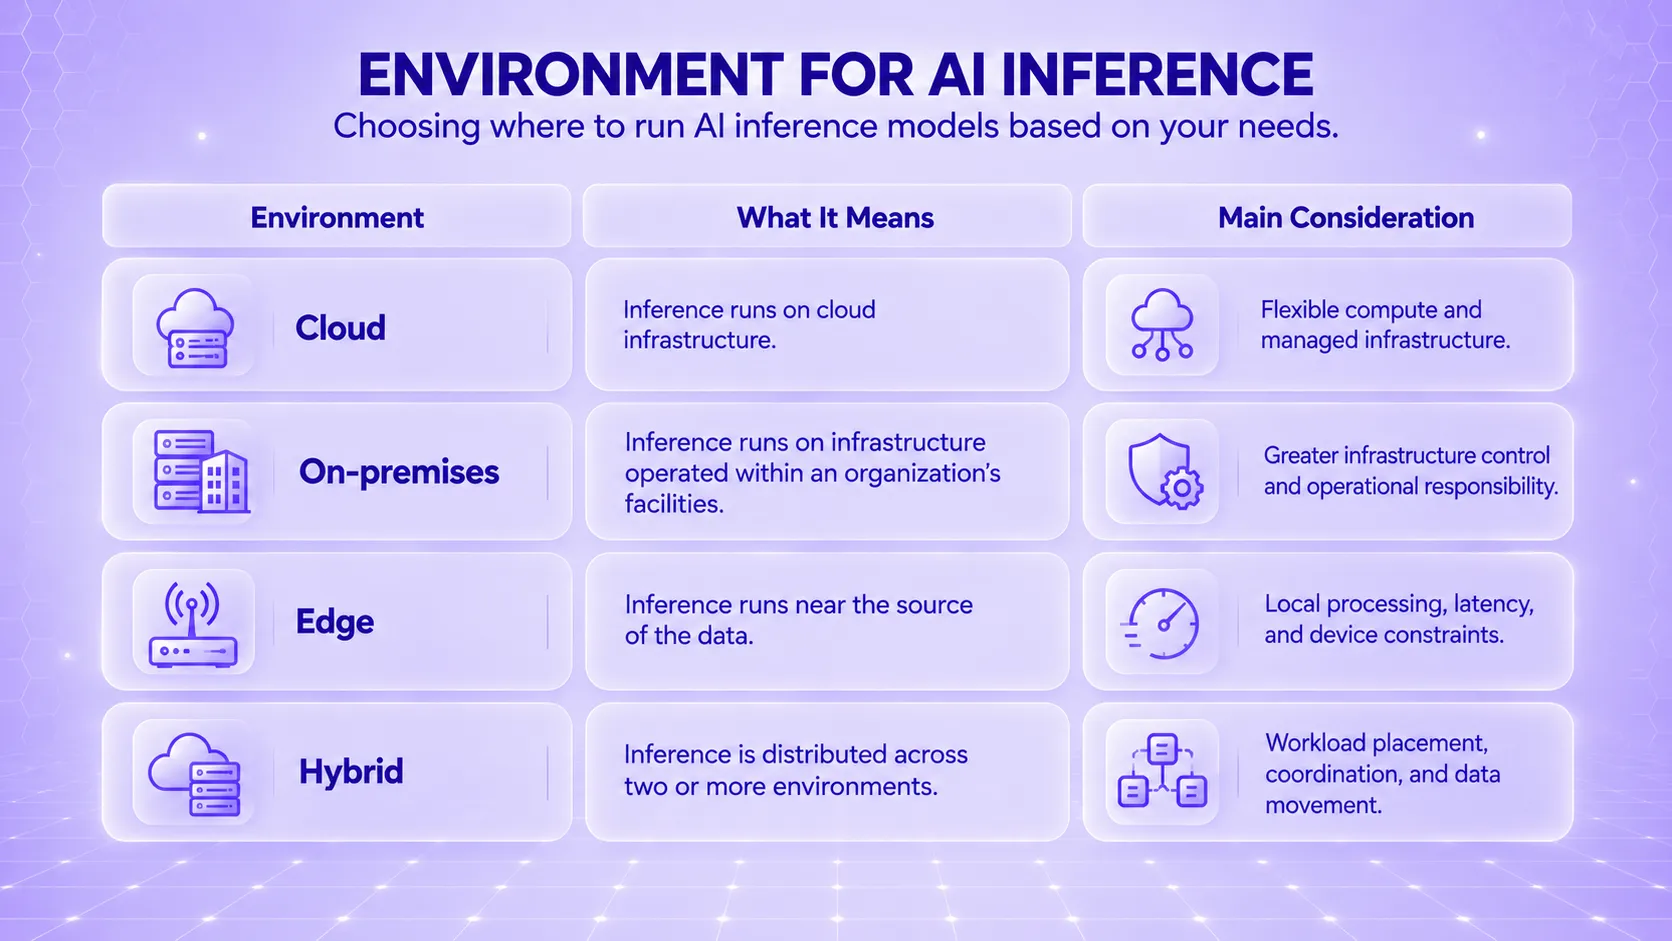
Belangrijk: Hybride is een architecturale aanpak die omgevingen combineert, geen fysieke locatie die gelijkstaat aan cloud, on-premises of edge.
Cloudplatforms
Cloudplatforms bieden toegang tot CPU's, GPU's, TPU's en andere accelerators zonder dat teams de onderliggende hardware zelf hoeven te beheren.
Beheerde endpoints en autoscaling kunnen applicaties helpen om te gaan met wisselende werklasten, terwijl implementaties in meerdere regio's de beschikbaarheid kunnen verbeteren en, met de juiste verkeersroutering, de latentie voor verspreide gebruikers kunnen verminderen. Dit is nauw verwant aan cloud-schaalbaarheid.
On-premises en private cloud
On-premises en private cloud -omgevingen bieden meer controle over infrastructuur en data.
Ze kunnen nuttig zijn wanneer organisaties strikte eisen hebben op het gebied van datalocatie, beveiliging, compliance of eigendom van de infrastructuur. Het nadeel is dat de organisatie een grotere verantwoordelijkheid draagt voor de hardware en het beheer.
Edge-locaties en apparaten
Inference kan ook dichter bij de bron waar data wordt gegenereerd plaatsvinden. Telefoons, browsers, camera's en gateways kunnen kleinere modellen lokaal uitvoeren.
Dit kan de netwerklatentie verminderen en de hoeveelheid informatie beperken die naar een centrale cloudomgeving moet worden verzonden.
Hybride inference
Hybride architecturen combineren edge- en cloud-inference. Een edge-apparaat kan inkomende informatie lokaal filteren of classificeren voordat geselecteerde data naar een groter cloudmodel wordt gestuurd.
Deze aanpak kan de bandbreedte en de behoefte aan cloud-rekenkracht verminderen, terwijl de applicatie indien nodig toch toegang heeft tot krachtigere modellen.
Waarom is hardware belangrijk voor AI-inference?
Hardware beïnvloedt de snelheid van inference, de geheugencapaciteit, de kosten en het energieverbruik.
CPU's zijn geschikt voor kleinere modellen en lichtgewicht werklasten of applicaties waarvoor geen accelerator-hardware nodig is. GPU's worden veel gebruikt voor deep learning en LLM-inference omdat hun parallelle architectuur zeer geschikt is voor de matrixoperaties die deze modellen vereisen. TPU's en andere accelerators voor kunstmatige intelligentie (AI) zijn ontworpen voor machine learning-werklasten en kunnen in geschikte omgevingen extra efficiëntie bieden.
Geheugen kan een grote bottleneck worden voor grote modellen. Modelparameters moeten in het beschikbare geheugen passen, terwijl LLM-werklasten ook geheugen vereisen voor de KV-cache.
Formaten met een lagere precisie verminderen het geheugengebruik en kunnen de efficiëntie van inferentie verbeteren in vergelijking met FP32. Afhankelijk van het model en de kwantisatiemethode kan een lagere precisie ook de kwaliteit van de output beïnvloeden, dus teams moeten de afweging voor hun specifieke workload evalueren.
Aan de 'edge' vormen stroom- en thermische beperkingen een extra aandachtspunt. Een model dat efficiënt draait op een GPU in een datacenter, moet mogelijk worden gecomprimeerd of geoptimaliseerd voordat het effectief kan draaien op een telefoon of ander apparaat met beperkte middelen.
Hoe werkt gedistribueerde AI-inferentie?
Bij grote modellen of hoge aantallen verzoeken kan het nodig zijn om inferentie over meerdere apparaten te verdelen.
Replicatie draait volledige kopieën van modellen op verschillende apparaten, zodat meerdere verzoeken of batches gelijktijdig kunnen worden verwerkt. Tensor- en pipeline-parallellisatie splitsen daarentegen de berekeningen van een model over meerdere apparaten, wat nodig kan zijn wanneer het model of de inferentie-workload niet efficiënt op één accelerator past. Deze technieken kunnen ook worden gecombineerd om aan de vereisten voor geheugen, latentie en doorvoer te voldoen.
Wat zijn de belangrijkste uitdagingen bij AI-inferentie?
Het draaien van inferentie in een productieomgeving brengt meer uitdagingen met zich mee dan alleen zorgen dat een model output genereert.
- Latentie: Applicaties die real-time reacties vereisen, kunnen hinder ondervinden van trage verzoeken, met name aan de uiterste randen van de latentieverdeling. Teams kunnen statistieken zoals p95- en p99-latentie monitoren en technieken inzetten zoals batching, caching, modeloptimalisatie, geschikte hardware en, waar nodig, autoscaling.
- Inferentiekosten: De kosten voor het draaien van modellen kunnen stijgen naarmate modellen groter worden of het aantal verzoeken toeneemt. Teams kunnen de modelgrootte, batching, hardwarebenutting, numerieke precisie en resourcetoewijzing optimaliseren om de kosten per verzoek onder controle te houden.
- Modelkwaliteit: Productiedata of gebruikspatronen kunnen afwijken van de data die tijdens training en evaluatie zijn gebruikt. Het monitoren van inputdistributies en modeloutputs kan teams helpen om data- of conceptdrift te detecteren en te bepalen wanneer aanvullende evaluatie, hertraining of andere interventies nodig zijn.
- Beveiliging: AI-applicaties kunnen worden blootgesteld aan bedreigingen zoals prompt-injectie, het lekken van gevoelige gegevens en ongeautoriseerde toegang tot modellen, vooral wanneer modellen interageren met privégegevens of externe tools. Authenticatie, toegangscontrole, input- en output-guardrails, datafiltering en veilige isolatie kunnen helpen deze risico's te beperken.
- Governance: Naarmate implementaties groeien, moeten teams de toegang tot modellen, de ingezette versies en wijzigingen beheren. Versiebeheer, op rollen gebaseerde toegangscontrole, auditlogs en goedkeuringsworkflows kunnen deze controle bieden.
- Testen: Wijzigingen in de infrastructuur of het model kunnen de prestaties en de kwaliteit van de output beïnvloeden. Belastingstesten kunnen limieten van de infrastructuur blootleggen, terwijl regressietesten en evaluatiedatasets kwaliteitsveranderingen kunnen identificeren. AI-observability kan extra inzicht bieden in de prestaties van de infrastructuur en het gedrag van modellen in productie.
Wat zijn de meest voorkomende use cases voor AI-inferentie?
AI-inferentie wordt gebruikt in toepassingen waarbij modellen voorspellingen moeten doen of output moeten genereren.
- Aanbevelingen en personalisatie gebruiken modellen om producten, video's of andere content te rangschikken op basis van gebruikersgedrag.
- Fraude- en anomaliedetectie gebruiken inferentie om transacties of gebeurtenissen te identificeren die afwijken van verwachte patronen.
- Computer vision -toepassingen gebruiken inferentie voor beeldclassificatie, objectdetectie, OCR, inspectie en veiligheidsmonitoring.
- Toepassingen voor natuurlijke taal gebruiken modellen voor classificatie, vertaling, samenvatting, sentimentanalyse en informatie-extractie.
- Generatieve AI-assistenten en AI-agents gebruiken inferentie om verzoeken te begrijpen, antwoorden te genereren, informatie op te halen en met tools te communiceren. Deze toepassingen vormen vaak onderdeel van een bredere LLMOps-omgeving.
Hoe past AI-inferentie in moderne AI-infrastructuur?
Inferentie is zelden een op zichzelf staand onderdeel in een AI-productieomgeving. Een typisch systeem combineert modellen vaak met API's, databases, ophaalsystemen, serving-infrastructuur, monitoring en orkestratie.
Een AI-assistent kan bijvoorbeeld een LLM gebruiken voor inferentie, relevante informatie ophalen uit een vectordatabase, en die informatie als context aan het model verstrekken. Complexere toepassingen kunnen meerdere modellen en tools tegelijk gebruiken, waardoor routing, observability, toegangscontrole en infrastructuurbeheer steeds belangrijker worden.
Voor LLM-applicaties die gebruikmaken van meerdere modellen of aanbieders, kan een AI Gateway een gecentraliseerde laag bieden voor het routeren van inferentie-aanvragen, het toepassen van toegangs- en kostencontroles, het afhandelen van fallbacks en het monitoren van modelverkeer. De AI Gateway van TrueFoundry ondersteunt deze functies voor zowel gehoste als zelf-gehoste modellen.
Naarmate AI-applicaties naar productie gaan, raakt inferentie nauw verbonden met model serving, implementatie, observability, governance en infrastructuurbeheer.
Preparing to run AI inference in production?
Belangrijkste punten
Het in productie brengen van een getraind model vereist meer dan alleen het genereren van een correcte output. Teams moeten ook voldoen aan doelstellingen voor latentie en doorvoer, serving-kosten beheersen, de juiste hardware kiezen, gegevens beschermen, de modelkwaliteit monitoren en de infrastructuur schalen naarmate de vraag verandert.
De juiste inferentie-architectuur hangt af van de workload. Interactieve applicaties geven mogelijk prioriteit aan lage latentie, batch-workloads aan doorvoer en kosten, en edge-implementaties aan lokale verwerking en efficiënt gebruik van resources. Door inferentie te behandelen als een kwestie van productie-infrastructuur, kunnen teams deze afwegingen weloverwogen maken.
Beheer, implementeer en traceer AI in je eigen infrastructuur
Veelgestelde vragen
What is an example of AI inference?
An AI assistant generating an answer to a user's question is an example of AI inference. Other examples include product recommendations, fraud detection, image recognition, and text classification.
What are common AI inference applications?
Common applications include recommendation systems, fraud detection, search ranking, computer vision, OCR, translation, summarization, chatbots, copilots, and AI agents. Each uses a trained model to process new data and produce an output.
Is inference the future of AI?
Inference is already a critical part of modern AI. As more models move into production, organizations need inference systems that are faster, scalable, reliable, and cost-efficient. The growth of generative AI and AI agents is likely to increase the demand for efficient inference infrastructure.
Is ChatGPT an inference engine?
ChatGPT is an AI application powered by large language models. When its underlying model processes a prompt and generates a response, it is performing inference. However, ChatGPT is more than an inference engine because it includes the application and supporting systems around the model.
Is AI inference better on CPU or GPU?
It depends on the workload. CPUs can work well for smaller models, lower-throughput workloads, or environments where accelerator hardware is unnecessary. GPUs are often preferred for large neural networks and high-throughput inference because they can execute many model operations in parallel. Model architecture, size, latency targets, throughput, memory, hardware availability, and cost all influence the decision.
What is the difference between generative AI and inference AI?
“Inference AI” is not generally a separate category of AI. Generative AI refers to models and applications that generate content such as text, images, audio, or code, while inference is the process of running a trained model to produce an output. Generative AI systems therefore perform inference whenever they generate content.

GenAI-infrastructuur: eenvoudiger, sneller, goedkoper
Vertrouwd door topteams voor het schalen van GenAI

- © 2022 ENSEMBLE Technologies



Aanmelden voor onze nieuwsbrief
Het laatste nieuws, artikelen en bronnen in je inbox


