


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


Wat zijn AI-hallucinaties en waarom treden ze op?

Een AI-systeem kan een antwoord produceren dat volkomen overtuigend klinkt en toch onjuist is. Het kan een onderzoeksartikel verzinnen, een niet-bestaande rechtszaak aanhalen, een softwarebibliotheek suggereren die nooit is uitgebracht, of vol zelfvertrouwen een foutief antwoord geven op de vraag van een gebruiker.
Deze output wordt AI-hallucinaties genoemd. Ze treden op wanneer een AI-systeem informatie genereert die onjuist, verzonnen of niet ondersteund wordt door betrouwbaar bewijs. In zakelijke toepassingen kunnen feitelijke fouten of onjuiste informatie gevolgen hebben voor klanten, medewerkers, besluitvorming of downstream-systemen.
Dit artikel behandelt wat AI-hallucinaties zijn, waarom ze voorkomen, welke vormen ze aannemen en hoe je ze kunt verminderen en detecteren in AI-systemen in productie.
Wat zijn AI-hallucinaties?
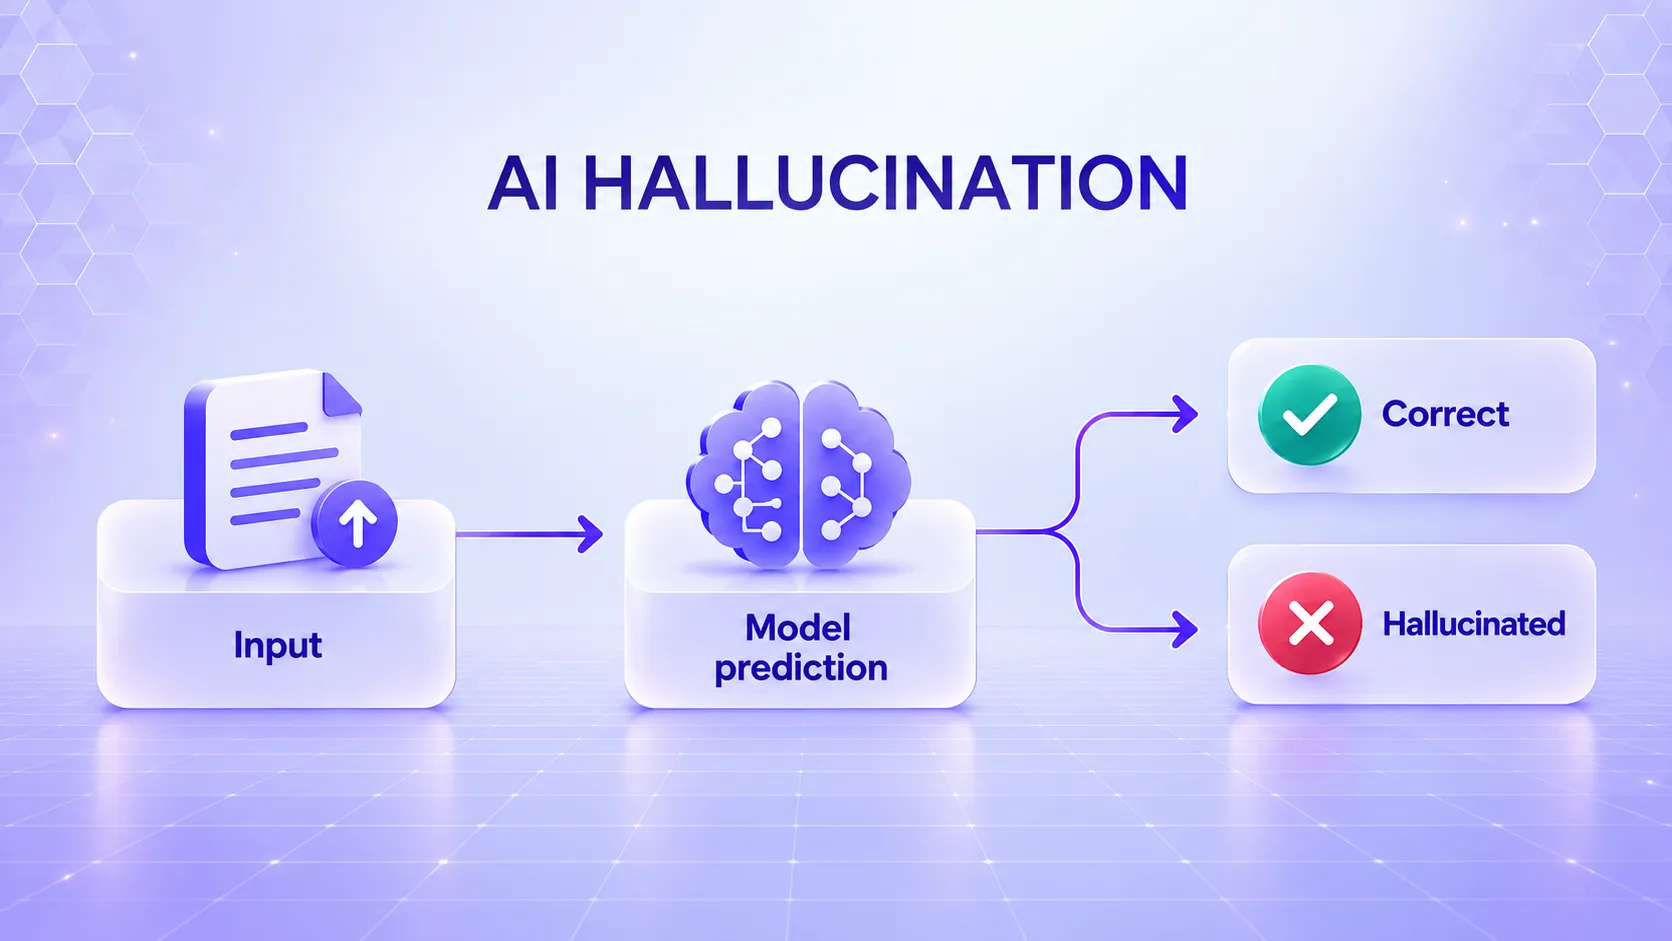
AI-hallucinaties zijn onjuiste, verzonnen of niet-ondersteunde resultaten die door een AI-systeem worden gegenereerd, die geloofwaardig lijken of als accuraat worden gepresenteerd.
Bijvoorbeeld, een large language model (LLM) kan worden gevraagd om een onderzoeksartikel samen te vatten en de bronvermelding te geven. Als het artikel niet bestaat, maar het model creëert een realistische titel, auteur, tijdschrift en publicatiedatum, dan is het antwoord een hallucinatie.
Dit gebeurt omdat generatieve modellen output produceren op basis van patronen die zijn geleerd uit de trainingsdata van het AI-model, in plaats van elke bewering automatisch te controleren aan de hand van een vertrouwde bron.
Hallucinaties kunnen voorkomen in tekst, afbeeldingen, code, audio en andere door AI gegenereerde output. De manier waarop ze verschijnen en de oorzaken van AI-hallucinaties kunnen verschillen per model, toepassing en taak.
Waarom treden AI-hallucinaties op?
Er zijn verschillende redenen waarom kunstmatige intelligentie (AI) -systemen hallucineren. Hallucinaties kunnen het gevolg zijn van beperkingen in het model en de trainingsdata, vage prompts of een gebrek aan betrouwbare databronnen die beschikbaar zijn op het moment van genereren.
Hoe genereren taalmodellen antwoorden?
Large language models genereren tekst door te voorspellen welke tokens waarschijnlijk als volgende komen op basis van patronen die tijdens de training zijn geleerd, in plaats van een vast redeneerproces te volgen dat elke bewering verifieert.
Hierdoor kunnen LLM's opmerkelijk vloeiende antwoorden produceren, maar vloeiendheid is niet hetzelfde als feitelijke nauwkeurigheid. Als het model niet over betrouwbare informatie beschikt of het antwoord niet kan bepalen op basis van zijn geleerde patronen, kan het alsnog een antwoord genereren dat redelijk lijkt, maar feitelijke onjuistheden bevat.
Een gebruiker die bijvoorbeeld vraagt naar een obscure historische gebeurtenis, kan een gedetailleerde uitleg krijgen, zelfs wanneer betrouwbare informatie over die gebeurtenis beperkt is. Het model kan geleerde patronen combineren tot een aannemelijk antwoord zonder dat er bewijs is om de gebeurtenis te ondersteunen.
Dit onderscheid helpt verklaren waarom een vloeiend antwoord niet per se een feitelijk juist antwoord is. Taalgeneratie en feitelijke verificatie zijn verschillende taken.
Kunnen hiaten in trainingsdata leiden tot hallucinaties?
Ja. Modellen leren van grote verzamelingen data, maar die datasets kunnen onvolledig, verouderd of inconsistent zijn, of bepaalde onderwerpen slechts beperkt dekken.
Dit kan een probleem worden wanneer een model vragen krijgt over nicheonderwerpen of informatie die vaak verandert, vooral wanneer het model vertrouwt op verouderde gegevens. Een model kan bijvoorbeeld informatie hebben geleerd over een oudere versie van een softwarebibliotheek zonder op de hoogte te zijn van een recente update.
Datakwaliteit speelt ook een rol. Onjuiste of tegenstrijdige informatie in trainingsdata kan het voor een model lastiger maken om betrouwbare resultaten te produceren.
Kan de modelarchitectuur bijdragen aan hallucinaties?
De modelarchitectuur en het statistische karakter van taalgeneratie kunnen eveneens bijdragen aan hallucinaties.
Een AI-model haalt geen feiten uit zijn parameters op zoals een database geverifieerde records ophaalt. Het leert patronen en relaties uit zijn trainingsdata en gebruikt die patronen om output te genereren, in plaats van geverifieerde gegevens uit gecureerde kennisbanken te raadplegen.
Hierdoor kan het model een bewering genereren die coherent en geloofwaardig klinkt, maar niet door bewijs wordt ondersteund.
Een groter of krachtiger model kan voor veel taken beter presteren, maar modelcapaciteit alleen is geen garantie voor feitelijke nauwkeurigheid.
Kunnen slechte prompts het aantal hallucinaties verhogen?
De manier waarop een vraag is geformuleerd, kan de kwaliteit van een AI-antwoord beïnvloeden.
Denk aan de vage prompt: "Vertel me over de nieuwste AI-regelgeving."
De prompt specificeert geen land, sector, toezichthouder of tijdsbestek. Het model kan aannames doen over deze ontbrekende details en een antwoord geven dat niet aansluit bij de context.
Duidelijke prompt engineering kan nuttige instructies, context, beperkingen en het verwachte outputformaat bieden. Dit kan ambiguïteit verminderen, hoewel betere prompting op zichzelf hallucinaties niet volledig kan elimineren.
Waarom is een gebrek aan 'grounding' een probleem?
Een model heeft mogelijk geen toegang tot de informatie die nodig is om een vraag nauwkeurig te beantwoorden.
Dit komt vaak voor wanneer een applicatie actuele informatie, privégegevens van een bedrijf, bedrijfsdata, interne documentatie of informatie uit een specifieke database nodig heeft.
Wanneer de benodigde informatie niet aanwezig is in de aangeleerde kennis van het model, kan een AI-toepassing het model verbinden met externe bronnen. Retrieval-augmented generation (RAG) is een methode die relevante informatie uit externe bronnen ophaalt en deze als context aan het model geeft voordat er een antwoord wordt gegenereerd. Deze RAG-systemen kunnen documentatie, databases en andere vertrouwde bronnen gebruiken om relevante context te bieden.
Het baseren van het model op relevante externe informatie kan hallucinaties verminderen, vooral als de toepassing afhankelijk is van recente of vertrouwelijke gegevens.
Welke soorten AI-hallucinaties kunnen optreden?
AI-hallucinaties kunnen verschillende vormen aannemen, afhankelijk van het type AI-systeem en de aard van de output of interpretatie die het model produceert.
Tekst- en taalhallucinaties
Tekstgebaseerde hallucinaties omvatten verzonnen feiten, gefabriceerde citaten, feitelijke onjuistheden, onjuiste uitleg, valse citaten en beweringen die nergens op gebaseerd zijn.
Ze kunnen lastig op te merken zijn wanneer het antwoord gedetailleerd, coherent en zelfverzekerd wordt gepresenteerd. Een gebruiker kan ervan uitgaan dat een goed gestructureerd antwoord ook op feiten is gecontroleerd, terwijl dat niet het geval is.
Beeld- en visuele hallucinaties
Beeldgeneratiemodellen kunnen objecten of visuele details creëren die niet met de werkelijkheid overeenkomen. Ze kunnen ook inconsistente vormen, kenmerken of relaties tussen objecten produceren.
Computervisiesystemen kunnen onnauwkeurige interpretaties produceren, zoals het verkeerd classificeren van een object of het onjuist identificeren van een visueel kenmerk.
Codehallucinaties
AI-codeersystemen kunnen functies, API's, pakketten of configuratieopties genereren die legitiem lijken maar niet bestaan, wat resulteert in feitelijke fouten in gegenereerde technische documentatie of code.
Ze kunnen ook technische details genereren, zoals API-parameters, die geldig lijken maar niet bestaan. Door AI gegenereerde code moet altijd worden getest en beoordeeld voordat deze in een productieomgeving kan worden gebruikt.
Multimodale hallucinaties
Multimodale hallucinaties treden op wanneer een AI-systeem een onjuiste interpretatie produceert op basis van meerdere soorten input, zoals tekst, afbeeldingen, audio en video.
Een systeem kan één input verkeerd begrijpen of een onjuist verband leggen tussen verschillende inputs, wat het risico op hallucinaties vergroot wanneer meerdere modaliteiten tegelijkertijd worden verwerkt. Deze hallucinaties kunnen moeilijker te identificeren zijn omdat het uiteindelijke antwoord informatie uit verschillende modaliteiten kan combineren.
Waar komen AI-hallucinaties voor in de echte wereld?
Hallucinaties worden zorgwekkender wanneer AI-outputs worden gebruikt in AI-workflows waarbij eindgebruikers erop vertrouwen als betrouwbare informatie.
Verzonnen bronvermeldingen
AI-systemen kunnen realistisch ogende verwijzingen genereren naar papers, websites, artikelen en andere bronnen die niet bestaan, inclusief verzonnen juridische citaten en academische referenties.
Dit kan problemen veroorzaken in onderzoek, journalistiek, onderwijs en professioneel werk, omdat een gebruiker de verzonnen bron kan citeren of erop kan vertrouwen zonder het origineel te controleren.
Verzonnen feiten en gebeurtenissen
Een AI-systeem kan onjuiste statistieken, bedrijfsinformatie, historische gebeurtenissen, productspecificaties of zelfs volledig fictieve personen genereren.
Het risico neemt toe wanneer het onderwerp obscuur is en betrouwbare informatie beperkt is.
Juridisch onderzoek
Juridisch werk heeft de duidelijkste voorbeelden opgeleverd van de risico's die hiermee gepaard gaan, vooral wanneer door AI gegenereerd juridisch advies zonder verificatie wordt gebruikt. Door AI gegenereerd juridisch onderzoek bevat in sommige gevallen verwijzingen naar zaken die niet bestaan of beschrijft bestaande jurisprudentie onnauwkeurig.
De les is niet dat AI geen plaats heeft in juridische werkprocessen. Integendeel, AI-output met een hoog risico moet worden gecontroleerd aan de hand van gezaghebbende bronnen voordat men erop vertrouwt.
Wetenschappelijk onderzoek
AI kan onjuiste referenties produceren, onderzoeksresultaten verkeerd interpreteren of ongefundeerde wetenschappelijke verklaringen genereren.
Onderzoekers kunnen AI gebruiken voor taken zoals samenvatten en literatuuronderzoek, maar belangrijke beweringen in wetenschappelijke teksten moeten nog steeds worden gecontroleerd aan de hand van de originele papers, datasets en andere betrouwbare bronnen.
Klantenservice
Denk aan een AI-chatbot die wordt gebruikt voor klantenservice. Een klant kan vragen of een product in aanmerking komt voor restitutie. Een AI-assistent zou vol zelfvertrouwen het verkeerde beleid kunnen geven als deze geen toegang heeft tot de actuele ondersteuningsdocumentatie van het bedrijf.
Voor dit type werkproces kan het baseren van het antwoord op actuele bedrijfsdocumentatie het risico verkleinen dat verouderde of onjuiste beleidsinformatie wordt verstrekt.
Hoe kunnen AI-hallucinaties worden verminderd?
Er is geen enkele oplossing die garandeert dat een AI-systeem nooit zal hallucineren. Betrouwbare systemen combineren meestal verschillende technieken, afhankelijk van de toepassing en het risico dat ermee gemoeid is.
Kan betere trainingsdata hallucinaties verminderen?
Hoogwaardige en representatieve trainingsdata kunnen de prestaties van een model verbeteren en bepaalde soorten fouten verminderen.
Training is echter geen praktische manier om elk model up-to-date te houden met voortdurend veranderende informatie. Een model dat maanden geleden is getraind, kan niet automatisch weten wat er gisteren is veranderd.
Voor actuele of vertrouwelijke informatie zijn retrieval en grounding vaak nuttiger.
Hoe helpt RAG om hallucinaties te verminderen?
Retrieval-augmented generation (RAG) koppelt een AI-model aan een externe kennisbron.
Wanneer een gebruiker een vraag stelt, haalt de applicatie relevante informatie op uit bronnen zoals documentatie, databases of samengestelde kennisbanken. De opgehaalde inhoud wordt vervolgens aan het model verstrekt, zodat het die informatie kan gebruiken bij het genereren van het antwoord.
RAG elimineert hallucinaties niet automatisch. Gebrekkige retrieval kan er nog steeds voor zorgen dat het model onvolledige of irrelevante context krijgt. Daarom moeten zowel de kwaliteit van de retrieval als de kwaliteit van het antwoord worden geëvalueerd.
Build reliable RAG applications with TrueFoundry

Kan prompt engineering helpen?
Met duidelijke instructies kun je een AI-systeem vertellen welke informatie het moet gebruiken, hoe het moet reageren als informatie ontbreekt en hoe het de verstrekte bronnen of context moet inzetten.
Een applicatie kan het model bijvoorbeeld instrueren om aan te geven dat het niet over voldoende informatie beschikt, in plaats van zelf een antwoord te verzinnen.
Prompting is nuttig, maar moet worden gezien als één laag van een bredere betrouwbaarheidsstrategie.
Waarom blijft menselijke controle belangrijk?
Menselijk toezicht wordt belangrijker naarmate de potentiële impact van een onjuist antwoord toeneemt, vooral wanneer er sprake is van ernstige gevolgen of financiële en reputatierisico's.
Een reactie van de klantenservice vereist mogelijk een ander niveau van controle dan een door AI gegenereerd advies dat wordt gebruikt in een financieel of medisch proces. Teams kunnen goedkeuringsprocessen definiëren voor output of acties die een hoger risico met zich meebrengen.
Kan fine-tuning hallucinaties voorkomen?
Fine-tuning Fine-tuning kan de prestaties van een model voor een specifieke taak verbeteren of helpen bij het volgen van een bepaald format. Het kan een model ook geschikter maken voor een specifiek domein.
Fine-tuning verandert een LLM echter niet in een continu bijgewerkte kennisbank. Als een applicatie actuele informatie nodig heeft, kunnen retrieval en externe grounding alsnog vereist zijn.
Stopt het verlagen van de temperatuur hallucinaties?
Het wijzigen van generatieparameters zoals de temperatuur kan invloed hebben op de variatie in de antwoorden van het model, maar het maakt het model geen feitencontroleur.
Een lagere temperatuur kan de output in sommige applicaties voorspelbaarder maken, maar een voorspelbaar onjuist antwoord blijft onjuist. Het afstellen van parameters moet daarom een aanvulling zijn op, en geen vervanging van, technieken zoals retrieval en evaluatie wanneer deze geschikt zijn voor de applicatie.
Hoe kunnen teams AI-hallucinaties detecteren?
Het verminderen van hallucinaties is slechts een onderdeel van het bouwen van een betrouwbare AI-applicatie. Teams hebben ook manieren nodig om onjuiste of verzonnen antwoorden te identificeren.
Modeloutputs evalueren
Teams kunnen evaluatiedatasets maken met representatieve vragen en verwachte antwoorden of uitkomsten. Deze datasets kunnen vervolgens worden gebruikt om wijzigingen in het model, prompts, ophaalsystemen en applicatielogica te testen.
Gouden datasets, regressietests, feitelijkheidscontroles en menselijke evaluaties kunnen teams helpen bepalen of outputs na wijzigingen nauwkeurig en betrouwbaar blijven.
Opgehaalde informatie verifiëren
In een RAG-applicatie hangt het uiteindelijke antwoord deels af van de informatie die uit de onderliggende kennisbron wordt opgehaald.
Als het verkeerde document wordt opgehaald, kan het model een onjuist antwoord genereren, zelfs als het model zelf in staat is om de vraag correct te beantwoorden.
Teams moeten daarom zowel de kwaliteit van het ophalen als de kwaliteit van de door het model gegenereerde respons evalueren.
AI-applicaties in productie monitoren
Zodra een AI-applicatie in productie draait, hebben teams inzicht nodig in hoe deze presteert en reageert op gebruikers.
AI-observability kan teams helpen bij het monitoren van factoren zoals modelprestaties, latentie, ophaalgedrag, fouten en outputkwaliteit. Dit maakt het eenvoudiger om problemen te identificeren die traditionele infrastructuurmonitoring mogelijk niet aan het licht brengt.
Deze werkwijzen kunnen onderdeel vormen van LLMOps, waarbij teams modellen, prompts, evaluaties, implementaties, monitoring en governance gedurende de gehele AI-levenscyclus beheren.
AI-hallucinaties in de praktijk
AI-hallucinaties maken betrouwbaarheid tot een uitdaging, aangezien aannemelijk klinkende outputs niet altijd accuraat zijn of door bewijs worden ondersteund. Voor AI-applicaties in productie betekent betrouwbaarheid het onderbouwen van antwoorden, het evalueren en observeren van outputs en het monitoren van systeemgedrag.
Grounding, RAG, betere prompting, fine-tuning, evaluatie, menselijk toezicht en AI-observability kunnen allemaal helpen de frequentie en impact van hallucinaties te verminderen. Voor AI in productie is het doel niet simpelweg om betere antwoorden te genereren. Het doel is om systemen te bouwen waarin die antwoorden onderbouwd, geëvalueerd en gemonitord kunnen worden.
Beheer, implementeer en traceer AI in je eigen infrastructuur
Veelgestelde vragen
How common is AI hallucination?
AI hallucinations are a known limitation of generative AI, but their occurrence varies by model, task, prompt, and domain. They are more likely to occur in open-ended tasks or when the model has no reliable information about the task, or when the subject matter is obscure or changing.
Which AI hallucinates the most?
There is no reliable single ranking of which AI model hallucinates the most. Hallucination rates depend on the model, evaluation method, subject matter, prompt, and whether the application uses techniques such as retrieval and grounding.
How do you know if your AI is hallucinating?
Check important claims against reliable sources instead of judging by how confident the response sounds. In production, teams can use evaluation datasets, source verification, factuality checks, human review, and monitoring to identify inaccurate outputs.
Can you get rid of AI hallucinations?
No. AI hallucinations cannot currently be eliminated. However, grounding, clear prompting, evaluation, output validation, and human oversight can reduce their frequency and limit their impact.

GenAI-infrastructuur: eenvoudiger, sneller, goedkoper
Vertrouwd door topteams voor het schalen van GenAI

- © 2022 ENSEMBLE Technologies



Aanmelden voor onze nieuwsbrief
Het laatste nieuws, artikelen en bronnen in je inbox


