


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


Wat is Unsupervised Learning en waarom is het belangrijk?

De meeste data in de wereld is niet gelabeld. Niemand heeft de tijd genomen om elke klant, elk document of elke afbeelding te voorzien van het antwoord waar jij toevallig in geïnteresseerd bent. Unsupervised learning is de tak van machine learning die precies voor deze situatie is gebouwd: het vinden van nuttige structuren in data zonder dat iemand het model heeft verteld waar het naar moet zoeken.
In plaats van een koppeling te leren tussen invoer en bekende antwoorden, bestudeert een unsupervised model de data zelf en brengt het patronen aan het licht, zoals welke groepen voorbeelden op elkaar lijken, welke kenmerken de meeste informatie bevatten en hoe de data is georganiseerd. Deze ontdekkingen kunnen op zichzelf waardevol zijn of dienen als input voor andere systemen.
Deze gids legt uit wat unsupervised learning is, waarvoor het wordt gebruikt, hoe het zich verhoudt tot supervised learning en wanneer je het moet inzetten.
Wat is unsupervised learning?
Unsupervised learning is een vorm van machine learning waarbij een model wordt getraind op data zonder gelabelde output. Het doel is niet om een bekend antwoord te voorspellen, maar om inherente structuren te vinden, zoals natuurlijke groeperingen, patronen of een compacte weergave van de data. Het model leert van de organisatie van de data zelf in plaats van door middel van supervisie.
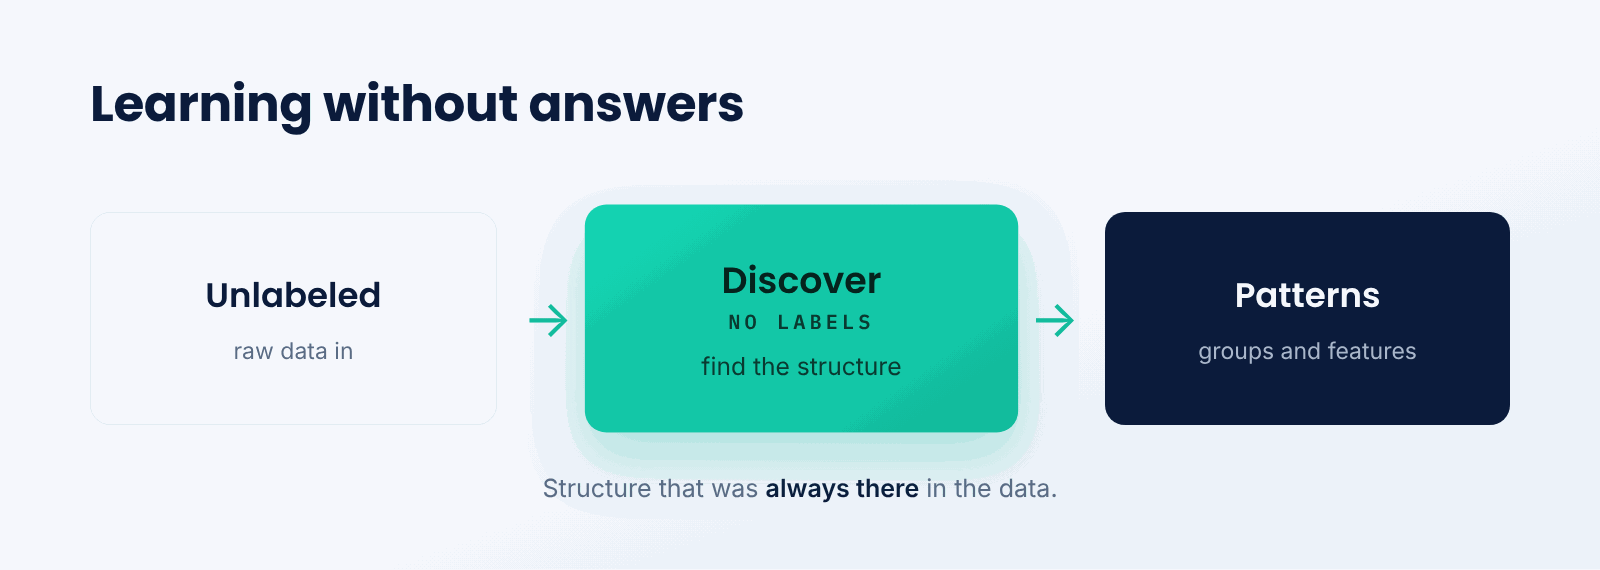
Zie het als het sorteren van een stapel ongesorteerde foto's. Zonder dat je de categorieën krijgt, zou je ze op natuurlijke wijze kunnen groeperen op basis van wie er op staat, waar ze zijn genomen of hun kleuren. Je ontdekt structuren die altijd al in de data aanwezig waren. Unsupervised learning doet hetzelfde: het vindt groeperingen en patronen zonder vooraf gedefinieerde labels.
Het kernidee is leren zonder antwoorden. Omdat het model geen doel-output krijgt, moet het volledig vertrouwen op de relaties binnen de data. Dit maakt het krachtig voor verkenning en voor het werken met de enorme hoeveelheden ongelabelde data die er bestaan.
Waarvoor wordt unsupervised learning gebruikt?
Verschillende veelvoorkomende taken vallen onder unsupervised learning, waarbij elk een ander soort structuur aan het licht brengt.
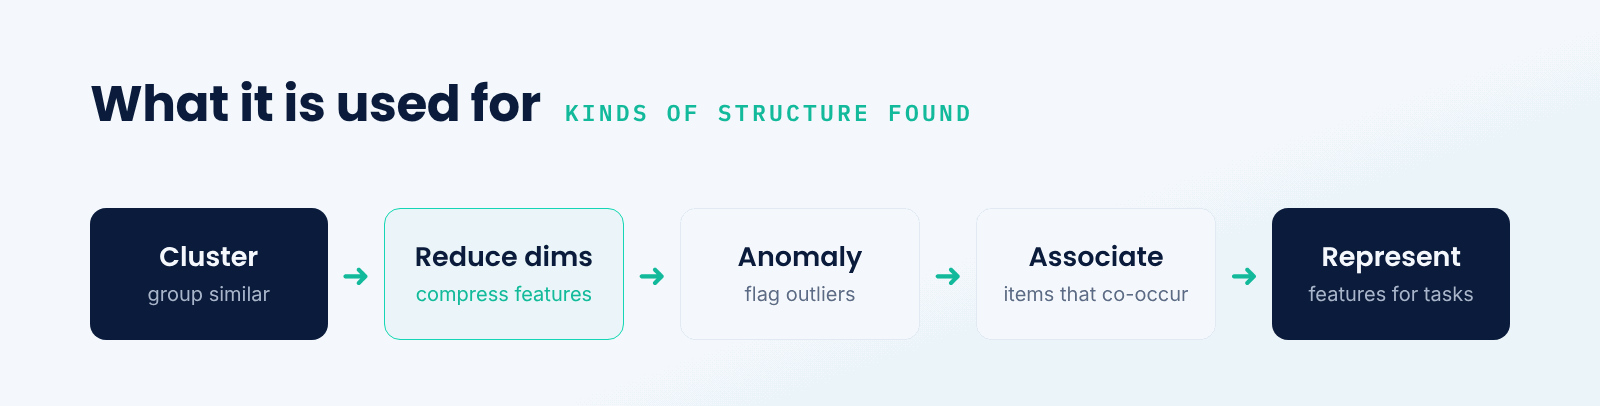
- Clustering. Groepeer vergelijkbare voorbeelden, zoals het segmenteren van klanten.
- Dimensionaliteitsreductie. Comprimeer data naar minder kenmerken met behoud van de structuur.
- Anomaliedetectie. Markeer voorbeelden die niet passen bij de geleerde patronen.
- Associatie. Vind items die vaak samen voorkomen, zoals bij marktmand-analyse.
- Representation learning. Leer nuttige kenmerken die helpen bij andere vervolgstappen.
Deze taken zetten ruwe, ongelabelde data om in iets bruikbaars: segmenten waarop je je kunt richten, gecomprimeerde kenmerken waar makkelijker mee te werken valt, of uitschieters die het onderzoeken waard zijn. Vaak vormt de output van unsupervised learning de input voor een latere supervised stap.
Unsupervised vs. supervised learning
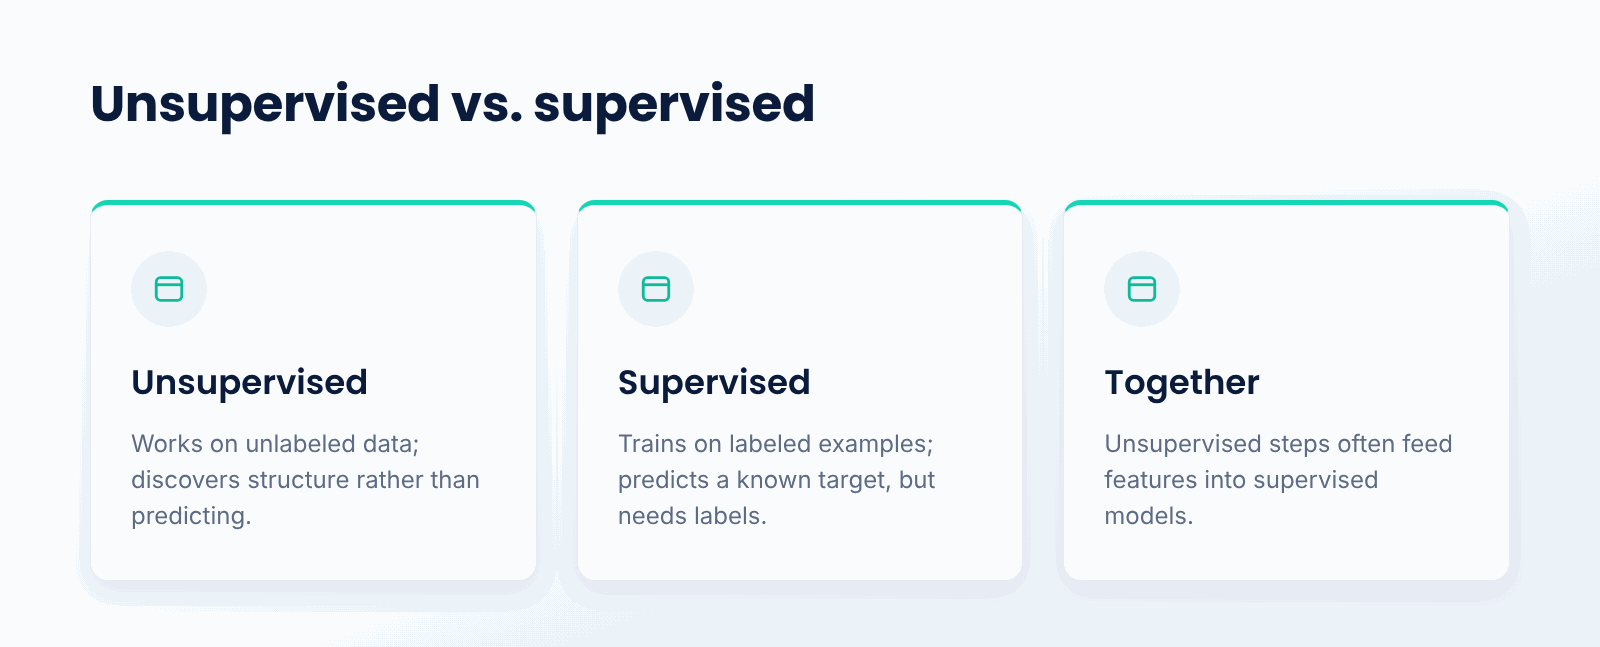
Supervised learning traint op gelabelde voorbeelden en leert input te koppelen aan bekende output, zodat het labels kan voorspellen voor nieuwe data. Hiervoor is gelabelde data nodig, wat kostbaar kan zijn om te produceren. Unsupervised learning werkt met ongelabelde data en ontdekt structuren in plaats van een bekend doel te voorspellen. Het ruilt de duidelijkheid van een vastgesteld doel in voor het vermogen om zonder labels te werken.
De twee zijn complementair. Supervised learning is uitstekend wanneer je labels en een duidelijke voorspellingstaak hebt; unsupervised learning is uitstekend wanneer je veel data hebt maar geen labels, of wanneer je de data wilt verkennen en begrijpen. Veel systemen gebruiken beide, waarbij unsupervised stappen de supervised stappen voeden.
Waarom is unsupervised learning belangrijk?
- Overvloed aan data. Het werkt met de enorme hoeveelheden ongelabelde data die er bestaan.
- Geen labelkosten. Het vermijdt de kosten van het annoteren van voorbeelden.
- Ontdekking. Het brengt patronen en segmenten aan het licht waar je niet naar zocht.
- Preprocessing. Het genereert kenmerken en representaties voor andere modellen.
- Anomaliedetectie. Het markeert ongebruikelijke gevallen zonder dat daar gelabelde voorbeelden van nodig zijn.
Wat zijn de afwegingen?
- Geen ground truth. Zonder labels zijn resultaten lastiger te valideren.
- Interpretatie. De ontdekte structuur komt mogelijk niet overeen met wat voor jou relevant is.
- Evaluatie.Het meten van de kwaliteit is minder eenduidig dan bij taken met labels.
- Optimalisatie.Keuzes zoals het aantal clusters kunnen de uitkomst sterk beïnvloeden.
Wanneer moet je unsupervised learning gebruiken?
Gebruik het wanneer je over ongelabelde data beschikt en de structuur wilt verkennen, segmenteren, comprimeren of afwijkingen wilt opsporen. Het is ook de juiste keuze wanneer labels te duur of onpraktisch zijn om te verkrijgen, en wanneer het doel is om de data te begrijpen in plaats van een specifiek doel te voorspellen.
Als je gelabelde data hebt en een duidelijke voorspellingstaak, is supervised learning meestal directer. Maar zelfs dan kan een unsupervised stap helpen door structuur te onthullen, dimensionaliteit te verminderen of kenmerken te genereren die het supervised model verbeteren.
Kernpunten over unsupervised learning
- Het vindt structuur in ongelabelde data.
- Clustering en dimensionaliteitsreductie zijn kerntaken.
- Het is waardevol wanneer labels schaars of kostbaar zijn.
- De resultaten kunnen moeilijker te valideren zijn zonder ground truth.
- Het levert vaak kenmerken of segmenten aan voor supervised modellen.
- Kies het voor verkenning, segmentatie en anomaliedetectie.
Conclusie
Unsupervised learning vindt patronen in data zonder labels en ontdekt structuren zoals clusters, gecomprimeerde representaties en afwijkingen, in plaats van een bekend antwoord te voorspellen. Het is van onschatbare waarde voor de enorme hoeveelheid ongelabelde data in de wereld en voor het verkennen en begrijpen van data, waarbij de resultaten vaak worden gebruikt in supervised stappen. Het belangrijkste voorbehoud is dat resultaten moeilijker te valideren zijn zonder ground truth.
TrueFoundry helpt teams bij het bouwen, trainen en serveren van allerlei soorten machine learning-modellen op hun eigen infrastructuur, inclusief de unsupervised stappen die ruwe data omzetten in bruikbare kenmerken en segmenten. Het begrijpen van unsupervised learning is essentieel om het maximale uit ongelabelde data te halen.
Beheer, implementeer en traceer AI in je eigen infrastructuur
Veelgestelde vragen
What is unsupervised learning in simple terms?
It is machine learning based on unlabeled data. Unlike the case where the model is trained on the correct answers, in unsupervised learning the model comes up with structure on its own, for instance clustering similar instances or reducing the dimensionality of data.
How is unsupervised learning different from supervised learning?
The supervised learning process involves labeled inputs that help predict the correct output, while unsupervised learning does not involve any labels. It simply helps find patterns and structure within the data, exploring rather than predicting a known target.
What is clustering?
Clustering is a fundamental unsupervised learning technique where the algorithm forms clusters of data points based on their similarity and not on pre-existing categories. It may involve grouping consumers according to their behaviors or documents according to their topics, with the groupings emerging from the data rather than being specified in advance.
When should I use unsupervised learning?
In situations where there is unlabeled data and it is necessary to explore it, segment it, reduce its dimensions, or look for anomalies, and where labeling the data is too expensive. It is also useful as a preprocessing step that produces features for a later supervised model.
How do you evaluate an unsupervised model?
It is more difficult than with labeled tasks since there is no ground truth here. You have to use indicators such as the correspondence between the structure and the data, the usefulness of the results downstream, and domain knowledge about whether the found patterns are meaningful.

GenAI-infrastructuur: eenvoudiger, sneller, goedkoper
Vertrouwd door topteams voor het schalen van GenAI

- © 2022 ENSEMBLE Technologies



Aanmelden voor onze nieuwsbrief
Het laatste nieuws, artikelen en bronnen in je inbox


